

În acest articol, voi vorbi despre o situație care a avut loc recent cu unul dintre serverele noastre din cloud VPS, care m-a lăsat perplex timp de câteva ore. Am lucrat timp de aproximativ 15 ani la configurarea și depanarea serverelor Linux, dar acest caz a fost complet neobișnuit pentru mine – am făcut câteva presupuneri greșite și am fost ușor disperat înainte de a reuși să identific corect cauza problemei și să o rezolv.
Preambul
Exploatăm un cloud de dimensiuni medii, construit pe servere standard cu următoarea configurație - 32 de nuclee, 256 GB RAM și un SSD NVMe PCI-E Intel P4500 de 4TB. Ne place foarte mult această configurație, deoarece ne permite să nu ne facem griji cu privire la lipsa de I/O, asigurând o limitare corectă la nivel de tipuri de instanțe VM. Deoarece NVMe Intel are o performanță impresionantă, putem oferi simultan atât IOPS complete pentru mașini, cât și backup pentru stocare pe un server de backup cu IOWAIT zero.
Facem parte din acei veghetori care nu folosesc SDN hiperconvergent și alte gadgeturi stilate, de ultimă generație pentru stocarea volumelor VM, considerând că cu cât sistemul este mai simplu, cu atât este mai ușor de depanat în condițiile în care "guru-ul principal a plecat la munte". Astfel, stocăm volumele VM în format QCOW2 pe XFS sau EXT4, care sunt instalate deasupra LVM2.
Utilizarea QCOW2 este dictată de produsul pe care îl folosim pentru orchestrare - Apache CloudStack.
Pentru a efectua backup-uri, realizăm o imagine completă a volumului, sub formă de snapshot LVM2 (da, știm că snapshot-urile LVM2 pot fi lente, dar Intel P4500 ne ajută și în acest sens). Facem lvmcreate -s .. și cu ajutorul dd trimitem backup-ul pe un server extern cu stocare ZFS. Aici suntem totuși puțin progresivi - ZFS poate stoca datele comprimate, iar noi putem să le recuperăm rapid folosind DD sau să extragem volumele VM individuale folosind mount -o loop ....
Desigur, putem realiza și o imagine necompletă a volumului LVM2, montând sistemul de fișiere în mod
ROși să copiem imaginile QCOW2 în sine, totuși, ne-am confruntat cu probleme, deoarece XFS devenea instabil, iar efectele nu erau imediate, ci imposibil de prognozat. Nu ne place deloc când hyper-vizorii "rămân blocați" brusc în weekenduri, noaptea sau de sărbători din cauza unor erroare care nu se știe când vor apărea. Prin urmare, pentru XFS nu folosim montarea instantaneelor în modulROde extragere a volumelor, ci pur și simplu copiem întregul volum LVM2.
Viteza de backup pe serverul de backup este determinată în cazul nostru de performanța serverului de backup, care este de aproximativ 600-800 MB/s pentru datele necompresibile, iar următorul limitator este canalul de 10Gbit/s, prin care serverul de backup este conectat la cluster.
În același timp, pe un singur server de backup se încarcă simultan backup-urile de la 8 servere hyper-vizori. Astfel, subsistemele de disc și rețea ale serverului de backup, fiind mai lente, nu permit suprasolicitarea subsistemelor de disc ale hyper-vizorilor, deoarece pur și simplu nu pot procesa, de exemplu, 8 GB/s, pe care hyper-vizorii le pot livra fără efort.
Procesul de copiere descris anterior este foarte important pentru povestea care urmează, incluzând detalii — utilizarea unui dispozitiv de stocare rapid Intel P4500, utilizarea NFS și, probabil, utilizarea ZFS.
Povestea despre backup
Pe fiecare nod hyper-vizor avem o mică partiție SWAP de 8 GB, iar nodul hyper-vizor este "desfășurat" folosind DD imaginea de referință. Pentru volumul de sistem pe servere folosim 2xSATA SSD RAID1 sau 2xSAS HDD RAID1 pe un controler hardware LSI sau HP. În general, nu ne pasă ce este acolo în interior, deoarece volumul de sistem funcționează în modul "aproape readonly", cu excepția SWAP-ului. Și, deoarece avem foarte mult RAM pe server și acesta este liber cu 30-40%, nu ne gândim la SWAP.
Procesul de creare a backup-ului. Această sarcină arată cam așa:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Rețineți că ionice -c3, de fapt, acest lucru este complet inutil pentru dispozitivele NVMe, deoarece planificatorul IO pentru acestea este configurat ca:
cat /sys/block/nvme0n1/queue/scheduler
[none]
Cu toate acestea, avem mai multe noduri legacy cu RAID-uri SSD obișnuite, pentru care este relevant, astfel încât se mută AS IS. În general, acesta este doar un fragment interesant de cod care explică inutilitatea ionice în cazul unei astfel de configurații.
Atenție la flag iflag=direct pentru DD. Folosim direct IO ocolind cache-ul buffer-ului, pentru a evita înlocuirea inutilă a buffer-elor IO în timpul citirii. Cu toate acestea, oflag=direct nu facem acest lucru, deoarece am întâmpinat probleme de performanță cu ZFS în utilizarea sa.
Această schemă este utilizată cu succes de noi de câțiva ani fără probleme.
Și aici a început… Am descoperit că pentru unul dintre noduri backup-ul a încetat să se execute, iar backup-ul anterior a fost realizat cu un IOWAIT monstruos de 50%. Când am încercat să înțelegem de ce backup-ul nu se efectuează, ne-am confruntat cu fenomenul:
Volume group "images" not foundAm început să ne gândim la "sfârșitul a venit pentru Intel P4500", totuși, înainte de a opri serverul pentru a schimba unitatea de stocare, a fost necesar totuși să realizăm backup-ul. Am reparat LVM2 cu ajutorul restaurării metadatelor din backup-ul LVM2:
vgcfgrestore imagesAm lansat backup-ul și am văzut această imagine:
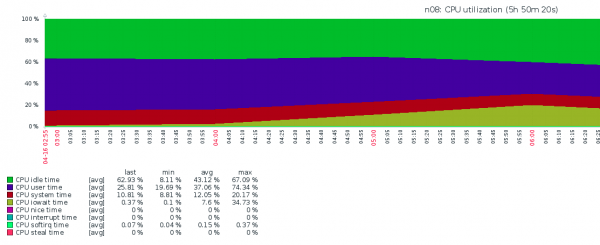
Din nou, am fost foarte triști — era clar că nu putem continua astfel, deoarece toate VPS-urile vor suferi, ceea ce înseamnă că vom suferi și noi. Ce se întâmpla, era complet neclar — iostat afișa IOPS-uri jalnice și un IOWAIT extrem de ridicat. Nu aveam alte idei, în afară de "hai să înlocuim NVMe", dar a venit o iluminare la timp.
Analiza situației pas cu pas
Jurnalul istoric. Cu câteva zile înainte, pe acest server a fost necesar să creăm un VPS mare cu 128 GB RAM. Memoria părea suficientă, dar pentru siguranță am alocat încă 32 GB pentru swap. VPS-ul a fost creat, a rezolvat cu succes sarcina sa și incidentul a fost uitat, iar partția SWAP a rămas.
Particularitățile configurației. pentru toți serverii din cloud, parametrul vm.swappiness a fost setat la valoarea implicită 60. Iar SWAP-ul a fost creat pe SAS HDD RAID1.
Ce se întâmpla (în opinia redacției). La backup, DD a produs multe date pentru scriere, care erau stocate în buffer-e RAM înainte de a fi scrise în NFS. Kernelul sistemului, ghidat de politica swappiness, muta multe pagini de memorie VPS în zona de swap, care se afla pe volumul lent HDD RAID1. Aceasta a dus la o creștere foarte mare a IOWAIT-ului, dar nu din cauza IO NVMe, ci din cauza IO HDD RAID1.
Cum a fost rezolvată problema. A fost dezactivată partția de swap de 32GB. A durat 16 ore, despre cum și de ce se dezactivează swap-ul atât de lent, se poate citi separat. Au fost modificate parametrii swappiness la o valoare egală cu 5 în întregul cloud.
Cum ar fi putut să nu se întâmple astaÎn primul rând, dacă SWAP ar fi fost pe un SSD RAID sau pe un dispozitiv NVMe; în al doilea rând, dacă nu ar fi existat un dispozitiv NVMe, ci un dispozitiv mai lent care nu ar fi putut furniza un volum atât de mare de date — ironic, problema a apărut tocmai din cauza că NVMe este prea rapid.
După aceasta, totul a început să funcționeze ca înainte — fără IOWAIT.
Sursa: habr.com
