

Salut tuturor. Dezvoltăm un produs pentru analiza traficului offline. În proiect există o sarcină legată de analiza statistică a căilor de mișcare a vizitatorilor între zone.
În cadrul acestei sarcini, utilizatorii pot face sistemului interogări de următoarele tipuri:
- câți vizitatori au trecut din zona "A" în zona "B";
- câți vizitatori au trecut din zona "A" în zona "B" prin zona "C" și apoi prin zona "D";
- cât timp a durat trecerea unui vizitator de un anumit tip din zona "A" în zona "B".
și o serie de interogări analitice similare.
Mișcarea vizitatorului între zone reprezintă un graf orientat. După ce am citit informații pe internet, am descoperit că bazele de date graf sunt folosite și pentru rapoarte analitice. Am avut dorința de a vedea cum se descurcă aceste baze de date graf cu astfel de interogări (TL;DR; slab).
Am ales să folosesc baza de date , ca un reprezentant remarcabil al bazelor de date graf open-source, care se bazează pe un stivă de tehnologii mature, care (în opinia mea) ar trebui să-i asigure caracteristici operaționale decente:
- backend-ul de stocare BerkeleyDB, Apache Cassandra, Scylla;
- indici complicați pot fi stocați în Lucene, Elasticsearch, Solr.
Autorii JanusGraph afirmă că acesta este potrivit atât pentru OLTP, cât și pentru OLAP.
Am lucrat cu BerkeleyDB, Apache Cassandra, Scylla și ES, de asemenea, aceste produse sunt adesea folosite în sistemele noastre, așa că am privit cu optimism testarea acestei baze de date graf. Mi s-a părut ciudat să aleg BerkeleyDB în loc de RocksDB, dar probabil că aceasta se leagă de cerințele pentru tranzacții. Oricum, pentru utilizarea scalabilă, de produs se recomandă utilizarea unui backend pe Cassandra sau Scylla.
Nu am considerat Neo4j, deoarece pentru clusterizare este necesară o versiune comercială, adică produsul nu este deschis.
Ce spun bazele de date graf: "Dacă ceva arată ca un graf — tratează-l ca pe un graf!" — minunat!
Mai întâi, am desenat un graf, care este realizat conform canonului bazelor de date graf:
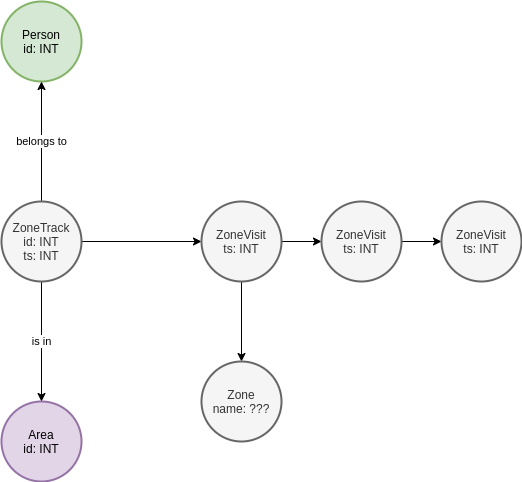
Există o entitate Zone, care răspunde de acest domeniu. Dacă ZoneStep aparține acesteia, atunci se referă la ea. La entitatea ZoneArea ZoneTrack, nu vă concentrați, aparțin domeniului și nu sunt considerate în cadrul testului. Așadar, pentru o astfel de structură grafică, interogarea pentru căutarea lanțurilor ar arăta ca:, Person atenție, nu le acordați atenție, ele aparțin domeniului și în cadrul testului nu sunt luate în considerare. Așadar, o interogare de căutare pentru o structură graf poate arăta astfel:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Ceea ce înseamnă în limba română este: găsește Zone cu ID=0, ia toate vârfurile de la care pornește o muchie (ZoneStep), mergi fără a te întoarce până găsești ZoneStep-uri din care merge o muchie către Zone cu ID=19, numără câte astfel de lanțuri sunt.
Nu pretind că cunosc toate subtilitățile căutării în grafuri, dar această interogare a fost generată pe baza acestei cărți ().
Am încărcat 50.000 de piese cu lungimi de la 3 la 20 de puncte în baza de date grafică JanusGraph, folosind backend-ul BerkeleyDB, am creat indecși conform .
Script pentru încărcare în Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Am folosit o VM cu 4 nuclee și 16 GB RAM pe SSD. JanusGraph a fost implementat cu această comandă:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestÎn acest caz, datele și indecșii care sunt utilizați pentru căutarea prin potrivire exactă sunt stocate în BerkeleyDB. După ce am executat interogarea menționată anterior, am obținut un timp egal cu câteva zeci de secunde.
Rulând cele 4 scripturi menționate anterior în paralel, am reușit să transform baza de date într-o dovleac cu un flux vesel de stive de erori Java (iar noi toți iubim să citim stive de erori Java) în jurnalele Docker.
Reflectând, am decis să simplific schema graficului la următoarea:
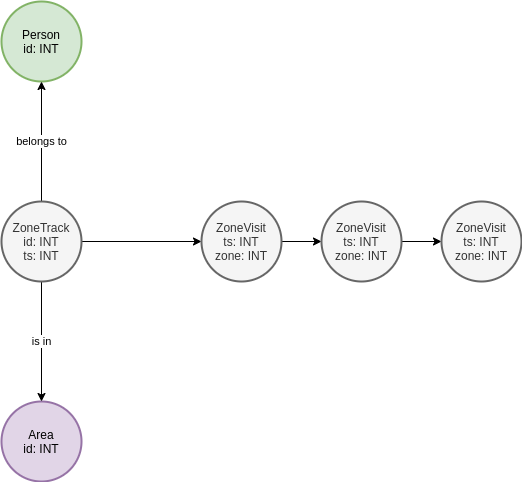
Considerând că căutarea după atributele entității va fi mai rapidă decât căutarea după muchii. Ca urmare, interogarea mea a devenit următoarea:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Ce înseamnă în limba română este: găsește ZoneStep cu ID=0, mergi fără a te întoarce până găsești ZoneStep cu ID=19, numără câte astfel de lanțuri sunt.
De asemenea, am simplificat scriptul de încărcare menționat mai sus, pentru a nu crea legături suplimentare, limitându-mă la atribute.
Interogarea a fost încă în execuție câteva secunde, ceea ce era complet inacceptabil pentru sarcina noastră, deoarece pentru scopurile interogărilor AdHoc de tip arbitrar, aceasta era complet inadecvată.
Am încercat să desfășor JanusGraph folosind Scylla, cea mai rapidă implementare a Cassandra, dar acest lucru nu a dus la modificări semnificative de performanță.
Astfel, deși "arată ca un grafic", nu am reușit să fac sistemul de gestionare a bazelor de date grafice să funcționeze rapid. Presupun că îmi scapă ceva și ar putea exista o modalitate de a face JanusGraph să efectueze această căutare în câteva fracțiuni de secundă, însă nu am reușit.
Având în vedere că trebuia oricum să rezolvăm problema, am început să mă gândesc la JOIN-uri și pivoturi de tabele, ceea ce nu inspira optimism din punct de vedere al eleganței, dar putea fi o opțiune viabilă în practică.
În proiectul nostru deja folosim Apache ClickHouse, așa că am decis să verific rezultatele studiilor mele pe această bază de date analitică.
Am desfășurat ClickHouse conform unei rețete simple:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Am creat o bază de date și un tabel de tipul:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
L-am umplut cu date folosind următorul script:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Deoarece inserțiile sunt efectuate în loturi, umplerea a fost mult mai rapidă decât pentru JanusGraph.
Am construit două interogări folosind JOIN. Pentru a trece din punctul A în punctul B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Pentru a face tranziția prin 3 puncte:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
Întrebările, desigur, arată destul de înfricoșător, pentru utilizarea reală este necesar să se facă un wrapper-generator. Cu toate acestea, ele funcționează și funcționează rapid. Atât prima, cât și a doua interogare se execută în mai puțin de 0.1 sec. Iată un exemplu de timp de execuție pentru count(*) pe 3 puncte:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 rows in set. Elapsed: 0.068 sec. Processed 250.03 thousand rows, 8.00 MB (3.69 million rows/s., 117.98 MB/s.)Observație despre IOPS. Când datele au fost completate, JanusGraph a generat un număr destul de mare de IOPS (1000-1300 pentru patru fire de executare a datelor), iar IOWAIT a fost destul de ridicat. În același timp, ClickHouse a generat o încărcare minimă asupra subsistemului de disc.
Concluzie
Am decis să folosim ClickHouse pentru a deservi interogările de acest tip. Întotdeauna putem optimiza și mai mult interogările folosind vizualizări materializate și paralelizare, efectuând preprocesarea fluxului de evenimente folosind Apache Flink înainte de a le încărca în ClickHouse.
Performanța este atât de bună, încât probabil nu va trebui să ne mai gândim la pivotarea tabelului prin metode programatice. Anterior, a fost necesar să facem pivoturi ale datelor extrase din Vertica prin export în Apache Parquet.
Din păcate, o altă încercare de a folosi o bază de date grafică nu a avut succes. Nu am descoperit că JanusGraph are un ecosistem prietenos care permite o familiarizare rapidă cu produsul. În același timp, configurația serverului urmează tradiționalul mod Java, care îi va face pe cei neexperimentați cu Java să plângă lacrimi de sânge:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary este aici pentru a înlocui Gryo și Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo și Graphson, versiunile cele mai recente
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Versiuni de serializare mai vechi pentru compatibilitate inversă:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Am reușit din întâmplare să "pun" BerkeleyDB versiunea JanusGraph.
Documentația este destul de complexă în ceea ce privește indexurile, deoarece gestionarea indexurilor necesită executarea unor manevre mai neobișnuite în Groovy. De exemplu, crearea unui index trebuie realizată prin scrierea de cod în consola Gremlin (care, de altfel, nu funcționează imediat). Din documentația oficială JanusGraph:
graph.tx().rollback() \/\/Nu creați noi indexuri în timp ce o tranzacție este activă
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

\/\/Așteptați ca indexul să devină disponibil
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
\/\/Reindexați datele existente
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Cuvânt înainte
Într-un anumit sens, experimentul de mai sus este ca o comparație între mere și pere. Dacă ne gândim bine, baza de date grafică execută operații diferite pentru a obține aceleași rezultate. Totuși, în cadrul testelor am realizat și un experiment cu o interogare de tip:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
, care reflectă accesibilitatea pas cu pas. Cu toate acestea, și pe astfel de date, baza de date grafică a arătat un rezultat care depășea câteva secunde... Acest lucru este, desigur, legat de faptul că existau căi de tipul 0 -> X -> Y ... -> 1, pe care motorul grafic le verifica de asemenea.
Chiar și pentru o interogare de tip:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()nu am reușit să obțin un răspuns eficient cu un timp de procesare mai mic de o secundă.
Morala acestei povești este că o idee frumoasă și un model paradigmativ nu conduc la rezultatul dorit, care este demonstrat cu o eficiență semnificativ mai mare în cazul ClickHouse. Opțiunea de utilizare prezentată în acest articol este un antipatent evident pentru bazele de date grafice, deși pare un mod potrivit pentru modelarea în paradigma lor.
Sursa: habr.com
