

O să explic imediat titlul articolului. Inițial, s-a planificat să ofer un sfat bun și de încredere despre accelerarea utilizării reflecției pe un exemplu simplu, dar realist, însă în timpul benchmarking-ului s-a dovedit că reflecția nu funcționează atât de lent pe cât am crezut, iar LINQ este mult mai lent decât am visat în coșmaruri. În final, s-a dovedit că am comis și o eroare în măsurători... Detalii despre această poveste de viață mai jos și în comentarii. Deoarece exemplul este destul de obișnuit și implementat în principiu așa cum se face de obicei în mediul enterprise, a rezultat o demonstrație interesantă, din punctul meu de vedere: influența asupra vitezei de lucru a subiectului principal al articolului nu a fost observată din cauza logicii externe: Moq, Autofac, EF Core și alte „înfășurări”.
Am început lucrul impresionat de acest articol:
După cum se vede, autorul sugerează utilizarea delegatelor precompilate în locul apelurilor directe la metodele tipurilor de reflecție ca o excelentă modalitate de a accelera semnificativ aplicația. Există acolo, desigur, și emisia IL, dar aș dori să o evit, deoarece este cea mai muncitoare modalitate de a rezolva sarcina, care vine la pachet cu erori.
Având în vedere că am avut mereu o opinie similară despre viteza reflecției, nu aveam de gând să contest concluziile autorului.
Mă întâlnesc adesea cu utilizarea naivă a reflecției în mediul enterprise. Se ia un tip. Se ia informația despre proprietate. Se apelează metoda SetValue și toată lumea se bucură. Valoarea a ajuns în câmpul țintă, toți sunt mulțumiți. Oamenii sunt destul de inteligenți - seniori și team lead-uri - își scriu extensiile pe object, bazându-se pe o implementare naivă a „mapperilor universali” de un tip în altul. Esența este de obicei: luăm toate câmpurile, luăm toate proprietățile, iterează peste ele: în caz de coincidență a numelui membrilor tipului, executăm SetValue. Perioadele în care prindem excepții din nume greșite, unde nu am găsit o proprietate la unul dintre tipuri, dar și aici există o soluție care aduce o performanță mai bună. Try/catch.
Am văzut cum oamenii reinventeză parsere și mappere, fără a avea toate informațiile despre cum funcționează bicicletele inventate înaintea lor. Am văzut cum oamenii își ascund implementările naive în spatele strategiilor, interfețelor și injecțiilor, de parcă acest lucru ar justifica ulterior haosul. Mă întorceam cu dispreț de la astfel de implementări. De fapt, nu am măsurat nicio scurgere de performanță reală și, ori de câte ori era posibil, am schimbat pur și simplu implementarea cu una mai „optimă”, dacă reușeam. Așadar, primele măsurători de care urmează să vorbesc m-au deranjat profund.
Cred că mulți dintre voi, citind pe Richter sau alți ideologi, v-ați întâlnit cu afirmația destul de justă că reflecția în cod este un fenomen care afectează extrem de negativ performanța aplicației.
Apelul la reflecție obligă CLR să parcurgă asamblările pentru a căuta ceea ce este necesar, să tragă metadatele acestora, să le parseze etc. În plus, reflecția în timpul parcurgerii secvențelor conduce la alocarea unei cantități mari de memorie. Consumând memorie, CLR declanșează GCe-ul și astfel apar întreruperi. Acest proces ar trebui să fie notabil de lent, credeți-mă. Cantități enorme de memorie ale serverelor moderne de producție sau ale mașinilor cloud nu ne salvează de întârzieri mari în procesare. De fapt, cu cât mai multă memorie, cu atât mai mare este probabilitatea să observați cum funcționează GCe-ul. Reflexia este, în teorie, o acea batistă roșie suplimentară pentru acesta.
Cu toate acestea, toți folosim atât containere IoC, cât și date mappere, principii de funcționare care se bazează de asemenea pe reflecție, totuși, rareori există întrebări legate de performanța lor. Nu, nu pentru că implementarea dependențelor și abstractizarea de modelele unui context extern limitat sunt lucruri atât de necesare încât suntem nevoiți să sacrificăm performanța în orice caz. Este mult mai simplu – acest lucru nu afectează în mod semnificativ performanța.
Problema este că cele mai comune cadre care se bazează pe tehnologia reflexiei utilizează diverse trucuri pentru a funcționa mai optim cu aceasta. De obicei, este vorba despre cache. De obicei – sunt Expressions și delegați compilați dintr-un arbore de expresii. Același automapper are în spate un dicționar concurent, care corelează tipurile cu funcțiile care pot converti un tip în altul fără a apela la reflecție.
Cum se realizează acest lucru? Practic, nu diferă de logica pe care plataforma însăși o folosește pentru generarea codului JIT. La prima apelare a metodei, aceasta este compilată (și, da, acest proces nu este rapid), iar la apelurile următoare, controlul este transferat metodei deja compilate, iar în acest caz nu vor exista scăderi semnificative ale performanței.
În cazul nostru, putem folosi de asemenea compilarea JIT și apoi să utilizăm comportamentul compilat având aceeași performanță ca și omologii săi AOT. În acest caz, expresiile ne vor fi de ajutor.
Principiul de care vorbim poate fi formulat succint astfel:
Trebuie să stocăm rezultatul final al funcției de reflecție sub formă de delegat care conține funcția compilată. De asemenea, are sens să stocăm în domeniile obiectelor de tip – worker toate obiectele necesare cu informații despre tipuri.
Logica în acest lucru există. Bunul simț ne spune că, dacă ceva poate fi compilat și stocat, ar trebui să facem acest lucru.
Înaintând, trebuie să menționez că stocarea în cache în lucrul cu reflecția are propriile sale avantaje, chiar și fără a folosi metoda propusă de compilare a expresiilor. De fapt, aici voi repeta tezele autorului articolului la care fac referire mai sus.
Acum, despre cod. Să luăm un exemplu bazat pe durerea mea recentă, cu care a trebuit să mă confrunt într-o producție serioasă a unei organizații de credit. Toate entitățile sunt ficționale, pentru a nu face pe nimeni să suspecteze.
Există o anumită entitate. Să o numim Contact. Există scrisori cu un conținut standardizat, din care parserul și hidratatorul creează aceste contacte. A venit o scrisoare, am citit-o, am descompus-o în perechi cheie-valoare, am creat un contact și l-am salvat în baza de date.
Este elementar. Să presupunem că contactul are proprietățile Nume, Vârstă și număr de telefon. Aceste date sunt transmise în scrisoare. De asemenea, afacerea dorește ca personalul de suport să poată adăuga rapid noi chei pentru maparea proprietăților entității pe perechile din conținutul scrisorii. Pentru cazul în care cineva a greșit în șablon sau dacă trebuie să lansăm rapid mapping-ul pentru un nou partener înainte de lansare, adaptându-ne la un nou format. Astfel, vom putea adăuga o nouă corelație de mapping ca un datafix ieftin. Adică, un exemplu din viață.
Implementăm, creăm teste. Funcționează.
Nu voi prezenta codul: sursele sunt prea multe și sunt disponibile pe GitHub la sfârșitul articolului. Le puteți descărca, modifica până la neagră și măsura cum ar reflecta în cazul dumneavoastră. Voi prezenta doar codul a două metode șablon, prin care se diferă hidrantul, care ar trebui să fie rapid de cel care ar trebui să fie lent.
Logica este următoarea: metoda șablon primește perechi formate de logica de bază a parser-ului. Nivelul LINQ reprezintă parser-ul și logica de bază a hidrantului, care face o interogare în contextul bazei de date și asociază cheile cu perechile de la parser (pentru aceste funcții există cod fără LINQ pentru comparare). Apoi, perechile sunt transmise în metoda principală de hidratare, iar valorile sunt setate în proprietățile corespunzătoare ale entității.
„Rapid” (Prefixul Fast în benchmark-uri):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
După cum vedem, se utilizează o colecție statică cu setteri de proprietăți – lambda compilate, care invocă settere ale entității. Ele sunt create cu următorul cod:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
În general este clar. Parcurgem proprietățile, creăm delegate pe baza acestora, invocăm settere, le păstrăm. Apoi le apelăm când este necesar.
„Lent” (Prefixul Slow în benchmark-uri):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Aici parcurgem imediat proprietățile și apelăm direct SetValue.
Pentru claritate și ca exempă, am implementat o metodă naive care scrie valorile perechilor de corelație direct în câmpurile entității. Prefixul – Manual.
Acum luăm BenchmarkDotNet și investigăm performanța. Și brusc… (spoiler – acesta nu este rezultatul corect, detalii – mai jos)
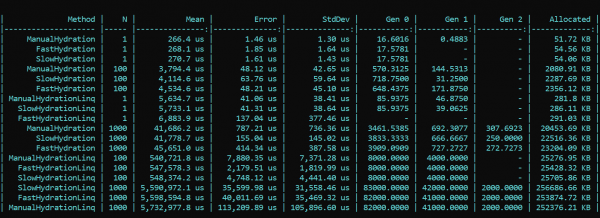
Ce vedem aici? Metodele, care poartă cu mândrie prefixul Fast, se dovedesc aproape mereu mai lente decât metodele cu prefixul Slow. Aceasta este valabil atât pentru alocare, cât și pentru viteza de execuție. Pe de altă parte, implementarea elegantă a mapării folosind metodele LINQ dedicate, acolo unde este posibil, consumă semnificativ mai multă performanță. Diferența este de ordinul. Tendința nu se schimbă cu numărul diferit de treceri. Diferența este doar în scale. Cu LINQ, este de 4 – 200 de ori mai lent, iar gunoiul se acumulează în aceleași scale aproximativ.
ACTUALIZAT
Nu mi-am putut crede ochii, dar, ceea ce este mai important, nici colegul nostru nu a crezut în ochii mei sau în codul meu — . Reanalizând soluția mea, el a descoperit și a semnalat superb o eroare pe care din cauza mai multor modificări în implementare, am omis-o de la început la final. După repararea erorii găsite în configurarea Moq, toate rezultatele s-au așezat la locul lor. Ca rezultat al retestului, tendința principală nu se schimbă — LINQ influențează în continuare performanța mai mult decât reflexia. Cu toate acestea, este plăcut că lucrul cu compilarea expresiilor se dovedește a fi nu în zadar, și rezultatul este vizibil atât în alocare, cât și în timpul de execuție. Prima rulare, când se inițializează câmpurile statice, este în mod evident mai lentă la metoda „rapidă”, dar pe măsură ce avansează, situația se schimbă.
Iată rezultatul retestului:
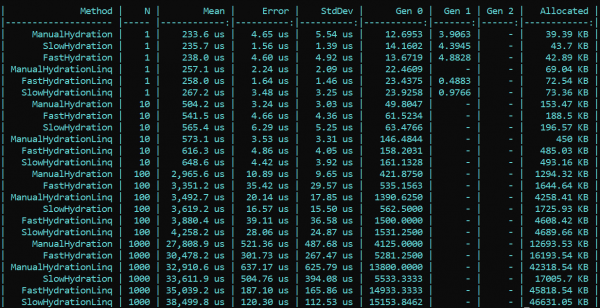
Concluzie: atunci când se utilizează reflexia în mediul enterprise, nu este necesar să recurgem la subterfugii — LINQ va consuma performanța mai puternic. Totuși, în metodele cu solicitări mari, care necesită optimizare, se poate păstra reflexia sub formă de inițializatori și compilatori de delegați, care vor asigura ulterior logica „rapidă”. Astfel, puteți păstra atât flexibilitatea reflexiei, cât și viteza de execuție a aplicației.
Codul cu benchmark este disponibil aici. Toți doritorii pot verifica afirmațiile mele:
PS: codul din teste utilizează IoC, iar în benchmark-uri – o construcție explicită. Problema este că în implementarea finală am eliminat toate factorii care ar putea influența performanța și ar putea distorsiona rezultatul.
PPS: Mersi utilizatorului pentru identificarea greșelii mele în configurarea Moq, care a afectat primele măsurători. Dacă cineva dintre cititori are suficientă karma, vă rog să îi dați un like. Omul s-a oprit, s-a concentrat, a verificat și a semnalat greșeala. Cred că asta merită respect și apreciere.
PPPS: mulțumesc cititorului atent care a comentat stilul și formatarea. Eu susțin uniformitatea și confortul. Diplomatismul prezentării poate fi îmbunătățit, dar am luat în considerare critica. Vă rog, haideți să ne axăm pe subiect.
Sursa: habr.com
