

Salut, Habr!
Îți place să zbori cu avionul? Îmi place enorm, dar în perioada de autoizolare am început să analizez și datele despre biletele de avion de pe o platformă bine cunoscută – Aviasales.
Astăzi vom analiza funcționarea Amazon Kinesis, vom construi un sistem de streaming cu analitică în timp real, vom configura o bază de date NoSQL Amazon DynamoDB ca principală sursă de date și vom seta notificări prin SMS pentru biletele interesante.
Toate detaliile mai jos! Să începem!
Introducere
Pentru exemplu, avem nevoie de acces la . Accesul la acesta este gratuit și fără restricții, trebuie doar să te înscrii în secțiunea „Dezvoltatori” pentru a obține tokenul API pentru accesul la date.
Scopul principal al acestui articol este de a oferi o înțelegere generală a utilizării transmiterii de informații în AWS; ne abținem de la a menționa că datele returnate de API-ul folosit nu sunt strict actualizate și sunt transmise din cache, care este format pe baza căutărilor utilizatorilor de pe site-urile Aviasales.ru și Jetradar.com în ultimele 48 de ore.
Datele despre biletele de avion obținute prin API vor fi automat analizate și transmise în fluxul necesar prin Kinesis Data Analytics de către Kinesis-agent, instalat pe mașina producătoare. Versiunea neprocesată a acestui flux va fi scrisă direct în depozit. Depozitul de date „neprocesate” desfășurat în DynamoDB va permite o analiză mai profundă a biletelor prin instrumente BI, de exemplu, AWS Quick Sight.
Vom examina două opțiuni pentru implementarea întregii infrastructuri:
- Manual – prin AWS Management Console;
- Infrastructura din cod Terraform – pentru automatizatorii leneși;
Arhitectura sistemului dezvoltat
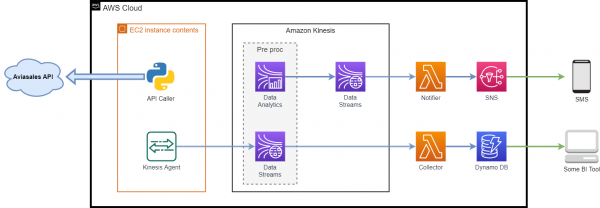
Componentele utilizate:
- – datele returnate de acest API vor fi folosite pentru întreaga activitate ulterioară;
- – o mașină virtuală obișnuită în cloud, pe care se va genera fluxul de date de intrare:
- – este o aplicație Java, instalată local pe mașină, care oferă o modalitate simplă de a colecta și trimite date în Kinesis (Kinesis Data Streams sau Kinesis Firehose). Agentul monitorizează constant un set de fișiere din directoarele specificate și trimite datele noi în Kinesis;
- – un script Python care face cereri către API și salvează răspunsul într-un folder pe care îl monitorizează Kinesis Agent;
- – un serviciu de transmitere a datelor în timp real, cu capabilități extinse de scalare;
- — un serviciu fără server care simplifică analiza datelor de flux în timp real. Amazon Kinesis Data Analytics configurează resursele pentru a rula aplicațiile și se scalează automat pentru a gestiona orice volum de date de intrare;
- — un serviciu care permite executarea codului fără a rezerva și configura servere. Toate resursele de calcul se scalează automat pentru fiecare apel;
- — o bază de date de tip „cheie-valoare” și documente, care oferă o întârziere mai mică de 10 milisecunde funcționând la orice scală. Când se utilizează DynamoDB, nu trebuie să distribuiți servere, să le aplicați patch-uri sau să le gestionați. DynamoDB scalează automat tabelele, ajustând volumul resurselor disponibile și menținând o performanță înaltă. Nu sunt necesare acțiuni de administrare a sistemului;
- — un serviciu complet gestionat de trimitere a mesajelor pe baza modelului „pub-/sub”, care permite izolarea microserviciilor, sistemelor distribuite și aplicațiilor fără server. SNS poate fi folosit pentru a trimite informații utilizatorilor finali prin notificări push mobile, mesaje SMS și e-mailuri.
Pregătirea inițială
Pentru a emula un flux de date, am decis să folosesc informațiile despre biletele de avion returnate de API-ul Aviasales. În o listă destul de extinsă de metode diferite, haideți să luăm una dintre ele — „Calendarul prețurilor pentru lună”, care returnează prețurile pentru fiecare zi a lunii, grupate după numărul de escale. Dacă nu se trimite în cerere luna de căutare, se vor returna informațiile pentru luna următoare.
Așadar, ne înregistrăm, primim token-ul nostru.
Exemplul de cerere de mai jos:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIMetoda de mai sus de obținere a datelor de la API prin indicarea token-ului în cerere va funcționa, dar prefer să transmit token-ul de acces prin antet, așa că în scriptul api_caller.py vom folosi această metodă.
Exemplul de răspuns:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
În exemplul de răspuns al API-ului de mai sus este prezentat un bilet din Sankt Petersburg către Phuket… Eh, ce să visezi...
Fiind din Kazan, iar Phuketul este acum „doar un vis pentru noi”, haideți să căutăm bilete din Sankt Petersburg în Kazan.
Se presupune că aveți deja un cont AWS. Vreau să subliniez de la început că Kinesis și trimiterea notificărilor prin SMS nu sunt incluse în oferta anuală. . Dar, chiar și așa, dacă aveți în minte câteva dolari, este posibil să construiți sistemul propus și să experimentați cu el. Și, desigur, nu uitați să ștergeți toate resursele după ce nu mai sunt necesare.
Din fericire, DynamoDb și funcțiile Lambda vor fi, pentru noi, condiționat gratuite, dacă ne încadram în limitele gratuite lunare. De exemplu, pentru DynamoDB: 25 GB de stocare, 25 WCU/RCU și 100 de milioane de interogări. Și un million de apeluri ale funcțiilor Lambda pe lună.
Implementarea manuală a sistemului
Configurarea Kinesis Data Streams
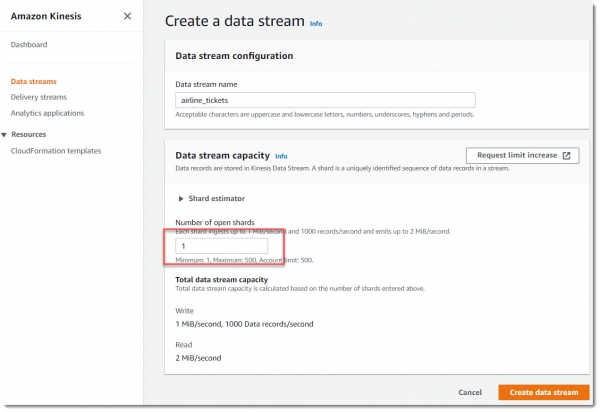
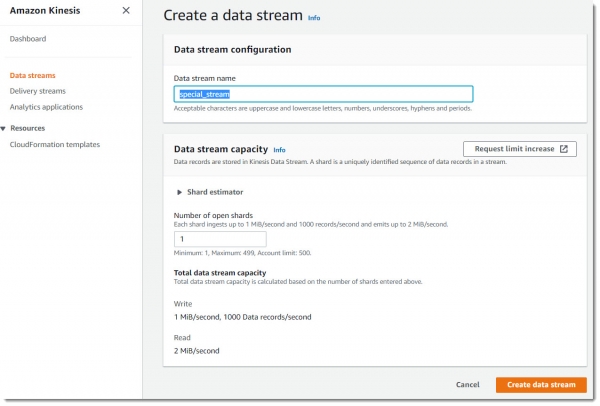
Să mergem la serviciul Kinesis Data Streams și să creăm două fluxuri noi cu câte un shard fiecare.
Ce este un shard?
Un shard este unitatea de bază pentru transferul de date în fluxul Amazon Kinesis. Un shard asigură transferul datelor de intrare cu o viteză de 1 MB/s și transferul datelor de ieșire cu o viteză de 2 MB/s. Un shard suportă până la 1000 de înregistrări PUT pe secundă. Atunci când creați un flux de date, trebuie să specificați numărul necesar de shards. De exemplu, puteți crea un flux de date cu două shards. Acest flux va asigura transferul datelor de intrare cu o viteză de 2 MB/s și transferul datelor de ieșire cu o viteză de 4 MB/s, suportând până la 2000 de înregistrări PUT pe secundă.
Cu cât aveți mai multe shards în fluxul vostru, cu atât capacitatea acestuia este mai mare. Practic, fluxurile se scalează prin adăugarea de shards. Dar cu cât aveți mai multe shards, cu atât costul este mai mare. Fiecare shard costă 1,5 cenți pe oră și suplimentar 1,4 cenți pentru fiecare milion de operațiuni de adăugare în flux (unități de încărcare PUT).
Să creăm un nou flux denumit airline_tickets, va fi suficient un shard:
Acum să creăm încă un flux denumit special_stream:
Configurarea producătorului
Ca și producător de date pentru această sarcină, se poate utiliza un simplu EC2 instance. Nu trebuie să fie o mașină virtuală puternică și costisitoare, un t2.micro pe spot va fi suficient.
Observație importantă: pentru exemplu, ar trebui folosit imaginea — Amazon Linux AMI 2018.03.0, deoarece aceasta necesită mai puține configurări pentru a lansa rapid Kinesis Agent.
Accesăm serviciul EC2, creăm o nouă mașină virtuală, alegem AMI-ul dorit cu tipul t2.micro, care face parte din Free Tier:
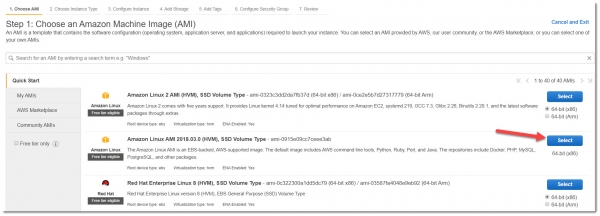
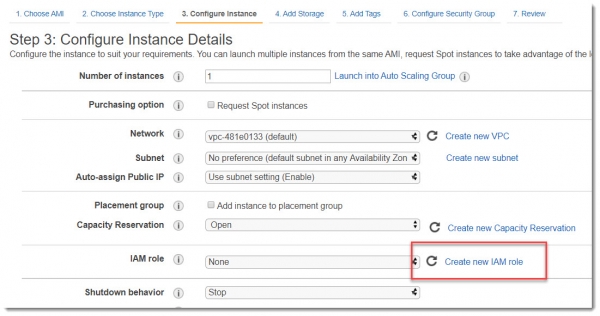
Pentru ca noua mașină virtuală să poată interacționa cu serviciul Kinesis, trebuie să îi acordăm permisiuni. Cea mai bună metodă de a face acest lucru este să atribuim un IAM Role. Așadar, pe ecranul Step 3: Configure Instance Details, trebuie să selectăm Creează un nou IAM Role:
Crearea unui IAM Role pentru EC2
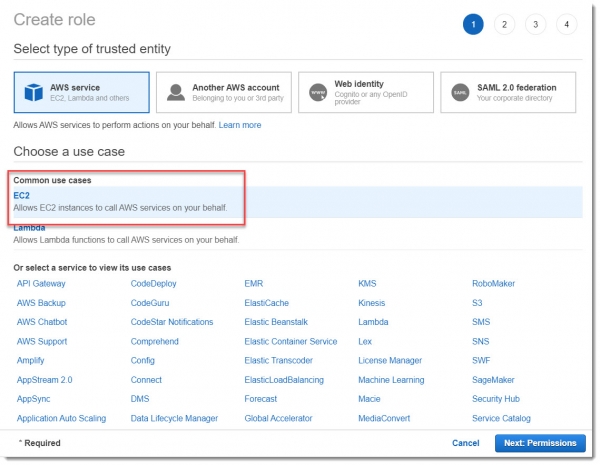
În fereastra deschisă, selectăm că noua rolă este destinat EC2 și ne deplasăm în secțiunea Permissions:
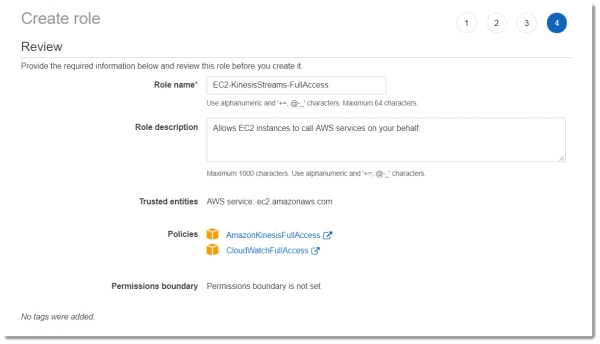
În exemplul didactic, nu este necesar să intrăm în toate detaliile fine ale configurării permisiunilor pentru resurse, așa că vom alege politicile prestabilite de Amazon: AmazonKinesisFullAccess și CloudWatchFullAccess.
Vom da un nume semnificativ pentru acest rol, de exemplu: EC2-KinesisStreams-FullAccess. Ca rezultat, ar trebui să obținem același lucru ca în imaginea de mai jos:
După ce am creat acest nou rol, nu uitați să-l atașați la instanța virtuală care este creată:
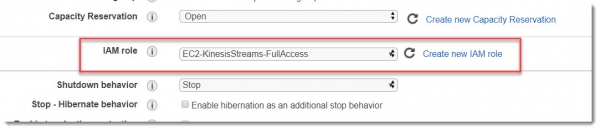
Nu modificăm nimic altceva pe acest ecran și trecem la ferontele următoare.
Parametrii discului pot fi lăsați pe setările implicite, etichetele de asemenea (deși, este o practică bună să folosești etichete, cel puțin pentru a da un nume instanței și a specifica mediu).
Acum suntem pe tab-ul Step 6: Configure Security Group, unde trebuie să creăm un nou sau să alegem unul existent de Sеcurity group, care permite conectarea prin SSH (portul 22) la instanță. Alegeți acolo Source -> My IP și puteți lansa instanța.
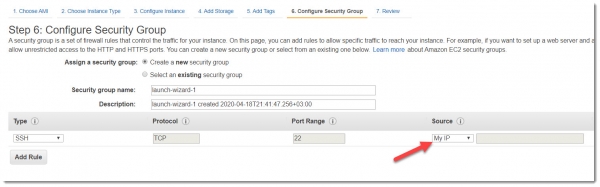
Odată ce aceasta trece în starea running, puteți încerca să vă conectați la ea prin SSH.
Pentru a avea posibilitatea de a lucra cu Kinesis Agent, după ce v-ați conectat cu succes la mașină, trebuie să introduceți următoarele comenzi în terminal:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Vom crea un dosar pentru a salva răspunsurile API:
sudo mkdir /var/log/airline_ticketsÎnainte de a lansa agentul, trebuie să-i configurăm fișierul de configurare:
sudo vim /etc/aws-kinesis/agent.jsonConținutul fișierului agent.json ar trebui să aibă următoarea structură:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
După cum se poate observa din fișierul de configurare, agentul va monitoriza în directorul /var/log/airline_tickets/ fișierele cu extensia .log, le va analiza și va trimite datele în fluxul airline_tickets.
Reporniți serviciul și asigurați-vă că acesta a fost pornit și funcționează:
sudo service aws-kinesis-agent restartAcum vom descărca scriptul Python care va solicita date de la API:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Scriptul api_caller.py solicită date de la Aviasales și salvează răspunsul obținut în directorul scanat de agentul Kinesis. Implementarea acestui script este destul de standardizată, există clasa TicketsApi care permite apeluri asyncrone la API. În această clasă trecem antetul cu tokenul și parametrii cererii:
class TicketsApi:
    """Clasa apelatoare API."""

    def __init__(self, headers):
        """Metodă de inițializare."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Obține datele din cererea API."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Starea răspunsului %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Ups! A apărut o eroare HTTP: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Ups! A apărut o eroare: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Returnează antetele și interogarea pentru cererea API."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Rulăm codul."""
    if len(sys.argv) != 2:
        print('Utilizare: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API a returnat %s articole', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s rânduri au fost salvate în %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Ups! Rezultatul cererii nu a fost salvat în fișier. %s',
                         str(e))
    else:
        LOGGER.error('Ups! Cererea API a fost nesuccessfulă %s!', response)
Pentru a verifica corectitudinea setărilor și funcționarea agentului, vom efectua o rulare de testare a scriptului api_caller.py:
sudo ./api_caller.py TOKEN 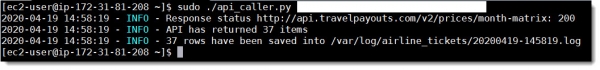
Și vedem rezultatul execuției în jurnalele Agentului și în tab-ul Monitoring în fluxul de date airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 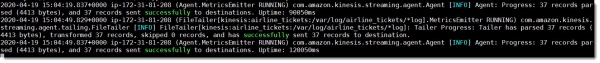
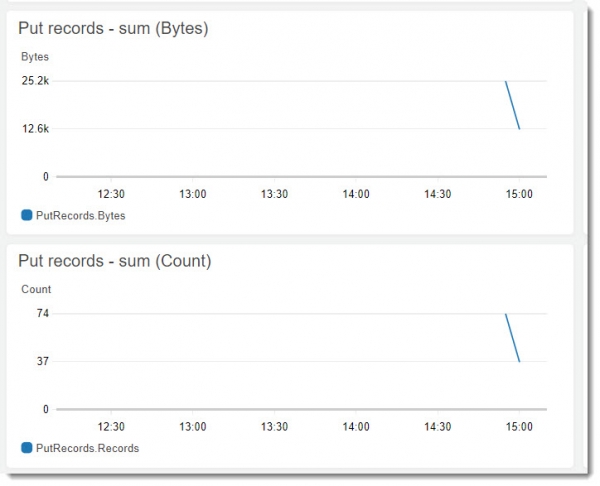
După cum se poate observa, totul funcționează și Kinesis Agent trimite cu succes date în flux. Acum să configurăm consumatorul.
Configurarea Kinesis Data Analytics
Să trecem la componenta centrală a întregului sistem — vom crea o nouă aplicație în Kinesis Data Analytics numită kinesis_analytics_airlines_app:
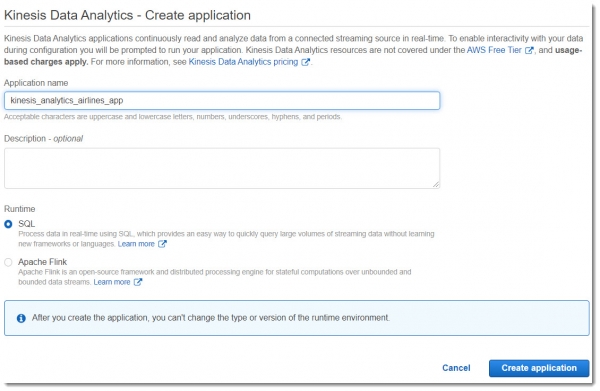
Kinesis Data Analytics permite analiza datelor în timp real din Kinesis Streams folosind limbajul SQL. Este un serviciu complet scalabil automat (spre deosebire de Kinesis Streams), care:
- permite crearea de fluxuri noi (Output Stream) pe baza interogărilor adresate datelor sursă;
- oferă un flux de erori care au apărut în timpul funcționării aplicațiilor (Error Stream);
- poate determina automat schema datelor de intrare (aceasta poate fi redefinită manual dacă este necesar).
Acesta nu este un serviciu ieftin — 0.11 USD pe oră de funcționare, așa că trebuie utilizat cu atenție și șters la finalizarea lucrului.
Să conectăm aplicația la sursa de date:
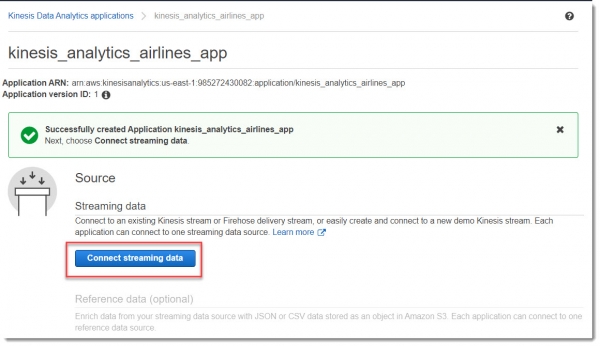
Selectăm fluxul la care dorim să ne conectăm (airline_tickets):
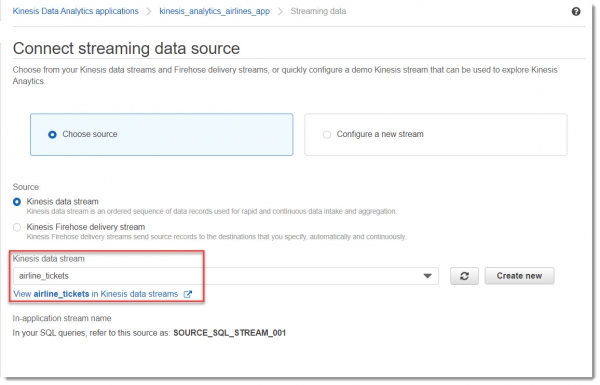
În continuare, trebuie să atașăm un nou rol IAM pentru ca aplicația să poată citi din flux și să scrie în flux. Pentru aceasta, nu trebuie să schimbăm nimic în blocul Permisiuni de acces:
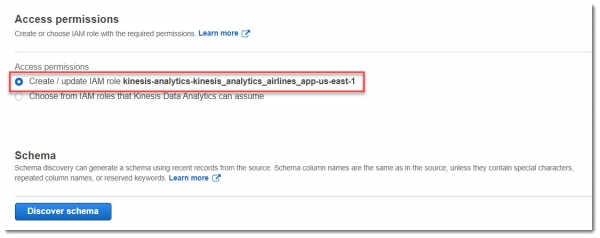
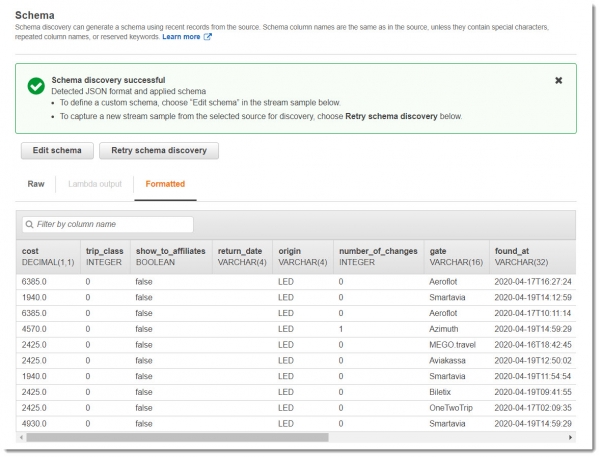
Acum să cerem descoperirea schemei de date în flux, pentru aceasta apăsăm butonul „Discover schema”. Ca rezultat, se va actualiza (se va crea un nou) rol IAM și va începe descoperirea schemei din datele care au ajuns deja în flux:
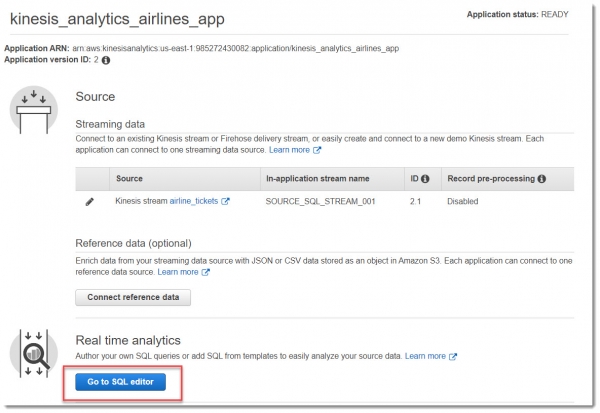
Acum trebuie să trecem la editorul SQL. Atunci când apăsăm pe acest buton, va apărea o fereastră cu întrebarea despre lansarea aplicației — alegem ce dorim să lansăm:
În fereastra editorului SQL, vom insera o interogare simplă și vom apăsa Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
În bazele de date relaționale, lucrați cu tabele, utilizând operatorii INSERT pentru a adăuga înregistrări și operatorul SELECT pentru a solicita date. În Amazon Kinesis Data Analytics, lucrați cu fluxuri (STREAM) și „pumpe” (PUMP) — interogări continue de inserare care introduc date dintr-un flux în aplicație în alt flux.
În interogarea SQL prezentată mai sus, se caută bilete Aeroflot cu un cost mai mic de cinci mii de ruble. Toate înregistrările care îndeplinesc aceste condiții vor fi plasate în fluxul DESTINATION_SQL_STREAM.
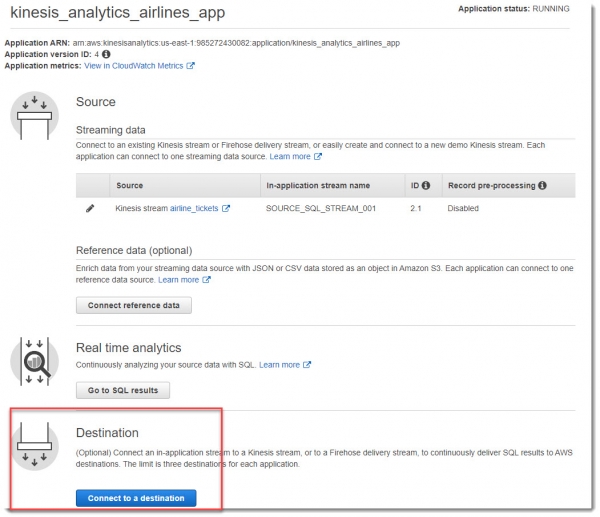
În secțiunea Destination, alegem fluxul special_stream, iar în lista derulantă In-application stream name DESTINATION_SQL_STREAM:
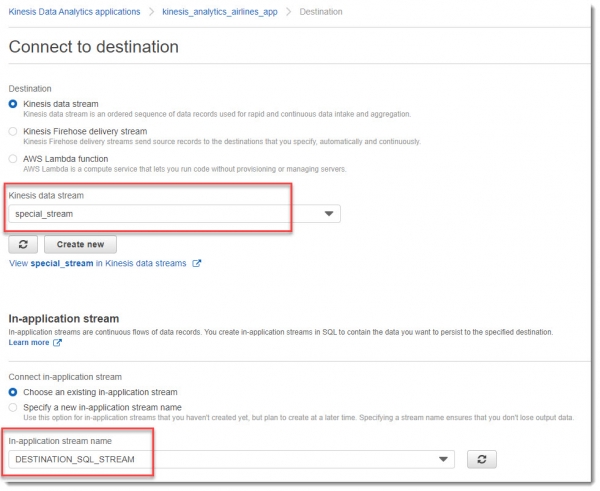
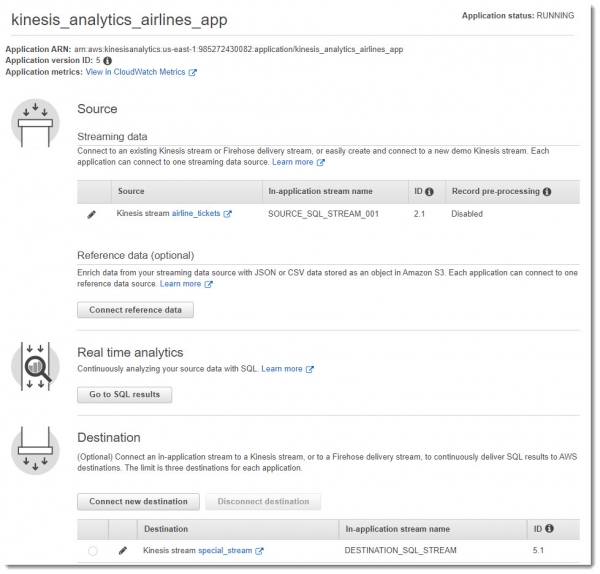
Ca rezultat al tuturor manevrelor, ar trebui să obținem ceva similar cu imaginea de mai jos:
Crearea și abonarea la un topic SNS
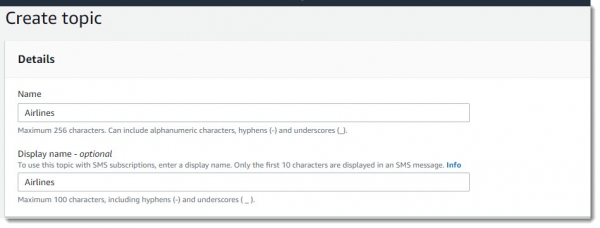
Accesăm serviciul Simple Notification Service și creăm un topic nou cu numele Airlines:
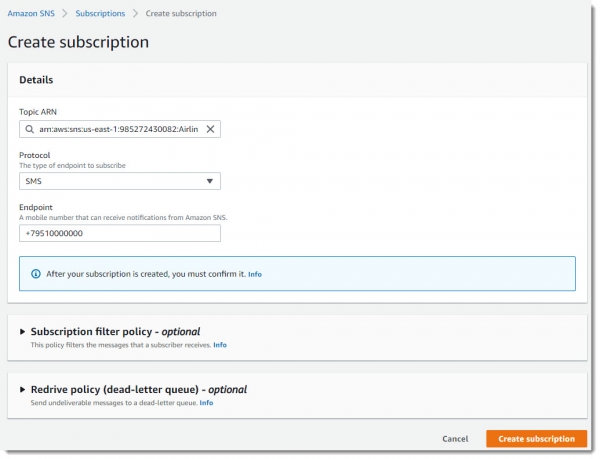
Facem abonamentul la acest topic, indicând numărul de telefon mobil la care vor sosi notificările SMS:
Crearea unui tabel în DynamoDB
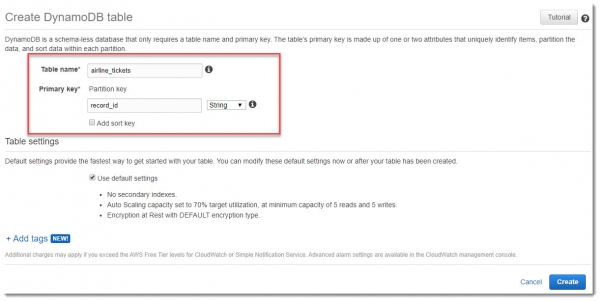
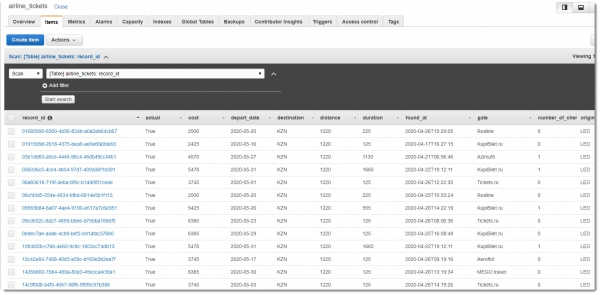
Pentru a stoca datele brute ale fluxului airline_tickets, vom crea un tabel în DynamoDB cu același nume. Ca și cheie primară, vom folosi record_id:
Crearea funcției lambda collector
Vom crea o funcție lambda numită Collector, ale cărei sarcini vor fi interogarea fluxului airline_tickets și, în cazul găsirii unor înregistrări noi, inserarea acestora în tabelul DynamoDB. Evident, pe lângă permisiunile implicite, această lambda trebuie să aibă acces la citirea fluxului de date Kinesis și la scrierea în DynamoDB.
Crearea rolului IAM pentru funcția lambda collector
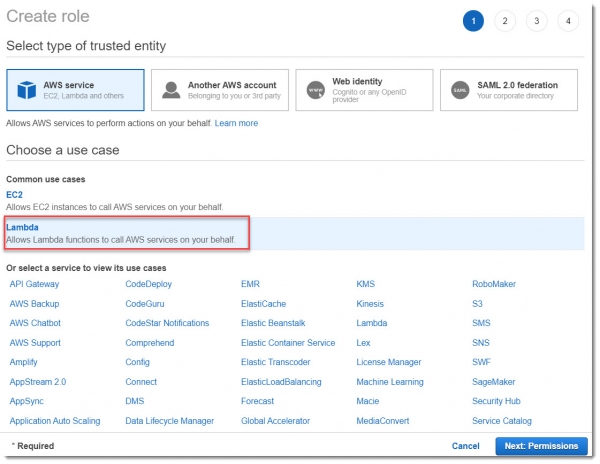
Pentru început, vom crea un nou rol IAM pentru lambda cu numele Lambda-TicketsProcessingRole:
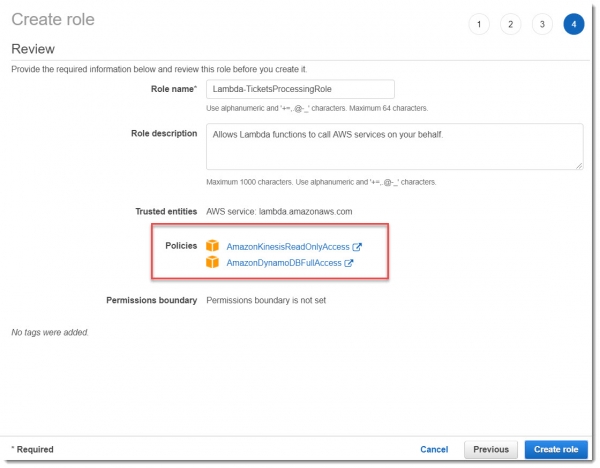
Pentru exemplul de testare, este suficient politicile preconfigurate AmazonKinesisReadOnlyAccess și AmazonDynamoDBFullAccess, așa cum este arătat în imaginea de mai jos:
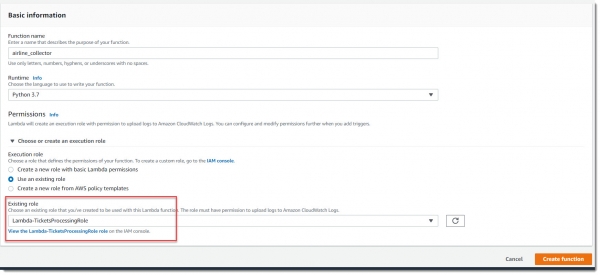
Această lambda trebuie să fie declanșată de Kinesis la primirea de noi înregistrări în fluxul airline_stream, așa că trebuie să adăugăm un nou declanșator:
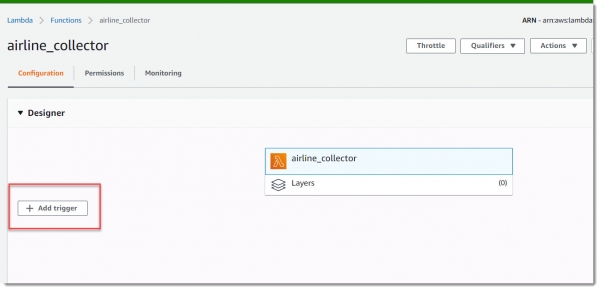
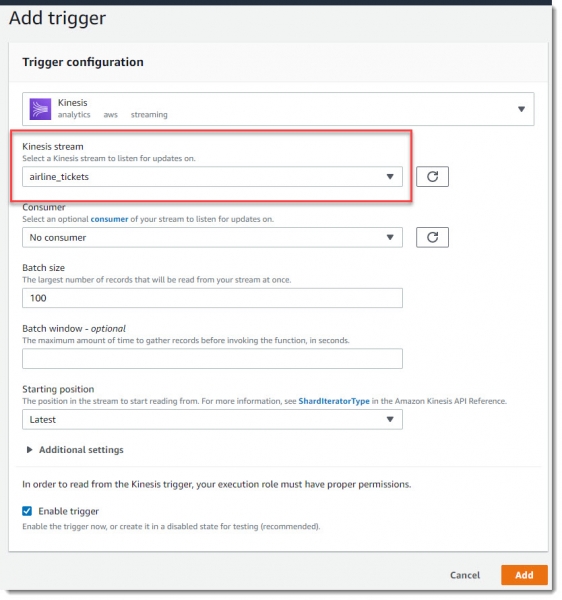
Rămâne să inserăm codul și să salvăm lambda.
"""Analizând fluxul și inserând în tabela DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Analizând informațiile din flux."""

    def __init__(self, table_name, records):
        """Metoda de inițializare."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Returnează datele deserializate din flux."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Preprocesează datele json."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Inserare în bloc în tabel."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Au fost adăugate', len(self.json_data), 'elemente')

def lambda_handler(event, context):
    """Analizează fluxul și inserează în tabela DynamoDB."""
    print('Am primit eveniment:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Crearea funcției Lambda notifier
A doua funcție Lambda, care va monitoriza al doilea flux (special_stream) și va trimite o notificare în SNS, este creată similar. Prin urmare, această lambda trebuie să aibă acces la citire din Kinesis și să trimită mesaje în topicul SNS specificat, care mai apoi va fi trimis de serviciul SNS tuturor abonaților acestui topic (email, SMS etc).
Crearea rolului IAM
Mai întâi, creăm rolul IAM Lambda-KinesisAlarm pentru această lambda, apoi atribuim acest rol pentru lambda alarm_notifier care se creează:
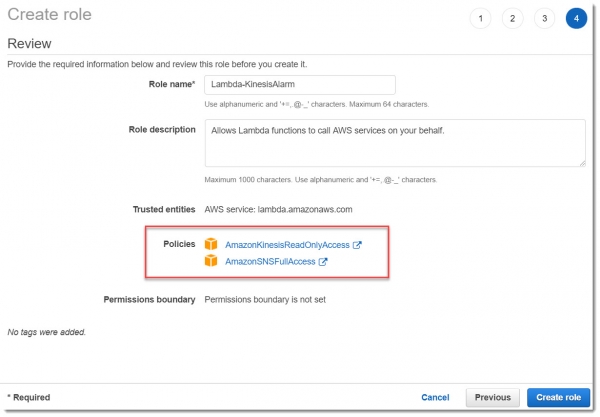
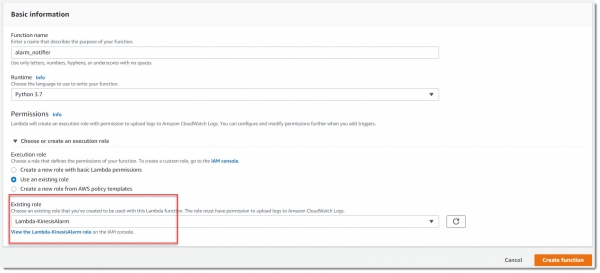
Această lambda trebuie să funcționeze pe baza unui trigger la adăugarea de noi înregistrări în fluxul special_stream, așa că este necesar să configurăm trigger-ul similar cu cel realizat pentru lambda Collector.
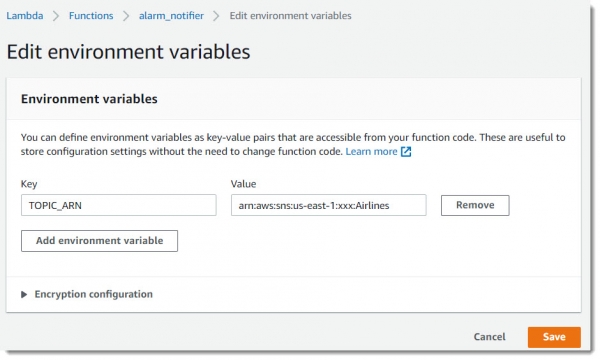
Pentru a facilita configurarea acestei lambda, introducem o nouă variabilă de mediu — TOPIC_ARN, unde plasăm ARN-ul (Amazon Resource Name) al topicului Airlines:
Și inserăm codul lambda; acesta nu este deloc complicat:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Bună! Am găsit o informație interesantă!',
                           Subject='Alarmă bilete de avion')
        print('Mesajul de alarmă a fost livrat cu succes')
    except Exception as err:
        print('Eșec de livrare', str(err))
Se pare că aici configurarea manuală a sistemului s-a încheiat. Mai rămâne doar să testăm și să ne asigurăm că totul este configurat corect.
Implementare din cod Terraform
Pregătiri necesare
— un instrument open-source foarte convenabil pentru desfășurarea infrastructurii din cod. Are propria sintaxă, care este ușor de învățat și numeroase exemple despre cum și ce să desfășori. În editorul Atom sau Visual Studio Code sunt multe pluginuri utile care facilitează lucrul cu Terraform.
Puteți descărca distribuția . O analiză detaliată a tuturor funcționalităților Terraform depășește cadrul acestui articol, așa că ne vom limita la aspectele principale.
Cum să pornești
Codul complet al proiectului se găsește . Clonăm repository-ul la noi. Înainte de a porni, asigurați-vă că aveți instalat și configurat AWS CLI, deoarece Terraform va căuta acreditivele în fișierul ~/ .aws/credentials.
O practică bună este să rulezi comanda plan înainte de a desfășura întreaga infrastructură, pentru a vedea ce va crea Terraform în cloud:
terraform.exe planVa fi solicitat să introduceți numărul de telefon pentru a primi notificări. La acest pas, introducerea lui nu este obligatorie.
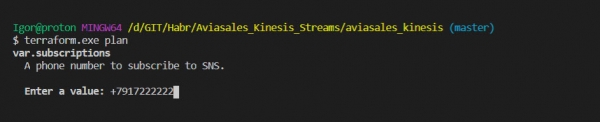
Analizând planul de lucru al programului, putem începe crearea resurselor:
terraform.exe applyDupă trimiterea acestei comenzi, va apărea din nou o solicitare pentru introducerea numărului de telefon, introduceți 'yes' când va apărea întrebarea despre executarea reală a acțiunilor. Aceasta va permite ridicarea întregii infrastructuri, configurarea necesară a EC2, desfășurarea funcțiilor lambda etc.
După ce toate resursele sunt create cu succes prin codul Terraform, trebuie să accesați detaliile aplicației Kinesis Analytics (din păcate, nu am găsit cum să fac asta direct din cod).
Să pornim aplicația:
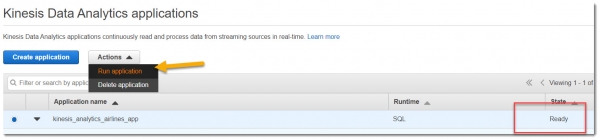
Apoi, trebuie să specificați în mod explicit numele fluxului în aplicație, alegând din lista derulantă:
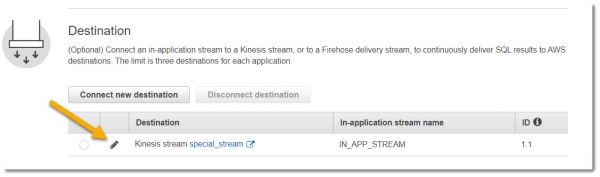
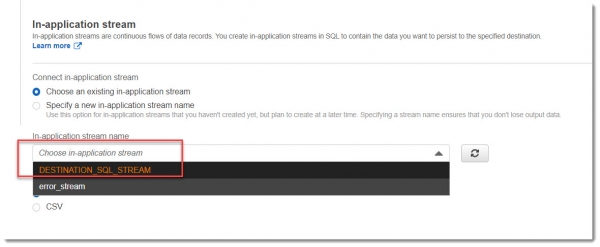
Acum totul este gata pentru lucru.
Testarea funcționării aplicației
Indiferent cum ați desfășurat sistemul, manual sau prin cod Terraform, va funcționa la fel.
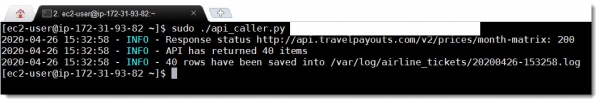
Ne conectăm prin SSH la instanța EC2 unde este instalat Kinesis Agent și lansăm scriptul api_caller.py
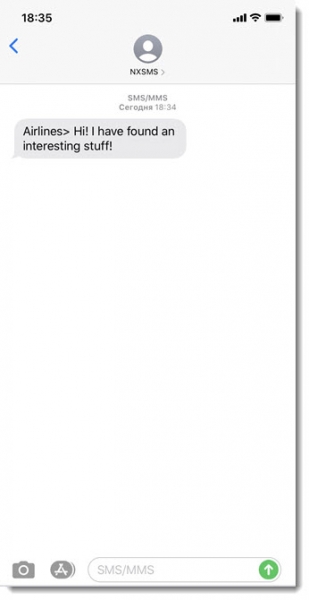
sudo ./api_caller.py TOKENAșteptați SMS-ul pe numărul dumneavoastră:
SMS-ul — mesajul ajunge pe telefon practic în 1 minut:
Trebuie să verificăm dacă înscrierile s-au păstrat în baza de date DynamoDB pentru o analiză ulterioară mai detaliată. Tabelul airline_tickets conține date aproximativ de acest tip:
Concluzie
În urma lucrărilor desfășurate, a fost construit un sistem de procesare online a datelor pe baza Amazon Kinesis. Au fost analizate opțiunile de utilizare a Kinesis Agent în legătură cu Kinesis Data Streams și analiza în timp real cu Kinesis Analytics prin comenzi SQL, precum și interacțiunea Amazon Kinesis cu alte servicii AWS.
Sistemul descris mai sus a fost implementat în două moduri: unul manual, mai îndelungat, și celălalt rapid prin codul Terraform.
Întregul cod sursă al proiectului este disponibil , vă invit să vă familiarizați cu el.
Sunt bucuros să discut articolul, aștept comentariile dumneavoastră. Sper la o critică constructivă.
Vă doresc mult succes!
Sursa: habr.com
