

Acest articol vă va ajuta să înțelegeți cum funcționează echilibrarea încărcăturii în Kubernetes, ce se întâmplă atunci când se scalează conexiunile de lungă durată și de ce ar trebui să luați în considerare echilibrarea pe partea clientului, dacă folosiți HTTP/2, gRPC, RSockets, AMQP sau alte protocoale de lungă durată.
Despre cum este redistribuit traficul în Kubernetes
Kubernetes oferă două abstracții utile pentru implementarea aplicațiilor: servicii (Services) și desfășurări (Deployments).
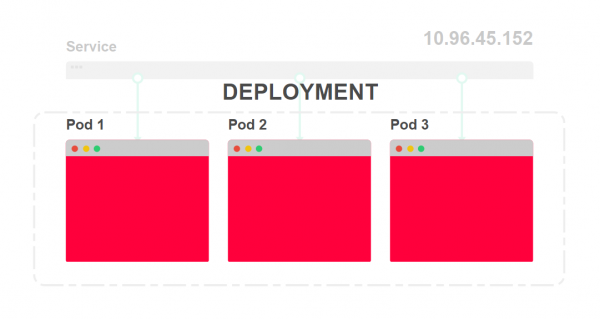
Desfășurările descriu cum și câte copii ale aplicației dvs. ar trebui să fie rulate în orice moment. Fiecare aplicație este desfășurată ca un pod (Pod) și i se alocă o adresă IP.
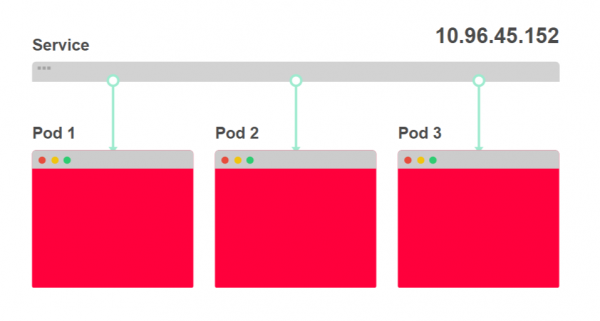
Serviciile sunt asemănătoare din punct de vedere funcțional cu un echilibror de încărcătură. Ele sunt destinate să distribuie traficul pe mai multe module.
Să vedem cum arată acest lucru.
- În diagrama de mai jos, vedeți trei instanțe ale unei aplicații și un echilibror de încărcătură:

- Echilibrorul de încărcătură se numește serviciu (Service) și are alocată o adresă IP. Orice cerere de intrare este redirecționată către unul dintre module:

- Scenariul de desfășurare definește numărul de instanțe ale aplicației. Practic, nu va trebui niciodată să desfășurați direct modul:

- Fiecare modul are alocată propria adresă IP:

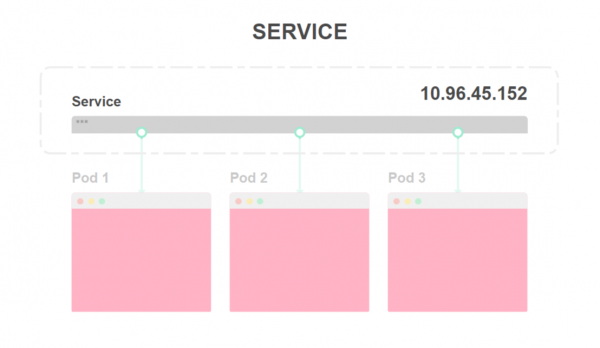
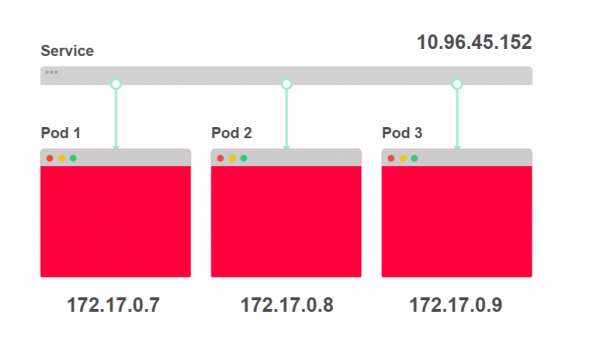
Este util să considerați serviciile ca un set de adrese IP. De fiecare dată când accesați un serviciu, una dintre adresele IP este selectată din listă și utilizată ca adresă de destinație.
Acesta arată astfel.
- Se primește o cerere curl 10.96.45.152 către serviciu:

- Serviciul alege una dintre cele trei adrese ale modulelor ca punct de destinație:

- Traficul este redirecționat către un modul specific:


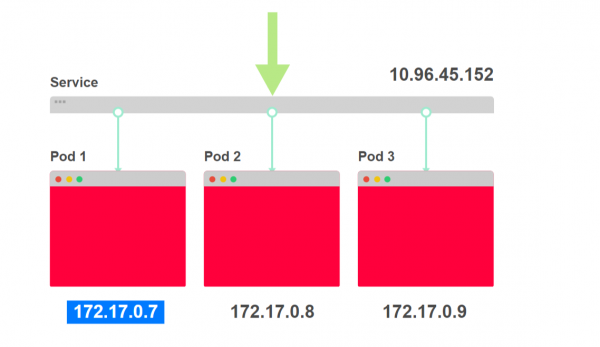
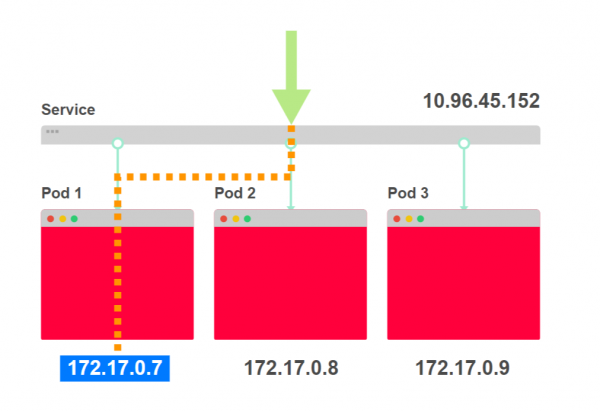
Dacă aplicația dvs. este formată dintr-un frontend și un backend, atunci veți avea atât un serviciu, cât și o desfășurare pentru fiecare.
Când frontendul face o cerere către backend, nu trebuie să știe câte module deservesc backend-ul: pot fi unul, zece sau o sută.
De asemenea, frontendul nu știe nimic despre adresele modulelor care deservesc backend-ul.
Când frontendul face o cerere către backend, folosește adresa IP a serviciului backend, care nu se schimbă.
Așa arată.
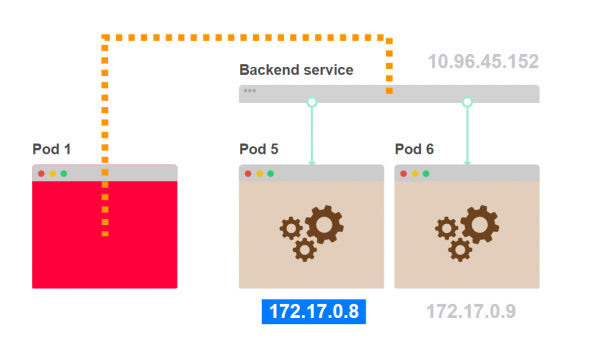
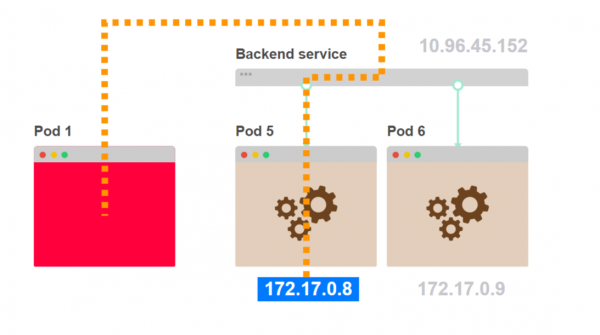
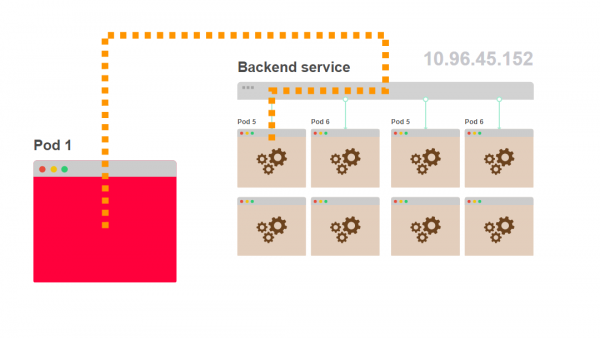
- Modul 1 face o cerere componentului intern al backend-ului. În loc să aleagă un modul specific al backend-ului, acesta face o cerere către serviciu:

- Serviciul selectează unul dintre podurile backend ca adresă de destinație:

- Traficul se îndreaptă de la podul 1 spre podul 5, ales de serviciu:

- Podul 1 nu știe câte astfel de poduri ca podul 5 sunt ascunse în spatele serviciului:

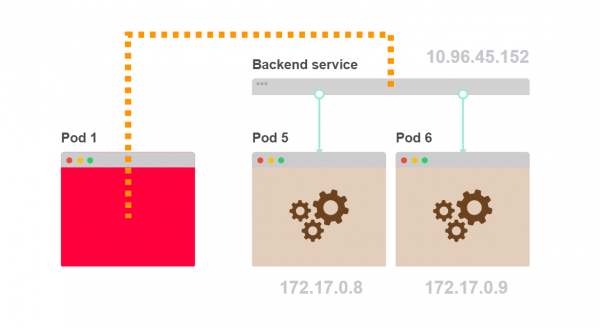
Dar cum anume distribuie serviciul cererile? Pare că se folosește de balansarea round-robin? Să analizăm.
Balansarea în serviciile Kubernetes
Serviciile Kubernetes nu există. Pentru un serviciu nu există un proces căruia i-a fost alocată o adresă IP și un port.
Te poți convinge de asta, accesând orice nod din cluster și executând comanda netstat -ntlp.
Chiar nu vei putea găsi adresa IP alocată serviciului.
Adresa IP a serviciului este plasată în stratul de control, în controller, și este înregistrată în baza de date — etcd. Această adresă este folosită de un alt component — kube-proxy.
Kube-proxy primește lista adreselor IP pentru toate serviciile și formează un set de reguli iptables pe fiecare nod din cluster.
Aceste reguli spun: „Dacă vedem adresa IP a serviciului, trebuie să modificăm adresa de destinație a cererii și să o trimitem la unul dintre poduri.”
Adresa IP a serviciului este folosită doar ca punct de intrare și nu este gestionată de niciun proces care să asculte această adresă IP și port.
Să ne uităm la asta.
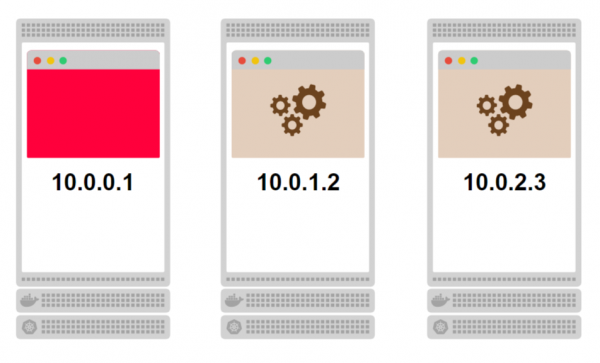
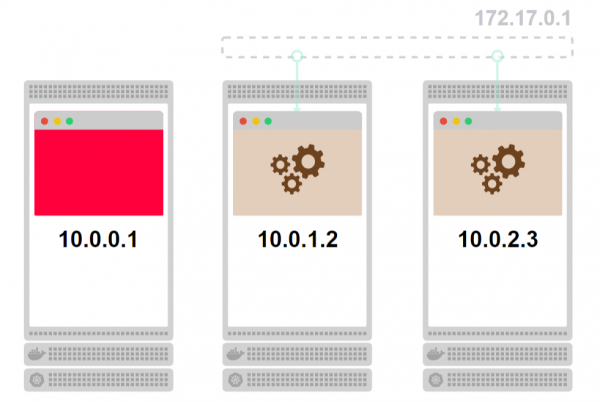
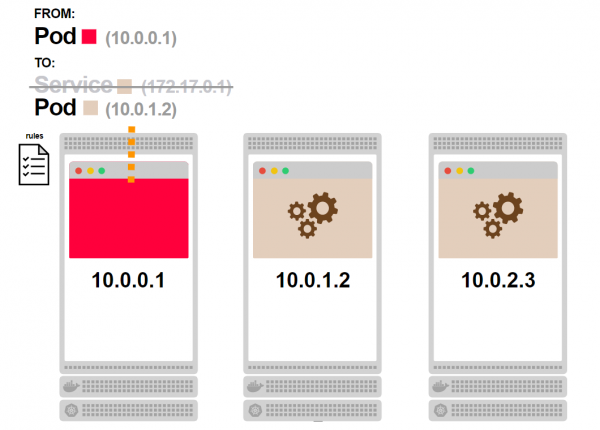
- Să considerăm un cluster cu trei noduri. Fiecare nod conține poduri:

- Podurile asociate, colorate în bej, fac parte din serviciu. Deoarece serviciul nu există ca proces, este reprezentat cu gri:

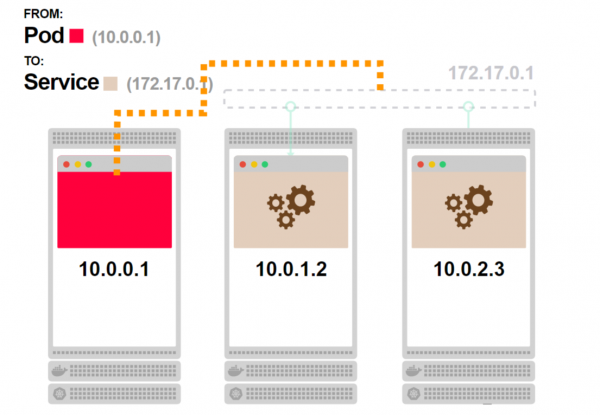
- Primul pod solicită serviciul și ar trebui să ajungă la unul dintre podurile asociate:

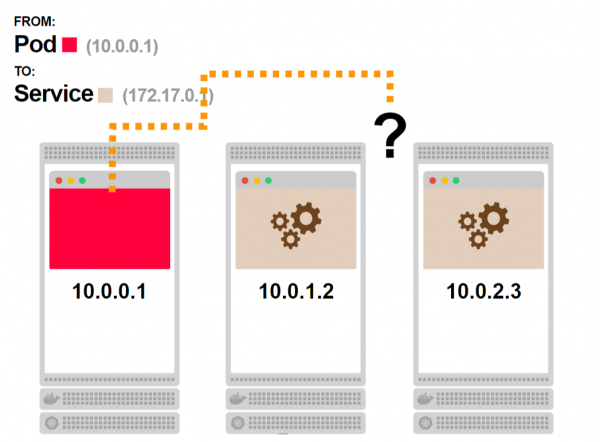
- Dar serviciul nu există, procesul nu este. Cum funcționează asta?

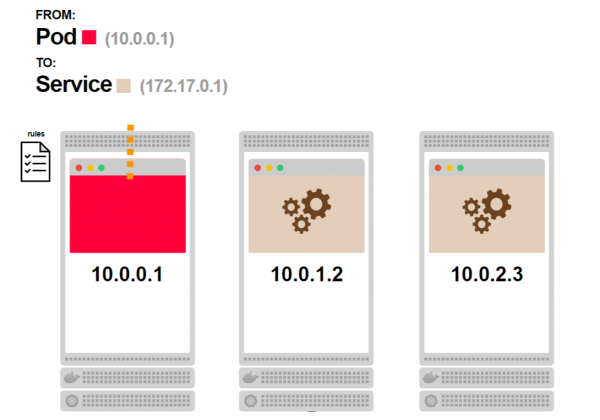
- Înainte ca cererea să părăsească nodul, trece prin regulile iptables:

- Regulile iptables știu că serviciul nu există și înlocuiesc adresa sa IP cu una dintre adresele IP ale podurilor asociate cu acest serviciu:

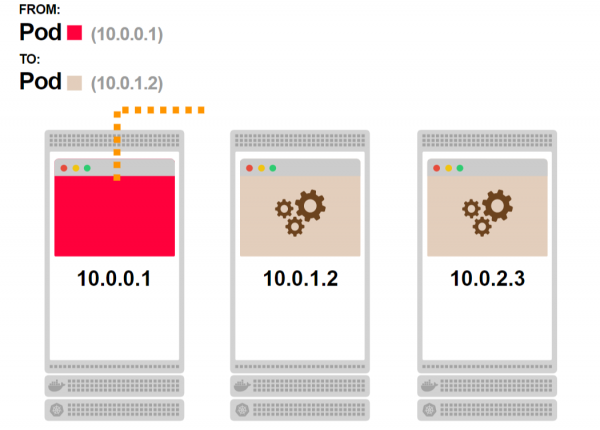
- Cererea primește o adresă IP validă ca adresă de destinație și este procesată corect:
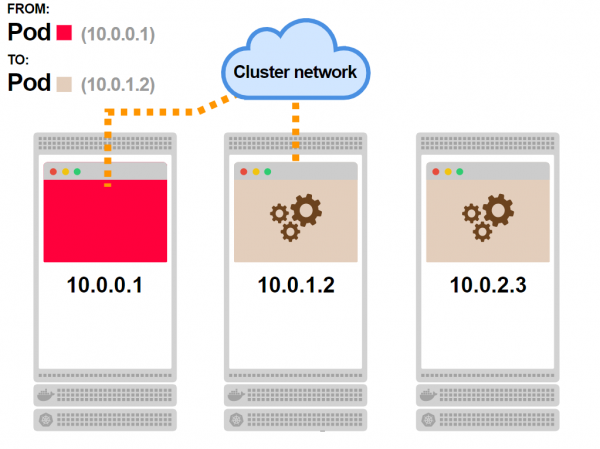
- În funcție de topologia rețelei, cererea ajunge în cele din urmă la pod:

Știu iptables să echilibreze sarcina?
Nu, iptables sunt folosite pentru filtrare și nu au fost proiectate pentru echilibrarea sarcinii.
Cu toate acestea, există posibilitatea de a scrie un set de reguli care funcționează ca .
Și exact asta este implementat în Kubernetes.
Dacă ai trei poduri, kube-proxy va scrie următoarele reguli:
- Alege primul pod cu o probabilitate de 33%, altfel trece la următoarea regulă.
- Alegeți al doilea pod cu o probabilitate de 50%, altfel treceți la următoarea regulă.
- Alegeți al treilea pod.
Un astfel de sistem conduce la faptul că fiecare pod este ales cu o probabilitate de 33%.
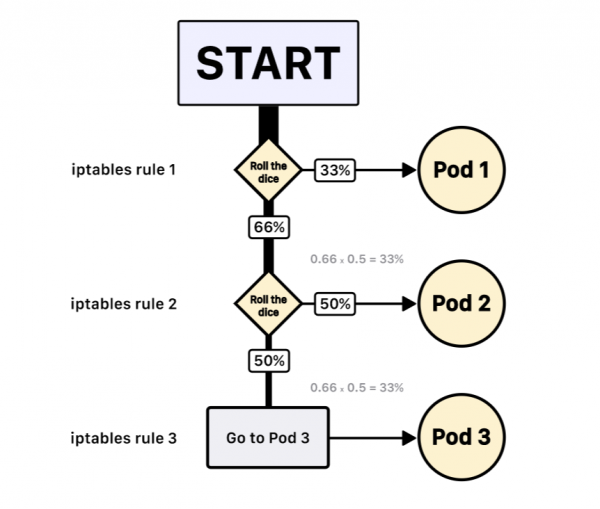
Și nu există nicio garanție că podul 2 va fi selectat următorul după podul 1.
Notă: iptables utilizează un modul statistic cu distribuție aleatoare. Astfel, algoritmul de balansare se bazează pe o alegere aleatoare.
Acum că înțelegeți cum funcționează serviciile, să aruncăm o privire asupra unor scenarii de lucru mai interesante.
Conexiunile de lungă durată în Kubernetes nu sunt scalate implicit.
Fiecare solicitare HTTP de la front-end către back-end este gestionată de o conexiune TCP separată, care este deschisă și închisă.
Dacă front-endul trimite 100 de solicitări pe secundă către back-end, 100 de conexiuni TCP diferite sunt deschise și închise.
Timpul de procesare a solicitării poate fi redus și încărcătura scăzută dacă se deschide o singură conexiune TCP și se folosește pentru toate solicitările HTTP ulterioare.
În protocolul HTTP este încorporată o capacitate numită keep-alive HTTP, sau reutilizarea conexiunii. În acest caz, o singură conexiune TCP este utilizată pentru a trimite și primi numeroase solicitări și răspunsuri HTTP:
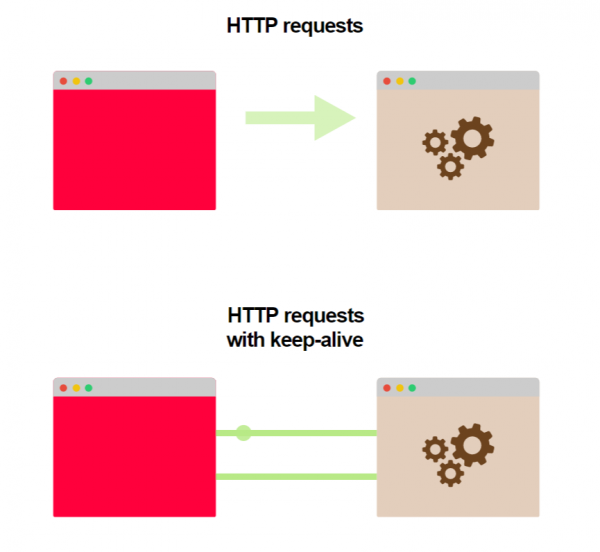
Această capacitate nu este activată implicit: atât serverul, cât și clientul trebuie să fie configurate corespunzător.
Configurarea în sine este simplă și accesibilă pentru majoritatea limbajelor de programare și mediilor.
Iată câteva linkuri către exemple în diferite limbaje:
Ce se va întâmpla dacă folosim keep-alive în serviciul Kubernetes?
Să presupunem că atât front-endul, cât și back-endul suportă keep-alive.
Avem o copie a front-endului și trei instanțe ale back-endului. Front-endul face prima solicitare și deschide o conexiune TCP către back-end. Solicitarea ajunge la serviciu, unul dintre podurile back-endului este ales ca adresă de destinație. Podul back-endului trimite un răspuns, iar front-endul îl primește.
Spre deosebire de situația obișnuită, când după primirea răspunsului conexiunea TCP este închisă, acum este menținută deschisă pentru următoarele solicitări HTTP.
Ce se va întâmpla dacă front-endul trimite și alte solicitări către back-end?
Pentru a redirecționa aceste solicitări, va fi folosită conexiunea TCP deschisă, toate solicitările vor merge la același pod al back-endului la care a ajuns prima solicitare.
Nu ar trebui iptables să redirecționeze traficul?
Nu în acest caz.
Când se creează o conexiune TCP, aceasta trece prin regulile iptables, care aleg backend-ul specific către care va merge traficul.
Deoarece toate cererile ulterioare trec printr-o conexiune TCP deja deschisă, regulile iptables nu mai sunt apelate.
Să vedem cum arată acest lucru.
- Primul pod trimite cererea către serviciu:

- Știți deja ce va urma. Serviciul nu există, dar există reguli iptables care vor procesa cererea:
- Unul dintre podurile backend va fi ales ca adresă de destinație:

- Cererea ajunge la pod. În acest moment, o conexiune TCP permanentă între cele două poduri va fi stabilită:

- Orice cerere ulterioară din primul pod va merge prin conexiunea deja stabilită:

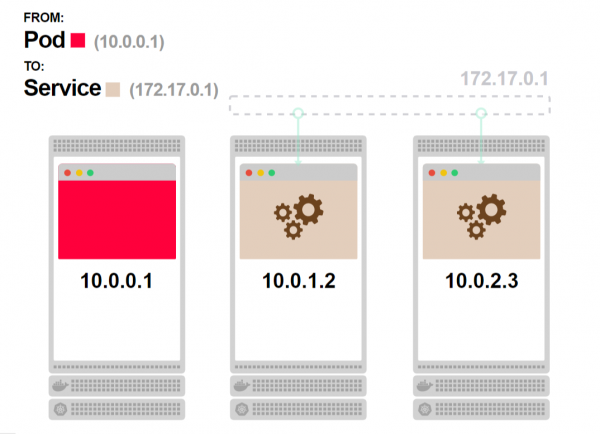
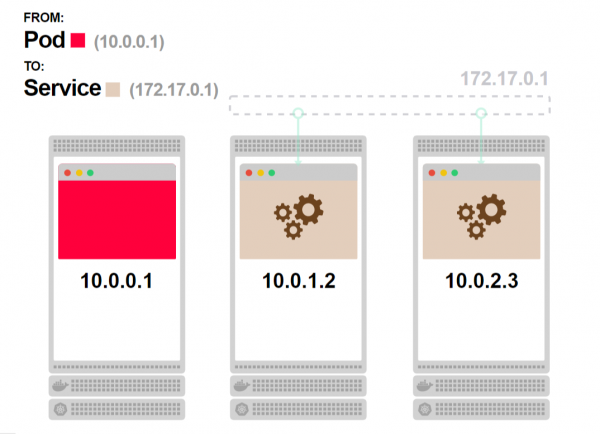
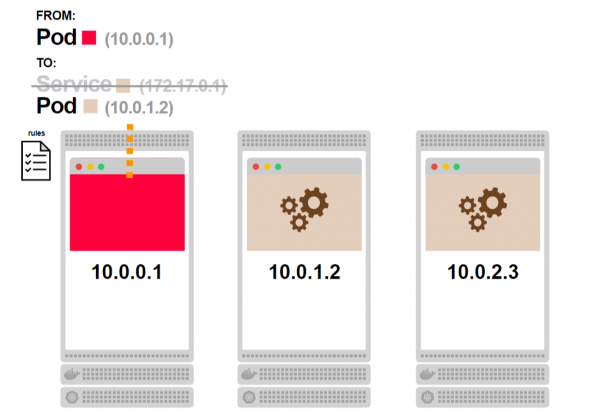
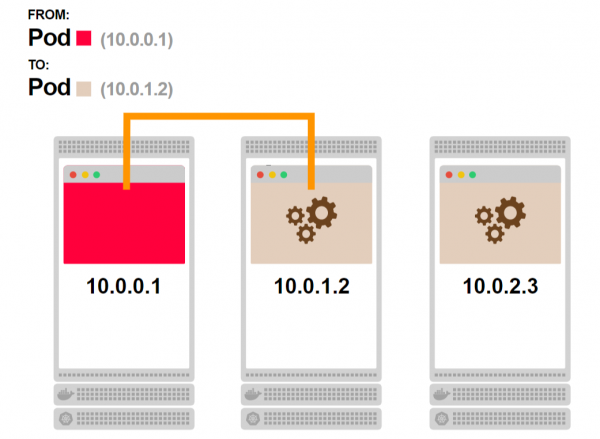
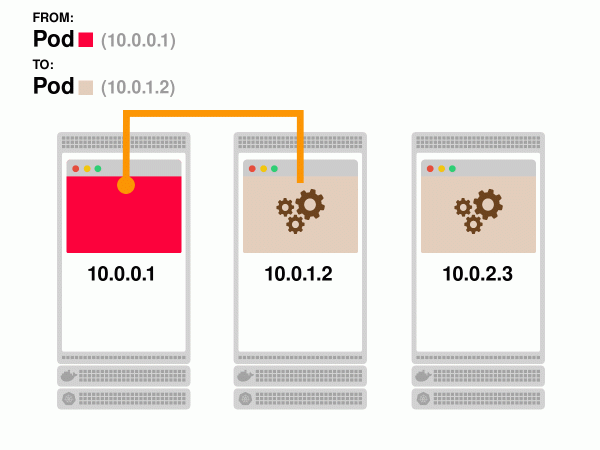
Ca rezultat, ați obținut un timp de răspuns mai rapid și o capacitate mai mare, dar ați pierdut posibilitatea de scalare a backend-ului.
Chiar și dacă aveți două poduri în backend, printr-o conexiune permanentă, traficul va merge tot timpul către unul dintre ele.
Se poate corecta acest lucru?
Deoarece Kubernetes nu știe cum să balanceze conexiunile permanente, această sarcină este încredințată ție.
Serviciile sunt un set de adrese IP și porturi numite puncte finale.
Aplicația ta poate obține o listă de puncte finale din serviciu și decide cum să distribuie cererile între ele. Poți deschide o conexiune permanentă cu fiecare pod și să balancezi cererile între aceste conexiuni folosind round-robin.
Sau să aplici algoritmi de .
Codul de client care se ocupă de balanceare trebuie să urmeze următoarea logică:
- Obține lista de puncte finale din serviciu.
- Pentru fiecare punct final, deschide o conexiune permanentă.
- Când trebuie să faci o cerere, folosește una dintre conexiunile deschise.
- Actualizează periodic lista de puncte finale, creând noi sau închizând vechile conexiuni permanente în cazul în care lista se schimbă.
Iată cum va arăta acest lucru.
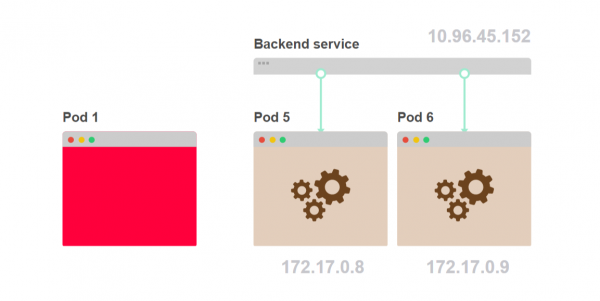
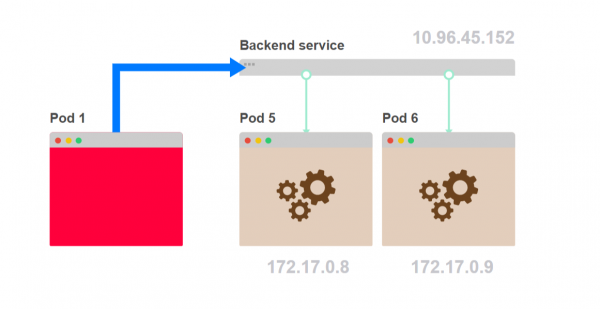
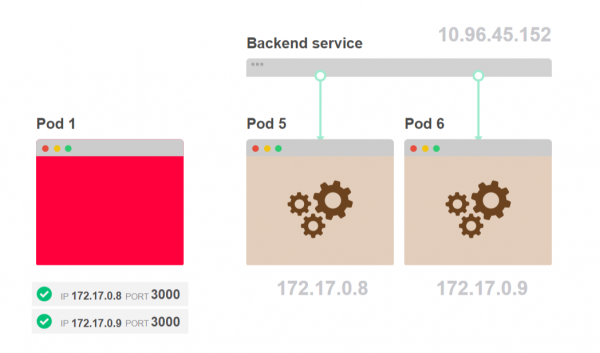
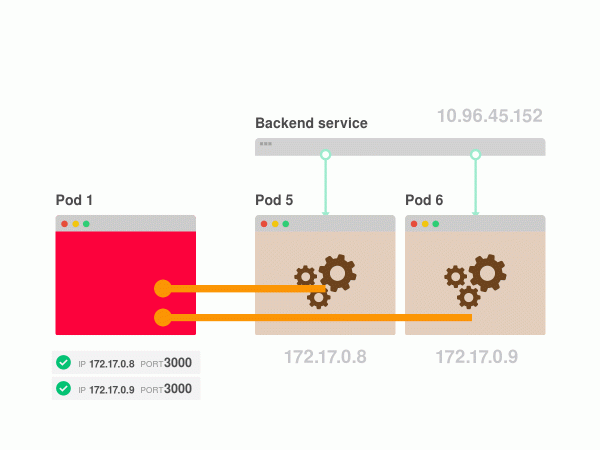
- În loc ca primul pod să trimită cererea către serviciu, poți balancează cererile pe partea clientului:

- Trebuie să scrii un cod care să întrebe care poduri fac parte din serviciu:

- Odată ce ai obținut lista, salvează-o pe partea clientului și folosește-o pentru a te conecta cu podurile:

- Sunteți responsabil pentru algoritmul de echilibrare a încărcării:
Acum apare întrebarea: această problemă se aplică doar HTTP keep-alive?
Echilibrarea încărcării pe partea clientului
HTTP nu este singurul protocol care poate folosi conexiuni TCP persistente.
Dacă aplicația dvs. folosește o bază de date, conexiunea TCP nu se deschide de fiecare dată când trebuie să executați o solicitare sau să obțineți un document din Bază de date.
În schimb, se deschide și se folosește o conexiune TCP persistentă la baza de date.
Dacă baza de date este desfășurată în Kubernetes și accesul este oferit sub formă de serviciu, veți întâmpina aceleași probleme descrise în secțiunea anterioară.
O replica a bazei de date va fi încărcată mai mult decât celelalte. Kube-proxy și Kubernetes nu vor ajuta la echilibrarea conexiunilor. Trebuie să vă ocupați de echilibrarea solicitărilor către baza dvs. de date.
În funcție de biblioteca pe care o folosiți pentru a vă conecta la baza de date, s-ar putea să aveți diverse opțiuni pentru a rezolva această problemă.
Mai jos este un exemplu de acces la clusterele de baze de date MySQL din Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* retrieve endpoints from the Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Faceți interogări la baza de date MySQL clusterizată
Există o mulțime de alte protocoale care folosesc conexiuni TCP persistente:
- WebSockets și WebSockets securizate
- HTTP/2
- gRPC
- RSockets
- AMQP
Ar trebui să fiți deja familiarizat cu majoritatea acestor protocoale.
Dar dacă aceste protocoale sunt atât de populare, de ce nu există o soluție standardizată pentru echilibrare? De ce este necesară modificarea logicii clientului? Există o soluție nativă Kubernetes?
Kube-proxy și iptables sunt create pentru a închide majoritatea scenariilor standard de utilizare la desfășurarea în Kubernetes. Acest lucru a fost realizat pentru comoditate.
Dacă folosiți un serviciu web care oferă REST API, aveți noroc — în acest caz, conexiunile TCP persistente nu sunt utilizate, puteți folosi orice serviciu Kubernetes.
Dar de îndată ce începeți să folosiți conexiuni TCP persistente, va trebui să înțelegeți cum să distribuiți uniform încărcătura pe backenduri. Kubernetes nu conține soluții pregătite pentru aceasta.
Cu toate acestea, există, desigur, opțiuni care pot ajuta.
Echilibrarea conexiunilor de lungă durată în Kubernetes
În Kubernetes există patru tipuri de servicii:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Primele trei servicii funcționează pe baza unei adrese IP virtuale, care este folosită de kube-proxy pentru a construi reguli iptables. Dar fundamentul tuturor serviciilor este serviciul de tip headless.
Nu există nicio adresă IP asociată cu serviciul headless, el oferind doar un mecanism de obținere a listei de adrese IP și porturi legate de podurile conexe (punctele finale).
Toate serviciile se bazează pe serviciul headless.
Serviciul ClusterIP este un serviciu headless cu unele adăugiri:
- Stratul de management îi atribuie o adresă IP.
- Kube-proxy formează regulile necesare iptables.
Astfel, puteți ignora kube-proxy și utiliza direct lista de puncte finale obținută din serviciul headless pentru a face balance de sarcină în aplicația dumneavoastră.
Dar cum puteți adăuga o astfel de logică în toate aplicațiile desfășurate în cluster?
Dacă aplicația dumneavoastră este deja desfășurată, această sarcină poate părea imposibilă. Cu toate acestea, există o alternativă.
Service Mesh vă va ajuta
Ați observat probabil că strategia de balance de sarcină pe partea clientului este destul de standard.
Când aplicația pornește, aceasta:
- Obține lista de adrese IP din serviciu.
- Deschide și menține un pool de conexiuni.
- Își actualizează periodic pool-ul, adăugând sau eliminând puncte finale.
Atunci când aplicația dorește să facă o cerere, aceasta:
- Alege o conexiune disponibilă, folosind o logică anume (de exemplu, round-robin).
- Execută cererea.
Acești pași funcționează atât pentru conexiunile WebSockets, cât și pentru gRPC și AMQP.
Puteți extrage această logică într-o bibliotecă separată și o puteți utiliza în aplicațiile dumneavoastră.
Cu toate acestea, în loc de asta, puteți folosi grile de servicii, cum ar fi Istio sau Linkerd.
Service Mesh completează aplicația dumneavoastră printr-un proces care:
- Caută automat adresele IP ale serviciilor.
- Verifică conexiunile, cum ar fi WebSockets și gRPC.
- Balancează cererile, folosind protocolul corect.
Service Mesh ajută la gestionarea traficului în interiorul cluster-ului, dar este destul de consumator de resurse. Alte opțiuni includ utilizarea bibliotecilor externe, cum ar fi Netflix Ribbon, sau proxy-uri programabile, cum ar fi Envoy.
Ce se va întâmpla dacă ignorați problemele de balance de sarcină?
Puteți să nu folosiți balance de sarcină și totuși să nu observați nicio schimbare. Haideți să analizăm câteva scenarii de funcționare.
Dacă aveți mai mulți clienți decât servere, aceasta nu este o problemă atât de mare.
Să presupunem că sunt cinci clienți care se conectează la două servere. Chiar dacă nu există echilibrare, ambele servere vor fi utilizate:
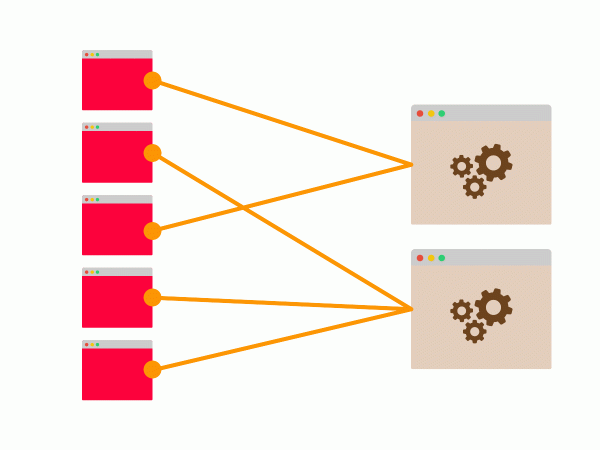
Conexiunile pot fi distribuite inegal: poate că patru clienți s-au conectat la același server, dar există o probabilitate bună ca ambele servere să fie folosite.
Ceea ce este mai problematic este scenariul invers.
Dacă aveți mai puțini clienți și mai multe servere, resursele dumneavoastră ar putea fi insuficient utilizate, iar un potențial punct de colaps ar putea apărea.
Să presupunem că sunt doi clienți și cinci servere. În cea mai bună situație, vor exista două conexiuni permanente la două servere din cinci.
Celelalte servere vor rămâne neutilizate:
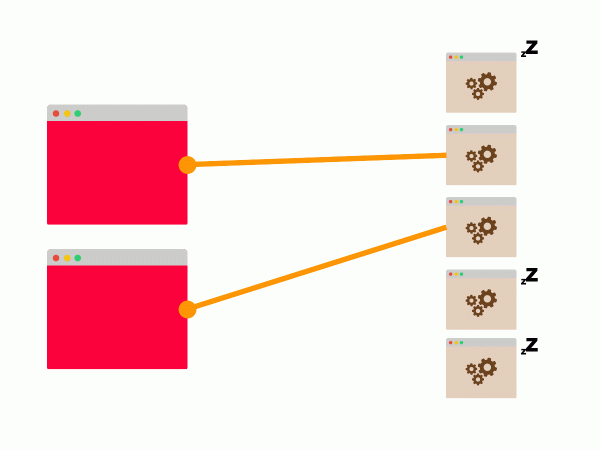
Dacă aceste două servere nu pot gestiona procesarea cererilor clienților, scalarea orizontală nu va ajuta.
Concluzie
Serviciile Kubernetes sunt create pentru a funcționa în cele mai multe scenarii standard de aplicații web.
Cu toate acestea, de îndată ce începeți să lucrați cu protocoale de aplicație care folosesc conexiuni TCP permanente, cum ar fi bazele de date, gRPC sau WebSockets, serviciile nu mai sunt adecvate. Kubernetes nu oferă mecanisme interne pentru echilibrarea conexiunilor TCP permanente.
Asta înseamnă că trebuie să scrieți aplicații având în vedere posibilitatea echilibrării la nivel de client.
Traducere realizată de echipă .
What else to read on the topic:
- .
- .
- .
Sursa: habr.com
