

Vă propun să vă familiarizați cu transcrierea prezentării din începutul anului 2016 a lui Andrei Salnikov „Erorile tipice în aplicații care duc la bloat în PostgreSQL”
În această prezentare voi analiza principalele erori în aplicații care apar în etapa de design și scriere a codului aplicației. Voi lua în considerare doar acele erori care duc la bloat în PostgreSQL. De regulă, aceasta este începutul sfârșitului performanței sistemului dumneavoastră în ansamblu, deși inițial nu au fost vizibile semne în acest sens.
Bună tuturor! Această prezentare nu este la fel de tehnică ca cea anterioară a colegului meu. Această prezentare se concentrează în principal pe dezvoltatorii de sisteme de backend, deoarece avem un număr destul de mare de clienți. Și toți fac aceleași greșeli. Voi vorbi despre ele. Voi explica la ce rezultă aceste greșeli fatale și grave.
De ce se fac erori? Ele apar din două motive: pe de o parte, pe baza unei atitudini de genul „poate va merge” și, pe de altă parte, din ignoranța unor mecanisme care au loc la nivelul dintre bază și aplicație, precum și în baza de date în sine.
Voi prezenta trei exemple cu imagini îngrozitoare despre cum totul a ajuns rău. Voi explica pe scurt mecanismul care se desfășoară acolo. Și cum să luptăm cu ele atunci când apar și ce metode preventive trebuie folosite pentru a evita erorile. Voi vorbi despre instrumente auxiliare și voi oferi linkuri utile.
Am folosit o bază de date de test, unde am avut două tabele. Un tabel cu facturile clienților, iar celălalt cu operațiunile legate de aceste facturi. Și la anumite intervale de timp actualizăm soldurile acestor facturi.
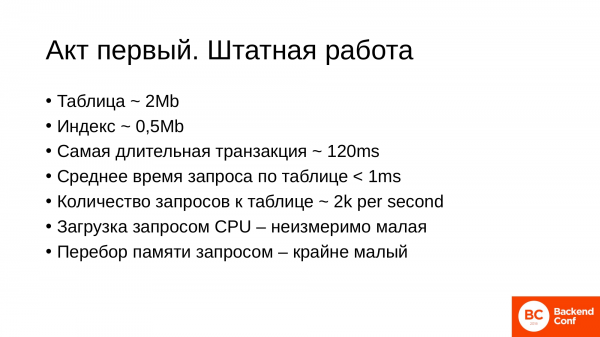
Datele inițiale ale tabelului: este destul de mic, 2 MB. Timpul de răspuns al bazei și pentru tabelul specific este, de asemenea, foarte bun. Și o sarcină destul de bună – 2000 de operațiuni pe secundă pe tabel.
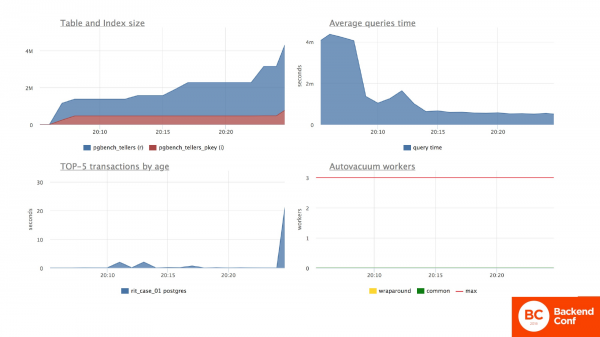
Pe parcursul acestei prezentări vă voi arăta grafice pentru a fi clar ce se întâmplă. Vor fi întotdeauna două diapozitive cu grafice. Primul diapozitiv va arăta ce se întâmplă în general pe server.
În această situație vedem că tabelul nostru este într-adevăr de dimensiuni mici. Indexul este mic, de 2 MB. Acesta este primul grafic din stânga.
Timpul mediu de răspuns al serverului este, de asemenea, stabil și mic. Acesta este graficul din dreapta sus.
Graficul din colțul stâng inferior arată cele mai lungi tranzacții. Vedem că tranzacțiile se efectuează rapid. De asemenea, autovacuum-ul nu funcționează încă aici, deoarece a fost un test de început. În continuare, acesta va funcționa și ne va fi util.
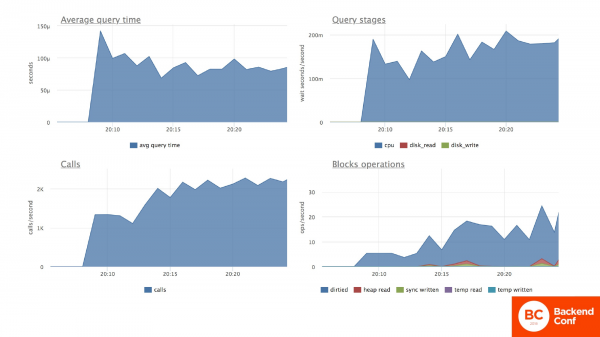
Al doilea diapozitiv va fi întotdeauna dedicat tabelului testat. În această situație, actualizăm constant soldurile din conturile clientului. Vedem că timpul mediu de răspuns pentru operația de actualizare este destul de bun, mai puțin de o milisecundă. Observăm că resursele procesorului (acesta este graficul din colțul drept superior) sunt consumate, de asemenea, uniform și într-o măsură destul de mică.
Graficul din colțul drept inferior arată câtă memorie operațională și de disc analizăm pentru a găsi linia dorită înainte de a o actualiza. Numărul de operații pe tabel este de 2000 pe secundă, așa cum am menționat la început.
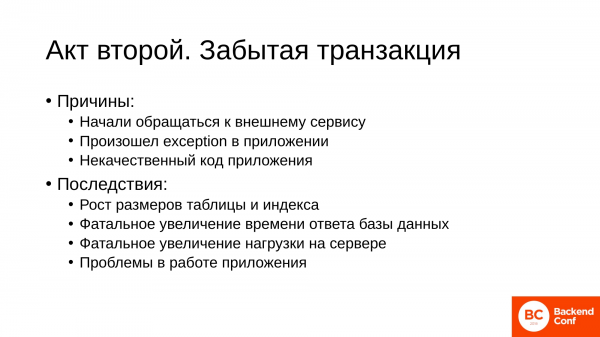
Și acum avem o tragedie. Dintr-un anumit motiv, apare o tranzacție lungă uitată. Cauzele sunt, de obicei, banale:
- Una dintre cele mai frecvente este aceea că am început să apelăm la un serviciu extern în codul aplicației. Iar acest serviciu nu ne răspunde. Adică, am deschis o tranzacție, am făcut o modificare în bază și am plecat din aplicație să citim emailurile sau să ne ocupăm de un alt serviciu din cadrul infrastructurii noastre, iar acesta, dintr-un motiv oarecare, nu ne răspunde. Și sesiunea noastră a rămas suspendată cu o stare – necunoscut, când se va rezolva.
- A doua situație în care, dintr-un anumit motiv, a apărut un exception în codul nostru. Și nu am tratat în exception închiderea tranzacției. Și astfel am obținut o sesiune suspendată cu o tranzacție deschisă.
- Și în final – acesta este și un caz destul de frecvent. Este vorba despre cod de proastă calitate. Unele framework-uri deschid o tranzacție. Ea rămâne suspendată și s-ar putea să nu știți în aplicație că aceasta este suspendată.
La ce duc astfel de lucruri?
La faptul că tabelele și indecșii încep să se umfle rapid. Acesta este efectul bloat. Pentru baza de date, aceasta se va traduce printr-o creștere bruscă a timpului de răspuns al bazei de date, o creștere a încărcării serverului de baze de date. Și, ca rezultat, aplicația va suferi. Deoarece, dacă în cod foloseai 10 milisecunde pentru o cerere în bază, 10 milisecunde pentru logica ta, atunci funcția ta se executa în 20 milisecunde. Iar acum situația ta va fi cu totul neplăcută.
Și să vedem ce se întâmplă. Grafica din colțul stâng inferior arată că avem o tranzacție lungă și prelungită. Și dacă ne uităm la grafica din colțul stâng superior, vedem că dimensiunea tabelului de la două megabytes a sărit brusc la 300 megabytes. În același timp, cantitatea de date din tabel nu s-a schimbat, adică acolo este o cantitate destul de mare de deșeuri.
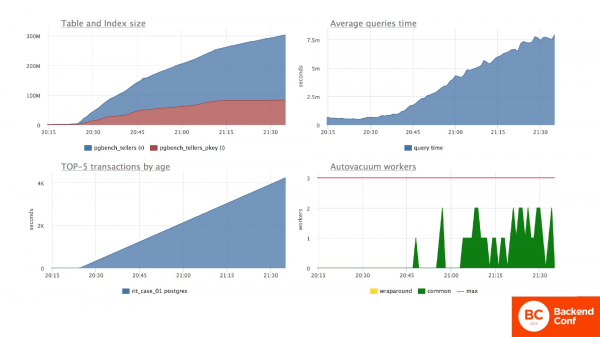
Situația generală în ceea ce privește timpul mediu de răspuns al serverului s-a schimbat și ea cu câteva ordine de magnitudine. Adică, toate cererile către server au început să scadă drastic. În același timp, s-au activat procesele interne Postgres în persoana autovacuum-ului, care încearcă să facă ceva și consumă resurse.
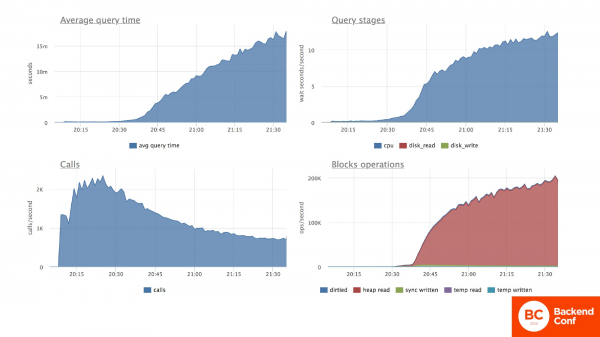
Ce se întâmplă cu tabelul nostru? Acelasi lucru. Timpul mediu de răspuns pentru tabelul nostru a sărit cu câteva ordine de magnitudine în sus. Dacă ne referim la resursele consumate, vedem că încărcătura pe procesor a crescut foarte mult. Aceasta este grafica din colțul dreapta sus. Aceasta a crescut deoarece procesorul trebuie să caute într-o mulțime de linii inutile în căutarea uneia necesare. Aceasta este grafica din colțul dreapta inferior. Și ca rezultat – numărul de apeluri pe secundă a început să scadă drastic, deoarece baza nu reușește să proceseze aceeași cantitate de cereri.
Trebuie să revenim la normalitate. Ne conectăm la internet și aflăm că tranzacțiile lungi duc la probleme. Găsim și eliminăm această tranzacție. Și totul revine la normal. Totul funcționează cum trebuie.
Ne-am liniștit, dar după un timp începem să observăm că aplicația nu funcționează la fel ca înainte de incident. Cererile sunt totuși procesate mai lent, și anume semnificativ mai lent. Cu 1,5-2 ori mai lent, în cazul meu. Încărcătura pe server este, de asemenea, mai mare decât era înainte de incident.
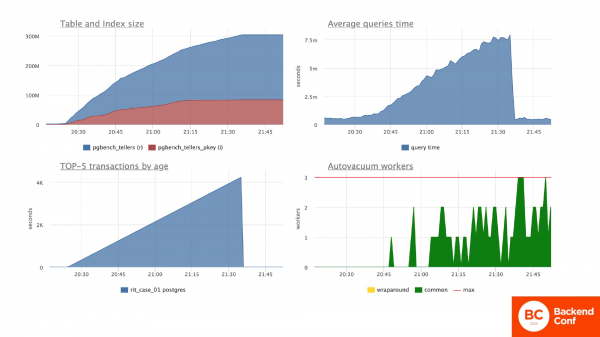
Și întrebarea este: „Ce se întâmplă cu baza de date în acel moment?”. Iar cu baza se întâmplă următoarea situație. În grafica tranzacțiilor vedeți că aceasta s-a oprit și acolo chiar nu există tranzacții lungi. Dar dimensiunile tabelului în timpul incidentei au crescut fatal. Și de atunci nu s-au micșorat. Timpul mediu pe baza s-a stabilizat. Și răspunsurile par să fie adecvate cu o viteză acceptabilă pentru noi. Autovacuum-ul a devenit mai activ și a început să facă ceva cu tabelul, deoarece trebuie să proceseze o cantitate mai mare de date.
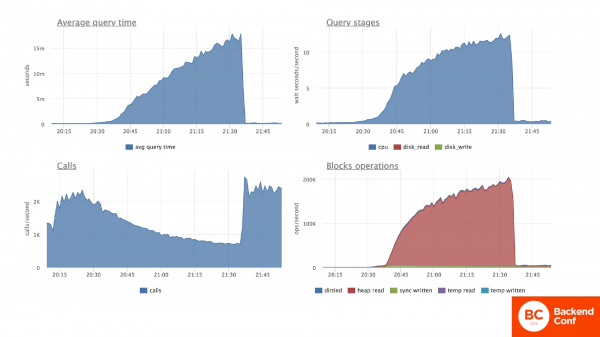
Referitor la tabelul testat cu conturile, unde schimbăm soldurile: timpul de răspuns la cerere pare să fi revenit la normal. Dar de fapt, este de o dată și jumătate mai mare.
Și în ceea ce privește sarcina pe procesor, vedem că aceasta nu a revenit la nivelul dorit până la accident. Iar cauzele sunt tocmai în graficul din colțul din dreapta jos. Se observă că acolo se face o verificare a unui anumit număr de înregistrări. Adică, pentru a găsi linia dorită, consumăm resursele serverului bazei de date căutând date inutile. Numărul de tranzacții pe secundă s-a stabilizat.
În general, este bine, dar situația este mai rea decât înainte. A existat o degradare evidentă a bazei de date ca rezultat al aplicației noastre care interacționează cu această bază de date.
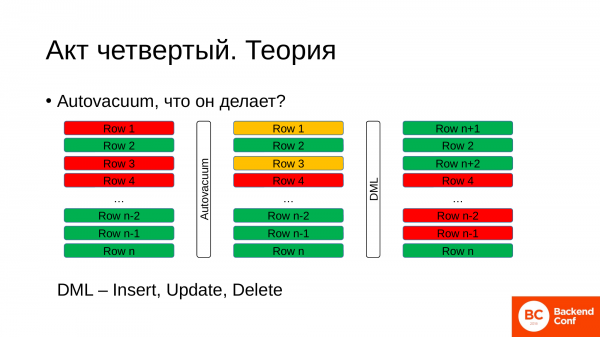
Și pentru a înțelege ce se întâmplă acolo, dacă nu ați fost la prezentarea anterioară, acum o să facem o mică teorie. Teoria despre procesul intern. De ce este necesar autovacuumul și ce rol joacă?
Pe scurt, pentru a înțelege. La un moment dat, avem un tabel. În tabel avem înregistrări. Aceste înregistrări pot fi active, vii, relevante pentru noi acum. În imagine, acestea sunt marcate cu verde. Și există înregistrări moarte, care au fost deja procesate, au fost actualizate, iar pentru ele au apărut noi înregistrări. Acestea sunt marcate ca fiind deja nesemnificative pentru baza de date. Însă ele rămân în tabel din cauza particularităților Postgres.
De ce este necesar autovacuumul? Autovacuumul la un moment dat vine, se adresează bazei de date și o întreabă: „Te rog, dă-mi id-ul celei mai vechi tranzacții care este deschisă în acest moment în baza de date”. Baza de date returnează acest id. Iar autovacuumul, bazându-se pe el, parcurge înregistrările din tabel. Și dacă observă că unele înregistrări au fost modificate de tranzacții mult mai vechi, atunci el are dreptul să le marcheze ca înregistrări pe care le putem reutiliza în viitor, scriind date noi în ele. Acesta este un proces în fundal.
Între timp, continuăm să lucrăm cu baza de date, continuăm să facem modificări în tabel. Și pentru acele înregistrări pe care le putem reutiliza, scriem date noi. Astfel, avem un ciclu, adică tot timpul apar înregistrări moarte vechi, iar în locul lor scriem înregistrări noi de care avem nevoie. Și aceasta este o stare normală pentru funcționarea PostgreSQL.
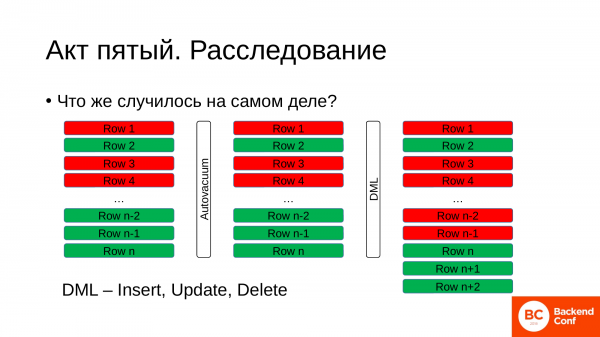
Ce s-a întâmplat în timpul accidentului? Cum s-a desfășurat acest proces acolo?
Aveam o tabelă într-o anumită stare, cu unele linii active, altele inactivate. A venit autovacuumul. A întrebat baza de date care este cea mai veche tranzacție, care este ID-ul ei. A obținut acest ID, care poate fi cu multe ore în urmă sau poate fi cu zece minute în urmă. Acest lucru depinde de cât de mare este sarcina pe baza de date. Și a început să caute liniile pe care le poate marca ca reutilizabile. Și nu a găsit astfel de linii în tabela noastră.
Dar în același timp continuăm să lucrăm cu tabela. Facem ceva în ea, actualizăm, schimbăm datele. Ce poate face baza de date în acel moment? Nu îi rămâne altceva de făcut decât să adauge linii noi la sfârșitul tabelului existent. Astfel, dimensiunea tabelului nostru începe să se umfle.
De fapt, avem nevoie de linii verzi pentru a lucra. Dar în timpul unei astfel de probleme, ajungem la concluzia că procentajul liniilor verzi este extrem de scăzut în întreaga masă a tabelului.
Când executăm o interogare, baza de date trebuie să parcurgă toate liniile: atât cele roșii, cât și cele verzi, pentru a găsi linia dorită. Efectul umflării tabelului cu date inutile se numește „bloat”, care consumă și spațiul nostru pe disk. Amintiți-vă, era 2 MB, a devenit 300 MB? Acum schimbați megabiții cu gigabiți, și veți rămâne destul de repede fără resursele de disk.
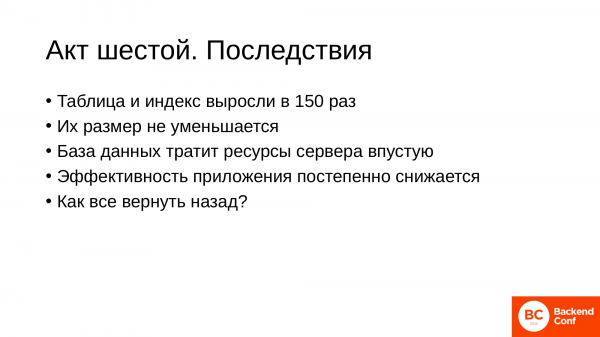
Ce consecințe pot exista pentru noi?
- În exemplul meu, tabela și indexul au crescut de 150 de ori. La unii dintre clienții noștri au existat cazuri mai fatale, când pur și simplu spațiul pe disk a început să se epuizeze.
- Dimensiunea tabelelor în sine nu se va micșora niciodată. Autovacuumul, în unele cazuri, poate tăia o porțiune de la tablă, dacă acolo sunt doar linii inactivate. Dar, deoarece are loc o rotație constantă, o linie verde poate rămâne suspendată la sfârșit și nu se va actualiza, în timp ce toate celelalte vor fi scrise undeva la începutul tabelului. Dar este un eveniment atât de improbabil, încât tabela dvs. nu se va micșora de la sine, deci nu ar trebui să sperați la asta.
- Baza de date trebuie să scaneze toate liniile inutile. Și astfel, cheltuim resursele de disk, consumăm resursele procesorului și energia electrică.
- Și acest lucru afectează direct aplicația noastră, deoarece, dacă la început cheltuiam 10 milisecunde pentru o cerere, 10 milisecunde pentru codul nostru, în timpul avariei am început să cheltuim o secundă pentru cerere și 10 milisecunde pentru cod, adică performanța aplicației a scăzut cu un ordin de magnitudine. Iar când s-a rezolvat avaria, am început să cheltuim 20 de milisecunde pentru cerere, 10 milisecunde pentru cod. Asta înseamnă că am rămas totuși cu o scădere de un și jumătate în performanță. Și totul din cauza unei singure tranzacții care a fost suspendată, posibil din vina noastră.
- Și întrebarea este: „Cum putem reveni la normal?”, astfel încât totul să funcționeze bine și cererile să fie la fel de rapide ca înainte de avarie.
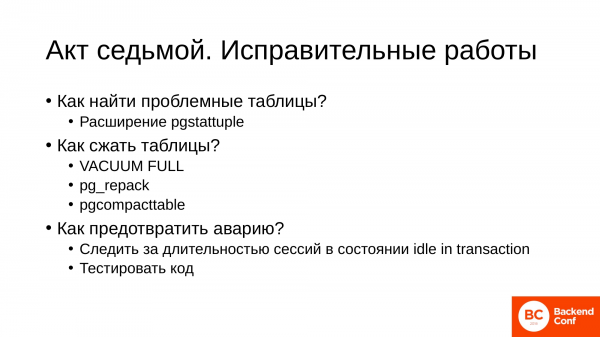
Pentru aceasta există un anumit ciclu de lucrări care se desfășoară.
Mai întâi, trebuie să găsim tabelele problematice, care s-au umflat. Înțelegem că, în funcție de anumite tabele, înregistrările se fac mai activ, iar în altele mai puțin activ. Și pentru aceasta se folosește extensia . Instalând această extensie, puteți scrie cereri care vă ajută să găsiți tabelele care s-au umflat considerabil.
După ce ați găsit aceste tabele, trebuie să le comprimați. Pentru aceasta existenția deja instrumente. În compania noastră folosim trei instrumente. Primul – VACUUM FULL încorporat. Este brutal, sever și necruțător, dar uneori este foarte util. și – sunt utilitare externe pentru comprimarea tabelelor. Și se comportă mai delicat cu baza de date.
Acestea sunt folosite în funcție de ceea ce vă este mai convenabil. Dar despre asta voi vorbi la final. Principalul lucru este că există trei instrumente. Avem de unde alege.
După ce am corectat totul, am confirmat că totul a devenit bine, trebuie să știm cum să prevenim această situație în viitor:
- Se previne destul de ușor. Trebuie să monitorizăm durata sesiunilor pe serverul Master. Sesiunile în stare de idle in transaction sunt deosebit de periculoase.Acestea sunt cele care au deschis o tranzacție, au făcut ceva și au plecat sau pur și simplu au rămas suspendate, pierdute în cod.
- Și pentru voi, ca dezvoltatori, este important să testați codul în momentul apariției acestor situații. Nu este greu de realizat. Aceasta va fi o verificare utilă. Vei evita o mulțime de probleme „copilărești” legate de tranzacții lungi.
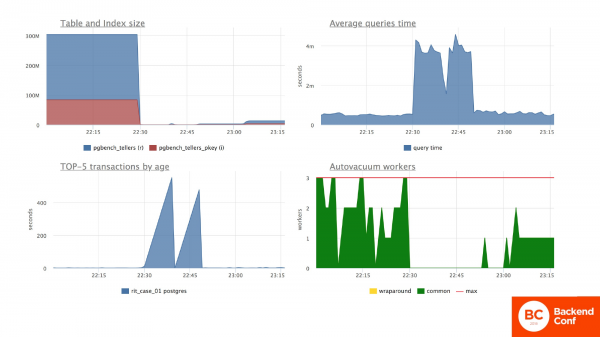
În aceste grafice, doream să vă arăt cum s-a modificat tabelul și comportamentul bazei de date după ce am aplicat VACUUM FULL pe tabel. Acesta nu este un mediu de producție.
Dimensiunea tabelului a revenit imediat la o stare normală de lucru, de câțiva megabytes. Timpul mediu de răspuns al serverului nu a fost afectat semnificativ.
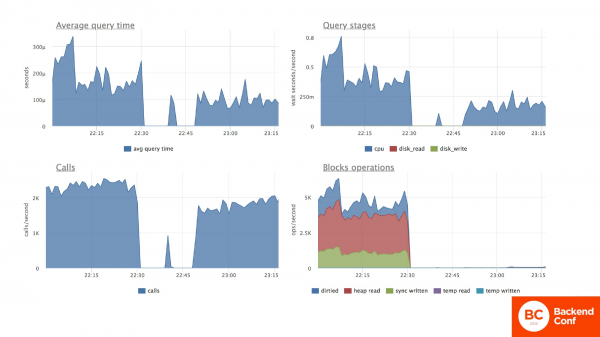
Dar, în cazul tabelului nostru testat, unde am actualizat soldurile conturilor, vedem că timpul mediu de răspuns pentru interogările de actualizare a datelor din tabel a scăzut la nivelul pre-incident. Resursele consumate de procesor pentru executarea acestei interogări au scăzut, de asemenea, la nivelul pre-incident. Iar graficul din colțul din dreapta jos arată că acum găsim exact linia de care avem nevoie imediat, fără a parcurge o mulțime de linii moarte care existau înainte de comprimarea tabelului. Timpul mediu al interogărilor a rămas aproximativ pe același nivel. Dar aici am o eroare de măsurare din partea hardware-ului meu.
Aici se încheie prima poveste. Este cea mai comună. Se întâmplă tuturor, indiferent de experiența clientului sau de cât de calificați sunt programatorii. Mai devreme sau mai târziu, acest lucru se întâmplă.
A doua poveste, în care distribuim sarcina și optimizăm resursele serverului.
- Am crescut și am devenit jucători serioși. Înțelegem că avem o replică și ar fi bine să echilibrăm sarcina: scriem pe Master și citim de pe replică. Această situație apare de obicei când dorim să pregătim rapoarte sau ETL. Iar afacerea este foarte încântată. Își dorește rapoarte diverse, cu multe analize complexe.
- Rapoartele sunt de lungă durată, pentru că analiza complexă nu poate fi realizată în milisecunde. Noi, ca băieți harnici, scriem cod. Facem în aplicație inserții, adică înregistrarea se face pe Master, iar rapoartele sunt executate pe replică.
- Distribuim sarcina.
- Totul funcționează perfect. Suntem grozavi.
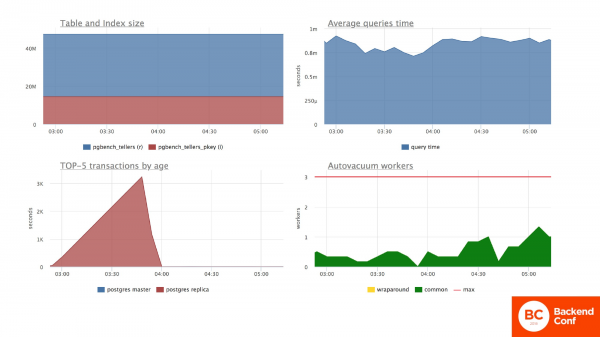
Și cum arată această situație? În mod specific, în aceste grafice am adăugat, de asemenea, durata tranzacțiilor de pe replică. Toate celelalte grafice se referă doar la serverul Master.
Tabela cu rapoartele de până acum a crescut. Au devenit mai multe. Vedem că timpul mediu de răspuns al serverului este stabil. Observăm că pe replică avem o tranzacție lungă care durează 2 ore. Vedem funcționarea lină a autovacuum-ului, care procesează liniile moarte. Totul este în regulă.
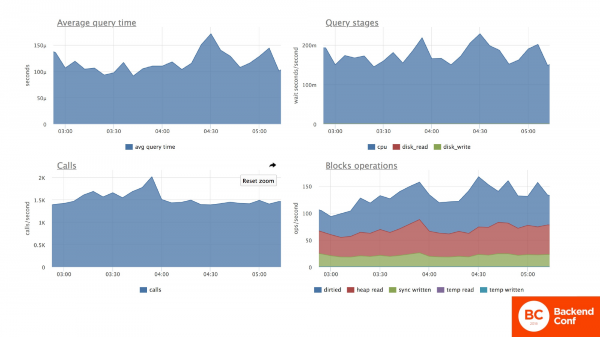
În ceea ce privește tabela testată, continuăm să actualizăm soldurile din conturi. Și avem un timp de răspuns stabil pentru cereri, consum stabil de resurse. Totul este bine.
Totul este bine până în momentul în care aceste rapoarte încep să se confrunte cu conflicte în replicare. Și se întâmplă la intervale regulate.
Intrăm pe internet și începem să citim de ce se întâmplă acest lucru. Și găsim o soluție.
Prima soluție este să creștem întârzierea replicării. Știm că raportul nostru funcționează timp de 3 ore. Stabilim întârzierea replicării - 3 ore. Pornim totul, dar avem în continuare probleme cu faptul că rapoartele uneori sunt afectate.
Vrem ca totul să fie perfect. Căutăm mai departe. Și găsim pe internet o setare interesantă - hot_standby_feedback. O activăm. Hot_standby_feedback ne permite să amânăm funcționarea autovacuum-ului pe Master. Astfel, ne eliminăm complet conflictele de replicare. Și totul funcționează bine cu rapoartele.
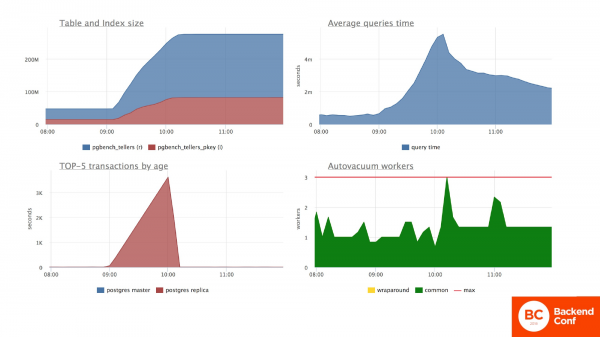
Ce se întâmplă în această perioadă cu serverul Master? Cu serverul Master, avem o problemă gravă. Acum observăm graficele, când am activat aceste două setări. Și vedem că sesiunea de pe replică a început să influențeze situația pe serverul Master. Aceasta chiar influențează, deoarece a suspendat autovacuum-ul, care curăță liniile moarte. Dimensiunea tabelei a sărit din nou în aer. Timpul mediu de execuție a cererilor în întreaga bază de date a crescut, de asemenea. Autovacuum-urile au început să fie mai solicitante.
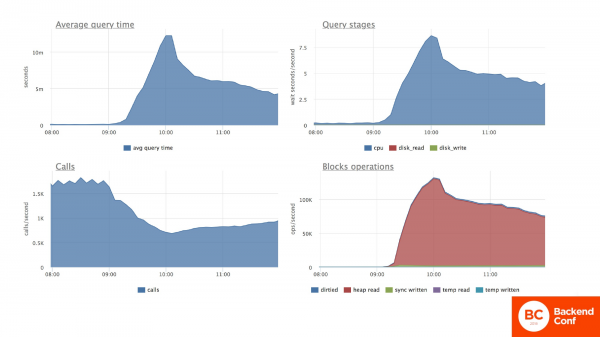
În specific pentru tabela noastră, vedem că actualizarea datelor a crescut foarte mult. Consumul de resurse CPU a crescut de asemenea dramatic. Revenim să vedem un număr mare de linii moarte inutile. Și timpul de răspuns pentru această tabelă, numărul de tranzacții a scăzut.
Cum ar arăta dacă nu știm despre ce am vorbit până acum?
- Începem să căutăm problemele. Dacă ne-am confruntat cu probleme în prima parte, știm că aceasta ar putea fi din cauza unei tranzacții lungi și ne îndreptăm spre Master. Problema este la noi pe Master. Timpul de răspuns este mare. Se supraîncălzește, are Load Average aproape de o sută.
- Solicitările sunt întârziate, dar nu vedem tranzacții lungi acolo. Și nu înțelegem de ce. Nu știm unde să căutăm.
- Verificăm echipamentul serverului. Poate că raid-ul s-a defectat. Poate că a ars o memorie. Orice s-ar putea întâmpla. Dar nu, serverele sunt noi, totul funcționează perfect.
- Toată lumea aleargă: administratori, dezvoltatori și directorul. Nimic nu ajută.
- Și, într-un anumit moment, totul începe să se corecteze de la sine.
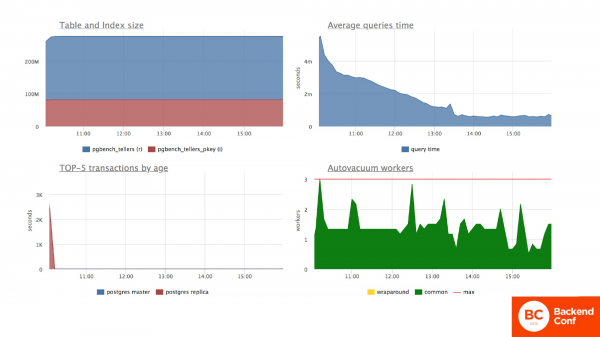
Pe replica noastră, la acel moment, o solicitare a fost procesată și a plecat. Am primit un raport. Afacerea este în continuare mulțumită. Așa cum vedem, tabelul nostru a crescut din nou și nu se va micșora. Pe graficul sesiunilor am lăsat o bucată din această tranzacție lungă de pe replica, pentru a putea evalua cât de mult timp durează până când situația se stabilizează.
Sesiunea a plecat. Și doar după un timp serverul revine într-o stare mai bună. Timpul mediu de răspuns al solicitărilor pe serverul Master revine la normal. Pentru că, în sfârșit, autovacuum a primit oportunitatea de a curăța, de a marca aceste linii moarte. Și a început să-și facă treaba. Și cu cât o face mai repede, cu atât mai repede ne vom pune în ordine.
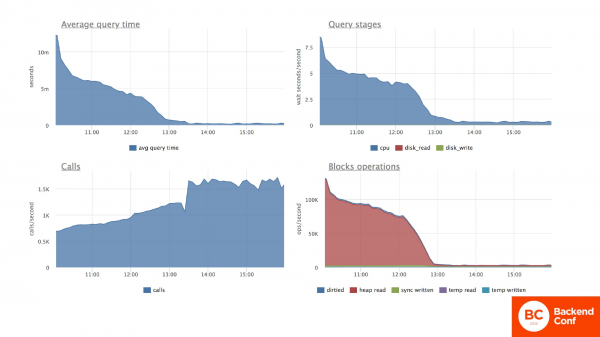
Pe tabelul testat, unde actualizăm soldurile conturilor, vedem exact aceeași imagine. Timpul mediu de actualizare a contului se normalizează treptat. Resursele consumate de procesor, de asemenea, scad. Și numărul de tranzacții pe secundă revine la normal. Dar din nou, nu la normalitatea pe care o aveam înainte de accident.
În orice caz, suferim o scădere a performanței, la fel ca și în primul caz, cu un procent de unu comma cinci până la două ori, sau chiar mai mult.
Se pare că am făcut totul corect. Am distribuit încărcătura. Echipamentul nu este inactiv. Am divizat solicitările în mod judicios, dar totuși a ieșit totul prost.
- Nu activați hot_standby_feedback? Da, nu se recomandă activarea acestuia fără motive serioase. Acest control afectează direct serverul principal și suspendă funcționarea autovacuum-ului de acolo. Activându-l pe o replică și uitând de el, puteți distruge serverul principal și veți avea mari probleme cu aplicația.
- Creșterea max_standby_streaming_delay? Da, pentru rapoarte - așa este. Dacă aveți un raport de trei ore și nu doriți să se blocheze din cauza conflictelor de replicare, atunci pur și simplu creșteți întârziera. Un raport de lungă durată nu va necesita date care au ajuns în baza de date chiar acum. Dacă raportul este de trei ore, înseamnă că îl rulați pe o perioadă mai veche de date. Deci, fie că este o întârziere de trei ore, fie de șase ore - nu va conta, dar veți primi rapoarte constant și nu veți avea probleme cu căderile acestora.
- Desigur, trebuie să monitorizăm sesiunile lungi pe replici, mai ales dacă ați decis să activați hot_standby_feedback pe replică. Pentru că poate apărea orice. Ați dat această replică unui dezvoltator pentru a testa interogările. Acesta a scris o interogare nebună. A activat-o și a plecat să bea ceai, iar noi am obținut un server principal supraîncărcat. Sau am lăsat să intre o aplicație greșită. Situațiile sunt variate. Sesiunile pe replici trebuie monitorizate la fel de atent ca cele de pe serverul principal.
- Și dacă aveți interogări rapide și lungi pe replici, în acest caz, este mai bine să le distribuiți pentru a echilibra încărcătura. Acesta este un link către streaming_delay. Pentru interogări rapide, aveți o replică cu o întârziere mică în replicare. Pentru interogările lungi de raport, aveți o replică care poate întârzia cu 6 ore sau chiar o zi. Aceasta este o situație complet normală.
Eliminăm consecințele tot prin aceeași metodă:
- Găsim tabelele umflate.
- Și le comprimăm cu cel mai convenabil instrument care ne se potrivește.
Povestea a doua s-a încheiat aici. Trecem la povestea a treia.
De asemenea, destul de obișnuită pentru noi, în care facem migrarea.
- Orice produs software crește. Cerințele la acesta se schimbă. Vrem să ne dezvoltăm în orice caz. Și se întâmplă uneori că trebuie să actualizăm datele din tabel, exact să rulăm un update în cadrul migrației noastre pentru noua funcționalitate pe care o implementăm în cadrul dezvoltării noastre.
- Formatul vechi de date nu este satisfăcător. Să presupunem că ne vom referi acum la a doua tabelă, în care am înregistrările pentru aceste conturi. Și, să zicem că acestea erau în ruble, iar noi am decis să creștem precizia și să lucrăm în copeici. Și pentru asta trebuie să facem o actualizare: câmpul cu suma operației să fie înmulțit cu o sută.
- În lumea modernă, folosim instrumente automatizate pentru controlul versiunilor bazei de date. Să presupunem că . Îl configurăm pentru migrarea noastră. O testăm pe baza noastră de teste. Totul este excelent. Actualizarea trece. Blochează activitatea pentru o vreme, dar astfel obținem date actualizate. Și putem lansa noul funcțional în acest sens. Totul a fost testat, verificat. Totul este confirmat.
- Am realizat lucrări planificate, am efectuat migrarea.
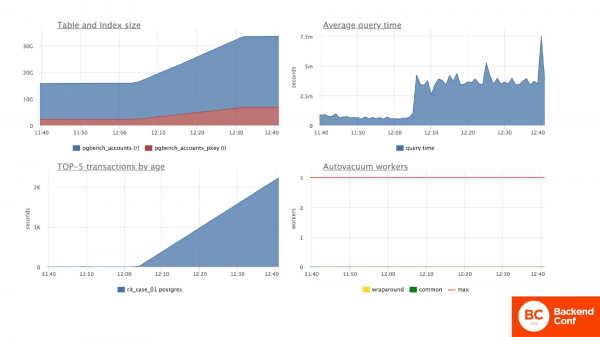
Iată migrarea cu actualizarea prezentată în fața dumneavoastră. Deoarece sunt înregistrări pentru conturi, tabela avea 15 GB. Și, deoarece actualizăm fiecare rând, am mărit tabela de două ori prin actualizare, pentru că am rescris fiecare rând.
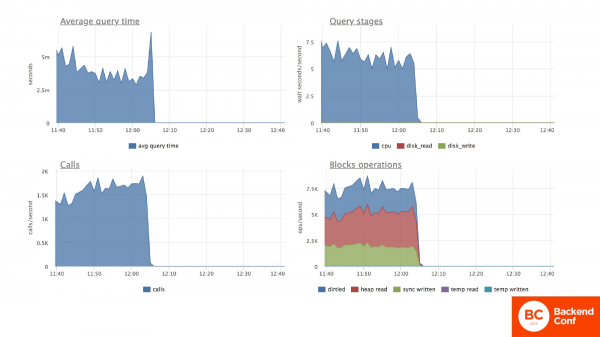
În timpul migrației, nu am putut face nimic cu această tabelă, pentru că toate cererile către ea au stat la coadă și au așteptat până când s-a încheiat această actualizare. Dar aici vreau să vă atrag atenția asupra cifrelor de pe axa verticală. Adică avem un timp mediu de cerere înainte de migrare în jur de 5 milisecunde și o încărcare pe procesor, numărul operațiunilor de blocare pentru citirea memoriei discurilor este mai mic decât 7,5.
Am efectuat migrarea și am avut din nou probleme.
Migrarea a fost un succes, dar:
- Funcționalitatea veche a început să fie mai lentă.
- Tabela a crescut din nou în dimensiuni.
- Încărcarea pe server a crescut din nou peste nivelul anterior.
- Și, desigur, deocamdată ne ocupăm cu funcționalitatea care a funcționat bine, am îmbunătățit-o puțin.
Și acesta este din nou bloat, care ne strică din nou viața.
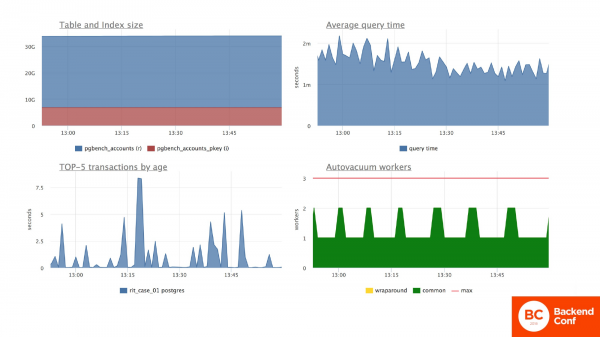
Aici demonstrez că tabela, ca în precedentele două cazuri, nu se va întoarce la dimensiunile anterioare. Încărcarea medie a serverului pare a fi adecvată.
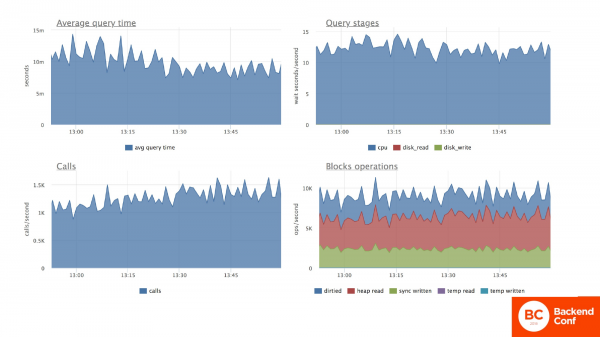
Dacă ne uităm la tabela cu conturi, vom observa că timpul mediu de solicitare a crescut de două ori pentru această tabelă. Sarcina pe procesor și numărul de rânduri scanate în memorie au sărit peste 7,5, în timp ce erau sub aceasta. A crescut de două ori în cazul procesoarelor și cu 1,5 ori în cazul operațiunilor pe blocuri, adică am avut o degradare a performanței serverului. Ca urmare – o degradare a performanței aplicației noastre. Totuși, numărul apelurilor a rămas aproximativ la același nivel.
Aici este esențial să înțelegem cum să facem corect aceste migrații. Iar acestea trebuie realizate. Facem destul de constant aceste migrații.
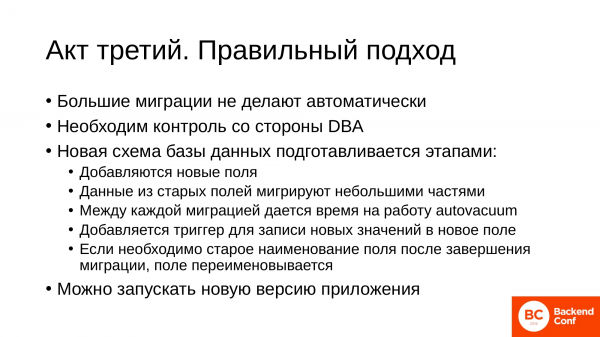
- Astfel de migrații mari nu se fac automat. Ele trebuie să fie întotdeauna controlate.
- Este necesar un control din partea unei persoane competente. Dacă aveți un DBA în echipă, lăsați-l pe acesta să se ocupe de asta. Este treaba lui. Dacă nu, atunci cea mai experimentată persoană ar trebui să se ocupe, cine știe cum să lucreze cu bazele de date.
- Schema nouă a bazei de date, chiar și în cazul în care actualizăm o coloană, o pregătim întotdeauna în etape, adică cu mult înainte de a lansa noua versiune a aplicației:
- Se adaugă noi câmpuri, în care vom scrie datele actualizate.
- Transferăm datele din câmpul vechi în cel nou în porțiuni mici. De ce facem asta? În primul rând, întotdeauna controlăm procesul acestui transfer. Știm că am transferat deja un anumit număr de loturi și ne mai rămâne atât.
- Un alt beneficiu este că între fiecare lot de acest tip, închidem o tranzacție, deschidem una nouă și acest lucru îi permite auto-vacuum-ului să funcționeze pe tabelă, marcând rândurile moarte pentru reutilizare.
- Pentru rândurile care apar în timpul funcționării aplicației (încă avem aplicația veche în funcțiune) adăugăm un trigger care scrie noi valori în câmpurile noi. În cazul nostru – este multiplicarea cu o sută a valorii vechi.
- Dacă suntem foarte încăpățânați și dorim același câmp, la finalizarea tuturor migrațiilor și înainte de a lansa noua versiune a aplicației, pur și simplu redenumim câmpurile. Pe cele vechi le denumim într-un mod inventat, iar câmpurile noi le redenumim pe cele vechi.
- Și doar după aceea lansăm noua versiune a aplicației.
În plus, nu vom obține bloat și nu vom scădea în performanță.
Aici s-a încheiat cea de-a treia poveste.
Și acum să vorbim puțin mai detaliat despre instrumentele pe care le-am menționat în prima poveste.
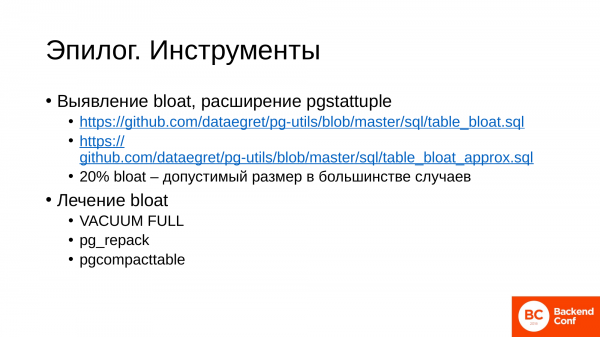
Înainte de a căuta bloat, trebuie să instalați neapărat extensia .
Pentru a nu fi nevoit să inventați interogări, noi am scris deja aceste interogări în munca noastră. Le puteți folosi. Aici sunt prezentate două interogări.
- Prima durează destul de mult, dar vă va arăta valorile exacte ale bloat-ului din tabel.
- A doua funcționează mai repede și este foarte eficientă atunci când trebuie să evaluați rapid – există bloat sau nu în tabel. De asemenea, trebuie să înțelegeți că bloat-ul în tabela Postgres există întotdeauna. Aceasta este o caracteristică a modelului său MVCC.
- Și 20% bloat este normal pentru tabele în majoritatea cazurilor. Adică, nu trebuie să vă faceți griji și să compresați această tabelă.
Cum să identificăm tabelele care s-au umflat, am înțeles, în special atunci când s-au umflat cu date inutile.
Acum despre cum să corectăm bloat-ul:
- Dacă avem o tabelă mică și discuri bune, adică pentru o tabelă de până la un gigabyte este perfect posibil să folosim VACUUM FULL. Acesta va lua o blocare exclusivă pe tabel pentru câțiva secunde și asta e, dar va face totul rapid și eficient. Ce face VACUUM FULL? Ia o blocare exclusivă pe tabel și scrie liniile active din tabelele vechi în tabelă nouă. Și la final le schimbă între ele. Dosarele vechi sunt eliminate, iar cele noi sunt înlocuite. Dar pe durata execuției sale, ia o blocare exclusivă pe tabel. Asta înseamnă că nu veți putea face nimic cu acea tabelă: nu veți putea scrie în ea, nu veți putea citi din ea, nu veți putea modifica. Și VACUUM FULL necesită spațiu suplimentar pe disc pentru a scrie datele.
- Următorul instrument . Ca principiu, este foarte asemănător cu VACUUM FULL, deoarece la fel și acesta rescrie datele din fișierele vechi în cele noi și le schimbă în tabel. Dar, în acest proces, nu ia o blocare exclusivă pe tabel la început, ci doar în momentul în care are deja datele gata pentru a schimba fișierele. Cerințele pentru resursele de disc sunt similare cu cele ale VACUUM FULL. Aveți nevoie de spațiu suplimentar pe disc, ceea ce poate fi critic, dacă aveți tabele de un terabyte. De asemenea, este destul de consumator de resurse CPU, deoarece lucrează activ cu I/O.
- Al treilea utilitar este . Aceasta are o abordare mai atentă față de resurse, deoarece funcționează pe principii ușor diferite. Esența principală a pgcompacttable este că, prin actualizările din tabel, mută toate rândurile active la începutul acestuia. Apoi, rulează un vacuum pe acest tabel, deoarece știm că avem la început rânduri active și la sfârșit rânduri moarte. Și vacuum-ul taie deja acea parte de la sfârșit, adică nu necesită mult spațiu de stocare suplimentar. În plus, acesta poate fi restrâns și din punct de vedere al resurselor.
Cu instrumentele, totul este în regulă.
Dacă v-au intrigat bloat-ul în sensul de a cerceta mai departe, iată câteva linkuri utile:
- – este o prezentare a colegului meu. Este o prezentare generală despre ce se întâmplă cu spațiul în PostgreSQL pe parcursul funcționării și existenței sale. Și acolo există o secțiune tehnică foarte mare și detaliată pentru administratorii de baze de date despre bloat.
- – acesta este un link către repository-ul nostru, unde păstrăm o mulțime de scripturi utile pentru verificarea stării bazei de date. Acolo puteți găsi scripturi pentru identificarea bloat-ului.
- și linkuri către instrumente care vă vor ajuta să restrângeți tabelele.
- – acesta este un post al colegului meu. Acolo el analizează într-un mod destul de serios și tehnic bloat-ul, la un nivel apropiat de administratorii de baze de date.
Am încercat mai mult să prezint o situație alarmantă pentru dezvoltatori, deoarece ei sunt clienții noștri direcți și trebuie să înțeleagă la ce conduc anumite acțiuni. Sper că am reușit. Vă mulțumesc pentru atenție!
Întrebări
Vă mulțumesc pentru prezentare! Ați discutat despre cum pot fi identificate problemele. Cum pot fi prevenite? Adică, am avut o situație când interogările au rămas suspendate nu doar din cauza că s-au conectat la anumite servicii externe. Au fost doar niște join-uri complicate. Au fost interogări foarte mici, inofensive, care au rămas suspendate timp de o zi, iar apoi au început să facă anumite probleme. Adică, este foarte asemănător cu ceea ce descrieți. Cum se poate monitoriza acest lucru? Trebuie să stau tot timpul să observ care interogare este suspendată? Cum se poate preveni asta?
În acest caz, aceasta este o responsabilitate pentru administratorii companiei dumneavoastră, nu neapărat pentru DBA.
Eu sunt administrator.
În PostgreSQL există o viziune numită pg_stat_activity, în care sunt afișate interogările suspendate. Și puteți vedea cât timp a rămas suspendată.
Trebuie să mă conectez și să verific la fiecare 5 minute?
Configurați cron-ul și verificați. Dacă aveți o cerere lungă, trimiteți un e-mail și gata. Adică, nu trebuie să urmăriți vizual, acest lucru poate fi automatizat. Veți primi un e-mail, iar dumneavoastră reacționați la el. Sau puteți să automatizați totul.
Există motive evidente pentru care se întâmplă acest lucru?
Am enumerat câteva. Există și alte exemple mai complexe. Și acolo discuția poate dura mult.
Mulțumesc pentru prezentare! Aș dori să clarific câteva lucruri despre utilitarul pg_repack. Dacă nu face o blocare exclusivă, atunci…
Face o blocare exclusivă.
… atunci pot pierde potențial date. Aplicația mea nu ar trebui să scrie nimic în acest timp?
Nu, funcționează fără probleme cu tabelul, adică pg_repack mută mai întâi toate înregistrările active. Evident, se face o anumită scriere în tabel. El doar adaugă acea parte de final.
Adică, la final totuși face?
La final, ia o blocare exclusivă pentru a schimba aceste fișiere între ele.
Va fi mai rapid decât VACUUM FULL?
VACUUM FULL, de îndată ce începe, ia imediat o blocare exclusivă. Și până când nu finalizează totul, nu o va elibera. În schimb, pg_repack ia o blocare exclusivă doar în momentul înlocuirii fișierelor. În acel moment nu veți putea scrie acolo, dar datele nu vor fi pierdute, totul va fi în regulă.
Bună ziua! Ați vorbit despre funcționarea autovacuum-ului. Acolo a fost un grafic cu celule roșii, galbene și verzi de înregistrare. Adică, galbene – le-a marcat ca fiind șterse. Și în consecință, în ele se pot scrie lucruri noi?
Da. Postgres nu șterge înregistrările. Are o astfel de specificație. Dacă am actualizat o înregistrare, am marcat-o pe cea veche ca fiind ștearsă. Se introduce ID-ul tranzacției care a modificat această înregistrare, iar noi înregistrăm o nouă înregistrare. Și avem sesiuni care pot să le citească potențial. La un moment dat, ele devin foarte vechi. Iar scopul autovacuum-ului este să parcurgă aceste înregistrări și să le marcheze ca fiind inutile. Și acolo se pot rescrie date.
Am înțeles. Dar întrebarea este puțin diferită. Nu am terminat. Să presupunem că avem un tabel. În el sunt câmpuri de dimensiune variabilă. Și dacă încerc să introduc ceva nou, ar putea să nu încapă în vechea celulă.
Nu, în orice caz, întreaga linie se actualizează. În Postgres există două modele de stocare a datelor. Acesta alege în funcție de tipul de date. Există date care sunt stocate direct în tabel, iar altele sunt date tos. Acestea sunt volume mari de date: text, json. Ele sunt stocate în tabele separate. Și pentru aceste tabele se aplică aceeași problemă cu bloat, adică este totul la fel. Doar că sunt separate.
Mulțumesc pentru prezentare! Cât de acceptabil este să folosim statement timeout pentru a limita durata cererilor?
Foarte acceptabil. Noi folosim asta peste tot. Și deoarece nu avem servicii proprii, oferim suport remote, avem clienți destul de variati. Și toți sunt destul de mulțumiți de asta. Adică, avem sarcini în cron care verifică. Pur și simplu se discută cu clientul despre durata sesiunilor, sub limita căreia nu intervenim. Aceasta poate fi de un minut sau de 10 minute. Depinde de încărcătura bazei de date și de scopul acesteia. Dar toți folosim pg_stat_activity.
Mulțumesc pentru prezentare! Încerc să aplic prezentarea dvs. la aplicațiile mele. Și se pare că începem tranzițiile peste tot, iar în toate le încheiem clar. Dacă iau un exception, rollback-ul are loc oricum. Și aici m-am gândit. Ar putea totuși să înceapă o tranzacție în mod implicit. Este un indiciu pentru fată, cred. Dacă pur și simplu fac o actualizare a unei înregistrări, tranzacția va începe în PostgreSQL și se va încheia doar atunci când va avea loc deconectarea?
Dacă vorbiți acum despre nivelul aplicației, depinde de driverul pe care îl folosiți, de ORM-ul utilizat. Există foarte multe setări. Dacă aveți activat auto commit on, atunci tranzacția va începe și va fi imediat încheiată.
Deci, aceasta se încheie imediat după actualizare?
Asta depinde de setări. Am menționat o setare. Este auto commit on. Este destul de comună. Dacă este activată, atunci tranzacția s-a deschis și s-a închis. Dacă nu ați spus explicit „start transaction” și „end transaction”, ci ați lansat pur și simplu o interogare în sesiune.
Bună ziua! Mulțumesc pentru prezentare! Să ne imaginăm că avem o bază de date care devine voluminoasă și aici pe server se termină spațiul. Există instrumente pentru a corecta această situație?
Spațiul pe server, în mod corect, trebuie monitorizat.
De exemplu, DBA a mers să bea ceai, era în vacanță etc.
Când se creează un sistem de fișiere, există cel puțin un spațiu rezervat creat, unde nu sunt scrise date.
Dar dacă este complet zero?
Se numește spațiu rezervat, adică se poate elibera, iar în funcție de cât de mare a fost creat, obțineți spațiu liber. În mod implicit, nu știu cât este acolo. În alt caz, trebuie să livrați discuri pentru a avea loc pentru a efectua operațiunea de recuperare. Puteți șterge o tabelă care, cu siguranță, nu vă mai este necesară.
Nu există alte instrumente?
Este întotdeauna o muncă manuală. Și la fața locului se stabilește ce ar trebui să se facă, pentru că există date critice și date non-critice. Și pentru fiecare bază de date și aplicație care lucrează cu aceasta, depinde de afacere. Este întotdeauna decizia luată la fața locului.
Mulțumesc pentru prezentare! Am două întrebări. În primul rând, ați demonstrat diapozitive în care ați arătat că, în caz de tranzacții suspendate, atât volumul spațiului tabelar, cât și dimensiunea indexului cresc. Și mai departe în prezentare au fost o mulțime de utilitare care compactează tabela. Dar ce se întâmplă cu indexul?
Ele compactizează și indexele.
Dar vacuumul nu atinge indexul?
Unele lucrări cu indexul. De exemplu, pg_rapack, pgcompacttable. Vacuumul recreează indexurile, le afectează. Scopul VACUUM FULL este să rescrie totul, adică lucrează cu toate.
Și a doua întrebare. Nu am înțeles de ce rapoartele de pe replici depind atât de mult de replicare. Mi se părea că rapoartele sunt citiri, iar replicarea este scriere.
În ce constă conflictul de replicare? Avem un Master, pe care se desfășoară procese. Avem un autovacuum. Ce face, de fapt, autovacuumul? Eliminază anumite rânduri vechi. Dacă în acel timp pe replică există o cerere care citește acele rânduri vechi, iar pe Master a avut loc o situație în care autovacuumul a marcat acele rânduri ca fiind posibile pentru rescriere, atunci le-am rescris. Și ne-a venit un pachet de date când trebuie să rescriem acele rânduri necesare cererii de pe replică, procesul de replicare va aștepta acel timeout pe care l-ați configurat. Apoi, PostgreSQL va decide ce este mai important pentru el. Iar replicarea este mai importantă decât cererea și aceasta va fi respinsă pentru a efectua modificările pe replică.
Andrei, am o întrebare. Aceste grafice minunate pe care le-ai arătat în timpul prezentării sunt rezultatul unor lucrări ale unei utilitare de-a voastră? Cu ce a fost creată grafica?
Este un serviciu .
Este un produs comercial?
Da. Este un produs comercial.
Sursa: habr.com
