

Pe măsură ce adresele IPv4 se epuizează, mulți operatori de telecomunicații s-au confruntat cu nevoia de a organiza accesul clienților lor la rețea prin traducerea adreselor. În acest articol, voi explica cum se poate obține o performanță de nivel Carrier Grade NAT pe servere de tip commodity.
Puțin istorie
Tema epuizării spațiului de adrese IPv4 nu mai este nouă. La un moment dat, în RIPE au apărut liste de așteptare (waiting list), apoi au apărut burse pe care erau tranzacționate blocuri de adrese și se încheiau contracte pentru închirierea acestora. Treptat, operatorii de telecomunicații au început să ofere servicii de acces la internet prin traducerea adreselor și a porturilor. Unii nu au reușit să obțină suficiente adrese pentru a oferi o adresă „albă” fiecărui abonat, iar alții au început să economisească resurse refuzând achiziționarea de adrese pe piața secundară. Producătorii de echipamente de rețea au sprijinit această idee, deoarece această funcționalitate necesită de obicei module suplimentare sau licențe. De exemplu, la Juniper, în gama de routere MX (cu excepția ultimelor MX104 și MX204), NAPT poate fi realizat pe un card de serviciu separat MS-MIC, iar pentru Cisco ASR1k este necesară o licență CGN, în timp ce pentru Cisco ASR9k este necesar un modul separat A9K-ISM-100 și o licență A9K-CGN-LIC. În general, plăcerea are un cost destul de ridicat.
IPTables
Sarcina de a efectua NAT nu necesită resurse computaționale specializate; aceasta poate fi rezolvată de procesoare generice, care sunt instalate, de exemplu, în orice router de acasă. La scară de operator de telecomunicații, această problemă poate fi rezolvată folosind servere commodity care rulează FreeBSD (ipfw/pf) sau GNU/Linux (iptables). Nu vom lua în considerare FreeBSD, deoarece am renunțat la utilizarea acestui sistem de operare cu ceva timp în urmă, așa că ne vom concentra pe GNU/Linux.
Activarea traducerii adreselor nu este deloc complicată. În primul rând, este necesar să se scrie o regulă în iptables în tabelul nat:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Sistemul de operare va încărca modulul nf_conntrack, care va monitoriza toate conexiunile active și va efectua transformările necesare. Aici există câteva subtilități. În primul rând, având în vedere că este vorba despre NAT la scară de operator de telecomunicații, este necesar să ajustăm timeout-urile, deoarece cu valorile implicite, dimensiunea tabelului de conversie va crește rapid la valori catastrofale. Mai jos este un exemplu de configurare pe care l-am folosit pe serverele mele:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
În al doilea rând, având în vedere că dimensiunea tabelului de conversie nu este calculată în mod implicit pentru a funcționa în condițiile unui operator de telecomunicații, aceasta trebuie să fie crescută:
net.netfilter.nf_conntrack_max = 3145728
De asemenea, este necesar să creștem și numărul de buckets pentru tabelul hash care păstrează toate conversiile (aceasta este o opțiune a modulului nf_conntrack):
options nf_conntrack hashsize=1572864
După aceste manevre simple, obținem o structură funcțională, care poate traduce un număr mare de adrese de client în pool-ul extern. Cu toate acestea, performanța acestei soluții lasă de dorit. În primele mele încercări de utilizare a GNU/Linux pentru NAT (aproximativ 2013), am reușit să obțin o performanță de aproximativ 7Gbit/s la 0.8Mpps pe un server (Xeon E5-1650v2). De atunci, în stiva de rețea a nucleului GNU/Linux au fost efectuate multe optimizări diferite, iar performanța unui singur server pe același hardware a crescut practic la 18-19 Gbit/s la 1.8-1.9 Mpps (acestea au fost valorile maxime), dar cerința privind volumul de trafic procesat de un singur server a crescut mult mai repede. În consecință, au fost dezvoltate scheme de echilibrare a încărcării pe diferite servere, însă toate acestea au crescut complexitatea configurării, întreținerii și menținerii calității serviciilor oferite.
NFTables
În prezent, o direcție populară în "manipularea pachetelor" este utilizarea DPDK și XDP. Pe această temă au fost scrise multe articole, au avut loc diverse prezentări și au apărut produse comerciale (de exemplu, SKAT de la VasExperts). Însă, în condițiile resurselor limitate ale programatorilor din cadrul operatorilor de telecomunicații, este destul de problematic să dezvoltăm o soluție „artizanală” bazată pe aceste cadre. Utilizarea unei astfel de soluții în continuare va fi mult mai complicată, în special va trebui să dezvoltăm instrumente de diagnoză. De exemplu, tcpdump standard nu va funcționa cu DPDK, iar pachetele trimise înapoi prin cabluri folosind XDP nu vor fi "vizibile". În acest context, toate discuțiile despre noile tehnologii de redirecționare a pachetelor în user-space au rămas nefavorizate. și Pablo Neira Ayuso, întreținătorul iptables, despre dezvoltarea flow offloading în nftables. Să vedem acest mecanism mai în detaliu.
Ideea principală este că, dacă routerul a permis pachetele unei sesiuni în ambele direcții ale fluxului (sesiunea TCP a trecut în starea ESTABLISHED), nu este necesar să permită pachetele ulterioare ale acestei sesiuni să treacă prin toate regulile firewall-ului, deoarece toate aceste verificări se vor încheia cu transmiterea pachetului mai departe în rutare. De asemenea, nu trebuie să luăm o decizie privind ruta — știm deja pe ce interfață și către ce host trebuie să direcționăm pachetele în cadrul acestei sesiuni. Rămâne doar să păstrăm această informație și să o utilizăm pentru rutare în stadiul incipient al procesării pachetului. La efectuarea NAT, este necesar să păstrăm informația despre modificările adreselor și porturilor, transformate de modulul nf_conntrack. Da, desigur, în acest caz nu vor mai funcționa diferite poliseri și alte reguli informaționale-statistice în iptables, dar în contextul unei sarcini individuale a unui NAT separat sau, de exemplu, a unei margini — acest lucru nu este atât de important, deoarece serviciile sunt distribuite pe dispozitive.
Configurație
Pentru a beneficia de această funcție, trebuie să:
- Folosim un kernel proaspăt. Deși funcționalitatea a apărut prima dată în kernel 4.16, a fost destul de „brută” și a cauzat în mod regulat kernel panic. Totul s-a stabilizat în jurul lunii decembrie 2019, când au fost lansate kernel-urile LTS 4.19.90 și 5.4.5.
- Rescrieți regulile iptables în format nftables, folosind o versiune destul de recentă de nftables. Funcționează perfect în versiunea 0.9.0
Dacă primul punct este, în principiu, clar, principalul lucru este să nu uitați să activați modulul în configurație la compilare (CONFIG_NFT_FLOW_OFFLOAD=m), atunci al doilea punct necesită explicații. Regulile nftables sunt descrise cu totul diferit față de iptables. acoperă practic toate aspectele, există, de asemenea, convertizoare speciale Configurarea NAT este foarte simplă:
Cu flow offload este puțin mai complicat, dar destul de clar:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Iată, de fapt, toată configurarea. Acum tot traficul TCP/UDP va ajunge în tabela fastnat și va fi procesat mult mai repede.
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
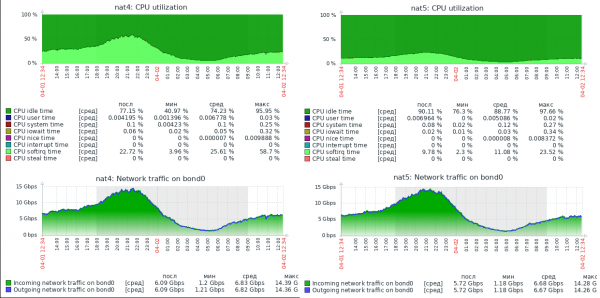
Pentru a înțelege cât de mult mai repede este, voi atașa o captură de ecran a sarcinii pe două servere reale, cu aceeași configurație (Xeon E5-1650v2), configurate în mod identic, folosind același nucleu Linux, dar realizând NAT în iptables (NAT4) și în nftables (NAT5).
Rezultate
Pe captura de ecran nu există un grafic al pachetelor pe secundă, dar în profilul de sarcină al acestor servere, dimensiunea medie a pachetului este în jur de 800 de octeți, așa că valorile ajung până la 1.5Mpps. Așa cum se poate observa, rezervele de performanță ale serverului cu nftables sunt uriașe. În acest moment, acest server procesează până la 30Gbit/s la 3Mpps și este clar capabil să atingă limitarea fizică a rețelei de 40Gbps, având totodată resurse CPU libere.
Sper că acest material va fi util pentru inginerii de rețea care încearcă să îmbunătățească performanța serverelor lor.
Pe măsură ce adresele IPv4 se epuizează, mulți operatori de telecomunicații s-au confruntat cu necesitatea de a organiza accesul clienților lor la rețea prin translatarea adreselor.
Sursa: habr.com
