

Salut, Habr! Numele meu este Maxim Vasiliev, sunt analist și manager de proiecte la FINCH. Astăzi aș dori să vă povestesc cum, cu ajutorul ElasticSearch, am reușit să procesăm 15 milioane de cereri în 6 minute și să optimizăm sarcinile zilnice pe site-ul unuia dintre clienții noștri. Din păcate, va trebui să ne descurcăm fără nume, deoarece avem un NDA, sperăm că conținutul articolului nu va avea de suferit. Să începem.
Cum este structurat proiectul
Pe backend-ul nostru, creăm servicii care asigură funcționalitatea site-urilor și aplicației mobile a clientului nostru. Structura generală poate fi văzută în schemă:
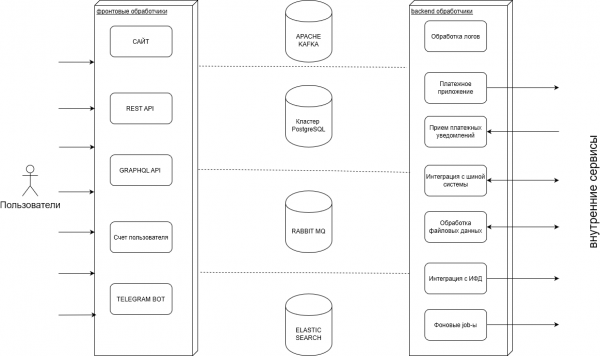
În procesul de lucru, procesăm un număr mare de tranzacții: achiziții, plăți, operațiuni cu soldurile utilizatorilor, pentru care păstrăm multe log-uri, precum și importăm și exportăm aceste date către sisteme externe.
De asemenea, există și procese inverse, când primim date de la client și le transferăm utilizatorilor. În plus, există procese legate de plăți și programele de recompense.
O scurtă istorie
Inițial, am folosit PostgreSQL ca singură bază de date. Avantajele sale standard ca SGBD: existența tranzacțiilor, un limbaj de interogare dezvoltat, un instrumentar larg pentru integrare; combinate cu o performanță bună, ne-au satisfăcut nevoile pentru o perioadă îndelungată.
Păstram în Postgres absolut toate datele: de la tranzacții la știri. Dar numărul utilizatorilor creștea, iar odată cu el și numărul cererilor.
Pentru a înțelege, numărul anual de sesiuni în 2017 doar pe site-ul desktop a fost de 131 milioane. În 2018 – 125 milioane. În 2019 din nou 130 milioane. Adăugați încă 100-200 milioane din versiunea mobilă a site-ului și aplicația mobilă, și veți obține un număr colosal de cereri.
Pe măsură ce proiectul a crescut, Postgres a încetat să facă față sarcinilor; nu reușeam să ne descurcăm – a apărut un număr mare de diverse cereri pentru care nu am putut crea suficiente indexuri.
Am realizat că există nevoie de alte stocări de date care să ne satisfacă cerințele și să reducă sarcina pe PostgreSQL. Ca opțiuni posibile, am luat în considerare Elasticsearch și MongoDB. Ultimul a pierdut în privința următoarelor puncte:
- Viteza lentă de indexare cu creșterea volumului de date în indecși. La Elastic, viteza nu depinde de volumul de date.
- Lipsa căutării full-text
Astfel, am ales Elastic și ne-am pregătit pentru tranziție.
Tranziția la Elastic
1. Am început tranziția cu serviciul de căutare a punctelor de vânzare. Clientul nostru are în total aproximativ 70.000 de puncte de vânzare, iar pentru aceasta sunt necesare mai multe tipuri de căutare pe site și în aplicație:
- Căutare text după denumirea localității.
- Geocăutare într-un anumit radius de un punct. De exemplu, dacă utilizatorul dorește să vadă care puncte de vânzare sunt cele mai apropiate de casa sa.
- Căutare pe un pătrat dat – utilizatorul desenează un pătrat pe hartă, iar el îi sunt arătate toate punctele din acest radius.
- Căutare după filtre suplimentare. Punctele de vânzare se diferențiază între ele prin sortiment.
Când vorbim despre organizare, în Postgres avem sursa de date atât pentru hărți, cât și pentru știri, iar în Elastic facem snapshot-uri de la datele originale. Motivul este că, inițial, Postgres nu putea gestiona căutarea pe toate criteriile. Cu atât de multe indecși, care se puteau și intersecta, planificatorul Postgres se pierdea și nu înțelegea care index să utilizeze.
2. Următorul pe listă a fost secțiunea de știri. Pe site apar publicații zilnic, astfel încât utilizatorul să nu se piardă în fluxul de informații, datele trebuie sortate înainte de a fi afișate. De aceea avem nevoie de căutare: pe site se poate căuta după potrivirea textului și, de asemenea, se pot adăuga filtre suplimentare, deoarece acestea sunt de asemenea gestionate prin Elastic.
3. Apoi, am mutat procesarea tranzacțiilor. Utilizatorii pot cumpăra un anumit produs pe site și pot participa la extrageri de premii. După astfel de achiziții, procesăm o cantitate mare de date, în special în week-end-uri și sărbători. Ca și comparație, în zilele obișnuite, numărul achizițiilor se ridică la 1,5-2 milioane, iar în sărbători cifra poate atinge 53 de milioane.
În același timp, datele trebuie procesate într-un timp minim — utilizatorii nu iubesc să aștepte câteva zile pentru rezultate. Prin Postgres nu se pot obține astfel de termene — adesea primeam blocaje, iar în timp ce procesam toate solicitările, utilizatorii nu puteau verifica dacă au câștigat premii sau nu. Acest lucru nu este foarte plăcut pentru afacere, așa că am mutat procesarea în Elasticsearch.
Periodicitate
Acum actualizările sunt configurate pe baza evenimentelor, în următoarele condiții:
- Puncte de vânzare. De îndată ce primim date dintr-o sursă externă, pornim imediat actualizarea.
- Știri. De îndată ce se editează o știre pe site, aceasta este de asemenea trimisă în Elastic.
Este important să menționăm din nou avantajele Elastic. În Postgres, în timpul trimiterii unei cereri, trebuie să aștepți până procesul finalizează toate înregistrările. În Elastic poți trimite 10.000 de înregistrări și să începi imediat să lucrezi, fără a aștepta ca înregistrările să se răspândească prin toate Shards. Desigur, un anumit Shard sau Replica pot să nu vadă imediat datele, dar foarte curând totul va fi disponibil.
Modalități de integrare
Există 2 modalități de integrare cu Elastic:
- Prin clientul nativ pe TCP. Driverul nativ este pe cale de dispariție: nu mai este susținut, are o sintaxă foarte incomodă. Prin urmare, practic nu-l folosim și ne străduim să ne desprindem complet de el.
- Prin interfața HTTP, în care se pot folosi atât cereri JSON, cât și sintaxa Lucene. Ultima este un motor text care folosește Elastic. În acest caz, obținem posibilitatea de Batch prin cereri JSON pe HTTP. Acestă variantă încercăm să o utilizăm.
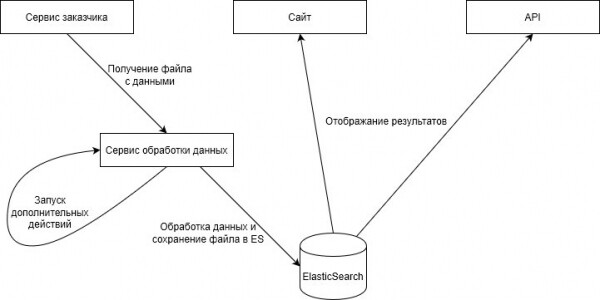
Datorită interfeței HTTP, putem folosi biblioteci care oferă o implementare asincronă a clientului HTTP. Putem beneficia de avantajele Batch și API-ului asincron, ceea ce în final ne oferă o performanță ridicată, care ne-a ajutat foarte mult în zilele de mari campanii (despre asta mai jos)
Câteva cifre pentru comparație:
- Menținerea utilizatorilor care au câștigat premii în Postgres în 20 de fire fără grupări: 460713 înregistrări în 42 de secunde
- Elastic + client reactiv pe 10 fire + batch de 1000 de elemente: 596749 înregistrări în 11 secunde
- Elastic + client reactiv pe 10 fire + batch de 1000 de elemente: 23801684 înregistrări în 4 minute
Acum am scris un manager de cereri pe HTTP, care construiește JSON, fie Batch/fie ne-Batch și trimite prin orice client HTTP, indiferent de bibliotecă. De asemenea, se poate alege să se trimită cererile în mod sincron sau asincron.
În anumite integrări, încă folosim clientul de transport oficial, dar aceasta este doar o chestiune de refactorizare iminentă. În același timp, pentru procesare se folosește un client propriu, construit pe baza Spring WebClient.
Campanie mare
O dată pe an, proiectul organizează o mare campanie pentru utilizatori — acesta este adevăratul Highload, deoarece în această perioadă lucrăm cu zeci de milioane de utilizatori simultan.
De obicei, picoanele de încărcare au loc în zilele de sărbătoare, dar această campanie este un alt nivel. În urmă cu doi ani, în ziua campaniei, am vândut 27 580 890 de articole. Datele au fost procesate timp de mai bine de o jumătate de oră, ceea ce a creat inconveniente pentru utilizatori. Utilizatorii au primit premii pentru participare, dar a devenit clar că procesul trebuie accelerat.
La începutul anului 2019, am decis că avem nevoie de ElasticSearch. Un întreg an am organizat procesarea datelor primite în Elastic și livrarea acestora prin api pentru aplicația mobilă și site. În cele din urmă, anul următor, în timpul campaniei, am procesat 15 131 783 de înregistrări în 6 minute.
Deoarece avem mulți doritori să cumpere produse și să participe la extragerea premiilor în campanii, aceasta este o măsură temporară. Acum trimitem informațiile actualizate în Elastic, dar planificăm să transferăm informațiile arhivate din lunile anterioare în Postgres, ca depozit permanent. Pentru a nu aglomera indicele Elastic, care are și el propriile sale limitări.
Concluzie/rezultate
În prezent, am transferat în Elastic toate serviciile pe care le-am dorit și, deocamdată, am făcut o pauză. Acum construim un indice în Elastic deasupra depozitului nostru persistent din Postgres, care preia sarcina utilizatorilor.
În continuare, planificăm să transferăm serviciile dacă înțelegem că cererea de date devine prea diversificată și este căutată pe un număr nelimitat de coloane. Aceasta este deja o sarcină care nu se potrivește cu Postgres.
Dacă vom avea nevoie de căutare cu text complet în funcționalitate sau dacă vor apărea multe criterii de căutare variate, atunci știm deja că trebuie să le transferăm în Elastic.
⌘⌘⌘
Merci că ați citit. Dacă în compania voastră se folosește și ElasticSearch și aveți propriile cazuri de implementare, împărtășiți-le. Va fi interesant să aflăm cum se descurcă ceilalți 🙂
Sursa: habr.com
