

Introducere
 „Trebuie să alergi cât de repede poți doar pentru a rămâne pe loc,
iar pentru a ajunge undeva, trebuie să alergi de cel puțin două ori mai repede!”
(c) Alice în țara minune
Cu ceva timp în urmă, am fost rugat să citesc o prelegere analiștilor companiei noastre pe tema proiectării modelelor de date, deoarece stând mult timp pe proiecte (uneori câțiva ani), pierdem din vedere ce se întâmplă în jur în lumea tehnologiilor IT. În compania noastră (așa a ieșit) la multe dintre proiecte nu se folosesc baze de date NoSQL (cel puțin deocamdată), așa că, în prelegerea mea, am acordat o atenție separată acestora pe exemplul HBase și am încercat să orientez materialul pentru cei care nu au lucrat niciodată cu ele. În special, am ilustrat câteva aspecte ale proiectării modelului de date printr-un exemplu pe care l-am citit cu câțiva ani în urmă Analizând exemplele, am comparat mai multe soluții pentru aceeași problemă, pentru a transmite mai bine ideile principale către ascultători.
Recent, „de plictiseală”, m-am întrebat (lungile weekenduri de mai în regim de carantină favorizează acest lucru) cât de mult vor corespunde teoriile cu practica? Așa s-a născut ideea acestui articol. Un dezvoltator care lucrează de mult timp cu NoSQL poate nu va învăța nimic nou din el (și, prin urmare, poate să sară direct la jumătatea articolului). Dar pentru analiștii, care nu au lucrat îndeaproape cu NoSQL, cred că va fi util pentru a obține o înțelegere de bază a specificităților proiectării modelelor de date pentru HBase.
Analiza unui exemplu
Din punctul meu de vedere, înainte de a începe utilizarea bazelor de date NoSQL, este necesar să reflectăm bine și să cântărim „pro” și „contra”. Adesea, sarcina poate fi soluționată mai degrabă folosind SGBD-uri relaționale tradiționale. Prin urmare, este mai bine să nu folosim NoSQL fără motive solide. Dacă totuși s-a decis utilizarea unei baze de date NoSQL, trebuie să ținem cont că abordările de proiectare sunt ceva diferite. În special, unele dintre ele pot fi neobișnuite pentru cei care au lucrat până acum doar cu SGBD-uri relaționale (după observațiile mele). Astfel, în lumea „relațională” de obicei plecăm de la modelarea domeniului subiectului și apoi, la nevoie, facem denormalizarea modelului. În NoSQL însă, trebuie să luăm imediat în considerare scenariile de lucru cu datele și să denormalizăm datele de la început. În plus, există o serie de alte diferențe, despre care va fi discutat mai jos.
Să luăm în considerare următoarea sarcină „sintetică”, cu care vom lucra în continuare:
Trebuie să proiectăm structura de stocare a listei de prieteni ai utilizatorilor unei rețele sociale abstracte. Pentru simplificare, vom presupune că toate legăturile sunt direcționate (așa cum este în Instagram, nu în Linkedin). Structura trebuie să permită eficient:
- Răspunsul la întrebarea dacă utilizatorul A îl citește pe utilizatorul B (șablon de citire)
- Permițând adăugarea/ștergerea legăturilor în cazul în care utilizatorul A se abonează/dezabonază de la utilizatorul B (șablon de modificare a datelor)
Desigur, există multe variante de soluționare a sarcinii. Într-o bază de date relațională obișnuită, am fi creat cel mai probabil pur și simplu un tabel de legături (eventual tipizat, dacă, de exemplu, este necesară stocarea grupului de utilizatori: familie, muncă etc., din care face parte acest „prieten”), iar pentru a optimiza viteza de acces am fi adăugat indecși/partiționare. Cel mai probabil, tabelul final ar arăta aproximativ așa:
user_id
friend_id
Vasya
Petya
Vasya
Olya
aici și mai departe, pentru claritate și o mai bună înțelegere, în loc de ID voi indica numele
În cazul HBase, știm că:
- căutarea eficientă, care nu duce la un full table scan, este posibilă exclusiv pe cheie
- De fapt, acesta este motivul pentru care a scrie interogări SQL obișnuite pentru astfel de baze de date reprezintă o idee proastă; tehnic, desigur, poți trimite o interogare SQL cu Join-uri și alte logici din Impala către HBase, dar cât de eficient va fi asta...
Prin urmare, suntem nevoiți să folosim ID-ul utilizatorului ca cheie. Prima idee despre „unde și cum să stocăm ID-urile prietenilor?” ar putea fi stocarea lor în coloane. Această variantă evidentă și „naivă” ar arăta cam așa (să-i spunem Varianta 1 (implicit), pentru a ne putea referi ulterior la ea):
RowKey
Coloane
Vasya
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Aici, fiecare rând corespunde unui utilizator al rețelei. Coloanele au numele: 1, 2, … - conform numărului de prieteni, iar în coloane sunt stocate ID-urile prietenilor. Este important de remarcat că fiecare rând va avea un număr diferit de coloane. În exemplul de mai sus, un rând are trei coloane (1, 2 și 3), iar al doilea – doar două (1 și 2) – aici am folosit cele două proprietăți ale HBase care nu există în bazele de date relaționale:
- capacitatea de a schimba dinamic compunerea coloanelor (adăugăm un prieten -> adăugăm o coloană, ștergem un prieten -> ștergem o coloană)
- diferite rânduri pot avea o compunere diferită a coloanelor
Să verificăm structura noastră pentru conformitatea cu cerințele problemei:
- Citirea datelor: pentru a înțelege dacă Vasya este abonat la Olya, va trebui să citim întregul rând după cheia RowKey = „Vasya” și să parcurgem valorile coloanelor, până o „întâlnim” în ele pe Olya. Sau să parcurgem valorile tuturor coloanelor, „fără a întâlni” pe Olya și să returnăm răspunsul False;
- Modificarea datelor: adăugarea unui prieten: pentru o astfel de sarcină va trebui, de asemenea, să citim întregul rând după cheia RowKey = „Vasya”, pentru a număra totalul prietenilor săi. Acest număr total de prieteni este necesar pentru a determina numărul coloanei în care trebuie să scriem ID-ul noului prieten.
- Modificarea datelor: ștergerea unui prieten:
- Este necesar să citim întregul rând după cheia RowKey = „Vasya” și să parcurgem coloanele pentru a găsi pe cea în care este înregistrat prietenul șters;
- Apoi, după ce ștergem prietenul, va trebui să „mutăm” toate datele cu o coloană, pentru a evita „găurile” în numerotarea lor.
Să evaluăm acum cât de eficiente vor fi aceste algoritmi pe care va trebui să le implementăm pe „latura aplicației presupuse” utilizând . Să desemnăm dimensiunea rețelei noastre sociale ipotetice ca n. Atunci numărul maxim de prieteni pe care un utilizator îl poate avea este (n-1). Această (-1) o putem neglija mai departe pentru scopurile noastre, deoarece în cadrul utilizării simbolicii O este nesemnificativă.
- Citirea datelor: trebuie să extragem întreaga linie și să parcurgem în limita tuturor coloanelor sale. Asta înseamnă că evaluarea superioară a costurilor va fi de aproximativ O(n)
- Modificarea datelor: adăugarea unui prieten: pentru a determina numărul de prieteni este necesar să parcurgem toate coloanele liniei, după care să inserăm o nouă coloană => O(n)
- Modificarea datelor: ștergerea unui prieten:
- Similar cu adăugarea – este necesar, în limită, să parcurgem toate coloanele => O(n)
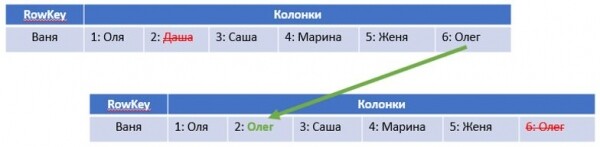
- După ștergerea coloanelor, trebuie să le „împingem”. Dacă realizăm acest lucru „în mod direct”, atunci va necesita, în limită, încă până la (n-1) operații. Dar noi aici și mai departe în partea practică vom aplica o altă abordare, care va implementa un „pseudo-împingere” într-un număr fix de operații – adică, va consuma timp constant, indiferent de n. Acest timp constant (dacă vrem să fim preciși, O(2)) poate fi neglijat în comparație cu O(n). Abordarea este ilustrată în imaginea de mai jos: pur și simplu copiem datele din „ultima” coloană în cea din care trebuie să ștergem datele, după care ștergem ultima coloană:

Prin urmare, în toate scenariile am obținut o complexitate computațională asimptotică O(n).
Probabil că ați observat deja că trebuie să extragem aproape întotdeauna întreaga linie din bază, iar în două din cele trei cazuri, doar pentru a parcurge toate coloanele și a număra numărul total de prieteni. Așadar, ca o încercare de optimizare, putem adăuga o coloană „count”, în care să stocăm numărul total de prieteni ai fiecărui utilizator din rețea. În acest caz, putem să nu extragem întreaga linie pentru a număra numărul total de prieteni, ci să citim doar o coloană „count”. Principalul lucru este să nu uităm să actualizăm „count” când manipulăm datele. Astfel, obținem o îmbunătățire Opțiunea 2 (count):
RowKey
Coloane
Vasya
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
Comparativ cu prima opțiune:
- Citirea datelor: pentru a obține răspunsul la întrebarea „Citește Olya?” nu s-a schimbat nimic => O(n)
- Modificarea datelor: adăugarea unui prieten: Am simplificat inserarea unui nou prieten, deoarece acum nu mai trebuie să citim întreaga linie și să parcurgem coloanele acesteia, ci putem obține doar valoarea coloanei „count” și, astfel, să determinăm imediat numărul coloanei pentru inserarea noului prieten. Aceasta duce la reducerea complexității computaționale la O(1)
- Modificarea datelor: ștergerea unui prieten: La ștergerea unui prieten, putem de asemenea să ne folosim de această coloană pentru a reduce numărul operațiunilor de intrare-ieșire în timpul „deplasării” datelor cu o celulă la stânga. Totuși, necesitatea de a parcurge coloanele pentru a găsi pe cea care trebuie ștearsă rămâne, așadar => O(n)
- Pe de altă parte, acum, la actualizarea datelor, trebuie să actualizăm de fiecare dată și coloana „count”, dar aceasta durează un timp constant, care în cadrul simbolicii O poate fi neglijat
În general, varianta 2 pare a fi puțin mai optimizată, dar mai degrabă este o „evoluție în loc de o revoluție”. Pentru a realiza o „revoluție”, avem nevoie de Varianta 3 (col).
Să întoarcem totul „cu susul în jos”: să desemnăm numele coloanei ca identificator al utilizatorului! Ce va fi scris în coloana însăși – pentru noi nu mai contează, să fie cifra 1 (de fapt, acolo putem păstra de exemplu, grupul „familie/prieteni/și altele”). Această abordare poate surprinde un „neavizat” nepregătit, care nu a avut experiență cu baze de date NoSQL, dar tocmai acesta permite utilizarea potențialului HBase în această sarcină mult mai eficient:
RowKey
Coloane
Vasya
Peti: 1
Olia: 1
Dașa: 1
Petya
Mașa: 1
Vasia: 1
Aici obținem imediat mai multe avantaje. Pentru a le înțelege, să analizăm noua structură și să evaluăm complexitatea computațională:
- Citirea datelor: pentru a răspunde la întrebarea dacă Vasia este abonat la Olia, este suficient să citim o singură coloană „Olia”: dacă aceasta există, atunci răspunsul este True, dacă nu – False => O(1)
- Modificarea datelor: adăugarea unui prieten: Adăugarea unui prieten: este suficient să adăugăm o nouă coloană „ID prieten” => O(1)
- Modificarea datelor: ștergerea unui prieten: este suficient să ștergem coloana „ID prieten” => O(1)
După cum vedem, un avantaj semnificativ al acestui model de stocare este că, în toate scenariile necesare, operăm doar cu o singură coloană, evitând să citim întreaga linie din baza de date și cu atât mai mult să parcurgem toate coloanele acestei linii. Pe aceasta am putea să ne oprim, dar...
Poate fi util să ne gândim și să mergem și mai departe în optimizarea performanței și reducerea operațiunilor de intrare-ieșire atunci când accesăm baza de date. Ce-ar fi să păstrăm informațiile complete despre legătură direct în cheia rândului? Adică să facem cheia compusă din userID.friendID? În acest caz, putem chiar să evităm citirea coloanelor rândului.Varianta 4(row)):
RowKey
Coloane
Vasya.Petya
Peti: 1
Vasya.Olia
Olia: 1
Vasya.Dasha
Dașa: 1
Petya.Masha
Mașa: 1
Petya.Vasya
Vasia: 1
Evident, evaluarea tuturor scenariilor de manipulare a datelor în această structură va fi, la fel ca în varianta anterioară, O(1). Diferența față de varianta 3 va fi exclusiv în eficiența operațiunilor de intrare-ieșire în BD.
Și ultimul „detaliu”. Este ușor de observat că în varianta 4 cheia rândului va avea o lungime variabilă, ceea ce ar putea afecta performanța (amintim că HBase stochează datele ca un set de bytes și rândurile din tabele sunt sortate după cheie). În plus, avem un separator, care în anumite scenarii poate necesita procesare. Pentru a elimina această influență, putem folosi hash-uri de userID și friendID, iar deoarece ambele hash-uri vor avea lungime constantă, le putem concatena pur și simplu, fără separator. Atunci datele din tabel vor arăta astfel:Varianta 5(hash)):
RowKey
Coloane
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Peti: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olia: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dașa: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Mașa: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasia: 1
Evident, complexitatea algoritmică a muncii cu o astfel de structură în scenariile discutate va fi la fel ca în varianta 4 – adică O(1).
În concluzie, să grupăm toate evaluările noastre de complexitate computațională într-un singur tabel:
Adăugarea unui prieten
Verificarea unui prieten
Ștergerea unui prieten
Varianta 1 (implicit)
O(n)
O(n)
O(n)
Varianta 2 (count)
O(1)
O(n)
O(n)
Varianta 3 (column)
O(1)
O(1)
O(1)
Varianta 4 (row)
O(1)
O(1)
O(1)
Varianta 5 (hash)
O(1)
O(1)
O(1)
După cum se poate observa, opțiunile 3-5 par a fi cele mai preferabile și teoretic asigură îndeplinirea tuturor scenariilor necesare de manipulare a datelor într-un timp constant. În condițiile sarcinii noastre nu există o cerință explicită pentru obținerea unei liste cu toți prietenii utilizatorului, dar în activitatea noastră de zi cu zi, ca analiști buni, ar fi bine să „anticipăm” că o astfel de sarcină ar putea apărea și să „ne pregătim”. Prin urmare, simpatia mea se îndreaptă spre opțiunea 3. Dar este foarte posibil ca, în cadrul unui proiect real, această solicitare să fi fost deja rezolvată prin alte metode, așa că fără o vedere de ansamblu asupra întregii sarcini, ar fi mai bine să nu facem concluzii definitive.
Pregătirea experimentului
Dorința de a verifica considerentele teoretice prezentate mai sus în practică - aceasta a fost scopul ideii apărute în lungile weekenduri. Pentru aceasta, este necesar să evaluăm viteza de funcționare a „aplicației noastre ipotetice” în toate scenariile descrise de utilizare a bazei, precum și creșterea acestui timp odată cu creșterea dimensiunii rețelei sociale (n). Parametrul țintă care ne interesează și pe care îl vom măsura pe parcursul experimentului este timpul consumat de „aplicația ipotetică” pentru a executa o „operațiune de afaceri”. Prin „operațiune de afaceri” înțelegem una dintre următoarele:
- Adăugarea unui nou prieten
- Verificarea dacă utilizatorul A este prieten cu utilizatorul B
- Ștergerea unui prieten
Astfel, având în vedere cerințele stabilite în enunțul inițial, scenariul de verificare se conturează astfel:
- Înregistrarea datelor. Generați aleatoriu o rețea inițială de dimensiune n. Pentru o mai bună apropiere de „realitate”, numărul de prieteni al fiecărui utilizator este, de asemenea, o variabilă aleatorie. Măsurați timpul în care „aplicația noastră ipotetică” va înregistra în HBase toate datele generate. Apoi, împărțiți timpul obținut la numărul total de prieteni adăugați - astfel vom obține timpul mediu pentru o „operațiune de afaceri”.
- Citirea datelor. Pentru fiecare utilizator, trebuie să se întocmească o listă de „identități” pentru care trebuie verificat dacă acesta le urmărește sau nu. Lungimea listei va fi aproximativ egală cu numărul de prieteni ai utilizatorului, iar pentru jumătate dintre prietenii verificați, răspunsul ar trebui să fie „Da”, iar pentru cealaltă jumătate – „Nu”. Verificarea se va desfășura astfel încât să se alterneze răspunsurile „Da” și „Nu” (adică în fiecare caz secund trebuie să parcurgem toate coloanele pentru variantele 1 și 2). Timpul total de verificare va fi împărțit apoi la numărul de prieteni verificați pentru a obține timpul mediu necesar pentru a verifica un subiect.
- Ștergerea datelor. Trebuie să ştergem toți prietenii utilizatorului. Iar ordinea ștergerii va fi aleatorie (adică „amestecăm” lista inițială utilizată pentru înregistrarea datelor). Timpul total de verificare va fi împărțit apoi la numărul de prieteni șterși pentru a obține timpul mediu pentru o verificare.
Scenariile trebuie să fie rulate pentru fiecare dintre cele 5 variante de modele de date și pentru dimensiuni diferite ale rețelei sociale, pentru a observa cum se schimbă timpul pe măsură ce aceasta crește. În cadrul aceleași n conexiuni în rețea, lista de utilizatori pentru verificare trebuie să fie, desigur, identică pentru toate cele 5 variante.
Pentru o mai bună înțelegere, mai jos este un exemplu de date generate pentru n= 5. Generatorul scris produce la ieșire trei dicționare de ID-uri:
- primul – pentru inserare
- al doilea – pentru verificare
- al treilea – pentru ștergere
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # în total 15 prieteni

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # în total 18 subiecți verificați

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # în total 15 prieteni
Așa cum se poate observa, toate ID-urile mai mari de 10 000 din dicționarul pentru verificare sunt acelea care vor da cu siguranță răspunsul False. Inserarea, verificarea și ștergerea „prietenilor” se realizează exact în ordinea specificată în dicționar.
Experimentul a fost realizat pe un laptop cu Windows 10, unde într-un container Docker a fost pornită baza de date HBase, iar în celălalt – Python cu Jupyter Notebook. Dock-ului i-au fost alocate 2 nuclee CPU și 2 GB de memorie RAM. Toată logica, atât pentru simularea funcționării „aplicației condiționate”, cât și „interfața” pentru generarea datelor de test și măsurarea timpului au fost scrise în Python. Pentru lucrul cu HBase a fost folosită biblioteca , pentru calcularea hash-urilor (MD5) pentru varianta 5 — hashlib
Având în vedere puterea de calcul a laptopului specific, s-a ales experimental să se ruleze pentru n = 10, 30, …. 170 – când timpul total de execuție al ciclului complet de testare (toate scenariile pentru toate variantele pentru toate n) era încă relativ rezonabil și se încadra în timpul unei ceaiuri (în medie 15 minute).
Aici trebuie să fac o remarcă că, în acest experiment, nu evaluăm în principal cifrele absolute de performanță. Chiar și comparația relativă a celor două variante poate să nu fie complet corectă. Acum ne interesează în mod special caracterul modificării timpului în funcție de n, deoarece, având în vedere configurația „bancului de teste” menționată mai sus, este foarte dificil să obținem estimări temporale „curățate” de influențele întâmplătoare și alte factori (de fapt, această sarcină nu a fost stabilită).
Rezultatul experimentului
Primul test – cum se schimbă timpul necesar pentru completarea listei de prieteni. Rezultatul – în graficul de mai jos.
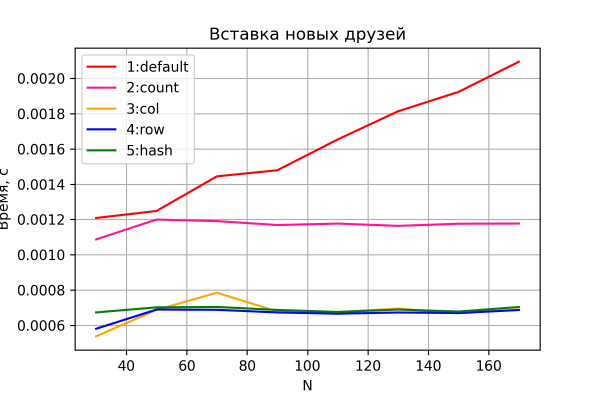
Variantele 3-5 arată așteptat un timp practic constant pentru „operațiunea de afaceri”, care nu depinde de creșterea dimensiunii rețelei și o diferență nedetectabilă în performanță.
Varianta 2 arată de asemenea o performanță constantă, dar puțin mai slabă, fiind practic de 2 ori mai slabă față de variantele 3-5. Și acest lucru nu poate să nu fie îmbucurător, deoarece se corelează cu teoria – în această variantă numărul de operațiuni de input-output în/a către HBase este de fapt de 2 ori mai mare. Acest lucru poate servi ca o dovadă indirectă că bancul nostru de teste oferă în principiu o precizie bună.
Varianta 1 este, de asemenea, așteptat să fie cea mai lentă și demonstrează o creștere liniară a timpului necesar pentru a adăuga un singur prieten, în funcție de dimensiunea rețelei.
Să examinăm acum rezultatele celui de-al doilea test.
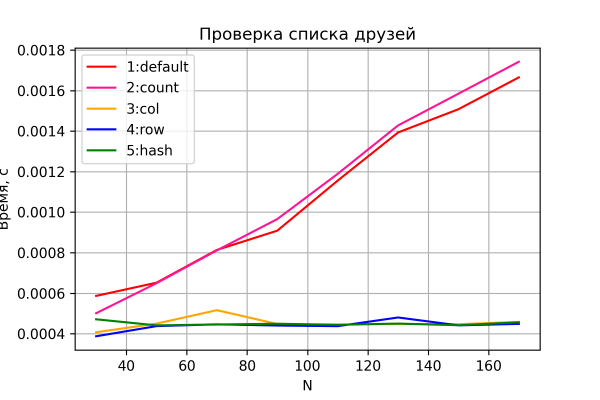
Opțiunile 3-5 se comportă din nou conform așteptărilor – timp constant, independent de dimensiunea rețelei. Opțiunile 1 și 2 demonstrează o creștere liniară a timpului pe măsură ce dimensiunea rețelei crește și o performanță similară. Totuși, opțiunea 2 se dovedește a fi puțin mai lentă – probabil din cauza necesității de a citi și procesa coloana suplimentară „count”, ceea ce devine mai evident pe măsură ce n crește. Totuși, mă voi abține de la orice concluzii, deoarece acuratețea acestei comparații este relativ scăzută. În plus, aceste raporturi (care opțiune, 1 sau 2, este mai rapidă) s-au schimbat de la o execuție la alta (menținând totuși caracterul dependenței și „mergând umăr la umăr”).
Și ultimul grafic – rezultatul testării ștergerii.
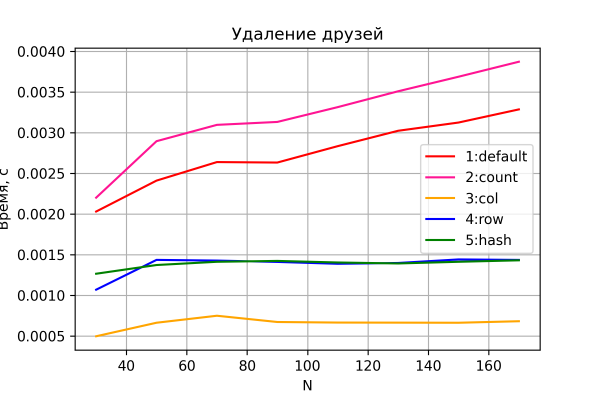
Aici din nou fără suprize. Opțiunile 3-5 realizează ștergerea într-un timp constant.
De asemenea, ceea ce este interesant, opțiunile 4 și 5, spre deosebire de scenariile anterioare, arată o performanță ușor mai slabă decât opțiunea 3. Probabil, operația de ștergere a unei linii este mai costisitoare decât operația de ștergere a unei coloane, ceea ce este, în general, logic.
Opțiunile 1 și 2, așa cum era de așteptat, demonstrează o creștere liniară a timpului. În acest context, opțiunea 2 este constant mai lentă decât opțiunea 1 – din cauza operațiunii suplimentare de intrare-ieșire pentru „întreținerea” coloanei count.
Concluziile generale ale experimentului:
- Opțiunile 3-5 demonstrează o eficiență mai mare, deoarece profită de avantajele HBase; performanța lor diferă între ele cu o constantă și nu depinde de dimensiunea rețelei.
- Diferența dintre opțiunile 4 și 5 nu a fost observată. Dar asta nu înseamnă că opțiunea 5 nu ar trebui utilizată. Este foarte probabil ca scenariul utilizat pentru experiment, având în vedere specificațiile tehnice ale băncii de testare, să nu fi permis identificarea acesteia.
- Caracterul creșterii timpului necesar pentru executarea „operațiunilor de afaceri” cu datele a confirmat, în general, concluziile teoretice anterioare pentru toate opțiunile.
Epilog
Experimentele necontrolate nu ar trebui considerate ca adevăruri absolute. Există mulți factori care nu au fost luați în considerare și care au distorsionat rezultatele (această fluctuație este foarte vizibilă în grafice atunci când dimensiunea rețelei este mică). De exemplu, viteza de lucru a thrift-ului utilizat de happybase, volumul și modul de implementare a logicii pe care am scris-o în Python (nu îmi asum că acel cod a fost scris optim și a folosit eficient capacitățile tuturor componentelor), posibilele particularități ale caching-ului HBase, activitățile de fundal ale Windows 10 pe laptopul meu etc. În general, se poate considera că toate concluziile teoretice au demonstrat validitatea lor experimentală. Sau, cel puțin, nu a fost posibil să le contestăm printr-o astfel de „atac frontal”.
În concluzie — recomandări pentru toți cei care încep să proiecteze modele de date în HBase: abstracționați-vă de experiența anterioară cu baze de date relaționale și țineți minte „poruncile”:
- Proiectând, plecăm de la problemă și de la tiparele de manipulare a datelor, nu de la modelul domeniului de aplicare.
- Acces eficient (fără full table scan) – doar pe cheie.
- Denormalizare.
- Liniile diferite pot conține coloane diferite.
- Compoziție dinamică a coloanelor.
Sursa: habr.com
