

Bună, recent am avut o sarcină interesantă de a configura un stocare pentru backup-ul unui număr mare de dispozitive bloc.
În fiecare săptămână efectuăm backup pentru toate mașinile virtuale din cloudul nostru, astfel încât trebuie să știm să gestionăm mii de copii de rezervă și să facem acest lucru cât mai rapid și eficient posibil.
Din păcate, configurațiile standard RAID5, RAID6 în acest caz nu ne vor ajuta din cauza faptului că procesul de restaurare pe astfel de discuri mari ca ale noastre va fi extrem de lent și probabil că nu se va termina niciodată.
Să examinăm ce alternative există:
— Analog cu RAID5, RAID6, dar cu un nivel de paritate configurabil. În acest timp, rezervarea se face nu pe blocuri, ci pentru fiecare obiect în parte. Cel mai simplu mod de a încerca erasure coding este să desfășori .
— aceasta este în prezent o caracteristică care nu a fost încă lansată de ZFS. Spre deosebire de RAIDZ, DRAID are un bloc de paritate distribuit și la restaurare implică toate discurile din array, ceea ce îl face să reziste mai bine la defecțiuni și să se restaureze mai repede după o eroare.
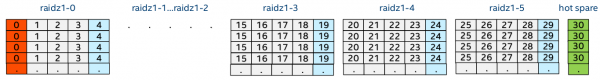
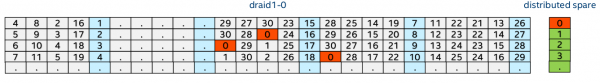
Avem la dispoziție un server Fujitsu Primergy RX300 S7 cu procesorul Intel Xeon CPU E5-2650L 0 @ 1.80GHz, nouă module de memorie RAM Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), o unitate de disc Supermicro SuperChassis 847E26-RJBOD1, conectată prin Dual LSI SAS2X36 Expander și 45 de discuri Seagate ST6000NM0115-1YZ110 pe 6TB fiecare.
Înainte de a lua o decizie, trebuie mai întâi să testăm corespunzător totul.
Pentru aceasta m-am pregătit și am efectuat teste asupra diferitelor configurații. Am folosit minio, care a funcționat ca backend S3, și l-am rulat în diferite moduri cu diferite număr de targeturi.
În principal, s-a testat cazul minio în erasure coding față de software raid cu același număr de discuri și discuri de paritate, adică: RAID6, RAIDZ2 și DRAID2.
Pentru referință: atunci când rulezi minio cu un singur target, minio funcționează în modul S3-gateway, oferind sistemul tău local de fișiere ca un stocare S3. În schimb, dacă rulezi minio specificând mai multe targeturi, se va activa automat modul Erasure Coding, care va dispersa datele între targeturile tale oferind rezistență la defecte.
În mod implicit, minio împarte destinațiile în grupuri de câte 16 discuri, unde fiecare grup are câte 2 paritate. Asta înseamnă că pot ieși din funcțiune simultan două discuri fără pierderi de date.
Pentru testarea performanței, am folosit 16 discuri de câte 6TB fiecare și am scris pe ele obiecte mici de 1MB, ceea ce descria cel mai precis încărcătura noastră viitoare, deoarece toate instrumentele moderne de backup își împart datele în blocuri de câțiva megabați și le scriu în acest mod.
Pentru realizarea benchmark-ului, am folosit utilitarul s3bench, rulat pe un server de la distanță, care trimitea în minio zeci de mii de asemenea obiecte în sute de fire. După aceea, am încercat să le solicit înapoi în același mod.
Rezultatele benchmark-ului sunt prezentate în tabelul următor:
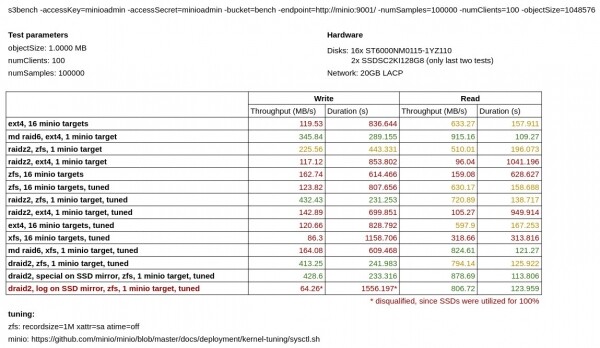
Așa cum vedem, minio în modul său de erasure coding funcționează semnificativ mai slab la scriere decât minio care rulează pe un RAID6 software, RAIDZ2 și DRAID2 în aceeași configurație.
Separat, am să testez minio pe ext4 vs XFS. Ciudat, dar pentru tipul meu de încărcătură, XFS s-a dovedit a fi semnificativ mai lent decât ext4.
În prima serie de teste, Mdadm a arătat superioritate față de ZFS, dar mai târziu , că pot îmbunătăți performanța ZFS setând următoarele opțiuni:
xattr=sa atime=off recordsize=1Mși după aceea, testele cu ZFS au devenit mult mai bune.
De asemenea, se poate observa că DRAID nu oferă un câștig semnificativ în performanță față de RAIDZ, dar teoretic ar trebui să fie mult mai sigur.
În ultimele două teste, am încercat, de asemenea, să mut metadatele (special) și ZIL (log) pe un mirror din SSD-uri. Însă mutarea metadatelor nu a adus un câștig semnificativ în viteza de scriere, iar în cazul mutării ZIL, SSD-urile mele s-au blocat la 100% utilizare, așa că consider că acest test a fost eșuat. Nu exclud că, dacă aș fi avut SSD-uri mai rapide, rezultatele mele s-ar fi îmbunătățit semnificativ, dar, din păcate, nu le-am avut.
În concluzie, am decis să continui folosind DRAID și, în ciuda statutului său beta, este cea mai rapidă și eficientă soluție de stocare în cazul nostru.
Am creat un DRAID2 simplu în configurația cu trei grupuri și două spare distribuite:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Bine, am clarificat cu stocarea, acum să vorbim despre ce vom folosi pentru backup. Aici vreau să vorbesc despre trei soluții pe care am reușit să le testez, și anume:
— fork , o soluție specializată pentru backup-ul dispozitivelor bloc, are o integrare strânsă cu Ceph. Poate extrage dif-uri între snapshot-uri și forma un backup incremental din acestea. Suportă un număr mare de backend-uri de stocare, printre care se numără atât stocarea locală, cât și S3. Necesită o bază de date separată pentru a păstra tabelul de hash pentru deduplicare. Printre dezavantaje: este scris în python, are un cli puțin necorespunzător.
— fork , un instrument cunoscut și testat pentru backup, este capabil să facă backup datelor și le deduplicează eficient. Poate salva backupuri atât local, cât și pe un server la distanță prin scp. Poate face backup la dispozitive bloc dacă este rulat cu flag-ul --special, printre dezavantaje: la crearea unui backup, repository-ul este complet blocat, așa că pentru fiecare mașină virtuală se recomandă crearea unui repository separat, ceea ce nu este o problemă, având în vedere că se creează foarte ușor.
— un proiect în dezvoltare activă, scris în go, suficient de rapid și care suportă un număr mare de backend-uri pentru stocare, printre care se numără atât stocarea locală, cât și scp, S3 și multe altele. Merită menționat faptul că există un creat special pentru restic, care permite exportarea celui mai rapid al storage-ului pentru utilizare la distanță. Dintre toate cele menționate mai sus, acesta mi-a plăcut cel mai mult. Poate face backup din stdin. Nu are dezavantaje notabile, dar există câteva particularități:
În primul rând, am încercat să-l folosesc în modul repository comun pentru toate mașinile virtuale (ca Benji) și a funcționat destul de bine, dar operațiile de restaurare au durat destul de mult timp, deoarece de fiecare dată înainte de restaurare, restic încearcă să citească metadatele tuturor backup-urilor. Această problemă a fost rezolvată, la fel ca și cu borg, prin crearea unui repository separat pentru fiecare mașină virtuală. Această abordare s-a dovedit a fi foarte eficientă și pentru gestionarea backup-urilor. Repository-urile separate pot avea o parolă distinctă pentru accesul la date, iar noi nu trebuie să ne temem că repository-ul global s-ar putea strica. Crearea de noi repository-uri se poate face la fel de simplu ca în borg backup.
În orice caz, deduplicarea se realizează doar în raport cu versiunea anterioară a backup-ului, iar backup-ul anterior este determinat de calea pentru backup-ul specificat, așa că, dacă faceți backup la diferite obiecte din stdin într-un depozit comun, nu uitați să specificați opțiunea
--stdin-filename, sau să specificați explicit opțiunea de fiecare dată--parent.
În al doilea rând, restaurarea în stdout durează semnificativ mai mult decât restaurarea pe sistemul de fișiere, din cauza paralelismului său. În viitor, se preconizează adăugarea unei suport mai strâns pentru backup-urile de dispozitive bloc.
În al treilea rând, în prezent se recomandă utilizarea , deoarece versiunea 0.9.6 are un bug cu restaurarea lentă a fișierelor mari.
Pentru a testa eficiența backup-ului și viteza de scriere/restaurare din backup, am creat un depozit separat și am încercat să fac backup la o imagine mică a unei mașini virtuale (21 GB). Au fost efectuate două backup-uri fără a modifica originalul, folosind fiecare dintre soluțiile enumerate, pentru a verifica cât de repede/lent sunt copiate datele deduplicate.
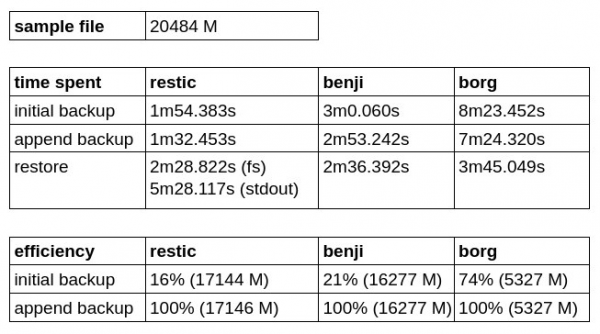
Așa cum putem observa, Borg Backup are cel mai bun coeficient de eficiență al backup-ului inițial, dar pierde la viteza atât de scriere, cât și de restaurare.
Restic s-a dovedit a fi mai rapid decât Benji Backup, dar restaurează mai lent în stdout, iar scrierea direct în dispozitivele bloc nu este, din păcate, încă posibilă.
Cântărind toate aspectele, am decis să mă opresc pe restic de rest-server ca fiind soluția cea mai convenabilă și promițătoare pentru backup.
În acest screencast, puteți vedea cum canalul de 10 gigabiți este complet utilizat în timpul mai multor operații de backup care rulează simultan. Merită menționat că utilizarea discurilor nu depășește 30%.
Sunt mai mult decât mulțumit de soluția obținută!
Sursa: habr.com
