

Decodificarea raportului din 2015 al lui Ilya Kosmodemyansky "Optimizarea Linux pentru îmbunătățirea performanței PostgreSQL"
Avertisment: Menționez că acest raport este din noiembrie 2015 – au trecut mai mult de 4 ani și s-au întâmplat multe. Versiunea 9.4 menționată în raport nu mai este suportată. În ultimii 4 ani, au fost lansate 5 versiuni noi de PostgreSQL și 15 versiuni de kernel Linux. Dacă ar trebui să rescriem aceste părți, am obține, în final, un alt raport. Totuși, aici este abordată optimizarea fundamentală a Linux pentru PostgreSQL, care rămâne relevantă și în prezent.
Mă numesc Ilya Kosmodemyansky. Lucrez la compania PostgreSQL-Consulting. Și acum voi povesti puțin despre ce să faci cu Linux în legătură cu bazele de date în general și cu PostgreSQL în special, deoarece principiile sunt destul de asemănătoare.
Despre ce vom vorbi? Dacă interacționați cu PostgreSQL, trebuie într-o oarecare măsură să fiți un administrator UNIX. Ce înseamnă asta? Dacă comparăm Oracle și PostgreSQL, atunci în Oracle trebuie să fii 80% administrator DBA al bazei de date și 20% administrator Linux.
Cu PostgreSQL este puțin mai complicat. Cu PostgreSQL trebuie să ai o mai bună înțelegere a modului în care funcționează Linux. Și, în același timp, trebuie să fugi puțin după tren, pentru că, în ultima vreme, totul se actualizează destul de rapid. Și noile kernel-uri sunt lansate, apare funcționalitate nouă, performanța se îmbunătățește etc.
De ce discutăm despre Linux? Nu pentru că suntem la conferința Linux din Petersburg, ci pentru că, în condiții moderne, unul dintre cele mai justificate sisteme de operare pentru utilizarea cu baze de date în general și cu PostgreSQL în special este Linux. Deoarece FreeBSD, din păcate, se dezvoltă într-o direcție destul de ciudată. Vor fi probleme atât cu performanța, cât și cu multe alte aspecte. Performanța PostgreSQL pe Windows este o temă complet separată, care se bazează pe faptul că Windows nu are memorie împărtășită ca UNIX, iar PostgreSQL se bazează pe acest fapt, deoarece este un sistem multiproces.
Și exotica precum Solaris, cred că interesează pe mult mai puțini, așa că hai să începem.
Un sistem de distribuție Linux modern are peste 1.000 de parametri syctl, în funcție de cum este compilat kernel-ul. Dacă ne uităm și la diferite setări, acolo putem ajusta și în multe alte moduri. Există parametri pentru sisteme de fișiere, cum să le montați. Dacă aveți întrebări, cum să porniți: ce să activați în BIOS, cum să configurați hardware-ul etc.
Aceasta este o cantitate foarte mare despre care se poate vorbi zile întregi, nu într-o scurtă prezentare, dar acum mă voi opri asupra lucrurilor importante, cum să evitați acele capcane care cu siguranță nu vă vor permite să exploatați bine baza de date pe Linux, dacă nu le corectați. Și un alt aspect important este că multe setări sunt activate implicit nu în configurații corecte pentru baza de date. Adică, în mod implicit, va funcționa prost sau nu va funcționa deloc.
Ce ținte tradiționale de optimizare există în Linux? Cred că, deoarece toți aveți de-a face cu administrarea Linux, nu trebuie să explic ce sunt țintele.
Se poate optimiza:
- CPU.
- Memorie.
- Stocare.
- Altele. Despre asta vom vorbi la final, ca un desert. Chiar și parametrii, cum ar fi politica de economisire a energiei, pot afecta performanța într-un mod foarte imprevizibil și neplăcut.
Care este specificitatea PostgreSQL și a bazei de date în general? Problema este că nu poți optimiza doar un singur element și să te aștepți că performanța va îmbunătăți semnificativ.
Da, există astfel de elemente, dar baza de date este un sistem complex. Aceasta interacționează cu toate resursele disponibile pe server și preferă să interacționeze complet. Dacă privești recomandările actuale ale Oracle despre cum să utilizezi sistemul de operare gazdă, va fi ca în gluma despre acel cosmonaut mongol – să hrănești câinele și să nu atingi nimic. Să dăm bazei toate resursele, baza de date se va descurca singură.
În principiu, situația cu PostgreSQL este exact aceeași în mare măsură. Diferența este că baza de date nu este capabilă să își aloce toate resursele, adică unele lucruri trebuie gestionate la nivel de Linux.
Ideea principală este să nu alegi o singură țintă și să începi să o optimizezi, de exemplu, memoria, CPU sau ceva similar, ci să analizezi sarcina de lucru și să încerci să îmbunătățești cât mai mult lățimea de bandă, astfel încât sarcina pe care buni programatori ne-au creat-o, inclusiv utilizatorii noștri, să treacă prin baza noastră de date cât mai eficient.
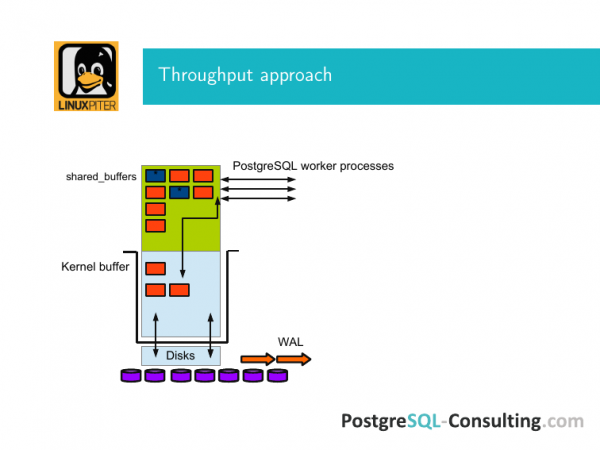
Iată o imagine care explică ce este aceasta. Există un buffer al sistemului de operare Linux, există memorie partajată și există bufferi partajați PostgreSQL. Spre deosebire de Oracle, PostgreSQL funcționează direct doar prin bufferul kernel-ului, adică pentru ca o pagină de pe disc să ajungă în memoria sa partajată, trebuie să treacă prin bufferul kernel și înapoi exact aceeași situație.
Sub acest sistem se află discurile. Le-am desenat ca discuri. De fapt, acolo poate fi un controler RAID etc.
Și astfel, acest input-output se desfășoară într-un fel sau altul prin aceasta.
PostgreSQL este o bază de date clasică. Acolo se află paginile. Și tot input-output se desfășoară cu ajutorul paginilor. Ridicăm blocuri în memorie cu paginile. Și dacă nu s-a întâmplat nimic, le-am citit doar, atunci treptat acestea din cache, din bufferii partajați, ajung înapoi pe disc.
Dacă undeva am înlocuit ceva, atunci întreaga pagină este marcată ca murdară. Le-am marcat aici cu culoarea albastră. Și asta înseamnă că această pagină trebuie să fie sincronizată cu stocarea pe bloc. Adică, când am făcut-o murdară, am înregistrat-o în WAL. Și într-un anumit moment, a apărut un fenomen numit checkpoint. Și în acest log s-a înregistrat informația că a apărut. Și asta înseamnă că toate paginile murdare care erau în acel moment în acești bufferi partajați s-au sincronizat cu discul de stocare prin fsync prin bufferul kernel.
De ce se face aceasta? Dacă ne pierdem tensiunea, nu avem situația în care toate datele au dispărut. Memoria persistentă, de care ne-au vorbit toți, este în prezent, în teoria bazelor de date – un viitor luminos, la care, desigur, aspirăm și ne place, dar în prezent ele mai trăiesc cu 20 de ani în urmă. Și, desigur, trebuie să ținem totul sub observație.
Iar sarcina de maximizare a capacității de transfer este să ajustăm toate aceste etape, astfel încât totul să funcționeze rapid. Memoria partajată este în principal un cache de pagini. În PostgreSQL am trimis o cerere select pentru ceva, a obținut aceste date de pe disc. Ele au ajuns în bufferii partajați. Prin urmare, pentru a funcționa mai bine, trebuie să avem multă memorie.
Pentru ca totul să funcționeze bine și rapid, trebuie să configurați corect sistemul de operare în toate etapele. De asemenea, trebuie să alegeți hardware-ul în mod echilibrat, deoarece, dacă există un dezechilibru undeva, puteți avea foarte multă memorie, dar aceasta va funcționa cu o viteză insuficientă.
Hai să discutăm despre fiecare dintre acești pași.
Pentru ca aceste pagini să călătorească rapid de colo-colo, trebuie să obținem următoarele:
- În primul rând, trebuie să lucrăm mai eficient cu memoria.
- În al doilea rând, trecerea acestora atunci când paginile lejer din memorie intră pe disc trebuie să fie mai eficientă.
- Și, în al treilea rând, trebuie să avem discuri bune.
Dacă aveți 512 GB de memorie RAM în server și totul ajunge în final pe un disc dur SATA fără niciun cache, atunci întregul server de baze de date se transformă nu doar în dovleac, ci într-un dovleac cu interfață SATA. Vei întâlni acest lucru direct. Și nimic nu te va salva.
În ceea ce privește primul punct despre memorie, sunt trei aspecte care pot complica foarte mult viața.
Primul dintre acestea este NUMA. NUMA este un concept creat pentru a îmbunătăți performanța. În funcție de sarcina de lucru, se pot optimiza diferite aspecte. Și în forma ei actuală, pentru aplicații precum bazele de date care utilizează intens cache-ul de pagini și buffer-ele partajate, nu este foarte eficientă.
Pe scurt. Cum îți dai seama că ceva nu e în regulă cu NUMA? Ai un zgomot neplăcut, iar brusc un procesor devine supraîncărcat. Totodată, analizezi cererile din PostgreSQL și vezi că nu există nimic care să semene cu asta. Aceste cereri nu ar trebui să consume CPU atât de intensiv. Îți va lua mult timp să identifici problema. E mai simplu să urmezi din start recomandarea corectă despre cum să configurezi NUMA pentru PostgreSQL.
Ce se întâmplă, de fapt? NUMA este Non-Uniform Memory Access. Despre ce este vorba? Ai un CPU, iar lângă el este memoria locală. Această memorie interconectată poate accesa memoria de la alte CPU-uri.
Dacă rulezi numactl --hardware, va apărea un șir lung de informații. Printre altele, va fi un câmp numit distanțe. Vor fi numere – 10-20, ceva de genul. Aceste numere nu sunt altceva decât numărul de hop-uri necesare pentru a accesa această memorie la distanță și a o utiliza local. În principiu, este o idee bună. Aceasta îmbunătățește considerabil performanța pentru anumite sarcini de lucru.
Acum imaginați-vă că aveți un CPU care încearcă mai întâi să folosească memoria sa locală, apoi încearcă să acceseze o altă memorie prin interconectare pentru ceva. Și pe acest CPU ajunge tot cache-ul de pagini PostgreSQL – câteva gigabytes. Întotdeauna obții cea mai proastă situație, deoarece pe CPU, în mod direct în acest modul de memorie, există de obicei puțin. Iar toată memoria care este accesată trece prin aceste interconectări. Devine lent și trist. Și ai un procesor care deservește acest nod, constant supraîncărcat. Iar timpul de acces la această memorie este prost, lent. Aceasta este situația pe care nu vrei să o ai dacă folosești acest lucru pentru o bază de date.
Prin urmare, o variantă mai bună pentru bazele de date este ca sistemul de operare Linux să nu știe deloc ce se întâmplă acolo. Să acceseze memoria așa cum ar trebui.
De ce așa? Ar părea că ar trebui să fie invers. Se întâmplă dintr-un singur motiv simplu, că avem nevoie de multă memorie pentru cache-ul de pagini – zeci, sute de gigabytes.
Și dacă am alocat totul și ne-am cache-uit datele acolo, atunci câștigul din utilizarea cache-ului va fi considerabil mai mare decât câștigul dintr-o abordare complicată a memoriei. Astfel, vom câștiga în mod necomparabil comparativ cu faptul că vom accesa memoria mai eficient folosind NUMA.
Prin urmare, în prezent există două abordări, până când un viitor luminos va veni și baza de date nu va putea să-și dea seama singură pe ce CPU funcționează și de unde ar trebui să acceseze ceva.
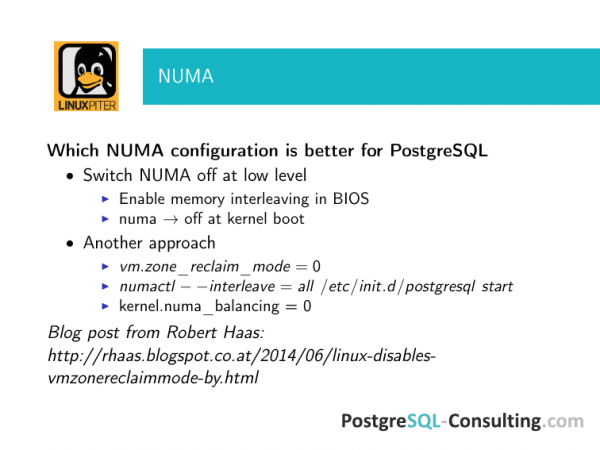
Astfel, abordarea corectă este să dezactivăm complet NUMA., de exemplu, la repornire. În majoritatea cazurilor, câștigurile sunt atât de mari, încât nu mai există nicio întrebare despre ce este mai bine.
Există o altă variantă. O folosim mai des decât pe prima, deoarece, atunci când avem un client care are nevoie de suport, pentru el repornirea serverului este un întreg proces. Are acolo o afacere în desfășurare. Și ei au probleme din cauza NUMA. Prin urmare, încercăm să dezactivăm într-un mod mai puțin invaziv decât prin reboot, dar aici trebuie să verificați cu atenție că aceasta s-a dezactivat. Pentru că, așa cum arată experiența, dacă dezactivăm NUMA pentru procesul părinte PostgreSQL, este bine, dar nu este deloc obligatoriu că aceasta va funcționa. Trebuie să verifici și să te asiguri că s-a dezactivat cu adevărat.
Există un articol interesant de Robert Haas. Este unul dintre commiters PostgreSQL. Unul dintre dezvoltatorii cheie ai tuturor aspectelor de bază. Dacă treceți prin linkurile din acest articol, veți găsi câteva povești interesante despre cum NUMA le-a complicat viața oamenilor. Vedeți, studiați lista de verificare pentru adminii de sistem, ce trebuie configurat pe server pentru a ne asigura că baza de date funcționează bine. Aceste setări trebuie notate și verificate, altfel va fi destul de neplăcut.
Atrag atenția că acest lucru se referă la toate setările despre care voi vorbi. Dar, de obicei, bazele de date sunt configurate în mod master-slave pentru redundanță. Nu uitați să faceți aceste setări și pe slave, deoarece la un moment dat s-ar putea să aveți o avarie și veți comuta pe slave, iar acesta va deveni master.
Într-o situație de urgență, când totul este foarte rău, telefonul vă sună constant și șeful vine cu un baston mare, nu veți avea timp să vă gândiți să verificați. Și rezultatele pot fi destul de dezastroase.
Următorul aspect este huge pages. Huge pages sunt dificile de testat separat și nu are sens să o faceți, deși există benchmark-uri care pot face acest lucru. Ele sunt ușor de găsit pe internet.
Care este ideea? Aveți un server relativ ieftin, cu multă memorie RAM, de exemplu, mai mult de 30 GB. Nu folosiți huge pages. Asta înseamnă că există cu siguranță overhead în utilizarea memoriei. Iar acest overhead nu este deloc plăcut.
De ce se întâmplă asta? Ce se petrece? Sistemul de operare alocă memorie în bucăți mici. Asa este convenabil, așa a fost istoric. Și dacă detaliem, OS-ul trebuie să transleze adresele virtuale în cele fizice. Și acest proces nu este cel mai simplu, de aceea OS-ul stochează rezultatul acestei operații în Translation Lookaside Buffer (TLB).
Și deoarece TLB-ul este un cache, în astfel de situații apar toate problemele specifice cache-ului. În primul rând, dacă aveți foarte multă memorie RAM și aceasta este alocată în bucăți mici, bufferul devine foarte mare. Iar dacă cache-ul este mare, căutarea devine mai lentă. Overhead-ul este considerabil și acesta în sine ocupă spațiu, adică memoria RAM este consumată de ceva nepotrivit. Asta e una.
Două – cu cât cache-ul se extinde mai mult în această situație, cu atât este mai mare șansa să aveți cache misses. Eficiența acestui cache scade rapid pe măsură ce dimensiunea sa crește. De aceea, în sistemele de operare a fost adoptată o abordare simplă. În Linux, aceasta este utilizată de mult timp. În FreeBSD a apărut nu de mult. Dar vorbim despre Linux. Acestea sunt huge pages.
Trebuie menționat că huge pages, ca idee, a fost inițial susținută de comunități care includeau Oracle și IBM, adică producătorii de baze de date s-au gândit serios că va fi utilă și pentru baze de date.
Și cum să le integrăm cu PostgreSQL? În primul rând, în kernel-ul Linux trebuie să fie activate huge pages.
În al doilea rând, acestea trebuie specificate explicit printr-un parametru sysctl – câte sunt. Numerele aici provin de la un server mai vechi. Puteți calcula câte shared buffers aveți aproximativ, astfel încât huge pages să încapă acolo.
Dacă întregul server este dedicat PostgreSQL, o bună punct de plecare este fie să alocați 25 % din memoria RAM pentru shared buffers, fie 75 %, dacă sunteți sigur că baza de date se va încadra în aceste 75 %. Aceasta este prima punct de plecare. Și calculați, dacă aveți 256 GB de memorie RAM, atunci, conform calculului, veți avea 64 GB pentru shared buffers. Faceți calculul aproximativ cu un mic surplus – cât ar trebui să aibă această cifră.
Până la versiunea 9.2 (dacă nu mă înșel, de la versiunea 8.2) era posibil să integrați PostgreSQL cu huge pages printr-o bibliotecă externă. Aceasta este întotdeauna necesar. În primul rând, aveți nevoie ca nucleul să poată aloca corect huge pages. În al doilea rând, aplicația care lucrează cu acestea trebuie să fie capabilă să le utilizeze. Pur și simplu nu le va utiliza. Deoarece PostgreSQL aloca memorie în stilul system 5, acest lucru se putea face prin libhugetlbfs – acesta este numele complet al bibliotecii.
În versiunea 9.3, a fost îmbunătățită performanța PostgreSQL în ceea ce privește gestionarea memoriei și s-a renunțat la metoda de alocare a memoriei system 5. Toată lumea a fost foarte încântată, deoarece altfel, atunci când încerci să rulezi două instanțe PostgreSQL pe o mașină, primești mesajul că nu ai suficientă memorie partajată. Îți spune că trebuie să ajustezi sysctl. Și acel sysctl este atât de complicat încât trebuie să te reinventezi și așa mai departe. În general, toată lumea a fost bucuroasă. Dar alocarea memoriei prin mmap a afectat utilizarea huge pages. Majoritatea clienților noștri folosesc buffer-uri partajate mari. Și am recomandat insistent să nu se treacă la 9.3, deoarece overhead-ul începea să conteze serios în procente.
Însă, comunitatea a observat această problemă și în versiunea 9.4 au regândit foarte bine acest aspect. În 9.4 a apărut un parametru în postgresql.conf, care permite activarea opțiunii try, on sau off.
Try – este cel mai sigur parametru. La pornirea PostgreSQL, când acesta alocă memorie partajată, încearcă să obțină acea memorie din huge pages. Și dacă nu reușește, revine la alocarea obișnuită. Dacă utilizați FreeBSD sau Solaris, puteți seta try, este întotdeauna sigur.
Dacă este on, nu va porni pur și simplu, dacă nu a reușit să aloce din huge pages. Aici depinde doar de preferințele fiecăruia. Dar dacă ați ales try, verificați că ați obținut cu adevărat ceea ce trebuie alocat, deoarece sunt multe spații pentru greșeli. Acest funcționalitate funcționează doar pe Linux.
Încă o mică observație, înainte de a merge mai departe. Transparent huge pages – nu se referă, deocamdată, la PostgreSQL. Acesta nu poate beneficia de ele în mod corespunzător. Și în cazul Transparent huge pages, pentru un astfel de workload, când este necesară o porțiune mare de memorie partajată, avantajele apar doar la volume foarte mari. Dacă aveți terabytes de memorie, atunci acest lucru ar putea fi relevant. Dacă discutăm despre utilizări mai obișnuite, când aveți 32, 64, 128, 256 GB de memorie pe mașină, atunci huge pages obișnuite sunt acceptabile, iar Transparent trebuie pur și simplu dezactivat.
Și ultimul lucru, legat de memorie, care nu este direct asociat cu throughput-ul, poate afecta foarte mult experiența. Întreaga capacitate de procesare va fi foarte afectată de faptul că serverul constant swap-uiește.
Și asta va fi foarte neplăcut în mai multe momente. Principalul neajuns constă în faptul că, în nucleele moderne, comportamentul diferă puțin de cel al nuclelor Linux mai vechi. Acesta este un aspect pe care este destul de neplăcut să-l întâmpini, pentru că, atunci când vorbim despre o anumită lucrare cu swap-ul, se încheie cu sosirea tardivă a OOM-killer-ului. Iar OOM-killer-ul care a sosit tardiv și a eliminat PostgreSQL este o neplăcere. Toată lumea va afla despre asta, adică până la ultimul utilizator.
Ce se întâmplă? Aveți acolo o cantitate mare de memorie RAM, totul funcționează bine. Dar de ce serverul se blochează în swap și se încetinește din această cauză? Părea că este multă memorie, dar se întâmplă așa.
În trecut, sfătuiam să setăm vm.swappiness la zero, adică să dezactivăm swap-ul. Se părea că 32 GB de memorie RAM și buffer-ele partajate corespunzătoare reprezintă o cantitate imensă. Principalul scop al swap-ului era să existe un loc unde să aruncăm un snapshot, în cazul în care ne deconectăm. Acesta nu își mai îndeplinea cu adevărat rolul. Și ce vei face ulterior cu acel snapshot? Aceasta devine o problemă, când nu este clar de ce este necesar swap-ul, mai ales de o asemenea dimensiune.
Dar în nucleele moderne, adică în versiunile a treia, comportamentul s-a schimbat. Și dacă setezi swap-ul la zero, adică îl dezactivezi, mai devreme sau mai târziu, chiar și cu o cantitate de memorie RAM disponibilă, OOM-killer-ul va veni să ucidă cei mai mari consumatori. Pentru că el va considera că, având un astfel de volum de lucru, ne-a mai rămas puțin și vom ieși, adică nu va ucide un proces sistemic, ci va elimina ceva mai puțin important. Acest lucru mai puțin important va fi un consumator intens de memorie partajată, adică postmaster-ul. Și după aceea, va fi bine dacă nu va trebui să restaurezi baza de date.
Prin urmare, acum, conform informațiilor pe care le am, majoritatea distribuțiilor seteză în mod implicit cam 6, adică în ce moment începe utilizarea swap-ului în funcție de cantitatea de memorie rămasă. Acum recomandăm să setăm vm.swappiness = 1, deoarece acest lucru practic îl dezactivează, dar nu produce efectele pe care le cauzează sosirea neașteptată a OOM-killer-ului și tot acest proces de eliminare.
Ce urmează? Atunci când discutăm despre performanța bazelor de date și ne apropiem treptat de discuri, toată lumea începe să se panicheze. Pentru că adevărul că discul este lent și memoria rapidă este bine cunoscut de toți. Și toată lumea știe că în baza de date vor apărea probleme cu performanța discului.
Problema principală cu performanța PostgreSQL, legată de vârfurile checkpoint-urilor, nu apare din cauza faptului că discul este lent. Este mai degrabă pentru că lățimea de bandă a memoriei și discului nu sunt echilibrate. Acestea pot fi dezechilibrate în diferite locații. PostgreSQL nu este configurat corect, sistemul de operare nu este configurat, hardware-ul nu este configurat și hardware-ul este greșit. Această problemă nu apare doar dacă totul se desfășoară conform planului, adică fie nu există încărcare, fie configurările și hardware-ul sunt bine corelate.
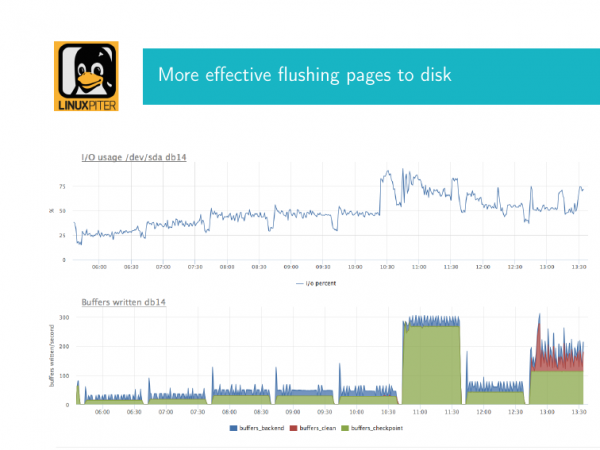
Ce este asta și cum arată? De obicei, persoanele care lucrează cu PostgreSQL s-au implicat în acest proces de mai multe ori. Voi explica. Așa cum am spus, PostgreSQL face periodic checkpoint-uri pentru a salva paginile murdare din memoria partajată pe disc. Dacă avem un volum mare de memorie partajată, atunci checkpoint-ul începe să afecteze intens discul, deoarece salvează aceste pagini cu fsync. Acesta ajunge în buffer-ul kernel și este scris pe discuri cu ajutorul fsync. Și dacă volumul acestui proces este mare, putem observa un efect neplăcut, și anume o utilizare foarte mare a discurilor.
Aici am două imagini. Voi explica acum ce este. Acestea sunt două grafice corelate în timp. Primul grafic – este utilizarea discului. Aici atinge aproape 90% în acest moment. Dacă aveți o bază de date cu discuri fizice și cu un controler RAID, utilizarea aproape de 90% este o veste proastă. Înseamnă că încă puțin și va ajunge la 100, iar intrarea-ieșirea se va opri.
Dacă aveți un array de discuri, atunci este o altă poveste. Asta depinde de modul în care este configurat, ce tip de array și așa mai departe.
În paralel, aici este configurat un grafic dintr-o vedere internă Postgres care arată cum decurge checkpoint-ul. Și cu verde este marcat numărul de buffere, adică paginile murdare care în acest moment au fost trimise în acest checkpoint pentru sincronizare. Acesta este aspectul principal pe care trebuie să-l știm. Vedem că aici avem multe pagini venind și, într-un anumit moment, ne-am lovit de limită, adică am scris continuu, iar sistemul de disc este evident foarte ocupat. Și checkpoint-ul nostru influențează semnificativ discul. Ideal, situația ar trebui să arate mai degrabă așa, adică ar trebui să fie mai puțină scriere. Și putem ajusta setările pentru a face ca situația să rămână astfel. Adică, utilizarea este mică, dar totuși scriem ceva aici.
Ce trebuie să facem pentru a depăși această problemă? Dacă I/O-ul pentru baza de date s-a oprit, asta înseamnă că toți utilizatorii care au venit să execute cererile lor vor fi în așteptare.
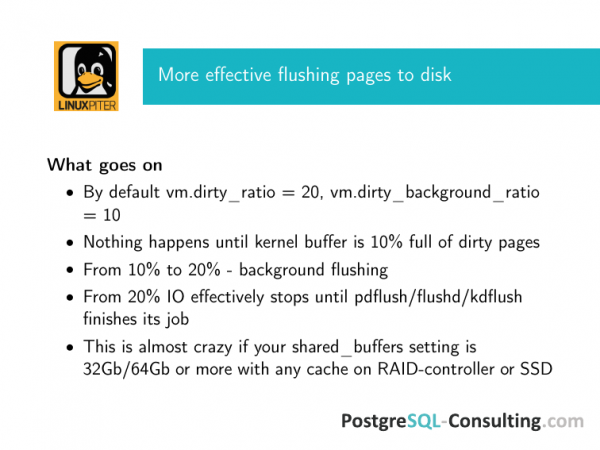
Dacă ne uităm din perspectiva Linux-ului, dacă ai un hardware bun, l-ai configurat corect și ai configurat PostgreSQL astfel încât să efectueze aceste checkpoint-uri mai rar, dispunându-le în timp, ajungi la parametrii impliciti ai Debian-ului. Pentru majoritatea distribuțiilor Linux, situația este următoarea: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Ce înseamnă asta? Cu kernel-ul 2.6 a apărut un demon de flushing. Pgflush, în funcție de cine-l folosește, se ocupă cu descărcarea paginilor murdare din buffer-ul kernel în fundal și descărcarea acestora când este necesar, chiar și atunci când descărcarea în fundal nu ajută.
Când apare fundalul? Când 10% din întreaga memorie RAM de pe server este ocupată de paginile murdare din buffer-ul kernel, este apelată o funcție specială pentru descărcarea în fundal. De ce este aceasta fundal? Ea primește ca parametru câte pagini să descarce. De exemplu, descarcă N pagini. Și pentru o vreme, acest proces intră în starea de odihnă. Apoi, revine și descarcă un alt număr de pagini.
Este o poveste extrem de simplă. Aici este o problemă similară cu un bazin, când într-un țeavă se toarnă apă, în cealaltă se umple. Aici a venit checkpoint-ul și, dacă nu a trimis suficiente pagini murdare la descărcare, acestea vor fi absorbite treptat din buffer-ul kernel de pgflush.
Dacă aceste pagini murdare continuă să acumulese, acestea ajung la 20%, după care sistemul de operare prioritizează să scrie toate acestea pe disc, deoarece dacă alimentarea pică, vom avea probleme. Vom pierde aceste date, de exemplu.
Care este trucul? Trucul constă în faptul că acești parametri, în lumea modernă, sunt 20% și 10% din toată memoria RAM disponibilă pe mașină, sunt complet inacceptabili din punctul de vedere al lățimii de bandă a oricărei sisteme de disc pe care o aveți.
Imaginați-vă că aveți 128 GB de memorie RAM. 12,8 GB ajung în sistemul dumneavoastră de discuri. Indiferent de cache-ul pe care îl aveți acolo, indiferent de matricea pe care o aveți, acestea nu vor putea face față.
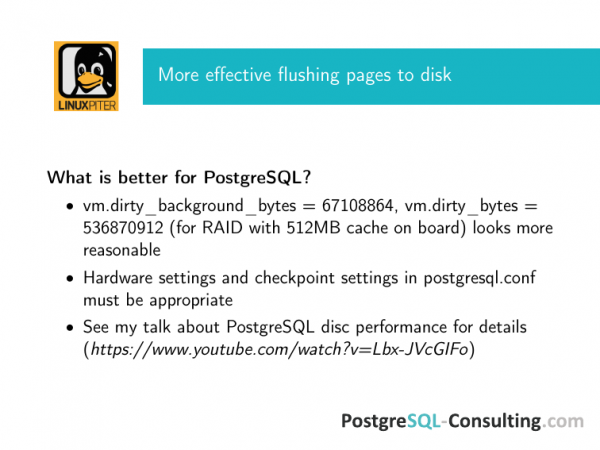
De aceea, recomandăm să ajustați aceste cifre în funcție de capacitățile controller-ului dumneavoastră RAID. Am aici o recomandare pentru un controller cu 512 MB de cache.
Se calculează foarte simplu. Puteți seta vm.dirty_background în bytes. Aceste setări anulează precedentele două. Fie raportul implicit, fie cele activate în bytes vor funcționa cele în bytes. Dar, deoarece sunt consultant DBA și lucrez cu diferiți clienți, încerc să mă protejez și, prin urmare, dacă este în bytes, atunci în bytes. Nimeni nu a dat nicio garanție că un administrator binevoitor nu va adăuga memorie serverului, nu îl va reporni, iar cifra va rămâne aceeași. Calculați aceste cifre astfel încât să fie garantat că totul se încadrează.
Ce se va întâmpla dacă nu reușiți să vă încadrați? Am scris că orice flushing se oprește eficient, dar de fapt este o figură de stil. Sistemul de operare are o problemă majoră - are multe pagini murdare, așa că efectiv se oprește IO, care este generat de clienții dumneavoastră, adică aplicația sql trimite cererea către baza de date, așteaptă. Orice input-output către aceasta este la cele mai joase priorități, deoarece baza de date este ocupată cu checkpoint-ul. Și când va termina acest lucru nu este deloc clar. Și când atingeți flushing-ul non-fond, non-background, atunci asta înseamnă că tot IO-ul este ocupat de el. Și până nu se termină, nu veți putea face nimic.
Aici sunt încă două puncte importante care depășesc acest raport. Aceste setări ar trebui să se potrivească cu setările din postgresql.conf, adică setările pentru checkpoints. Și sistemul dumneavoastră de discuri trebuie să fie configurat corespunzător. Dacă aveți un cache pe RAID, acesta ar trebui să aibă o baterie. Oamenii cumpără RAID-uri cu cache bun fără baterie. Dacă aveți SSD în RAID, acestea ar trebui să fie server-based, și ar trebui să aibă condensatoare. Aici este o listă detaliată de verficare. La acest link este raportul meu despre cum să configurați performanța discului în PostgreSQL. Toate aceste liste de verificare sunt acolo.
Ce ar putea complica foarte mult viața? Acestea sunt două parametrii. Sunt relativ noi. Pot fi activate în mod implicit în diferite aplicații. Și pot complica viața la fel de mult, dacă sunt activate greșit.
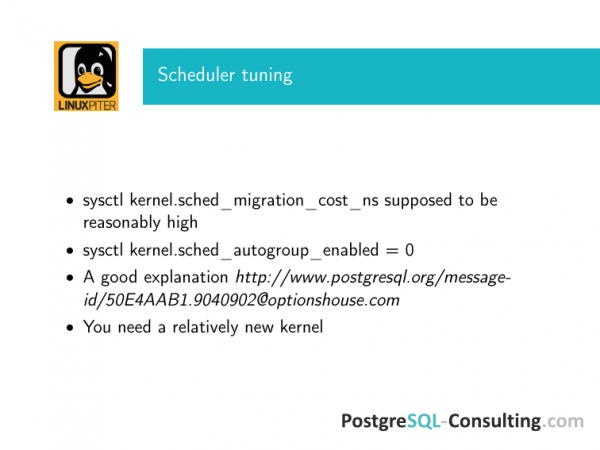
Există două lucruri relativ noi. Au apărut deja în nucleele a treia. Acestea sunt sched_migration_cost în nanosecunde și sched_autogroup_enabled, care este activat implicit.
Și cum le strică viața? Ce este sched_migration_cost? Scheduler-ul Linux poate migra un proces de pe un CPU pe altul. Și pentru PostgreSQL, care execută interogări, migrarea pe un alt CPU nu este deloc clar de ce ar fi necesară. Din punct de vedere al sistemului de operare, când schimbați feronrețele între openoffice și terminal, poate fi bine, dar pentru baza de date - este foarte rău. Prin urmare, o politică rațională este să setați migration_cost la o valoare mare, cel puțin câteva mii de nanosecunde.
Ce ar însemna asta pentru scheduler? Va considera că, pe durata acestui timp, acest proces este încă activ. Adică, dacă aveți o tranzacție lungă care se ocupă de ceva, scheduler-ul va înțelege asta. Va considera că până nu trece acea perioadă de timeout, nu este necesar să migreze acel proces. Dacă în același timp procesul face ceva, nu va fi migrarea, va continua liniștit pe CPU-ul care i-a fost alocat. Iar rezultatul este excelent.
Al doilea punct - este autogroup. Există o idee bună pentru workload-uri specifice, care nu au legătură cu baza de date modernă - aceea de a grupa procesele în funcție de terminalul virtual de unde au fost lansate. Este convenabil pentru anumite sarcini. În practică, PostgreSQL este un sistem multi-proces cu prefork, care pornește dintr-un terminal. Aveți un lock writer, checkpoint și toate cererile clienților se vor grupa pe un singur scheduler, pe un singur CPU. Acolo vor aștepta prietenește, când acesta se va elibera, pentru a se perturbă reciproc și a-l ocupa mai mult. Aceasta este o situație complet inutilă în cazul unei astfel de încărcări și de aceea trebuie dezactivată.
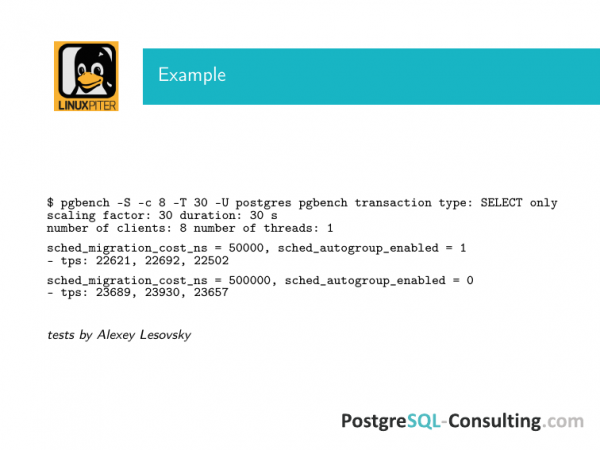
Colegul meu Alexey Lesovski a efectuat teste cu un simplu pgbench, unde a crescut cu un ordin migration_cost și a dezactivat autogroup. Diferența pe un hardware slab a reieșit aproape 10 %. Există o discuție în mailing listul postgres, unde oamenii oferă rezultate despre cum astfel de modificări au influențat viteza interogării cu 50 %. Aceste povești sunt destul de multe.
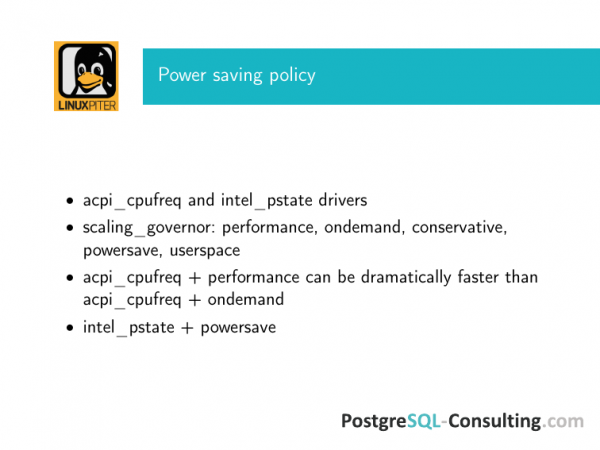
Și în cele din urmă despre politica de economisire a energiei. E bine că acum Linux poate fi folosit pe laptopuri. Și va consuma, chipurile, bine bateria. Dar se dovedește că acest lucru poate fi adevărat și pentru servere.
Mai mult, dacă închiriați servere de la un anumit hoster, atunci „buni” hosting, nu se ocupă de faptul că aveți o performanță mai bună. Sarcina lor este să se asigure că hardware-ul lor este utilizat cât mai eficient. De aceea, ei pot activa din start modul de economisire a energiei în sistemul de operare.
Dacă utilizați pe un server cu o bază de date sub o încărcare intensivă acest lucru, alegerea dumneavoastră este acpi_cpufreq + performance. Chiar și cu ondemand vor apărea deja probleme.
Intel_pstate este deja un driver ceva mai diferit. Și acum se preferă acest driver, considerat mai recent și mai eficient.
Prin urmare, guvernatorul trebuie să fie doar performance. Ondemand, powersave și altele – nu sunt pentru dumneavoastră.
Rezultatele obținute prin explain analyze PostgreSQL pot varia cu câteva ordine, dacă activați powersave, deoarece practic CPU-ul va fi planificat de bază într-un mod complet imprevizibil.
Aceste lucruri pot fi activate implicit. Verificați cu atenție – nu cumva au fost activate implicit. Aceasta ar putea fi realmente o problemă mare.
Și la final, aș dori să le mulțumesc băieților din echipa noastră DBA PostgreSQL-Consulting, mai precis lui Max Boguc și Alexei Lesovski, care își asumă zilnic provocările acestui domeniu. Încercăm să oferim clienților noștri cele mai bune soluții pentru ca totul să funcționeze perfect. Aici e ca la instrucțiunile de siguranță aeriană. Totul este scris în sânge. Fiecare dintre aceste probleme a fost descoperită în urma unor dificultăți. Sunt bucuros să le împărtășesc cu voi.
Întrebări:
Mulțumesc! De exemplu, dacă o companie dorește să economisească și să găzduiască baza de date și logica aplicației pe același server, sau dacă compania urmează tendința modernă a arhitecturilor de microservicii, în care PostgreSQL rulează într-un container. Care este cheia? Sysctl afectează global toate nucleele. Nu am auzit să fie sysctl virtualizate pentru a funcționa separat pe containere. Există doar cgroup și acolo există control doar pe o parte. Cum se poate conviețui cu asta? Sau, dacă doriți performanță, atunci rulați PostgreSQL pe un server fizic dedicat și optimizați-l?
Am răspuns la întrebarea dvs. în aproximativ trei moduri. Dacă nu este vorba despre un server fizic, care poate fi optimizat etc., atunci relaxați-vă, va funcționa bine fără aceste setări. Dacă ajungeți la o încărcare atât de mare încât să fie necesare aceste setări, atunci veți ajunge mai repede la un server fizic decât la aceste setări.
Care este problema? Dacă este o mașină virtuală, cel mai probabil veți avea multe probleme, de exemplu, cu consistența latenței discului, care este adesea inconsistentă pe majoritatea mașinilor virtuale. Chiar dacă lățimea de bandă a discurilor este bună, o tranzacție defectuoasă în operațiunile de intrare-ieșire, care nu afectează semnificativ lățimea de bandă medie, poate apărea în timpul unui checkpoint sau în timpul unei scrieri în WAL, iar baza de date va suferi mult din această cauză. Veți observa aceste probleme înainte de a vă confrunta cu ele.
Dacă aveți NGINX pe același server, va apărea aceeași problemă. Se va lupta pentru memoria partajată. Și nu veți ajunge la problemele descrise aici.
Dar, pe de altă parte, unele dintre aceste parametri tot vor fi relevanți pentru tine. De exemplu, poți seta dirty_ratio cu sysctl, astfel încât să nu fie atât de extrem – oricum, acest lucru va ajuta. În orice caz, interacțiunea ta cu discul va exista. Și va fi pe o schemă greșită. Acestea sunt, de fapt, parametrii default pe care i-am arătat. Și în orice caz, este mai bine să-i schimbi.
Dar cu NUMA pot apărea probleme. VmWare, de exemplu, funcționează bine cu NUMA cu setările exact opuse. Aici trebuie să alegi – server fizic sau nu.
Am o întrebare legată de Amazon AWS. Au imagini preconfigurate. Una dintre ele se numește Amazon RDS. Există acolo setări personalizate pentru sistemul lor de operare?
Există setări, dar acestea sunt alte setări. Aici configurăm sistemul de operare din perspectiva modului în care baza de date va folosi acest lucru. Acolo sunt parametrii care definesc încotro mergem acum, așa că este un fel de shaping. Adică, avem nevoie de atâtea resurse, le vom consuma acum. După aceea, Amazon RDS le atașează, iar performanța scade. Există povești în care oamenii încep să experimenteze cu acest lucru. Uneori chiar cu succes destul de mare. Dar aceasta nu are legătură cu setările OS. Este un fel de hacking al cloud-ului. Este o altă poveste.
De ce paginile mari transparente nu au efect comparativ cu Huge TLB?
Nu au. Acest lucru poate fi explicat în multe feluri. Dar, de fapt, pur și simplu nu au efect. Care este povestea cu PostgreSQL? La start, acesta alocă un mare bloc de memorie partajată. Fie că sunt transparente sau nu – este complet irelevant. Faptul că sunt alocate la start explică totul. Și dacă există foarte multă memorie și trebuie să reconstruiești segmentul shared_memory, atunci paginile mari transparente vor fi relevante. La PostgreSQL, acesta este pur și simplu alocat ca un bloc uriaș la start și nimic special nu se întâmplă mai departe. Poate fi desigur utilizat, dar există riscul de corupție a shared_memory, când va trebui să realoce ceva. PostgreSQL nu știe despre acest lucru.
Sursa: habr.com
