

Decodarea raportului din 2015 al lui Alexey Lesovski "Analiză profundă a statisticilor interne PostgreSQL"
Declinarea responsabilității de la autorul raportului: Observ că acest raport este datat noiembrie 2015 — au trecut mai mult de 4 ani și mult timp. Versiunea discutată în raport, 9.4, nu mai este suportată. În acești 4 ani, au fost lansate 5 versiuni noi, în care au apărut o mulțime de noutăți, îmbunătățiri și modificări referitoare la statistici, iar o parte din material este învechit și nu mai este relevant. Pe măsură ce revizuiesc, am încercat să subliniez aceste locuri pentru a nu induce în eroare cititorul. Nu am refăcut aceste pasaje, deoarece sunt foarte multe și ar rezulta, în cele din urmă, un raport complet diferit.
Sistemul de gestionare a bazelor de date PostgreSQL este un mecanism uriaș, fiind compus din numeroase subsisteme, de la funcționarea armonioasă a cărora depinde direct eficiența SGBD-ului. În timpul exploatării, se asigură colectarea de statistici și informații despre funcționarea componentelor, ceea ce permite evaluarea eficienței PostgreSQL și luarea măsurilor pentru îmbunătățirea performanței. Cu toate acestea, există foarte multe informații și acestea sunt prezentate într-o formă destul de simplificată. Procesarea acestei informații și interpretarea ei pot fi uneori o sarcină deloc trivială, iar "zoo" de instrumente și utilitare poate pune în dificultate chiar și un DBA avansat.
Bună ziua! Numele meu este Alexey. Așa cum a spus Ilya, voi vorbi despre statisticile PostgreSQL.
Statisticile activității PostgreSQL. PostgreSQL are două tipuri de statistici. Statistici de activitate, despre care voi vorbi. Și statistici ale planificatorului despre distribuția datelor. Voi discuta tocmai despre statisticile de activitate PostgreSQL, care ne permit să judecăm despre performanță și cum să o îmbunătățim.
Voi explica cum să utilizăm eficient statisticile pentru a rezolva cele mai variate probleme cu care te confrunți sau te-ai putea confrunta.
Ce nu va fi în raport? În raport nu voi aborda statisticile planificatorului, deoarece aceasta este o temă separată, pentru un alt raport despre cum sunt stocate datele în bază și cum planificatorul de interogări obține o imagine de ansamblu asupra caracteristicilor calitative și cantitative ale acestor date.
Și nu vor fi prezentări ale instrumentelor, nu voi compara un produs cu altul. Nu va exista publicitate. Să eliminăm asta.
Vreau să vă arăt că utilizarea statisticilor este utilă. Este necesară. Nu este înfricoșător să le folosești. Ne vom folosi doar de un SQL obișnuit și de cunoștințe de bază despre SQL.
Și vom discuta despre ce statistici să alegem pentru soluționarea problemelor.
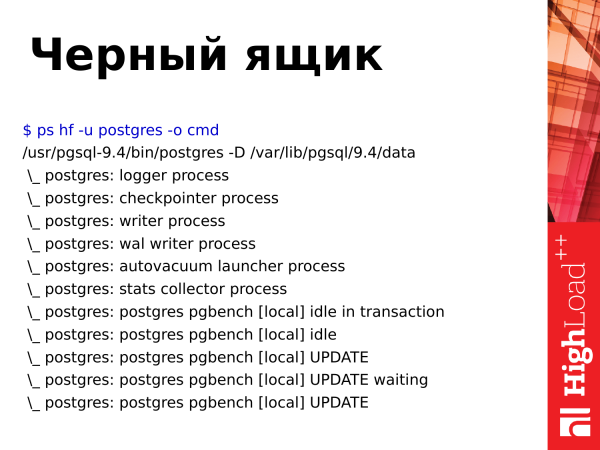
Dacă ne uităm la PostgreSQL și în sistemul de operare rulăm o comandă pentru vizualizarea proceselor, vom vedea un "negru cutie". Vom observa niște procese care fac ceva, iar din denumire putem aproxima ce fac, cu ce se ocupă. Însă, în esență, este o neagră cutie, în interiorul căreia nu putem privi.
Putem verifica încărcarea CPU-ului în top, putem verifica utilizarea memoriei cu anumite utilitare de sistem, dar nu vom putea privi în interiorul PostgreSQL. Pentru aceasta, avem nevoie de alte instrumente.
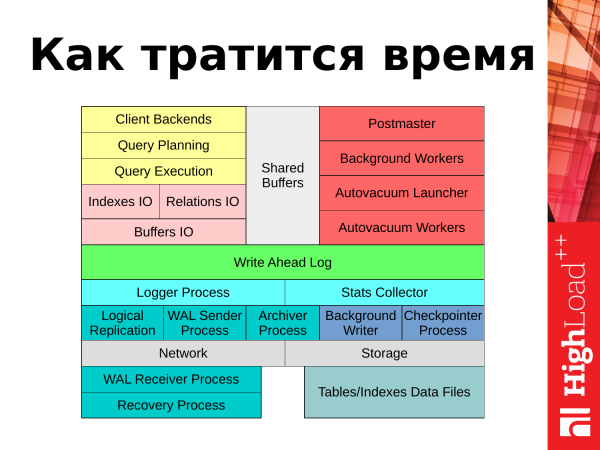
Și continuând, voi explica unde se cheltuie timpul. Dacă ne imaginăm PostgreSQL sub forma unui astfel de schemă, atunci putem răspunde la întrebarea unde se cheltuie timpul. Acestea sunt două lucruri: procesarea cererilor clienților din aplicații și sarcinile de fundal pe care PostgreSQL le execută pentru a-și menține funcționalitatea.
Dacă începem să analizăm din colțul din stânga sus, putem urmări cum sunt procesate cererile clienților. O cerere vine de la aplicație și pentru a continua se deschide o sesiune client. Cererea este transmisă planificatorului. Planificatorul construiește un plan pentru cerere. O trimite mai departe pentru executare. Se realizează un anumit input-output blocant de date legat de tabele și indecși. Datele necesare sunt citite de pe discuri în memorie într-o zonă specială numită "shared buffers". Rezultatele cererii, dacă sunt actualizări, ștergeri, sunt înregistrate în jurnalul de tranzacții în WAL. Unele informații statistice ajung în jurnal sau în colectorul de statistici. Și rezultatul cererii este returnat clientului. După care clientul poate repeta totul din nou cu o nouă cerere.
Ce se întâmplă cu sarcinile de fundal și cu procesele de fundal? Avem mai multe procese care asigură funcționalitatea și mențin baza de date în stare normală de funcționare. Aceste procese vor fi de asemenea abordate în prezentare: autovacuum, checkpointer, procesele legate de replicare, scriitorul de fundal. Fiecare dintre acestea va fi evocat pe parcursul prezentării.
Ce probleme există cu statisticile?
- Există multe informații. PostgreSQL 9.4 oferă 109 metrici pentru vizualizarea datelor statistice. Totuși, dacă în baza de date sunt stocate multe tabele, scheme, baze, atunci toate aceste metrici trebuie multiplicate cu numărul corespunzător de tabele și baze. Adică, informația devine și mai abundentă. Și este foarte ușor să te pierzi în ea.
- Următoarea problemă este că statisticile sunt prezentate prin intermediul contorilor. Dacă examinăm această statistică, vom observa contori care cresc constant. Și dacă a trecut mult timp de la resetarea statisticilor, vom vedea valori de miliarde. Acestea nu ne oferă nicio informație.
- Lipsa istoricului. Dacă a avut loc o defecțiune, ceva a picat acum 15-30 de minute, nu vom putea folosi statistica pentru a vedea ce s-a întâmplat acum 15-30 de minute. Aceasta este o problemă.
- Lipsa unui instrument încorporat în PostgreSQL reprezintă o problemă. Dezvoltatorii nucleului nu oferă nicio utilitate. Nu au nimic de acest fel. Ei pur și simplu oferă statisticile din bază. Folosește-le, formulă orice interogare dorești, fă ce vrei.
- Fiindcă nu există un instrument încorporat în PostgreSQL, aceasta dă naștere unei alte probleme. Multe instrumente externe. Fiecare companie care are un minim de cunoștințe încearcă să dezvolte propriul program. În final, în comunitate există foarte multe instrumente pe care le poți folosi pentru lucrul cu statisticile. Unele instrumente au anumite funcționalități, altele nu le au, sau oferă noi posibilități. Se creează situația în care trebuie să folosești două, trei, patru instrumente, care se suprapun și au funcții diferite. Este foarte neplăcut.
Ce se deduce din aceasta? Este important să poți obține statisticile direct, pentru a nu depinde de programe sau pentru a îmbunătăți cumva aceste programe: adaugă anumite funcții pentru a obține avantajul tău.
Și sunt necesare cunoștințe de bază în SQL. Pentru a obține date din statistică, trebuie să formulezi interogări SQL, adică trebuie să știi cum se compun select și join.
Statistica ne oferă câteva aspecte. Acestea pot fi împărțite în categorii.
- Prima categorie se referă la evenimentele care se produc în bază. Acestea sunt momentele când are loc un anumit eveniment în bază: o interogare, o accesare a unei tabele, autovacuum, comitări; toate acestea sunt evenimente. Counters corespunzătoare acestor evenimente sunt incrementate. Și putem urmări aceste evenimente.
- A doua categorie se referă la proprietățile obiectelor, precum tabelele și bazele. Acestea au proprietăți. De exemplu, dimensiunea tabelelor. Putem urmări creșterea tabelelor, creșterea indexurilor. Putem observa modificările în dinamică.
- Și a treia categorie se referă la timpul consumat pentru un eveniment. O interogare este un eveniment. Acesta are o măsură exactă a duratei. Aici a început, aici s-a terminat. Putem urmări acest lucru. Fie timpul de citire a unui bloc de pe disc sau de scriere. Aceste lucruri sunt, de asemenea, urmărite.
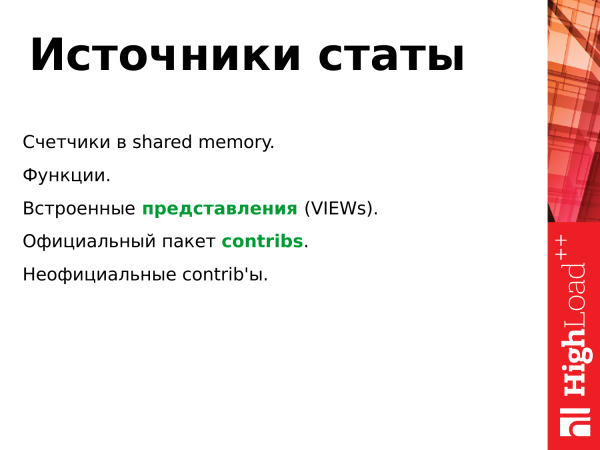
Sursele statisticii sunt prezentate astfel:
- În memoria partajată (shared buffers) există un segment pentru stocarea datelor statistice, acolo se află și acele contoare care sunt constant incrementate atunci când au loc anumite evenimente sau apar anumite momente în funcționarea bazei.
- Toate aceste contoare nu sunt accesibile utilizatorului și nici administratorului. Acestea sunt lucruri de nivel inferior. Pentru a accesa aceste informații, PostgreSQL oferă o interfață sub formă de funcții SQL. Putem face selecții folosind aceste funcții și obține o metrică (sau un set de metrici).
- Cu toate acestea, utilizarea acestor funcții nu este întotdeauna convenabilă, așa că funcțiile sunt baza pentru vederi (VIEWs). Acestea sunt tabele virtuale care oferă statistici pentru o anumită subsistemă sau pentru un anumit set de evenimente în baza de date.
- Aceste vederi încorporate (VIEWs) sunt principalul interface al utilizatorului pentru interacțiunea cu statistica. Ele sunt disponibile implicit fără nicio configurare suplimentară, puteți să le folosiți imediat, să vizualizați și să obțineți informații de acolo. Și mai există contrib’uri. Contrib’urile sunt oficiale. Puteți instala pachetul postgresql-contrib (de exemplu, postgresql94-contrib), să încărcați modulul necesar în configurație, să specificați parametrii pentru acesta, să reporniți PostgreSQL și să utilizați. (Notă. În funcție de distribuție, în versiunile recente, pachetul contrib face parte din pachetul principal.).
- Există contriburi neoficiale. Acestea nu sunt incluse în livrarea standard a PostgreSQL. Trebuie fie să fie compilate, fie instalate ca biblioteci. Opțiunile pot varia foarte mult, în funcție de ceea ce a gândit dezvoltatorul acestui contrib neoficial.
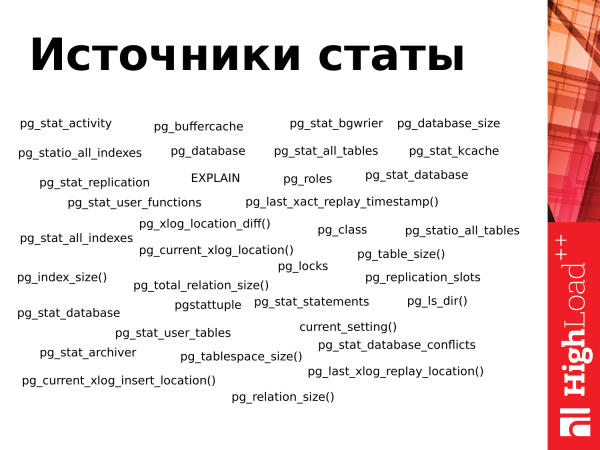
Pe acest diapozitiv sunt prezentate toate acele vizualizări (VIEWs) și o parte din funcțiile disponibile în PostgreSQL 9.4. După cum putem observa, sunt foarte multe. Este destul de ușor să te pierzi, dacă te întâlnești cu acest lucru pentru prima dată.
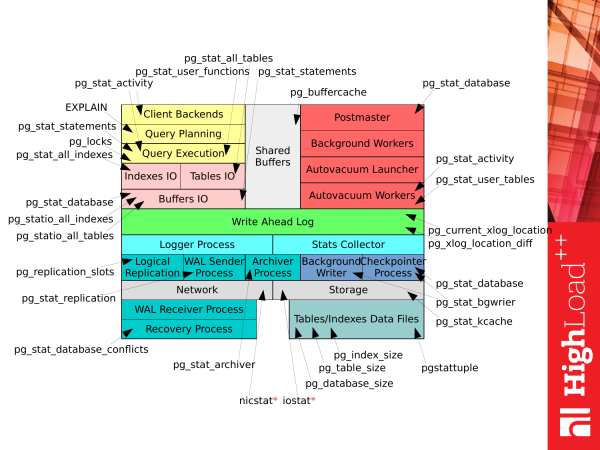
Cu toate acestea, dacă luăm imaginea anterioară Cum se cheltuie timpul pe PostgreSQL și o corelăm cu această listă, atunci obținem o astfel de imagine. Fiecare vizualizare (VIEWs), fiecărei funcții le putem folosi în scopuri diferite pentru a obține statistici corespunzătoare, atunci când PostgreSQL este activ. Și putem deja obține informații despre funcționarea subsistemului.
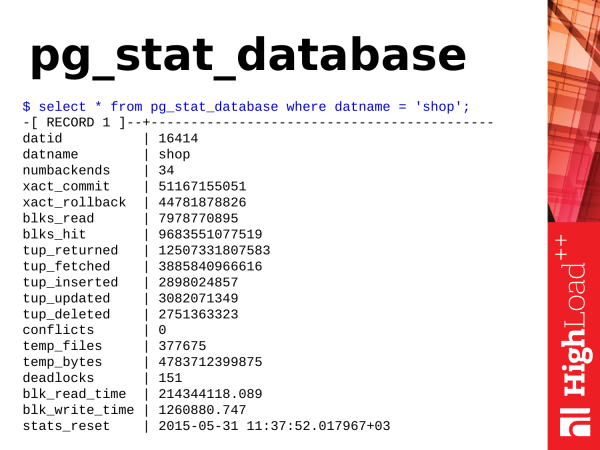
Primul lucru pe care îl vom analiza este pg_stat_database. După cum vedem, aceasta este o vizualizare. Conține foarte multe informații. Informații foarte variate. Și oferă un cunoștinț valoros despre ce se întâmplă în baza de date.
Ce informații utile putem obține de acolo? Să începem cu cele mai simple lucruri.
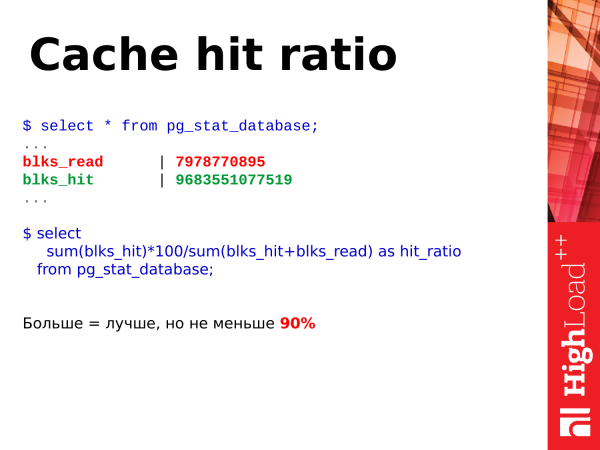
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Primul lucru pe care îl putem observa este procentul de hit-uri în cache. Procentul de hit-uri în cache este o metrică utilă. Aceasta permite evaluarea cât de multe date sunt preluate din cache-ul shared buffers și cât de multe sunt citite de pe disc.
Este evident că cu cât avem mai multe hit-uri în cache, cu atât este mai bine. Evaluăm această metrică ca procent. De exemplu, dacă raportul procentual al acestor hit-uri în cache este mai mare de 90%, atunci este bine. Dacă scade sub 90%, înseamnă că nu avem suficientă memorie pentru a menține „capul” fierbinte al datelor în memorie. Și pentru a utiliza aceste date, PostgreSQL este nevoit să acceseze discul, ceea ce este mai lent decât dacă datele ar fi citite din memorie. Și trebuie deja să ne gândim la creșterea memoriei: fie să creștem shared buffers, fie să extindem memoria RAM.
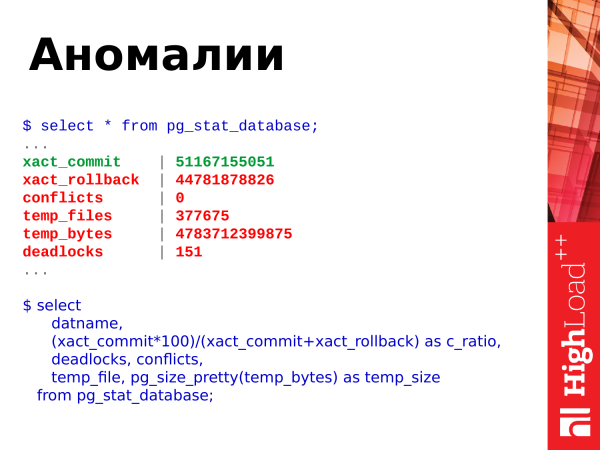
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Ce altceva putem obține din această vizualizare? Putem verifica anomaliile care apar în bază. Ce este prezentat aici? Aici sunt commits, rollbacks, crearea de fișiere temporare, volumul acestora, deadlocks și conflicte.
Putem folosi această interogare. Acest SQL este destul de simplu. Și putem vedea aceste date la noi.
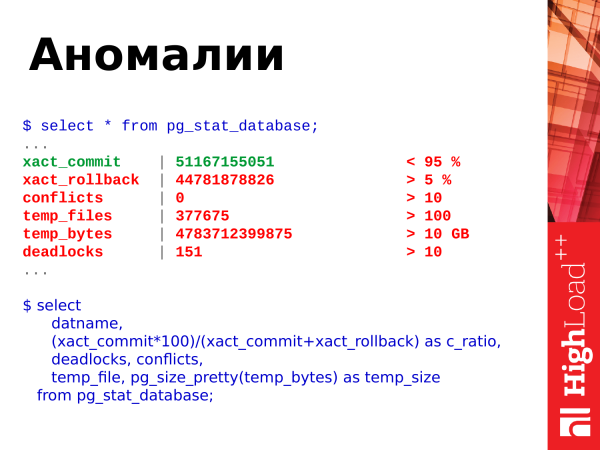
Și aici avem imediat valorile prag. Ne uităm la raportul dintre commits și rollbacks. Commits sunt confirmările reușite ale unei tranzacții. Rollbacks sunt anulări, adică o tranzacție a efectuat o anumită muncă, a solicitat baza de date, a calculat ceva, iar apoi a apărut o eroare și rezultatele tranzacției sunt eliminate. Așadar, un număr tot mai mare de rollbacks este o problemă. Trebuie să le evităm și să ajustăm codul pentru a preveni astfel de situații.
Conflictele sunt legate de replicare. Și acestea trebuie evitate, de asemenea. Dacă aveți câteva interogări care se execută pe replică și apar conflicte, trebuie să analizați aceste conflicte, să verificați ce se întâmplă. Detaliile pot fi găsite în jurnale. Și trebuie să rezolvați situațiile conflicte pentru ca interogările aplicației să funcționeze fără erori.
Deadlocks sunt, de asemenea, o situație nedorită. Când interogările concurează pentru resurse, o interogare a accesat o resursă și a obținut un blocaj, iar cealaltă interogare a accesat o altă resursă și a obținut de asemenea un blocaj, iar apoi ambele interogări au accesat resursele reciproce și s-au blocat așteptând ca vecinul să elibereze blocajul. Aceasta este, de asemenea, o situație problematică. Trebuie rezolvată la nivelul rescrierii aplicațiilor și serializării accesului la resurse. Și dacă observați că deadlocks cresc constant, trebuie să verificați detalii în jurnale, să analizați situațiile apărute și să identificați problema.
Fișierele temporare sunt, de asemenea, o problemă. Atunci când o cerere a utilizatorului nu are suficientă memorie pentru a stoca datele temporare, creează un fișier pe disc. Și toate operațiile pe care le-ar putea efectua în bufferul temporar din memorie, încep să se realizeze deja pe disc. Aceasta este lent. Aceasta crește timpul de execuție al cererii. Și clientul care a trimis cererea către PostgreSQL va primi un răspuns puțin mai târziu. Dacă toate aceste operații sunt realizate în memorie, Postgres va răspunde mult mai repede, iar clientul va aștepta mai puțin.
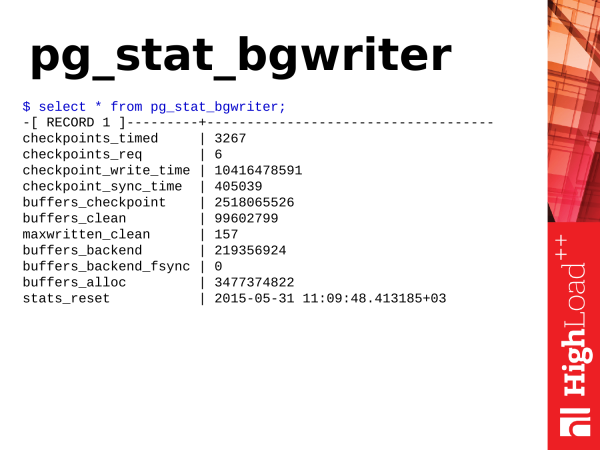
Pg_stat_bgwriter este o viziune care descrie activitatea a două subsisteme de fundal PostgreSQL: aceasta checkpointer și background writer.
Pentru început, să analizăm punctele de control, așa-numitele checkpoints. Ce sunt punctele de control? Un punct de control este o poziție în jurnalul tranzacțiilor care indică faptul că toate modificările de date înregistrate în jurnal au fost sincronizate cu datele de pe disc. Procesul, în funcție de sarcina de lucru și de setări, poate dura și se concentrează în mare parte pe sincronizarea paginilor murdare din buffer-ele partajate cu fișierele de date de pe disc. De ce este necesar? Dacă PostgreSQL ar accesa constant discul pentru a prelua date și ar scrie date cu fiecare acces, ar fi lent. Prin urmare, PostgreSQL are un segment de memorie, a cărui dimensiune depinde de parametrii din configurație. Postgres stochează în această memorie datele operative pentru procesare ulterioară sau pentru livrare la cerere. În cazul cererilor de modificare a datelor, aceste date sunt actualizate. Astfel, obținem două versiuni ale datelor. Una în memorie, cealaltă pe disc. Și periodic, aceste date trebuie sincronizate. Trebuie să sincronizăm ceea ce a fost modificat în memorie cu discul. De aceea sunt necesare punctele de control.
Punctul de control trece prin buffer-ele partajate, marchează paginile murdare care sunt necesare pentru punctul de control. Apoi, inițiază o a doua trecere prin buffer-ele partajate. Iar paginile marcate pentru punctul de control sunt sincronizate. Astfel, se realizează sincronizarea datelor cu discul.
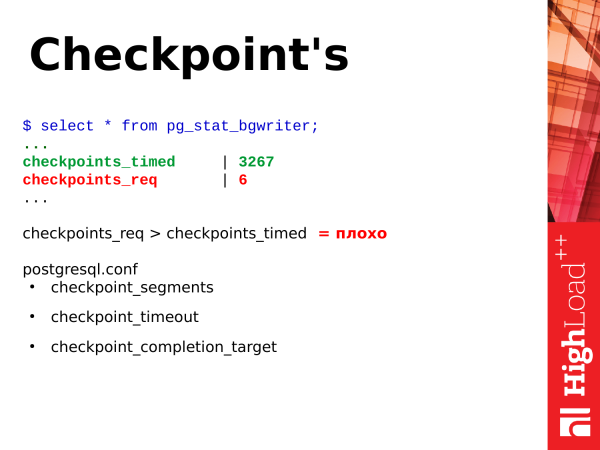
Există două tipuri de puncte de control. Un punct de control se execută la expirarea unui timp limită. Acesta este un punct de control util și bun – checkpoint_timed. Și există puncte de control pe cerere – checkpoint required. Un astfel de punct de control are loc atunci când avem o scriere foarte mare de date. Am înregistrat multe jurnale de tranzacții. Și PostgreSQL consideră că trebuie să sincronizeze totul cât mai repede, să facă un punct de control și să continue.
Și dacă ați verificat statistica pg_stat_bgwriter și ați observat că aveți checkpoint_req mult mai mare decât checkpoint_timed, atunci este rău. De ce este rău? Acest lucru înseamnă că PostgreSQL se află într-o situație de stres constant, când trebuie să scrie date pe disc. Punctul de control la expirarea unui timp limită este mai puțin stresant și se execută conform unui program intern și este cumva întins în timp. PostgreSQL are capacitatea de a face pauze în activitate și de a nu tensiona subsistemul de disc. Acesta este un lucru util pentru PostgreSQL. Și cererile care sunt executate în timpul unui punct de control nu vor experimenta stres din cauza utilizării subsistemului de disc.
Și pentru reglarea checkpoint-ului există trei parametri:
checkpoint_segments.checkpoint_timeout.checkpoint_competion_target.
Aceștia permit reglarea funcționării punctelor de control. Dar nu voi insista asupra lor. Influența lor este un subiect aparte.
Atenție: Versiunea discutată în raport, 9.4, nu mai este actuală. În versiunile moderne PostgreSQL, parametrul checkpoint_segments a fost înlocuit de parametrii min_wal_size și max_wal_size.
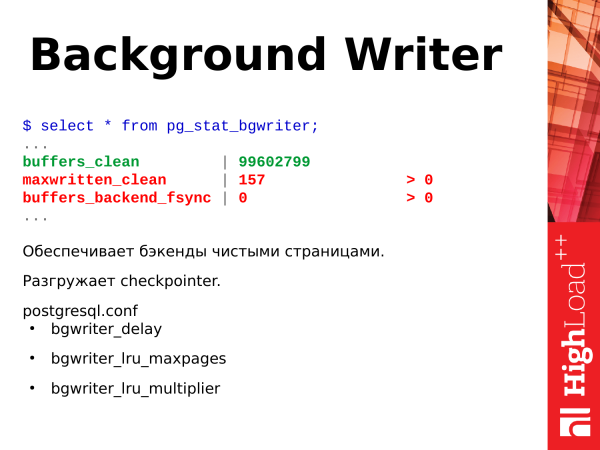
Următoarea subsistemă este scriitorul în fundal — background writer. Ce face el? Lucrează constant într-un ciclu infinit. Scanează paginile din shared buffers și paginile murdare pe care le găsește le scrie pe disc. Astfel, ajută checkpointer-ul să efectueze mai puțină muncă în timpul executării punctelor de control.
La ce mai este util? Asigură necesitatea de pagini curate în shared buffers dacă vor fi nevoie (în cantitate mare și imediat) pentru stocarea datelor. Să presupunem că a apărut o situație când pentru executarea unei cereri sunt necesare pagini curate și acestea există deja în shared buffers. Backend-ul backend le ia pur și simplu și le folosește, nu trebuie să curățe nimic singur. Dar dacă dintr-o dată nu sunt astfel de pagini, backend-ul își suspendă activitatea și începe căutarea paginilor pentru a le scrie pe disc și a le lua pentru propriile nevoi — ceea ce afectează negativ timpul cererii în curs de desfășurare. Dacă observați că parametrul maxwritten_clean este mare, înseamnă că scriitorul în fundal nu își îndeplinește sarcinile și este necesar să creșteți parametrii bgwriter_lru_maxpages, pentru a putea realiza mai multă muncă într-un singur ciclu, curățând mai multe pagini.
Și un alt indicator foarte util – este buffers_backend_fsync. Backend-urile nu efectuează fsync, deoarece este lent. Ele transmit fsync mai sus în stiva IO checkpointer-ului. Checkpointer-ul are o coadă, el prelucrează periodic fsync-ul și sincronizează paginile din memorie cu fișierele de pe disc. Dacă coada la checkpointer este mare și plină, backend-ul este obligat să efectueze singur fsync, ceea ce încetinește activitatea sa,adică clientul va primi un răspuns mai târziu decât ar putea. Dacă observați că acest valoare este mai mare decât zero, atunci acesta este deja o problemă și trebuie să acordați atenție setărilor scriitorului în fundal și să evaluați și performanța subsistemului de disc.
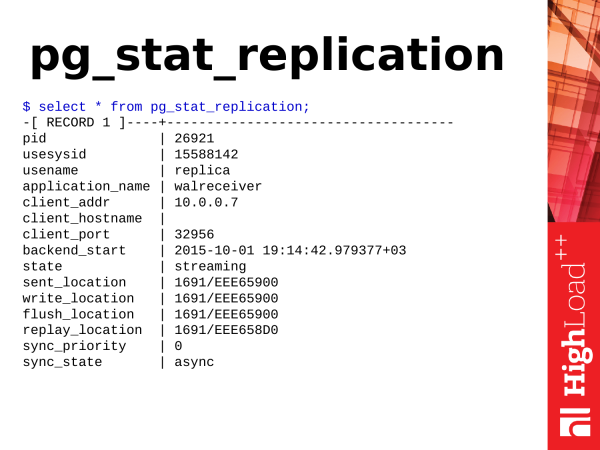
Atenție: _Următorul text descrie reprezentările statistice legate de replicare. Majoritatea numelui reprezentărilor și funcțiilor au fost redenumite în Postgres 10. Esența redenumirii consta în înlocuirea xlog pe wal și location pe în numele funcțiilor/reprezentărilor etc. Un exemplu specific, funcția pg_xlog_location_diff() a fost redenumită în pg_wal_lsn_diff() Aici avem multe lucruri. Dar ne vor fi necesare doar punctele legate de location.._
Dacă vedem că toate valorile sunt egale, atunci este varianta ideală și replica nu întârzie față de master.
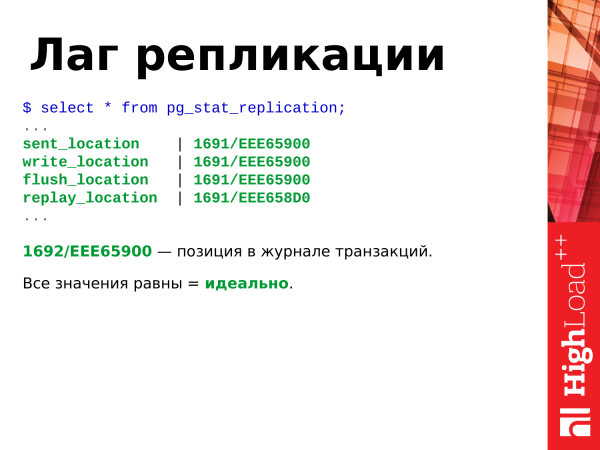
Această poziție hexadecimală reprezintă o poziție în jurnalul de tranzacții. Ea crește constant, dacă există o activitate în bază de date: inserări, ștergeri etc.
cât xlog a fost scris în octeți $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); întârzierea replicării în octeți $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) from pg_stat_replication; întârzierea replicării în secunde $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
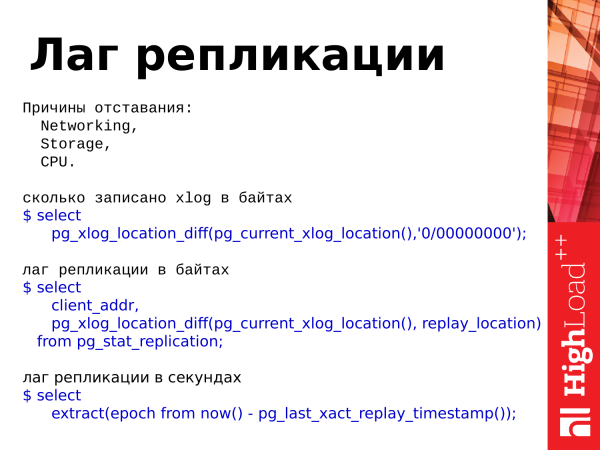
Dacă aceste lucruri diferă, înseamnă că există o întârziere. Întârzierea reprezintă decalajul replicii față de master, adică datele diferă între servere.Există trei motive pentru întârziere:
Este subsistemul de discuri care nu face față scrierii sincronizării fișierelor.
- Sunt posibile erori de rețea sau o suprasarcină a rețelei, când datele nu ajung la replică la timp și acesta nu le poate reda.
- Și procesorul. Procesorul este un caz foarte rar. Și am văzut așa ceva de două sau trei ori, dar se poate întâmpla și asta.
- Și iată trei interogări care ne permit să folosim statisticile. Putem evalua cât a fost scris în jurnalul de tranzacții. Există o astfel de funcție
pg_xlog_location_diff și putem evalua întârzierea replicării în octeți și secunde. Folosim de asemenea valoarea din această prezentare (VIEWs). _În loc de pg_xlog_location
Notă: diff() se poate utiliza operatorul de scădere și se poate scădea o location din alta. Convenabil.Cu întârzierea în secunde, există un aspect. Dacă nu există nicio activitate pe master, tranzacția a fost acum 15 minute în urmă și nu există nicio activitate, iar dacă ne uităm la replică această întârziere, atunci vom vedea o întârziere de 15 minute. Trebuie să țineți cont de acest lucru. Și asta poate fi confuz, atunci când ați verificat această întârziere.
Există un moment legat de întârzieri în secunde. Dacă pe serverul principal nu se înregistrează nicio activitate, iar tranzacția a avut loc acum aproximativ 15 minute fără nicio activitate, iar dacă ne uităm la replica acestui lag, vom observa o întârziere de 15 minute. Este important să ne amintim acest lucru. Acest lucru poate fi derutant atunci când te uiți la această întârziere.
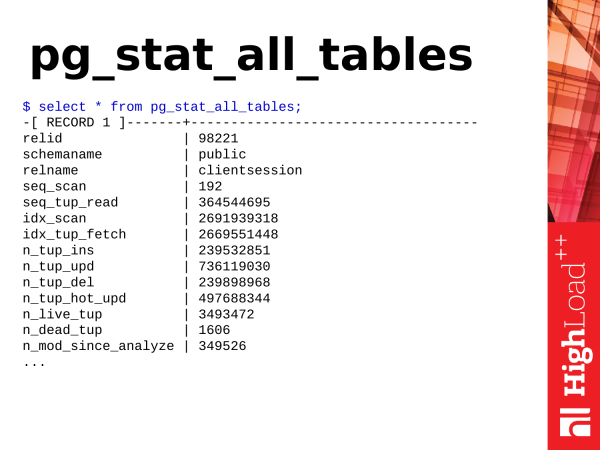
Pg_stat_all_tables – o altă vedere utilă. Aceasta arată statistici despre tabele. Când în baza noastră există tabele cu o anumită activitate, o serie de acțiuni, putem obține această informație din această vedere.
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
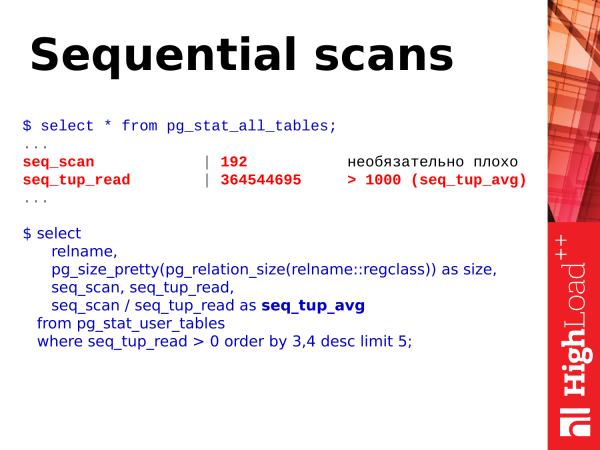
Primul lucru pe care îl putem analiza este numărul de scanări secvențiale ale tabelei. Numărul de după aceste treceri nu este neapărat un indicator negativ și nu arată că trebuie să intervenim deja.
Cu toate acestea, există o a doua metrică – seq_tup_read. Aceasta reprezintă numărul de rânduri returnate ca urmare a scanării secvențiale. Dacă numărul mediu depășește 1.000, 10.000, 50.000, 100.000, atunci este un semn că poate ar trebui să construim un index pentru a face accesările prin index, sau poate ar trebui să optimizăm interogările care folosesc aceste scanări secvențiale pentru a evita astfel de situații.
Un exemplu simplu – să presupunem că o interogare cu un OFFSET și LIMIT mari este executată. De exemplu, se scanează 100.000 de rânduri din tabel, după care se preiau 50.000 de rânduri necesare, iar celelalte scanate anterior sunt respinse. Acesta este un caz nefericit. Aceste interogări trebuie optimizate. Iată un simplu SQL pe care îl puteți folosi pentru a observa și evalua cifrele obținute.
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
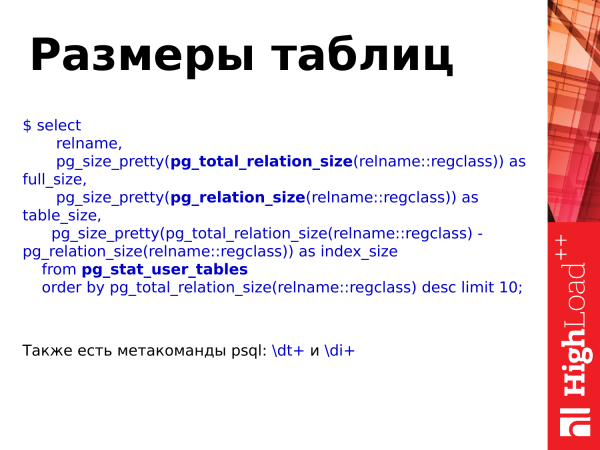
Dimensiunile tabelelor pot fi de asemenea obținute prin intermediul acestei tabele și prin utilizarea unor funcții suplimentare. pg_total_relation_size(), pg_relation_size().
În general, există metacomande dt și di, care pot fi utilizate în PSQL pentru a vizualiza dimensiunile tabelelor și indexurilor.
Însă utilizarea funcțiilor ne ajută să vedem dimensiunile tabelelor atât cu indexuri, cât și fără a ține cont de indexuri, și astfel să facem evaluări pe baza creșterii bazei de date, adică cum crește, cu ce intensitate, și să tragem concluzii despre optimizarea dimensiunilor.
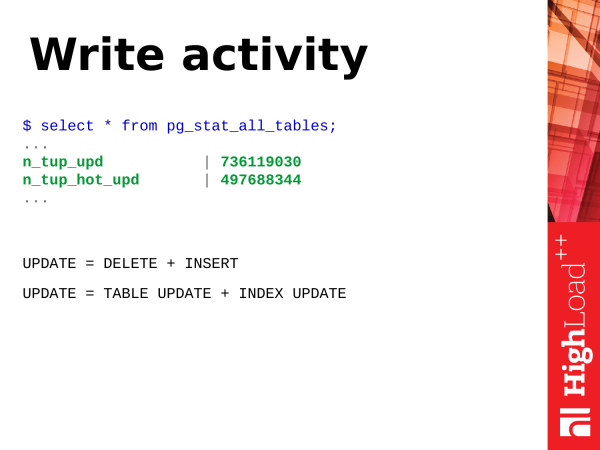
Activitatea de scriere. Ce reprezintă scrierea? Să analizăm operațiunea UPDATE — operațiunea de actualizare a rândurilor din tabel. În esență, update este de fapt două operațiuni (sau chiar mai multe). Aceasta este inserarea unei noi versiuni a rândului și marcarea versiunii vechi ca fiind învechită. Ulterior, va veni avacuumul și va curăța aceste versiuni vechi ale rândurilor, marcând acel loc ca fiind disponibil pentru reutilizare.
În plus, update nu este doar actualizarea tabelului. Este, de asemenea, actualizarea indexurilor. Dacă aveți multe indexuri în tabel, atunci la update toate indexurile care implică câmpurile actualizate în interogare vor trebui, de asemenea, actualizate. În aceste indexuri vor exista și versiuni învechite ale rândurilor care vor trebui curățate.
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
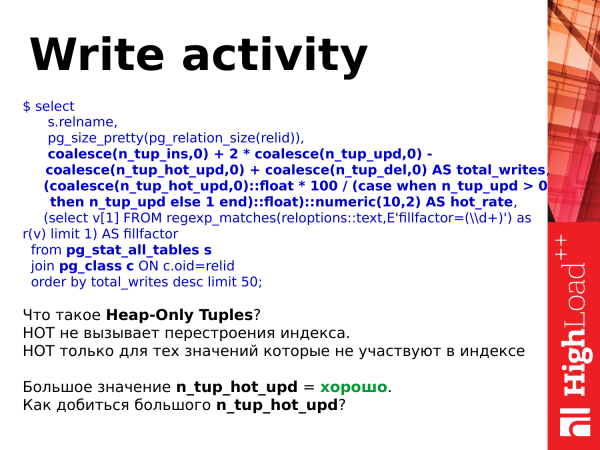
Și datorită designului său, UPDATE – acestea sunt operațiuni grele. Dar ele pot fi ușurate. Există hot updates. Acestea au apărut în PostgreSQL versiunea 8.3. Și ce sunt? Acestea sunt update-uri ușoare, care nu provoacă reconstruirea indexurilor. Adică, am actualizat o înregistrare, dar în același timp s-a actualizat doar înregistrarea din pagină (care aparține tabelului), iar indexurile continuă să indice spre aceeași înregistrare din pagină. Acolo există o logică interesantă de funcționare, atunci când vine vacuumul, el reconstruiește aceste lanțuri hot și totul continuă să funcționeze fără actualizarea indexurilor, și se întâmplă totul cu un consum mai mic de resurse.
Și când aveți n_tup_hot_upd mare, atunci este foarte bine. Acest lucru înseamnă că update-urile ușoare predomină și din punct de vedere al resurselor, se dovedește că sunt mai ieftine și totul este excelent.
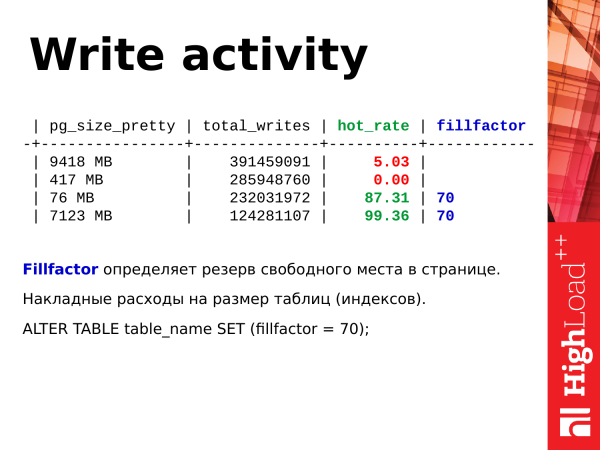
ALTER TABLE table_name SET (fillfactor = 70);Cum să creșteți volumul hot updateurilor? Putem folosi fillfactor. Acesta definește dimensiunea spațiului liber rezervat atunci când se umple pagina din tabel cu ajutorul INSERT-urilor. Când în tabel se fac inserții, acestea umplu complet pagina, fără a lăsa spațiu gol în ea. Apoi, se alocă o nouă pagină. Din nou, datele se umplu. Și acest comportament este implicit, fillfactor = 100%.
Putem seta fillfactor la 70%. Adică, în momentul inserțiilor, se ocupă doar 70% dintr-o pagină, iar 30% rămân ca rezervă. Când va fi nevoie de un update, acesta va avea loc, cu o mare probabilitate, în aceeași pagină, iar noua versiune a rândului va fi plasată în aceeași pagină. Se va efectua astfel un hot_update. Astfel, se facilitează scrierea în tabele.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
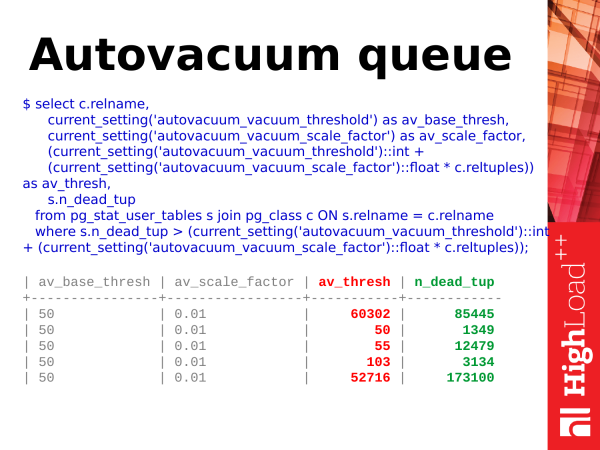
Coada de av vacuum. Av vacuum – este un subsistem pentru care statistica în PostgreSQL este foarte redusă. Putem observa în tabelele din pg_stat_activity câte vacuum-uri avem în prezent. Totuși, este foarte dificil să înțelegem câte tabele sunt în coadă.
Notă: _Începând cu versiunea Postgres 10, situația în ceea ce privește monitorizarea av vacuum-ului s-a îmbunătățit semnificativ – a fost introdusă vizualizarea pg_stat_progressvacuum, care simplifică considerabil problema monitorizării av vacuum-ului.
Putem folosi următoarea interogare simplificată. Și putem observa când ar trebui să fie făcut vacuum-ul. Dar, când și cum ar trebui să pornească vacuum-ul? Aceste versiuni învechite ale rândurilor, despre care am vorbit mai devreme. A avut loc un update, noua versiune a rândului a fost inserată. A apărut o versiune învechită a rândului. În tabelul pg_stat_user_tables există acest parametru n_dead_tup. Acesta arată numărul de rânduri "moarte". Și de îndată ce numărul rândurilor moarte depășește un anumit prag, av vacuum-ul va veni la tabel.
Și cum se calculează acest prag? Este o proporție procentuală specifică din totalul rândurilor din tabel. Există parametrul autovacuum_vacuum_scale_factor. Acesta definește proporția procentuală. De exemplu, 10% + un prag de bază suplimentar de 50 de rânduri. Și ce obținem? Când avem mai multe rânduri moarte decât "10% + 50" din toate rândurile din tabel, atunci punem tabelul pe av vacuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
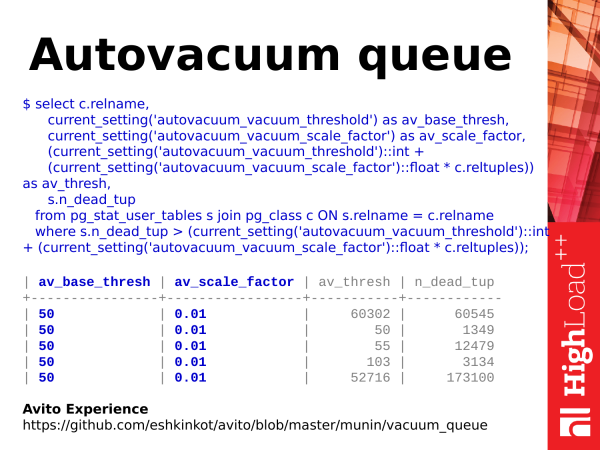
Cu toate acestea, există un moment aici. Pragurile de bază pentru parametrii av_base_thresh și av_scale_factor pot fi stabilite individual. Prin urmare, pragul nu va fi global, ci individual pentru tabel. Așadar, pentru a calcula, trebuie să folosești trucuri și metode. Dacă ești interesat, poți privi experiența colegilor noștri de la Avito (linkul de pe diapozitiv este invalid și a fost actualizat în text).
Ei au scris pentru , care ia în considerare aceste aspecte. Este o scriere pe două pagini. Dar calculează corect și permite evaluarea eficientă a locurilor unde avem un deficit de vid pentru tabele, unde este puțin.
Ce putem face în legătură cu asta? Dacă avem o coadă mare și vacuumul automat nu face față, putem crește numărul de lucrători pentru vacuum sau pur și simplu să facem vacuumul mai agresiv, astfel încât să fie declanșat mai devreme, procesând tabelul în bucăți mici. Astfel, coada va fi redusă. — Principalul lucru este să monitorizăm sarcina pe discuri, deoarece vacuumul nu este gratuit, deși odată cu apariția dispozitivelor SSD/NVMe problema a devenit mai puțin vizibilă.
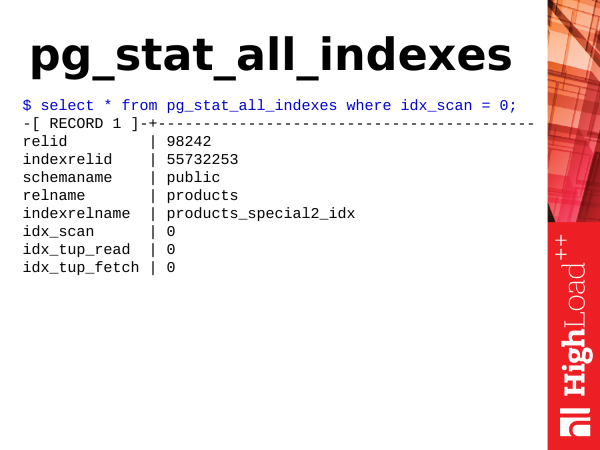
Pg_stat_all_indexes – aceasta este statistica pentru indecși. Este mică. Și putem obține informații despre utilizarea indecșilor. De exemplu, putem determina care indecși sunt redundanți.
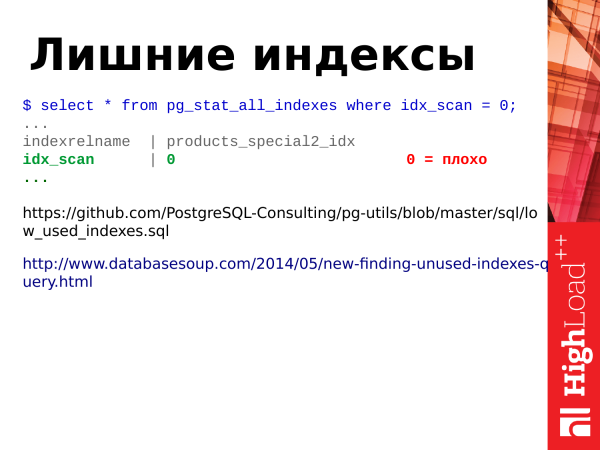
Așa cum am spus deja, update – este nu doar actualizarea tabelelor, ci și actualizarea indecșilor. Prin urmare, dacă avem mulți indecși în tabel, atunci la actualizarea rândurilor din tabel, indecșii câmpurilor indexate trebuie de asemenea actualizați, și dacă avem indecși neutilizați, pentru care nu există scanări indexate, aceștia constituie un ballast. Trebuie să ne debarasăm de ei. Pentru aceasta avem nevoie de câmpul idx_scan. Ne uităm pur și simplu la numărul de scanări indexate. Dacă indecșii au zero scanări pe o perioadă relativ lungă de păstrare a statisticilor (de cel puțin 2-3 săptămâni), atunci cel mai probabil aceștia sunt indecși slab calibrați, de la care trebuie să ne debarasăm.
Notă: Când căutăm indecși neutilizați în cazul clusterelor de replicare în flux, trebuie să verificăm toate nodurile clusterului, deoarece statisticile nu sunt globale, și dacă un index nu este utilizat pe master, acesta poate fi utilizat pe replici (dacă există încărcare acolo).
Două linkuri:
Acestea sunt exemple mai avansate de interogări pentru a căuta indecși neutilizați.
Al doilea link este o solicitare destul de interesantă. Acolo este o logică foarte neobișnuită. Îl recomand pentru studiu.
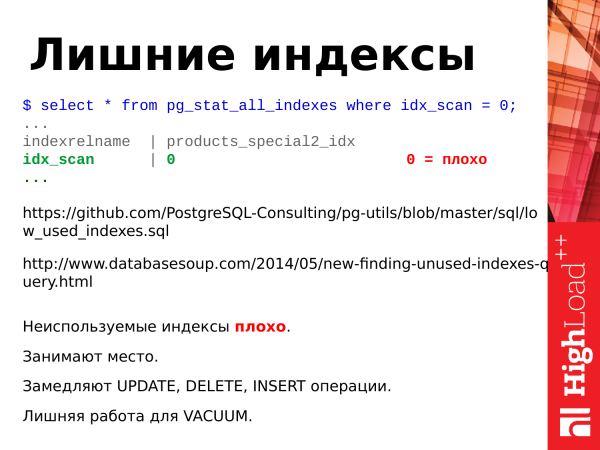
Ce altceva ar trebui să rezumăm în legătură cu indicii?
Indicii neutilizați sunt o problemă.
Ei ocupă spațiu.
Încetinesc operațiile de actualizare.
Reprezintă un efort suplimentar pentru sistem.
Dacă eliminăm indicii neutilizați, vom face baza de date mult mai bună.
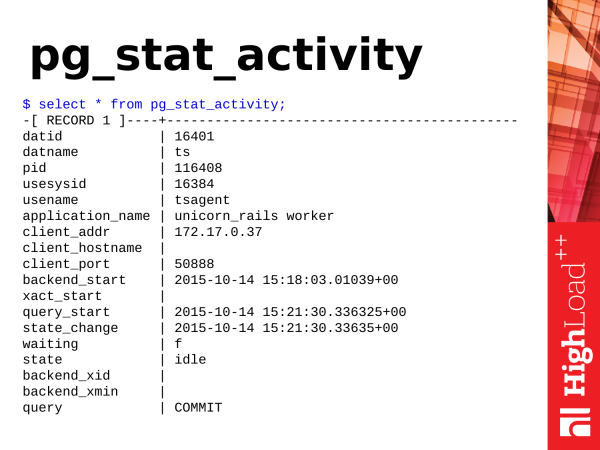
Următoarea prezentare este pg_stat_activity. Aceasta este echivalentul utilitarului ps, doar că în PostgreSQL. Dacă psmonitorizați procesele în sistemul de operare, atunci pg_stat_activity vă va arăta activitatea din PostgreSQL.
Ce putem lua de acolo de folos?
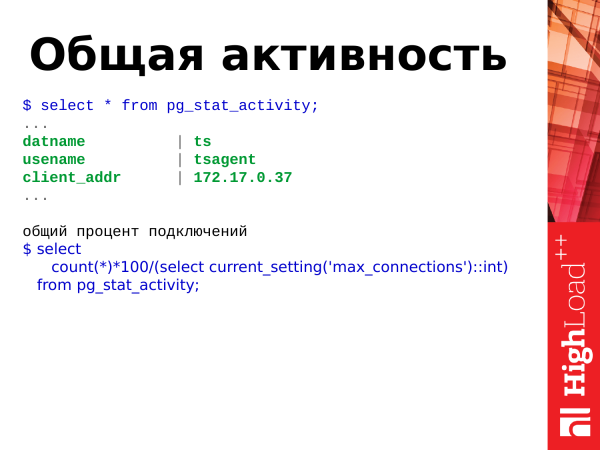
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Putem vedea activitatea generală, ce se întâmplă în baza de date. Putem face un nou deploy. Totul este în aer, conexiunile noi nu sunt acceptate, erorile curg în aplicație.
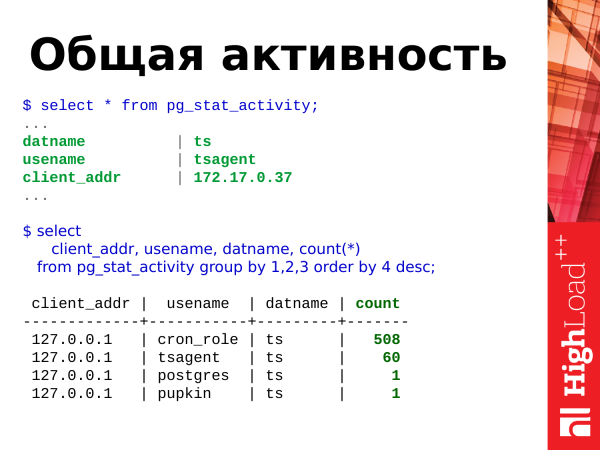
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Putem executa această interogare și să vedem procentul total de conexiuni în raport cu limita maximă de conexiuni și să vedem cine are cele mai multe conexiuni. În cazul prezentat, observăm că utilizatorul cron_role a deschis 508 conexiuni. Ceva s-a întâmplat acolo. Trebuie să ne ocupăm de el și este foarte posibil să fie un număr anormal de conexiuni.
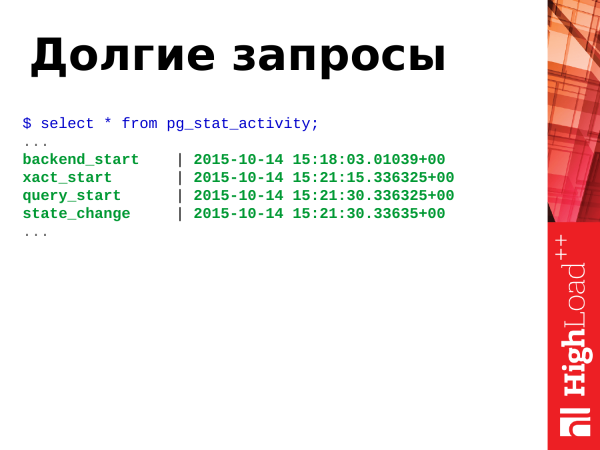
Dacă avem o încărcare OLTP, interogările trebuie să fie executate repede, foarte repede și nu trebuie să existe interogări lungi. Totuși, dacă apar interogări lungi, pe termen scurt nu este nimic grav, dar pe termen lung, interogările lungi afectează baza de date, ele cresc efectul de bloat al tabelelor, când apare fragmentarea tabelelor. Este necesar să ne eliberăm de bloat și de interogările lungi.
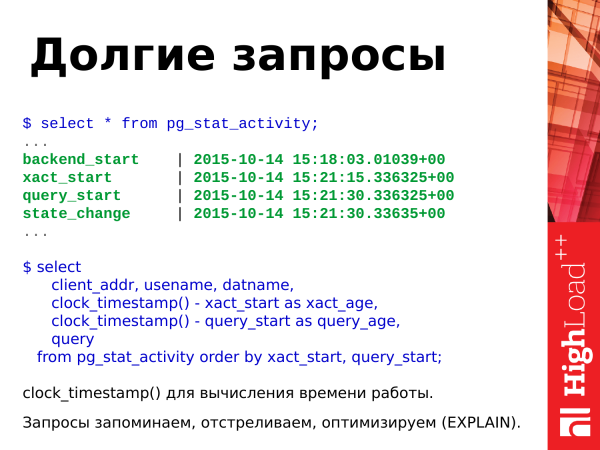
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Rețineți: cu această interogare putem determina interogările și tranzacțiile lungi. Folosim funcția clock_timestamp() pentru a determina timpul de execuție. Interogările lungi descoperite pot fi memorate, executate explain, putem examina planurile și optimiza cumva. Interogările lungi curente le oprind și apoi continuăm.
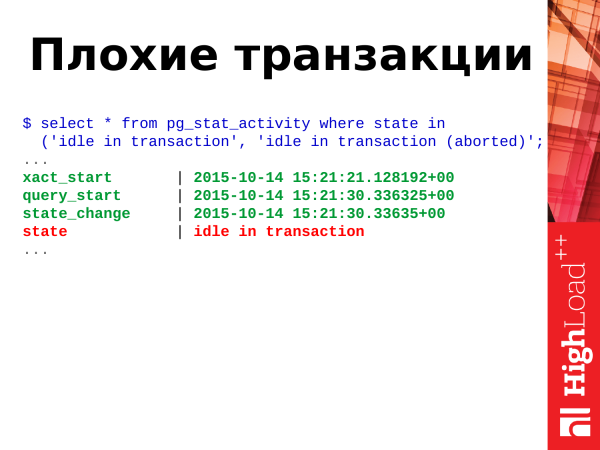
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Tranzacțiile proaste sunt tranzacțiile aflate în starea idle in transaction și idle in transaction (aborted).
Ce înseamnă asta? Tranzacțiile au mai multe stări. Și una dintre aceste stări le poate lua în orice moment. Pentru a determina stările, există un câmp state în această reprezentare. Și îl folosim pentru a determina starea.
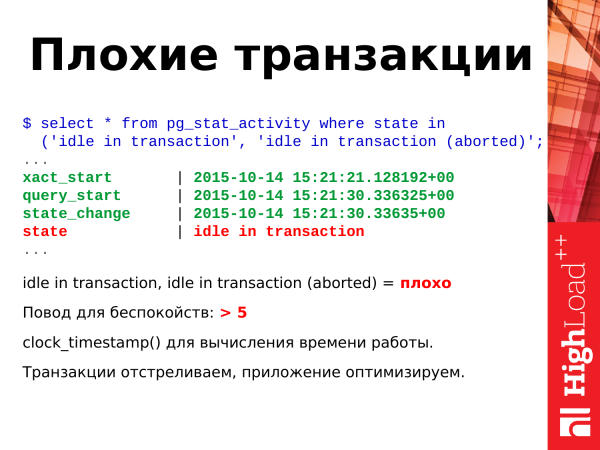
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Și, așa cum am spus mai sus, aceste două stări idle in transaction și idle in transaction (aborted) – sunt dăunătoare. Ce sunt acestea? Este atunci când aplicația a deschis o tranzacție, a efectuat anumite acțiuni și apoi a plecat la alte treburi. Tranzacția a rămas deschisă. Ea rămâne suspendată, nimic nu se întâmplă, ocupă conexiunea, blochează liniile modificate și, potențial, crește bloat-ul altor tabele din cauza arhitecturii motorului tranzacțional Postgres. Aceste tranzacții trebuie, de asemenea, eliminate, deoarece sunt dăunătoare în general, în orice ipoteză.
Dacă observați că aveți mai mult de 5-10-20 dintre acestea în baza de date, atunci ar trebui să vă îngrijorați și să începeți să faceți ceva în legătură cu ele.
Aici folosim, de asemenea, pentru calcularea timpului clock_timestamp(). Eliminăm tranzacțiile, optimizăm aplicația.
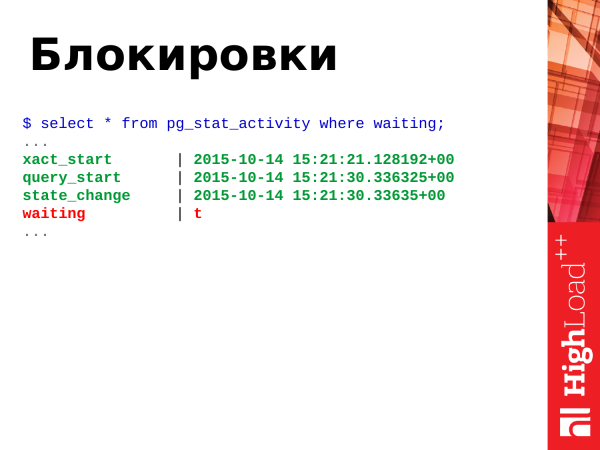
Așa cum am spus mai sus, blocajele sunt atunci când două sau mai multe tranzacții se luptă pentru o resursă sau un grup de resurse. Pentru aceasta avem câmpul waiting cu o valoare booleană true sau false.
True – înseamnă că procesul este în așteptare, trebuie să facem ceva. Când procesul este în așteptare, înseamnă că clientul care a inițiat acest proces așteaptă, de asemenea. Clientul din browser stă și el și așteaptă.
Atenție: _Începând cu versiunea Postgres 9.6, câmpul waiting a fost eliminat și în locul lui au fost adăugate două câmpuri mai informative wait_event_type și wait_event._
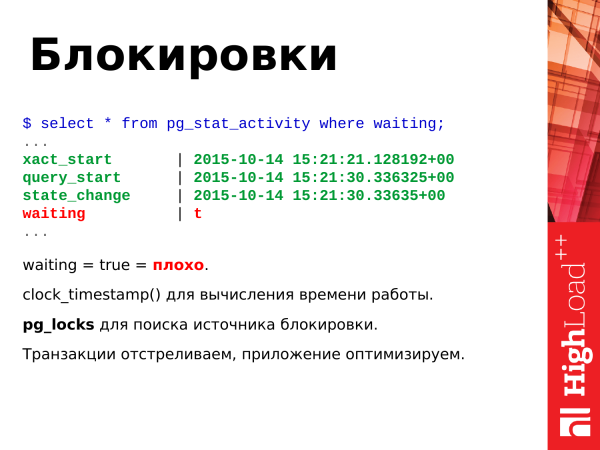
Ce să fac? Dacă vedeți true pentru o perioadă lungă, înseamnă că trebuie să scăpați de astfel de interogări. Pur și simplu eliminăm astfel de tranzacții. Scriem dezvoltatorilor că trebuie să optimizeze cumva, pentru a nu exista competiții pentru resurse. Și apoi dezvoltatorii optimizează aplicația, astfel încât să nu apară astfel de probleme.
Și un caz extrem, dar totuși potențial non-fatal – este apariția deadlocks. Două tranzacții au actualizat două resurse, apoi se referă din nou la acestea, acum la resurse opuse. PostgreSQL în acest caz ia și elimină tranzacția, astfel încât cealaltă să poată continua activitatea. Aceasta este o situație blocată și ea nu se rezolvă singură. De aceea, PostgreSQL este obligat să ia măsuri extreme.
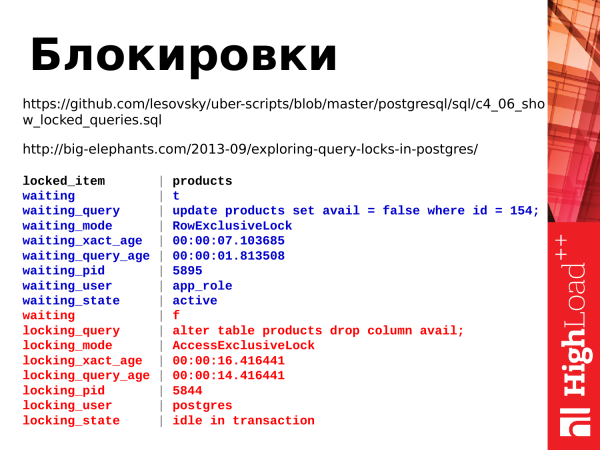
Și iată două interogări care permit urmărirea blocajelor. Folosim reprezentarea pg_locks, care permite urmărirea blocajelor grele.
Iar primul link este textul cererii. Este destul de lung.
Și al doilea link este un articol despre blocaje. Merită citit, este foarte interesant.
Deci, ce vedem? Vedem două cereri. O tranzacție cu ALTER TABLE – este o tranzacție blocantă. A fost inițiată, dar nu a fost finalizată și aplicația care a pornit această tranzacție se ocupă acum cu alte lucruri. A doua cerere – update. Așteaptă să se termine alter table pentru a continua munca.
Așa putem descoperi cine a blocat pe cine, cine reține și putem să ne ocupăm de asta mai departe.
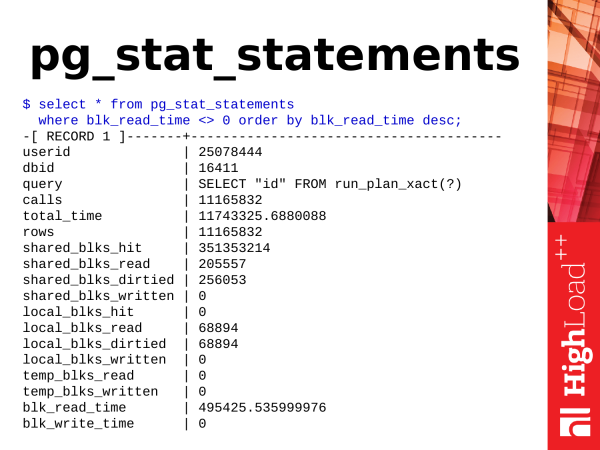
Următorul modul este pg_stat_statements. Așa cum am spus, acesta este un modul. Pentru a-l folosi, trebuie să încărcăm biblioteca în configurație, să repornim PostgreSQL, să instalăm modulul (cu o singură comandă) și apoi vom avea o nouă viziune.
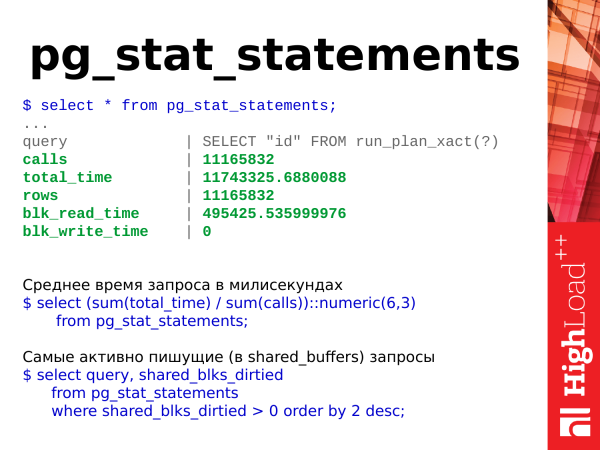
Timpul mediu de cerere în milisecunde
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Cele mai active cereri de scriere (în shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Ce putem lua de acolo? Dacă vorbim despre lucruri simple, putem să luăm timpul mediu de execuție a cererii. Dacă timpul crește, înseamnă că PostgreSQL răspunde lent și trebuie să întreprindem ceva.
Putem verifica cele mai active tranzacții de scriere din baza de date, care schimbă date în shared buffers. Putem să ne uităm cine actualizează sau șterge date.
Și putem să vizualizăm diferite statistici legate de aceste cereri.
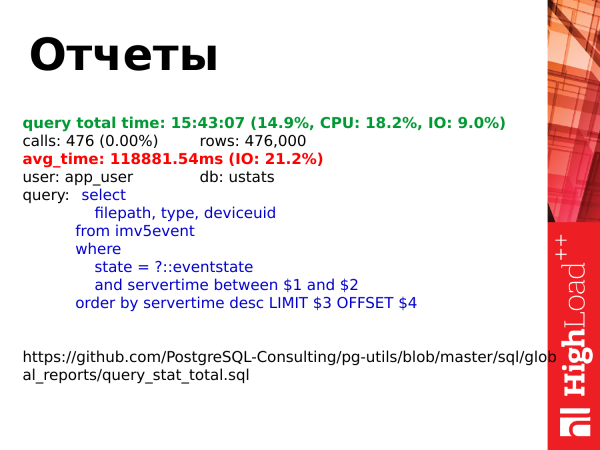
Noi pg_stat_statements folosim pentru generarea rapoartelor. Resetăm statisticile o dată pe zi. Le acumulăm. Înainte de resetare statisticile, generăm un raport. Iată un link către raport. Îl puteți vizualiza.
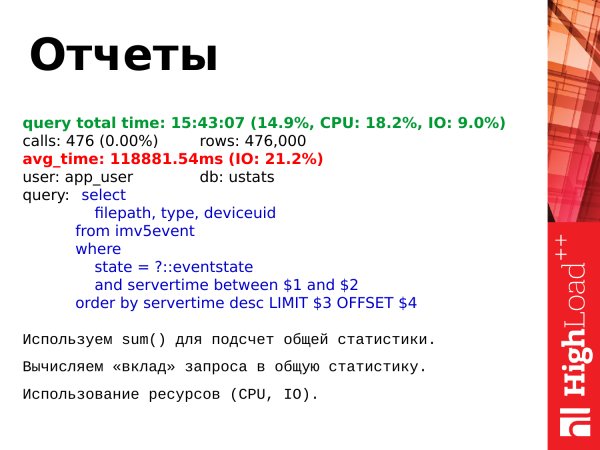
Ce facem? Calculăm statistica totală pentru toate cererile. Apoi, pentru fiecare cerere, calculăm contribuția sa individuală la această statistică totală.
Și ce putem vizualiza? Putem să vedem timpul total de execuție pentru toate cererile unui anumit tip în comparație cu celelalte cereri. Putem verifica utilizarea resurselor de procesor și intrare-ieșire în raport cu imaginea generală. Apoi optimizăm aceste cereri. Generăm un top al cererilor pe baza acestui raport și obținem material de reflecție pentru optimizare.
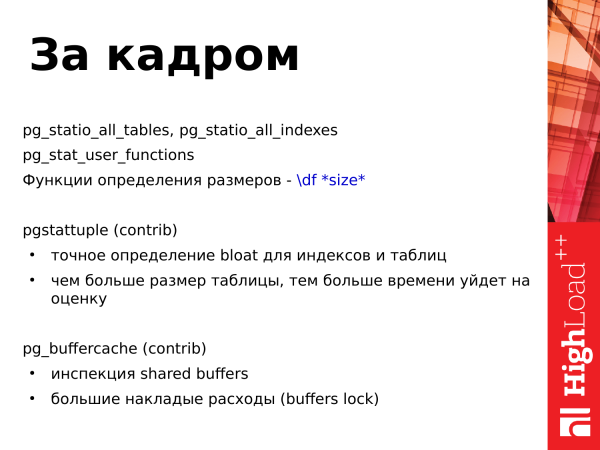
Ce ne-a mai rămas în culise? Au mai rămas câteva prezentări pe care nu le-am abordat, deoarece timpul este limitat.
Există pgstattuple – este un modul suplimentar din pachetul standard contribs. Permite evaluarea bloat tabelilor, adică a fragmentării tabelelor. Și dacă fragmentarea este mare, trebuie să o eliminăm, folosind diverse instrumente. Funcția pgstattuple funcționează mult timp. Și cu cât sunt mai multe tabele, cu atât va dura mai mult.
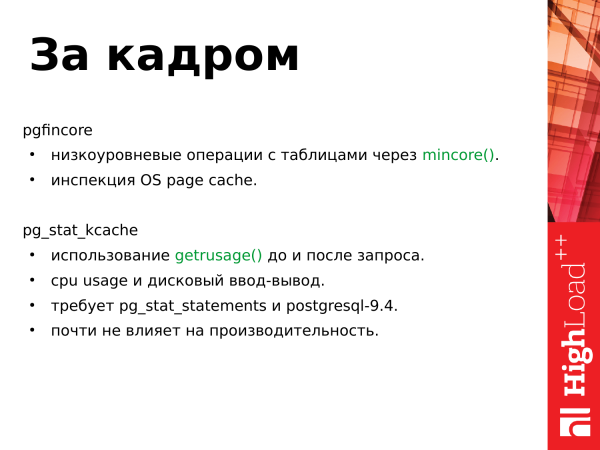
Următorul contrib – este pg_buffercache. Permite inspectarea bufferelor partajate: cât de intens și pentru ce tabele sunt utilizate paginile bufferului. Și pur și simplu permite să aruncați o privire în bufferele partajate și să evaluați ce se întâmplă acolo.
Următorul modul este pgfincore. Permite efectuarea de operațiuni la un nivel inferior cu tabelele prin apelul de sistem mincore(), adică permite să încărcați o tabelă în bufferul partajat sau să o descărcați. De asemenea, permite, printre altele, inspectarea cache-ului de pagini al sistemului de operare, adică în ce măsură ocupăm tabelul în cache-ul de pagini, în bufferele partajate și pur și simplu permite evaluarea încărcării tabelei.
Următorul modul – pg_stat_kcache. Utilizează de asemenea apelul de sistem getrusage(). Și îl execută înainte și după executarea interogării. În statisticile obținute permite evaluarea cât timp a fost consumat de interogare pentru input-ul/output-ul pe disc, adică operațiile cu sistemul de fișiere și observă utilizarea procesorului. Totuși, modulul este tânăr (ahem-ahem) și pentru a funcționa necesită PostgreSQL 9.4 și pg_stat_statements, despre care am vorbit mai devreme.
A ști să folosești statisticile – este util. Nu ai nevoie de programe externe. Poți să te uiți singur, să vezi, să faci ceva, să execute.
Utilizarea statisticilor nu este complicată, este SQL obișnuit. Ai compilat interogarea, ai redactat-o, ai trimis-o, ai privit.
Statisticile ajută la răspunsul la întrebări. Dacă ai întrebări, te adresezi statisticilor – te uiți, tragi concluzii, analizezi rezultatele.
Și experimentează. Sunt multe interogări, multe date. Tot timpul poți optimiza o interogare existentă. Poți face versiunea ta a interogării, care ți se potrivește mai bine decât originalul și să o folosești.
Linkuri
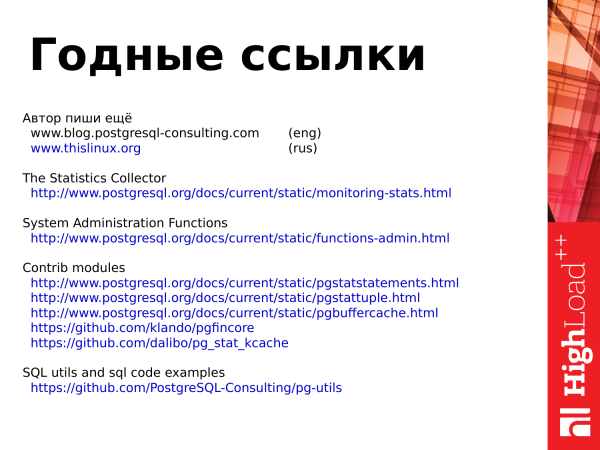
Linkuri utile, care au fost întâlnite în articolul, pe baza materialelor căruia a fost prezentarea.
Autorul scrie din nou
(eng)
Colecția de statistici
Funcții de administrare a sistemului
Module contrib
Utilitare SQL și exemple de cod SQL
Mulțumesc tuturor pentru atenție!
Sursa: habr.com
