

În toamna anului 2019, echipa iOS de la Oborul Mail.ru a trăit un eveniment așteptat mult timp. Principala bază de date pentru stocarea persistentă a stării aplicației a devenit o soluție destul de exotică pentru lumea mobilă. (LMDB). Îți oferim un ghid detaliat în patru părți. Mai întâi, să discutăm motivele unei alegeri atât de neobișnuite și dificile. Apoi, vom analiza cei trei stâlpi ai arhitecturii LMDB: fișierele mapate în memorie, B+-arborele, abordarea copy-on-write pentru implementarea tranzacționalității și multi-versiunii. În final, partea practică: vom discuta despre cum să proiectăm și să implementăm un schema de bază de date cu mai multe tabele, utilizând un API de tip key-value.
Cuprins
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivația implementării
Într-o zi, prin 2015, ne-am preocupat de măsurarea frecvenței cu care interfața aplicației noastre întâmpina întârzieri. Am început acest demers dintr-un motiv întemeiat. Am primit tot mai multe plângeri despre faptul că aplicația uneori nu răspunde la acțiunile utilizatorului: butoanele nu reacționează, listele nu se derulează ș.a.m.d. Despre mecanismul măsurătorilor, la AvitoTech, așa că aici ofer doar un ordin de magnitudine.
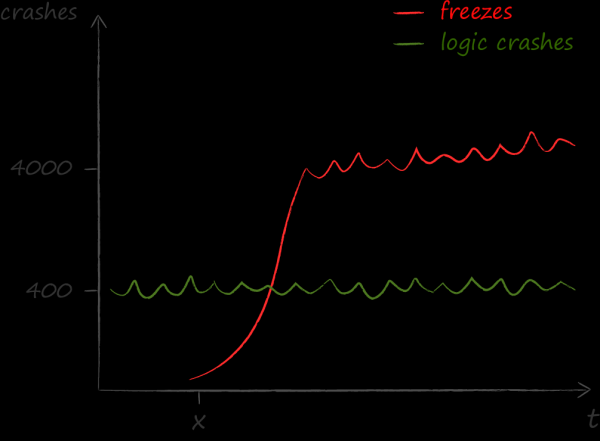
Rezultatele măsurătorilor au fost pentru noi un duș rece. S-a dovedit că problemele cauzate de întârzieri sunt mult mai numeroase decât orice altceva. Dacă înainte de conștientizarea acestui fapt, principalul indicator tehnic de calitate era lipsa de crashe-uri, după aceea, focusul pe lipsa întârzierilor.
Construind și efectuând și a cauzelor lor, a devenit clar principalul dușman — logica de afaceri complexă, care se desfășura în firul principal al aplicației. Reacția naturală la acest haos a fost o dorință arzătoare de a o dispersa pe firele de lucru. Pentru a soluționa sistematic această problemă, am apelat la o arhitectură multi-thread bazată pe actori ușori. Adaptarea acesteia pentru lumea iOS i-am dedicat pe Twitter-ul colectiv și . În cadrul narațiunii actuale vreau să subliniez aspectele soluției care au influențat alegerea bazei de date.
Modelul actor al organizării sistemului presupune că multiprocesarea devine a doua sa esență. Obiectele din model adoră să traverseze granițele firelor de execuție. Și asta nu se întâmplă din când în când sau pe ici, pe colo, ci practic constant și pretutindeni.
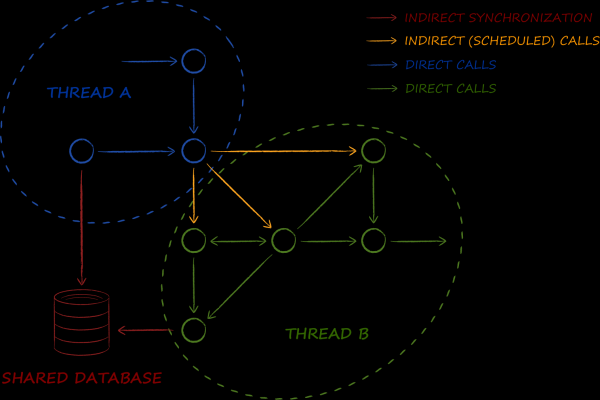
Baza de date este unul dintre componentele fundamentale din schema prezentată. Principala sa sarcină este realizarea macropattern-ului. . Dacă în lumea enterprise această bază de date este utilizată pentru a organiza sincronizarea datelor între servicii, în cazul arhitecturii actor, aceasta este pentru date între fire. Astfel, avem nevoie de o astfel de bază de date, a cărei utilizare în mediu multiprocesare nu provoacă nici măcar cele mai minime dificultăți. Aceasta înseamnă că obiectele obținute din ea trebuie să fie cel puțin sigure în aplicarea concurrentă, iar idealul ar fi să fie complet imuabile. Așa cum se știe, ultimele pot fi utilizate simultan din mai multe fire fără a necesita vreo blocare, ceea ce afectează pozitiv performanța.
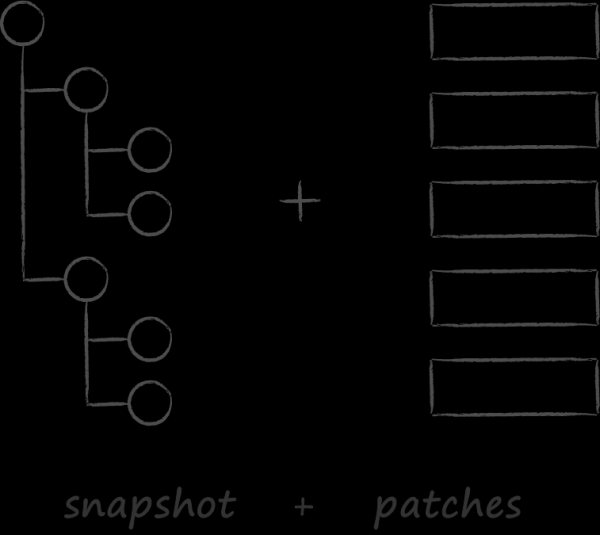 Un alt factor semnificativ care a influențat alegerea bazei de date a fost API-ul nostru cloud. Acesta a fost inspirat de abordarea sincronizării adoptate în git. La fel ca acesta, ne-am orientat spre , care pentru clienții cloud este mai mult decât adecvat. S-a presupus că aceștia vor descărca o singură dată starea completă a cloud-ului, iar apoi sincronizarea în majoritatea cazurilor va avea loc prin aplicarea modificărilor. Din păcate, această posibilitate este încă doar teoretică, iar clienții nu au reușit să învețe cum să lucreze cu patch-uri în practică. Există o serie de motive obiective pentru aceasta, pe care, pentru a nu prelungi introducerea, le lăsăm deoparte. Acum, mult mai interesant sunt lecțiile învățate despre ce se întâmplă când API-ul a spus „A”, iar consumatorul său nu a spus „B”.
Așadar, dacă vă imaginați git, care la executarea comenzii pull în loc să aplice patch-uri la snapshot-ul local compară starea sa completă cu cea a serverului, veți avea o imagine destul de exactă despre cum se desfășoară sincronizarea în clienții cloud. Nu e greu de ghicit că pentru a realiza acest lucru este necesar să alocați în memorie două arbori DOM cu metainformații despre toate fișierele de pe server și cele locale. Așadar, dacă un utilizator stochează în cloud 500 de mii de fișiere, pentru sincronizarea sa este necesar să recreați și să distrugeți două arbori cu 1 milion de noduri. Iar fiecare nod este un agregat care conține un grafic de sub-obiecte. În acest context, rezultatele profilării s-au dovedit a fi așteptate. S-a descoperit că, chiar și fără a lua în considerare logica algoritmului de îmbinare, procedura de creare și distrugere a unui număr mare de obiecte mici costă deja destul de mult. Situația este agravată de faptul că operația de sincronizare de bază este inclusă într-un număr mare de scenarii de utilizator. Ca urmare, fixăm al doilea criteriu important în alegerea unei baze de date – posibilitatea de a realiza operații CRUD fără alocarea dinamică a obiectelor.
Celelalte cerințe sunt mai tradiționale și lista lor completă arată astfel.
- Securitate în multithreading.
- Multiprocesare. Dictată de dorința de a folosi aceeași instanță a bazei de date pentru a sincroniza starea nu doar între fire, ci și între aplicația principală și extensiile iOS.
- Posibilitatea de a reprezenta entitățile stocate sub formă de obiecte nemodificabile.
- Absența alocărilor dinamice în cadrul operațiunilor CRUD.
- Suport pentru proprietățile de bază ale tranzacțiilor : atomicitate, consistență, izolare și fiabilitate.
- Viteza în cele mai populare cazuri.
O alegere bună cu un astfel de set de cerințe a fost și rămâne SQLite. Totuși, în cadrul explorării alternativelor, mi-a căzut în mână o carte . Sub conducerea sa, a fost elaborat un benchmark care compară viteza de operare cu diferite baze de date în scenarii reale de cloud. Rezultatul a depășit cele mai optimiste așteptări. În cazurile cele mai populare — obținerea unui cursor pe o listă sortată de fișiere și o listă sortată de toate fișierele pentru un director specificat — LMDB s-a dovedit a fi de 10 ori mai rapid decât SQLite. Alegerea a devenit evidentă.
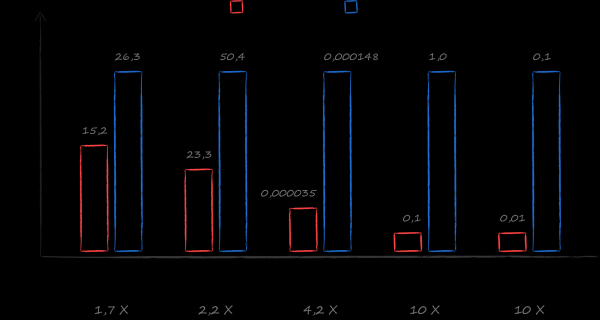
2. Poziționarea LMDB
LMDB este o bibliotecă foarte mică (doar 10K linii), implementând cel mai de bază strat fundamental al bazelor de date — stocarea.
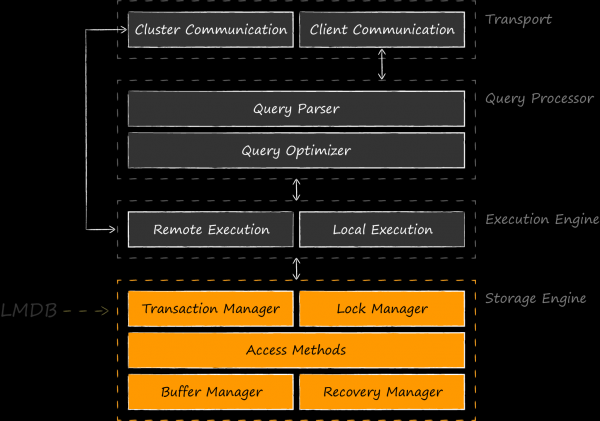
Schema prezentată arată că a compara LMDB cu SQLite, care implementează și straturi superioare, nu este corect mai mult decât compararea SQLite cu Core Data. Ca competitori pe aceeași cale, ar fi mai corect să aducem în discuție motoare de stocare similare — BerkeleyDB, LevelDB, Sophia, RocksDB și altele. Există chiar și dezvoltări în care LMDB servește drept componentă a motorului de stocare pentru SQLite. Primul experiment de acest gen a avut loc în 2012. de autorul LMDB . s-au dovedit atât de intrigante, încât inițiativa sa a fost preluată de entuziaștii OSS, găsindu-și continuarea sub numele de . În ianuarie 2020, autorul acestui proiect, Den Shearer, a prezentat la LinuxConfAu.
Principalul său utilizare a LMDB este ca motor pentru baze de date aplicații. Biblioteca își datorează apariția dezvoltatorilor , care nu erau mulțumiți de BerkeleyDB ca bază pentru proiectul lor. Bazându-se pe o bibliotecă modestă , Howard Chu a reușit să creeze una dintre cele mai populare alternative de astăzi. Această poveste, precum și structura internă a LMDB, au fost dedicate unui very impressive talk . Un exemplu bun de stocare inovatoare a fost prezentat de Leonid Yuriev (aka ) de la Positive Technologies, în talk-ul său de la Highload 2015 . În acesta, el discută despre LMDB în contextul unei sarcini similare de implementare a ReOpenLDAP, iar o critică comparativă a primit LevelDB. Ca urmare a implementării, Positive Technologies a creat chiar un fork în continuă dezvoltare cu caracteristici foarte interesante, optimizări și .
LMDB este adesea folosit și ca stocare as is. De exemplu, browserul Mozilla Firefox acesta pentru o serie de nevoi, iar începând cu versiunea 9, Xcode acesta în loc de SQLite pentru stocarea indicelui.
Motorul a devenit cunoscut și în lumea dezvoltării mobile. Urmele utilizării acestuia pot fi găsite în clientul iOS pentru Telegram. LinkedIn a mers și mai departe, alegând LMDB ca stocare implicită pentru framework-ul intern de кешare a datelor Rocket Data, despre care a scris în articolul său din 2016.
LMDB luptă cu succes pentru un loc sub soare în nișa lăsată de BerkeleyDB după trecerea sub controlul Oracle. Biblioteca este apreciată pentru viteză și fiabilitate chiar și în comparație cu similare. Așa cum se știe, nu există mese gratuite, iar trade-off-ul trebuie subliniat, cu care va trebui să te confrunți atunci când alegi între LMDB și SQLite. Schema de mai sus demonstrează clar cum se obține o viteză crescută. În primul rând, nu plătim pentru straturi suplimentare de abstractizare deasupra stocării pe disc. Este evident că, într-o arhitectură bună, aceste straturi sunt inevitabile, dar ele vor fi mult mai subțiri. Ele nu vor include funcționalități care nu sunt cerute de aplicația specifică, de exemplu, suportul pentru interogări SQL. În al doilea rând, se oferă posibilitatea de a implementa optim maparea operațiunilor aplicației pe interogări la stocarea pe disc. Dacă SQLite 3. Cele trei fundații ale LMDB
Privind LMDB din înaltul cerului, a sosit momentul să ne scufundăm mai adânc. Următoarele trei secțiuni vor fi dedicate analizei principalelor fundații pe care se bazează arhitectura stocării:
Fișierele mapate în memorie ca mecanism de lucru cu discul și sincronizare a structurilor interne de date.
- Arborele B+ ca organizare a structurii datelor stocate.
- Copy-on-write ca abordare pentru asigurarea proprietăților ACID ale tranzacțiilor și multi-versioning.
- 3.1. Fundația nr. 1. Fișiere mapate în memorie
3.1. Fundația nr. 1. Fișiere mapate în memorie
Fișierele implicite în memorie sunt atât de importante încât ele apar chiar și în numele stocării. Întrebările legate de cache și sincronizarea accesului la informațiile stocate sunt complet încredințate sistemului de operare. LMDB nu conține niciun fel de cache. Aceasta este o alegere deliberată a autorului, deoarece citirea datelor direct din fișierele implicite permite evitarea multor dintre problemele întâlnite la implementarea motorului. Mai jos este un exemplu de listă, departe de a fi completă, cu câteva dintre acestea.
- Menținerea consistenței datelor în stocare când este folosită de mai multe procese devine responsabilitatea sistemului de operare. În următoarea secțiune, această mecanică va fi discutată în detaliu, completată cu imagini.
- Lipsa cache-urilor scapă complet LMDB de cheltuielile legate de alocările dinamice. Citirea datelor reprezintă, în practică, stabilirea unui pointer pe adresa corectă din memoria virtuală și nu mai mult. Pare de necrezut, dar în sursele stocării, toate apelurile cualloc sunt concentrate în funcția de configurare a stocării.
- Lipsa cache-urilor înseamnă, de asemenea, lipsa blocărilor legate de sincronizarea accesului la acestea. Cititorii, care pot exista simultan în număr arbitrar, nu întâlnesc niciun mutex pe drumul lor către date. Datorită acestui fapt, viteza de citire are o scalabilitate liniară ideală în funcție de numărul de CPU-uri. În LMDB, sincronizarea se aplică doar operațiunilor de modificare. În orice moment, poate exista doar un singur scriitor.
- Minimul logic de caching și sincronizare scutește codul de o varietate de erori extrem de complexe legate de funcționarea într-un mediu multithreading. La conferința Usenix OSDI 2014 au fost prezentate două studii interesante despre baze de date: și Din acestea se pot obține informații atât despre fiabilitatea fără precedent a LMDB, cât și despre implementarea practic impecabilă a proprietăților ACID ale tranzacțiilor, care depășește pe cea din SQLite.
- Minimalismul LMDB permite reprezentării sale codificate să fie complet plasată în cache-ul L1 al procesorului, având astfel caracteristici de viteză rezultate.
Din păcate, în iOS, gestionarea fișierelor mapate în memorie nu este atât de simplă pe cât ne-am dori. Pentru a discuta despre dezavantajele asociate mai conștient, este necesar să ne amintim principiile generale de implementare a acestui mecanism în sistemele de operare.
Informații generale despre fișierele mapate în memorie
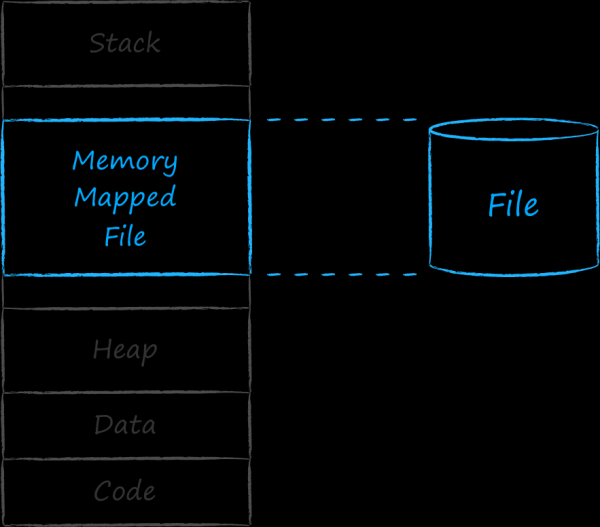 Fiecare aplicație executabilă este asociată de sistemul de operare cu o entitate numită proces. Fiecărui proces îi este alocat un interval continuu de adrese în care plasează tot ceea ce are nevoie pentru a funcționa. La cele mai mici adrese se află secțiuni cu cod și date și resurse hardcodate. Apoi urmează un bloc în creștere, bine cunoscut sub numele de heap. În acesta se află adresele entităților care apar în timpul executării programului. În partea de sus se află zona de memorie utilizată de stiva aplicației. Aceasta crește și se micșorează, în alte cuvinte, dimensiunea sa are de asemenea o natură dinamică. Pentru a evita coliziunile între stivă și heap, acestea sunt separate în colțuri diferite ale spațiului de adrese. Între cele două secțiuni dinamice, sus și jos, este un gol. Adresele din această zonă intermediară sunt utilizate de sistemul de operare pentru a asocia cele mai diverse entități cu procesul. În special, acesta poate asocia un set continuu de adrese cu un fișier de pe disc. Acest fișier se numește fișier mapat în memorie.
Spațiul de adrese alocat unui proces este imens. Teoretic, numărul de adrese este limitat doar de dimensiunea pointerului, determinată de arhitectura sistemului. Dacă ar fi asociată 1-la-1 cu memoria fizică, primul proces ar consuma toată memoria RAM, iar despre multitasking nu ar mai putea fi vorba.
Cu toate acestea, din experiența noastră știm că sistemele de operare moderne pot executa simultan un număr nedeterminat de procese. Acest lucru este posibil deoarece ele alocă procesele o mulțime de memorie doar pe hârtie, iar în realitate încarcă în memoria fizică principală doar partea care este necesară aici și acum. De aceea, memoria asociată unui proces se numește memorie virtuală.
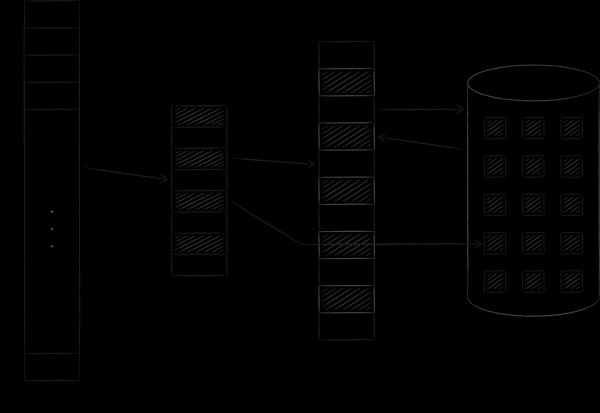
Sistemul de operare organizează memoria virtuală și fizică sub formă de pagini de dimensiuni fixe. Odată ce o pagină de memorie virtuală devine necesară, sistemul de operare o încarcă în memoria fizică și stabilește o corespondență între ele într-un tabel special. Dacă nu există sloturi libere, una dintre paginile deja încărcate este copiată pe disc, iar pagina solicitată ocupă locul ei. Această procedură, la care ne vom întoarce curând, se numește swapping. Imaginea de mai jos ilustrează acest proces. Pe ea, pagina A cu adresa 0 a fost încărcată și plasată pe pagina din memoria principală cu adresa 4. Această realitate este reflectată în tabelul de corespondențe în celula cu numărul 0.
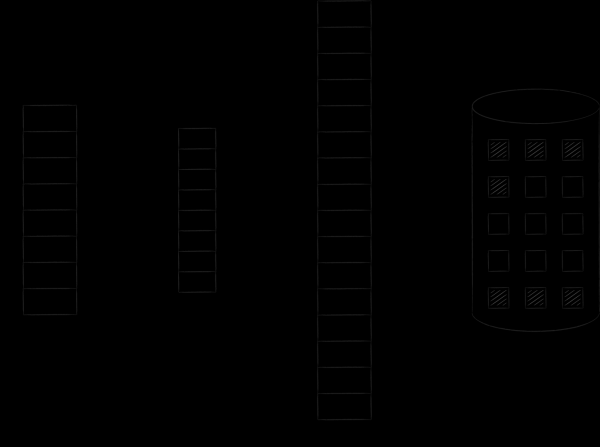
Istoria fișierelor afișate în memorie este exact aceeași. Din punct de vedere logic, acestea sunt despre a fi plasate continuu și complet în spațiul de adrese virtuale. Cu toate acestea, ele ajung în memoria fizică pe pagini și doar la cerere. Modificările acestor pagini sunt sincronizate cu fișierul de pe disc. Astfel, se pot efectua operații de intrare/ieșire pe fișiere, pur și simplu lucrând cu octeți în memorie, toate modificările fiind transferate automat de nucleul sistemului de operare către fișierul sursă.
Imaginea de mai jos demonstrează cum LMDB își sincronizează starea în timp ce lucrează cu o bază de date din diferite procese. Mappând memoria virtuală a diferitelor procese pe același fișier, de facto obligăm sistemul de operare să sincronizeze tranzitiv anumite blocuri ale spațiului lor de adrese, la care se referă LMDB.
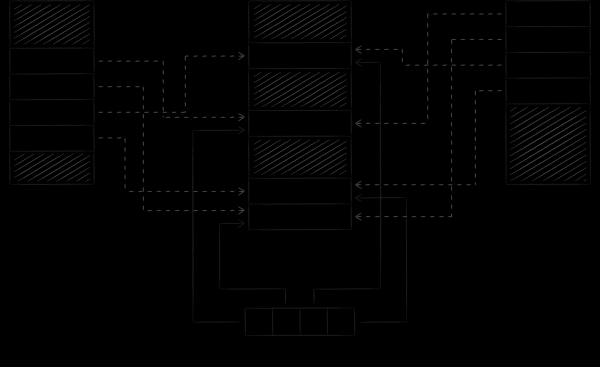
Un aspect important este că LMDB, în mod implicit, modifică fișierul cu datele prin mecanismul apelului de sistem write, iar fișierul este mapat în modul read-only. Acest tip de abordare are două consecințe importante.
Prima consecință - comună tuturor sistemelor de operare. Esența acesteia constă în adăugarea unei protecții împotriva deteriorării involuntare a bazei de date de către codul incorect. Așa cum este bine cunoscut, instrucțiunile executabile ale procesului pot accesa datele din orice loc al spațiului său de adrese. În același timp, așa cum am menționat deja, maparea unui fișier în modul citire-scriere înseamnă că orice instrucțiune poate să-l modifice, de asemenea. Dacă aceasta face acest lucru din greșeală, încercând, de exemplu, să suprascrie un element al unui array la un index inexistent, atunci astfel poate modifica accidental fișierul mapat la acea adresă, ceea ce va duce la deteriorarea bazei de date. Dacă fișierul este mapat în modul doar citire, atunci încercarea de a modifica spațiul său de adrese corespunzător va duce la încheierea necontrolată a programului cu un semnal SIGSEGV, iar fișierul va rămâne intact.
A doua consecință este specifică pentru iOS. Atât autorul, cât și orice alte surse nu o menționează explicit, dar fără aceasta, LMDB ar fi impracticabil pentru utilizare în acest sistem de operare mobil. Discuția asupra sa este dedicată următoarei secțiuni.
Specificitatea fișierelor mapate în memorie în iOS
În 2018, la WWDC, a avut loc o prezentare remarcabilă . Aceasta vorbește despre faptul că, în iOS, toate paginile situate în memoria fizică sunt clasificate în unul dintre cele 3 tipuri: dirty, compressed și clean.
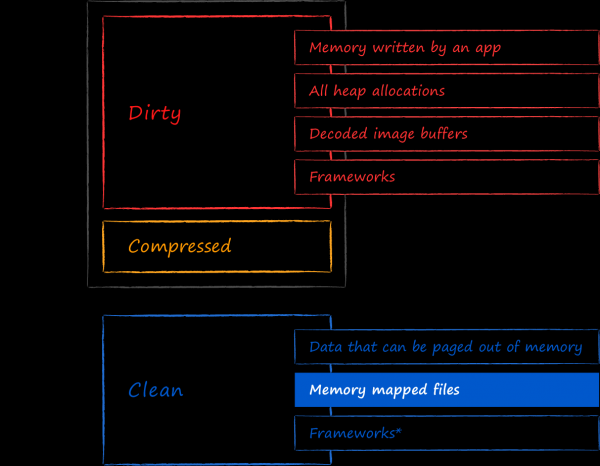
Memoria curată - este un ansamblu de pagini care pot fi eliberate din memoria fizică fără probleme. Datele aflate în acestea pot fi reîncărcate după cum este necesar din sursele lor inițiale. Fișierele mapate în memorie doar în citire intră exact în această categorie. iOS nu se teme să elibereze oricând paginile mapate la fișiere din memorie, deoarece acestea sunt garantat sincronizate cu fișierul de pe disc.
În memoria dirty sunt incluse toate paginile modificate, indiferent de locul în care s-au aflat inițial. În special, fișierele mapate în memorie modificate prin scrierea în memoria virtuală asociată cu acestea vor fi clasificate astfel. Deschizând LMDB cu flag-ul MDB_WRITEMAP, după efectuarea modificărilor, se poate verifica personal acest lucru.
Atunci când o aplicație începe să ocupe prea multă memorie fizică, iOS îi supune paginile dirty comprimării. Cantitatea de memorie ocupată de paginile dirty și cele comprimate constituie așa-numitul memory footprint al aplicației. Odată ce acesta atinge un anumit prag, demonul de sistem OOM killer intervine și o închide forțat. Aceasta este o caracteristică a iOS, spre deosebire de sistemele de operare desktop. Spre deosebire de acestea, reducerea memory footprint-ului prin swap-ul paginilor din memoria fizică pe disc nu este prevăzută în iOS. Despre motive, putem doar să speculăm. Poate că procesul intensiv de mutare a paginilor pe disc și înapoi este prea consumator de energie pentru dispozitivele mobile sau iOS economisește resursele de scriere a celulelor pe SSD-uri, sau poate că proiectanții nu erau mulțumiți de performanța generală a sistemului, în care totul este constant schimbat. Oricum ar fi, rămâne un fapt.
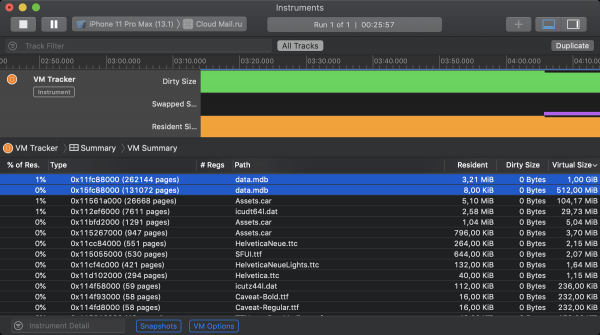
Vestea bună, deja menționată anterior, este că LMDB, în mod implicit, nu folosește mecanismul mmap pentru actualizarea fișierelor. Din aceasta rezultă că datele mapate sunt clasificate de iOS ca memorie curată și nu contribuie la memory footprint. Acest lucru se poate verifica cu ajutorul instrumentului Xcode numit VM Tracker. În captura de ecran de mai jos, este afișată starea memoriei virtuale a aplicației iOS Cloud în timpul funcționării. La început, au fost inițializate 2 instanțe LMDB. Primei i-a fost permis să-și mapeze fișierul pe 1GiB de memorie virtuală, iar celei de-a doua — 512MiB. Cu toate că ambele stocări ocupă un anumit volum de memorie rezidentă, niciuna dintre ele nu contribuie la dimensiunea dirty.
Și acum vine vestea proastă. Datorită mecanismului de swap în sistemele de operare desktop pe 64 de biți, fiecare proces poate ocupa atât de mult spațiu virtual de adresare cât permite spațiul liber de pe disc pentru potențialul său swap. Înlocuirea swap-ului cu comprimarea în iOS reduce radical maximul teoretic. Acum, toate procesele active trebuie să încapă în memoria principală (adică RAM), iar toate cele care nu se încadrează sunt supuse închiderii forțate. Despre acest lucru se menționează și în textul anterior. , cât și în Ca urmare, iOS limitează strict dimensiunea memoriei disponibile pentru alocarea prin mmap. Aici puteți să verificați limitele empirice ale volumelor de memorie care au fost alocate pe diferite dispozitive folosind acest apel de sistem. Pe cele mai moderne modele de smartphone-uri iOS, s-au alocat 2 gigabiți, iar pe versiunile de top ale iPad-ului — 4. În practică, desigur, trebuie să ne orientăm spre cele mai vechi modele suportate, unde situația este foarte tristă. Mai rău, după ce ne uităm la starea memoriei aplicației în VM Tracker, putem descoperi că LMDB nu este singura care pretinde la memoria mapată. Porțiuni bune sunt consumate de allocatorii de sistem, fișierele cu resurse, cadrele pentru manipularea imaginilor și alți prădători mai mici.
În urma experimentelor din Cloud, am ajuns la următoarele valori de compromis pentru memoria LMDB alocată: 384 megabiți pentru dispozitivele pe 32 de biți și 768 pentru cele pe 64 de biți. După consumarea acestui volum, orice operații de modificare încep să se încheie cu codul MDB_MAP_FULL. Astfel de erori le observăm în monitorizarea noastră, dar sunt suficient de puține pentru a putea fi ignorate în acest stadiu.
O cauză neobișnuită a consumului excesiv de memorie de către stocare poate fi tranzacțiile pe termen lung. Pentru a înțelege cum sunt legate aceste două fenomene, ne va ajuta analiza celor doi „cete” rămase ale LMDB.
3.2. Cetatea nr. 2. B+-arbore
Pentru a emula tabelele peste o stocare de tip key-value, trebuie ca API-ul acesteia să conțină următoarele operațiuni:
- Inserarea unui nou element.
- Căutarea unui element cu cheia dată.
- Ștergerea unui element.
- Iterarea pe intervale de chei în ordinea ordonării lor.
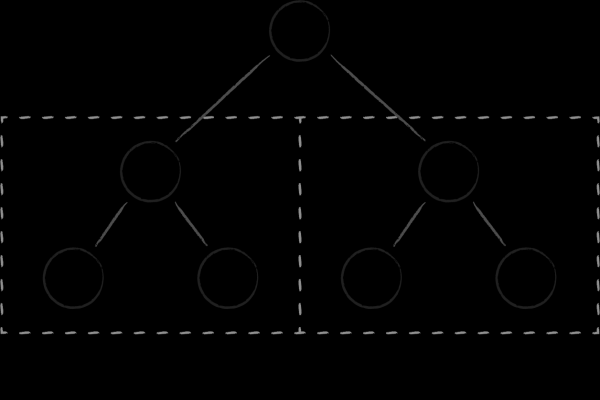 Cea mai simplă structură de date, cu ajutorul căreia pot fi realizate ușor toate cele patru operațiuni, este arborele binar de căutare. Fiecare nod reprezintă o cheie, împărțind tot submulțimea cheilor fiice în două subarbori. În stânga sunt cele care sunt mai mici decât părinte, iar în dreapta sunt cele care sunt mai mari. Obținerea unui set ordonat de chei se realizează prin una dintre parcurgerile clasice ale arborelui.
Arborile binare au două dezavantaje fundamentale care le împiedică să fie eficiente ca structuri de date pentru discuri. În primul rând, gradul lor de echilibrare este imprevizibil. Există un risc semnificativ de a obține arbori în care înălțimea diferitelor ramuri poate varia considerabil, ceea ce complică în mod semnificativ complexitatea algoritmică a căutării în comparație cu cea așteptată. În al doilea rând, abundenta corelațiilor între noduri privează arborii binari de localitate în memorie. Nodurile apropiate (din punct de vedere al conexiunilor dintre ele) pot fi situate pe pagini complet diferite în memoria virtuală. Ca urmare, chiar și pentru o simplă traversare a câtorva noduri vecine în arbore, poate fi necesară vizitarea unui număr comparabil de pagini. Aceasta este o problemă chiar și atunci când discutăm despre eficiența arborilor binari ca structuri de date în memorie, deoarece rotația constantă a paginilor în cache-ul procesorului nu este o plăcere ieftină. Când se discută despre accesarea frecventă a paginilor asociate nodurilor de pe disc, situația devine cu adevărat .
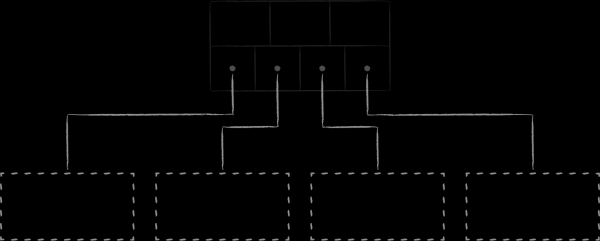 Arborii B, fiind o evoluție a arborilor binari, rezolvă problemele menționate în paragraful anterior. În primul rând, sunt auto-echilibranți. În al doilea rând, fiecare nod își împarte multitudinea de chei fiice nu în 2, ci în M submulțimi ordonate, iar numărul M poate fi destul de mare, fiind de ordinul sutelor sau chiar al miilor.
Prin urmare:
- În fiecare nod se află un număr mare de chei deja ordonate, iar arborii devin foarte scunzi.
- Arborele dobândește proprietatea de localitate a plasării în memorie, deoarece cheile apropiate ca valoare sunt în mod natural plasate una lângă alta pe același nod sau pe noduri învecinate.
- Se reduce numărul nodurilor tranzitorii în timpul coborârii pe arbore în timpul operației de căutare.
- Se reduce numărul nodurilor țintă citite în cazul cererilor de tip range, deoarece fiecare dintre ele conține deja un număr mare de chei ordonate.
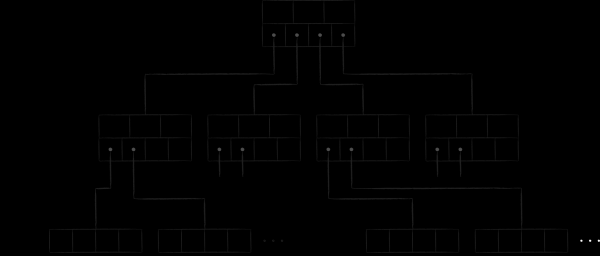
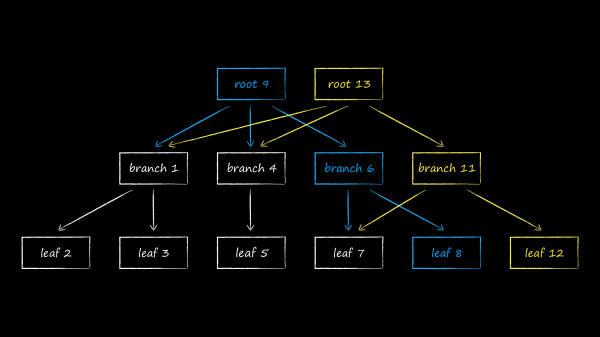
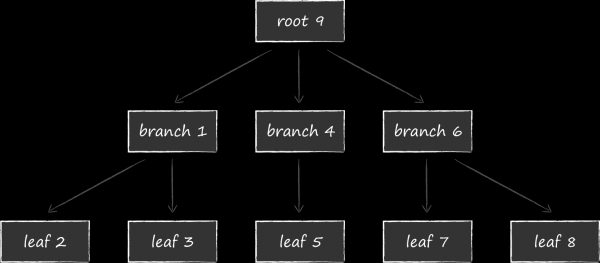
În LMDB, pentru stocarea datelor se utilizează o variantă a arborelui B cunoscută sub numele de arbore B+. În schema de mai sus sunt reprezentate trei tipuri de noduri care pot apărea în acesta:
- La rădăcina se află la vârf. Aceasta nu este nimic altceva decât o materializare a conceptului de bază de date în interiorul unui depozit. Într-un singur exemplu de LMDB, pot fi create mai multe baze de date care împărtășesc aceeași memorie virtuală mapată. Fiecare dintre ele începe cu propria sa rădăcină.
- La cel mai de jos nivel se află frunzele. Ele sunt singurele care conțin perechile cheie-valoare stocate în baza de date. Aceasta este particularitatea arborilor B+. Dacă un arbore B obișnuit stochează părțile de valoare în noduri de toate nivelurile, variația B+ face acest lucru doar la cel mai de jos nivel. Având în vedere acest fapt, vom numi subtipul arborelui utilizat în LMDB simplu arbore B.
- Între rădăcină și frunze se află 0 sau mai multe niveluri tehnice cu noduri de navigare. Sarcina lor este să împartă mulțimea ordonată de chei între frunze.
Fizic, nodurile sunt blocuri de memorie cu o dimensiune prestabilită. Dimensiunea acestora este un multiplu al dimensiunii paginilor de memorie din sistemul de operare, despre care am vorbit anterior. Mai jos este ilustrată structura unui nod. În antet se află informații meta, dintre care cea mai evidentă pentru exemplu este suma de control. Apoi urmează informațiile despre ofseturile la care sunt plasate celulele cu date. Ca date, pot fi fie cheile, dacă vorbim despre noduri de navigare, fie perechile cheie-valoare complete în cazul frunzelor. Puteți citi mai multe despre structura paginilor în lucrarea „Evaluation of High Performance Key-Value Stores.” .
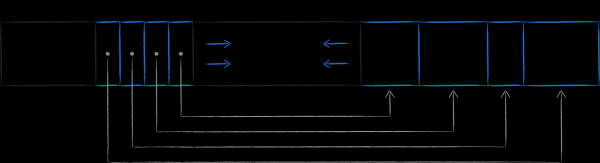
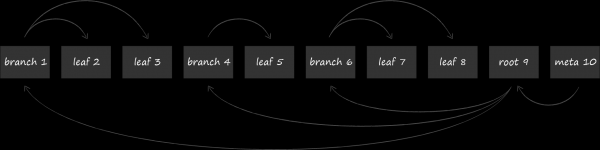
După ce am înțeles conținutul intern al nodurilor-paginii, vom prezenta simplificat arborele B din LMDB în următoarea formă.
Pagini cu noduri sunt plasate secvențial pe disc. Pagini cu numere mai mari sunt plasate mai aproape de sfârșitul fișierului. Așa-numita pagină meta conține informații despre ofseturile la care pot fi găsite rădăcinile tuturor arborilor. Atunci când se deschide un fișier LMDB, acesta scanează paginile fișierului de la sfârșit la început în căutarea unei pagini meta valide și prin aceasta găsește bazele de date existente.
Acum, având o idee despre structura logică și fizică a organizației datelor, putem trece la analiza celui de-al treilea pilon al LMDB. Cu ajutorul acestuia, toate modificările stocării sunt realizate tranzacțional și izolat unele de altele, conferind întregii baze de date și proprietatea de multi-versionare.
3.3. Pilonul nr. 3. Copy-on-write
Unele operațiuni cu arbori B presupun efectuarea unei serii întregi de modificări în nodurile acestuia. Un exemplu este adăugarea unei noi chei într-un nod care a atins deja capacitatea maximă. În acest caz, este necesar, pe de o parte, să împărțim nodul în două, iar pe de altă parte, să adăugăm un link către noul nod copil desprins în părintele său. Această procedură este potențial foarte periculoasă. Dacă din anumite motive (crash, oprirea curentului etc.) doar o parte din modificările din serie au loc, atunci arborele va rămâne într-o stare inconsistentă.
Una dintre soluțiile tradiționale pentru asigurarea rezilienței bazei de date la eșecuri este adăugarea, alături de arborele B, a unei structuri de date suplimentare pe disc — jurnalul de tranzacții, cunoscut și sub numele de write-ahead log (WAL). Acesta este un fișier în care, înainte de a modifica arborele B, se scriu operațiile propuse. Astfel, dacă în timpul auto-diagnosticării se descoperă o corupție a datelor, baza de date consultă jurnalul pentru a se restabili.
LMDB, ca mecanism de asigurare a rezilienței la eșecuri, a ales o altă metodă, denumită copy-on-write. Esența acesteia este că, în loc să actualizeze datele pe pagina existentă, se face mai întâi o copie totală a acesteia și toate modificările sunt efectuate pe copie.
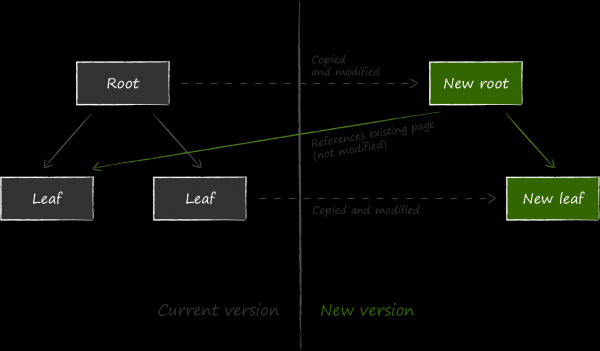
Apoi, pentru ca datele actualizate să fie disponibile, este necesar să se schimbe linkul la nodul actualizat în nodul părinte. Deoarece pentru aceasta trebuie să fie modificat și el, acesta este de asemenea copiat anterior. Procesul continuă recursiv până la rădăcină. Ultimele date modificate sunt pe pagina meta.
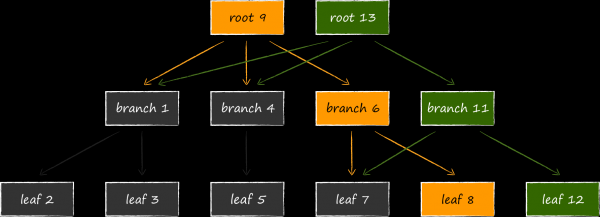
Dacă, dintr-o dată, în timpul procedurii de actualizare, va avea loc o întrerupere neașteptată a procesului, fie nu se va crea o nouă meta-pagină, fie nu va fi scrisă pe disc până la final, iar suma sa de control va fi incorectă. În oricare dintre aceste două cazuri, paginile noi vor fi inaccesibile, iar cele vechi nu vor fi afectate. Aceasta scapă LMDB de necesitatea de a menține un jurnal scris anterior pentru a păstra coerența datelor. Structura de stocare a datelor pe disc, descrisă mai sus, îndeplinește simultan și această funcție. Lipsa unui jurnal de tranzacții în mod explicit este una dintre caracteristicile LMDB care asigură o viteză mare de citire a datelor.
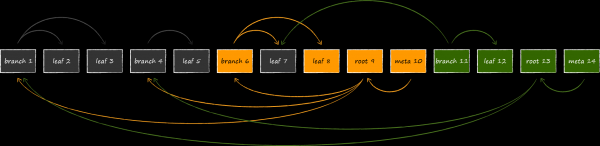
Construcția rezultată, numită arbore B doar pentru adăugare, asigură în mod natural izolarea tranzacțiilor și multiversionarea. În LMDB, fiecare tranzacție deschisă este asociată cu rădăcina actuală a arborelui. Atâta timp cât tranzacția nu este finalizată, paginile arborelui asociate nu vor fi niciodată modificate sau reutilizate pentru noi versiuni de date. Astfel, poți lucra cât vrei cu setul de date care era relevant la momentul deschiderii tranzacției, chiar dacă depozitul continuă să fie actualizat activ în acel moment. Asta este esența multiversionării, care face LMDB o sursă ideală de date pentru toți cei care le iubim. UICollectionView. Du-te la o tranzacție, nu trebuie să crești amprenta de memorie a aplicației, grabindu-te să extragi datele actualizate într-o structură în memorie, temându-te că vei rămâne fără opțiuni. Această caracteristică diferențiază LMDB de SQLite, care nu poate oferi o astfel de izolare totală. Dacă deschizi în acesta două tranzacții și ștergi o anumită înregistrare în cadrul uneia dintre ele, nu vei putea obține aceeași înregistrare în cadrul celeilalte rămase.
O latură a medaliei este consumul potențial semnificativ mai mare de memorie virtuală. Diagrama arată cum va arăta structura bazei de date atunci când aceasta este modificată simultan de trei tranzacții deschise pe citire, fiecare privind versiuni diferite ale bazei de date. Deoarece LMDB nu poate reutiliza nodurile accesibile din rădăcinile legate de tranzacțiile active, depozitului nu îi rămâne altceva de făcut decât să aloce în memorie o a patra rădăcină și din nou să cloneze paginile modificate sub aceasta.
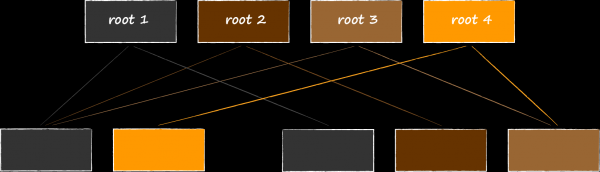
Aici nu este lipsit de importanță să ne amintim de secțiunea despre fișierele care utilizează maparea în memorie. Se pare că consumul suplimentar de memorie virtuală nu ar trebui să ne îngrijoreze foarte mult, deoarece nu contribuie la amprenta de memorie a aplicației. Cu toate acestea, a fost observat că iOS este foarte zgârcit în alocarea acesteia, iar noi nu putem, ca pe un server sau un desktop, să oferim LMDB o regiune de 1 terabyte și să nu ținem cont de această caracteristică în niciun fel. Atâta vreme cât este posibil, trebuie să ne străduim să facem durata de viață a tranzacțiilor cât mai scurtă.
4. Proiectarea schemelor de date pe API-ul key-value
Vom începe analiza API-ului cu examinarea abstrumentelor de bază furnizate de LMDB: mediu și baze de date, chei și valori, tranzacții și cursori.
Observație despre listele de cod
Toate funcțiile din API-ul public LMDB returnează rezultatul execuției sub formă de cod de eroare, dar în următoarele liste verificarea acestuia este omisă pentru concizie. În practică, am folosit chiar wrapper-ul nostru pentru a interacționa cu depozitul Wrapper C++ , în care erorile se materializează sub formă de excepții C++.
Ca cea mai rapidă modalitate de a conecta LMDB la un proiect pentru iOS sau macOS, vă propun CocoaPod-ul meu .
4.1. Abstracții de bază
Mediu (environment)
Structura MDB_env reprezintă starea internă a LMDB. Familia de funcții cu prefixul mdb_env permite configurarea unor anumite proprietăți. În cele mai simple cazuri, inițializarea motorului arată astfel.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);În aplicația Mail.ru Cloud, am schimbat valorile implicite doar pentru două parametrii.
Primul dintre ele este dimensiunea spațiului virtual de adrese, pe care se află fișierul de stocare. Din păcate, chiar și pe același dispozitiv, o valoare specifică poate varia semnificativ de la o rulare la alta. Pentru a ține cont de această particularitate a iOS, volumul maxim de stocare este setat dinamic. Începând de la o anumită valoare, acesta este împărțit treptat la jumătate până când funcția mdb_env_open returnează un rezultat diferit de ENOMEM. Teoretic, există și calea opusă - mai întâi alocăm motorului un minim de memorie, iar apoi, în cazul de erori MDB_MAP_FULL, să o creștem. Cu toate acestea, este mult mai complicat. Motivul constă în faptul că procedura de realocare a memoriei (remap) folosind funcția mdb_env_set_map_size normalizează toate entitățile (cursori, tranzacții, chei și valori) obținute anterior de la motor. Luarea în considerare a unei astfel de întorsături în cod va complica semnificativ lucrurile. Dacă, totuși, memoria virtuală este foarte valoroasă pentru tine, atunci ar putea fi un motiv să arunci o privire asupra unui fork care a avansat semnificativ , unde printre caracteristicile declarate se numără „ajustarea automată a dimensiunii bazei de date în timp real”.
Al doilea parametru, al cărui valoare implicită nu ne-a fost potrivită, reglează mecanica asigurării siguranței firelor. Din păcate, în iOS 10 există probleme cu suportul stocării locale a firelor. Din acest motiv, în exemplul de mai sus, stocarea este deschisă cu un flag MDB_NOTLS. În plus, a fost nevoie și de wrapper-ul C++ , pentru a elimina variabilele cu acest atribut din el.
Baze de date
Baza de date este o instanță separată a arborelui B despre care am discutat mai devreme. Deschiderea sa are loc în cadrul unei tranzacții, lucru care la început poate părea puțin ciudat.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);Într-adevăr, o tranzacție în LMDB este o entitate de stocare, nu o bază de date specifică. Această concepție permite efectuarea de operații atomice asupra entităților aflate în baze de date diferite. În teorie, aceasta deschide posibilități de modelare a tabelelor sub formă de baze diferite, dar pe vremea mea am ales o altă cale, detaliată mai jos.
Chei și valori
Structura MDB_val modelizează conceptul atât al cheii, cât și al valorii. Stocarea nu are nici cea mai mică idee despre semantica acestora. Pentru ea, un lucru este ca celălalt - este pur și simplu un array de bytes de dimensiune specificată. Dimensiunea maximă a cheii este de 512 bytes.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Cu ajutorul comparatorului, stocarea ordonează cheile în ordine crescătoare. Dacă nu îl înlocuiești cu unul propriu, va fi utilizat cel implicit, care le sortează byte cu byte în ordine lexicografică.
Tranzacții
Dispozitivul de tranzacții este descris în detaliu în , de aceea aici o voi repeta pe scurt:
- Suportul pentru toate proprietățile de bază : atomicitate, consistență, izolare și durabilitate. Nu pot să nu menționez că, în ceea ce privește durabilitatea, pe macOS și iOS există un bug care a fost corectat în MDBX. Poți citi mai multe în .
- Abordarea față de multithreading este descrisă prin schema 'writer unic / cititori multipli'. Scriitorii se blochează între ei, dar nu blochează cititorii. Cititorii nu blochează nici scriitorii, nici între ei.
- Suport pentru tranzacții imbricate.
- Suport pentru multiversionare.
Multiversionarea în LMDB este atât de bună încât vreau să o demonstrez în acțiune. Din codul de mai jos se vede că fiecare tranzacție lucrează exact cu versiunea bazei de date care era actuală în momentul deschiderii acesteia, fiind complet izolată de toate modificările ulterioare. Inițializarea stocării și adăugarea unei înregistrări de test nu reprezintă nimic interesant, așa că aceste ritualuri sunt lăsate sub spoiler.
Adăugarea unei înregistrări de test
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ". /testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Deschidem 2 tranzacții, fiecare dintre ele verificând
// versiunea bazei de date cu un singur înregistrare.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// În cadrul primei tranzacții, ștergem în baza de date înregistrarea existentă.
mdb_del(txn1, dbi, &key, NULL);
// Confirmăm ștergerea.
mdb_txn_commit(txn1);
// Deschidem a treia tranzacție, care verifică
// versiunea actuală a bazei de date, unde înregistrarea nu mai există.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Ne asigurăm că înregistrarea după cheia căutată nu mai există.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Finalizăm tranzacția.
mdb_txn_abort(txn3);
// Ne asigurăm că în cadrul celei de-a doua tranzacții, deschise în momentul
// existenței înregistrării în baza de date, aceasta poate fi găsită încă după cheie.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Verificăm că după cheie am obținut nu orice mizerie, ci date valide.
assert(*(int *)val.mv_data == 997);
// Finalizăm tranzacția, funcționând deși cu o bază de date învechită, dar consistentă.
mdb_txn_abort(txn2);Recomand optional să încerci să faci același truc cu SQLite și să vezi ce iese.
Multiversionalitatea aduce beneficii foarte plăcute în viața dezvoltatorului iOS. Cu ajutorul acestei proprietăți, se poate regla cu ușurință și fără efort viteza de actualizare a sursei de date pentru formularele de pe ecran, având în vedere experiența utilizatorului. De exemplu, să luăm o caracteristică a aplicației OblaMail.ru, și anume încărcarea automată a conținutului din galeria media de sistem. Cu o conexiune bună, clientul poate adăuga pe server mai multe fotografii pe secundă. Dacă după fiecare încărcare actualizăm UICollectionView cu conținutul media din cloud-ul utilizatorului, putem uita de 60 fps și de derularea lină în timpul acestui proces. Pentru a preveni actualizările frecvente ale ecranului, trebuie să limităm cumva viteza de schimbare a datelor de bază. UICollectionViewDataSource.
Dacă baza de date nu suportă multiperspective și permite lucrul doar cu starea curentă, pentru a crea un snapshot stabil în timp al datelor, este necesar să-l copiem fie într-o structură de date in-memory, fie într-un tabel temporar. Oricare dintre aceste abordări are un cost ridicat. În cazul stocării in-memory, avem cheltuieli atât pe memorie, cauzate de păstrarea obiectelor construite, cât și pe timp, legate de transformările ORM excesive. Cât despre tabelul temporar, acesta este chiar mai costisitor, având sens doar în cazuri non-triviale.
Multiperspectiva LMDB rezolvă problema menținerii unei surse de date stabile într-un mod foarte elegant. Este suficient să deschidem o tranzacție și voilà—până nu o finalizăm, setul de date este garantat a fi fixat. Logica vitezei de actualizare este acum complet în mâinile stratului de prezentare, fără cheltuieli semnificative pentru resurse.
Cursori
Cursori oferă un mecanism pentru iterarea ordonată prin perechile cheie-valoare prin parcurgerea unui B-tree. Fără ele, ar fi imposibil să modelăm eficient tabelele din baza de date pe care le vom analiza.
4.2. Modelarea tabelelor
Proprietatea ordonării cheilor permite construirea unei structuri înalt nivelate, cum ar fi o tabelă, deasupra abtracțiilor de bază. Vom analiza acest proces folosind exemplul tabelului principal al clientului cloud, în care este stocată informația despre toate fișierele și folderele utilizatorului.
Schema tabelului
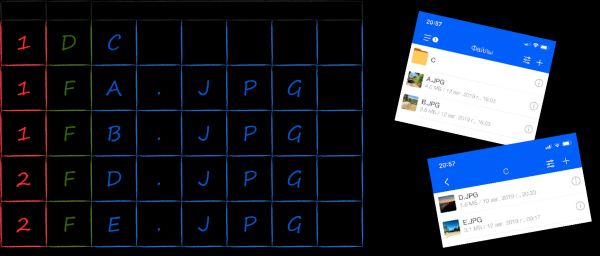
Unul dintre scenariile frecvente pentru care trebuie să fie concepută structura tabelului cu un arbore de foldere este selectarea tuturor elementelor aflate în interiorul unui director dat. O bună modelare a organizării datelor pentru interogări eficiente de acest tip este . Pentru a fi implementată deasupra unui stocare cheie-valoare, este necesar să ordonăm cheile fișierelor și folderelor astfel încât să fie grupate în funcție de apartenența la directorul părinte. În plus, pentru a afișa conținutul directorului în formatul familiar utilizatorului Windows (mai întâi folderele, apoi fișierele, ambele sortate alfabetic), este necesar să includem în cheie câteva câmpuri suplimentare corespunzătoare.
Imaginea de mai jos arată cum, în funcție de sarcina dată, poate arăta reprezentarea cheilor sub formă de tablou de bytes. La început sunt plasate byte-urile cu identificatorul directorului părinte (roșu), apoi - cu tipul (verde) și, la final - cu numele (albastru). Fiind sortate cu comparatorul implicit LMDB în ordine lexicografică, acestea se ordonează după cum este necesar. Parcurgerea secvențială a cheilor cu același prefix roșu ne oferă valorile asociate în ordinea în care acestea trebuie să fie afișate în interfața utilizatorului (în dreapta), fără a necesita o postprocesare suplimentară.
Serializarea cheilor și valorilor
În lume au fost inventate numeroase metode de serializare a obiectelor. Deoarece nu am avut alte cerințe în afară de viteză, am ales cea mai rapidă metodă posibilă - dump-ul memoriei utilizate de instanța structurii limbajului C. Astfel, cheia unui element de director poate fi modelată cu următoarea structură: NodeKey.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
Pentru a salva NodeKey în stocare, trebuie să poziționezi pointerul pe date la adresa de început a structurii, iar dimensiunea acestora se calculează cu ajutorul funcției MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
În primul capitol despre criteriile de alegere a unei baze de date, ca un factor important, am menționat minimizarea alocărilor dinamice în cadrul operațiunilor CRUD. Codul funcțieiserialize arată cum, în cazul LMDB, acestea pot fi complet evitate la inserarea de noi înregistrări în baza de date. Array-ul de bytes venit de la server este mai întâi transformat în structuri pe stivă și apoi sunt dump-uite în mod trivial în stocare. Având în vedere că în interiorul LMDB nu există alocări dinamice, se poate obține o situație fantastică din perspectiva iOS - utilizarea doar a memoriei pe stivă pentru a lucra cu datele pe tot parcursul lor de la rețea până pe disc! Ordinea cheilor cu un comparator binar
Ordinea cheilor cu un comparator binar
Ordinea cheilor este determinată de o funcție specială numită comparator. Deoarece motorul nu știe nimic despre semantica octeților conținuți, comparatorul implicit nu are altceva de făcut decât să ordoneze cheile în ordine lexicografică, recurgând la compararea acestora pe bază de octeți. A folosi acest lucru pentru a ordona structuri este similar cu a te rade cu un topor. Totuși, în cazuri simple, consider că această metodă este acceptabilă. Alternativa este descrisă puțin mai jos, iar aici voi menționa câteva capcane întâlnite pe acest drum.
Primul lucru de reținut este reprezentarea în memorie a tipurilor de date primitive. Astfel, pe toate dispozitivele Apple, variabilele întregi sunt stocate în formatul . Aceasta înseamnă că octetul cel mai puțin semnificativ va fi pe stânga, iar ordonarea numerelor întregi utilizând compararea pe bază de octeți nu va funcționa. De exemplu, încercarea de a face acest lucru cu un set de numere de la 0 la 511 va duce la următorul rezultat.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Pentru a rezolva această problemă, numerele întregi trebuie stocate în cheie într-un format adecvat pentru comparatorul pe bază de octeți. Funcțiile din familia hton* vor ajuta la realizarea transformării necesare (în special htons pentru numerele pe două octeți din exemplu).
Formatul de reprezentare a stringurilor în programare este, așa cum se știe, un întreg. Dacă semantica stringurilor, precum și codificarea utilizată pentru reprezentarea acestora în memorie, presupun că un simbol poate ocupa mai mult de un octet, atunci este mai bine să renunțăm imediat la ideea de a folosi comparatorul implicit.
Al doilea lucru de reținut este ale structurilor de câmpuri de către compilator. Din cauza acestora, între câmpuri în memorie pot apărea octeți cu valori de resturi, ceea ce, desigur, rupe ordonarea pe bază de octeți. Pentru a elimina resturile, trebuie fie să declarăm câmpurile într-o ordine strict definită, ținând cont de regulile de aliniere, fie să folosim atributul packed.
Ordonarea cheilor de către un comparator extern
Logica comparării cheilor poate deveni prea complexă pentru un comparator binar. Una dintre numeroasele motive este existența câmpurilor tehnice în structuri. Voi ilustra apariția acestora utilizând exemplul cheii deja cunoscute pentru un element de director.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
În ciuda simplității sale, în majoritatea cazurilor consumă prea multă memorie. Bufferul pentru nume ocupă 256 de octeți, deși, în medie, numele fișierelor și folderelor rar depășesc 20-30 de caractere.
O metodă standard de optimizare a dimensiunii înregistrării constă în tăierea acesteia la dimensiunea reală. Esența acestuia este că conținutul tuturor câmpurilor de lungime variabilă este stocat în buffer la sfârșitul structurii, iar lungimile lor în variabile separate. Conform acestei abordări, cheia NodeKey se transformă astfel.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Apoi, la serializare, dimensiunea datelor specificată nu este MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } întregii structuri, ci dimensiunea tuturor câmpurilor de lungime fixă plus dimensiunea părții real utilizate a bufferului.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Ca rezultat al refactorizării efectuate, am obținut o economisire semnificativă a spațiului ocupat de chei. Totuși, din cauza câmpului tehnic nameLength, comparatorul binar implicit nu mai este potrivit pentru compararea cheilor. Dacă nu îl înlocuim cu unul propriu, lungimea numelui va fi un factor mai prioritar în sortare decât numele însuși.
LMDB permite stabilirea unei funcții de comparare a cheilor pentru fiecare bază de date. Acest lucru se face prin intermediul funcției mdb_set_compare strict înainte de deschiderea acesteia. Din motive evidente, pe parcursul întregii sale vieți, baza de date nu poate fi modificată. Comparatorul primește două chei în format binar ca intrare, iar ca ieșire returnează rezultatul comparării: mai mic (-1), mai mare (1) sau egale (0). Pseudocodul pentru NodeKey arată astfel.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey * const aKey = (NodeKey * const)a->mv_data;
    NodeKey * const bKey = (NodeKey * const)b->mv_data;
    return // ...
}
Atâta timp cât toate cheile din baza de date au același tip, conversia necondiționată a reprezentării lor în octeți la tipul structurii de cheie aplicații este legală. Există un detaliu aici, dar acesta va fi discutat mai jos în secțiunea «Citire înregistrări».
Serializarea valorilor
Cu cheile înregistrărilor stocate, LMDB funcționează extrem de intens. Compararea acestora se realizează în cadrul oricărei operațiuni aplicaționale, iar viteza comparatoarelor influențează performanța întregului sistem. Într-o lume ideală, comparatoarele binare implicite ar trebui să fie suficiente pentru a compara cheile, dar dacă trebuie să folosiți unul propriu, atunci procedura de deserializare a cheilor ar trebui să fie cât mai rapidă posibil.
Partea Value a înregistrării (valoarea) nu este deosebit de interesantă pentru baza de date. Transformarea acesteia dintr-o reprezentare pe byte într-un obiect are loc doar atunci când este necesară pentru codul aplicației, de exemplu, pentru afisarea pe ecran. Deoarece aceasta se întâmplă relativ rar, cerințele de viteză pentru această procedură nu sunt atât de critice și, în implementarea sa, suntem mult mai liberi să ne orientăm spre confort. De exemplu, pentru serializarea metadatelor despre fișierele încă neîncărcate, folosim NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Cu toate acestea, există cazuri în care performanța contează. De exemplu, pentru a salva metainformațiile despre structura de fișiere a norului utilizatorului, folosim tot acel dump de memorie a obiectelor. Caracteristica principală a sarcinii de a forma reprezentarea serializată a acestora este că elementele directorului sunt modelate printr-o ierarhie de clase.
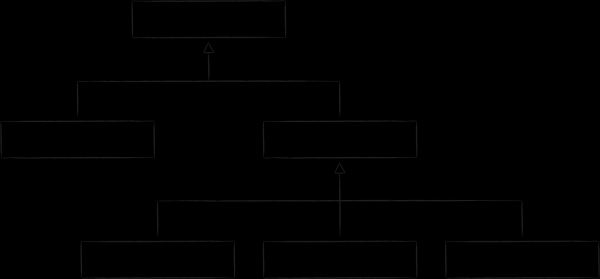
Pentru implementarea acesteia în limbajul C, câmpurile specifice ale subclasei sunt extrase în structuri separate, iar legătura lor cu baza este stabilită printr-un câmp de tip union. Conținutul actual al uniunii este definit printr-un atribut tehnic de tip.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Adăugarea și actualizarea înregistrărilor
Cheia și valoarea serializate pot fi adăugate în stocare. Pentru aceasta, se folosește funcția mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);În etapa de configurare, stocării i se poate permite sau interzice să păstreze mai multe înregistrări cu aceeași cheie. Dacă duplicarea cheilor este interzisă, atunci la inserarea unei înregistrări se poate decide dacă este permisă actualizarea unei înregistrări existente sau nu. Dacă suprascrierea poate apărea doar dintr-o eroare în cod, atunci se poate preveni acest lucru prin specificarea unui flag NOOVERWRITE.
Citirea înregistrărilor
Pentru citirea înregistrărilor în LMDB este destinată funcția mdb_get. Dacă perechea cheie-valoare a fost prezentată anterior cu structuri dumpate, atunci această procedură arată astfel.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Lista de coduri prezentată arată cum serializarea prin dumparea structurilor permite evitarea alocărilor dinamice nu doar la scriere, ci și la citirea datelor. Obținut din funcția mdb_get pointerul privește exact la acea adresă din memoria virtuală, unde baza de date stochează reprezentarea în byte a obiectului. De fapt, obținem un fel de ORM, care asigură practic gratuit o viteză foarte mare de citire a datelor. În ciuda frumuseții abordării, trebuie să ne amintim de câteva particularități asociate acesteia.
- Pentru tranzacțiile readonly, pointerul către structura-valoare va rămâne garantat valid doar până când tranzacția nu va fi închisă. Așa cum s-a menționat anterior, paginile arborelui B, pe care se află obiectul, rămân neschimbate datorită principiului copy-on-write atâta timp cât cel puțin o tranzacție le referă. Cu toate acestea, odată ce ultima tranzacție asociată se încheie, paginile pot fi reutilizate pentru noi date. Dacă este necesar ca obiectele să supraviețuiască tranzacției din care s-au născut, atunci trebuie, totuși, să fie copiate.
- Pentru tranzacția readwrite, pointerul către structura-valoare obținută va fi valid doar până la prima procedură de modificare (scriere sau ștergere de date).
- Deși structura
NodeValuenu este completă, ci tăiată (vezi subsecțiunea „Ordinea cheilor de către comparatorul extern”), prin pointer se pot accesa liniștit câmpurile sale. Principalul lucru este să nu îl dereferentiem! - În niciun caz nu trebuie să modificați structura printr-un pointer obținut. Toate modificările trebuie realizate doar printr-o metodă.
mdb_putCu toate acestea, chiar dacă doriți să faceți acest lucru, nu veți reuși, deoarece zona de memorie în care se află această structură este mapată în modul readonly. - Remaparea fișierului în spațiul de adresare al procesului, cu scopul, de exemplu, de a crește dimensiunea maximă a stocării folosind funcția
mdb_env_set_map_sizeinvalidă complet toate tranzacțiile și entitățile asociate și pointerii către obiectele citite în special.
În cele din urmă, o altă caracteristică este atât de vicleană încât dezvăluirea sa nu se încadrează pur și simplu în încă un punct. În capitolul despre arborele B am prezentat o schemă a organizării paginilor sale în memorie. Din aceasta rezultă că adresa de început a buffer-ului cu datele serializate poate fi absolut arbitrară. Din cauza aceasta, pointerul către ele, obținut în structură MDB_val și convertit într-un pointer către structură, devine în general nealiniat. Totuși, arhitecturile unor cipuri (în cazul iOS, armv7) necesită ca adresa oricăror date să fie un multiplu al dimensiunii cuvântului mașinii sau, altfel spus, al bitului sistemului (pentru armv7, aceasta este de 32 de biți). Cu alte cuvinte, o operație de genul *(int *foo)0x800002 pe ele este considerată ca o evadare și duce la o execuție cu verdictul EXC_ARM_DA_ALIGN. Puteți evita o soartă atât de tristă în două moduri.
Primul constă în copierea prealabilă a datelor într-o structură bine aliniată. De exemplu, pe un comparator personalizat, acest lucru se va reflecta astfel.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
O alternativă este să informați din timp compilatorul că structurile cu cheia și valoarea pot fi nealiniate, folosind atributul aligned(1). Pe ARM, același efect poate fi obținut și cu ajutorul atributului packed. Având în vedere că acesta contribuie de asemenea la optimizarea spațiului ocupat de structură, această metodă mi se pare preferabilă, deși duce la o creștere a costului operațiunilor de acces la date.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Interogări de tip Range
Pentru iterarea peste un grup de înregistrări în LMDB este prevăzută o abstracție de cursor. Cum se lucrează cu acesta, vom explora prin exemplul deja familiar al tabelului cu metadatele cloud-ului utilizatorului.
În cadrul afișării listei de fișiere din director este necesar să găsim toate cheile cu care sunt asociate fișierele și folderele sale subordonate. În secțiunile anterioare, am sortat cheile NodeKey în așa fel încât să fie ordonate mai întâi după identificatorul directorului părinte. Astfel, tehnic, sarcina de a obține conținutul unui folder se reduce la stabilirea cursorului pe limita superioară a grupului de chei cu prefixul dat, urmată de iterarea până la limita inferioară.
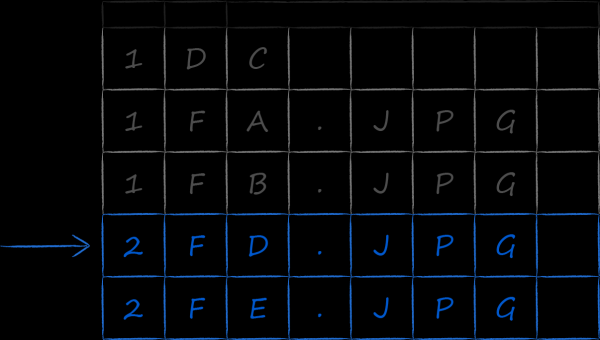
Limita superioară poate fi găsită "frontal" printr-o căutare secvențială. Pentru aceasta, cursorul este setat la începutul întregii liste de chei din baza de date și se incrementează până când sub el se află cheia cu identificatorul directorului părinte. Această abordare are 2 dezavantaje evidente:
- Complexitatea liniară a căutării, deși, după cum se știe, în arbori, în general, și în arborii B, în special, aceasta poate fi efectuată în timp logaritmic.
- În mod inutil, toate paginile anterioare căutării sunt ridicate din fișier în memoria principală, ceea ce este extrem de costisitor.
Din fericire, API-ul LMDB a prevăzut o metodă eficientă de poziționare inițială a cursorului. Pentru aceasta, trebuie să formăm o cheie astfel încât valoarea acesteia să fie întotdeauna mai mică sau egală cu cheia aflată pe limita superioară a intervalului. De exemplu, aplicabil listei din imaginea de mai sus, putem crea o cheie în care câmpul parentId să fie 2, iar toate celelalte să fie umplute cu zerouri. Această cheie parțial umplută este introdusă în funcția mdb_cursor_get specificând operația MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Dacă limita superioară a grupului de chei a fost găsită, atunci continuăm să iterăm peste aceasta până când fie întâlnim o cheie diferită, fie cheile se termină complet. parentIddo { rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT); // procesare... } while (MDB_NOTFOUND != rc && // verificăm sfârșitul tabelului IsTargetKey(key)); // verificăm sfârșitul grupului de chei
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
\/\/ procesare...
} while (MDB_NOTFOUND != rc && \/\/ verificare sfârșitul tabelului
IsTargetKey(key)); \/\/ verificare sfârșitul grupului de cheiEste plăcut, în cadrul iterației folosind mdb_cursor_get, obținem nu doar cheia, ci și valoarea. Dacă trebuie să verificăm condițiile de selecție, inclusiv câmpurile din partea value a înregistrării, acestea sunt complet accesibile fără mișcări suplimentare.
4.3. Modelarea relațiilor între tabele
Până în prezent, am reușit să discutăm toate aspectele proiectării și operării cu o bază de date unică. Se poate afirma că o masă este un set de înregistrări sortate, constând din perechi de tip cheie-valoare. Dacă reprezentăm cheia sub formă de dreptunghi, iar valoarea asociată cu aceasta sub formă de paralelipiped, obținem un diagramă vizuală a bazei de date.

Cu toate acestea, în viața reală, este rar să reușești să te descurci cu atât de puțin. Adesea, în baza de date este necesar să avem, pe de o parte, mai multe tabele și, pe de altă parte, să efectuăm selecții într-o ordine diferită de cea a cheii primare. Acest ultim capitol este dedicat creării și interconectării lor.
Tabele indexate
În aplicația cloud există o secțiune "Galerie". Aceasta afișează conținut multimedia din întreaga cloud, sortat după dată. Pentru a implementa optim o astfel de selecție, lângă masa principală trebuie să creezi una nouă cu un tip de chei diferit. Aceasta va conține un câmp cu data creării fișierului, care va acționa ca principal criteriu de sortare. Deoarece noile chei se referă la aceleași date ca și cheile din masa principală, acestea sunt numite chei indexate. În imaginea de mai jos, acestea sunt marcate cu culoarea portocalie.
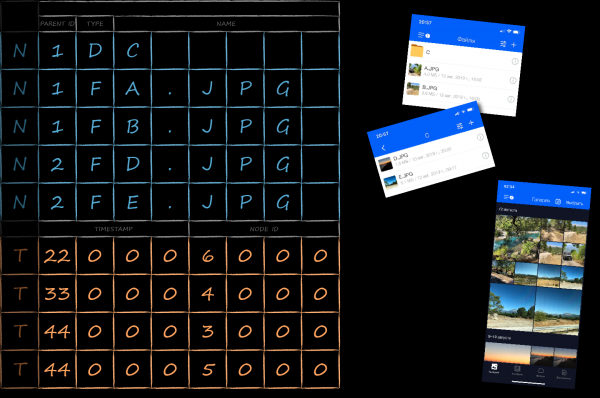
Pentru a separa cheile din diferite tabele în cadrul aceleași baze de date, tuturor le-a fost adăugat un câmp tehnic suplimentar, tableId. Făcându-l cel mai prioritar pentru sortare, vom obține gruparea cheilor întâi pe tabele, iar apoi în interiorul tabelelor - conform propriilor reguli.
Cheia indexată se referă la aceleași date ca și cheia primară. Implementarea directă a acestei proprietăți prin asocierea cu o copie a părții value a cheii primare nu este optimă din mai multe puncte de vedere:
- Din perspectiva spațiului ocupat, având în vedere că metadatele pot fi destul de bogate.
- Din perspectiva performanței, deoarece la actualizarea metadatelor nodurile vor trebui să efectueze rescriere pe două chei.
- Din punctul de vedere al suportului pentru cod, imediat ce uităm să actualizăm datele pentru una dintre chei, vom întâlni un bug greu de identificat de inconsistență a datelor în stocare.
În continuare, vom analiza cum putem elimina aceste dezavantaje.
Organizarea relațiilor între tabele
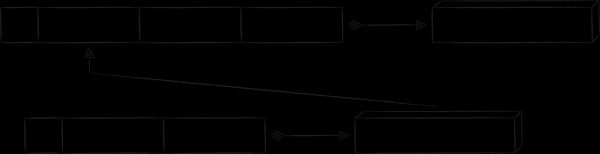
Pentru a lega tabelul de index cu tabelul principal, un model potrivit este „cheie ca valoare”. Așa cum sugerează numele, partea value a înregistrării de index este o copie a valorii cheii primare. Această abordare elimină toate dezavantajele menționate anterior legate de stocarea unei copii a părții value a înregistrării primare. Singurul cost este că, pentru a obține valoarea după cheia de index, trebuie să facem două cereri în baza de date în loc de una. Schema rezultată a bazei de date arată schematic astfel.
Un alt model de organizare a relației între tabele este „cheie redundantă”. Esența acesteia constă în adăugarea de atribute suplimentare în cheie, care nu sunt necesare pentru sortare, ci pentru recrearea cheii asociate. În aplicația OblaCă Mail.ru există exemple reale de utilizare, însă, pentru a evita o aprofundare în contextul cadrelor specifice iOS, voi oferi un exemplu imaginar, dar mai ușor de înțeles.
În clienții mobili din cloud există o pagină unde sunt afișate toate fișierele și folderele la care utilizatorul a dat acces altor persoane. Deoarece există relativ puține astfel de fișiere, dar multe informații specifice legate de publicitate (cine a primit acces, cu ce drepturi etc.), nu ar fi eficient să le îngreunăm partea value a înregistrării în tabela principală. Totuși, dacă s-ar dori afișarea acestor fișiere offline, atunci trebuie să fie stocate undeva. O soluție firească este crearea unei tabele separate pentru aceasta. În schema de mai jos, cheia sa are prefixul „P”, iar placeholder-ul „propname” poate fi înlocuit cu o valoare mai specifică, „informații publice”.
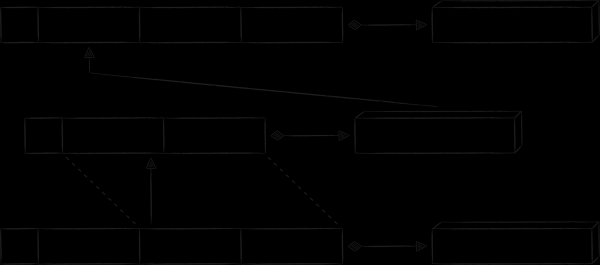
Toate metadatele unice, pentru stocarea cărora a fost creat un nou tabel, sunt extrase în partea value a înregistrării. În același timp, nu dorim să duplicăm datele despre fișiere și foldere, care sunt deja stocate în tabelul principal. În schimb, în cheia „P” sunt adăugate date redundante sub formă de câmpuri „node ID” și „timestamp”. Datorită acestora, putem construi o cheie index, prin care să obținem cheia primară, care, în cele din urmă, ne va permite să accesăm metadatele nodului.
Concluzie
Evaluăm pozitiv rezultatele implementării LMDB. După implementare, numărul blocajelor aplicației a scăzut cu 30%.
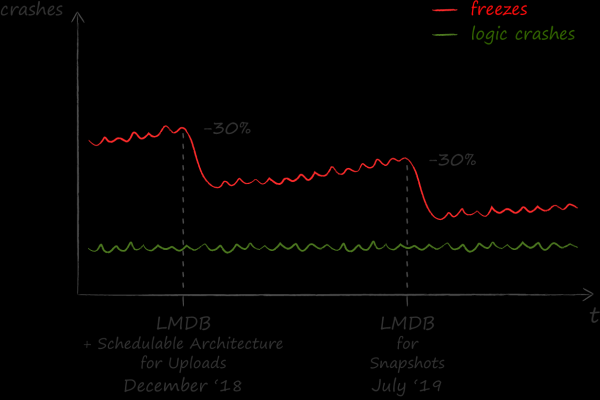
Rezultatele muncii efectuate au fost bine primite dincolo de echipa iOS. În prezent, una dintre secțiunile principale „Fișiere” din aplicația Android a adoptat de asemenea LMDB, iar alte părți sunt în curs de adaptare. Limbajul C, în care a fost realizat stocarea key-value, a fost un bun ajutor pentru a crea inițial un wrapper aplicațional în mod cross-platform pe C++. Pentru integrarea fără probleme a bibliotecii C++ rezultate cu codul platformei în Objective-C și Kotlin, a fost utilizat un generator de cod. de la Dropbox, dar aceasta este o cu totul altă poveste.
Sursa: habr.com
