

Salut tuturor, mă numesc Serghei Emeliančik. Sunt managerul companiei Audit-Telecom, principalul dezvoltator și autorul sistemului Veliam. Am decis să scriu un articol despre cum eu și un prieten ne-am creat o companie de outsourcing, am dezvoltat software pentru nevoile noastre și ulterior am început să îl distribuim tuturor doritorilor prin intermediul sistemului SaaS. Voi povesti despre cum am fost categoric sceptic că acest lucru este posibil. Articolul va conține nu doar o relatare, ci și detalii tehnice despre cum a fost creat produsul Veliam, inclusiv câteva fragmente de cod sursă. Voi discuta despre greșelile pe care le-am făcut și cum le-am corectat ulterior. Am avut dubii dacă ar trebui să public o astfel de articol. Dar m-am gândit că este mai bine să fac asta, să primesc feedback și să mă corectez, decât să nu public articolul și să mă gândesc la ce ar fi fost dacă...
Povestea
Am lucrat la o companie ca angajat IT. Compania era destul de mare, cu o structură de rețea ramificată. Nu mă voi opri asupra responsabilităților mele, voi spune doar că acestea nu includeau dezvoltarea nimic.
Aveam un sistem de monitorizare, dar din pură curiozitate academică am vrut să încerc să scriu unul simplu. Ideea era următoarea: voiam să fie bazat pe web, astfel încât să putem accesa ușor și să vedem ce se întâmplă cu rețeaua de pe orice dispozitiv, inclusiv de pe un dispozitiv mobil prin Wi-Fi, și, de asemenea, mi-ar fi plăcut să înțeleg rapid în ce cameră se află echipamentul care „se clatină”, deoarece aveam cerințe foarte stricte privind timpul de reacție la astfel de probleme. În cele din urmă, mi-a venit ideea de a scrie o pagină web simplă, care să aibă ca fundal un jpeg cu schema rețelei, să tai pe acea imagine dispozitivele cu adresele lor IP, iar deasupra imaginii, în coordonatele necesare, să arătăm deja conținut dinamic sub formă de adresă IP verde sau roșie clipește. Sarcina a fost stabilită, să începem.
Anterior, m-am ocupat de programare în Delphi, PHP, JS și foarte superficial C++. Am o cunoaștere destul de bună a funcționării rețelelor. VLAN, Routing (OSPF, EIGRP, BGP), NAT. Acestea au fost suficiente pentru a dezvolta un prototip primitiv de monitorizare pe cont propriu.
Am scris ceea ce îmi propusesem în PHP. Serverul Apache și PHP au fost pe Windows, deoarece Linux pentru mine la acel moment era ceva complet necunoscut și foarte complicat. Așa cum s-a dovedit mai târziu, m-am înșelat foarte mult, și în multe aspecte Linux este mult mai simplu decât Windows, dar aceasta este o temă separată și știm cu toții câte controverse sunt pe această temă. Planificatorul de sarcini din Windows apela la un interval mic (nu-mi amintesc exact, dar ceva de genul o dată la trei secunde) un script PHP, care verifica toate obiectele printr-un ping banal și salva starea într-un fișier.
system(“ping -n 3 -w 100 {$ip_address}“);
Da, da, lucrul cu baze de date la acel moment era de asemenea un teren neexplorat pentru mine. Nu știam că pot paraleliza procesele, iar trecerea prin toate nodurile rețelei dura mult timp, deoarece se desfășura pe un singur fir. Problemele apăreau în special atunci când mai multe noduri erau indisponibile, deoarece fiecare dintre ele încetinea scriptul cu 300 ms. Pe partea clientului exista o funcție simplă în buclă, care la intervale de câteva secunde descărca informații actualizate de pe server printr-o cerere Ajax și actualiza interfața. Și apoi, după 3 pinguri nereușite la rând, dacă pagina web cu monitorizarea era deschisă pe calculator, se redau o melodie veselă.
At the moment everything worked out, I was very inspired by the result and thought that I could add even more (given my knowledge and capabilities). However, I have always disliked systems with a million charts, which I considered unnecessary in most cases back then and still do today. I only wanted to integrate what would genuinely help me in my work. This principle remains fundamental in the development of Veliam to this day. Then, I realized it would be really great if I didn’t have to keep monitoring open and be aware of problems; instead, when something happened, I could just open the page and see where the problematic network node was located and what to do next. Back then, I didn’t read my email; I simply didn't use it. I stumbled upon SMS gateways online, where you could send a GET or POST request, and they would send an SMS with the text I wrote to my mobile phone. I immediately understood that I really wanted this. So I began to study the documentation. After some time, I succeeded, and now I received SMS about network issues on my mobile phone with the name of the “downed object.” Although the system was primitive, it was written by me, and most importantly, what motivated me to develop it was that this was an application that truly helped me in my work.
And then came the day when one of the internet channels at work went down, but my monitoring did not indicate anything. Google's DNS were still responding well. It was time to think about how to monitor whether the communication channel was active. There were various ideas on how to do this. I didn’t have access to all the equipment. I had to come up with ways to understand which of the channels was operational, while not being able to look at anything on the actual networking equipment. Then a colleague suggested the idea that perhaps the trace route to public servers could differ depending on which communication channel was being used to access the internet. I checked, and it turned out to be true. There were different routes during the trace.
system(“tracert -d -w 500 8.8.8.8”);
Așa a apărut încă un script, iar mai exact, urmărirea a fost adăugată la sfârșitul aceluiași script, care pinga toate dispozitivele din rețea. Aceasta era un alt proces lung, care era executat în același fir de execuție și încetinea funcționarea întregului script. Dar atunci nu era atât de evident. Oricum, își făcea treaba, codul stipulând în mod clar ce fel de urmărire trebuia să aibă fiecare dintre canale. Așa a început să funcționeze sistemul, care monitoriza (expresie mai puțin potrivită, deoarece nu existau metrici colectate, ci doar ping) dispozitivele de rețea (routere, switch-uri, wi-fi etc.) și canalele de conectare cu lumea exterioară. SMS-urile sosind la timp, iar în diagramă era întotdeauna clar unde era problema.
Apoi, în activitatea zilnică, trebuia să mă ocup de cross-linking. Și de fiecare dată era plictisitor să intru pe switch-urile Cisco pentru a verifica ce interfață trebuie utilizată. Cât de fain ar fi fost să pot face clic pe monitorizare și să văd lista interfețelor sale cu descrierile. Ar fi economisit timp. În plus, în acest sistem nu ar fi fost necesar să deschid Putty sau SecureCRT, să introduc utilizatorii și comenzile. Pur și simplu făceam clic în monitorizare, vedeam ce am nevoie și mergeam să-mi fac treaba. Am început să caut modalități de interacțiune cu switch-urile. La prima vedere, am găsit imediat 2 opțiuni: SNMP sau să accesez switch-ul prin SSH, să introduc comenzile necesare și să parsez rezultatul. Am abandonat SNMP din cauza complexității implementării, nu aveam răbdare să aștept rezultatul. Cu SNMP ar fi fost nevoie să caut mult în MIB, bazându-mă pe aceste date pentru a forma datele despre interfețe. Există o comandă minunată în CISCO
show interface statusArată exact ceea ce aveam nevoie pentru monitorizarea interfețelor. De ce să mă complic cu SNMP când eu doar vreau să văd rezultatul acestui comandă, m-am gândit. După ceva timp, am implementat această posibilitate. Am apăsat pe obiectul de pe pagina web. A fost declanșat un eveniment, prin care AJAX-ul clientului s-a conectat la server, iar acesta, la rândul său, s-a conectat prin SSH la switch-ul dorit (crediteau de acces erau hardcodate în cod, nu aveam dorința de a crea meniuri separate pentru a schimba acreditivele din interfață, aveam nevoie de un rezultat și cât mai repede) introducând comanda menționată mai sus și retransmițând-o în browser. Astfel, am început să văd informațiile despre interfețe cu un singur click. A fost extrem de convenabil, mai ales atunci când trebuia să verific aceste informații pe mai multe switch-uri simultan.
Monitorizarea canalelor pe baza trasării s-a dovedit a fi, în cele din urmă, o idee nu foarte bună, deoarece uneori aveau loc lucrări în rețea, iar trasarea se putea schimba, iar monitorizarea începea să-mi semnaleze că există probleme cu canalul. După ce am petrecut mult timp analizând, înțelegeam că toate canalele funcționează, iar monitorizarea mea mă înșela. În cele din urmă, am cerut colegilor care gestionau switch-urile de bază să-mi trimită pur și simplu syslog atunci când se schimba starea vizibilității vecinilor. Așa că, a fost mult mai simplu, mai rapid și mai corect decât trasarea. A venit un eveniment de tipul 'neighbor lost', iar eu am realizat imediat o notificare cu privire la căderea canalului.
Apoi, au apărut rezultatele prin click pe obiect al unor comenzi suplimentare și am adăugat SNMP pentru a colecta unele metrici, iar asta a fost, în mare parte, tot. Sistemul nu a evoluat mai departe. A făcut tot ce aveam nevoie, a fost un instrument bun. Mulți cititori, probabil, îmi vor spune că pentru rezolvarea acestor probleme există deja o grămadă de software pe internet. Dar, de fapt, nu am găsit produse gratuite de acest gen atunci și îmi doream foarte mult să îmi dezvolt abilitățile de programare, iar ce poate fi mai bun decât o problemă practică reală pentru a mă împinge în această direcție. Astfel, prima versiune a monitorizării a fost finalizată și nu a mai fost modificată.
Crearea companiei Audit-Telecom
Pe măsură ce timpul trecea, am început să lucrez în paralel și pentru alte companii, din fericire programul de lucru îmi permitea să fac asta. Atunci când lucrezi pentru diferite companii, abilitățile tale cresc rapid în diverse domenii, iar orizonturile tale se dezvoltă bine. Există companii în care, cum se spune, ești și croitor, și secerător, și jucător pe cimpoi. Pe de o parte, este complicat, pe de altă parte, dacă nu ești leneș, devii un specialist cu un profil larg, iar acest lucru îți permite să rezolvi mai repede și mai eficient problemele, deoarece știi cum funcționează domeniul înrudit.
Prietenul meu Pavel (tot un IT-ist) a încercat mereu să mă încurajeze să-mi deschid propria afacere. Au fost nenumărate idei cu diverse variante de afaceri. Aceasta a fost discutată timp de mulți ani. Și, în cele din urmă, nu părea să ajungă nicăieri, deoarece eu sunt un skeptic, iar Pavel un visător. De fiecare dată când el propunea o idee, eu nu o credeam niciodată și refuzam să particip. Dar ne doream cu adevărat să ne deschidem propria afacere.
În cele din urmă, am reușit să găsim o variantă care ne mulțumea pe amândoi și să ne ocupăm de ceea ce știm să facem. În 2016, am decis să creăm o companie IT care să ajute afacerea să rezolve problemele IT. Aceasta include desfășurarea sistemelor IT (1C, servere de terminale, servere de e-mail etc.), asistență pentru acestea, HelpDesk clasic pentru utilizatori și administrarea rețelei.
Sincer să fiu, în momentul în care am creat compania, nu aveam încredere în ea vreo 99,9%. Dar, somehow, Pavel a reușit să mă convingă să încerc, iar, pe scurt, s-a dovedit că avea dreptate. Eu și Pavel am contribuit fiecare cu 300.000 de ruble, am înregistrat un nou SRL „Audit-Telecom”, am închiriat un birou mic, am făcut cărți de vizită grozave și, în general, am început ca majoritatea antreprenorilor noi și neexperimentați, căutând clienți. Căutarea de clienți este o poveste complet diferită. Poate vom scrie un articol separat în cadrul blogului corporativ, dacă va fi de interes pentru cineva. Apeluri reci, pliante și altele. Aceasta nu a dat rezultate. Așa cum citesc acum din multe povești de afaceri, în multe aspecte depinde, într-un fel sau altul, de noroc. Am avut noroc. Și, la câteva săptămâni după înființarea firmei, fratele meu Vladimir ne-a contactat și a adus primul client. Nu vreau să obosesc cu detalii despre colaborarea cu clienții, articolul nu este despre asta, vreau doar să spun că am mers la un audit, am identificat locuri critice și aceste locuri s-au defectat în timp ce se lua decizia de a colabora cu noi pe o bază constantă ca outsourceri. După aceasta, a fost luată imediat o decizie pozitivă.
Apoi, în principal prin recomandări de la cunoscuți, au început să apară și alte companii la care am lucrat. Helpdesk-ul era într-un singur sistem. Conexiunile la echipamentele de rețea și servere în altul, adică fiecare cum avea. Unii păstrau scurtături, alții foloseau cărți de adrese RDP. Monitorizarea era o altă sistemă separată. Era foarte incomod pentru echipă să lucreze în sisteme diferite. Informațiile importante se pierdeau din vedere. De exemplu, serverul terminal al clientului a devenit inaccesibil. Imediat primim solicitări de la utilizatorii acestui client. Specialistul din suport deschide o solicitare (care a venit prin telefon). Dacă incidentele și solicitările ar fi fost înregistrate într-un singur sistem, specialistul de suport ar fi văzut imediat care era problema utilizatorului și i-ar fi spus despre aceasta, în timp ce se conecta deja la obiectul necesar pentru a rezolva situația. Toată lumea este la curent cu situația tactică și lucrează coordonat. Nu am găsit un astfel de sistem unde toate acestea sunt integrate. A devenit clar că este timpul să facem propriul produs.
Continuarea lucrului la propriul nostru sistem de monitorizare
Era evident că sistemul care fusese scris anterior nu se potrivea deloc cu sarcinile actuale. Nici din punct de vedere funcțional, nici din punct de vedere al calității. Așa că am luat decizia de a scrie un sistem de la zero. Grafic, acesta urma să arate complet diferit. Trebuia să fie un sistem ierarhic, astfel încât să putem deschide rapid și convenabil obiectul necesar pentru clientul dorit. Schema din prima versiune nu mai era deloc justificată în acest caz, deoarece clienții erau diferiți și nu conta în ce încăperi se afla echipamentul. Aceasta a fost deja trecută în documentație.
Așadar, sarcinile:
- Structură ierarhică;
- O parte de server care poate fi plasată la client sub formă de mașină virtuală pentru a colecta metricile necesare și a le trimite către serverul central, care va centraliza toate acestea și ne va arăta rezultatele;
- Alerte. De acelea pe care nu le poți rata, deoarece în acel moment nu era posibil pentru nimeni să stea doar și să observe monitorul;
- Sistem de solicitări. Au început să apară clienți pentru care ofeream nu doar echipamente de server și rețea, ci și stații de muncă;
- Posibilitatea de a ne conecta rapid la servere și echipamente din sistem;
Sarcinile au fost stabilite, așa că începem să scriem. Între timp, procesăm solicitările din partea clienților. La acel moment, eram deja patru oameni. Am început să scriem simultan ambele părți: serverul central și serverul pentru instalare la clienți. Până în acel moment, Linux nu era străin pentru noi și s-a decis că mașinile virtuale care vor fi la clienți vor fi pe Debian. Nu vor fi instalatoare, pur și simplu vom face proiectul părții de server pe o mașină virtuală specifică, iar apoi vom clona această mașină pentru clientul necesar. Aceasta a fost o altă eroare. Ulterior, a devenit clar că în această schemă mecanismul de actualizări nu era deloc bine gândit. Adică, adăugam o nouă funcționalitate, dar apoi era o problemă întreagă să o răspândim pe toate serverele clienților, dar vom reveni la acest aspect mai târziu, totul în ordine.
Am creat primul prototip. Acesta putea să facă ping la dispozitivele de rețea necesare ale clienților și serverelor și să trimită aceste date către serverul nostru central. La rândul său, serverul actualiza aceste date în masa comună de pe serverul central. Aici voi povesti nu doar despre istoria a ceea ce a reușit, ci și despre greșelile de începător care au fost comise și cum am plătit pentru asta cu timp. Așadar, toate obiectele erau stocate într-un singur fișier sub formă de obiect serializat. Până am conectat la sistem câțiva clienți, totul a fost mai mult sau mai puțin în regulă, deși uneori apăreau anumite artefacte, care erau complet neclare. Însă când am conectat la sistem o duzină de servere, au început să se întâmple minuni. Uneori, din motive neclare, toate obiectele din sistem dispăreau pur și simplu. Este important de subliniat că serverele clienților trimiteau date către serverul central la fiecare câteva secunde printr-o cerere POST. Cititorul atent și programatorul experimentat și-au dat seama că apăruse o problemă de acces simultan la același fișier în care era stocat obiectul serializat din diferite fire de execuție simultan. Și exact atunci când se întâmpla acest lucru, minuni cu dispariția obiectelor se manifestau. Fișierul devenea pur și simplu gol. Dar asta s-a descoperit nu imediat, ci doar în timpul exploatării cu mai multe servere. În acest timp, a fost adăugată funcționalitatea de scanare a porturilor (serverele trimiteau către centrală nu doar informații despre disponibilitatea dispozitivelor, ci și despre porturile deschise pe ele). Aceasta s-a realizat prin apelarea comenzii:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
rezultatele erau adesea incorecte și scanarea dura foarte mult. Am uitat complet de ping, care se efectua prin fping:
system("fping -r 3 -t 100 {$this->ip}");
Toate acestea nu erau nici ele paralelizate, prin urmare procesul era foarte lung. Mai târziu, în fping se transmitea deja întreaga listă de adrese IP necesare pentru verificare și se primea înapoi o listă gata a celor care au răspuns. Spre deosebire de noi, fping putea paraleliza procesele.
O altă activitate frecventă și rutinieră a fost configurarea unor servicii prin WEB. De exemplu, ECP de la MS Exchange. În esență, este vorba doar despre un link. Am decis că trebuie să avem posibilitatea de a adăuga astfel de linkuri direct în sistem, pentru a nu căuta în documentație sau în alte marcaje cum să accesăm ECP-ul unui client specific. Așa a apărut conceptul de linkuri resursă pentru sistem, iar funcționalitatea acestora este disponibilă și în prezent și nu a suferit modificări, sau aproape că nu.
Funcționarea linkurilor resursă în Veliam
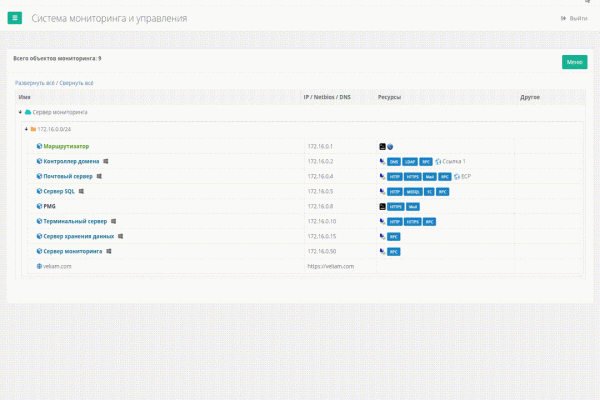
Conexiuni la distanță
Iată cum arată în practică în versiunea curentă Veliam
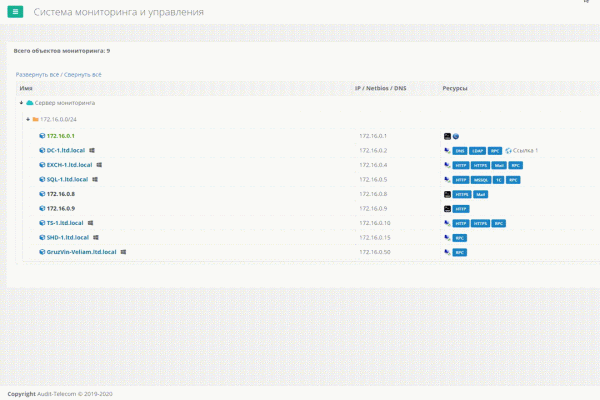
Una dintre sarcini a fost conectarea rapidă și convenabilă la servere, care au devenit deja foarte multe (nu doar câteva sute), iar să parcurgi milioane de scurtături RDP salvate anterior era extrem de incomod. Aveam nevoie de un instrument. Există un software pe internet care se prezintă ca o carte de adrese pentru astfel de conexiuni RDP, dar ele nu sunt integrate cu sistemul de monitorizare și conturile nu se pot salva. A introduce de fiecare dată datele de autentificare pentru diferiți clienți este o adevărată nebunie, mai ales când într-o zi te conectezi de zeci de ori la diferite servere. În cazul SSH, lucrurile stau puțin mai bine, există multe software-uri bune care permit organizarea acestor conexiuni în foldere și salvarea datelor de autentificare. Dar sunt două probleme. Prima — pentru conexiunile RDP și SSH nu am găsit un program unic. A doua — dacă într-un anumit moment nu mă aflu la computerul meu și trebuie să mă conectez rapid, sau pur și simplu am reinstalat sistemul, va trebui să caut în documentație pentru a verifica datele de autentificare ale acestui client. Este incomod și o pierdere de timp.
Structura ierarhică necesară pentru serverele clienților era deja prezentă în produsul nostru intern. Trebuia doar să ne dăm seama cum să integrăm acolo conexiuni rapide la echipamentele necesare. De început, cel puțin în interiorul rețelei noastre.
Având în vedere că clientul din sistemul nostru era un browser care nu avea acces la resursele locale ale computerului pentru a putea deschide aplicația dorită printr-o comandă, s-a decis să facem totul prin „Windows custom url scheme”. Astfel, a apărut un fel de „plugin” pentru sistemul nostru, care includea pur și simplu Putty și Remote Desktop Plus și, la instalare, înregistra URI schema în Windows. Acum, când doream să ne conectăm la un obiect prin RDP sau SSH, apăsam această acțiune în sistemul nostru și se activa funcția Custom URI. Se lansa mstsc.exe standard încorporat în Windows sau putty, care făcea parte din „plugin”. Folosesc cuvântul plugin în ghilimele, deoarece nu este un plugin de browser în sensul clasic.
Asta era deja ceva. O agendă de contacte convenabilă. Și în cazul lui Putty, totul mergea foarte bine, deoarece putea primi atât IP-ul de conectare, cât și utilizatorul și parola ca parametri de intrare. Așadar, ne conectam la serverele Linux din rețeaua noastră cu un singur clic, fără a introduce parole. Dar cu RDP lucrurile nu erau atât de simple. În mstsc standard nu puteai furniza datele de autentificare ca parametri. În ajutor a venit Remote Desktop Plus. Acesta permitea acest lucru. Acum ne descurcăm fără el, dar mult timp a fost un ajutor fidel în sistemul nostru. Cu site-urile HTTP(S) era simplu, aceste obiecte se deschideau pur și simplu în browser și asta era tot. Convenabil și practic. Dar aceasta era fericirea doar în rețeaua internă.
Dat fiind că majoritatea problemelor le rezolvam de la distanță din birou, cea mai simplă soluție era să facem VPN-uri către clienți. Astfel, din sistemul nostru ne puteam conecta și la ei. Dar era totuși destul de incomod. Pentru fiecare client trebuia să păstrăm pe fiecare computer o mulțime de conexiuni salvate VPN și înainte de a ne conecta la oricare, trebuia să activăm VPN-ul corespunzător. Am folosit această soluție pentru o perioadă destul de lungă. Dar numărul clienților crește, numărul VPN-urilor de asemenea și toate acestea au început să devină stresante, iar ceva trebuia făcut. În special, lacrimile se adunau în ochi după reinstalarea sistemului, când trebuia să introduc din nou zeci de conexiuni VPN în noul profil Windows. Ajunge cu această supărare, am spus eu și am început să mă gândesc ce pot face în legătură cu asta.
Este obicei ca toți clienții să aibă routere de la binecunoscuta firmă Mikrotik. Acestea sunt foarte funcționale și utile pentru aproape orice sarcină. Din păcate, au un dezavantaj: sunt „furate”. Am rezolvat această problemă prin închiderea tuturor accesurilor externe. Însă trebuia să găsim o modalitate de a avea acces la ele fără a merge la client, deoarece acest lucru durează mult. Am creat tuneluri pentru fiecare astfel de Mikrotik și le-am grupat într-un pool separat, fără niciun fel de rutare, pentru a evita fuziunea rețelei noastre cu rețelele clienților și între rețelele acestora.
A apărut ideea de a face ca, la apăsarea pe obiectul dorit din sistem, serverul central de monitorizare, cunoscând acreditivele SSH ale tuturor Mikrotik-urilor clienților, să se conecteze la cel dorit, creând o regulă de redirecționare către gazda necesară pe portul dorit. Sunt câteva aspecte aici. Soluția nu este universală — va funcționa doar pentru Mikrotik, deoarece sintaxa comenzilor este diferită pentru fiecare router. De asemenea, aceste redirecționări trebuiau cumva șterse, iar partea serverului sistemului nostru nu putea urmări efectiv dacă mi-am încheiat sesiunea de lucru prin RDP. Și o astfel de redirecționare reprezintă o vulnerabilitate pentru client. Totuși, nu ne-am axat pe universalitate, deoarece produsul era utilizat doar în cadrul companiei noastre și nu am avut gânduri să-l facem public.
Fiecare problemă a fost rezolvată într-un mod specific. Când se crea o regulă, redirecționarea era disponibilă doar pentru un anumit IP extern (de la care a fost inițiată conexiunea). Așa că au fost evitate vulnerabilitățile de securitate. Însă, cu fiecare astfel de conexiune, se adăuga o regulă pe Mikrotik în pagina NAT care nu era ștersă. Și este bine cunoscut faptul că, cu cât sunt mai multe reguli, cu atât procesorul router-ului este mai solicitat. În general, nu puteam accepta situația în care să accesez odată un Mikrotik și acolo să găsesc sute de reguli moarte, inutile.
Deoarece serverul nostru nu poate monitoriza starea conexiunii, haideți să lăsăm Mikrotik să se ocupe singur de asta. Am scris un script care monitoriza constant toate regulile de redirecționare cu o descriere specifică (description) și verifica dacă există o conexiune TCP pentru regula respectivă. Dacă nu a existat niciuna timp de un anumit interval, atunci probabil că conexiunea s-a încheiat deja și redirecționarea poate fi eliminată. Totul a mers bine, scriptul a funcționat foarte bine.
Apropo, iată-l:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Removing nat rules added automaticaly by atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Cu siguranță s-ar fi putut face mai frumos, mai rapid etc., dar a funcționat, nu a suprasolicitat Mikrotik-urile și s-a descurcat excelent. În sfârșit, am reușit să ne conectăm la servere și echipamentele de rețea ale clienților cu o simplă apăsare de buton. Fără să ridicăm VPN-ul și fără a introduce parole. Sistemul a devenit foarte ușor de utilizat. Timpul pentru întreținere s-a redus, iar noi ne-am putut concentra pe muncă, nu pe conectarea la obiectele dorite.
Backup Mikrotik
Aveam configurat backup-ul tuturor Mikrotik-urilor pe FTP. În general, totul era bine. Dar când trebuia să recuperăm un backup, trebuia să deschidem acel FTP și să-l căutăm acolo. Avem un sistem unde sunt înregistrate toate routerele, știm să comunicăm cu dispozitivele prin SSH. De ce să nu facem astfel încât sistemul să recupereze zilnic backup-uri de la toate Mikrotik-urile, m-am gândit. Și am început să implementez. Ne-am conectat, am făcut backup-ul și l-am recuperat în depozitul nostru.
Codul scriptului în PHP pentru a face un backup de pe Mikrotik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, ' /system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, ' /export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); // Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    // Download backup file
    $size = filesize("ssh2.sftp://$sftp/atmon.backup");
    $stream = fopen("ssh2.sftp://$sftp/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    // Download RSC file
    $size = filesize("ssh2.sftp://$sftp/atmon.rsc");
    $stream = fopen("ssh2.sftp://$sftp/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
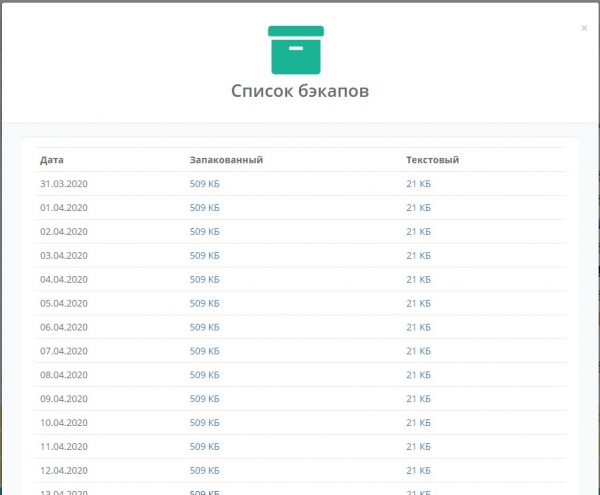
Backup is created in two formats — binary and text configuration. The binary helps to quickly restore the necessary configuration, while the text one allows you to understand what to do if there is a forced equipment replacement and the binary cannot be loaded onto it. In the end, we got another convenient functionality in the system. Moreover, when adding new MikroTik devices, there was no need to configure anything, just added the object to the system and specified the SSH credentials for it. The system then automatically handled the backup process. This functionality is currently not available in the latest version of SaaS Veliam, but we will be porting it soon.
Screenshots of how it looked in the internal system
Transition to normal storage in the database
Anterior am menționat că au apărut artefacte. Câteodată, întreaga listă de obiecte din sistem dispărea, alteori, când editam un obiect, informația nu se salva și trebuia să redenumesc obiectul de trei ori. Acest lucru îi frustra enorm pe toți. Dispariția obiectelor se întâmpla rar și era ușor de recuperat prin restaurarea acelui fișier, dar eroarea în timpul editării obiectelor era o problemă frecventă. Probabil că nu am implementat inițial prin Baza de Date pentru că nu înțelegeam cum se poate menține un arbore cu toate relațiile într-un tabel plat. Este un tabel plat, iar arborele este ierarhic. Dar o soluție bună pentru accesul multiplu și ulterior (pe măsură ce sistemul devenea mai complex) și pentru tranzacții - este un SGBD. Sunt sigur că nu sunt primul care s-a confruntat cu această problemă. Am început să caut pe Google. S-a dovedit că deja s-au gândit alții înaintea mea și există mai multe algoritmi care construiesc un arbore dintr-un tabel plat. După ce am analizat fiecare, am implementat unul dintre ele. Dar aceasta a fost deja o versiune nouă a sistemului, deoarece a trebuit să rescriu foarte mult din cauza acestui lucru. Rezultatul a fost previzibil, problemele cu comportamentul aleator al sistemului au dispărut. Unii ar putea spune că erorile sunt destul de naive (scripturi unithreaded, stocarea informațiilor la care era acces simultan din diferite fire în fișiere, etc.) în dezvoltarea software-ului. Poate că așa este, dar munca mea principală era administrarea, iar programarea era un hobby, și pur și simplu nu am avut experiență de lucru într-o echipă de programatori, unde astfel de lucruri elementare mi-ar fi fost sugerate imediat de colegii mai experimentați. Prin urmare, toate aceste greșeli le-am învățat singur, dar am asimilat foarte bine materialul. De asemenea, activitatea mea includea întâlniri cu clienții, încercări de promovare a firmei, o mulțime de chestiuni administrative interne și multe altele. Dar, într-un fel sau altul, ceea ce existase deja - fusese solicitat. Băieții și eu, personal, foloseam produsul în activitatea de zi cu zi. Au existat și idei cu adevărat nefericite, dar și soluții la care s-a investit timp, iar la final a devenit clar că este un instrument nefuncțional și nimeni nu îl folosea și acesta nu a intrat în Veliam.
Asistență clienți — HelpDesk
Merită menționat cum a fost dezvoltat HelpDesk. Este o poveste complet separată, deoarece în Veliam aceasta este deja a treia versiune complet nouă, care se distinge de toate cele anterioare. Acum este un sistem simplu, intuitiv, fără elemente inutile și opțiuni sofisticate, având capacitatea de a se integra cu domeniul, precum și posibilitatea de acces la același profil de utilizator din orice locație printr-un link dintr-un email. Și ceea ce este cel mai important, există posibilitatea de a te conecta la solicitant prin VNC direct din cerere, fără VPN sau port forwarding, din orice loc (fie acasă, fie la birou). Voi povesti cum am ajuns aici, ce a fost înainte și ce soluții teribile am avut.
Ne-am conectat la utilizatori prin binecunoscutul TeamViewer. Pe toate calculatoarele utilizatorilor pe care îi deservim era instalat TV. Primul lucru pe care l-am făcut greșit și pe care ulterior l-am eliminat a fost legarea fiecărui client la hardware. Cum intra utilizatorul în sistemul HD pentru a trimite o cerere? Pe toate computerele, pe lângă TV, a fost instalată o utilitate specială, scrisă în Lazarus (aici mulți vor ridica din sprâncene și poate chiar vor căuta pe Google ce este, dar cel mai bine dintre limbajele compilate pe care le cunoșteam era Delphi, iar Lazarus este aproape același, doar că gratuit). În general, utilizatorul rula un fișier batch special, care pornea această utilitate, care la rândul său citea HWID-ul sistemului și după aceea se lansa browserul și se realiza autenticarea. De ce a fost făcută aceasta? În unele companii, numărul utilizatorilor deserviți este contabilizat pe fiecare, iar prețul de întreținere pentru fiecare lună este format în funcție de numărul persoanelor. Acest lucru este clar, veți spune, dar de ce legătura cu hardware-ul? Foarte simplu, unele persoane veneau acasă și trimiteau cereri de genul "fă-mi aici totul frumos" de pe laptopul de acasă. Pe lângă citirea HWID-ului sistemului, utilitatea extrăgea din registru ID-ul curent al TeamViewer-ului și de asemenea îl transmitea către noi. TeamViewer are un API pentru integrare. Și am realizat această integrare. Dar a fost o problemă. Prin aceste API nu se poate conecta la computerul utilizatorului, când acesta nu inițiază în mod clar sesiunea, și după încercarea de a te conecta la el, trebuie să apese încă pe "confirmare". La acea vreme, ni s-a părut logic că fără permisiunea utilizatorului nimeni nu ar trebui să se conecteze, iar având în vedere că există o persoană la computer, aceasta inițiază sesiunea și va răspunde afirmativ la cererea de conectare la distanță. Totul s-a dovedit a fi diferit. Solicitantii uitau să apese inițierea sesiunii și trebuia să le explicăm acest lucru în timpul convorbirilor telefonice. Asta ne consuma timp și nervii ambelor părți implicate în proces. Mai mult, nu erau deloc rare situațiile în care o persoană trimite o cerere, dar permite conectarea doar atunci când pleacă la prânz. Deoarece problema nu era critică și nu dorea să-i fie întrerupt procesul de lucru. Așadar, nu va apăsa niciun buton pentru a permite conectarea. Așa a apărut funcționalitatea suplimentară la autentificarea în HelpDesk — citirea ID-ului TeamViewer-ului. Noi cunoșteam parola constantă care era utilizată la instalarea TeamViewer-ului. Mai exact, o știa doar sistemul, deoarece era încorporată în installer, și în sistemul nostru. Așadar, exista un buton de conectare din cerere, apăsând pe care nu mai trebuia să așteptăm nimic, ci se deschidea imediat TeamViewer-ul și se realiza conexiunea. În final, au apărut două tipuri posibile de conexiuni. Prin API-ul oficial TeamViewer și prin cel improvizat de noi. Spre surprinderea mea, primul a fost aproape imediat abandonat, deși existau indicații pentru a-l folosi doar în cazuri speciale și când utilizatorul dă acordul. Totuși, acum se pune accent pe siguranță. Dar s-a dovedit că solicitantii nu au nevoie de aceasta. Ei nu se opun deloc conectării fără un buton de confirmare. Și astfel, în continuare, funcționalitatea de conectare prin API a fost desființată din lipsă de necesitate.
Trecerea la multi-threading în Linux
Întrebarea despre accelerarea trecerii scanner-ului de rețea pentru a verifica deschiderea unei liste prestabilite de porturi și simpla pingare a obiectelor rețelei s-a pus demult. Primul lucru care vine în minte ca soluție este multi-threading-ul. Deoarece timpul principal care se pierde la ping este așteptarea răspunsului pachetului, și următorul ping nu poate începe până nu se întoarce pachetul precedent, în companiile cu peste 20 de servere plus echipamente de rețea, acest proces funcționează deja destul de încet. Ideea este că un pachet poate lipsi, dar nu este controlat instantaneu de către administratorul de sistem. Acesta va ignora rapid acest tip de spam. Așadar, trebuie să pingăm fiecare obiect de mai multe ori înainte de a concluziona despre inaccesibilitate. Fără a intra prea mult în detalii, trebuie să facem acest proces paralel, pentru că dacă nu o facem, cel mai probabil administratorul de sistem va afla despre problemă de la client, și nu de la sistemul de monitorizare.
PHP, în sine, nu suportă multithreading din cutie. Suportă multiprocessing, se poate fork. Dar eu aveam deja un mecanism de sondare scris și îmi doream să citesc toate nodurile necesare din baza de date o singură dată, să fac ping la toate simultan, să aștept răspunsul de la fiecare și abia apoi să scriu datele. Aceasta economisește la numărul de cereri de citire. Ideea de multi-threading se încadra perfect în acest plan. Pentru PHP există modulul PThreads, care permite realizarea adevăratului multithreading, deși a fost nevoie de mult timp pentru a-l configura pe PHP 7.2, dar a fost realizat. Scanarea porturilor și pingul au devenit rapide. Și în loc de, de exemplu, 15 secunde pe tur înainte, acest proces a ajuns să dureze 2 secunde. Acesta a fost un rezultat bun.
Audit rapid al noilor companii
Cum a apărut funcționalitatea de colectare a diferitelor metrici și caracteristici ale hardware-ului? Este simplu. Uneori, primim comenzi pentru un audit al infrastructurii IT existente. De asemenea, același lucru este necesar pentru a accelera procesul de audit al unui nou client. Aveam nevoie de ceva care să ne permită să intrăm într-o companie medie sau mare și să ne orientăm rapid în legătură cu ceea ce au. Pingingul în rețeaua internă este, în opinia mea, blocat doar de cei care doresc să-și complice viața, iar aceștia, după experiența noastră, sunt puțini. Totuși, sunt și astfel de cazuri. Prin urmare, putem scana rapid rețelele pentru a detecta dispozitivele printr-un ping simplu. Apoi, le putem adăuga și scanare pentru porturile deschise, care ne interesează. Practic, această funcționalitate exista deja, era necesar doar să adăugăm o comandă de pe serverul central către cel subordonat, astfel încât acesta să scaneze rețelele specificate și să le adauge în listă pe toate cele găsite. Am uitat să menționez, se presupunea că avem deja o imagine pregătită cu sistemul configurat (serverul de monitorizare subordonat) pe care o puteam desfășura la client în timpul auditului și să-l conectăm la propriul nostru cloud.
Dar rezultatul auditului include, de obicei, o mulțime de informații variate, iar una dintre ele este - ce dispozitive există în rețea. În primul rând, ne-au interesat serverele Windows și stațiile de lucru Windows care fac parte din domeniu. Deoarece în companiile medii și mari, absența unui domeniu este probabil o excepție de la regulă. Ca să vorbim aceeași limbă, consider că o medie este de 100+ de persoane. A trebuit să găsim o metodă de a colecta date de pe toate mașinile și serverele Windows, cunoscându-le IP-ul și contul de administrator al domeniului, fără a instala un software pe fiecare dintre ele. La ajutor vine interfața WMI. Windows Management Instrumentation (WMI), tradus literal - instrumentarul de gestionare Windows. WMI este una dintre tehnologiile fundamentale pentru managementul centralizat și monitorizarea funcționării diferitelor părți ale infrastructurii computerizate în cadrul platformei Windows. Luat din wiki. Apoi, a fost din nou nevoie să ne ocupăm de colectarea wmic (clientul WMI) pentru Debian. După ce totul a fost pregătit, rămânea pur și simplu să interogăm prin wmic nodurile necesare pentru informațiile dorite. Prin WMI, putem obține aproape orice informație de pe un computer Windows, și mai mult decât atât, putem controla computerul, de exemplu, să-l trimitem în repornire. Așa a început colectarea informațiilor despre stațiile de lucru și serverele Windows în sistemul nostru. La aceasta, se adaugă și informațiile curente despre parametrii de încărcare a sistemului. Acestea sunt cerute mai des, iar informația despre hardware mai rar. După aceasta, auditul a devenit puțin mai plăcut.
Decizia de distribuire a software-ului
Noi înșine folosim sistemul zilnic, și acesta este întotdeauna deschis pentru fiecare angajat tehnic. Și ne-am gândit că putem împărtăși cu alții ceea ce avem deja. Sistemul nu era deloc pregătit pentru distribuire. Era necesar să refacem foarte multe, astfel încât versiunea locală să devină un SaaS. Acest lucru include modificări ale diferitelor aspecte tehnice ale funcționării sistemului (conexiuni la distanță, serviciul de suport), analiza modulelor pentru licențiere, shardarea bazelor de date ale clienților, scalarea fiecărui serviciu și dezvoltarea sistemelor de auto-actualizare pentru toate părțile. Dar despre aceasta va fi a doua parte a articolului.
Actualizare
Sursa: habr.com
