

În 2018, în cercurile profesionale și la conferințele tematice dedicate AI, a apărut termenul MLOps, care s-a consolidat rapid în industrie și acum se dezvoltă ca o direcție de sine stătătoare. În perspectiva viitoare, MLOps ar putea deveni unul dintre cele mai căutate domenii din IT. Ce este acesta și cu ce se consumă, aflăm în continuare.
Ce este MLOps
MLOps (combinarea tehnologiilor și proceselor de învățare automată și a abordărilor pentru implementarea modelelor dezvoltate în procesele de afaceri) este o nouă modalitate de colaborare între reprezentanții afacerilor, cercetători, matematicieni, specialiști în învățarea automată și inginerii IT în crearea sistemelor de inteligență artificială.
Cu alte cuvinte, este o modalitate de transformare a metodelor și tehnologiilor de învățare automată în unelte utile pentru soluționarea problemelor de afaceri.
Trebuie să înțelegem că lanțul de productivizare începe mult înainte de dezvoltarea modelului. Primul său pas este definirea obiectivului de afaceri, ipotezele despre valoarea care poate fi extrasă din date și idea de afaceri pentru aplicarea acesteia.
Conceptul de MLOps a apărut ca o analogie a conceptului DevOps aplicat modelelor și tehnologiilor de învățare automată. DevOps este o abordare a dezvoltării software-ului ce permite creșterea vitezei de implementare a unor modificări individuale, menținând în același timp flexibilitatea și fiabilitatea printr-o serie de metode, dintre care se numără dezvoltarea continuă, divizarea funcțiilor în microservicii independente, testarea automatizată și implementarea modificărilor individuale, monitorizarea globală a funcționării, sistemul de reacție rapidă la defecțiuni identificate etc.
DevOps a definit ciclul de viață al software-ului și în comunitatea specialiștilor a apărut ideea de a utiliza aceeași metodologie aplicată datelor mari. DataOps este o încercare de a adapta și extinde metodologia ținând cont de specificitățile stocării, transiterii și procesării unor seturi mari de date în platforme diverse și interconectate.
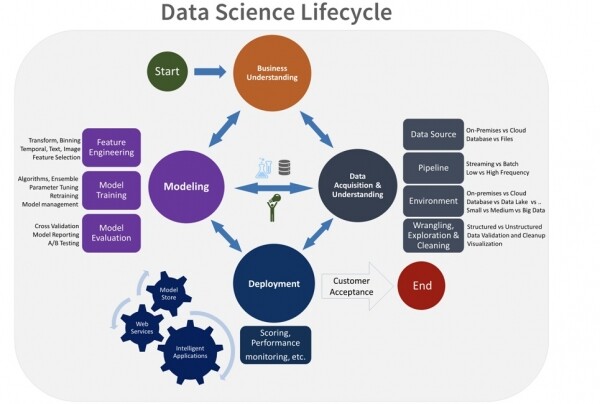
Odată cu apariția unei mase critice de modele de învățare automată integrate în procesele de afaceri ale întreprinderilor, a fost observată o asemănare puternică între ciclul de viață al modelului de învățare automată și ciclul de viață al software-ului. Diferența este că algoritmii modelului sunt creați cu ajutorul instrumentelor și metodelor de învățare automată. Prin urmare, a apărut în mod natural ideea de a aplica și adapta abordările cunoscute de dezvoltare a software-ului pentru modelele de învățare automată. Astfel, în ciclul de viață al modelelor de învățare automată se pot identifica următoarele etape cheie:
- definirea ideii de afaceri;
- antrenarea modelului;
- testarea și implementarea modelului în procesul de afaceri;
- exploatarea modelului.
Atunci când în timpul exploatării apare necesitatea de a modifica sau de a reantrena modelul pe date noi, ciclul se reia - modelul este revizuit, testat și se lansează o nouă versiune.
Dezvoltare. De ce reantrenare, nu reconstrucție? Termenul „reconstrucție a modelului” are o interpretare ambivalentă: printre specialiști, acesta semnifică un defect al modelului, atunci când modelul face predicții bune, reproducând efectiv parametrul previzibil pe setul de antrenament, dar funcționează mult mai slab pe un set extern de date. Evident, un astfel de model este considerat defect, deoarece acest defect nu îi permite utilizarea.
În acest ciclu de viață, utilizarea instrumentelor DevOps pare logică: testare automată, desfășurare și monitorizare, prezentarea calculului modelului sub formă de microservicii separate. Totuși, există și o serie de particularități care împiedică aplicarea directă a acestor instrumente fără un adaos suplimentar de ML.
Cum să facem modelele să funcționeze și să genereze profit
Ca exemplu, în care vom demonstra aplicarea abordării MLOps, să luăm o problemă clasică de automatizare a chatului de suport pentru un produs bancar (sau orice alt produs). De obicei, procesul de afaceri de suport prin chat arată în felul următor: clientul introduce un mesaj cu o întrebare în chat și primește un răspuns de la specialist în cadrul unui arbore de dialoguri prestabilit. Sarcina automatizării acestui chat este, de obicei, rezolvată prin seturi de reguli definite de experți, care sunt foarte laborioase de dezvoltat și întreținut. Eficiența unei astfel de automatizări, în funcție de complexitatea sarcinii, poate atinge 20–30%. Evident, apare ideea că este mai profitabil să implementăm un modul de inteligență artificială — un model dezvoltat prin învățare automată, care:
- este capabil să proceseze fără participarea operatorului un număr mai mare de solicitări (în funcție de subiect, în unele cazuri eficiența poate ajunge la 70–80%);
- se adaptează mai bine la formulări neobișnuite în dialog — știe să determine intentia, dorința reală a utilizatorului dintr-o solicitare formulată neclar;
- știe să determine când răspunsul modelului este adecvat și când, având în vedere 'conștiența' acestui răspuns, există îndoieli și trebuie să pună o întrebare suplimentară de clarificare sau să se îndrepte către operator;
- poate fi îmbunătățită automat (în locul unui grup de dezvoltatori care adaptează și corectează constant scenariile de răspuns, modelul este perfecționat de un specialist în Data Science, folosind bibliotecile corespunzătoare de învățare automată).
Cum putem face un astfel de model avansat să funcționeze?
Așa cum se întâmplă cu orice altă problemă, înainte de a dezvolta un astfel de modul, este necesar să definim procesul de afaceri și să descriem formal sarcina specifică pe care o vom rezolva cu ajutorul metodei de învățare automată. Acest punct marchează începutul procesului de operativizare, denumit în prescurtare Ops.
Următorul pas pentru specialistul în Data Science, în colaborare cu inginerul de date, este de a verifica disponibilitatea și suficiența datelor și a ipotezei de afaceri referitoare la viabilitatea ideii de afaceri, dezvoltând un prototip al modelului și testând efectiv eficiența acestuia. Numai după confirmarea de către afacere se poate începe tranziția de la dezvoltarea modelului la integrarea acestuia în sistemele care execută un proces de afaceri specific. Planificarea implementării de la un capăt la altul, o înțelegere profundă la fiecare etapă a modului în care modelul va fi utilizat și a efectului economic pe care îl va aduce, reprezintă un punct fundamental în procesele de implementare a abordărilor MLOps în peisajul tehnologic al companiei.
Odată cu dezvoltarea tehnologiilor AI, numărul și diversitatea sarcinilor care pot fi rezolvate prin învățarea automată cresc exponențial. Fiecare astfel de proces de afaceri reprezintă o economie pentru companie datorită automatizării muncii angajaților din funcții de masă (centru de apeluri, verificarea și clasificarea documentelor etc.), extinderea bazei de clienți prin adăugarea de funcții noi atrăgătoare și convenabile, economisirea de fonduri prin utilizarea optimă și redistribuirea resurselor și multe altele. În cele din urmă, orice proces este orientat spre crearea de valoare și, ca urmare, ar trebui să aducă un anumit efect economic. Aici este foarte important să formulăm clar idea de afaceri și să calculăm profitul estimat din implementarea modelului în structura generală de creare a valorii companiei. Se întâmplă situații în care implementarea modelului nu se justifică, iar timpul petrecut de specialiștii în învățarea automată costă mult mai mult decât un loc de muncă pentru un operator care îndeplinește această sarcină. De aceea, astfel de cazuri trebuie identificate la etapele timpurii de creare a sistemelor AI.
Prin urmare, profitul modelului începe să apară doar atunci când în procesul MLOps a fost formulată corect sarcina de afaceri, prioritățile au fost stabilite și, în etapele timpurii de dezvoltare, a fost formulat procesul de integrare a modelului în sistem.
Un nou proces – noi provocări
O răspuns cuprinzător la întrebarea de bază a afacerii despre cât de aplicabile sunt modelele ML pentru rezolvarea problemelor, întrebarea generală a încrederii în AI — este unul dintre provocările cheie în procesul de dezvoltare și implementare a abordărilor MLOps. Inițial, afacerea percepe cu scepticism implementarea învățării automate în procese — este greu să te bazezi pe modele în locuri în care anterior, de obicei, lucrau oamenii. Pentru afaceri, programele apar ca un „black box”, relevanța răspunsurilor căruia trebuie încă dovedită. În plus, în activitatea bancară, în afacerile operatorilor de telecomunicații și în altele există cerințe stricte din partea autorităților de reglementare. Toate sistemele și algoritmii integrați în procesele bancare sunt supuși auditului. Pentru a rezolva această problemă, pentru a dovedi afacerii și reglementatorilor validitatea și corectitudinea răspunsurilor inteligenței artificiale, împreună cu modelul sunt implementate instrumente de monitorizare. În plus, există o procedură de validare independentă, obligatorie pentru modelele de reglementare, care respectă cerințele BNR. Un grup de experți independenți efectuează auditul rezultatelor obținute de model, având în vedere datele de intrare.
A doua provocare — evaluarea și gestionarea riscurilor modelului la implementarea modelului de învățare automată. Chiar dacă o persoană nu poate răspunde cu o sută la sută siguranță la întrebarea dacă rochia era albă sau albastră, inteligența artificială are de asemenea dreptul la eroare. De asemenea, trebuie avut în vedere că, de-a lungul timpului, datele se pot schimba, iar modelele trebuie să fie actualizate pentru a oferi rezultate suficient de precise. Pentru a preveni afectarea procesului de afaceri, este necesar să se gestioneze riscurile modelului și să se urmărească performanța modelului, actualizându-l periodic cu date noi.
Dar după prima etapă de neîncredere, apare efectul invers. Cu cât mai multe modele sunt implementate cu succes în procese, cu atât apetitul afacerii pentru utilizarea inteligenței artificiale crește — până la a găsi noi sarcini care pot fi rezolvate prin metode de învățare automată. Fiecare sarcină inițiază un întreg proces, necesitant diverse competențe:
- inginerii de date pregătesc și prelucrează datele;
- specialiștii în știința datelor aplică instrumente de învățare automată și dezvoltă modelul;
- IT implementează modelul în sistem;
- Inginerul ML determină cum să integreze corect acest model în proces, ce instrumente IT să folosească în funcție de cerințele modului de aplicare a modelului, ținând cont de fluxul de solicitări, timpul de răspuns etc.
- Arhitectul ML proiectează cum poate fi implementat fizic produsul software într-un sistem industrial.
Întregul ciclu necesită un număr mare de specialiști foarte calificați. La un anumit punct de dezvoltare și grad de penetrare a modelelor ML în procesele de afaceri, devine evident că scalarea liniară a numărului de specialiști în funcție de creșterea numărului de sarcini devine costisitoare și ineficientă. Prin urmare, apare întrebarea automatizării procesului MLOps - definirea unor clase standard de sarcini de învățare automată, dezvoltarea unor pipeline-uri tipice pentru procesarea datelor și recalibrarea modelului. Într-o imagine ideală, pentru rezolvarea acestor sarcini sunt necesari profesioniști care să dețină competențe la intersecția BigData, Data Science, DevOps și IT. De aceea, cea mai mare problemă din industria Data Science și cea mai mare provocare în organizarea proceselor MLOps este lipsa acestei competențe pe piața actuală de pregătire a resurselor umane. Specialiștii care îndeplinesc aceste cerințe sunt, în prezent, foarte rari pe piața muncii și sunt apreciați la preț de aur.
Despre competențe
În teorie, toate sarcinile MLOps pot fi rezolvate cu instrumente clasice DevOps, fără a recurge la o extindere specializată a modelului de roluri. Așa cum am menționat mai sus, data scientist-ul trebuie să fie nu numai matematician și specialist în analytics de date, ci și guru al întregului pipeline - responsabilitatea sa include dezvoltarea arhitecturii, programarea modelelor în mai multe limbaje în funcție de arhitectură, pregătirea vitrinei de date și implementarea aplicației. Cu toate acestea, crearea unei structuri tehnologice, realizată în cadrul procesului MLOps, necesită până la 80% din eforturile de muncă, ceea ce înseamnă că un matematician calificat, așa cum este un Data Scientist de calitate, va dedica doar 20% din timp specialității sale. Prin urmare, delimitarea rolurilor specialiștilor care implementează modele de învățare automată devine o necesitate vitală.
Cât de bine trebuie delimitate rolurile depinde de dimensiunea întreprinderii. E o situație când într-un startup există un specialist care se ocupă de tot, de inginerie și arhitectură, până la DevOps. Este cu totul altceva când într-o mare întreprindere toate procesele de dezvoltare a modelelor sunt concentrate pe câțiva specialiști de Data Science de înaltă calitate, în timp ce programatorii sau specialiștii în baze de date — competențe mai comune și mai puțin costisitoare pe piața muncii — pot prelua o mare parte din sarcinile de rutină.
Astfel, de modul în care se trasează granița în alegerea specialiștilor pentru asigurarea procesului MLOps și de cum este organizat procesul de operativizare a modelelor dezvoltate, depind direct viteza și calitatea modelelor dezvoltate, productivitatea echipei și climatul de muncă din cadrul acesteia.
Ce a fost deja realizat de echipa noastră
Nu cu mult timp în urmă am început să construim structura competențelor și proceselor MLOps. Dar deja în această etapă, proiectele noastre pentru gestionarea ciclului de viață al modelelor și pentru aplicarea modelelor ca serviciu sunt în stadiul de testare MVP.
De asemenea, am definit structura optimă de competențe și structura organizațională a interacțiunii între toți participanții la proces pentru o mare întreprindere. Au fost organizate echipe Agile care rezolvă sarcini pentru întreaga gamă de clienți de afaceri, iar procesul de interacțiune cu echipele de proiect care dezvoltă platforme și infrastructura, care este fundația clădirii MLOps, a fost îmbunătățit.
Întrebări pentru viitor
MLOps este un domeniu în dezvoltare care se confruntă cu o lipsă de competențe și care în viitor va câștiga avânt. Până atunci, cel mai bine este să ne bazăm pe experiențele și practicile DevOps. Scopul principal al MLOps este utilizarea mai eficientă a modelelor ML pentru a rezolva problemele de afaceri. Dar apar multe întrebări:
- Cum să reducem timpul necesar pentru a lansa modelele în producție?
- Cum să reducem fricțiunile birocratice între echipele cu competențe diferite și să sporim concentrarea pe colaborare?
- Cum să monitorizăm modelele, să gestionăm versiunile și să organizăm un monitorizare eficientă?
- Cum să creăm un ciclu de viață cu adevărat ciclic pentru un model ML modern?
- Cum să standardizăm procesul de învățare automată?
Răspunsurile la aceste întrebări vor determina în mare măsură cât de repede MLOps își va desfășura pe deplin potențialul.
Sursa: habr.com
