

În a doua parte a articolului despre simulatoarele sistemelor informatice, voi continua să discut într-o formă simplă și accesibilă despre simulatoarele de calculatoare, în special despre simularea pe platforme complete, cu care se confruntă cel mai adesea utilizatorul obișnuit, precum și despre modelul pe cicluri și traseele care sunt mai comune în cercurile dezvoltatorilor.
În Am explicat ce sunt simulatoarele în general, precum și despre nivelurile de modelare. Acum, pe baza acestor cunoștințe, vă propun să ne aprofundăm puțin și să discutăm despre simularea pe platforme complete, despre cum se construiesc traseele, ce se poate face cu ele și despre simularea arhitecturală pe cicluri.
Simulatorul pe platforme complete (full platform simulator) sau „Unul în câmp — nu este un războinic”
Dacă este necesar să cercetăm funcționarea unui dispozitiv specific, de exemplu, a unei plăci de rețea, sau să scriem firmware sau driver pentru acest dispozitiv, atunci acel dispozitiv poate fi modelat separat. Cu toate acestea, utilizarea acestuia în afara întregii infrastructuri nu este foarte convenabilă. Pentru a lansa driverul corespunzător, va fi necesar un procesor central, memorie, acces la magistrala de transfer de date etc. În plus, pentru funcționarea driverului este necesar un sistem de operare (SO) și un stivă de rețea. La acestea se poate adăuga și un generator de pachete separat și un server de primire a răspunsurilor.
Simulatorul pe platforme complete creează un mediu pentru rularea întregului stivă software, care include totul, de la BIOS și bootloader până la SO-ul propriu-zis și diversele sale subsisteme, cum ar fi stiva de rețea, driverele și aplicațiile de nivel utilizator. Pentru aceasta, în simulator sunt implementate modele software pentru majoritatea dispozitivelor computerului: procesor și memorie, disc, dispozitive de intrare-ieșire (tastatură, mouse, ecran), precum și placa de rețea.
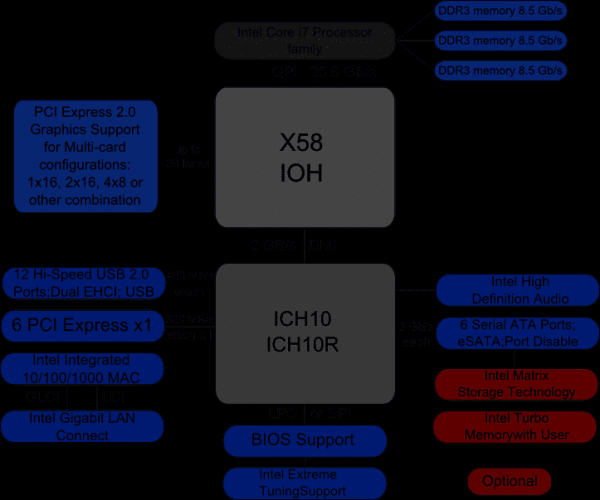
Mai jos este un diagramă a chipset-ului x58 de la Intel. În simulatorul complet al platformei pe acest chipset, este necesară implementarea majorității dispozitivelor enumerate, inclusiv a celor aflate în interiorul IOH (Input/Output Hub) și ICH (Input/Output Controller Hub), care nu sunt reprezentate în detaliu pe diagramă. Cu toate acestea, așa cum arată practica, există destul de multe dispozitive care nu sunt utilizate de software-ul pe care intenționăm să-l rulăm. Modelele acestor dispozitive ar putea să nu fie necesare.
Cel mai adesea, simulatoarele complete ale platformei sunt implementate la nivelul instrucțiunilor procesorului (ISA, vezi ). Aceasta permite crearea relativ rapidă și economică a simulatorului. Nivelul ISA este de asemenea benefic deoarece rămâne mai mult sau mai puțin constant, spre deosebire de, de exemplu, nivelul API/ABI, care se schimbă mai frecvent. În plus, implementarea la nivelul instrucțiunilor permite rularea așa-numitului software binar nemodificat, adică rularea codului deja compilat fără modificări, exact așa cum este utilizat pe hardware-ul real. Cu alte cuvinte, se poate face o copie („dump”) a hard disk-ului, se poate specifica ca imagine pentru modelul din simulatorul complet al platformei și – voilà! – OS-ul și celelalte programe se încarcă în simulator fără nicio acțiune suplimentară.
Performanța simulatoarelor
Așa cum s-a menționat mai sus, procesul de simulare a întregului sistem, adică a tuturor dispozitivelor sale, este un demers destul de lent. Dacă se implementează totul la un nivel foarte detaliat, de exemplu, la nivel de microarhitectură sau logic, atunci execuția va deveni extrem de lentă. Nivelul instrucțiunilor este o alegere adecvată și permite sistemului de operare și programelor să ruleze la viteze suficiente utilizatorului pentru o interacțiune confortabilă cu acestea.
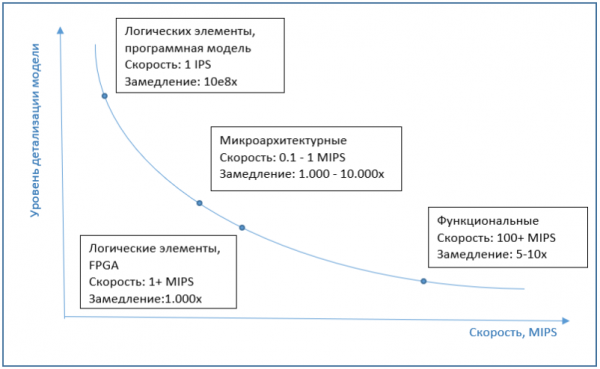
Aici este potrivit să abordăm tema performanței simulatoarelor. Aceasta este de obicei măsurată în IPS (instrucțiuni pe secundă), mai precis în MIPS (milioane IPS), adică numărul de instrucțiuni ale procesorului executate de simulator într-o singură secundă. În același timp, viteza simulării depinde și de performanța sistemului pe care funcționează simularea însăși. Așadar, poate că este mai corect să vorbim despre „încetinirea” simulatorului în comparație cu sistemul original.
Cele mai comune simulatoare complete de pe piață, precum QEMU, VirtualBox sau VmWare Workstation, oferă o performanță decentă. Pentru utilizator, este posibil să nu fie nici măcar observabil faptul că funcționarea se desfășoară într-un simulator. Acest lucru se datorează capacităților speciale de virtualizare implementate în procesoare, algoritmilor de traducere binară și altor aspecte interesante. Toate acestea sunt subiecte pentru un articol separat, dar, pe scurt, virtualizarea este o opțiune hardware a procesoarelor moderne, care permite simulatorilor să nu simuleze instrucțiuni, ci să le execute direct pe procesorul real, dacă, desigur, arhitecturile simulatorului și procesorului sunt asemănătoare. Traducerea binară este procesul de conversie a codului mașină al gazdelor în codul mașină al gazdelor și executarea ulterioară pe procesorul real. Drept urmare, simularea este doar puțin mai lentă, de aproximativ 5-10 ori, iar adesea funcționează chiar cu aceeași viteză ca sistemul real. Deși acest lucru depinde de foarte mulți factori. De exemplu, dacă dorim să simulăm un sistem cu zeci de procesoare, atunci viteza se va reduce imediat de câteva zeci de ori. Pe de altă parte, simulatoarele de tip Simics în versiuni recente suportă hardware-ul gazdelor multiprocesor și eficient împart nucleele simulate pe nucleele procesorului real.
Când vine vorba de viteza simulării microarhitecturale, aceasta este de obicei cu câteva ordine de magnitudine, aproximativ de 1000-10000 de ori, mai lentă decât execuția pe un computer obișnuit, fără simulare. Implementările la nivel de elemente logice sunt și mai lente cu câteva ordine de magnitudine. De aceea, la acest nivel, se folosesc FPGA ca emulator, ceea ce permite creșterea semnificativă a performanței.
Graficul de mai jos arată dependența aproximativă a vitezei de simulare în funcție de detalierea modelului.
Simularea pe ciclo
În ciuda vitezei de execuție relativ reduse, simulatoarele microarhitecturale sunt destul de răspândite. Modelarea blocurilor interne ale procesorului este necesară pentru a simula precis timpul de execuție al fiecărei instrucțiuni. Aici poate apărea o neînțelegere – de ce nu ar putea fi pur și simplu programat timpul de execuție pentru fiecare instrucțiune? Dar un astfel de simulator ar funcționa foarte inexact, deoarece timpul de execuție al aceleași instrucțiuni poate varia de la apel la apel.
Un exemplu simplu este instrucțiunea de acces la memorie. Dacă celula de memorie solicitată este disponibilă în cache, atunci timpul de execuție va fi minim. Dacă informația nu este prezentă în cache ("cache miss"), atunci acest lucru va crește semnificativ timpul de execuție al instrucțiunii. Astfel, pentru o simulare precisă, este necesar un model de cache. Totuși, modelul de cache nu este singurul aspect. Procesorul nu va aștepta pur și simplu să obțină datele din memorie atunci când acestea nu se află în cache. În schimb, va începe să execute următoarele instrucțiuni, alegându-le pe cele care nu depind de rezultatul citirii din memorie. Aceasta este așa-numita execuție "în afara ordinii" (OOO, out of order execution), necesară pentru a minimiza timpul de inactivitate al procesorului. Luarea în considerare a tuturor acestor aspecte la calcularea timpului de execuție al instrucțiunilor va fi ajutată de modelarea blocurilor corespunzătoare ale procesorului. Printre instrucțiunile desfășurate în timp ce se așteaptă rezultatul citirii din memorie, se poate întâlni o operațiune de salt condiționat. Dacă rezultatul evaluării condiției nu este cunoscut în acel moment, procesorul nu va opri execuția, ci face o "presupunere", executând saltul corespunzător și continuând să execute preventiv instrucțiunile de la locul saltului. Acest bloc, numit predictor de ramuri, trebuie, de asemenea, să fie implementat în simulatorul microarhitectural.
Imaginea de mai jos arată blocurile principale ale procesorului; nu este obligatoriu să le cunoști, ea este prezentată doar pentru a arăta complexitatea implementării microarhitecturale.
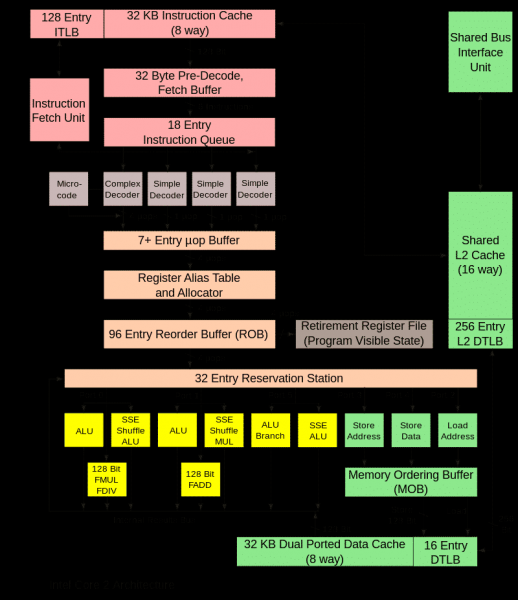
Funcționarea tuturor acestor blocuri în procesorul real este sincronizată prin semnale de ceas speciale, la fel cum se întâmplă și în model. Un astfel de simulator de microarhitectură se numește simulator de ciclu (cycle accurate). Principalul său scop este de a prezice cu exactitate performanța procesorului în dezvoltare și/sau de a calcula timpul de execuție al unei anumite programe, de exemplu, al unui benchmark. Dacă valorile vor fi sub cele necesare, va fi nevoie să se îmbunătățească algoritmii și blocurile procesorului sau să se optimizeze programul.
După cum s-a arătat mai sus, simularea pe ciclu este foarte lentă, de aceea este utilizată doar în cercetarea anumitor aspecte ale funcționării unui program, unde este necesar să se cunoască viteza reală de execuție a programelor și să se evalueze performanța viitoare a dispozitivului, prototipul căruia este modelat.
Pentru simularea restului timpului de lucru al programului se folosește un simulator funcțional. Cum se desfășoară o astfel de utilizare combinată în realitate? Mai întâi se lansează simulatorul funcțional, pe care se încarcă sistemul de operare și tot ce este necesar pentru a rula programul investigat. Deoarece nu suntem interesați nici de sistemul de operare, nici de etapele inițiale de pornire a programului, configurarea acestuia și alte detalii. Totuși, nu putem sărat aceste părți și să trecem direct la execuția programului din mijloc. Prin urmare, toate aceste etape preliminare sunt parcurse pe simulatorul funcțional. După ce programul a fost executat până în momentul de interes, sunt posibile două variante. Se poate schimba modelul cu cel pe ciclu și se poate continua execuția. Modul de simulare în care se folosește codul executabil (adică fișierele compilate obișnuite ale programelor) se numește simulare pe executare (execution driven simulation). Aceasta este cea mai răspândită variantă de simulare. Există, de asemenea, și o altă abordare – simularea bazată pe trasee (trace driven simulation).
Simularea bazată pe trasee
Aceasta constă în două pași. Cu ajutorul simulatorului funcțional sau pe un sistem real, se adună și se înregistrează într-un fișier jurnalul acțiunilor programului. Acest jurnal se numește traseu (trace). În funcție de ceea ce este investigat, traseul poate include instrucțiuni executabile, adrese de memorie, numere de porturi, informații despre întreruperi.
Următorul pas este „reproducerea” traseului, când simulatorul pe cicluri citește traseul și execută toate instrucțiunile înregistrate în acesta. La final, obținem timpul de execuție al acestei porțiuni de program, precum și diverse caracteristici ale acestui proces, de exemplu, procentajul de hit-uri în cache.
O caracteristică importantă a lucrului cu traseele este determinismul, adică, rulând simularea în modul descris mai sus, de fiecare dată reproducem aceeași secvență de acțiuni. Aceasta permite, prin modificarea parametrilor modelului (dimensiunile cache-ului, buffer-elor și coadelor) și folosind diferite algoritmi interni sau configurându-i, să investigăm cum un anumit parametru influențează performanța sistemului și care variantă oferă cele mai bune rezultate. Toate acestea pot fi realizate cu modelul prototipului dispozitivului înainte de a crea un prototip hardware real.
Complexitatea acestui demers constă în necesitatea de a rula anterior aplicația și de a colecta traseul, precum și în dimensiunea imensă a fișierului cu traseul. Printre avantaje se numără faptul că este suficient să modelăm doar partea de interes a dispozitivului sau platformei, în timp ce simularea execuției necesită, de obicei, un model complet.
Așadar, în acest articol am discutat despre particularitățile simulării complete a platformei, am vorbit despre viteza implementărilor la diferite niveluri, simularea pe cicluri și trasee. În articolul următor voi descrie principalele scenarii de utilizare a simulatoarelor, atât în scopuri personale, cât și din perspectiva dezvoltării în mari companii.
Sursa: habr.com
