

Articolul este tradus în cadrul pregătirii pentru lansarea cursului .
Cum să economisești la cheltuielile pe cloud în lucrul cu Kubernetes? Nu există o soluție unică, dar în acest articol sunt prezentate câteva instrumente care te vor ajuta să gestionezi mai eficient resursele și să reduci costurile pentru servicii cloud.
Am scris acest articol având în vedere Kubernetes pentru AWS, dar va fi aplicabil (aproape) la fel de bine și pentru alți furnizori de cloud. Presupun că clusterul(tă) tău are deja activată scalarea automată (). Eliminarea resurselor și reducerea dimensiunii deployment-ului va permite economii doar în cazul în care aceasta va duce la reducerea parcului tău de noduri de lucru (instanțe EC2).
În acest articol vor fi discutate:
- curățarea resurselor neutilizate ()
- reducerea dimensiunii în timpul neutilizării ()
- utilizarea scalării automate orizontale (HPA),
- reducerea rezervării excesive a resurselor (, VPA)
- utilizarea instanțelor Spot
Curățarea resurselor neutilizate
Lucrul într-un mediu în continuă schimbare este excelent. Vrem ca organizațiile tehnice . O livrare de software mai rapidă înseamnă, de asemenea, un număr mai mare de deployment-uri PR, medii de previzualizare, prototipuri și soluții analitice. Totul se desfășoară pe Kubernetes. Cine are timp să curețe deployment-urile de testare manual? Este ușor să uiți de eliminarea experimentului de acum o săptămână. Factura pentru cloud va crește, în cele din urmă, din cauza uitării de a închide:
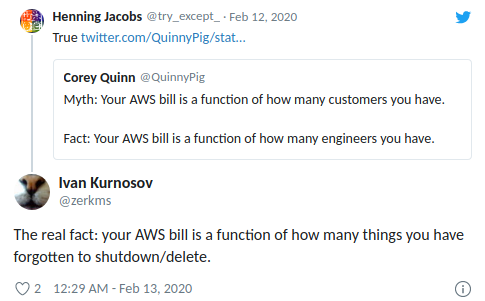
(Henning Jacobs:
Viața reală:
(citat) Cory Quinn:
Mit: Factura ta AWS depinde de numărul de utilizatori.
Fapt: Factura ta AWS depinde de numărul de ingineri.
Ivan Kurnosov (în răspuns):
Fapt real: Factura ta AWS depinde de numărul de lucruri pe care ai uitat să le oprești/elimin
(kube-janitor) ajută la curățarea clusterului tău. Configurarea janitor-ului este flexibilă atât pentru utilizarea globală, cât și pentru cea locală:
- Regulile generale pentru întregul cluster pot determina timpul maxim de viață (TTL - time-to-live) pentru deployment-uri PR/test.
- Resursele individuale pot fi annotate folosind janitor/ttl, de exemplu, pentru ștergerea automată a spike/prototipului după 7 zile.
Regulile generale sunt definite într-un fișier YAML. Calea sa este transmisă prin parametrul --rules-file în kube-janitor. Iată un exemplu de regulă pentru ștergerea tuturor spațiilor de nume care conțin -pr- în nume după două zile:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Următorul exemplu reglementează utilizarea etichetei application pe podurile Deployment și StatefulSet pentru toate noile Deployments/StatefulSet din anul 2020, dar în același timp permite desfășurarea testelor fără această etichetă timp de o săptămână:
- id: require-application-label
  # șterge deployments și statefulsets fără eticheta "application"
  resources:
    - deployments
    - statefulsets
  # vezi http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Lansarea unei demo cu limită de timp de 30 de minute în clusterul unde rulează kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
O altă sursă a costurilor în creștere sunt volumele persistente (AWS EBS). Când se șterge un StatefulSet Kubernetes, volumele sale persistente (PVC - PersistentVolumeClaim) nu sunt șterse. Volumele EBS nefolosite pot duce ușor la costuri de sute de dolari pe lună. Kubernetes Janitor are o funcție pentru curățarea PVC-urilor nefolosite. De exemplu, această regulă va șterge toate PVC-urile care nu sunt montate de modul și la care nu face referire StatefulSet sau CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor vă poate ajuta să mențineți clusterul „curat” și să preveniți acumularea treptată de costuri în cloud. Urmați instrucțiunile pentru desfășurare și configurare din .
Reducerea scalării în afara programului de lucru
Sistemele de testare și intermediare sunt, de obicei, necesare doar în timpul programului de lucru. Unele aplicații de producție, cum ar fi backend-ul / instrumentele de administrare, necesită, de asemenea, doar disponibilitate limitată și pot fi oprite noaptea.
(kube-downscaler) permite utilizatorilor și operatorilor să reducă scalarea sistemului în afara orelor de lucru. Deployments și StatefulSets pot fi scalate până la zero replici. CronJobs pot fi suspendate. Kubernetes Downscaler este configurabil pentru întregul cluster, pentru unul sau mai multe namespaces sau resurse individuale. Se poate seta fie „timp de nefuncționare”, fie dimpotrivă „timp de funcționare”. De exemplu, pentru a minimiza scalarea în timpul nopții și în weekenduri:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # nu suspenda componentele infrastructurii
  - --exclude-namespaces=kube-system,infra
  # nu suspenda kube-downscaler și lasă Postgres Operator, astfel încât bazele de date excluse să poată fi gestionate
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Iată un grafic de scalare a nodurilor de lucru ale clusterului în weekend:
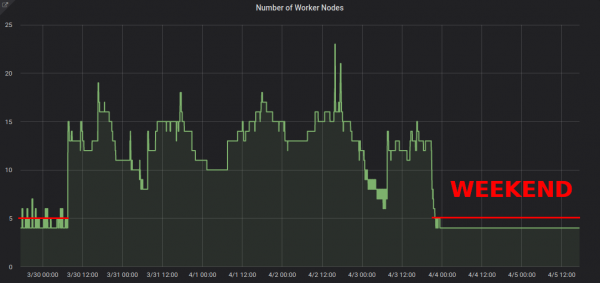
Reducerea numărului de la ~13 la 4 noduri de lucru face cu adevărat o diferență notabilă în factura AWS.
Dar ce se întâmplă dacă trebuie să lucrez în „timpul de nefuncționare” al clusterului? Anumite deployments pot fi excluse permanent din scalare prin adăugarea unei anotări downscaler/exclude: true. Deployments pot fi excluse temporar folosind anotarea downscaler/exclude-until cu un timestamp absolut în formatul AAAA-MM-ZZ HH:MM (UTC). Dacă este necesar, întregul cluster poate fi scalat înapoi prin desfășurarea unui pod cu anotarea downscaler/force-uptime, de exemplu, prin rularea unui nginx placeholder:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # șterge deploymentul după o oră
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Vedeți , dacă ești interesat de instrucțiuni de desfășurare și opțiuni suplimentare.
Folosește autoscalarea orizontală
Multe aplicații/servicii se confruntă cu un model dinamic de încărcare: uneori modulele lor stau inactive, iar alteori acestea rulează la capacitate maximă. Munca cu un parc constant de poduri pentru a face față sarcinilor de vârf nu este economică. Kubernetes suportă scalarea automată orizontală prin resursa (HPA). Utilizarea CPU-ului este adesea un indicator bun pentru scalare:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando a creat un component pentru integrarea simplă a metricilor personalizate pentru scalare: (kube-metrics-adapter) este un adaptor de metrici universal pentru Kubernetes, care poate colecta și furniza metrici personalizate și externe pentru scalarea orizontală a podurilor. Acesta suportă scalarea pe baza metricilor Prometheus, cozi SQS și alte configurări. De exemplu, pentru a scala o desfășurare pe baza unei metrici personalizate furnizate de aplicație sub formă de JSON în /metrics utilizați:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Configurarea scalării orizontale cu ajutorul HPA ar trebui să fie una dintre acțiunile implicite pentru a spori eficiența pentru servicii fără stare. Spotify are o prezentare a experienței și recomandărilor lor pentru HPA: .
Reducerea rezervării excesive a resurselor
Sarcinile de lucru Kubernetes își definesc nevoile de CPU/memorie prin "cerințele de resurse". Resursele CPU sunt măsurate în nuclee virtuale sau mai frecvent în „milicore” (milicores), de exemplu, 500m înseamnă 50% vCPU. Resursele de memorie sunt măsurate în octeți și se pot folosi sufixe obișnuite, cum ar fi 500Mi, ceea ce înseamnă 500 megabaiți. Cerințele de resurse „blochează” volumul pe nodurile de lucru, ceea ce înseamnă că un modul cu cerințe CPU de 1000m pe un nod cu 4 vCPU va lăsa doar 3 vCPU disponibili pentru alte module.
Slack (rezervă excesivă) — aceasta este diferența dintre resursele solicitate și utilizarea reală. De exemplu, un pod care solicită 2 GiB de memorie, dar folosește doar 200 MiB, are ~ 1,8 GiB de „memorie excesivă”. Excesul costă bani. Se poate estima brut că 1 GiB de memorie excesivă costă ~ 10 dolari pe lună.
(kube-resource-report) afișează rezervele excesive și poate ajuta să determinați potențialul de economisire:
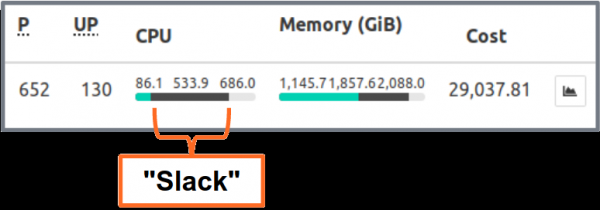
arată excesul, agregat pe aplicație și echipă. Aceasta permite găsirea locurilor unde cererile de resurse pot fi reduse. Raportul HTML generat oferă doar un instantaneu al utilizării resurselor. Trebuie să analizați utilizarea CPU/memorie în timp pentru a determina cererile adecvate de resurse. Iată un grafic Grafana pentru un serviciu „tipic” cu o mare încărcare a CPU: toate podurile folosesc semnificativ mai puțin de 3 nuclee de CPU solicitate:
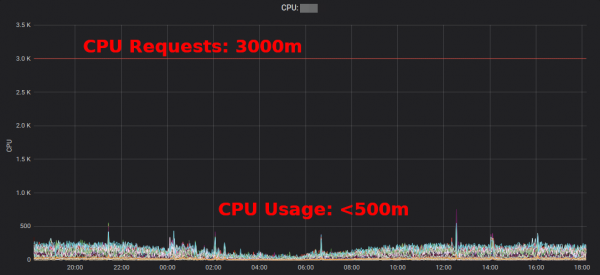
Reducerea cererii CPU de la 3000m la ~400m eliberează resurse pentru alte sarcini de lucru și permite micșorarea clusterei.
„Utilizarea medie a CPU-urilor EC2 fluctuează adesea în intervale de procente unice”, — . În timp ce pentru EC2 , modificarea anumitor cereri de resurse Kubernetes în fișierul YAML se face ușor și poate aduce economii uriașe.
Dar chiar vrem ca oamenii să schimbe valorile în fișierele YAML? Nu, mașinile pot face asta mult mai bine! Kubernetes (VPA) tocmai asta face: adaptează cererile de resurse și limitele conform sarcinii de lucru. Iată un exemplu de grafic ale cererilor de CPU Prometheus (linia albastră subțire), adaptate de VPA în timp:
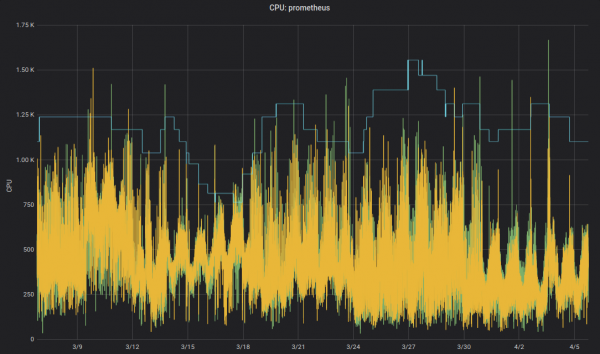
pentru componentele de infrastructură. Aplicațiile non-critice pot folosi, de asemenea, VPA.
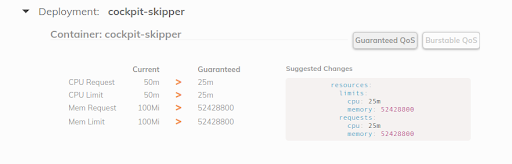
de la Fairwind — este un instrument care creează VPA pentru fiecare desfășurare în spațiul de nume și apoi afișează recomandarea VPA pe tabloul său de bord. Acesta poate ajuta dezvoltatorii să stabilească cererile corecte de procesor/memorie pentru aplicațiile lor:
Am scris un mic în 2019, și recent în .
Utilizarea instanțelor EC2 Spot
În cele din urmă, nu mai puțin important, costurile AWS EC2 pot fi reduse utilizând instanțe Spot ca noduri de lucru Kubernetes. . Instanțele Spot sunt disponibile cu discount de până la 90% în comparație cu prețurile la cerere. Rularea Kubernetes pe EC2 Spot este o combinație bună: trebuie să specificați mai multe tipuri diferite de instanțe pentru o disponibilitate mai mare, adică puteți obține un nod mai mare la același preț sau la un preț mai mic, iar capacitatea crescută poate fi utilizată de sarcinile de lucru containerizate Kubernetes.
Cum să rulați Kubernetes pe EC2 Spot? Există câteva opțiuni: utilizați un serviciu terț, cum ar fi SpotInst (acum se numește „Spot”, nu mă întrebați de ce), sau adăugați pur și simplu un Spot AutoScalingGroup (ASG) în clusterul dvs. De exemplu, iată un fragment CloudFormation pentru un Spot ASG „optimizat pentru capacitate” cu mai multe tipuri de instanțe:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Câteva observații referitoare la utilizarea Spot cu Kubernetes:
- Trebuie să gestionați finalizările Spot, de exemplu, prin drenarea nodului la oprirea instanței.
- Zalando utilizează automașcalingul oficial al clusterului cu priorități pentru piscinele de noduri.
- Nodurile Spot pentru a accepta „înregistrările” sarcinilor de lucru pentru a rula în Spot.
Rezumat
Sper că veți găsi unele dintre instrumentele prezentate utile pentru a reduce factura dvs. de cloud computing. Puteți găsi cea mai mare parte a conținutului articolului, de asemenea, în .
Care sunt cele mai bune practici pentru economisirea costurilor cloud pe Kubernetes? Vă rog să-mi spuneți pe .
De fapt, mai puțin de 3 CPU virtuali vor rămâne utilizabili, deoarece capacitatea de rețea a nodului scade din cauza resurselor sistemice rezervate. Kubernetes distinge între capacitatea fizică a nodului și resursele „alocate” ().
Exemplu de calcul: o instanță m5.large cu 8 GiB memorie costă aproximativ ~84 de dolari pe lună (eu-central-1, On-Demand), adică blocarea 1/8 din nod costă aproximativ ~10 dolari pe lună.
Există multe alte modalități de areduce costul EC2, cum ar fi instanțele rezervate, planul de economii etc. — nu voi discuta aceste subiecte aici, dar trebuie neapărat să te informezi despre ele!
Sursa: habr.com
