

Structurarea datelor nestructurate cu ajutorul GROK
Dacă utilizați stiva Elastic (ELK) și sunteți interesat de potrivirea jurnalelor personalizate Logstash cu Elasticsearch, acest articol este pentru dumneavoastră.
Stiva ELK este un acronim pentru trei proiecte open source: Elasticsearch, Logstash și Kibana. Împreună formează o platformă de gestionare a jurnalelor.
- Elasticsearch – este un sistem de căutare și analiză.
- Logstash – este un conector de server care procesează date din mai multe surse simultan, le transformă și apoi le trimite într-un "depozit", cum ar fi Elasticsearch.
- Kibana permet utilizatorilor să vizualizeze datele prin diagrame și grafice în Elasticsearch.
Beats a apărut ulterior și este un agent ușor de transport al datelor. Introducerea Beats a transformat stiva Elk în Elastic Stack, dar aceasta nu este esențială.
Acest articol se concentrează asupra Grok, care este o funcție în Logstash ce poate transforma jurnalele dumneavoastră înainte de a fi trimise la depozit. În scopurile noastre, voi vorbi doar despre procesarea datelor din Logstash în Elasticsearch.
Grok este un filtru în Logstash care este utilizat pentru a analiza datele nestructurate în ceva structurat și interogabil. Se află deasupra expresiilor regulate (regex) și folosește șabloane de text pentru a potrivi stringuri din fișierele de jurnal.
După cum vom vedea în secțiunile următoare, utilizarea Grok este esențială atunci când vine vorba de gestionarea eficientă a jurnalelor.
Fără Grok, datele dumneavoastră de jurnal sunt nestructurate
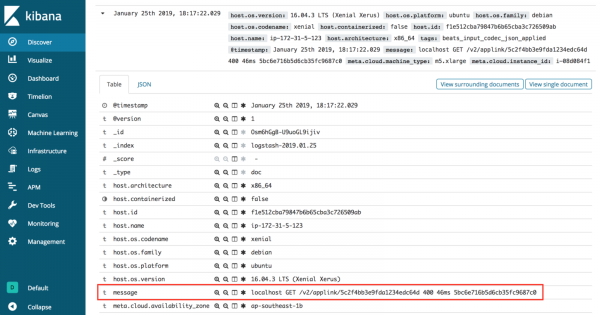
Fără Grok, când jurnalele sunt trimise din Logstash în Elasticsearch și vizualizate în Kibana, apar doar în valoarea mesajului.
Interogarea informațiilor semnificative în această situație este îngreunată, deoarece toate datele jurnalului sunt păstrate într-o singură cheie. Ar fi fost mai bine dacă mesajele jurnalului erau organizate mai bine.
Date nestructurate din jurnale
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Dacă vă uitați atent la datele brute, veți observa că acestea sunt de fapt compuse din părți diferite, fiecare separată printr-un spațiu.
Pentru dezvoltatori mai experimentați, probabil că puteți deduce ce înseamnă fiecare dintre părți și că acesta este un mesaj de jurnal dintr-un apel API. Reprezentarea fiecărei părți este prezentată mai jos.
Aspectul structurat al datelor noastre
- localhost == mediu
- GET == metodă
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == stare_răspuns
- 46ms == timp_răspuns
- 5bc6e716b5d6cb35fc9687c0 == id_utilizator
După cum vedem în datele structurale, există o ordine pentru jurnalele nestructurate. Pasul următor este prelucrarea programatică a datelor brute. Aici Grok strălucește.
Șabloane Grok
Logstash vine cu peste 100 de șabloane încorporate pentru structurarea datelor nestructurate. Ar trebui să profitați de acest avantaj ori de câte ori este posibil pentru jurnalele sistemului, cum ar fi apache, linux, haproxy, aws și altele.
Cu toate acestea, ce se întâmplă atunci când aveți jurnale personalizate, precum în exemplul de mai sus? Trebuie să construiți propriul șablon Grok.
Șabloane Grok personalizate
Trebuie să experimentați pentru a construi propriul șablon Grok. Am folosit
Debugger Grok și .
%{SYNTAX:SEMANTIC} Primul lucru pe care am încercat să-l fac este să navighez la tabul
Discover în debuggerul Grok. M-am gândit că ar fi grozav dacă acest instrument ar putea genera automat un șablon Grok, dar nu a fost prea folositor, deoarece a găsit doar două potriviri. Folosind această descoperire, am început să creez propriul meu șablon în debuggerul Grok, folosind sintaxa găsită pe pagina Github Elastic.
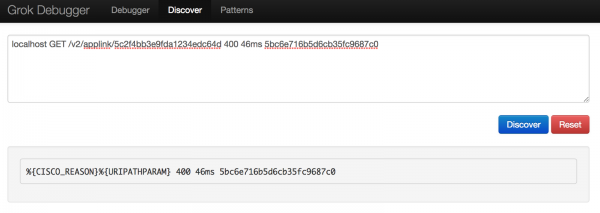
Jucându-mă cu diferite sintaxe, în cele din urmă am reușit să structurez datele jurnalului așa cum mi-am dorit.
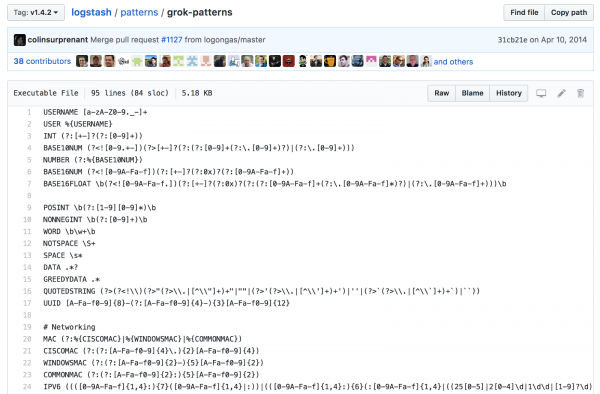
Link către debuggerul Grok
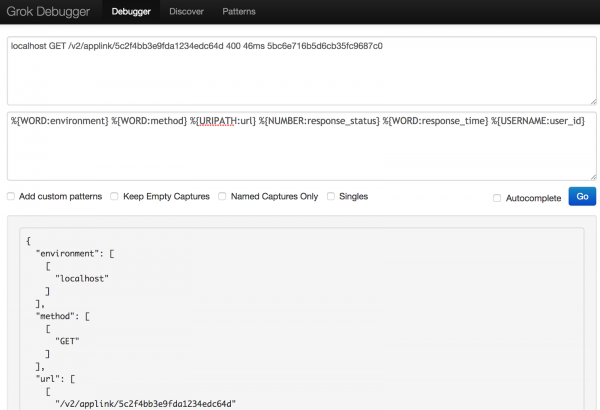
Text original:
Model:
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}
Ceea ce am obținut în cele din urmă{ "environment": [ [ "localhost" ] ], "method": [ [ "GET" ] ], "url": [ [ "/v2/applink/5c2f4bb3e9fda1234edc64d" ] ], "response_status": [ [ "400" ] ], "BASE10NUM": [ [ "400" ] ], "response_time": [ [ "46ms" ] ], "user_id": [ [ "5bc6e716b5d6cb35fc9687c0" ] ] }
Având în mână șablonul Grok și datele corelate, ultimul pas este să-l adăugați în Logstash.Actualizarea fișierului de configurare Logstash.conf
Pe serverul pe care ați instalat stiva ELK, accesați configurația Logstash:
sudo vi /etc/logstash/conf.d/logstash.conf
Introduceți modificările.input { file { path => "/your_logs/*.log" } } filter{ grok { match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"} } } output { elasticsearch { hosts => [ "localhost:9200" ] } }
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
După salvarea modificărilor, reporniți Logstash și verificați starea acestuia pentru a vă asigura că funcționează în continuare.
sudo service logstash restart
sudo service logstash status
În cele din urmă, pentru a vă asigura că modificările au fost aplicate, asigurați-vă că actualizați indexul Elasticsearch pentru Logstash în Kibana!
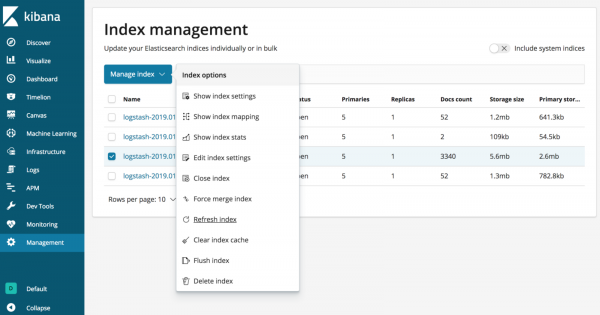
Cu Grok, datele dvs. din jurnale sunt structurate!
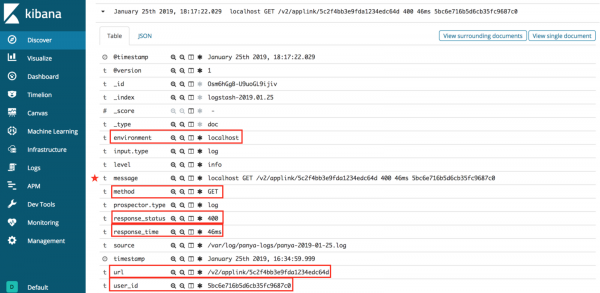
Așa cum vedem în imaginea de mai sus, Grok este capabil să potrivească automat datele din jurnal cu Elasticsearch. Acest lucru facilitează gestionarea jurnale și cererea rapidă de informații. În loc să căutați în fișierele jurnal pentru depanare, puteți pur și simplu să filtrați ceea ce căutați, cum ar fi mediu sau URL.
Încercați să oferiți o șansă expresiilor Grok! Dacă aveți o altă modalitate de a face acest lucru sau aveți întrebări cu privire la exemplele de mai sus, vă rog, lăsați un comentariu mai jos pentru a-mi spune.
Mulțumesc pentru lectură — și, vă rog, urmăriți-mă aici, pe Medium, pentru articole mai interesante despre ingineria software!
Resurse
P.S
Canal Telegram despre
Sursa: habr.com
