

Din 2019, în Rusia este în vigoare o lege privind etichetarea obligatorie. Legea nu se aplică tuturor categoriilor de produse, iar termenele de implementare a etichetării obligatorii variază pentru diferitele grupuri de produse. Primele produse care intră sub incidența acestei reglementări sunt tutunul, încălțămintea și medicamentele, iar ulterior vor fi adăugate și alte produse, cum ar fi parfumurile, textilele și laptele. Această inovație legislativă a stimulat dezvoltarea de noi soluții IT care vor permite urmărirea întregii lanțuri de viață a produsului, de la producție până la achiziția finală de către consumator, pentru toți participanții la proces: atât statul, cât și toate organizațiile care vând produse cu etichetare obligatorie.
În cadrul H5, sistemul care va urmări produsele etichetate și va schimba date cu statul și furnizorii se numește „Marcus”. Vă vom explica în ordinea corectă cum și cine l-a dezvoltat, ce tehnologie folosește și de ce avem motive de mândrie.
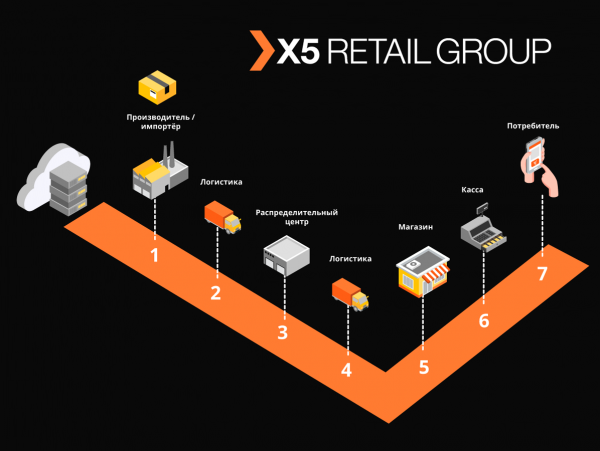
Adevărat HighLoad
„Marcus” rezolvă numeroase probleme, cea mai importantă fiind interacțiunea de integrare între sistemele informaționale H5 și sistemul informatic de stat pentru produsele etichetate (GIS MP) pentru a urmări mișcarea produselor etichetate. De asemenea, platforma stochează toate codurile de etichetare primite și întreaga istorie a mișcărilor acestor coduri între obiecte, ajutând la eliminarea confuziei în ceea ce privește produsele etichetate. De exemplu, în cazul produselor din tutun, care fac parte din primele grupuri de produse etichetate, doar un camion de țigări conține aproximativ 600.000 de pachete, fiecare având un cod unic. Sarcina sistemului nostru este să urmărească și să verifice legalitatea mișcărilor fiecărui pachet între magazine și depozite, și, în cele din urmă, să verifice permisiunea de vânzare a acestora către consumatorul final. În fiecare oră, înregistrăm aproximativ 125.000 de operațiuni de casă, iar fiecare pachet trebuie să fie înregistrat cum a ajuns în magazin. Prin urmare, având în vedere toate mișcările între obiecte, ne așteptăm la zeci de miliarde de înregistrări pe an.
Echipa M
Deși „Markus” este considerat un proiect în cadrul H5, acesta este realizat printr-o abordare de tip produs. Echipa lucrează după metodologia Scrum. Proiectul a început în vara anului trecut, dar primele rezultate au venit abia în octombrie — a fost complet constituită o echipă dedicată, a fost dezvoltată arhitectura sistemului și achiziționate echipamentele. Acum echipa are 16 membri, dintre care șase se ocupă cu dezvoltarea backend și frontend, iar trei cu analiza sistemului. Alte șase persoane se ocupă de testarea manuală, de stres și de automatizare, precum și de suportul produsului. În plus, avem un specialist SRE.
Codul în echipa noastră este scris nu doar de dezvoltatori, practic toți colegii știu să programeze și scriu teste automate, scripturi de stres și scripturi de automatizare. Acordăm o atenție deosebită acestui aspect, deoarece chiar și suportul produsului necesită un nivel înalt de automatizare. Colegilor care nu au programat anterior, încercăm întotdeauna să le sugerăm și să îi ajutăm, oferindu-le sarcini mici de lucru.
În contextul pandemiei de coronavirus, am mutat întreaga echipă în regim de muncă la distanță, disponibilitatea tuturor instrumentelor pentru gestionarea dezvoltării, fluxul de lucru construit în Jira și GitLab au permis trecerea ușoară prin acest etapă. Lunile petrecute în regim de telemuncă au dovedit că productivitatea echipei nu a fost afectată, pentru mulți confortul muncii s-a îmbunătățit, singurul lucru care lipsește este interacțiunea față în față.
Întâlnirea echipei înainte de telemuncă
Întâlniri în timpul telemuncii
Tehnologiile utilizate în soluție
Repository-ul standard și instrumentul CI/CD pentru H5 este GitLab. Îl folosim pentru stocarea codului, testarea continuă, desfășurarea pe servere de testare și de producție. De asemenea, practicăm revizuirea codului, în care cel puțin doi colegi trebuie să aprobe modificările aduse de dezvoltator în cod. Analizatorii statici de cod SonarQube și JaCoCo ne ajută să menținem codul curat și să asigurăm nivelul necesar de acoperire cu teste unitare. Toate modificările din cod trebuie să treacă neapărat prin aceste verificări. Toate scenariile de testare care sunt rulate manual sunt ulterior automatizate.
Pentru a îndeplini cu succes procesele de afaceri ale „Markus”, a trebuit să rezolvăm o serie de probleme tehnologice, pe fiecare pe rând.
Sarcina 1. Necesitatea scalabilității orizontale a sistemului
Pentru a aborda această problemă, am ales o abordare arhitecturală bazată pe microservicii. A fost foarte important să înțelegem domeniile de responsabilitate ale serviciilor. Am încercat să le împărțim pe operațiuni de afaceri, având în vedere specificitatea proceselor. De exemplu, recepția în depozit este o operațiune rară, dar foarte voluminoasă, în cadrul căreia trebuie să obținem cât mai repede informații de la regimul de stat despre unitățile de produs recepționate, al căror număr într-o livrare poate ajunge până la 600000, să verifice acceptabilitatea recepției acestor bunuri în depozit și să transmită toate informațiile necesare sistemului de automatizare a depozitului. În schimb, expedierea din depozite are o intensitate mult mai mare, dar operează cu volume de date mai mici.
Toate serviciile le implementăm conform principiului stateless și chiar și operațiunile interne încercăm să le împărțim în pași, folosind, așa cum le numim noi, self-topic-uri Kafka. Acest lucru îi permite microserviciului să trimită un mesaj lui însuși, ceea ce permite echilibrarea încărcării pe operațiunile mai intensive din punct de vedere al resurselor și simplifică întreținerea produsului, dar despre asta mai târziu.
Am decis să separăm modulele de interacțiune cu sistemele externe în servicii distincte. Acest lucru a permis rezolvarea problemei API-urilor externe care se schimbă frecvent, practic fără a afecta serviciile cu funcționalitate de afaceri.
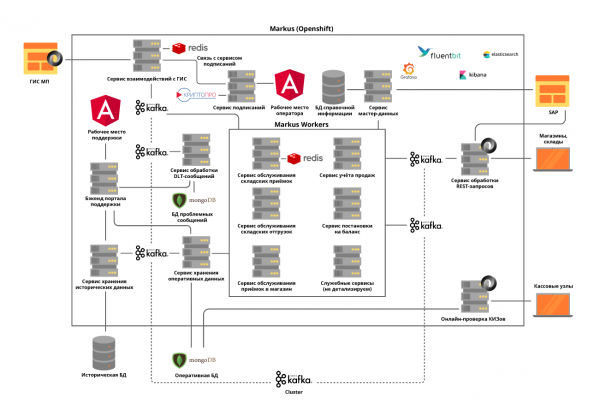
Toate microserviciile sunt desfășurate în clusterul OpenShift, care rezolvă atât problema scalabilității fiecărui microserviciu, cât și ne permite să nu folosim instrumente externe de descoperire a serviciilor.
Sarcina 2. Necesitatea de a menține o încărcare ridicată și un schimb de date foarte intens între serviciile platformei: doar în faza de lansare a proiectului se realizează aproximativ 600 de operațiuni pe secundă. Ne așteptăm ca această valoare să crească până la 5000 ops/sec pe măsură ce obiectivele comerciale se conectează la platforma noastră.
Această problemă a fost rezolvată prin desfășurarea unui cluster Kafka și practic renunțarea completă la interacțiunea sincronă între microserviciile platformei. Acest lucru necesită o analiză foarte atentă a cerințelor sistemului, deoarece nu toate operațiunile pot fi asincrone. De asemenea, nu ne limităm la transmiterea evenimentelor prin broker, ci transmitem în mesaj toate informațiile de afaceri necesare. Astfel, dimensiunea mesajului poate ajunge la câteva sute de kilobytes. Limitarea volumului mesajelor în Kafka ne obligă la o prognoză precisă a dimensiunii mesajelor, iar, dacă este necesar, le împărțim, însă această împărțire este logică și legată de operațiunile de afaceri.
De exemplu, un produs care sosește cu mașina, îl împărțim pe cutii. Pentru operațiunile sincronizate sunt alocate microservicii separate și se efectuează teste de încărcare riguroase. Utilizarea Kafka ne-a pus în fața unei alte provocări — verificarea funcționării serviciului nostru cu integrarea Kafka face ca toate testele unitare să fie asincrone. Această problemă a fost soluționată prin scrierea unor metode utilitare proprii folosind Embedded Kafka Broker. Aceasta nu anulează necesitatea de a scrie teste unitare pentru metodele separate, dar pentru cazurile complexe preferăm să testăm folosind Kafka.
Am acordat multă atenție trasării jurnalelor, astfel încât TraceId-urile lor să nu se piardă în cazul apariției unor excepții în timpul funcționării serviciilor sau în timpul lucrului cu Kafka batch. Și dacă la prima problemă nu au apărut întrebări speciale, în al doilea caz am fost nevoiți să înregistrăm în jurnal toate TraceId-urile cu care a sosit batch-ul și să alegem unul pentru continuarea trasării. Astfel, prin căutarea după TraceId-ul inițial, utilizatorul va descoperi cu ușurință cu ce a continuat trasarea.
Sarcina 3. Necesitatea stocării unui volum mare de date: peste 1 miliard de etichete pe an doar pentru tutun ajunge la X5. Acestea necesită acces constant și rapid. Sistemul trebuie să proceseze aproximativ 10 miliarde de înregistrări privind istoricul mișcărilor de produse etichetate.
Pentru a rezolva a treia sarcină, a fost aleasă baza de date NoSQL MongoDB. Am construit un shard din 5 noduri și în fiecare nod există un Replica Set din 3 servere. Acest lucru permite scalarea orizontală a sistemului, adăugând servere noi în cluster și a asigura reziliența acesteia. Aici ne-am confruntat cu o altă problemă – asigurarea tranzacționalității în clusterul Mongo ținând cont de utilizarea microserviciilor scalabile orizontal. De exemplu, una dintre sarcinile sistemului nostru este de a detecta încercările de revânzare a produselor cu același cod de identificare. Aici apar suprapunerile cu scanări greșite sau cu operațiuni eronate ale casierilor. Am descoperit că astfel de dubluri pot apărea atât în cadrul unui lot Kafka procesat, cât și în cadrul a două loturi procesate în paralel. Prin urmare, verificarea existenței dublurilor prin interogarea bazei de date nu aducea rezultate. Pentru fiecare dintre microservicii am abordat problema separat, bazându-ne pe logica de afaceri a acestui serviciu. De exemplu, pentru bonuri am adăugat o verificare în cadrul lotului și o procesare separat pentru a detecta dublurile la inserție.
Pentru a ne asigura că activitatea utilizatorilor cu istoricul operațiunilor nu influențează esențialul – funcționarea proceselor noastre de afaceri, toate datele istorice le-am separat într-un serviciu distinct cu o bază de date proprie, care primește, de asemenea, informații prin Kafka. Astfel, utilizatorii interacționează cu un serviciu izolat, fără a afecta serviciile care procesează datele operațiunilor curente.
Sarcina 4. Reprocesarea cozii și monitorizarea:
În sistemele distribuite, inevitabil apar probleme și erori de accesibilitate a bazelor de date, cozii, surselor externe de date. În cazul „Markus”, sursa acestor erori este integrarea cu sistemele externe. A fost necesar să găsim o soluție care să permită retrimiteri pentru răspunsurile eronate cu un anumit timeout definit, dar să nu întrerupă procesarea cererilor reușite în coada principală. Pentru aceasta a fost aleasă așa-numita concept “retry bazat pe topic”. Pentru fiecare topic principal se creează unul sau mai multe topicuri de retry, unde sunt trimise mesajele eronate și se elimină întârzierea în procesarea mesajelor din topicul principal. Schema de interacțiune —
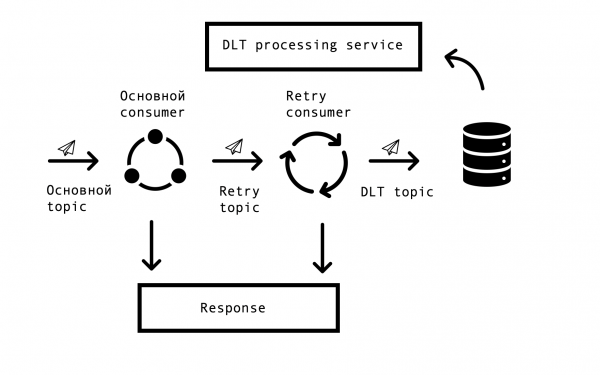
Pentru a implementa acest sistem, aveam nevoie de următoarele — integrarea acestei soluții cu Spring și evitarea duplicării codului. Pe internet am întâlnit o soluție similară, bazată pe Spring BeanPostProcessor, dar ni s-a părut prea greoaie. Echipa noastră a realizat o soluție mai simplă, care permite integrarea în ciclul de creare a consumer-ului din Spring și adăugarea suplimentară de Retry Consumer-i. Prototipul soluției noastre a fost propus echipei Spring, pe care îl puteți viziona . Numărul de Retry Consumer-i și numărul de încercări ale fiecărui consumer este configurabil prin parametri, în funcție de nevoile procesului de afaceri, și, pentru ca totul să funcționeze, trebuie doar să adăugați binecunoscuta anotare org.springframework.kafka.annotation.KafkaListener, folosită de toți dezvoltatorii Spring.
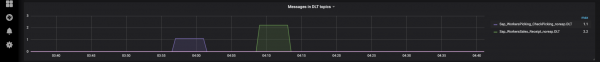
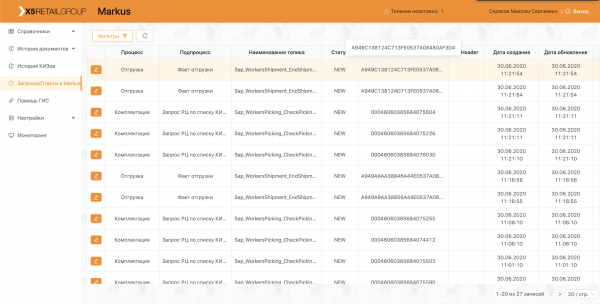
În cazul în care mesajul nu a putut fi procesat după toate încercările de retry, acesta ajunge în DLT (dead letter topic) cu ajutorul Spring DeadLetterPublishingRecoverer. La cererea suportului, am extins această funcționalitate și am creat un serviciu separat care permite vizualizarea mesajelor ajunse în DLT, stackTrace, traceId și alte informații utile despre acestea. În plus, au fost adăugate monitorizări și alerte pentru toate topicurile DLT, iar acum, în esență, apariția unui mesaj în topicul DLT reprezintă un motiv pentru investigare și deschiderea unui defect. Este foarte convenabil — prin numele topicului, înțelegem imediat în ce etapă a procesului a apărut problema, ceea ce accelerează semnificativ căutarea cauzei fundamentale.
Recent am implementat o interfață care permite revenirea asupra mesajelor de către echipa noastră de suport, după remedierea cauzelor acestora (de exemplu, restaurarea funcționalității unui sistem extern) și, bineînțeles, deschiderea unui defect corespunzător pentru analiză. Aici ne-au fost utile topicurile noastre self, pentru a nu reporni o lungă lanț de procesare, putem relua de la pasul necesar.
Exploatarea platformei
Platforma este deja în exploatare productivă, livrăm și încărcăm produse în fiecare zi, conectăm noi centre de distribuție și magazine. În cadrul pilotului, sistemul funcționează cu grupuri de produse „Tutun” și „Încălțăminte”.
Întreaga noastră echipă participă la desfășurarea pilotului, analizează problemele apărute și face propuneri pentru îmbunătățirea produsului nostru, de la îmbunătățirea logurilor la modificări în procese.
Pentru a nu repeta greșelile anterioare, toate cazurile întâlnite pe parcursul pilonului își găsesc reflectarea în testele automatizate. Prezența unui număr mare de teste automate și teste unitare permite efectuarea testării de regresie și aplicarea hotfix-urilor în doar câteva ore.
Acum continuăm să dezvoltăm și să perfecționăm platforma noastră și ne confruntăm constant cu noi provocări. Dacă sunteți interesați, vă vom împărtăși soluțiile noastre în articolele următoare.
Sursa: habr.com
