

Decodificarea prezentării din 2020 a lui Bruce Momjian "Desc unlocking the Postgres Lock Manager".
(Notă: Toate interogările SQL din slide-uri le puteți obține la acest link: )
Salut! E minunat să fiu din nou aici, în Rusia. Îmi cer scuze că nu am putut veni anul trecut, dar anul acesta Ivan și cu mine avem planuri mari. Sper să fiu aici mult mai des. Îmi place foarte mult să vin în Rusia. Voi vizita Tyumen și Tver. Sunt foarte încântat că voi putea fi în aceste orașe.
Mă numesc Bruce Momjian. Lucrez la EnterpriseDB și folosesc Postgres de mai bine de 23 de ani. Locuiesc în Philadelphia, SUA. Călătoresc aproximativ 90 de zile pe an și particip la aproximativ 40 de conferințe. Site-ul meu , care conține slide-urile pe care le voi prezenta acum. Așadar, după conferință, le puteți descărca de pe site-ul meu personal. Acolo se află de asemenea aproximativ 30 de prezentări. Există și videoclipuri și o mulțime de înregistrări de blog, peste 500. Este o resursă destul de cuprinzătoare. Dacă sunteți interesat de acest material, vă invit să o folosiți.
Am fost profesor înainte să încep să lucrez cu Postgres și sunt foarte bucuros că acum pot să vă spun ce am de gând să vă spun. Aceasta este una dintre cele mai interesante prezentări ale mele. Prezentarea aceasta conține 110 slide-uri. Vom începe cu lucruri simple, iar spre final, prezentarea va deveni din ce în ce mai complexă și va ajunge să fie destul de dificilă.
Este o discuție destul de neplăcută. Blocarea nu este un subiect foarte popular. Ne dorim să dispară undeva. Este ca atunci când mergi la dentist.
- Blocarea este o problemă pentru mulți oameni care lucrează cu baze de date și care au mai multe procese active simultan. Au nevoie de blocare. Adică, astăzi vă voi oferi noțiuni de bază despre blocare.
- Identificatorii de tranzacție. Aceasta este o parte destul de plictisitoare a prezentării, dar trebuie înțeleasă.
- Apoi vom vorbi despre tipurile de blocare. Este o parte destul de mecanică.
- Și apoi vom da câteva exemple de blocări. Și aceasta va fi destul de dificil de înțeles.
Haideți să vorbim despre blocări.
Termenologia noastră este destul de complicată. Câți dintre voi știu de unde vine acest fragment? Două persoane. Este dintr-un joc numit „Colosală aventură în peșteră”. A fost un joc de calculator text în anii `80, cred. Trebuia să intri în peșteră, într-un labirint, iar textul se schimba, dar conținutul era aproximativ același de fiecare dată. Așa îmi amintesc de acest joc.
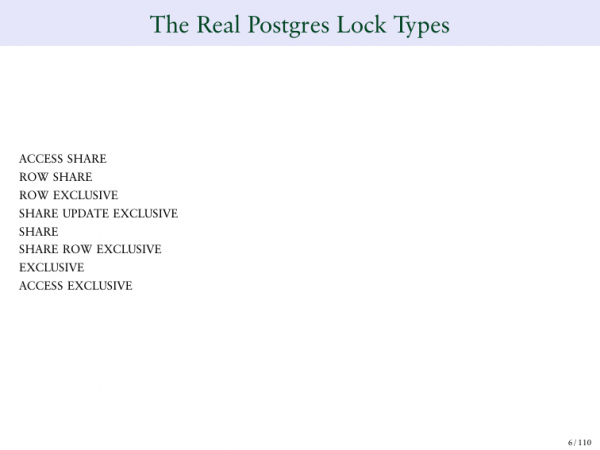
Și aici vedem denumirile blocajelor care ne vin de la Oracle. Le folosim.
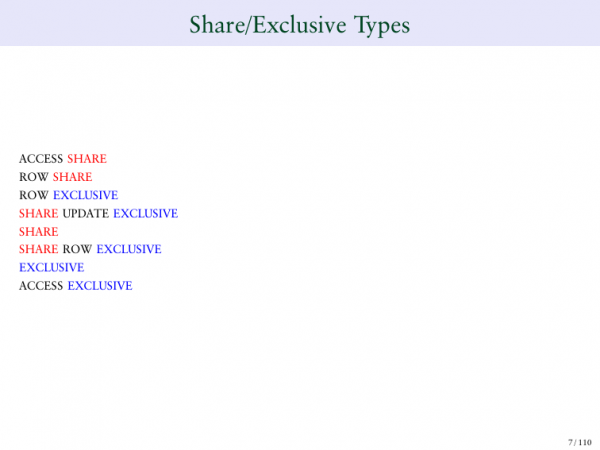
Aici vedem termeni care mă derutează. De exemplu, SHARE UPDATE EXCLUSIVE. Apoi SHARE RAW EXCLUSIVE. Sincer să fiu, aceste denumiri nu sunt foarte clare. Vom încerca să le analizăm mai în detaliu. Unele conțin cuvântul „share”, care înseamnă - a se separa. Unele conțin cuvântul „exclusive” - exclusiv. În unele se află ambele cuvinte. Aș dori să încep cu modul în care funcționează aceste blocaje.
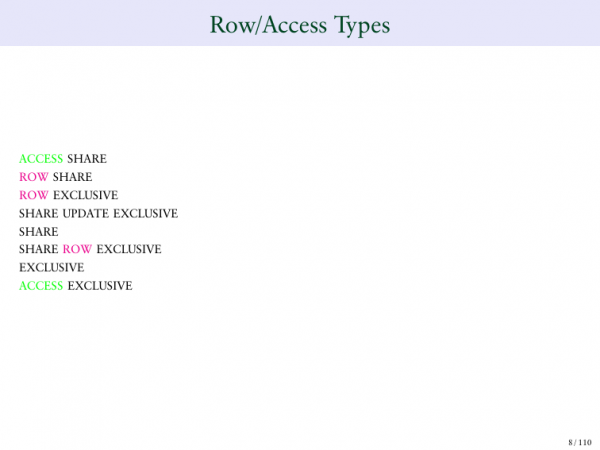
Și de asemenea, un cuvânt foarte important este „acces” - access. Și cuvântul „row” - rând. Adică, distribuția accesului, distribuția rândurilor.
O altă problemă pe care trebuie să o înțelegem în Postgres, din păcate, nu voi putea să o discut în prezentarea mea, este MVCC. Am o prezentare separată pe acest subiect pe site-ul meu. Și dacă credeți că această prezentare este complicată, atunci MVCC este, probabil, cea mai complicată dintre toate. Și dacă sunteți interesați, puteți să o vizionați pe site. Puteți vedea și un video.
Un alt aspect pe care trebuie să-l înțelegem este identificatorii de tranzacție. Multe tranzacții nu pot funcționa fără identificatori unici. Aici avem o explicație despre ce este o tranzacție. În Postgres există două sisteme de numerotare a tranzacțiilor. Știu că nu este o soluție foarte elegantă.
De asemenea, rețineți că slide-urile vor fi destul de dificile de înțeles, așa că la ceea ce este evidențiat cu roșu, exact asta trebuie să acordați atenție.
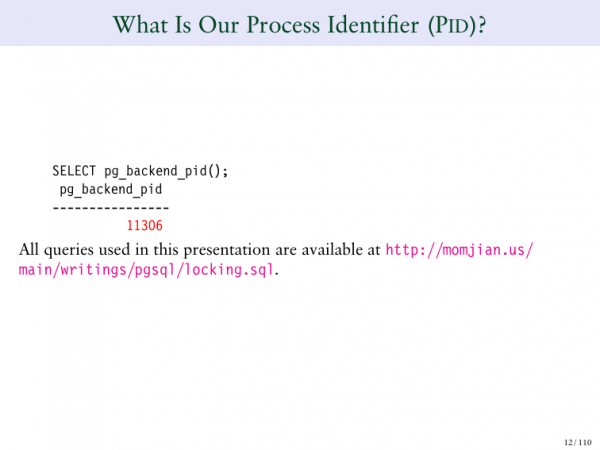
Privim. Cu roșu este evidențiat numărul tranzacției. Aici este arătată funcția SELECT pg_back. Aceasta returnează tranzacția mea și ID-ul acestei tranzacții.
Un alt aspect, dacă vă place această prezentare și doriți să o rulați în baza de date, puteți urma acest link marcat cu roz și descărca SQL-ul pentru această prezentare. O puteți rula pur și simplu în PSQL-ul dvs. și toată prezentarea va apărea imediat pe ecranul dvs. Nu va conține culori, dar măcar o vom putea vedea.
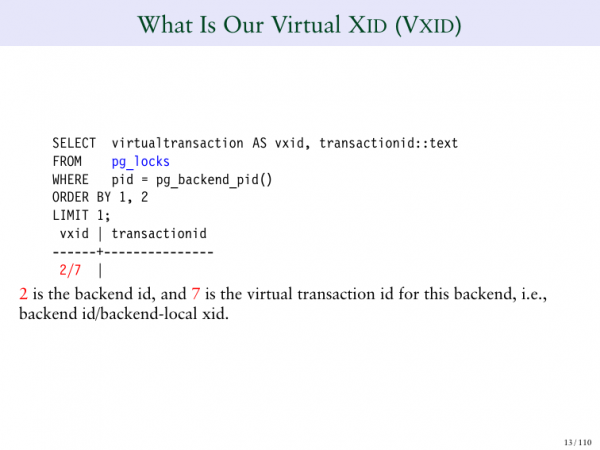
În acest caz, vedem ID-ul tranzacției. Acesta este numărul pe care i l-am atribuit. Mai există un tip de ID de tranzacție în Postgres, care se numește ID virtual de tranzacție.
Și trebuie să înțelegem acest lucru. Este foarte important, altfel nu vom putea înțelege blocajul în Postgres.
ID-ul virtual de tranzacție este ID-ul tranzacției care nu conține valori permanente. De exemplu, dacă execut o comandă SELECT, sunt foarte probabil să nu modific baza de date, nu voi bloca nimic. De aceea, când executăm un simplu SELECT, nu oferim acestui tip de tranzacție un ID permanent. Îi oferim doar un ID virtual.
Și aceasta îmbunătățește performanța Postgres, oferind mai multe oportunități pentru curățare, astfel ID-ul virtual de tranzacție constă din două numere. Primul număr înainte de slash este ID-ul backend-ului. Iar pe dreapta vedem un simplu contor.
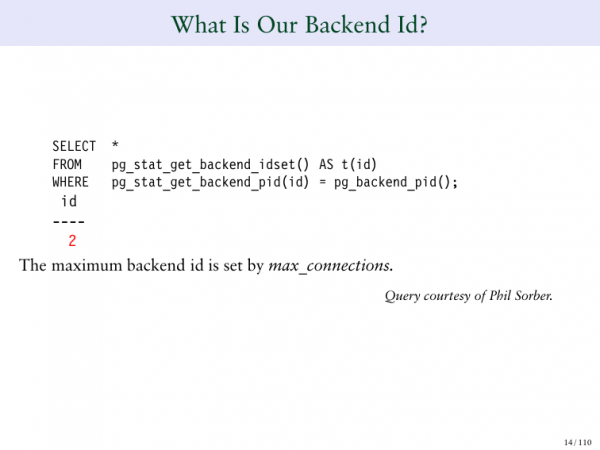
Prin urmare, dacă execut un query, spune că ID-ul backend-ului este 2.
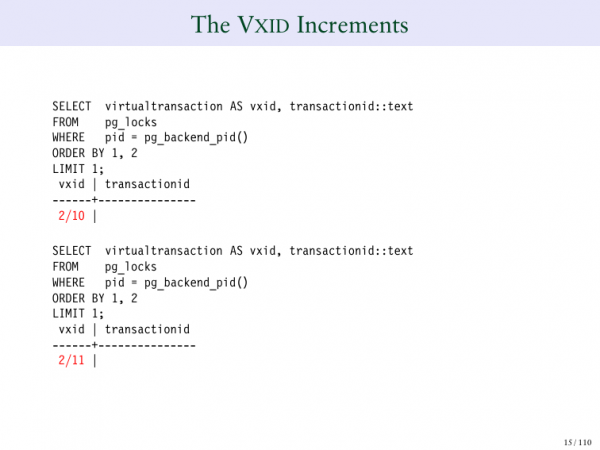
Iar dacă execut o serie de astfel de tranzacții, vedem că contorul crește de fiecare dată când execut un query. De exemplu, când execut query-uri 2/10, 2/11, 2/12 etc.
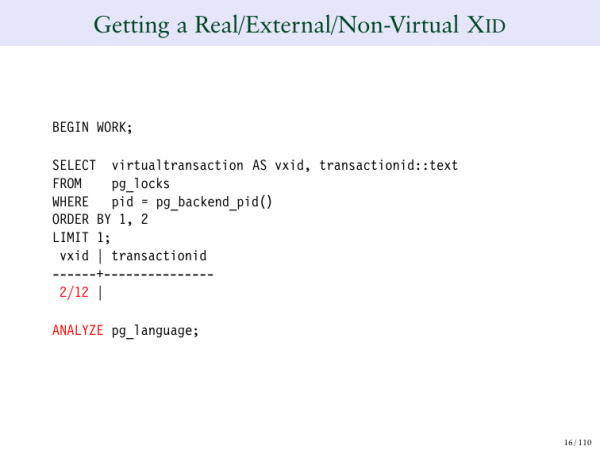
Rețineți că aici sunt două coloane. Pe stânga vedem ID-ul virtual de tranzacție – 2/12. Iar pe dreapta avem ID-ul permanent de tranzacție. Și acest câmp este gol. Această tranzacție nu modifică baza de date. Prin urmare, nu îi atribui un ID permanent de tranzacție.
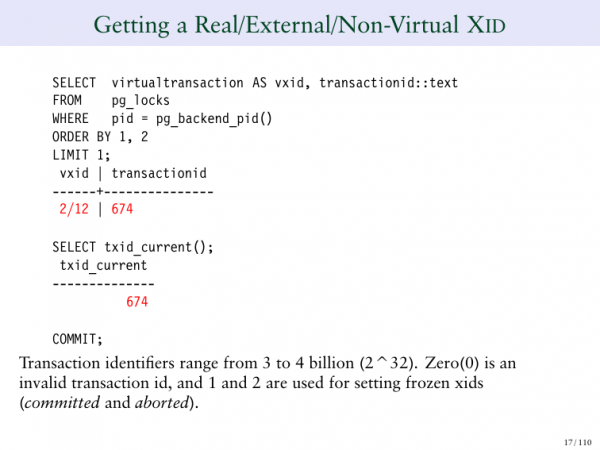
De îndată ce execut comanda ANALYZE, același query îmi oferă un ID permanent de tranzacție. Observați cum s-a schimbat acest lucru. Anterior nu aveam acest ID, acum a apărut.
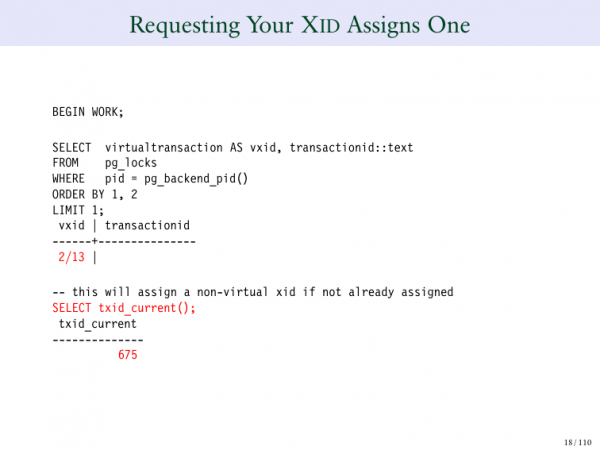
Așadar, iată un alt query, o altă tranzacție. Numărul virtual de tranzacție este 2/13. Și dacă solicit ID-ul permanent de tranzacție, atunci când execut query-ul, îl voi obține.
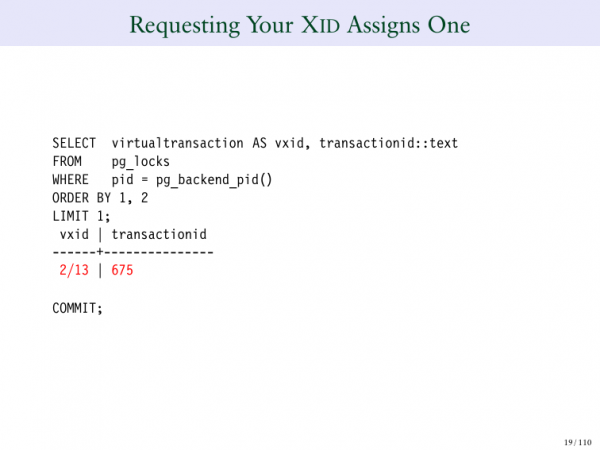
Așadar, încă o dată. Avem ID-ul virtual de tranzacție și ID-ul permanent de tranzacție. Doar înțelegeți acest aspect pentru a înțelege comportamentul Postgres.
Trecem la a treia secțiune. Aici vom trece prin diferitele tipuri de blocări din Postgres. Nu este foarte interesant. Ultima secțiune va fi mult mai captivantă. Dar trebuie să luăm în considerare lucrurile de bază, altfel nu vom înțelege ce va urma.
Vom parcurge această secțiune, vom analiza fiecare tip de blocaj. Și vă voi arăta exemple despre cum sunt stabilite, cum funcționează, vă voi arăta câteva interogări pe care le puteți folosi pentru a vedea cum funcționează blocajul în Postgres.
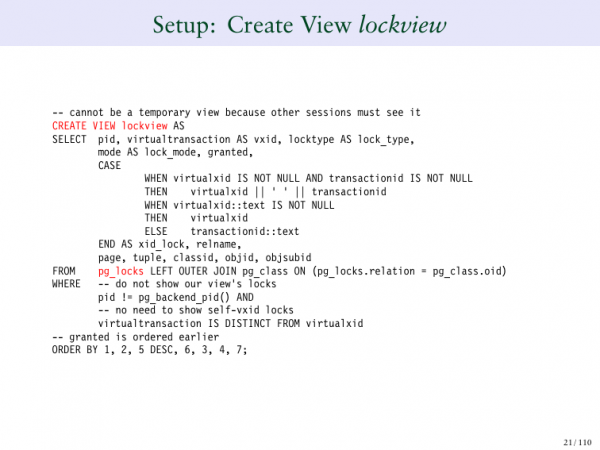
Pentru a crea o interogare și a vedea ce se întâmplă în Postgres, trebuie să emitim o interogare în system view. În acest caz, pg_lock este evidențiat cu roșu. Pg_lock este o tabelă sistem care ne arată ce blocări sunt folosite acum în Postgres.
Cu toate acestea, îmi este foarte greu să vă arăt pg_lock în sine, deoarece este destul de complex. De aceea, am creat un view care arată pg_locks. Și acesta efectuează, de asemenea, o muncă pentru mine, care îmi permite să înțeleg mai bine. Adică, exclude blocările mele, sesiunea mea etc. Este doar SQL standard și îmi permite să vă arăt mai bine ceea ce se întâmplă.
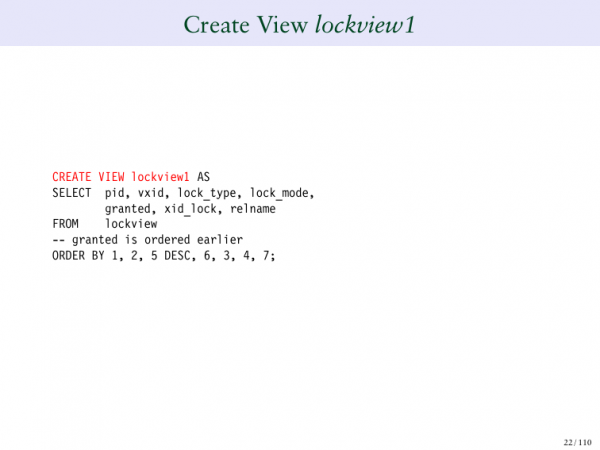
O altă problemă este că acest view este foarte larg, așa că a trebuit să creez unul secundar – lockview2.
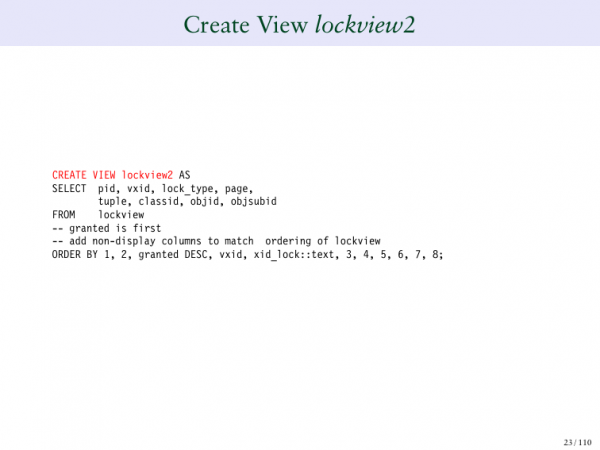 Și acesta îmi arată și alte coloane din tabel. Și încă unul care îmi arată celelalte coloane. Este destul de complicat, așa că am încercat să-l prezint cât mai simplu posibil.
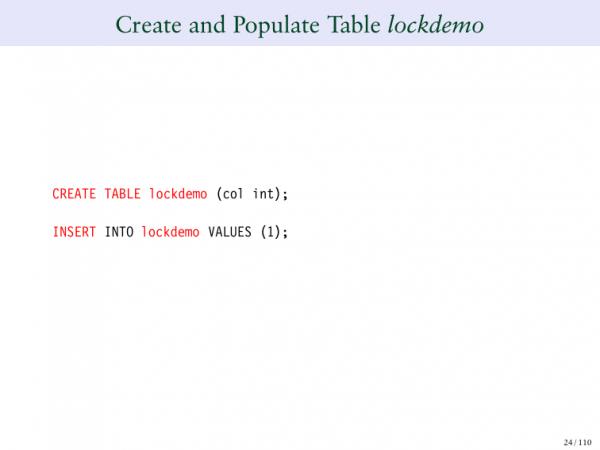
Așadar, am creat o tabelă, care se numește Lockdemo. Și am creat acolo o linie. Aceasta este tabela noastră de referință. Și vom crea secțiuni pentru a vă arăta exemple de blocări.
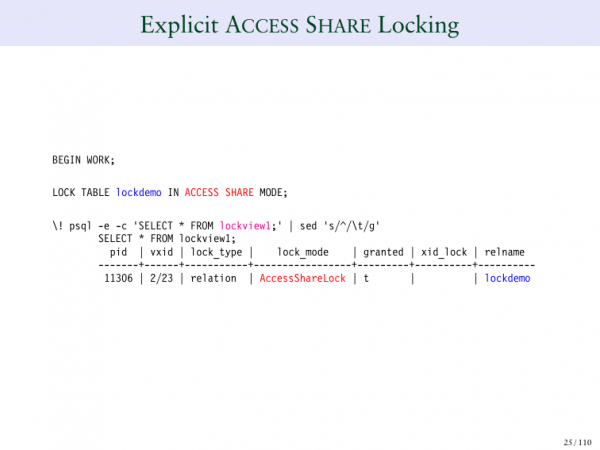
Așadar, o linie, o coloană. Primul tip de blocare se numește ACCESS SHARE. Aceasta este cea mai puțin restrictivă blocare. Înseamnă că practic nu intră în conflict cu alte blocări.
Și dacă vrem să definim explicit blocarea, executăm comanda „lock table”. Și aceasta va bloca explicit, adică în modul ACCESS SHARE executăm lock table. Și dacă lansez PSQL în fundal, atunci astfel încep a doua sesiune din prima mea sesiune. Adică, ce voi face aici? Voi trece la cealaltă sesiune și îi voi spune „arată-mi lockview pentru această întrebare”. Și aici am AccessShareLock în această tabelă. Aceasta este exact ceea ce am cerut. Și el spune că blocarea a fost atribuită. Foarte simplu.
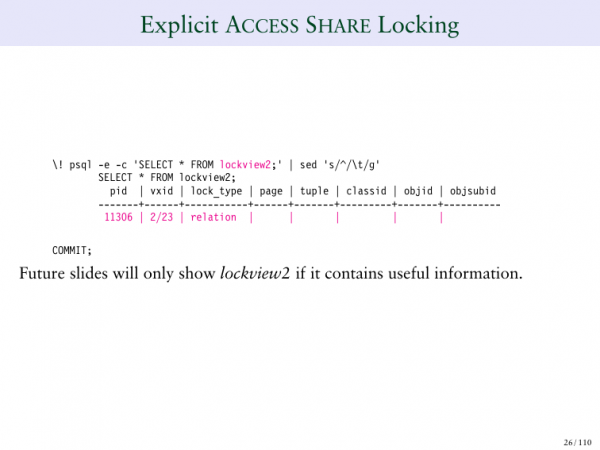
În continuare, dacă ne uităm în a doua coloană, nu există nimic. Sunt goale.
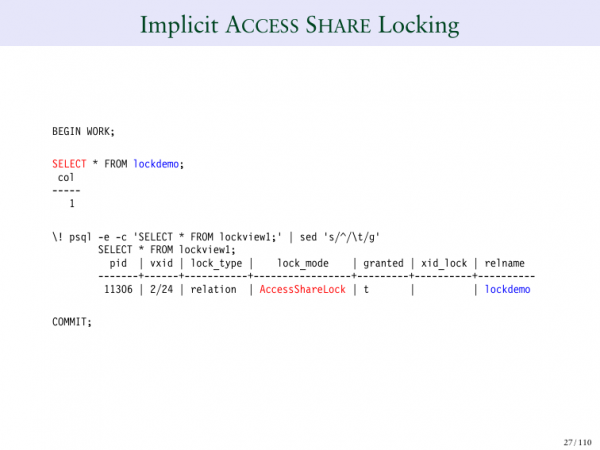
Și dacă execut comanda „SELECT”, aceasta este o modalitate implicită (explicită) de a solicita AccessShareLock. Așadar, eliberez tabela mea și lansez interogarea, iar interogarea returnează câteva linii. Și în una dintre linii vedem AccessShareLock. Astfel, SELECT generează AccessShareLock în tabelă. Și nu conflictuează practic cu nimic, deoarece este o blocare de nivel scăzut.
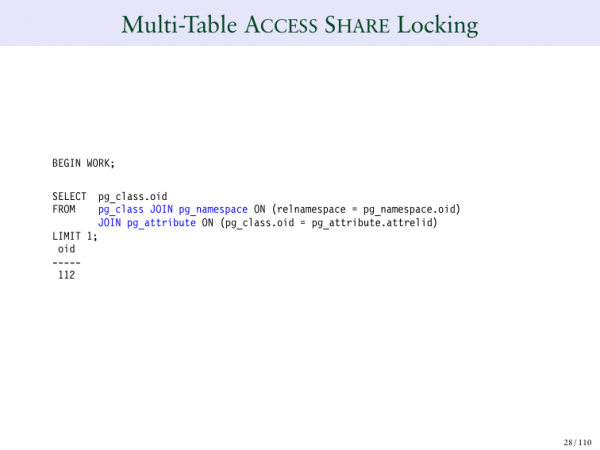
Ce se întâmplă dacă execut SELECT și am trei tabele diferite? Anterior executam doar o tabelă, acum execut trei: pg_class, pg_namespace și pg_attribute.
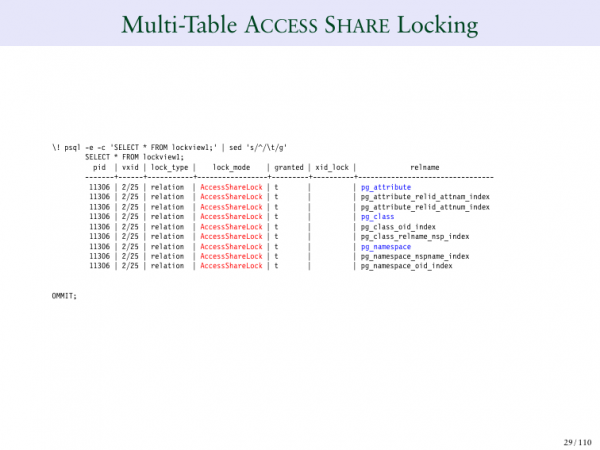
Și acum, când mă uit la interogare, văd 9 AccessShareLocks în cele trei tabele. De ce? În culoarea albastră sunt evidențiate cele trei tabele: pg_attribute, pg_class, pg_namespace. Dar puteți vedea, de asemenea, că toate indicii definiți prin aceste tabele au de asemenea AccessShareLock.
Și aceasta este o blocare care practic nu conflictuează cu altele. Și tot ce face este să nu ne permită să resetăm tabela, atâta timp cât o selectăm. Acest lucru are sens. Adică, dacă selectăm o tabelă, aceasta ar dispărea în acel moment, ar fi greșit, așa că AccessShare este o blocare de nivel scăzut care ne spune "nu șterge această tabelă în timp ce lucrez".. În esență, aceasta este tot ceea ce face.
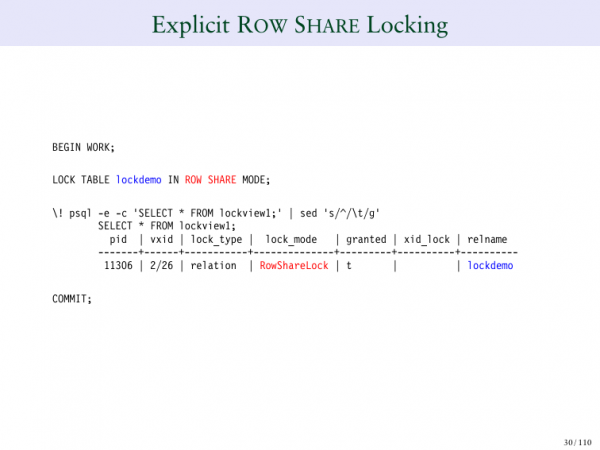
ROW SHARE este o blocare puțin diferită.
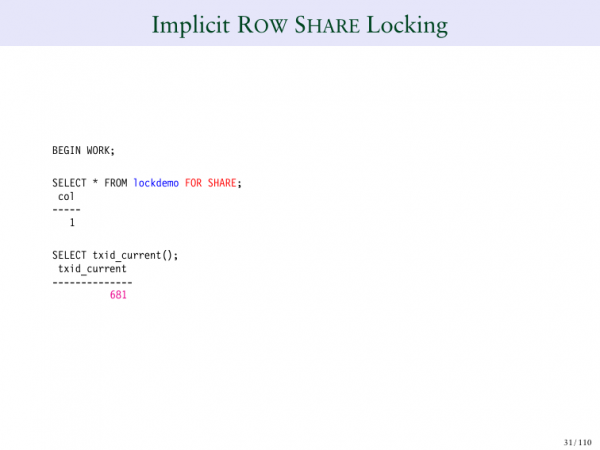
Să luăm un exemplu. SELECT ROW SHARE este modalitatea de blocare a fiecărei linii individual.. Astfel, nimeni nu poate să le șteargă sau să le modifice în timp ce le vizionăm.
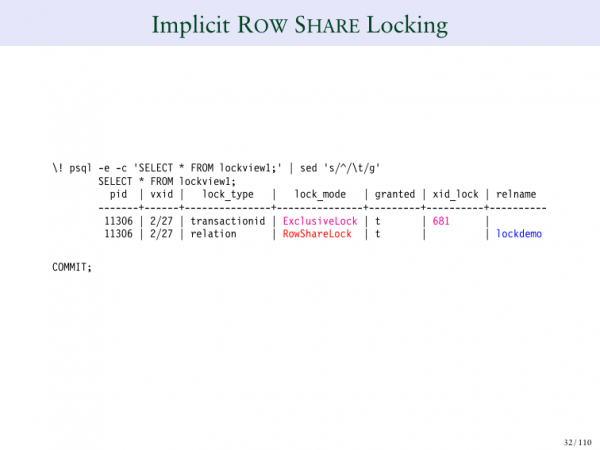 Așadar, ce face SHARE LOCK? Vedem că ID-ul tranzacției 681 este pentru un SELECT. Și acest lucru este interesant. Ce s-a întâmplat aici? Este prima dată când vedem un număr în câmpul „Lock”. Luăm ID-ul tranzacției, iar acesta ne spune că o blochează în modul exclusiv. Tot ce face este să spună că am o linie care este tehnic blocată undeva în tabel. Dar nu spune unde anume. Puțin mai târziu vom analiza acest aspect mai în detaliu.
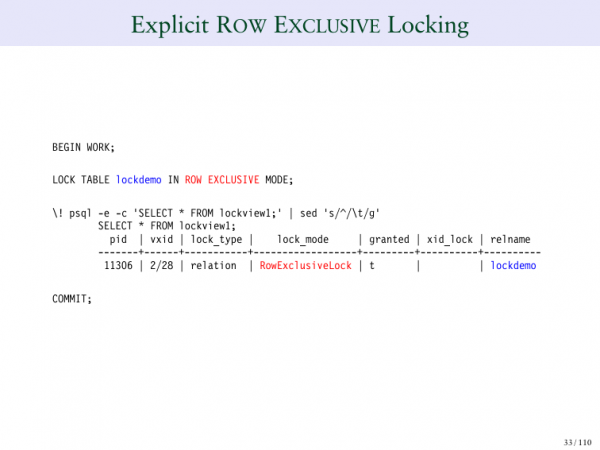
Aici spunem că blocarea este folosită de noi.
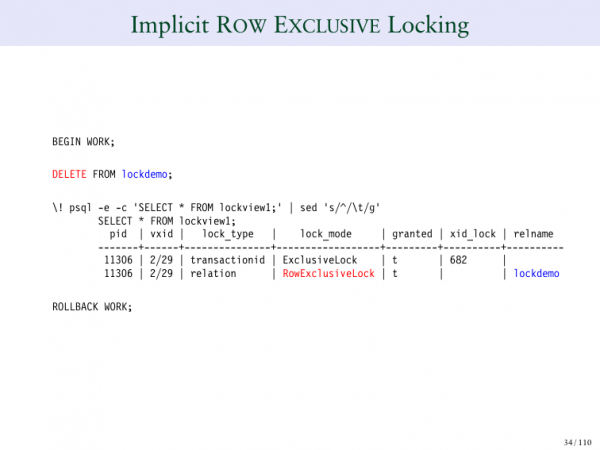
Așadar, blocarea exclusivă spune în mod explicit că este exclusivă. Și, de asemenea, dacă ștergeți o linie din acest tabel, aceasta se va întâmpla, așa cum puteți observa.
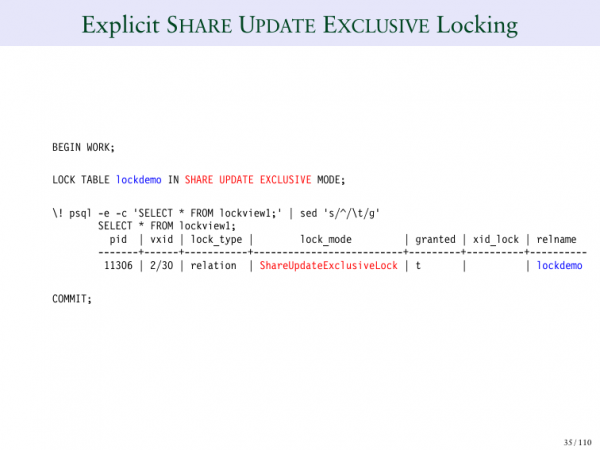
SHARE EXCLUSIVE – este o blocare mai lungă.
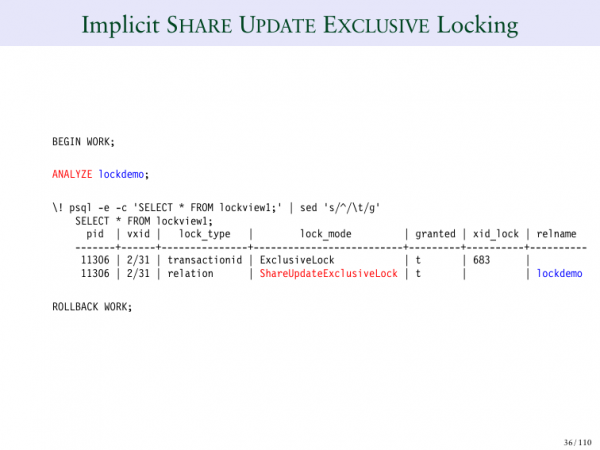
Aceasta (ANALYZE) este comanda analizatorului care va fi utilizată.
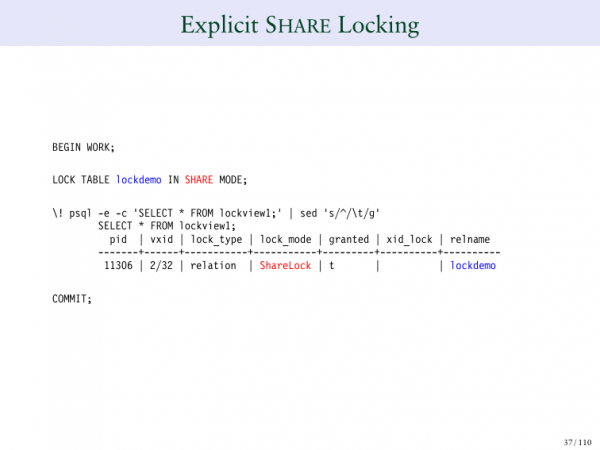
SHARE LOCK – puteți bloca explicit în modul share.
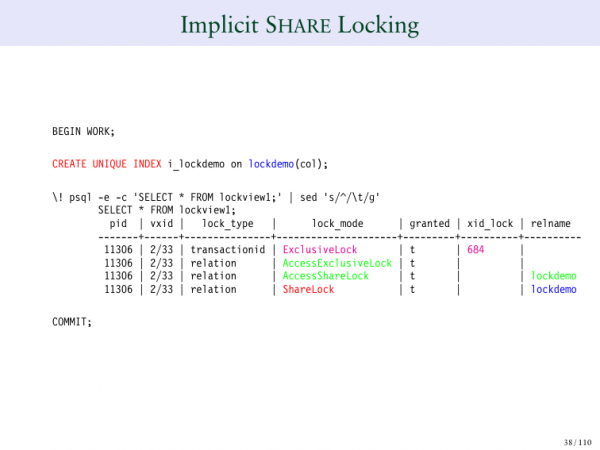
De asemenea, puteți crea un index unic. Și acolo puteți vedea SHARE LOCK, care face parte din acestea. Și blochează tabela și stabilește pe ea o blocare SHARE LOCK.
Implicit, SHARE LOCK pe tabel înseamnă că alte persoane pot citi tabela, dar nimeni nu o poate modifica. Și aceasta este ceea ce se întâmplă atunci când creați un index unic.
Dacă creez un index concurrent unic, atunci voi avea un alt tip de blocare, deoarece, după cum vă amintiți, utilizarea indexurilor concurrente reduce cerințele de blocare. Și dacă folosesc o blocare normală, un index normal, atunci astfel voi împiedica scrierea în indexul tabelului în timpul creării acestuia. Dacă folosesc un index concurrent, atunci trebuie să folosesc un alt tip de blocare.
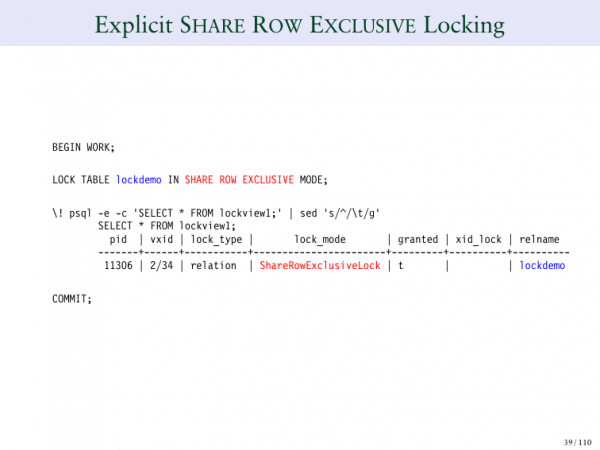
SHARE ROW EXCLUSIVE – din nou, aceasta poate fi specificată explicit.
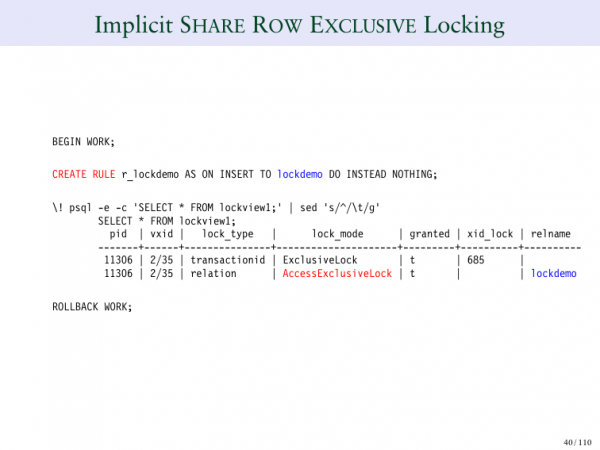
Sau putem crea o regulă, adică să luăm un caz specific în care aceasta va fi utilizată.
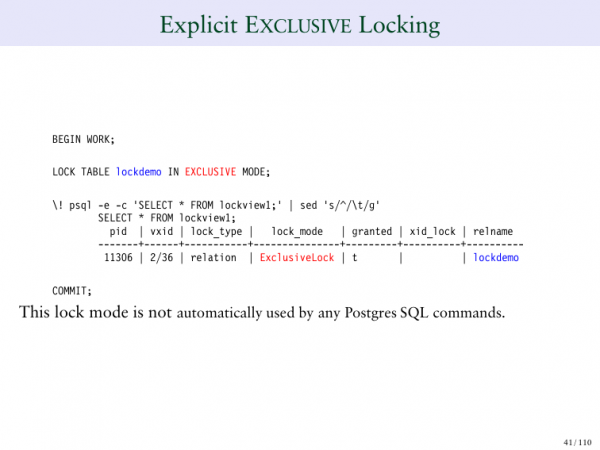
Blocarea EXCLUSIVE înseamnă că nimeni altcineva nu poate modifica tabela.
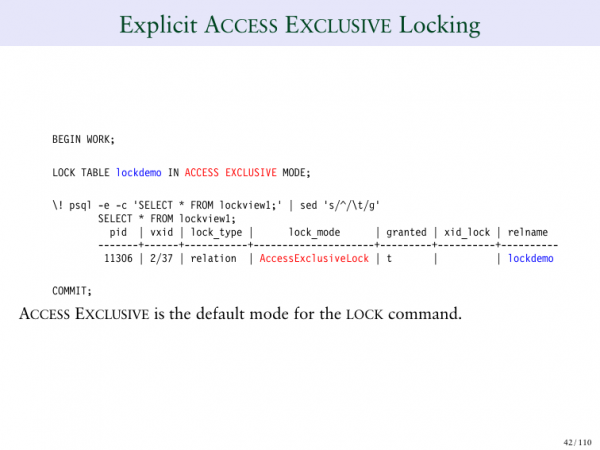
Aici vedem diferite tipuri de blocări.
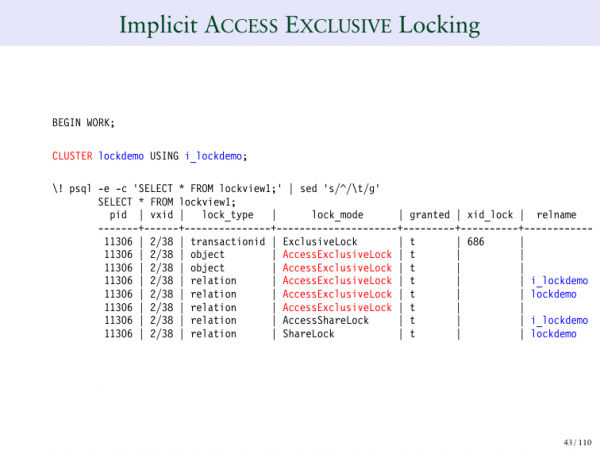
ACCESS EXCLUSIVE, de exemplu, este comanda de blocare. De exemplu, dacă faceți CLUSTER table, aceasta va însemna că nimeni nu va putea scrie acolo. Și blochează nu doar tabela în sine, ci și indicii de asemenea.
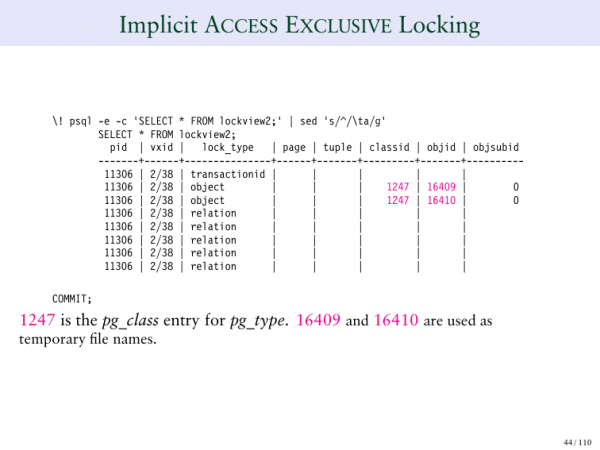
Aceasta este a doua pagină a blocării ACCESS EXCLUSIVE, unde vedem foarte clar ce blochează în tabel. Blochează rânduri individuale din tabel, ceea ce este destul de interesant.
Aceasta este toată informația de bază pe care am vrut să o ofer. Am discutat despre blocaje, despre ID-uri de tranziție, am vorbit despre ID-uri virtuale de tranziție, despre ID-uri de tranziție permanente.
Și acum vom trece la exemple de blocaje. Aceasta este cea mai interesantă parte. Vom analiza cazuri foarte interesante. Sarcina mea în această prezentare este să vă ofer o idee mai bună despre ceea ce face, de fapt, Postgres atunci când încearcă să blocheze anumite lucruri. Mi se pare că se descurcă foarte bine să blocheze părți separate.
Haideți să examinăm anumite exemple.
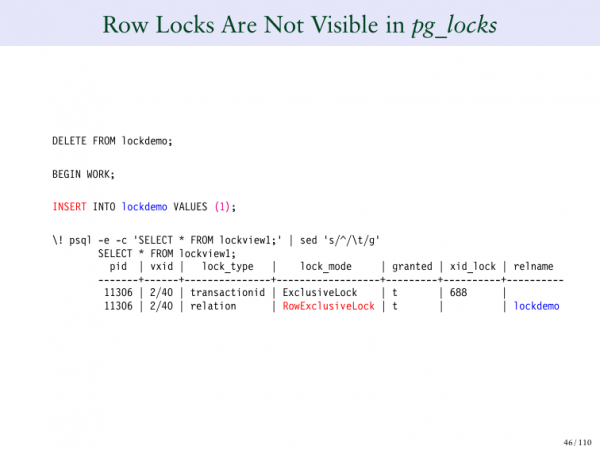
Vom începe cu tabelele și cu o linie în tabel. Când introduc ceva, mi se afișează ExclusiveLock, ID-ul tranziției și ExclusiveLock-ul pentru tabel.
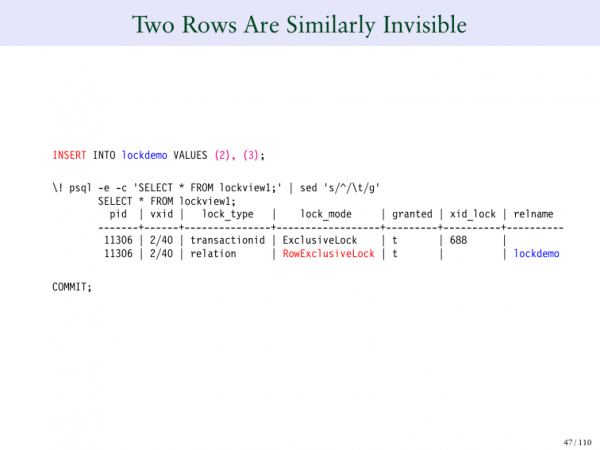
Și ce se va întâmpla dacă introduc încă două rânduri? Și acum avem trei rânduri în tabelul nostru. Am introdus un rând și am obținut acest rezultat. Și dacă introduc încă două rânduri, ce este ciudat aici? Există o ciudățenie, deoarece am adăugat trei rânduri la acest tabel, dar am încă două rânduri în tabelul de blocare. Și acesta este, în esență, comportamentul fundamental al Postgres.
Mulți cred că dacă în baza de date blochezi 100 de rânduri, va fi necesar să creezi 100 de înregistrări de blocare. Dacă blochez simultan 1.000 de rânduri, atunci voi avea nevoie de 1.000 de astfel de comenzi. Și dacă trebuie să blochez un milion sau un miliard. Dar dacă facem asta, nu va funcționa foarte bine. Dacă ai folosit un sistem care creează înregistrări de blocare pentru fiecare rând în parte, vezi că este complicat. Pentru că trebuie să definești din start un tabel de blocare, care ar putea fi depășit, dar Postgres nu face asta.
Și pe acest diapozitiv este foarte important să se demonstreze că există un alt sistem care funcționează în interiorul MVCC, care blochează rânduri individuale. Așadar, când blochezi miliarde de rânduri, Postgres nu creează un miliard de comenzi separate pentru blocare. Și acest lucru are un impact foarte pozitiv asupra performanței.
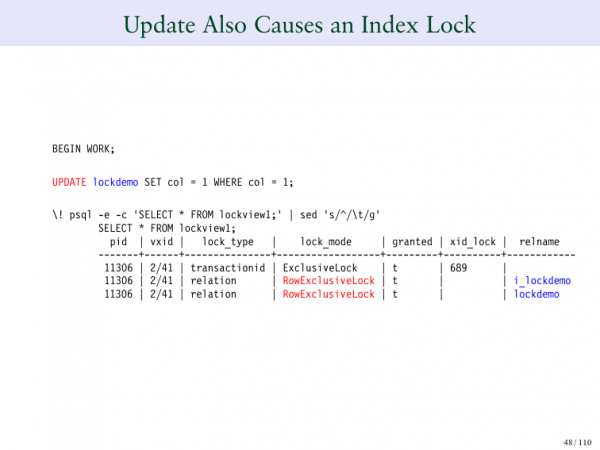
Ce părere aveți despre actualizare? Acum actualizez un rând și puteți observa că a realizat instantaneu două operațiuni diferite. A blocat în același timp tabela, dar a blocat și indexul. Era necesar să blocheze indexul deoarece există constrângeri unice pe această tabelă. Vrem să ne asigurăm că nimeni nu îl modifică, așa că îl blocăm.
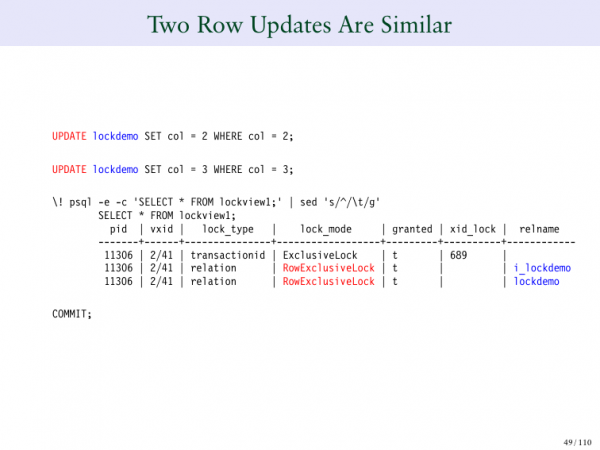
Ce se întâmplă dacă vreau să actualizez două rânduri? Observăm că se comportă la fel. Facem de două ori mai multe actualizări, dar exact același număr de rânduri blocate.
Dacă sunteți curios cum face Postgres asta, trebuie să ascultați prezentările mele despre MVCC pentru a înțelege cum Postgres marchează intern rândurile pe care le modifică. Postgres are o metodă prin care face acest lucru, dar nu o face la nivelul blocării tabelelor, ci la un nivel mai jos și mai eficient.
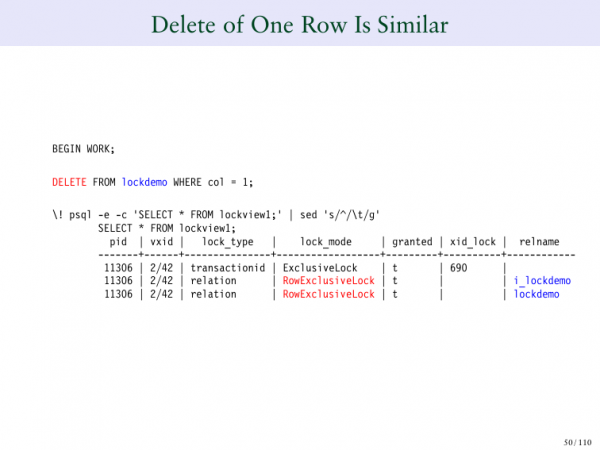
Și dacă vreau să șterg ceva? Dacă șterg, de exemplu, un rând și am încă cele două blocări, chiar dacă vreau să le șterg pe toate, ele tot vor fi prezente.
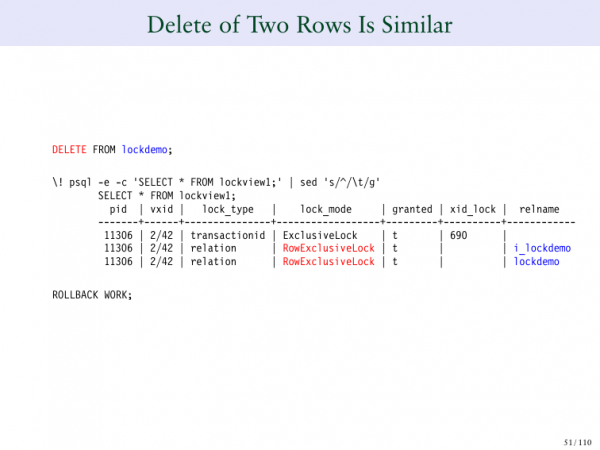
De exemplu, dacă vreau să inserez 1.000 de rânduri, apoi să șterg sau să adaug 1.000 de rânduri, acele rânduri individuale pe care le adaug sau le modific nu sunt scrise aici. Ele sunt scrise la un nivel mai jos, în cadrul rândului. La prezentarea despre MVCC am vorbit despre asta în detaliu. Dar este foarte important, când analizați blocările, să vă asigurați că aveți o blocare la nivel de tabel și că aici nu vedeți cum se efectuează scrierea rândurilor individuale.
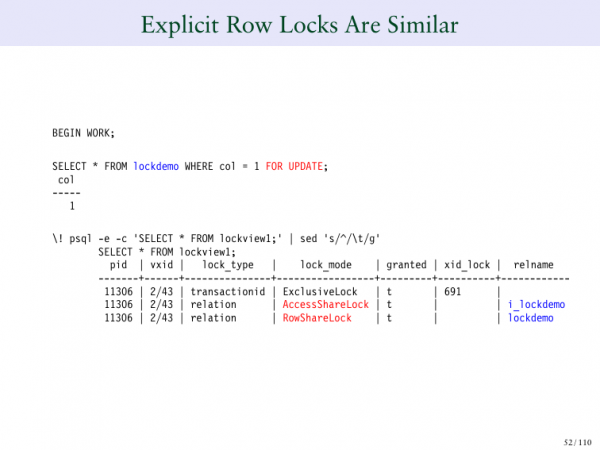
Ce ziceți de blocarea explicitară?
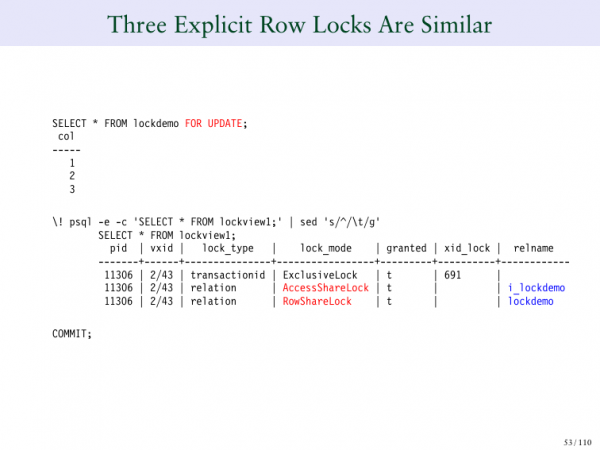
Dacă apas pe „actualizează” am două rânduri blocate. Dacă le selectez pe toate și apăs pe „actualizează tot”, îmi rămân în continuare două înregistrări blocate.
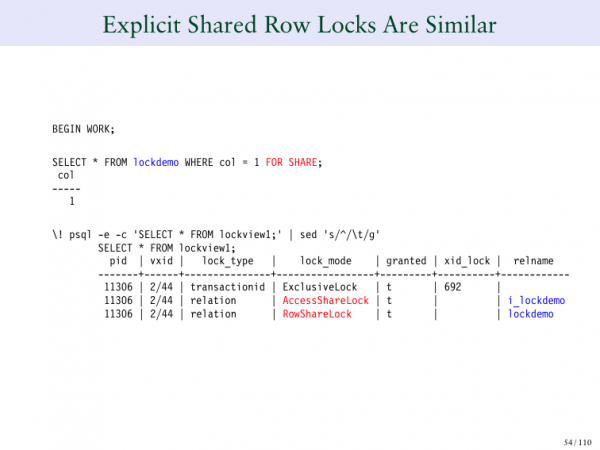
Nu creăm înregistrări separate pentru fiecare rând. Pentru că atunci scade performanța, ar putea fi prea multe. Și ne-am putea afla într-o situație neplăcută.
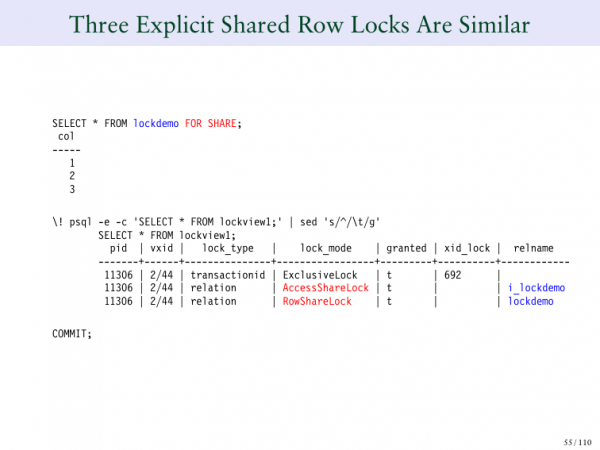
Și același lucru se aplică dacă facem shared, putem face asta de 30 de ori.
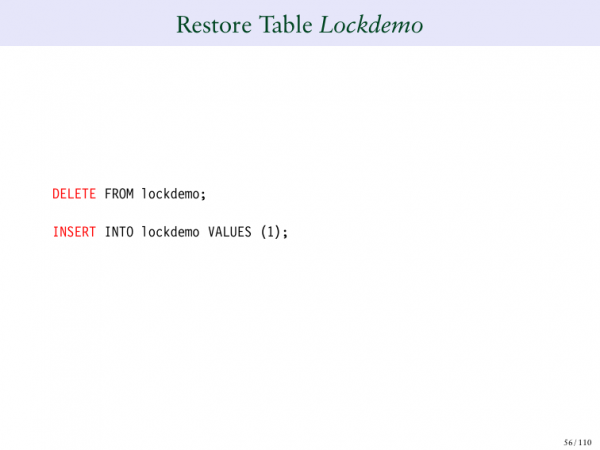
Restaurăm tabela noastră, ștergem tot, apoi inserăm din nou un rând.
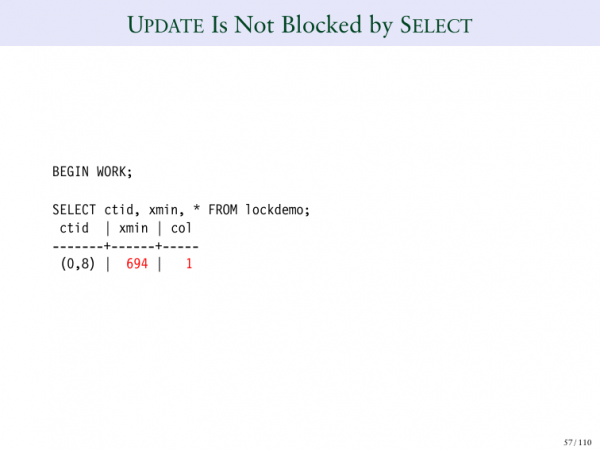
Un alt comportament pe care îl vedeți în Postgres este un comportament foarte bine cunoscut și dorit – este faptul că puteți efectua update sau select. Și puteți face asta simultan. Iar select nu blochează update și invers. Spunem cititorului să nu blocheze cel care scrie, iar cel care scrie să nu blocheze cititorul.
Vă voi arăta un exemplu al acestui lucru. Voi face acum o selecție. Apoi vom efectua un INSERT. Și apoi veți putea vedea – 694. Veți putea vedea ID-ul tranzacției care a efectuat această inserare. Și astfel funcționează.
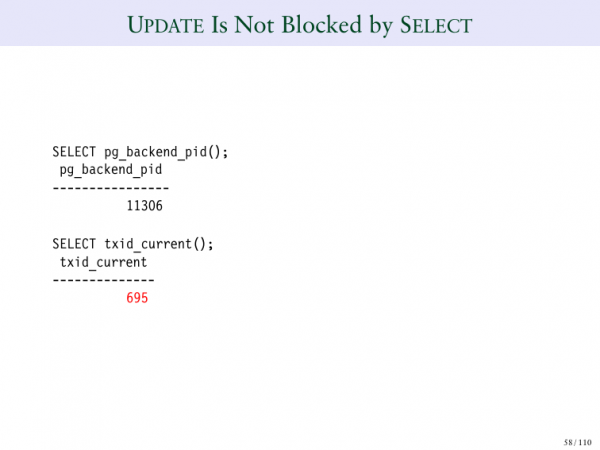
Și dacă acum mă uit la backend ID-ul meu, acesta a devenit – 695.
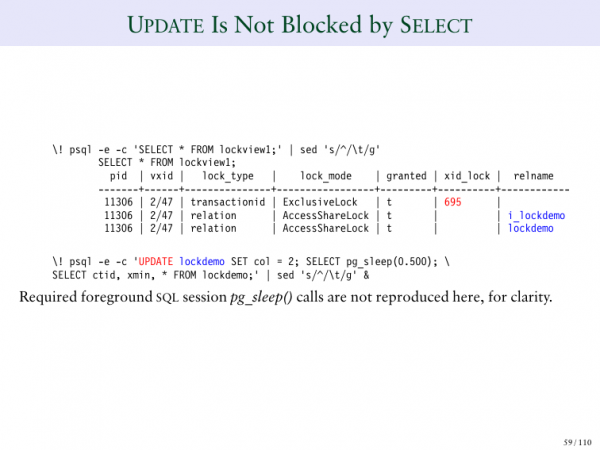
Și pot vedea că 695 apare în tabelul meu.
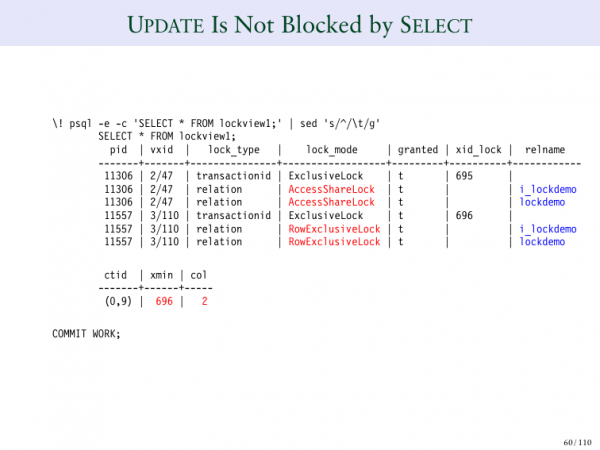
Și dacă fac o actualizare aici în acest mod, atunci obțin un alt caz. În acest caz, 695 – blochează exclusiv, iar update are un comportament similar, dar între ele nu apare niciun conflict, ceea ce este destul de neobișnuit.
Și puteți observa că sus – este ShareLock, iar jos – este ExclusiveLock. Și ambele tranzacții au avut loc.
Și trebuie să ascultați prezentarea mea în MVCC pentru a înțelege cum se întâmplă acest lucru. Dar aceasta este o ilustrare a faptului că puteți face asta simultan, adică să efectuați SELECT și UPDATE în același timp.
Hai să resetăm și să facem o operație din nou.
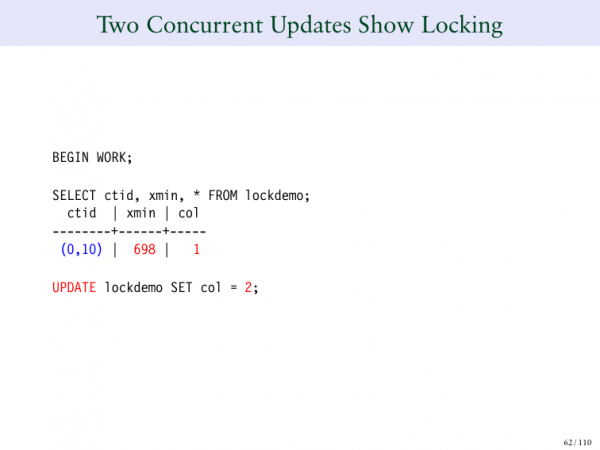
Dacă încercați să rulați simultan două update-uri pe același rând, atunci va fi blocat. Și amintiți-vă, am spus că cititorul nu blochează scriitorul, iar scriitorul blochează cititorul, dar un scriitor blochează alt scriitor. Adică nu putem face ca două persoane să actualizeze simultan același rând. Trebuie să așteptăm până când unul dintre ei finalizează.
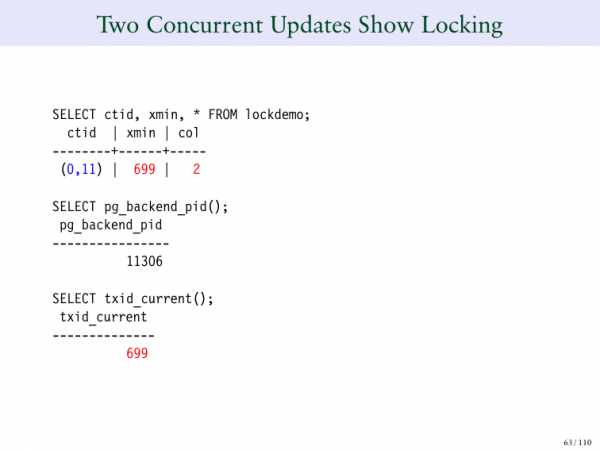
Și pentru a ilustra acest lucru, mă voi uita la tabela Lockdemo. Și vom observa un rând. La tranzacția 698.
L-am actualizat la 2. 699 – aceasta este prima actualizare. Și a trecut cu succes sau se află într-o tranzacție în așteptare și așteaptă să confirmăm sau să anulăm.
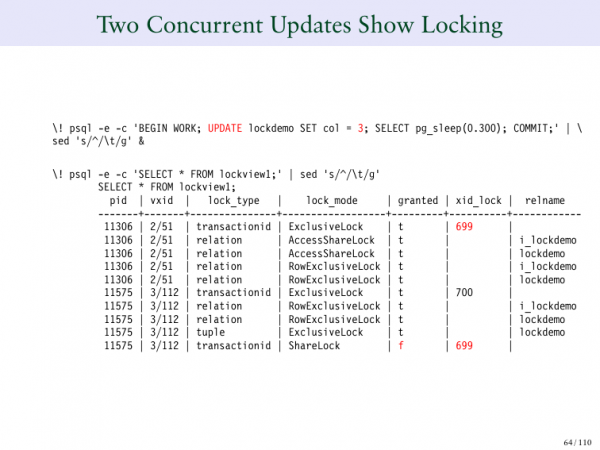
Dar luați în considerare altceva – 2/51 – aceasta este prima noastră tranzacție, prima noastră sesiune. 3/112 – aceasta este a doua cerere, care a apărut deasupra și care a schimbat această valoare în 3. Și dacă observați, atunci cel de sus s-a blocat singur, care este 699. Însă 3/112 nu a oferit o blocare. În coloana Lock_mode scrie că așteaptă. Așteaptă 699. Și dacă vă uitați, unde este 699, este mai sus. Și ce a făcut prima sesiune? A creat o blocare exclusivă pe ID-ul său de tranzacție. Așa face Postgres. Blochează propriul ID de tranzacție. Și dacă vrei să aștepți până când cineva confirmă sau anulează, trebuie să aștepți până există o tranzacție în așteptare. Și de aceea putem vedea o linie ciudată.
Să ne uităm din nou. În stânga vedem ID-ul nostru de procesare. În a doua coloană vedem ID-ul nostru virtual de tranzacție, iar în a treia vedem lock_type. Ce înseamnă asta? Practic, spune că blochează ID-ul de tranzacție. Dar observați că în toate rândurile de jos scrie relation. Și de aceea aveți două tipuri de blocare în tabelă. Există blocarea relation. De asemenea, există blocarea transactionid, unde ne blocăm noi înșine, aceasta este exact ceea ce se întâmplă în primul rând sau în cel mai de jos, unde transactionid, unde așteptăm ca 699 să își finalizeze operațiunea.
Mă uit la ce se întâmplă aici. Și aici se petrec în același timp două lucruri. Te uiți la blocarea pe ID-ul de tranzacție din primul rând, care se blochează singură. Și se blochează singură pentru a-i face pe oameni să aștepte.
Dacă te uiți la a 6-a linie, este aceeași înregistrare ca și prima. Și astfel tranzacția 699 este blocată. 700, de asemenea, se auto-blochează. Și apoi în rândul de jos vei vedea că așteptăm ca 699 să își finalizeze operațiunea.
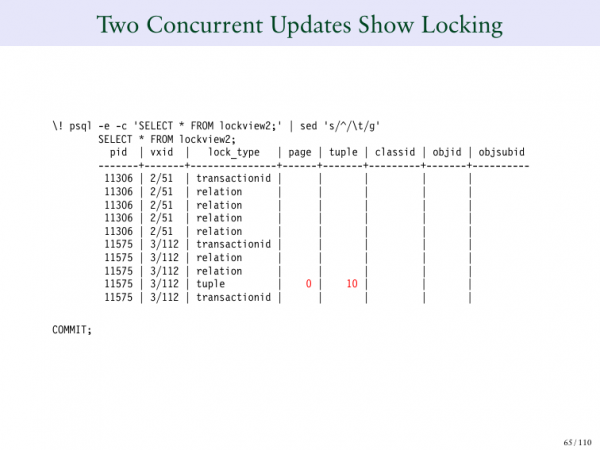
Și în lock_type, tuple vezi numere.
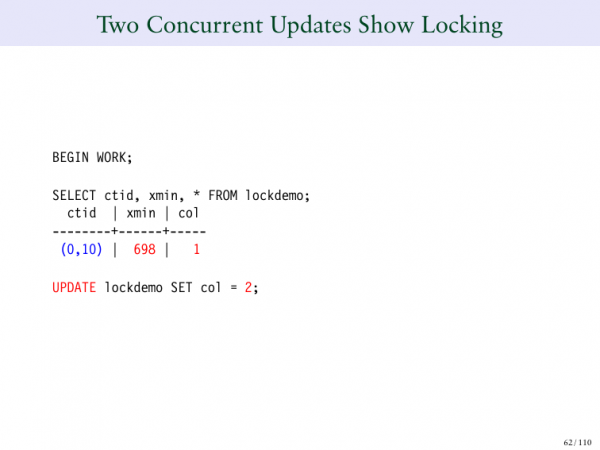
Poți vedea că este 0/10. Și aceasta este pagina și, de asemenea, offset-ul acestei înregistrări specifice.
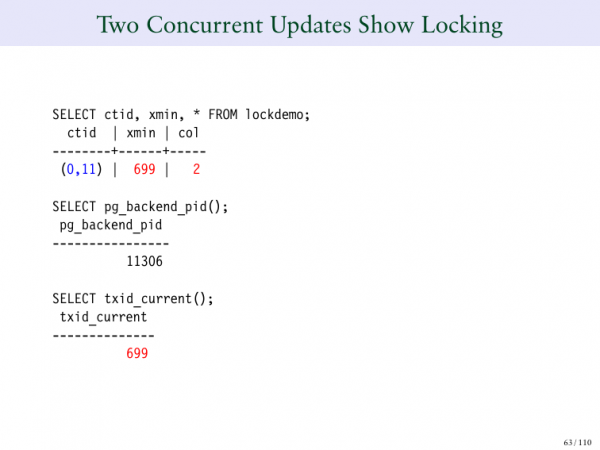
Și vezi că devine 0/11, când actualizăm.
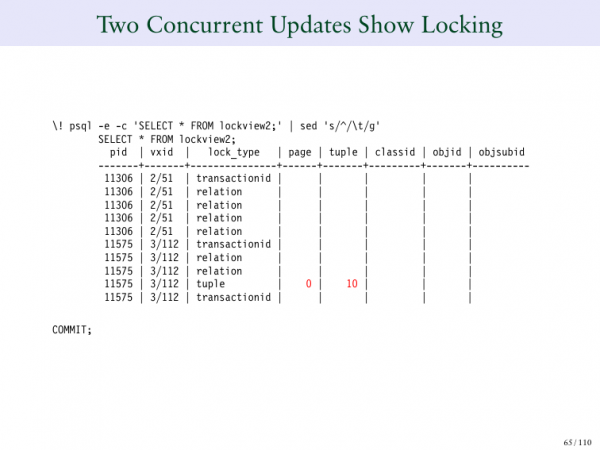
Dar, de fapt – este 0/10, pentru că apare așteptarea acestei operațiuni. Avem oportunitatea să vedem că aceasta este înregistrarea pe care o aștept să fie confirmată.
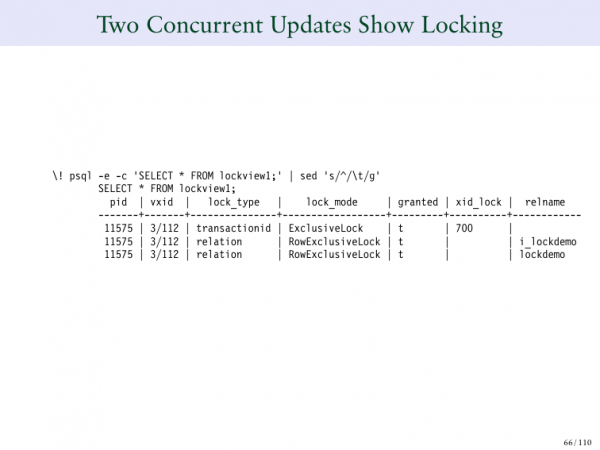
Odată ce l-am confirmat și am apăsat commit, și când actualizarea s-a terminat, aceasta este ceea ce obținem din nou. Transacția 700 este singura blocare, nu așteaptă pe nimeni altcineva, deoarece a fost confirmată. Așteaptă doar ca transacția să se finalizeze. Odată ce transacția 699 se termină, nu mai așteptăm nimic. Și acum transacția 700 spune că totul este în regulă, că toate blocările necesare le are în toate tabelele autorizate.
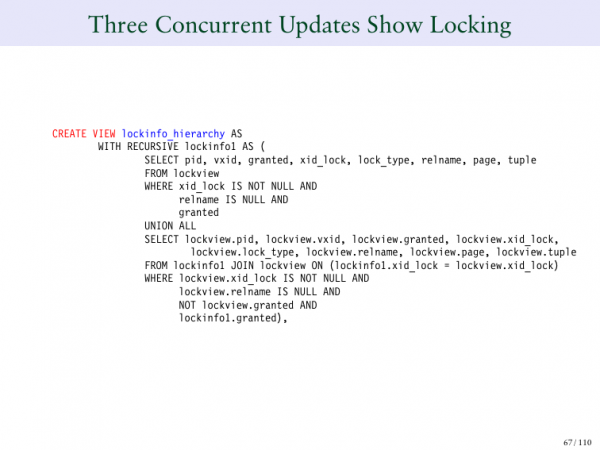
Și ca să complicăm și mai mult lucrurile, creăm o altă vedere, care de data aceasta ne va oferi o ierarhie. Nu mă aștept să înțelegi această interogare. Dar ne va oferi o viziune mai clară asupra a ceea ce se întâmplă.
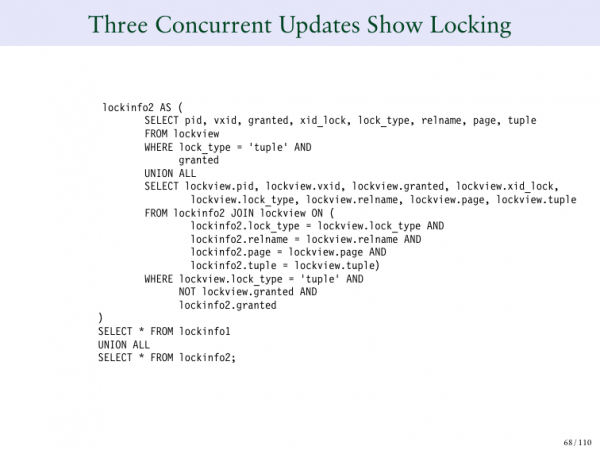
Aceasta este o vedere recursivă, care mai are și o altă secțiune. Și apoi ne întoarce totul din nou. Hai să folosim aceasta.
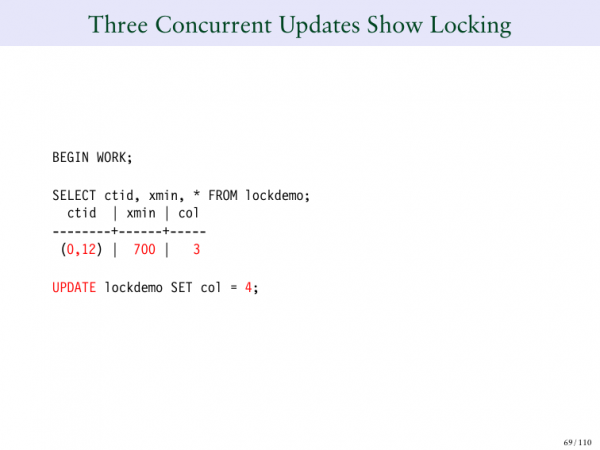
Ce s-ar întâmpla dacă am face trei actualizări simultane și am spune că rândul este acum egal cu trei. Și vom schimba 3 în 4.
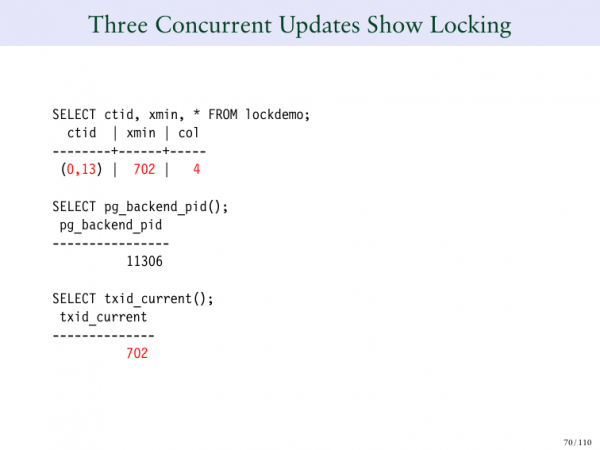
Și iată ne vedem 4. Și ID-ul tranzacțional 702.
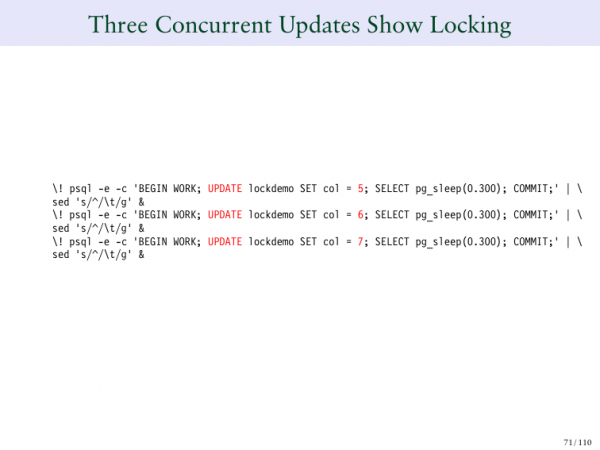
Și apoi voi schimba 4 în 5. Iar 5 în 6, iar 6 în 7. Și îmi creez o coadă de oameni care așteaptă ca această singură tranzacție să se termine.
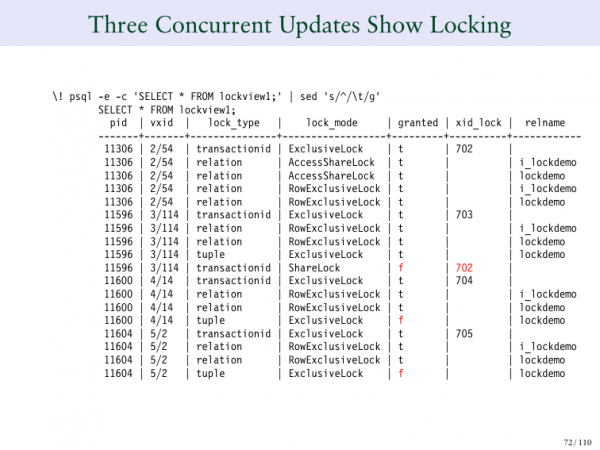
Și totul devine clar. Care este primul rând? Acesta este 702. Acesta este ID-ul tranzacțional, care a inițiat această valoare. Și ce am notat în coloana Granted? Am mărci. f. Acestea sunt actualizările mele, care (5, 6, 7) nu pot fi aprobate, deoarece așteptăm ca ID-ul tranzacțional 702 să se finalizeze. Acolo avem o blocare a ID-ului tranzacțional. Iar 5 devin blocări tranzacționale ID.
Și dacă te uiți la 704, la 705, atunci acolo nu este nimic scris, deoarece ei încă nu știu ce se întâmplă. Ei doar scriu că nu au idee ce se întâmplă. Și vor merge la somn, deoarece așteaptă pe cineva să finalizeze și să-i trezească când va apărea oportunitatea de a schimba rândul.
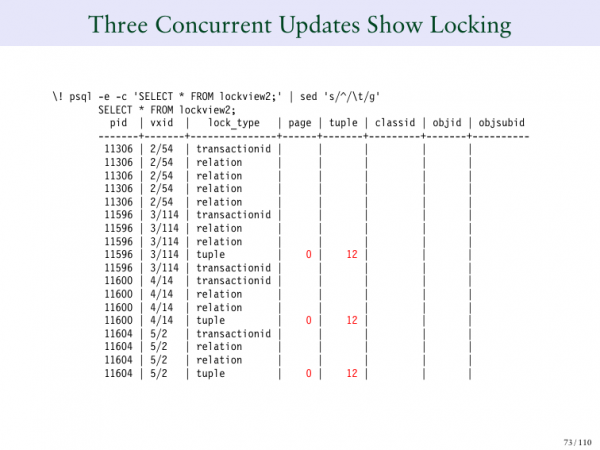
Așa arată. Este clar că toți așteaptă rândul 12.
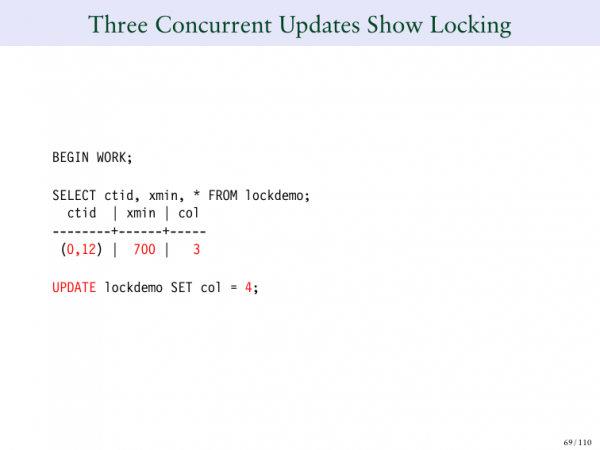
Acesta este ceea ce am văzut aici. Iată 0/12.
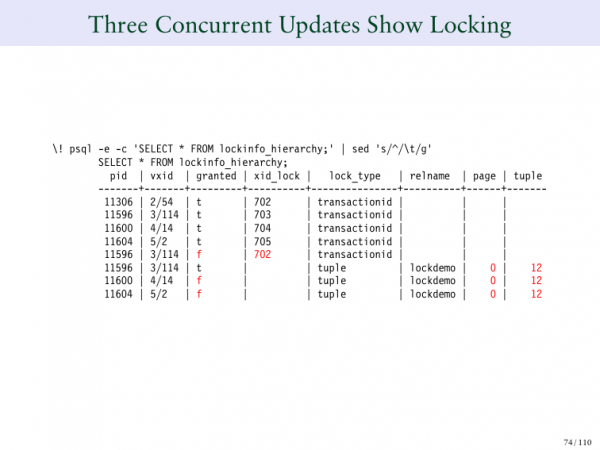
Deci, odată ce prima tranzacție este aprobată, poți vedea aici cum funcționează ierarhia. Și acum devine totul clar. Toți devin liberi. Și ei, de fapt, așteaptă.
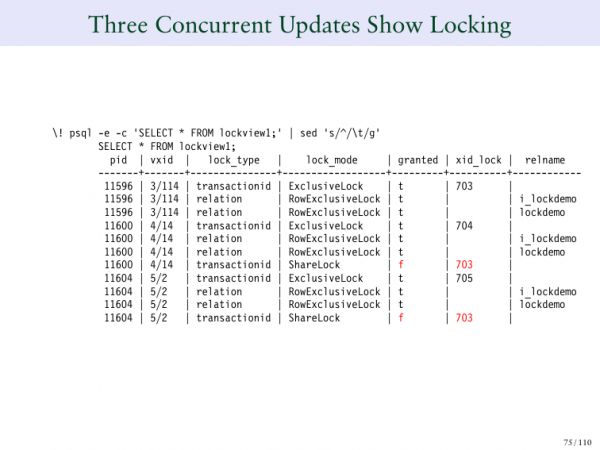
Iată ce se întâmplă. 702 se comite. Și acum 703 primește această blocare a rândului, iar apoi 704 începe să aștepte când 703 se va comite. Și 705 așteaptă și el acest lucru. Și când totul se încheie, se eliberează singuri. Și aș dori să subliniez că toți se aliniază. Și este foarte asemănător cu situația unui ambuteiaj, când toți așteaptă prima mașină. Prima mașină s-a oprit și toată lumea se aliniază într-o linie lungă. Apoi se mișcă, apoi următoarea mașină poate avansa și obține blocarea sa etc.
Și dacă vi s-a părut că acest lucru nu este suficient de complicat, acum vom discuta despre deadlocks. Nu știu câți dintre voi s-au întâlnit cu ei. Este o problemă destul de comună în sistemele de baze de date. Dar deadlocks sunt cazul când o sesiune așteaptă ca o altă sesiune să execute ceva. Iar în acel moment, cealaltă sesiune așteaptă ca prima sesiune să execute ceva.
De exemplu, dacă Ivan spune: „Dă-mi ceva”, iar eu spun: „Nu, ți-l voi da doar dacă îmi dai ceva altceva”. Iar el spune: „Nu, nu îți voi da asta dacă nu îmi dai tu”. Și ajungem într-o situație de deadlock. Sunt sigur că Ivan nu ar face așa ceva, dar înțelegeți ideea, că avem doi oameni care vor să obțină ceva și nu sunt dispuși să dea până când cealaltă persoană nu le dă ceea ce vor. Și aici nu există o soluție.
Și, practic, baza dvs. de date trebuie să identifice acest lucru. Și apoi trebuie să elimine sau să închidă una dintre sesiuni, pentru că altfel vor rămâne acolo pentru totdeauna. Și vedem asta în bazele de date, vedem asta în sistemele de operare. Și în toate locurile unde avem procese paralele, acest lucru se poate întâmpla.
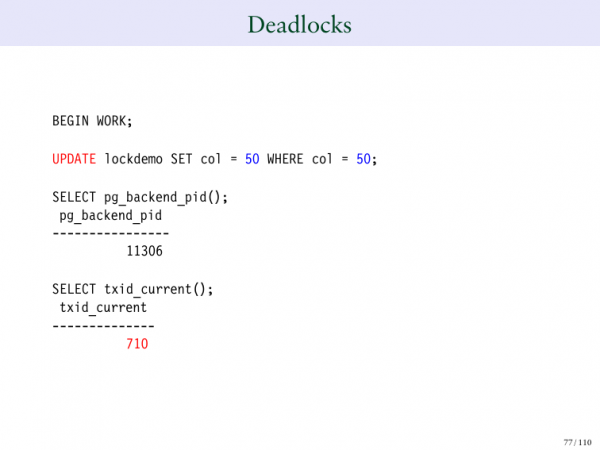
Și acum vom crea două deadlocks. Vom folosi 50 și 80. În primul rând, voi efectua o actualizare de la 50 la 50. Voi obține numărul tranzacției 710.
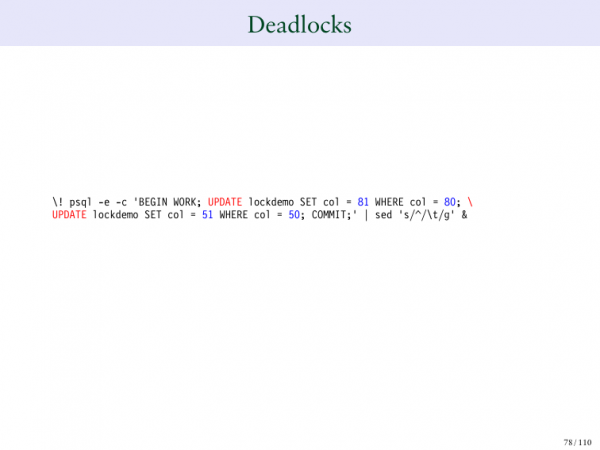
Și apoi voi schimba 80 pe 81 și 50 pe 51.
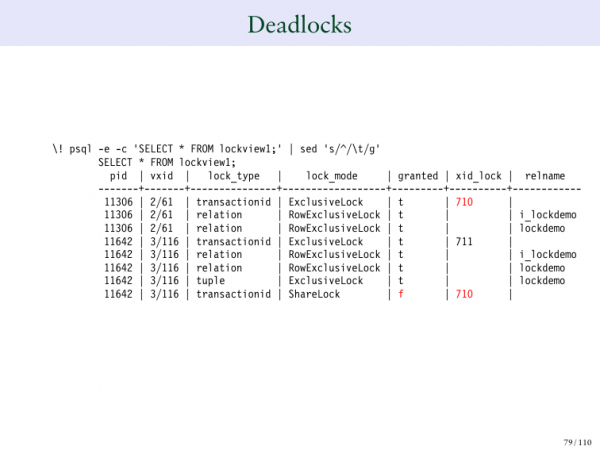
Și așa va arăta. Deci 710 are blocarea rândului, iar 711 așteaptă confirmarea. Am văzut acest lucru când am actualizat. 710 este proprietarul rândului nostru. Iar 711 așteaptă ca 710 să finalizeze tranzacția.
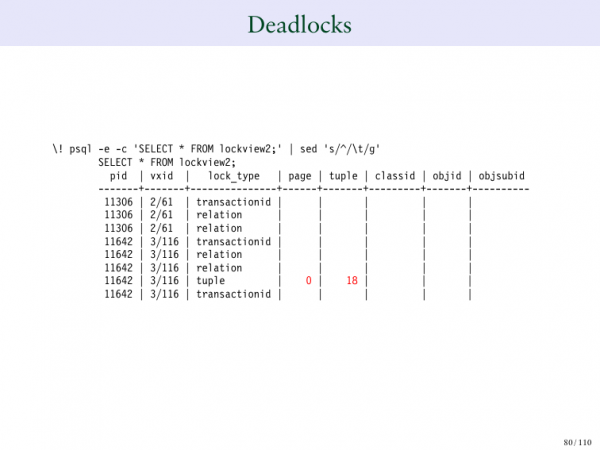
Și este chiar scris pe ce rând exact avem deadlocks. Și aici devine ciudat.
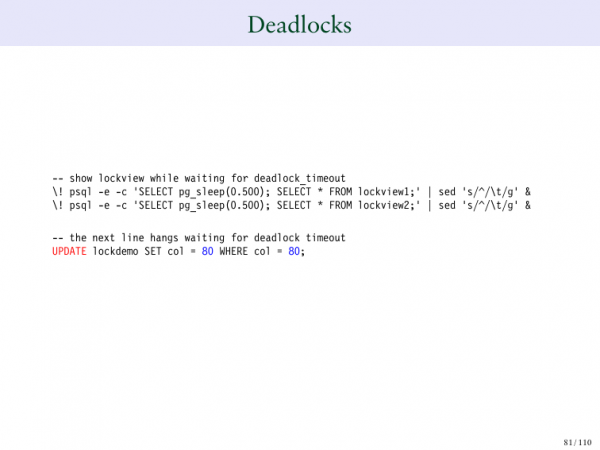
Acum actualizăm 80 la 80.
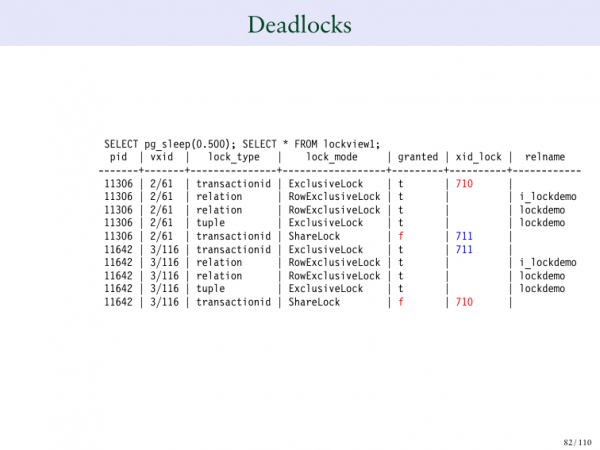
Și aici începe problema blocajelor. 710 așteaptă un răspuns de la 711, iar 711 așteaptă de la 710. Și acest lucru nu se va termina bine. Și nu există o soluție. Și ei vor aștepta să primească răspuns unul de la celălalt.
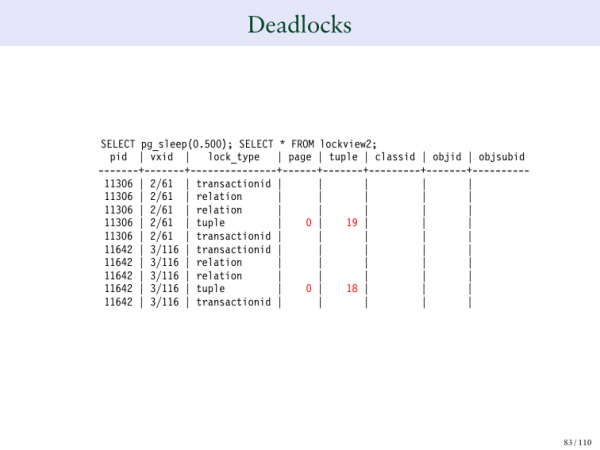
Și acest lucru va începe să întârzie totul. Și nu ne dorim asta.
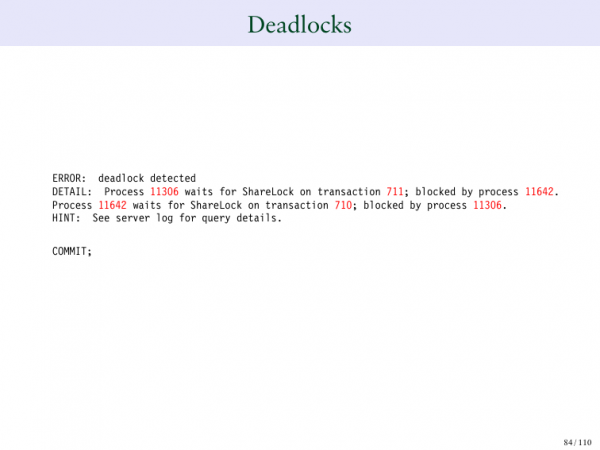
Și în Postgres există modalități de a observa când se întâmplă acest lucru. Și când se întâmplă, obțineți această eroare. Și din aceasta reiese că un anumit proces așteaptă un SHARE LOCK de la un alt proces, adică care este blocat de procesul 711. Iar acel proces aștepta să fie acordat un SHARE LOCK pentru un anumit ID de tranzacție și a fost blocat de un anume proces. Prin urmare, avem o situație de blocare moartă.
Dar există blocaje de tip trei? Este posibil? Da.
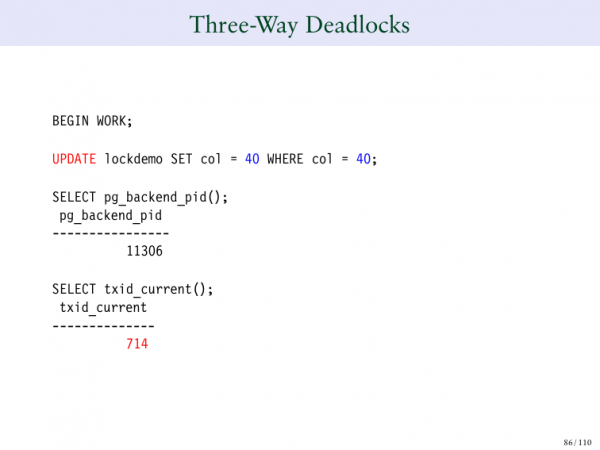
Introducem aceste numere în tabel. Schimbăm 40 cu 40, facem blocaj.
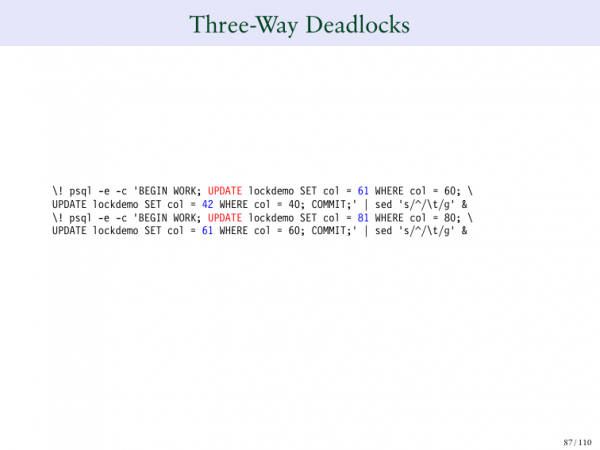
Schimbăm 60 cu 61, 80 cu 81.
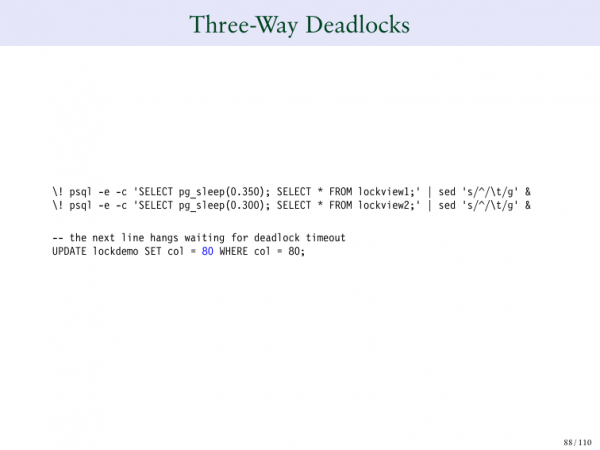
Și apoi schimbăm 80, iar apoi – bum!
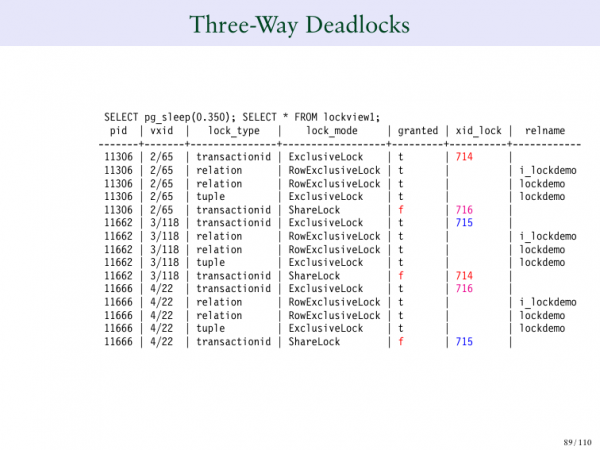
Și 714 acum așteaptă 715. 716 așteaptă 715. Și cu asta nu mai poți face nimic.
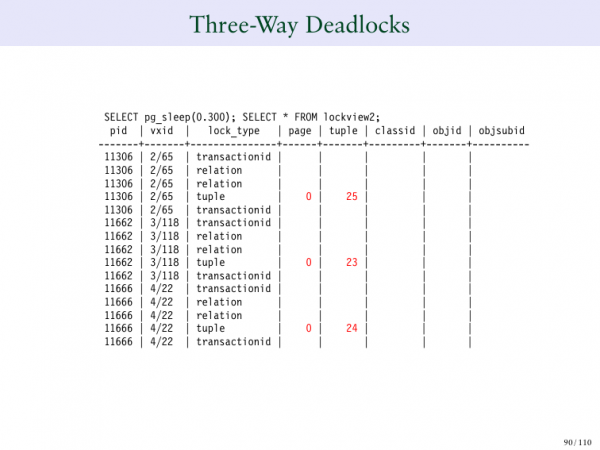
Aici nu mai sunt doar două persoane, ci trei. Eu vreau ceva de la tine, acesta vrea ceva de la a treia persoană, iar a treia persoană vrea ceva de la mine. Și ajungem într-o stare de așteptare circulară, pentru că toți așteptăm ca celălalt să termine ceea ce trebuie să facă.
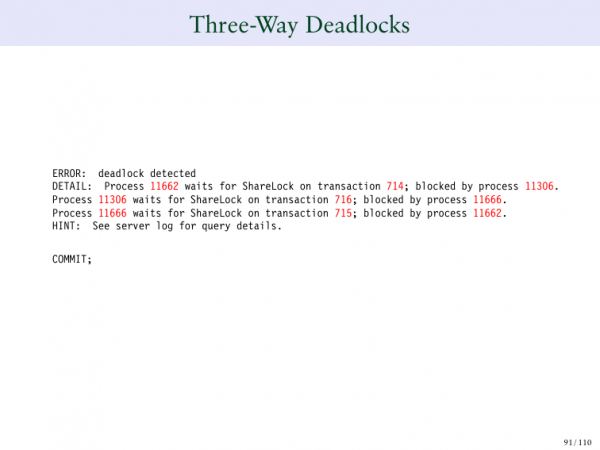
Și Postgres știe pe ce rând se întâmplă asta. Și din acest motiv, îți va oferi următorul mesaj care arată că ai o problemă, unde cele trei intrări se blochează reciproc. Și nu există limitări. Acest lucru se poate întâmpla în cazul în care 20 de înregistrări se blochează între ele.
Problema următoare este serializabila.
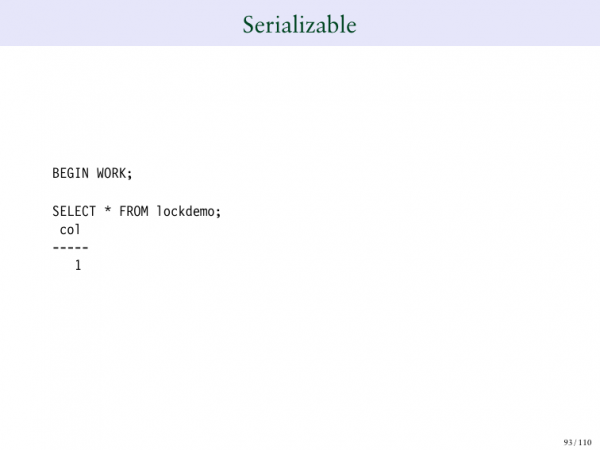
Dacă există un blocaj serializabil special.
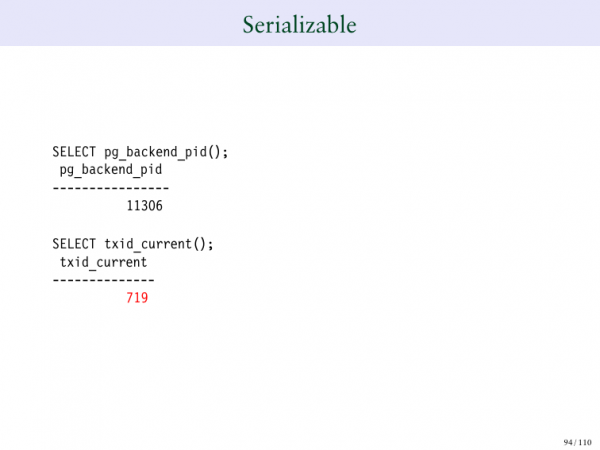
Și revenim la 719. Are o ieșire complet normală.
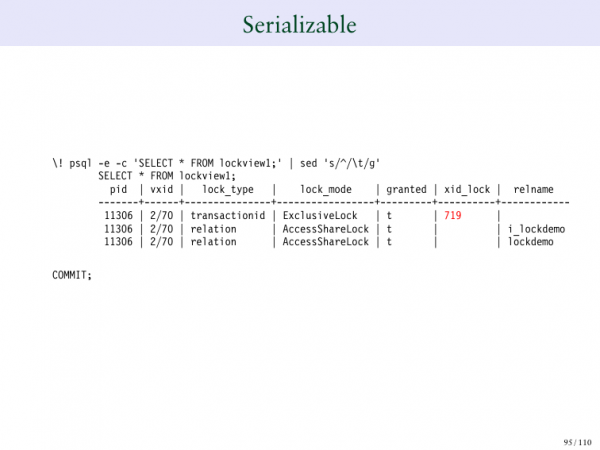
Și poți apăsa pentru a face o tranzacție din serializabil.
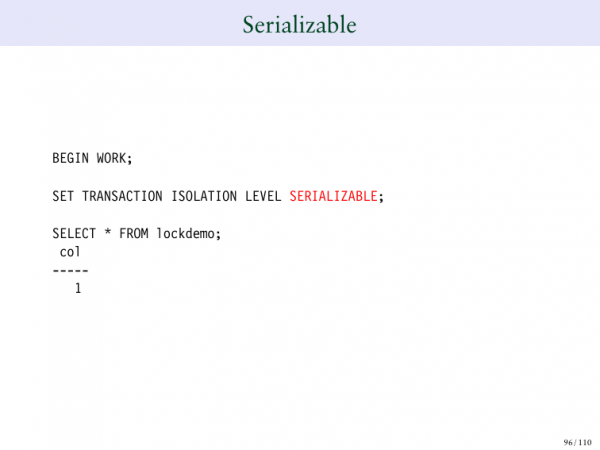
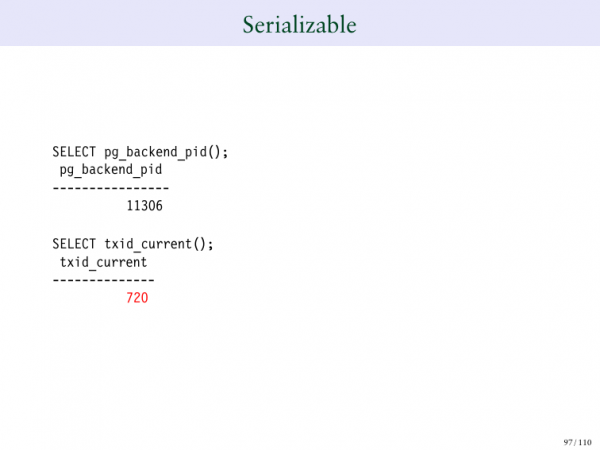
Și îți dai seama că acum ai un alt tip de blocaj SA - aceasta înseamnă serializabil.
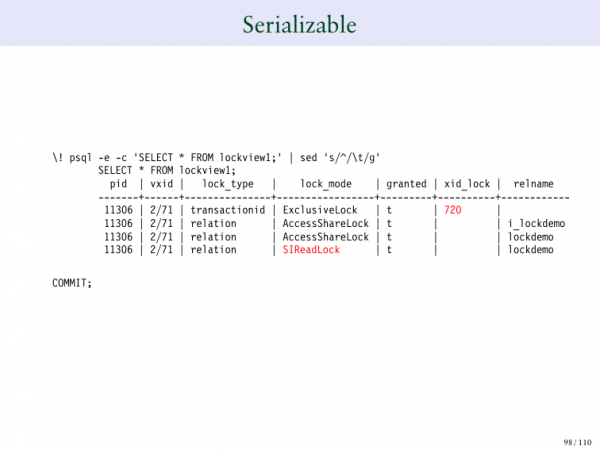
Și prin urmare avem un nou tip de blocaj numit SARieadLock, care este un blocaj serial și permite introducerea de numere seriale.
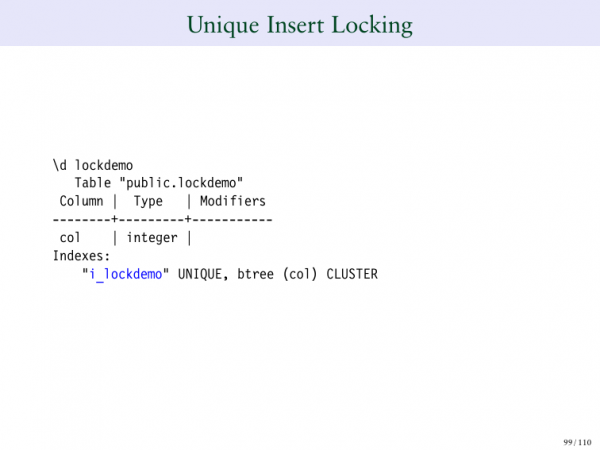
Și de asemenea, poți insera indecși unici.
În acest tabel avem indecși unici.
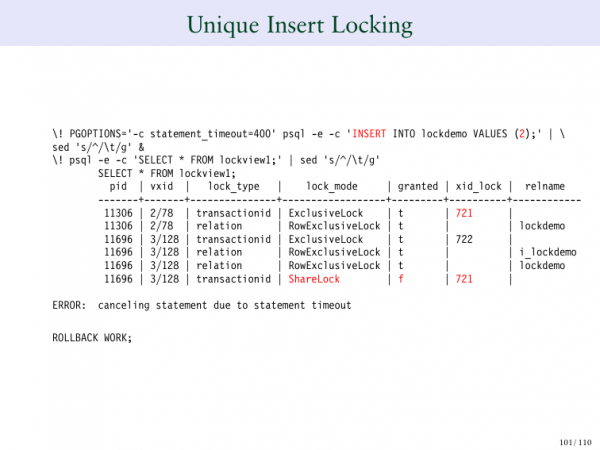
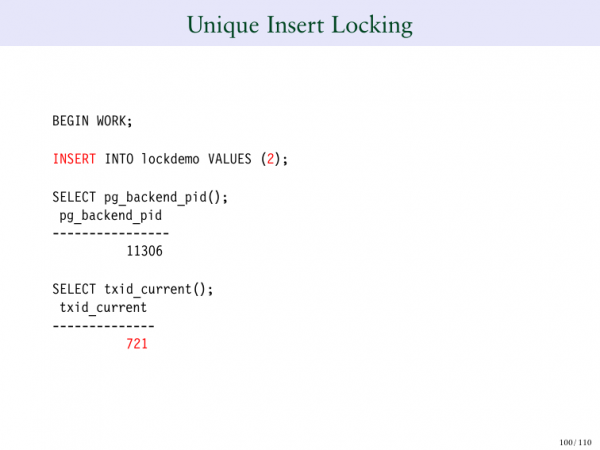
Prin urmare, dacă introduc aici numărul 2, am 2. Dar în vârful listei introduc încă un 2. Și poți vedea că 721 are un blocaj exclusiv. Dar acum 722 așteaptă ca 721 să finalizeze operația, pentru că nu poate insera 2 până când nu știe ce se va întâmpla cu 721.
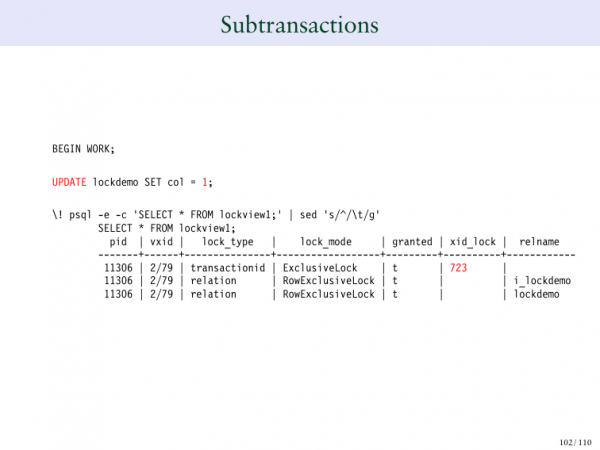
Și dacă facem o subtranzacție.
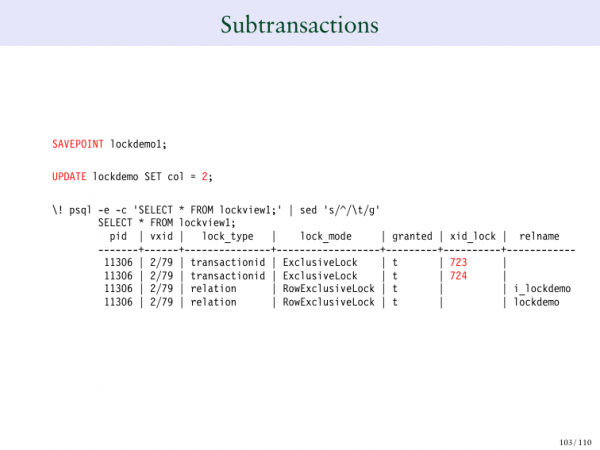
Iată-ne 723.
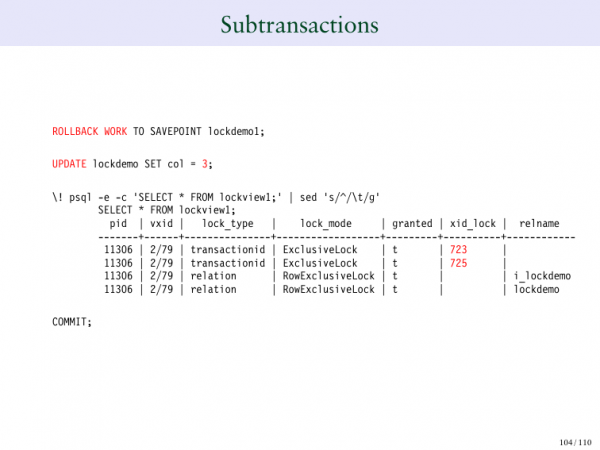
Dacă păstrăm un punct și apoi îl actualizăm, obținem un nou ID de tranzacție. Aceasta este încă o caracteristică pe care trebuie să o cunoașteți. Dacă întoarcem acest lucru, ID-ul de tranzacție se pierde. 724 se pierde. Dar acum avem 725.
Și ce încerc eu să fac aici? Încerc să vă arăt exemple de blocări neobișnuite pe care le puteți găsi: fie că sunt blocări serializabile sau SAVEPOINT – acestea sunt tipuri diferite de blocări care vor apărea în tabelul de blocări.
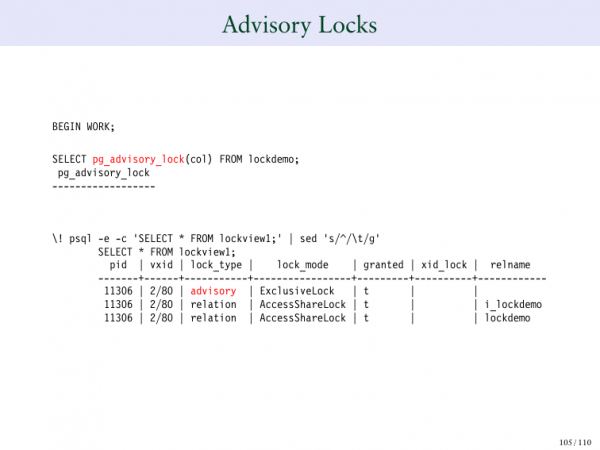
Acesta este un exemplu de blocări explicite, care au pg_advisory_lock.
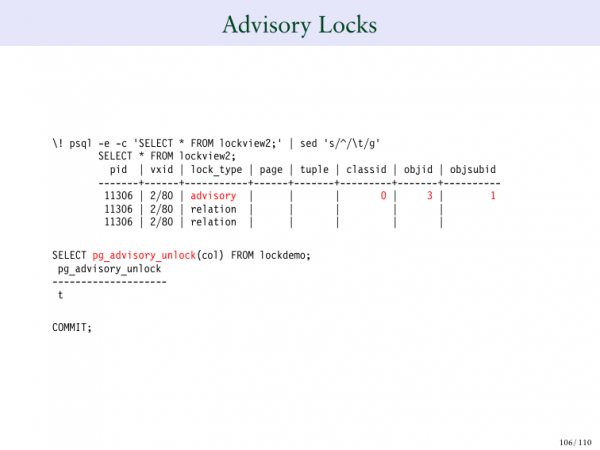
Și veți vedea că tipul blocării este listat ca advisory. Și este scris cu roșu „advisory”. Și puteți bloca simultan cu pg_advisory_unlock.
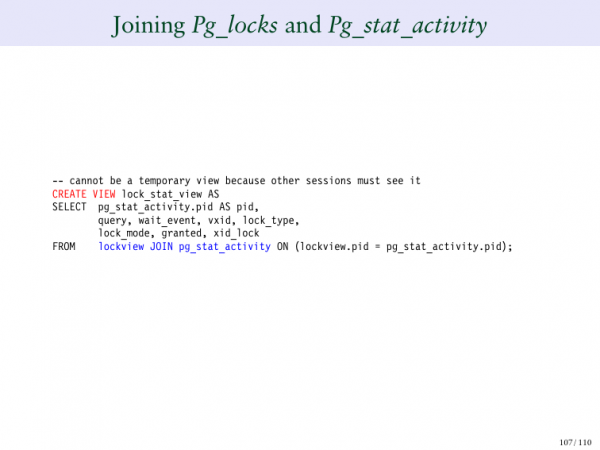
Și pentru a încheia, aș dori să vă arăt încă o chestie fascinantă. Voi crea un alt tip. Dar voi conecta tabelul pg_locks cu tabelul pg_stat_activity. De ce vreau să fac asta? Pentru că îmi va permite să văd toate sesiunile curente și să observ ce fel de blocări așteaptă. Și este suficient de interesant când adunăm laolaltă tabelul de blocări și tabelul de interogări.
Și aici creăm pg_stat_view.
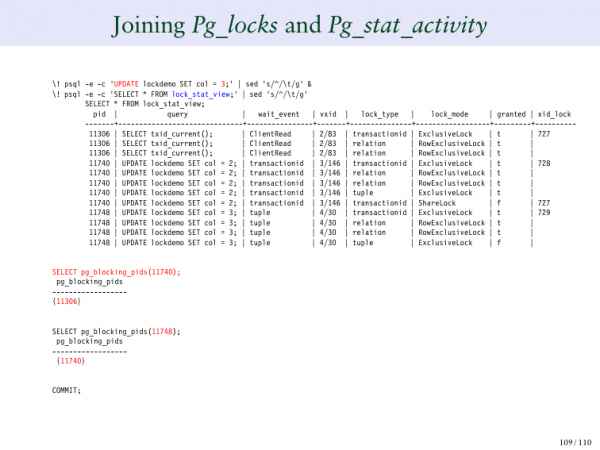
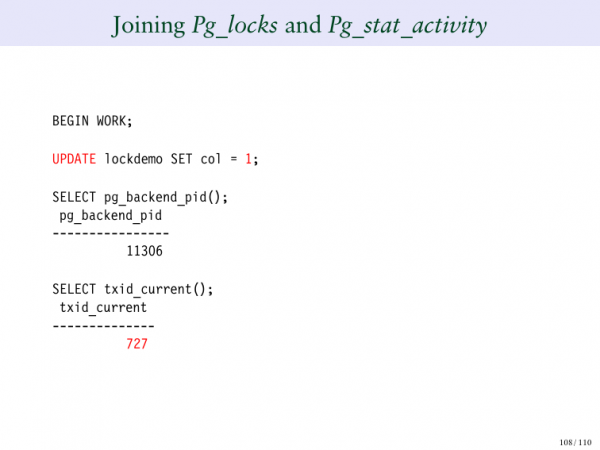
Și actualizăm un rând cu unul. Și aici vedem 724. Apoi actualizăm rândul nostru la trei. Și ce observați aici acum? Acestea sunt interogările, adică vedeți întreaga listă de interogări enumerate în coloana din stânga. Apoi, în partea dreaptă, puteți vedea blocările și ceea ce generează acestea. Și poate fi mai clar pentru voi, astfel încât să nu fie necesar să vă întoarceți de fiecare dată la fiecare sesiune pentru a vedea dacă trebuie să vă alăturați sau nu. Acest lucru se face pentru noi.
O altă funcție care este foarte utilă este pg_blocking_pidsProbabil că nu ați auzit niciodată de aceasta. Ce face? Ea ne permite să spunem că pentru această sesiune 11740, ce ID-uri de procese așteaptă. Și puteți vedea că 11740 așteaptă 724. Iar 724 este în partea de sus. Prozesele ID sunt 11306. Practic, această funcție parcurge tabelul vostru de blocări. Știu că este puțin complicat, dar reușiți să înțelegeți. Practic, funcția trece prin acest tabel de blocări și încearcă să găsească unde este procesul ID, luând în considerare blocajele pe care le așteaptă. De asemenea, încearcă să calculeze ce proces ID are procesul care așteaptă blocajele. Așadar, puteți rula această funcție. pg_blocking_pids.
Și asta poate fi foarte util. Am adăugat asta doar începând cu versiunea 9.6, așa că această funcție are doar 5 ani, dar este extrem de utilă. Și același lucru se aplică și celei de-a doua interogări. Arată exact ceea ce trebuie să vedem.
Acesta este subiectul despre care am vrut să discut cu voi. Și, după cum m-am așteptat, ne-am folosit tot timpul, deoarece au fost atât de multe slide-uri. Slide-urile sunt disponibile pentru descărcare. Aș dori să vă mulțumesc că ați fost aici. Sunt sigur că vă va plăcea restul conferinței, vă mulțumesc mult!
Întrebări:
De exemplu, dacă încerc să actualizez linii, iar a doua sesiune încearcă să șteargă întreaga masă. Din câte înțeleg, ar trebui să existe ceva de genul intent lock. Există așa ceva în Postgres?
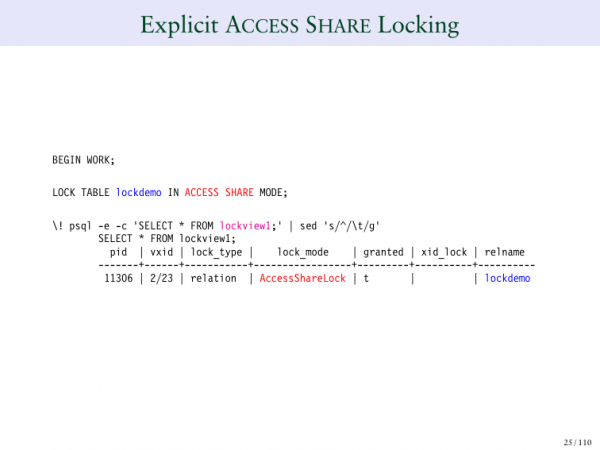
Să ne întoarcem la început. Poate vă amintiți că atunci când faceți orice, de exemplu, când faceți SELECT, emit un AccessShareLock. Acesta previne ștergerea tabelului. Așadar, dacă, de exemplu, doriți să actualizați o linie din tabel sau să ștergeți o linie, cineva nu poate șterge întreaga masă simultan cu asta, deoarece dețineți acest AccessShareLock pe întreaga masă și pe linie. Și imediat ce ați terminat, pot să o șteargă. Dar cât timp modificați ceva acolo, nu vor putea face asta.
Hai să mai facem o dată. Să trecem la exemplul cu ștergerea. Și vezi cum pe linie este un lock exclusiv pe întreaga masă.
Asta va arăta ca un lock exclusiv, corect?
Da, asta pare a fi cazul. Înțeleg despre ce vorbești. Spui că, dacă fac un SELECT, voi avea ShareExclusive, iar apoi transform acest lucru într-o stare Row Exclusive, devine asta o problemă? Dar, spre surprinderea mea, aceasta nu creează o problemă. Este asemănător cu o creștere a gradului de blocare, dar, în esență, am un lock care împiedică ștergerea. Și acum, când fac acest lock mai puternic, acesta încă împiedică ștergerea. Așadar, nu este ca și când mă ridic la un nivel superior. Adică, acesta prevenea deja asta și când era la un nivel mai mic, așa că, atunci când îi înalț nivelul, acesta încă împiedică ștergerea tabelului.
Înțeleg despre ce vorbești. Aici nu este un caz de creștere a gradului de blocare, în care încerci să renunți la o blocare pentru a introduce una mai puternică. Aici acesta pur și simplu crește în mod uniform această prevenire, deci nu provoacă niciun conflict. Dar este o întrebare bună. Îți mulțumesc mult că ai pus-o!
Ce trebuie să facem pentru a evita situația de deadlock, când avem multe sesiuni, un număr mare de utilizatori?
Postgres observă automat situațiile de deadlock. Și va elimina automat una dintre sesiuni. Singura modalitate de a evita situațiile de deadlock este să bloci oamenii în aceeași ordine. Așadar, când te uiți la aplicația ta, de obicei motivul pentru deadlocks… Să ne imaginăm că vreau să blochez două lucruri diferite. O aplicație blochează tabelul 1, iar cealaltă aplicație blochează 2, iar apoi tabelul 1. Și cea mai simplă modalitate de a evita deadlocks este să te uiți la aplicația ta și să încerci să te asiguri că blocarea se face în aceeași ordine în toate aplicațiile. Și aceasta, de regulă, elimină 80% din probleme, deoarece oameni diferiți scriu aceste aplicații. Și dacă le blochezi în aceeași ordine, nu te confrunți cu o situație de deadlock.
Îți mulțumesc mult pentru prezentarea ta! Ai vorbit despre vacuum full și, dacă înțeleg corect, vacuum full deformează ordinea înregistrărilor într-un spațiu de stocare separat, astfel încât păstrează înregistrările actuale neschimbate. De ce vacuum full necesită o blocare exclusivă și de ce interferează cu operațiunile de scriere?
Este este o întrebare bună. Motivul este că vacuum full preia tabela. Și, practic, creăm o nouă versiune a tabelei. Astfel, tabela va fi una nouă. Rezultă că aceasta va fi o versiune complet nouă a tabelei. Problema este că, atunci când facem asta, nu vrem ca oamenii să o citească, deoarece trebuie ca ei să vadă noua tabelă. Așadar, aceasta se leagă de întrebarea anterioară. Dacă am putea citi în același timp, nu am putea să o mutăm și să îndrumăm oamenii spre noua tabelă. Ar trebui să așteptăm ca toată lumea să termine de citit această tabelă și, prin urmare, aceasta este, în esență, o situație de blocare exclusivă.
Pur și simplu spunem că blocăm de la început, deoarece știm că, la final, ne va trebui o blocare exclusivă pentru a muta pe toată lumea pe o nouă copie. Așadar, potențial, putem permite asta. Și facem asta cu indexare simultană. Dar este mult mai complicat de realizat. Și se leagă foarte mult de întrebarea ta anterioară despre blocarea exclusivă.
Este posibil să adaugi un timeout pentru blocare în Postgres? În Oracle, pot, de exemplu, să scriu „select for update” și să aștept 50 de secunde până la actualizare. Acest lucru era bun pentru aplicație. Dar în Postgres trebuie fie să faci asta imediat și să nu aștepți deloc, fie să aștepți până la un moment dat.
Da, poți alege un timeout pentru blocările tale, pentru locks. De asemenea, poți emite comanda no way, care va fi …, dacă nu poți obține blocarea imediat. Așadar, fie lock timeout, fie altceva care îți va permite să faci asta. Nu se face la nivel sintactic. Se face ca o variabilă pe server. Uneori nu poate fi utilizată.
Poți deschide diapozitivul 75?
Da.
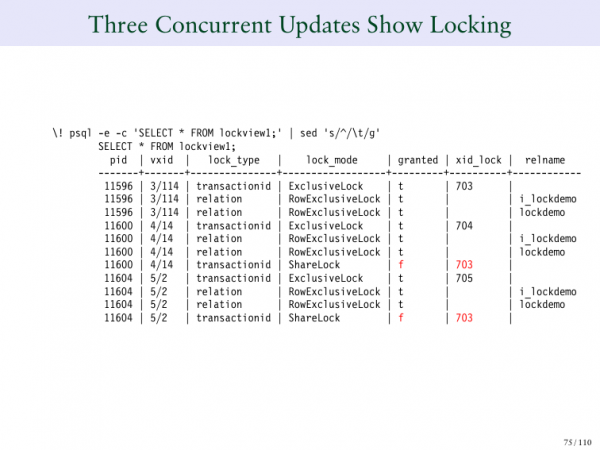
Și întrebarea mea este următoarea. De ce ambele procese de actualizare așteaptă 703?
Și aceasta este o întrebare excelentă. Nu înțeleg, de altfel, de ce Postgres face asta. Dar când 703 a fost creat, acesta a așteptat 702. Iar când 704 și 705 apar, se pare că nu știu ce așteaptă, pentru că nu este nimic acolo. Și Postgres face asta astfel: când nu poți obține un blocaj, spune „Care este sensul să te procesez?”, pentru că tu oricum aștepți pe cineva. Așadar, să-l lăsăm să rămână în suspans, nu-l actualizează deloc. Dar ce s-a întâmplat aici? De îndată ce 702 a terminat procesul și 703 a obținut blocajul său, sistemul s-a întors. Și a spus că acum avem două persoane care așteaptă. Și apoi să le actualizăm împreună. Și să indicăm că ambele așteaptă.
Nu știu de ce Postgres face așa. Dar există o problemă numită f…. Mi se pare că acest termen nu există în limba română. Este atunci când toți așteaptă un singur blocaj, chiar și atunci când sunt 20 de instanțe care așteaptă blocajul. Și dintr-o dată, toți se trezesc simultan. Și toți încep să încerce să reacționeze. Dar sistemul face astfel încât toți așteaptă 703. Pentru că toți așteaptă și noi îi așezăm imediat într-o linie. Și dacă apare o altă cerere nouă, care a fost formulată după aceasta, de exemplu, 707, atunci va fi din nou un vid.
Și mi se pare că acest lucru se face pentru a putea spune că în acest moment 702 așteaptă 703, iar toți cei care vin după aceasta nu vor avea nicio înregistrare în acest câmp. Dar de îndată ce primul care aștepta pleacă și toți cei care așteptau în acel moment înainte de actualizare primesc același marcaj. Și din acest motiv, mi se pare că acest lucru este înfăptuit pentru a putea procesa în ordine, astfel încât să fie corect organizate.
Întotdeauna am privit asta ca pe un fenomen destul de straniu. Pentru că aici, de exemplu, nu-i enumerăm deloc. Dar, mi se pare că de fiecare dată când dăm un nou lock, ne uităm la toți cei care sunt în proces de așteptare. Atunci, îi așezăm pe toți într-o linie. Iar orice nou venit care apare este inclus în linie doar atunci când următoarea persoană a terminat de procesat. O întrebare foarte bună. Vă mulțumesc foarte mult pentru întrebare!
Mi se pare mult mai logic atunci când 705 așteaptă 704.
Dar problema este că, din punct de vedere tehnic, puteți trezi fie unul, fie celălalt. Așadar, vom trezi unul sau altul. Dar ce se întâmplă în funcționarea sistemului? Vedeți cum 703, în partea de sus, și-a blocat propriul ID de tranzacție. Așa funcționează Postgres. Și 703 se blochează cu propriul ID de tranzacție, așa că, dacă cineva vrea să aștepte, va aștepta 703. Și, în esență, 703 finalizează. Și doar după ce se finalizează, un anumit proces se trezește. Și nu știm care va fi acela. Apoi le procesăm gradual. Dar nu este clar care proces se trezește primul, pentru că poate fi oricare dintre aceste procese. Practic, am avut un planificator care spunea că acum putem trezi oricare dintre aceste procese. Alegem pur și simplu unul la întâmplare. De aceea, ambele trebuie marcate, pentru că putem trezi oricare dintre ele.
Și problema este că avem CP-infinit. Astfel, este foarte probabil să putem trezi unul mai recent. Și, dacă, de exemplu, vom trezi unul mai recent, ne vom aștepta la cel care tocmai a primit blocajul, așa că nu definim cu exactitate cine va fi trezit primul. Cream pur și simplu o astfel de situație, iar sistemul îi va trezi în ordine aleatorie.
Există . Uitați-vă, acestea sunt de asemenea interesante și utile. Tema este, desigur, extrem de complexă. Vă mulțumesc foarte mult, Bruce!
Sursa: habr.com
