

Povestea
Fiind un pasionat de hardware retro, am achiziționat odată un ZX Spectrum+ de la un vânzător din Marea Britanie. Împreună cu computerul, am primit câteva casete audio cu jocuri (în ambalajul original cu instrucțiuni) și, de asemenea, programe, înregistrate pe casete fără o marcajare specială. Spre surprinderea mea, datele de pe casete, vechi de 40 de ani, s-au citit bine și am reușit să încarc aproape toate jocurile și programele de pe ele.
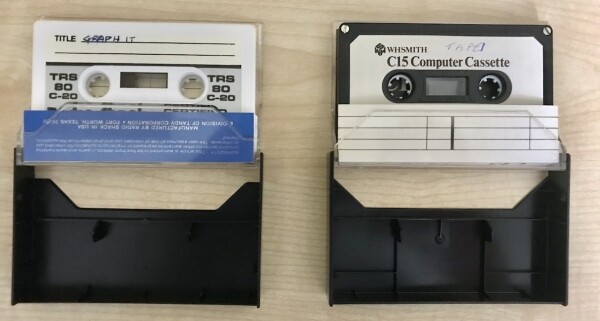
Cu toate acestea, pe unele casete am descoperit înregistrări care, evident, nu erau realizate de computerul ZX Spectrum. Acestea aveau un sunet complet diferit și, spre deosebire de înregistrările de pe computerul menționat, nu începeau cu un scurt loader BASIC, care, de obicei, este prezent în toate înregistrările de programe și jocuri.
O perioadă, acest lucru m-a făcut să mă simt neliniștit — eram foarte curios să știu ce se ascunde în ele. Dacă aș putea citi semnalul audio ca o succesiune de biți, aș putea căuta caractere sau ceva ce indică originea semnalului. O formă de arheologie retro.
Acum, când am parcurs tot acest drum și privesc etichetele casetelor, zâmbesc, pentru că
răspunsul a fost chiar în fața ochilor mei tot timpul
Pe eticheta casetei din stânga se află numele computerului TRS-80, iar puțin mai jos numele producătorului: „Manufactured by Radio Shack in USA”
(Dacă doriți să mențineți suspansul până la final, nu intrați sub spoiler)
Comparația semnalelor audio
În primul rând, să digitizăm înregistrările audio. Puteți asculta cum sună:
Și cum sună înregistrarea de la computerul ZX Spectrum:
În ambele cazuri, la începutul înregistrării este prezentă așa-numita ton pilot — sunet de o frecvență (în prima înregistrare este foarte scurt <1 sec, dar detectabil). Tonul pilot servește ca semnal pentru computer că trebuie să se pregătească pentru primirea datelor. De obicei, fiecare computer recunoaște doar „tonul pilot” propriu prin forma semnalului și frecvența acestuia.
Trebuie să menționăm forma semnalului. De exemplu, la ZX Spectrum, forma acestuia este dreptunghiulară:
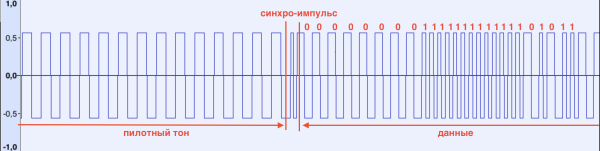
Atunci când detectează tonul pilot, ZX Spectrum afișează dungi alternante roșii și albastre pe partea bordurii ecranului, indicând că semnalul a fost recunoscut. Tonul pilot se încheie cu un impuls de sincronizare, care semnalizează computerului că trebuie să înceapă să primească date. Acesta se caracterizează printr-o durată mai mică (comparativ cu tonul pilot și datele ulterioare) (vezi figura)
După ce sincronizarea impulsului este primită, computerul înregistrează fiecare creștere/scădere a semnalului, măsurând durata acestuia. Dacă durata este mai mică decât o limită prestabilită, în memorie se înregistrează bitul 1, altfel 0. Bitele sunt adunate în octeți și procesul se repetă până când sunt obținuți N octeți. Numărul N este, de obicei, luat din antetul fișierului încărcat. Secvența de încărcare este următoarea:
- ton pilot
- antet (de lungime fixă), conține dimensiunea datelor încărcate (N), numele și tipul fișierului
- ton pilot
- datele propriu-zise
Pentru a asigura că datele sunt încărcate corect, ZX Spectrum citește ultimul octet cunoscut sub numele de octet de paritate care este calculat la salvarea fișierului prin operația XOR asupra tuturor octeților de date înregistrate. La citirea fișierului, computerul calculează octetul de paritate din datele primite și, dacă rezultatul diferă de cel salvat, afișează un mesaj de eroare „R Tape loading error”. Strict vorbind, computerul poate emite acest mesaj și mai devreme, dacă în timpul citirii nu poate recunoaște impulsul (fie a fost pierdut, fie durata sa nu corespunde unor limite prestabilite)
Acum să vedem cum arată un semnal necunoscut:
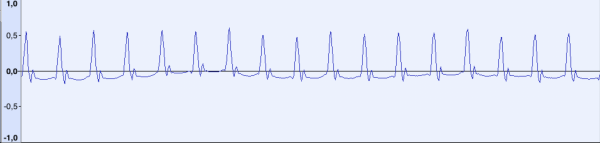
Acesta este tonul pilot. Forma semnalului diferă semnificativ, dar se observă că semnalul este format din impulsuri scurte repetate de o anumită frecvență. La o frecvență de eșantionare de 44100 Hz, distanța dintre „vârfuri” este de aproximativ 48 de eșantioane (ceea ce corespunde unei frecvențe de ~918 Hz). Să reținem acest număr.
Acum să ne uităm la un fragment cu date:
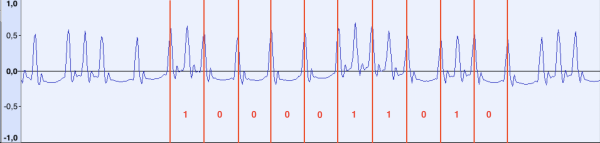
Dacă măsurăm distanța dintre impulsurile individuale, se va dovedi că între impulsurile „lungi”, distanța rămâne de aproximativ ~48 de eșantioane, iar între cele scurte — ~24. Atrag atenția că, în cele din urmă, s-a descoperit că impulsurile „de referință” cu frecvența de 918 Hz urmează continuu, de la început până la sfârșitul fișierului. Se poate presume că, în timpul transmisiei de date, dacă între impulsurile de referință apare un impuls suplimentar, considerăm că este un bit 1, altfel 0.
Ce este cu sincronizarea impulsului? Să ne uităm la începutul datelor:
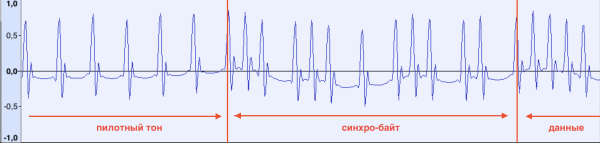
Tonul pilot se termină și imediat începe datele. Puțin mai târziu, analizând mai multe înregistrări audio diferite, am reușit să descoperim că primul byte de date este întotdeauna același (10100101b, A5h). Este posibil ca computerul să înceapă să citească datele după ce le-a primit.
De asemenea, se poate observa devierea primului impuls de referință imediat după ultima 1 din sincronizare. Acesta a fost descoperit semnificativ mai târziu în timpul dezvoltării programului pentru recunoașterea datelor, când datele de la începutul fișierului nu au putut fi citite în mod stabil.
Acum vom încerca să descriem algoritmul care va procesa fișierul audio și va încărca datele.
Încărcarea datelor
Mai întâi, vom lua în considerare câteva presupuneri pentru a nu complica algoritmul:
- Vom considera fișierele doar în format WAV;
- Fișierul audio trebuie să înceapă cu tonul pilot și să nu conțină tăcere la început.
- Fișierul original trebuie să aibă o frecvență de eșantionare de 44100 Hz. În acest caz, distanța dintre impulsurile de referință de 48 de eșantioane este deja definită și nu trebuie să o calculăm programatic;
- Formatul eșantioanelor poate fi oricare (8/16 biți/sau cu virgulă mobilă) - deoarece la citire putem să-l convertim în cel necesar;
- Presupunem că fișierul original este normalizat pe amplitudine, ceea ce ar trebui să stabilizeze rezultatul;
Algoritmul de citire va fi următorul:
- Cităm fișierul în memorie, simultan convertind formatul eșantioanelor în 8 biți;
- Determinăm poziția primului impuls în datele audio. Pentru aceasta, trebuie să calculăm numărul eșantionului cu amplitudinea maximă. Pentru simplificare, îl vom număra o singură dată manual. Vom salva în variabila prev_pos;
- Adăugăm la poziția ultimului impuls 48 (pos := prev_pos + 48)
- Deoarece creșterea poziției cu 48 nu garantează că vom ajunge în poziția următorului impuls de referință (defecte ale benzii, funcționare instabilă a mecanismului de transportare a benzii etc.), este necesar să corectăm poziția impulsului pos. În acest scop, vom lua un mic segment de date (pos-8;pos+8) și vom găsi maximul valorii amplitudinii pe acesta. Poziția corespunzătoare maximului va fi salvată în pos. Aici, 8 = 48/6 — o constantă obținută experimental, care garantează că vom determina corect maximul și nu vom afecta alte impulsuri care pot fi adiacente. În cazuri foarte rele, când distanța între impulsuri este semnificativ mai mică sau mai mare decât 48, se poate realiza o căutare forțată a impulsului, dar în cadrul acestui articol nu voi descrie acest lucru în algoritm.
- În pasul anterior, este de asemenea necesar să verificăm că impulsul de referință a fost găsit. Adică, dacă căutăm pur și simplu maximul, aceasta nu garantează că impulsul este prezent în acest segment. În ultima mea implementare a programului de citire, verific diferența între valoarea maximă și cea minimă a amplitudinii pe segment, iar dacă depășește o anumită limită, consider că impulsul este prezent. De asemenea, este întrebarea ce să facem dacă impulsul de referință nu este găsit. Aici sunt două opțiuni: fie datele s-au terminat și urmează tăcerea, fie aceasta trebuie considerată o eroare de citire. Totuși, să ignorăm acest lucru pentru simplificarea algoritmului.
- În pasul următor, este necesar să determinăm prezența impulsului de date (bit 0 sau 1), pentru aceasta vom lua mijlocul segmentului (prev_pos;pos) middle_pos egal cu middle_pos := (prev_pos+pos)/2 și în jurul middle_pos pe segmentul (middle_pos-8;middle_pos+8) vom calcula maximul și minimul amplitudinii. Dacă diferența dintre ele este mai mare de 10, vom înregistra în rezultat bit 1, altfel 0. 10 este o constantă obținută empiric.
- Salvăm poziția curentă în prev_pos (prev_pos := pos)
- Repetăm începând cu pasul 3, până citim întregul fișier;
- Bit array obtained must be saved as a byte set. Since we didn't account for sync bytes while reading, the number of bits may not be a multiple of 8, and the necessary bit offset is also unknown. In the initial implementation of the algorithm, I was unaware of the existence of the sync byte and just saved 8 files with different bit offsets. One of them contained correct data. In the final algorithm, I simply remove all bits up to A5h, which allows me to immediately obtain a correct output file.
Algorithm in Ruby, for those interested.
I chose Ruby as the programming language because I spend most of my time programming in it. The option is not high-performance, however, the goal is not to make reading speed maximally fast.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Rezultatul
After trying several algorithm variants and constants, I was lucky to obtain something extremely interesting:
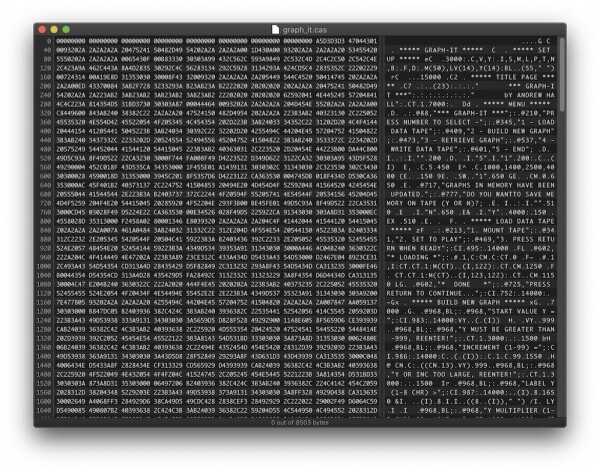
So, judging by the character strings, we have a program for plotting graphs. However, the program text lacks keywords. All keywords are encoded as bytes (each value > 80h). Now we need to find out which computer from the 80s could save programs in such a format.
Actually, it closely resembles a program in BASIC language. The ZX Spectrum computer stores programs in memory and saves them to tape in a similar format. Just in case, I checked the keywords against However, the result was obviously negative.
I also checked the BASIC keywords of popular computers of the time, such as Atari, Commodore 64, and several others for which I could find documentation, but unsuccessfully — my knowledge of retro-computer varieties was not extensive enough.
Then I decided to follow the , and my gaze fell on the manufacturer name Radio Shack and the computer TRS-80. Those names were actually written on the cassette labels that were on my desk! I had not known those names before and was not familiar with the TRS-80, so I thought Radio Shack was an audio cassette manufacturer like BASF, Sony, or TDK, and TRS-80 referred to playback duration. Why not?
Tandy/Radio Shack TRS-80 computer.
It is very likely that the audio recording I provided as an example at the beginning of the article was made on such a computer:
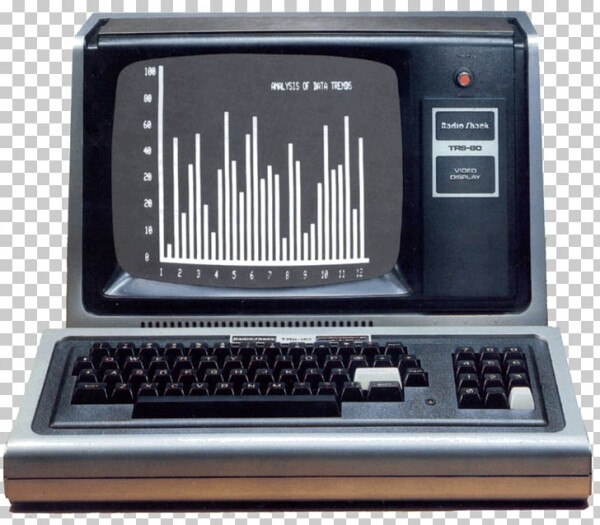
S-a dovedit că acest computer și variantele sale (Model I/Model III/Model IV etc.) au fost foarte populare la vremea lor (desigur, nu în Rusia). Este notabil că procesorul folosit în ele era tot Z80. Pe acest computer, pe internet se pot găsi . În anii '80, informațiile despre computer se răspândeau în . În prezent, există mai multe ale computerului pentru diferite platforme.
Am descărcat emulatorul și mi-a fost dat pentru prima dată să văd cum funcționa acest computer. Desigur, computerul nu suporta ieșirea de culoare, rezoluția ecranului fiind de doar 128x48 puncte, dar existau multe extensii și modificări care puteau crește rezoluția ecranului. De asemenea, existau multe variante de sisteme de operare pentru acest computer și variante de implementare a limbajului BASIC (care, spre deosebire de ZX Spectrum, în unele modele nici măcar nu era 'încărcat' în ROM și orice variantă putea fi încărcată de pe dischetă, la fel ca și sistemul de operare)
Am găsit de asemenea pentru a converti înregistrările audio în format CAS, care este acceptat de emulatoare, totuși nu am reușit dintr-un anumit motiv să citesc înregistrările de pe casetele mele folosind acestea.
După ce am înțeles formatul fișierului CAS (care s-a dovedit a fi pur și simplu o copie bit cu bit a datelor de pe banda pe care o aveam deja, cu excepția antetului cu prezența unui byte de sincronizare), am făcut câteva modificări în programul meu și am reușit să obțin un fișier CAS funcțional, care a funcționat în emulator (TRS-80 Model III):
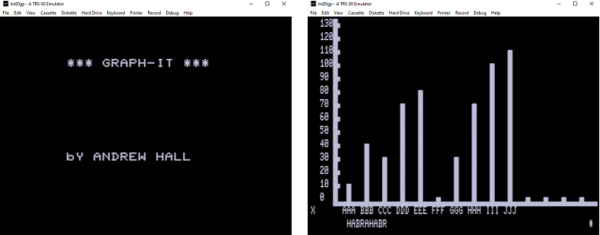
Ultima variantă a utilitarului pentru conversie cu detectarea automată a primului impuls și distanța dintre impulsurile de referință am realizat-o sub formă de pachet GEM, codul sursă fiind disponibil pe .
Concluzie
Drumul parcurs s-a dovedit a fi o călătorie captivantă în trecut, și sunt bucuros că în cele din urmă am găsit soluția. Pe lângă asta, eu:
- Am înțeles formatul de salvare a datelor în ZX Spectrum și am studiat subprogramele încorporate în ROM pentru salvarea/citirea datelor de pe casete audio.
- M-am familiarizat cu computerul TRS-80 și variantele sale, am studiat sistemul de operare, am văzut exemple de programe și chiar am avut ocazia să mă ocup de depanarea codului mașină (totuși, toate mnemonicele Z80 îmi sunt bine cunoscute).
- Am scris un utilitar complet pentru conversia înregistrărilor audio în format CAS, care poate citi datele nerecunoscute de utilitarul „oficial”
Sursa: habr.com
