

Monitorizarea a devenit o componentă esențială a soluțiilor cloud în creștere, pe măsură ce se complică sistemele distribuite. Este necesară pentru a înțelege comportamentul acestora. Sunt necesare instrumente scalabile care să poată colecta date din toate servicii - și să ofere specialiștilor o interfață unificată cu analiza performanței, demonstrarea erorilor, disponibilitatea și jurnalele.
Aceste instrumente trebuie să fie eficiente și performante. În acest articol, vom analiza două stive tehnologice populare: EFK (Elasticsearch) și PLG (Loki) și vom discuta arhitecturile și diferențele acestora.
Stiva EFK
Probabil că ați auzit deja despre foarte cunoscutul ELK sau EFK. Stiva este compusă din mai multe părți separate: Elasticsearch (stocare de obiecte), Logstash sau FluentD (colectarea și agregarea jurnalelor) și Kibana pentru vizualizare.
Schema tipică de funcționare arată astfel:
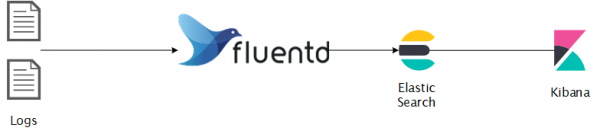
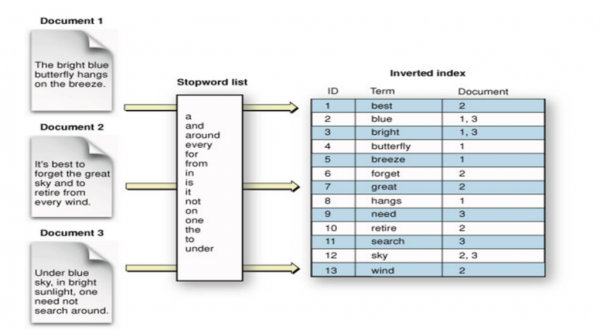
Elasticsearch — o stocare distribuită de obiecte cu căutare și analiză în timp real. O soluție excelentă pentru datele parțial structurate, cum ar fi jurnalele. Informațiile sunt păstrate sub formă de documente JSON, sunt indexate în timp real și distribuite între nodurile clusterei. Se utilizează un index inversat, care conține toate cuvintele unice și documentele asociate pentru căutarea completă în text, bazată pe motorul de căutare Apache Lucene.
FluentD — este un colector de date care realizează unificarea datelor în timpul colectării și consumului. Își propune să structureze datele în JSON cât mai mult posibil. Arhitectura sa este extensibilă, existând mai mult de , acceptate de comunitate, pentru toate ocaziile.
Kibana — un instrument de vizualizare a datelor pentru Elasticsearch cu diverse funcționalități suplimentare, cum ar fi analiza seriilor temporale, grafuri, învățare automată și alte caracteristici.
Arhitectura Elasticsearch
Datele clusterei Elasticsearch sunt stocate răspândite pe toate nodurile sale. Clustera constă din mai multe noduri pentru a îmbunătăți disponibilitatea și reziliența. Orice nod poate îndeplini toate rolurile clusterei, dar în desfășurările mari și scalabile, nodurilor li se atribuie de obicei sarcini separate.
Tipuri de noduri ale clusterei:
- nod master — gestionează clusterul, sunt necesare cel puțin trei, unul fiind întotdeauna activ;
- nod de date — stochează datele indexate și realizează diverse sarcini cu acestea;
- nod de ingestie — organizează canale pentru transformarea datelor înainte de indexare;
- nod de coordonare — rotează solicitările, scurtează faza de prelucrare a căutării, coordonează indexarea masivă;
- nod de alertă — inițiază sarcini de notificare;
- nod de învățare automatizată — prelucrează sarcinile de învățare automată.
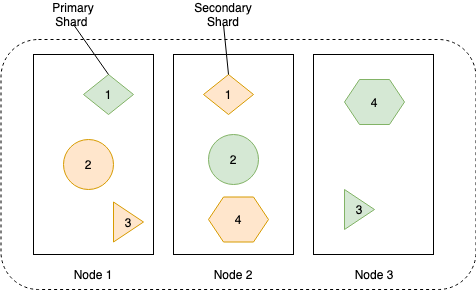
Diagrama de mai jos ilustrează modul în care datele sunt salvate și replicate între noduri pentru a asigura o disponibilitate mai mare a datelor.
Datele fiecărei replici sunt stocate într-un index inversat, schema de mai jos arată cum se desfășoară acest proces:
Instalare
Puteți vizualiza detaliile , voi folosi diagrama helm:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsStiva PLG
Nu vă mirați dacă nu puteți găsi acest acronim, căci este mai bine cunoscut ca Grafana Loki. Oricum, această stivă câștigă popularitate deoarece aplică soluții tehnice bine gândite. Poate ați auzit deja de Grafana, un instrument popular de vizualizare. Creatorii săi, inspirându-se din Prometheus, au dezvoltat Loki, un sistem de agregare a jurnalelor scalabil pe orizontală și performant. Loki indexează doar metadatele, nu și jurnalele în sine, această soluție tehnică a permis să fie simplu de utilizat și economic.
Promtail — agent pentru trimiterea jurnalelor din sistemul de operare în clusterul Loki. Grafana — instrument de vizualizare bazat pe date din Loki.
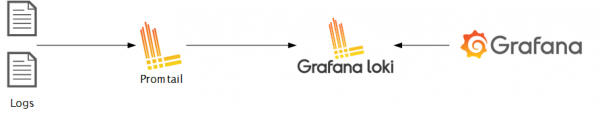
Loki este construit pe aceleași principii ca și Prometheus, astfel încât este bine adaptat pentru stocarea și analiza jurnalelor Kubernetes.
Arhitectura Loki
Loki poate fi rulat atât în modul unui singur proces, cât și în modul mai multor procese, asigurând scalabilitate orizontală.
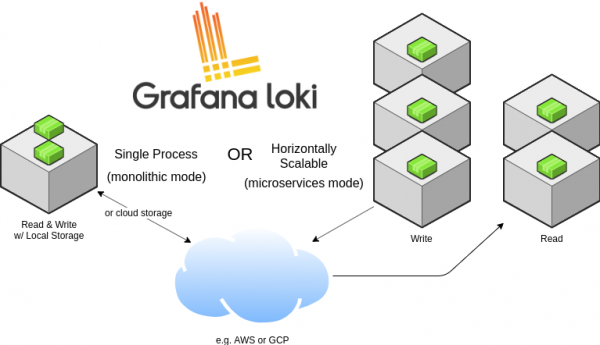
De asemenea, poate funcționa, atât ca o aplicație monolitică, cât și ca un microserviciu. Rularea ca un singur proces poate fi utilă pentru dezvoltarea locală sau pentru o supraveghere minoră. Pentru implementarea industrială și sarcinile scalabile, se recomandă utilizarea variantei de microserviciu. Cărțile de scriere și citire a datelor sunt separate, astfel încât aceasta poate fi ajustată și scalată în mod eficient, după cum este necesar.
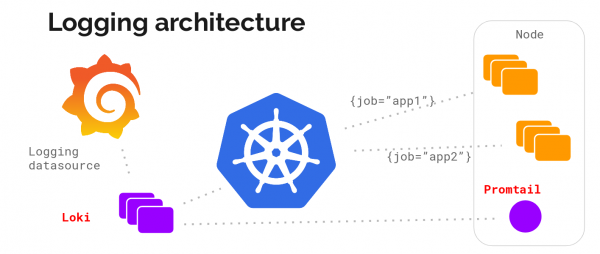
Să aruncăm o privire asupra arhitecturii sistemului de colectare a jurnalelor fără detalii:
Iar aici — descrierea (arhitectura microserviciilor):
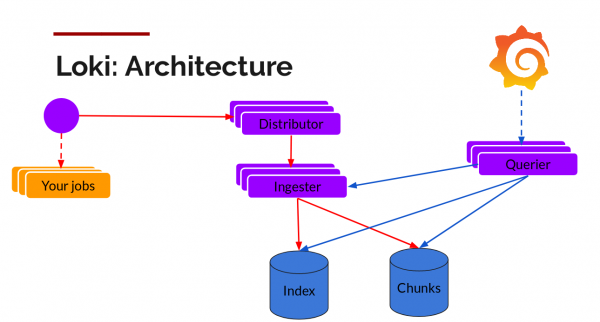
Componentele:
Promtail — agent, instalat pe noduri (sub formă de seturi de servicii), preia jurnalele din sarcini și accesează API-ul Kubernetes pentru a obține metadatele cu care vor fi etichetate jurnalele. Apoi, trimite jurnalul către serviciul principal Loki. Pentru asocierea metadatelor se aplică aceleași reguli de etichetare ca în Prometheus.
Distribuitor — serviciu distribuitor care funcționează ca un buffer. Pentru a procesa milioane de înregistrări, el împachetează datele în intrare, comprimându-le în blocuri pe măsură ce sosesc. Funcționează simultan mai mulți receptori de date, dar jurnalele aparținând unui singur flux de date de intrare trebuie să se regăsească doar în unul dintre aceștia pentru toate blocurile sale. Aceasta este organizată sub formă de inel de receptori și hashing secvențial. Pentru toleranță la defecte și redundanță, se face de n ori (3, dacă nu este configurat altfel).
Ingester — serviciu receptor. Blocurile de date sosesc comprimate cu jurnalele adăugate. Odată ce blocul atinge o dimensiune suficientă, acesta este eliminat în baza de date. Metadatele sunt indexate, iar datele din blocul de jurnal ajung în Chunks (de obicei, un stocare obiectuală). După eliminare, receptorul creează un nou bloc, unde vor fi adăugate înregistrări noi.
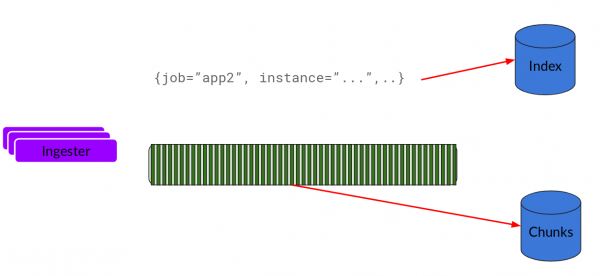
Index — bază de date, DynamoDB, Cassandra, Google BigTable și altele.
Chunks — blocuri de jurnale comprimate, de obicei stocate în stocare obiectuală, cum ar fi S3.
Interogator — cale de citire care face toată munca grea. Se uită la intervalul de timp și etichete, după care consultă indexul pentru a căuta potriviri. Apoi, citește blocurile de date și le filtrează pentru a obține rezultatul.
Și acum să vedem totul în acțiune.
Instalare
Pentru instalarea în Kubernetes, cel mai simplu este să folosești helm. Presupunem că deja l-ai instalat și configurat ( nota traducătorului)
Adăugăm repository-ul și instalăm stack-ul.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
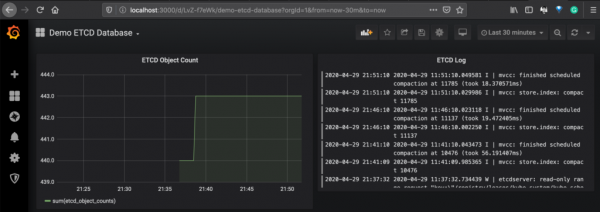
Mai jos este un exemplu de panou de instrumente care prezintă date din Prometheus pentru metricile Etcd și Loki pentru jurnalele podurilor Etcd.
Și acum hai să discutăm despre arhitectura ambelor sisteme și să comparăm capabilitățile lor între ele.
Comparare
Limbajul de interogare
În Elasticsearch se utilizează Query DSL și limbajul de interogare Lucene, care oferă capacitatea de a efectua căutări cu text complet. Este un motor de căutare robust, consacrat, cu suport extins pentru operatori. Cu ajutorul său, este posibil să căutați în funcție de context și să sortați după relevanță.
De cealaltă parte a ringului se află LogQL, folosit în Loki, succesorul PromQL (limbajul de interogare Prometheus). Acesta utilizează etichetele de jurnal pentru filtrarea și extragerea datelor din jurnale. Există posibilitatea de a folosi anumiți operatori și aritmetică, așa cum este descris , dar în privința capabilităților rămâne în urma limbajului Elastic.
Deoarece interogările în Loki sunt legate de etichete, acestea sunt ușor de corelat cu metricile, făcându-le mai ușor de utilizat pentru monitorizarea în timp real.
Scalabilitate
Ambele stive sunt scalabile pe orizontală, dar cu Loki este mai simplu, deoarece are căi separate pentru citirea și scrierea datelor, precum și o arhitectură microservicii. Loki poate fi configurat în funcție de nevoile dumneavoastră și poate fi utilizat pentru volumes mari de date de jurnal.
Multi-tenant
Multi-tenantitatea clusterului este un subiect comun pentru reducerea OPEX, ambele stive oferind suport pentru multi-tenantitate. Pentru Elasticsearch, există câteva de separare a clienților: un index separat pentru fiecare client, rutare bazată pe client, câmpuri unice pentru client, filtre de căutare. În Loki, aceasta există sub forma antetului HTTP X-Scope-OrgID.
Preț
Loki este foarte eficient din punct de vedere economic deoarece nu indexează datele, ci doar metadatele. Astfel, se realizează și memorie (cache), deoarece stocarea obiectelor este mai ieftină decât stocarea pe blocuri, care este utilizată în clusterele Elasticsearch.
Concluzie
Stiva EFK poate fi utilizată în scopuri diverse, oferind flexibilitate maximă și o interfață multifuncțională Kibana pentru analiză, vizualizare și interogări. Aceasta poate fi îmbunătățită suplimentar prin capacitățile de învățare automată.
Stiva Loki este utilă în ecosistemul Kubernetes datorită mecanismului de descoperire a metadatelor. Este ușor de corelat datele pentru monitorizarea bazată pe serii temporale în Grafana și jurnalele.
Când vine vorba de cost și stocarea pe termen lung a jurnalelor, Loki este o alegere excelentă pentru intrarea în soluții cloud.
Pe piață există mai multe alternative — unele pot fi mai bune pentru dvs. De exemplu, pentru GKE există integrarea Stackdriver, care oferă o soluție excelentă pentru monitorizare. Nu le-am inclus în analiza noastră din acest articol.
Linkuri:
Articolul a fost tradus și pregătit pentru Habr de angajații — intensive, cursuri video și formare corporativă de la specialiști practicanți (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Sursa: habr.com
