

Introducere
Bună!
În acest articol, voi împărtăși experiența de construire a unei arhitecturi microservicii pentru un proiect care utilizează rețele neuronale.
Vom discuta despre cerințele arhitecturii, vom analiza diferite diagrame structurale, vom examina fiecare componentă a arhitecturii gata realizate și vom evalua metricile tehnice ale soluției.
Lectură plăcută!
Câteva cuvinte despre problemă și soluția acesteia
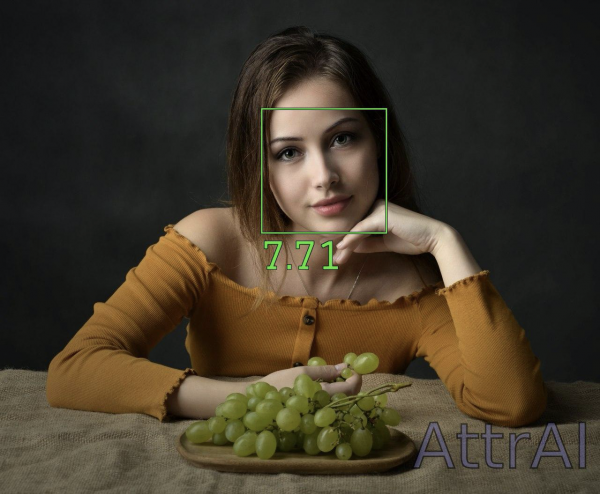
Ideea de bază este de a evalua atractivitatea unei persoane pe o scară de la 1 la 10, pe baza unei fotografii.
În acest articol, ne vom abate de la descrierea rețelelor neuronale utilizate și a procesului de pregătire a datelor și a învățării. Cu toate acestea, într-una dintre publicațiile viitoare, ne vom întoarce cu siguranță la analiza pipeline-ului de evaluare la un nivel mai profund.
Acum, vom trece prin pipeline-ul de evaluare la un nivel înalt, punând accent pe interacțiunea microserviciilor în contextul arhitecturii generale a proiectului.
În lucrul la pipeline-ul de evaluare a atractivității, sarcina a fost descompusă în următoarele componente:
- Detectarea fețelor din fotografii
- Evaluarea fiecărei fețe
- Redarea rezultatelor
Prima sarcină este rezolvată cu ajutorul . Pentru a doua, a fost antrenată o rețea neuronală convoluțională pe PyTorch, ca backbone a fost folosit - având în vedere balanța 'calitate / viteză de inferență pe CPU'
Diagrama funcțională a pipeline-ului de evaluare
Analiza cerințelor arhitecturii proiectului
În ciclu de viață etapele de lucru asupra arhitecturii și automatizarea desfășurării modelului sunt adesea unele dintre cele mai costisitoare în timp și resurse.
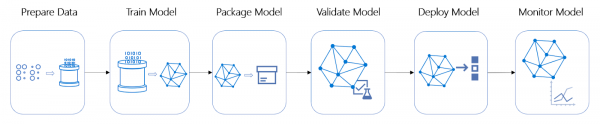
Ciclul de viață al unui proiect ML
Acest proiect nu face excepție - a fost luată decizia de a învârti pipeline-ul de evaluare într-un serviciu online, pentru aceasta a fost necesară înțelegerea arhitecturii. Au fost stabilite următoarele cerințe de bază:
- Un depozit unic de loguri - toate serviciile ar trebui să scrie log-urile într-un singur loc, care să fie ușor de analizat
- Capacitatea de scalare orizontală a serviciului de evaluare - ca fiind cel mai probabil Bottleneck
- Fiecare imagine ar trebui să aibă un număr egal de resurse ale procesorului alocate - pentru a evita anomalii în distribuția timpului de inferență
- Desfășurare rapidă (re) a serviciilor individuale, precum și a stivei în ansamblu
- Posibilitatea de a utiliza, dacă este necesar, obiecte comune în diferite servicii
Arhitectură
După analiza cerințelor, a devenit evident că arhitectura bazată pe microservicii se potrivește aproape perfect.
Pentru a scăpa de durerea de cap suplimentară, a fost ales API-ul Telegram ca frontend.
Mai întâi, să examinăm diagrama structurală a arhitecturii finale, apoi vom trece la descrierea fiecărui component și vom formaliza procesul de prelucrare reușită a imaginii.
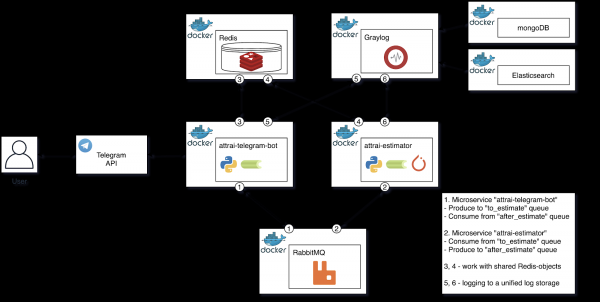
Diagrama structurală a arhitecturii finale
Să discutăm mai în detaliu despre fiecare dintre componentele diagramei, să le subliniem responsabilitatea unică în procesul de evaluare a imaginii.
Microserviciul „attrai-telegram-bot”
Acest microserviciu încasează toate interacțiunile cu API-ul Telegram. Putem identifica două scenarii principale – lucrul cu imaginea utilizatorului și lucrul cu rezultatul pipeline-ului de evaluare. Vom analiza ambele scenarii în mod general.
Atunci când primim un mesaj de la utilizator cu o imagine:
- Se efectuează o filtrare, care constă din următoarele verificări:
- Prezența dimensiunii optime a imaginii
- Numărul de imagini ale utilizatorului, deja aflate în așteptare
- După ce imaginea trece prin filtrul inițial, aceasta este salvată în volum Docker.
- În coada „to_estimate” se produce o sarcină, care include, printre altele, calea către imaginea aflată în volumul nostru.
- Dacă etapele menționate mai sus sunt parcurse cu succes – utilizatorul va primi un mesaj cu un timp estimat pentru prelucrarea imaginii, care este calculat pe baza numărului de sarcini din coadă. În caz de eroare, utilizatorul va fi informat explicit despre aceasta – printr-un mesaj care conține informații despre ce ar fi putut merge prost.
De asemenea, acest microserviciu, ca worker Celery, ascultă coada „after_estimate”, care este destinată sarcinilor care au trecut prin pipeline-ul de evaluare.
Când primim o nouă sarcină din „after_estimate”:
- Dacă imaginea a fost procesată cu succes – trimitem rezultatul utilizatorului, altfel – informăm despre eroare.
- Ștergem imaginea care este rezultatul pipeline-ului de evaluare.
Microserviciul de evaluare „attrai-estimator”
Acest microserviciu este un worker Celery și încasează tot ce ține de pipeline-ul de evaluare a imaginii. Algoritmul de funcționare aici este unul – să-l analizăm.
Când primim o nouă sarcină din „to_estimate”:
- Procesăm imaginea prin pipeline-ul de evaluare:
- Încărcăm imaginea în memorie
- Redimensionăm imaginea la dimensiunea necesară
- Detectăm toate fețele (MTCNN)
- Evaluăm toate fețele (împachetăm fețele găsite în punctul anterior într-un batch și aplicăm inferența ResNet34)
- Redăm imaginea finală
- Desenăm bounding boxes
- Desenăm evaluările
- Ștergem imaginea originală (de utilizator)
- Salvăm ieșirea din pipeline-ul de evaluare
- Adăugăm task-ul în coada „after_estimate”, pe care o ascultă microserviciul analizat mai sus „attrai-telegram-bot”
Graylog (+ mongoDB + Elasticsearch)
— este o soluție pentru gestionarea centralizată a logurilor. În acest proiect, a fost folosită conform destinației sale.
Am ales-o pe ea, și nu stiva familiară tuturor din motive de confort în utilizare din Python. Tot ce trebuie să facem pentru a face logging în Graylog este să adăugăm GELFTCPHandler din pachetul la ceilalți root logger handlers ai microserviciului nostru Python.
Eu, ca persoană care a lucrat anterior doar cu stiva ELK, am avut în general o experiență pozitivă în timpul lucrului cu Graylog. Singurul lucru care îngrijorează este superioritatea funcționalităților Kibana față de interfața web a Graylog.
RabbitMQ
— este un broker de mesaje bazat pe protocolul AMQP.
În acest proiect, a fost utilizat ca broker pentru Celery și a funcționat în modul durable.
Redis
— este o bază de date NoSQL care lucrează cu structuri de date de tip „cheie - valoare”
Uneori, apare necesitatea de a folosi în diferite microservicii Python obiecte comune care realizează anumite structuri de date.
De exemplu, în Redis se păstrează un hashmap de tipul „telegram_user_id => numărul de task-uri active în coadă”, ceea ce permite limitarea numărului de cereri din partea unui utilizator la o valoare specifică și, astfel, prevenirea atacurilor DoS.
Formalizăm procesul de procesare de succes a imaginii
- Utilizatorul trimite o imagine în botul Telegram
- „attrai-telegram-bot” primește mesajul de la API-ul Telegram și îl analizează
- Task-ul cu imaginea este adăugat în coada asincronă „to_estimate”
- Utilizatorul primește un mesaj cu timpul estimat pentru evaluare
- „attrai-estimator” ia task-ul din coada „to_estimate”, îl procesează prin pipeline-ul de evaluare și produce task-ul în coada „after_estimate”
- „attrai-telegram-bot”, care ascultă coada „after_estimate”, trimite rezultatul utilizatorului
DevOps
În cele din urmă, după revizuirea arhitecturii, putem trece la o parte la fel de interesantă — DevOps
Dar înseamnă asta că puteți folosi același fișier docker-compose în
— un sistem de clusterizare, funcționalitatea căruia este implementată în cadrul Docker Engine și este disponibilă din cutie.
Cu ajutorul „roiului”, toate nodurile clusterului nostru pot fi împărțite în 2 tipuri – worker și manager. Pe mașinile de tip worker se desfășoară grupuri de containere (stacks), iar mașinile de tip manager răspund pentru scalare, balansare și . Managerii sunt în mod implicit și workers.
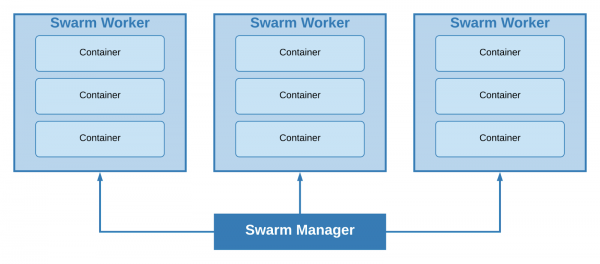
Un cluster cu un leader manager și trei workers
Dimensiunea minimă posibilă a clusterului este de 1 nod, o singură mașină va funcționa simultan ca leader manager și worker. Având în vedere dimensiunea proiectului și cerințele minime pentru toleranța la erori, s-a decis să se folosească această abordare.
Spunând pe scurt, de la prima livrare în producție, care a avut loc în mijlocul lui iunie, nu au existat probleme legate de organizarea acestui cluster (dar asta nu înseamnă că o astfel de organizare este acceptabilă în orice proiecte medii-mari la care se impun cerințe de toleranță la erori).
Docker Stack
În modul „roi”, desfășurarea stacks-urilor (seturi de servicii docker) este responsabilitatea
Acesta suportă configurații docker-compose, permițând utilizarea suplimentară a parametrilor de desfășurare.
De exemplu, cu ajutorul acestor parametri, au fost limitate resursele pentru fiecare dintre instanțele microserviciului de evaluare (alocăm N core pentru N instanțe, în microserviciu limităm numărul de core-uri utilizate de PyTorch la unul singur)
attrai_estimator:
  imagine: 'erqups/attrai_estimator:1.2'
  desfășurare:
    replici: 4
    resurse:
      limite:
        cpu-uri: '4'
    politica_de_restart:
      condiție: în caz de eșec
      …
Este important de menționat că Redis, RabbitMQ și Graylog sunt servicii stateful și nu se pot scala la fel de simplu ca „attrai-estimator”
Anticipând întrebarea – de ce nu Kubernetes?
Pare că utilizarea Kubernetes în proiecte mici și medii este un cost suplimentar, întreaga funcționalitate necesară poate fi obținută de la Docker Swarm, care este destul de prietenos pentru orchestrarea containerelor și are un prag de intrare scăzut.
Infrastructură
Toate acestea au fost desfășurate pe un VDS cu următoarele caracteristici:
- CPU: 4 nuclee Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
După testarea de încărcare locală, părea că în cazul unui aflux serios de utilizatori, această mașină va fi abia suficientă.
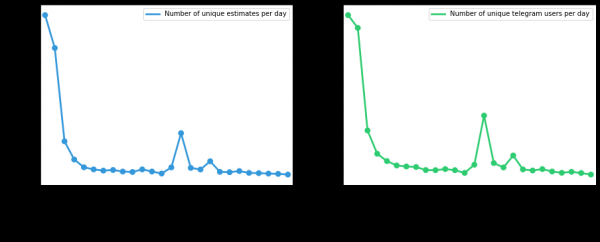
Însă, imediat după desfășurare, am postat un link pe unul dintre cele mai populare imageboard-uri din CSI (da, acel imageboard), după care oamenii s-au arătat interesați și, în câteva ore, serviciul a procesat cu succes zeci de mii de imagini. În plus, în momentele de vârf, resursele CPU și RAM nu au fost folosite nici măcar la jumătate.
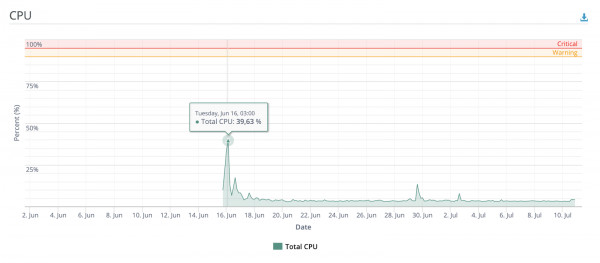
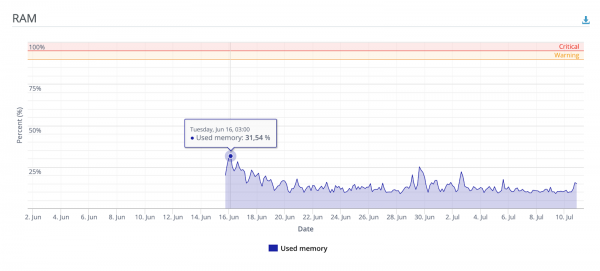
Încă puțină grafică
Numărul utilizatorilor unici și al cererilor de evaluare, de la desfășurare, în funcție de zi
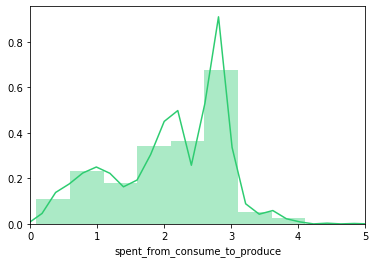
Distribuția timpului de inferență a pipeline-ului de evaluare
Conclusions
Rezumând, pot spune că arhitectura și abordarea orchestratului containerelor s-au dovedit a fi pe deplin justificate — chiar și în momentele de vârf nu au fost căderi sau scăderi ale timpului de procesare.
Cred că proiectele mici și medii care folosesc inferența în timp real a rețelelor neuronale pe CPU pot adopta cu succes practicile descrise în acest articol.
Voi adăuga că inițial articolul a fost mai lung, dar, pentru a evita un longread, am decis să omitem unele puncte din acest articol — ne vom întoarce la ele în viitoarele publicații.
Poți interacționa cu botul pe Telegram — @AttraiBot, va funcționa, cel puțin, până la sfârșitul toamnei anului 2020. Vă reamintesc — nu sunt stocate datele utilizatorilor — nici imaginile originale, nici rezultatele pipeline-ului de evaluare — totul este șters după procesare.
Sursa: habr.com
