

Salut, sunt Dmitri Logvinenko — Data Engineer în departamentul de analiză al grupului de companii „Vezet”.
Voi vorbi despre un instrument minunat pentru dezvoltarea proceselor ETL — Apache Airflow. Dar Airflow este atât de versatil și complex, încât merită să-i acordați atenție chiar dacă nu vă ocupați de fluxurile de date și aveți nevoie, din când în când, să lansați anumite procese și să urmăriți executarea acestora.
Și da, nu voi doar povesti, ci voi și arăta: programul conține mult cod, capturi de ecran și recomandări.
Ce vezi de obicei când cauți cuvântul Airflow / Wikimedia Commons
Cuprins
Introducere
Apache Airflow — este exact ca Django:
- scris în Python,
- are un panou de administrare excelent,
- extensibil nelimitat,
— doar că este mai bun, și, de fapt, a fost creat pentru scopuri complet diferite, și anume (așa cum este scris în prefață):
- lansarea și monitorizarea sarcinilor pe un număr nelimitat de mașini (cât vă permite Celery/Kubernetes și conștiința voastră)
- cu generarea dinamică a fluxurilor de lucru dintr-un cod Python foarte ușor de scris și de înțeles
- și posibilitatea de a conecta între ele orice baze de date și API-uri prin componente existente și plugin-uri personalizate (ceea ce se face extrem de ușor).
Folosim Apache Airflow astfel:
- adunăm date din diverse surse (multe instanțe SQL Server și PostgreSQL, diverse API-uri cu metrici de aplicații, chiar și 1C) în DWH și ODS (la noi este Vertica și Clickhouse).
- ca un avansat
cron, care lansează procese de consolidare a datelor în ODS și monitorizează întreținerea acestora.
Până de curând, nevoile noastre erau acoperite de un singur server mic cu 32 de nuclee și 50 GB de memorie RAM. În Airflow, în același timp, funcționează:
- peste 200 de DAG-uri (de fapt, fluxuri de lucru, în care am adunat sarcini),
- în fiecare, în medie, 70 de sarcini,
- aceasta se lansează (de asemenea, în medie) o dată pe oră.
Și despre cum ne-am extins, voi scrie mai jos, dar acum haideți să definim sarcina über, pe care o vom rezolva:
Există trei servere SQL de bază, fiecare cu 50 de baze de date — instanțe ale aceluiași proiect, prin urmare, structura lor este similară (aproape peste tot, muahaha), așa că fiecare conține un tabel Orders (din fericire, un tabel cu acest nume poate fi integrat în orice afacere). Noi extragem datele, adăugând câmpuri auxiliare (server sursă, bază de date sursă, identificatorul sarcinii ETL) și le transferăm naiv într-un, să zicem, Vertica.
Configurarea Mitogen pentru Ansible este foarte simplă:
Partea principală, practică (și puțin teoretică)
De ce ne trebuie (și vă trebuie)
Când copacii erau mari, iar eu eram un simplu SQL-lucrător într-un retail din Rusia, executam procesele ETL aka fluxuri de date cu ajutorul a două instrumente disponibile pentru noi:
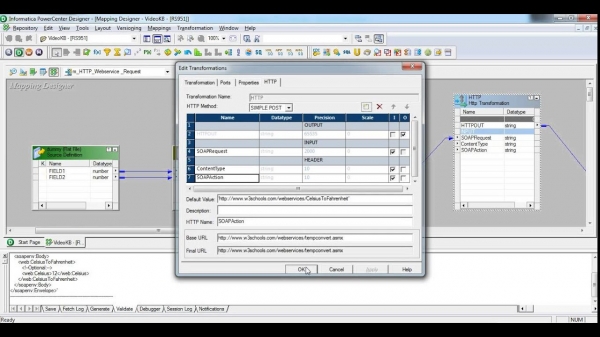
- Informatica Power Center — un sistem extrem de complex, extrem de performant, cu propriile sale hardware-uri, propria sa versiune de gestionare. Am folosit, cu greu, 1% din capacitățile sale. De ce? Ei bine, în primul rând, această interfață, undeva din anii 2000, ne presează psihic. În al doilea rând, această unealtă este proiectată pentru procese extrem de sofisticate, reutilizare intensă a componentelor și alte caracteristici foarte importante pentru întreprinderi. Cât despre preț, echivalent cu aripa unui Airbus A380 pe an, să tăcem.
Atenție, captura de ecran ar putea provoca puțin disconfort celor sub 30 de ani.

- SQL Server Integration Server — acest instrument l-am folosit în fluxurile noastre interne de proiect. Ei bine, în realitate: deja folosim SQL Server și ar fi fost nedar de nerezonabil să nu folosim instrumentele sale ETL. Totul în el este bun: interfața arată bine, iar rapoartele de execuție... Dar nu pentru asta iubim produsele software, oh, nu pentru asta. Putem să versionăm
dtsx(care reprezintă un XML cu nodurile amestecate la salvare), dar ce folos? Și să facem un pachet de sarcini care să transfere o sută de tabele de pe un server pe altul? Da, ce sută, de la douăzeci de bucăți te va lăsa fără degetul arătător care apasă butonul mouse-ului. Dar, fără îndoială, arată semnificativ mai modern:
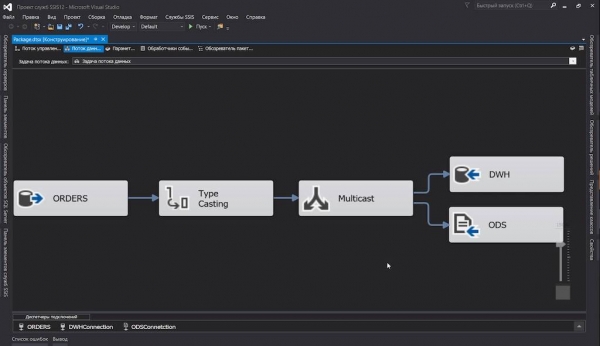
Căutam cu siguranță soluții. Chiar aproape am ajuns la un generator personalizat de pachete SSIS...
... și apoi m-a găsit un nou loc de muncă. Iar acolo mă aștepta Apache Airflow.
Când am aflat că descrierile fluxurilor ETL sunt un simplu cod Python, aproape că am început să dansez de bucurie. Astfel, fluxurile de date au fost versionate și difuzate, iar combinarea tabelelor cu o structură unică din sute de baze de date într-un singur target a devenit o chestiune de cod Python pe un ecran de 13 inch.
Construim un cluster
Să nu facem din asta o grădiniță și să nu vorbim despre lucruri complet evidente, cum ar fi instalarea Airflow, baza de date aleasă de tine, Celery și alte detalii menționate în documentație.
Pentru a putea începe imediat experimentele, am schițat docker-compose.yml în care:
- Vom ridica efectiv Airflow: Scheduler, Webserver. Acolo va rula și Flower pentru monitorizarea sarcinilor Celery (pentru că a fost deja inclus în
apache/airflow:1.10.10-python3.7, și noi nu ne opunem); - PostgreSQL, în care Airflow va scrie informațiile sale de sistem (datele planificatorului, statistica executării etc.), iar Celery va marca sarcinile finalizate;
- Redis, care va acționa ca broker de sarcini pentru Celery;
- Celery worker, care se va ocupa de executarea efectivă a sarcinilor.
- În folderul
. /dagsvom plasa fișierele noastre cu descrierea DAG-urilor. Acestea vor fi preluate instantaneu, așa că nu este nevoie să repornim întregul sistem după fiecare mică schimbare.
În unele locuri, codul din exemple este prezentat incomplet (pentru a nu aglomera textul), iar în alte părți este modificat în timpul procesului. Exemplele complete de cod funcțional pot fi vizualizate în repository. .
docker-compose.yml
versiune: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: \/dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2:\/\/airflow:airflow@airflow-db:5432\/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis:\/\/broker:6379\/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql:\/\/airflow:airflow@airflow-db\/airflow

x-airflow-base: &airflow-base
  imagine: apache\/airflow:1.10.10-python3.7
  entrypoint: \/bin\/bash
  restart: always
  volumes:
    - .\/dags:\/dags
    - .\/requirements.txt:\/requirements.txt

services:
  # Redis ca broker pentru Celery
  broker:
    imagine: redis:6.0.5-alpine

  # DB pentru metadatele Airflow
  airflow-db:
    imagine: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - .\/db:\/var\/lib\/postgresql\/data

  # Containerul principal cu Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <<: *airflow-config

      AIRFLOW__SCHEDULER__DAG_DIR_LIST_INTERVAL: 30
      AIRFLOW__SCHEDULER__CATCHUP_BY_DEFAULT: 'False'
      AIRFLOW__SCHEDULER__MAX_THREADS: 8

      AIRFLOW__WEBSERVER__LOG_FETCH_TIMEOUT_SEC: 10

    depends_on:
      - airflow-db
      - broker

    command: >
      -c " sleep 10 &&
           pip install --user -r \/requirements.txt &&
           \/entrypoint initdb &&
          (\/entrypoint webserver &) &&
          (\/entrypoint flower &) &&
           \/entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, va fi scalat folosind `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <<: *airflow-config

    command: >
      -c " sleep 10 &&
           pip install --user -r \/requirements.txt &&
           \/entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Observații:
- În construirea compozitului m-am bazat mult pe imaginea cunoscută – asigurați-vă că verificați. Poate că nu veți mai avea nevoie de nimic altceva în viața voastră.
- Toate setările Airflow sunt disponibile nu doar prin
airflow.cfg, ci și prin variabile de mediu (slavă dezvoltatorilor), de care am profitat cu nerușinare. - Desigur, nu este gata pentru producție: intenționat nu am setat heartbeats pentru containere, nu m-am preocupat de securitate. Dar am realizat un minimum potrivit pentru experimentele noastre.
- Rețineți că:
- Folderul cu DAG-uri trebuie să fie accesibil atât planificatorului, cât și lucrătorilor.
- Același lucru este valabil și pentru toate bibliotecile externe — toate trebuie să fie instalate pe mașinile cu planificator și lucrători.
Acum, la simplu:
$ docker-compose up --scale worker=3După ce totul este pornit, se pot vizualiza interfețele web:
- Airflow:
- Flower:
Concepturi de bază
Dacă nu ai înțeles nimic din toți acești „dags”, iată un mic glosar:
- Scheduler — cel mai important tip din Airflow, care se asigură că roboții muncesc, nu oamenii: urmărește programul, actualizează dags, pornește sarcinile.
În versiunile anterioare, avea probleme de memorie (nu, nu amnezie, ci scurgeri) și în configurații a rămas chiar un parametru legacy
run_duration— intervalul de repornire. Dar acum e totul bine. - DAG (denumit și „dag”) — „graf orientat aciclic”, dar această definiție nu spune prea multe, de fapt este un container pentru sarcini care interacționează între ele (vezi mai jos) sau echivalentul unui Pachet în SSIS și Workflow în Informatica.
În afară de dags, pot exista și sub-dags, dar cel mai probabil nu vom ajunge la ele.
- DAG Run — un dag inițializat, căruia i s-a atribuit propria
execution_date. Dagrun-urile unui dag pot funcționa simultan (dacă, desigur, ai făcut sarcinile tale idempotente). - Operator — acestea sunt bucăți de cod responsabile pentru executarea unei acțiuni specifice. Există trei tipuri de operatori:
- action, cum ar fi iubitul nostru
PythonOperator, care poate executa orice cod Python (valid); - transfer, care transferă date de la un loc la altul, de exemplu,
MsSqlToHiveTransfer; - sensor va permite să reacționezi sau să oprești executarea ulterioară a dag-ului până la apariția unui anumit eveniment.
HttpSensorpoate verifica endpoint-ul specificat, și când primește răspunsul dorit, pornește transferulGoogleCloudStorageToS3Operator. O minte curioasă ar întreba: „de ce? Puteți face repetări direct în operator!” Apoi, pentru a nu suprasolicita pool-ul de sarcini cu operatori suspendați. Senorul se activează, verifică și se oprește până la următoarea încercare.
- action, cum ar fi iubitul nostru
- Task — operatorii declarați, indiferent de tip, atașați la dag sunt ridicați la rangul de sarcină.
- Task instance — când general-planificatorul decide că sarcinile sunt gata să fie trimise în luptă către executanți- lucrători (direct pe loc, dacă folosim
LocalExecutorsau pe un nod remote în cazul cuCeleryExecutor), le atribuie un context (adică un set de variabile — parametri de execuție), desfășoară șabloanele de comenzi sau cereri și le compilează în pool.
Generăm sarcini
Să definim mai întâi schema generală a dag-ului nostru, apoi vom intra din ce în ce mai mult în detalii, deoarece aplicăm soluții non-triviale.
Așadar, în forma cea mai simplă, un astfel de dag ar arăta așa:
din datetime import timedelta, datetime

de airflow import DAG
from airflow.operators.python_operator import PythonOperator

de commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Să începem:
- Mai întâi vom importa bibliotecile necesare și câteva lucruri în plus;
sql_server_ds— acesta esteList[namedtuple[str, str]]cu numele conexiunilor din Airflow Connections și bazele de date din care vom lua tabelul nostru;dageste declarația DAG-ului nostru, care trebuie neapărat să se afle înglobals(), altfel Airflow nu îl va găsi. De asemenea, trebuie să informăm DAG-ul:- ce nume are
ordersacest nume va apărea în interfața web, - că va începe să funcționeze de la miezul nopții pe 8 iulie,
- și că va fi executat la fiecare 6 ore (pentru cei avansați, aici în loc de
timedelta()se acceptăcron-linie0 0 0/6 ? * * *, pentru cei mai puțin avansați — o expresie de genul@daily);
- ce nume are
workflow()va face munca de bază, dar nu acum. Acum, doar vom lista contextul nostru în log.- Și acum magia simplă a creării sarcinilor:
- iterăm prin sursele noastre;
- inițializăm
PythonOperator, care va executa placeholder-ul nostruworkflow(). Nu uitați să specificați un nume unic (în cadrul DAG-ului) pentru sarcină și să legați DAG-ul. Flagulprovide_contextva transmite funcției argumente suplimentare, pe care le vom aduna cu ajutorul**context.
Deocamdată, asta e tot. Ce am obținut:
- un nou DAG în interfața web,
- aproximativ o sută cincizeci de sarcini, care vor fi executate în paralel (dacă permite setările Airflow, Celery și puterea serverelor).
Ei bine, aproape că am obținut.
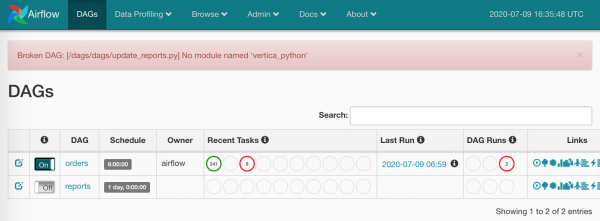
Cine va stabili dependențele?
Pentru a simplifica totul, am integrat în docker-compose.yml procesare requirements.txt pe toate nodurile.
Aproape că începem:
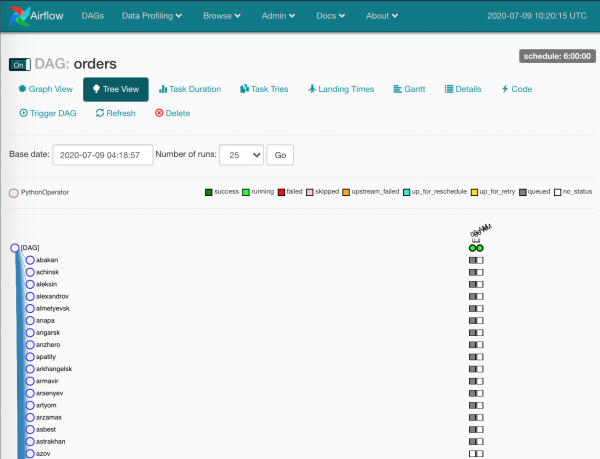
Cercurile gri — instanțe de sarcini, procesate de planificator.
Așteptăm puțin, sarcinile sunt preluate de lucrători:
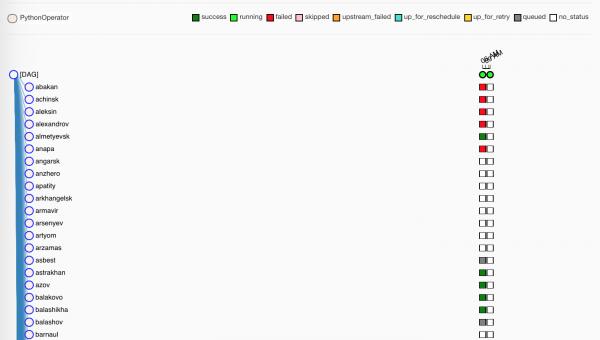
Verzii, evident, — au fost executați cu succes. Roșii — nu atât de bine.
Apropo, pe producția noastră nu există niciun dosar
. /dags, sincronizat între mașini — toate DAG-urile stau îngitpe Gitlab, iar Gitlab CI desfășoară actualizările pe mașini la fuziunea înmaster.
Puțin despre Flower
Între timp, lucrătorii execută sarcinile noastre placeholder, să ne aducem aminte de un alt instrument care ne poate arăta unele informații — Flower.
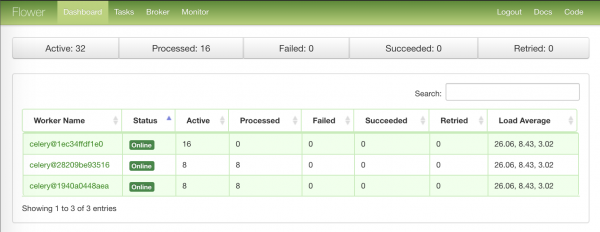
Prima pagină cu informații generale despre nodurile lucrător:
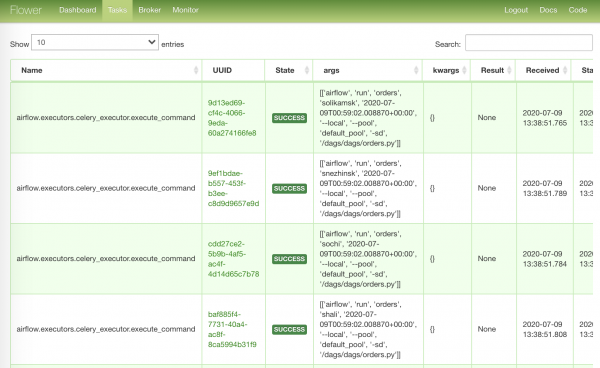
Pagina cea mai detaliată cu sarcinile trimise la lucru:
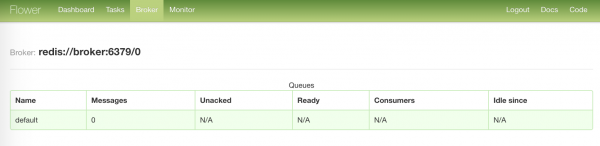
Cea mai plictisitoare pagină cu starea brokerului nostru:
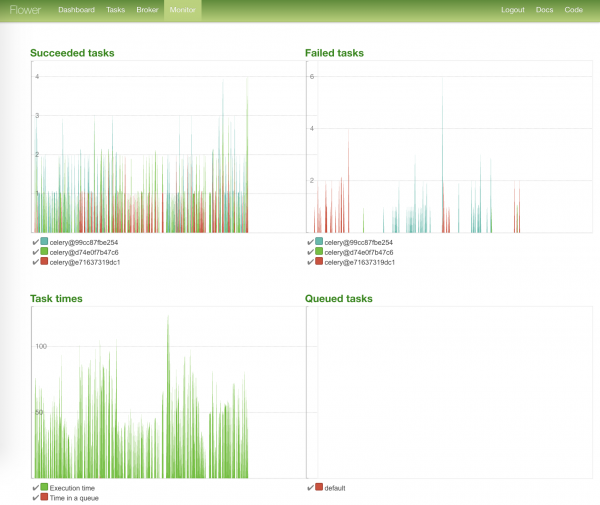
Cea mai vibrantă pagină — cu graficele stării task-urilor și timpul de execuție al acestora:
Încărcăm ceea ce nu a fost încărcat
Așadar, toate task-urile au fost executate, putem să ne ocupăm de răniți.
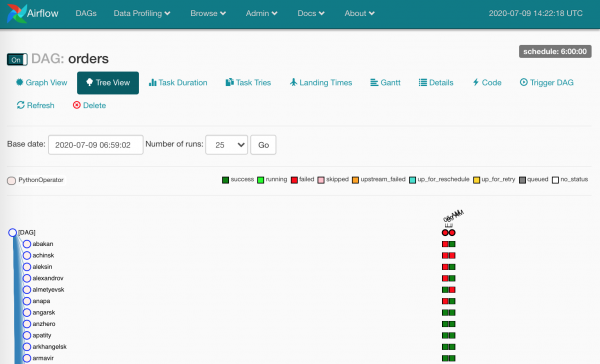
Și s-au dovedit a fi mulți răniți — din diverse motive. În cazul în care Airflow este utilizat corect, aceste pătrate spun că datele cu siguranță nu au ajuns.
Trebuie să verifici log-ul și să relansezi instanțele de task-uri căzute.
Dacă facem clic pe oricare pătrat, vom vedea acțiunile disponibile pentru noi:
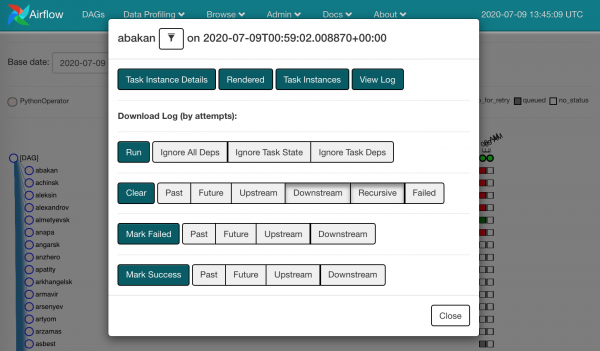
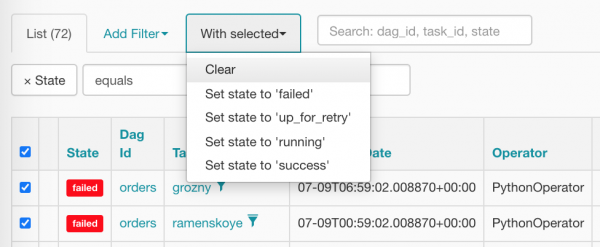
Putem lua și face Clear pentru cel căzut. Asta înseamnă că uităm că acolo s-a întâmplat ceva și același instanță a task-ului va reveni la planificator.
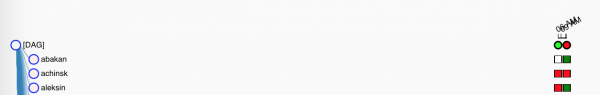
Este clar că a face asta cu mouse-ul pentru toate pătratele roșii nu este foarte uman — nu asta așteptăm de la Airflow. Desigur, avem o armă de distrugere în masă: Browse/Task Instances
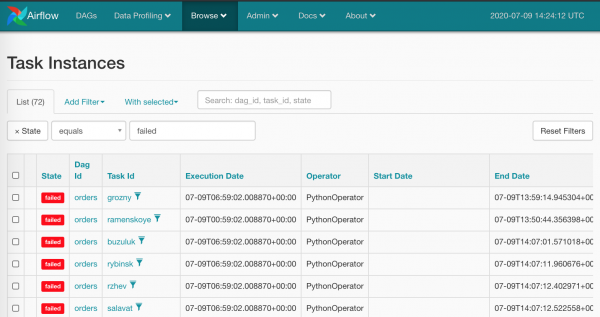
Vom selecta totul odată și să resetăm alegând punctul corect:
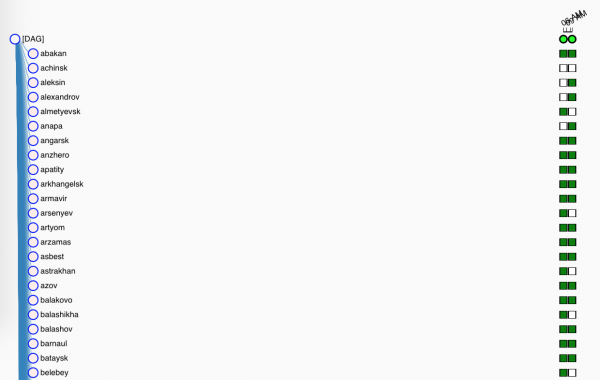
După curățare, taxiurile noastre arată așa (ele așteaptă nerăbdătoare când planificatorul le va programa):
Conexiuni, hook-uri și alte variabile
E momentul perfect să aruncăm o privire la următorul DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Bună ziua, rapoartele au fost actualizate"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natash, trezește-te, {{ dag.dag_id }} a picat
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Toată lumea a făcut vreodată un script de actualizare a raportelor? Iată-l din nou: există o listă de surse din care să aducem date; există o listă cu destinațiile; și să nu uităm să semnalizăm când totul s-a întâmplat sau s-a stricat (dar asta nu este despre noi).
Hai să revenim la fișier și să vedem lucrurile noi și neînțelese:
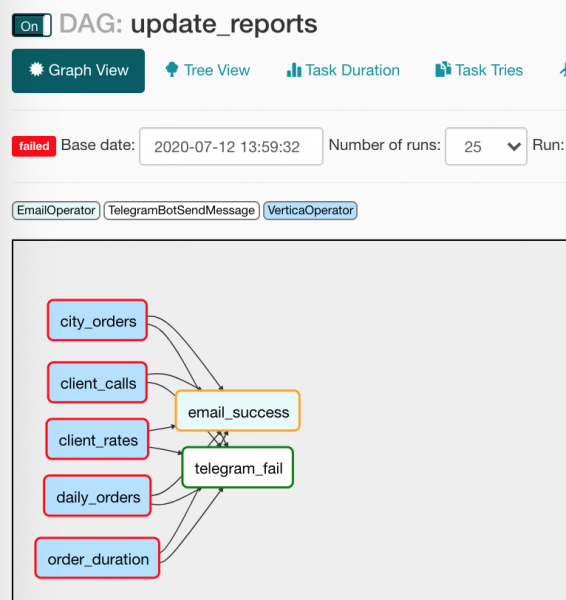
from commons.operators import TelegramBotSendMessage— nu ne împiedică nimic să ne facem propriile operatori, ceea ce am și făcut, creând un mic wrapper pentru trimiterea mesajelor în Desbloqueado. (Vom discuta mai jos despre acest operator);default_args={}— DAG-ul poate distribui aceleași argumente tuturor operatorilor săi;to='{{ var.value.all_the_kings_men }}'— câmpultonu va fi hardcodat, ci generat dinamic cu ajutorul Jinja și a variabilei cu lista de e-mailuri, pe care am plasat-o cu grijă înAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— condiția de activare a operatorului. În cazul nostru, scrisoarea va ajunge la șefi doar dacă toate dependențele au fost procesate cu succes;tg_bot_conn_id='tg_main'— argumenteleconn_idacceptă identificatoarele conexiunilor pe care le creăm înAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— mesajele în Telegram vor fi trimise doar în cazul existenței unor sarcini eșuate;task_concurrency=1— interzicem lansarea simultană a mai multor instanțe de task pentru aceeași sarcină. În caz contrar, vom obține lansarea simultană a mai multorVerticaOperator(care vizionează aceeași tabelă);report_update >> [email, tg]— toateVerticaOperatorse vor converte în trimiterea unei scrisori și a unui mesaj, astfel:

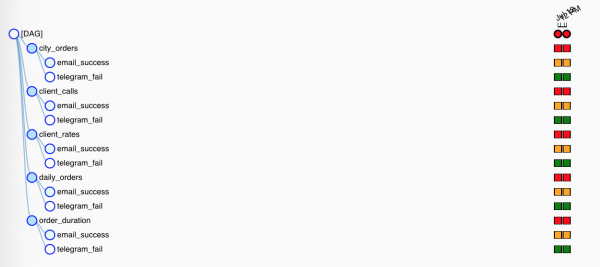
Dar deoarece operatorii de notificare au condiții de activare diferite, va funcționa doar unul. În Tree View, totul arată puțin mai puțin intuitiv:

Voi spune câteva cuvinte despre macros și prietenii lor — variabile.
Macros-urile sunt placeholder-uri Jinja care pot introduce diferite informații utile în argumentele operatorilor. De exemplu, așa:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se va extinde în conținutul variabilei de context execution_date în formatul YYYY-MM-DD: 2020-07-14. Cel mai plăcut este că variabilele de context sunt legate de un anumit exemplu de task (cadrul din Tree View), iar la reluarea lor, placeholder-urile se vor deschide în aceleași valori.
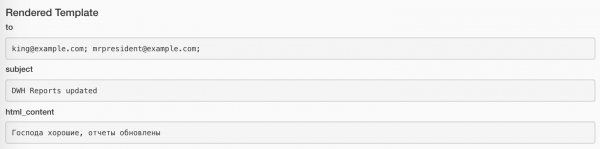
Valorile atribuite pot fi vizualizate folosind butonul Rendered din fiecare instanță de task. Iată cum arată la task-ul cu trimiterea scrisorii:
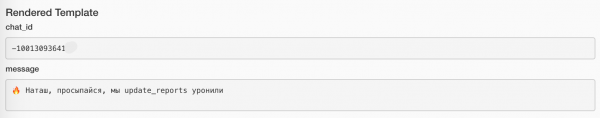
Iată cum arată la task-ul cu trimiterea mesajului:
Lista completă a macro-urilor integrate pentru cea mai recentă versiune disponibilă este disponibilă aici:
Mai mult, cu ajutorul plugin-urilor, putem declara propriile noastre macro-uri, dar aceasta este o poveste complet diferită.
Pe lângă piesele predeterminate, putem introduce valorile propriilor noastre variabile (am folosit deja acest lucru mai sus în cod). Să creăm un Admin/Variables câteva lucruri:
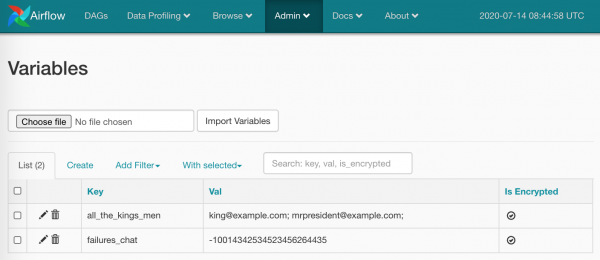
Gata, putem folosi:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')În valoare poate fi un scalar, dar poate fi și JSON. În cazul JSON-ului:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
pur și simplu folosim calea către cheia dorită: {{ var.json.bot_config.bot.token }}.
Voi spune un singur cuvânt și voi arăta un screenshot despre conexiuni. Aici totul este elementar: pe pagina Admin/Connections creăm conexiunea, adunăm acolo loginele/parolele noastre și parametrii mai specifici. Așa:
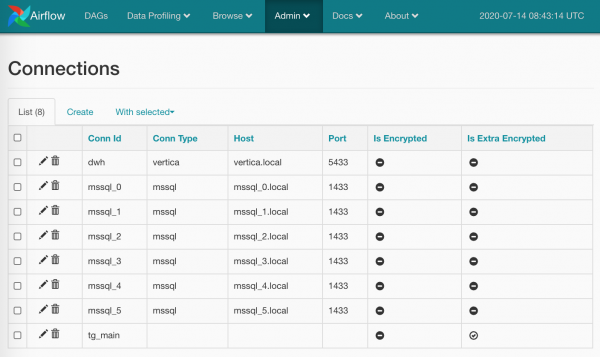
Parolele pot fi criptate (mai riguros decât în varianta implicită), sau putem să nu specificăm tipul conexiunii (așa cum am făcut pentru tg_main) — problema este că lista tipurilor este încorporată în modelele Airflow și extensia nu poate fi modificată fără a interveni în surse (dacă cumva nu am căutat bine — vă rog să mă corectați), dar a obține credențialele pur și simplu după nume nu ne va împiedica.
Și mai putem face mai multe conexiuni cu același nume: în acest caz, metoda BaseHook.get_connection(), care ne aduce conexiunile după nume, va returna una aleatoare din mai multe omonime (ar fi fost mai logic să facem Round Robin, dar să lăsăm acest lucru pe seama dezvoltatorilor Airflow).
Variables și Connections sunt, fără îndoială, instrumente excelente, dar este important să nu pierdem echilibrul: ce părți ale fluxurilor voastre le păstrați în codul propriu și care le lăsați pe seama stocării în Airflow. Pe de o parte, schimbarea rapidă a unei valori, de exemplu, a căsuței de mail, poate fi convenabilă prin UI. Pe de altă parte, este totuși un întoarcere la click-ul cu mouse-ul, de la care noi (eu) am dorit să ne desprindem.
Lucrul cu conexiunile este una dintre sarcini hook-urilor. În general, hook-urile Airflow sunt puncte de conectare la servicii și biblioteci externe. De exemplu, JiraHook ne va deschide un client pentru interacțiunea cu Jira (putem muta sarcini înapoi și înainte), iar cu ajutorul SambaHook putem să încărcăm un fișier local pe smb-punct.
Analizăm un operator personalizat
Și ne apropiem de momentul în care să vedem cum este realizat TelegramBotSendMessage
Cod commons/operators.py cu operatorul propriu-zis:
din typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Trimite un mesaj către chat_id folosind TelegramBotHook

    Exemplu:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} a eșuat :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Trimite "{self.message}" către chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Aici, la fel ca restul în Airflow, totul este foarte simplu:
- Am moștenit de la
BaseOperator, care implementează multe lucruri specifice Airflow (uitați-vă pe îndelete) - Am declarat câmpurile
template_fields, în care Jinja va căuta macrocomenzi pentru prelucrare. - Am organizat argumentele corecte pentru
__init__(), am stabilit valorile implicite unde este necesar. - Nu am uitat nici de inițializarea părintelui.
- Am deschis hook-ul corespunzător
TelegramBotHook, am obținut de la el obiectul client. - Am suprascris (overrided) metoda
BaseOperator.execute(), pe care Airflow o va apelare atunci când va veni timpul să ruleze operatorul — în ea implementăm acțiunea principală, fără a uita să ne logăm. (Logăm, de altfel, direct înstdoutșistderr— Airflow va intercepta, va ambala frumos și va organiza, unde trebuie.)
Să vedem ce avem în commons/hooks.py. Prima parte a fișierului, cu hook-ul propriu-zis:
din typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Hook pentru API Telegram Bot

    Notă: adăugați o conexiune cu tip de conexiune gol și nu uitați
    să completați Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Nici nu știu ce aș putea explica aici, doar voi sublinia aspectele importante:
- Moștenim, ne gândim la argumente — în cele mai multe cazuri va fi unul singur:
conn_id; - Suprascriem metodele standard: m-am limitat la
get_conn(), în care obțin parametrii conexiunii după nume și pur și simplu scot secțiuneaextra(acest câmp pentru JSON), în care eu (după instrucțiunile mele!) am pus tokenul botului Telegram:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Creez o instanță a botului nostru
TelegramBot, furnizându-i deja tokenul specific.
Asta e tot. Poți obține clientul din hook folosind TelegramBotHook().client sau TelegramBotHook().get_conn().
Și a doua parte a fișierului, în care am realizat un micro-wrapper pentru API-ul REST Telegram, astfel încât să nu trebuiască să folosesc același doar pentru o metodă sendMessage.
class TelegramBot:
    """Wrapper pentru API-ul Bot Telegram

    Exemple:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Salut, dragă')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Salut, dragă', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Calea corectă este să punem totul:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— într-un plugin, să-l încărcăm într-un repository public și să-l oferim în Open Source.
În timp ce studiam toate acestea, actualizările noastre de rapoarte au reușit să se umple cu succes și să-mi trimită un mesaj de eroare în canal. Mă duc să verific ce nu e în regulă din nou...
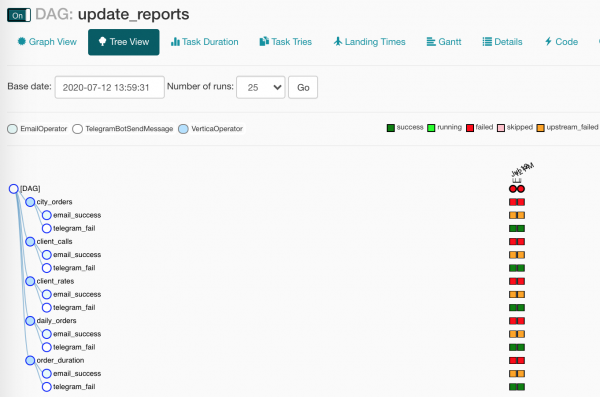
În DAG-ul nostru s-a stricat ceva! Asta nu era exact ceea ce așteptam? Exact!
Vei avea de băut?
Simți că am ratat ceva? Se părea că promiteam să mut datele din SQL Server în Vertica, iar acum m-am abătut de la subiect, nenorocit!
Crima a fost intenționată, trebuia neapărat să îți explic anumite terminologii. Acum putem merge mai departe.
Planul nostru era acesta:
- Să facem un DAG
- Să generăm sarcini
- Să vedem cât de frumos arată totul
- Să asignăm sesiunilor numerele de încărcare
- Să luăm datele din SQL Server
- Să punem datele în Vertica
- Să adunăm statistici
Așadar, pentru a lansa toate acestea, am făcut o mică adăugire la docker-compose.yml:
docker-compose.db.yml
versiune: '3.4'

x-mssql-base: &mssql-base
  imagine: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  repornire: întotdeauna
  mediu:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

servicii:
  dwh:
    imagine: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    imagine: mio101/py3-sql-db-client-base
    comandă: python3 ./mssql_init.py
    depinde_de:
      - mssql_0
      - mssql_1
      - mssql_2
    mediu:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volume:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Acolo ridicăm:
- Vertica ca host
dwhcu cele mai standard setări, - trei instanțe SQL Server,
- umplem bazele cu unele date recente (nu cumva să aruncați o privire în
mssql_init.py!)
Pornim toată treaba cu o comandă puțin mai complexă decât data trecută:
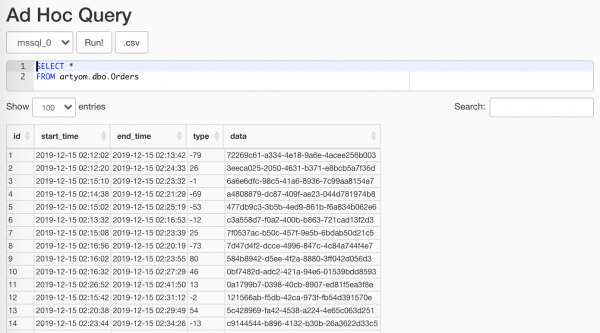
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Ce a generat minunatul nostru generator de aleator, poate fi folosit, apelând secțiunea Data Profiling/Ad Hoc Query:
Principalul lucru, nu arătați asta analistilor
Nu mă voi opri detaliat asupra sesiunilor ETL nu voi, acolo totul e trivial: creăm baza, în ea o tabelă, împachetăm totul într-un manager de context, și acum facem așa:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
de sys import stderr

clasa Session:
    """Flux de lucru ETL

    Exemplu:
        cu Session(task_name) ca sesiune:
            print(sesiune.id)
            sesiune.successful = True
            sesiune.loaded_rows = 15
            sesiune.comment = 'Bine făcut'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'opened')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Sesiunea nu este deschisă')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'closed',
              ', successful: ', self.successful,
              ', Loaded: ', self.loaded_rows,
              ', comment:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
A sosit momentul să ne luăm datele din cele peste o sută de mese. Vom face asta cu câteva linii foarte simple:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Cu ajutorul hook-ului vom obține din Airflow
pymssql-conexiunea - În interogare vom adăuga o restricție de dată — funcția o va introduce prin template.
- Îi oferim interogarea noastră
pandas, care va prelua pentru noiDataFrame— ne va fi util mai departe.
Folosesc substituția
{dt}în locul parametrului interogării%snu pentru că aș fi un Buratino rău, ci pentru căpandasnu poate face față lapymssqlși îi propune ultimuluiparams: List, chiar dacă acesta își dorește foarte multtuple.
De asemenea, rețineți că dezvoltatorulpymssqla decis să nu mai ofere suport și este timpul să ne mutăm pepyodbc.
Să vedem ce argumente ne-a oferit Airflow pentru funcțiile noastre:
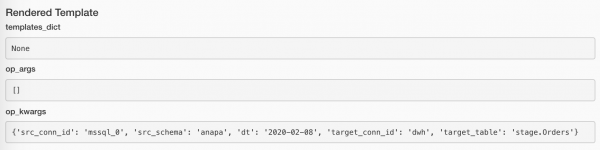
Dacă nu au fost date, nu are sens să continuăm. Dar nici să considerăm că încărcarea a fost reușită e ciudat. Dar nici nu este o eroare. A-ah, ce să facem?! Așa:
if df.empty:
    raise AirflowSkipException('No rows to load')
AirflowSkipException va spune Airflow că nu există, de fapt, o eroare, iar sarcina o să o sărim. În interfață nu va fi un pătrat verde sau roșu, ci de culoare roz.
Să adăugăm datelor noastre câteva coloane:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Anume:
- BD, din care am preluat comenzile,
- Identificatorul sesiunii noastre de încărcare (va fi diferit pentru fiecare sarcină),
- Hash-ul de la sursă și identificatorul comenzii — pentru ca în baza finală (unde totul se va aduna într-un singur tabel) să avem un identificator unic al comenzii.
A rămas penultimul pas: să încărcăm totul în Vertica. Și, cum nu e ciudat, una dintre cele mai eficiente metode de a face acest lucru este prin CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Facem un receptor special
StringIO. pandasse va ocupa să adune în elDataFrameîn formă deCSV-liniile.- Să deschidem o conexiune folosind hook-ul nostru preferat pentru Vertica.
- Și acum, folosind
copy()să trimitem datele noastre direct în Vertica!
Din driver, vom lua câte linii au fost adăugate și vom spune managerului de sesiune că totul este OK:
session.loaded_rows = cursor.rowcount
session.successful = True
Asta e tot.
Pe mediu de producție, creăm manual tabela țintă. Aici mi-am permis un mic automat:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Folosesc
VerticaOperator()pentru a crea schema BD și tabela (dacă acestea nu există încă, desigur). Principala atenție este asupra dependențelor corecte:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Încheiem
— Ei bine, — a spus fetița șoricel, — nu-i așa că acum
Te-ai convins că în pădure eu sunt cel mai înfricoșător animal?
Julia Donaldson, „Gruffalo”
Cred că dacă eu și colegii mei am organiza o competiție: cine reușește să construiască și să lanseze cel mai repede un proces ETL de la zero: ei cu SSIS și mouse-ul și eu cu Airflow… Și apoi am compara și ușurința de întreținere… Uff, cred că vei fi de acord că îi voi depăși pe toate fronturile!
Pentru a fi puțin mai serios, Apache Airflow – prin descrierea proceselor sub formă de cod – mi-a ușurat munca mult mai comodă și plăcută.
Extensibilitatea sa nelimitată: atât în ceea ce privește pluginurile, cât și predispoziția la scalabilitate – îți oferă posibilitatea de a aplica Airflow practic în orice domeniu: fie în ciclul complet de colectare, pregătire și procesare a datelor, fie în lansarea rachetelor (pe Marte, bineînțeles).
Partea finală, informații și referințe
Capcanele pe care le-am adunat pentru tine
start_date. Da, acesta este deja un meme local. Prin argumentul principal al DAG-uluistart_datetrec toate. Pe scurt, dacă specifici înstart_datedata curentă, iar înschedule_interval– o zi, atunci DAG-ul se va lansa mâine nu mai devreme.start_date = datetime(2020, 7, 7, 0, 1, 2)Și nicio altă problemă.
Aceasta este legată și de o altă eroare de execuție:
Task is missing the start_date parameter, care de cele mai multe ori semnalează că ai uitat să îl legi de operatorul DAG.- Totul pe o singură mașină. Da, și baze (ale Airflow-ului și al aplicației noastre), și server web, și planificator, și muncitorii. Și chiar a funcționat. Dar în timp, numărul de sarcini ale serviciilor a crescut, iar când PostgreSQL a început să răspundă prin index în 20 ms în loc de 5 ms, l-am luat și l-am mutat.
- LocalExecutor. Da, noi suntem pe el și acum, și ne-am apropiat de marginea prăpastiei. LocalExecutor-ul ne-a fost suficient până acum, dar acum a venit vremea să ne extindem cu cel puțin un muncitor, și va trebui să ne străduim să ne mutăm pe CeleryExecutor. Și având în vedere că poți lucra și pe o singură mașină, nimic nu ne oprește de la utilizarea Celery chiar pe un server care „evident, nu va merge niciodată în producție, cuvântul meu!”
- Lipsa utilizării unor instrumente încorporate:
- Connections pentru stocarea acreditivelor serviciilor,
- SLA Misses pentru a reacționa la sarcini care nu au fost finalizate la timp,
- XCom pentru a schimba metadatele (am spus metadate!) între sarcinile DAG-ului.
- Abuzul emailului. Ce pot să spun aici? Am configurat notificări pentru toate repetițiile de sarcini căzute. Acum, în Gmail-ul meu de lucru, sunt peste 90k de mesaje de la Airflow, iar interfața web a emailului refuză să preia și să șteargă mai mult de 100 de bucăți odată.
Mai multe capcane ascunse:
Mijloace de automatizare suplimentară
Pentru a ne ajuta să lucrăm mai mult cu mintea și nu cu mâinile, Airflow a pregătit pentru noi următoarele:
- — încă are statut experimental, ceea ce nu îi împiedică funcționarea. Cu ajutorul său nu poți doar să obții informații despre DAG-uri și sarcini, ci și să oprești/pornești un DAG, să creezi un DAG Run sau un pool.
- — prin linia de comandă, multe instrumente sunt disponibile, care nu sunt doar incomode de utilizat prin WebUI, ci chiar lipsesc cu desăvârșire. De exemplu:
backfilleste necesar pentru a relua instanțele sarcinilor.
De exemplu, au venit analiștii și spun: „Și la voi, tovarășe, e o problemă cu datele din 1 până pe 13 ianuarie! Repară-repară-repară-repară!”. Și tu ai așa:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Întreținerea bazei de date:
initdb,resetdb,upgradedb,checkdb. run, care permite să lansezi o instanță de sarcină, fără a ține cont de toate dependențele. Mai mult, poți să o lansezi prinLocalExecutor, chiar dacă ai un cluster Celery.- Aproape același lucru face
test, doar că nu scrie nimic în bază. connectionspermete crearea în masă a conectărilor din shell.
- este o modalitate destul de hardcore de interacțiune, destinată plugin-urilor, nu pentru a te chinui manual. Dar cine ne poate opri să intrăm în
/home/airflow/dags, să lansămipythonși să ne distram? De exemplu, poți exporta toate conexiunile cu următorul cod:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Conexiune la baza de date a metadatelor Airflow. Nu recomand să scrii în ea, dar poți obține starea sarcinilor pentru diverse metrici specifice mult mai repede și mai ușor decât prin oricare dintre API-uri.
Să spunem că nu toate sarcinile noastre sunt idempotente și pot cădea din când în când, ceea ce este normal. Dar ceva acumulări sunt deja suspecte și ar trebui verificate.
Atenție, SQL!
CU ultimile execuții AS (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' ZILE
),
failed AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Linkuri
Și, desigur, primele zece linkuri din rezultatele Google conțin conținutul folderului Airflow din favoritele mele.
- — firesc, trebuie să începem cu documentația oficială, dar cine citește instrucțiunile?
- — măcar citiți recomandările creatorilor.
- — începutul: interfața utilizator în imagini
- — bazele sunt bine explicate, în cazul în care (deci!) nu ați înțeles ceva de la mine.
- — un ghid scurt pentru configurarea clusterului Airflow.
- — un articol aproape la fel de interesant, doar că mai formal, cu mai puține exemple.
- — despre lucrul în tandem cu Celery.
- — despre idempotența sarcinilor, încărcarea după ID în loc de dată, transformări, structura fișierelor și alte lucruri interesante.
- — dependențele sarcinilor și Trigger Rule, pe care le-am menționat doar în treacăt.
- — cum să depășești câteva "funcționează conform așteptărilor" ale programatorului, să încarci datele pierdute și să prioritizezi sarcinile.
- — interogări SQL utile pentru metadatele Airflow.
- — există o secțiune utilă despre crearea unui senzor personalizat.
- — o notă scurtă interesantă despre construirea infrastructurii pe AWS pentru Data Science.
- — erori frecvente (când cineva totuși nu citește instrucțiunile).
- — zâmbiți, cum oamenii fac workaround-uri pentru stocarea parolelor, deși se poate folosi pur și simplu Connections.
- — trecerea implicită a DAG-ului, trecerea contextului în funcții, din nou despre dependențe, iar despre săritul peste lansările task-urilor.
- — despre utilizarea
argumente impliciteșiparamsîn șabloane, dar și despre Variabile și Conexiuni. - — o poveste despre cum se pregătește planificatorul pentru Airflow 2.0.
- — un articol puțin depășit despre desfășurarea clusterului nostru în
docker-compose. - — sarcini dinamice folosind șabloane și trecerea contextului.
- — notificări standard și personalizate prin email și Slack.
- — Ramificarea sarcinilor, macro-uri și XCom.
Și linkurile utilizate în articol:
- — plase care sunt disponibile pentru utilizare în șabloane.
- — Greșeli frecvente în crearea DAG-urilor.
- —
docker-composepentru experimente, depanare și nu numai. - — Wrapper Python pentru REST API Telegram.
Sursa: habr.com
