

Scopul principal al Patroni este de a asigura disponibilitatea ridicată pentru PostgreSQL. Dar Patroni este doar un template, nu un instrument gata făcut (așa cum este specificat în documentație). La prima vedere, după ce configurăm Patroni într-un laborator de testare, putem observa cât de minunat este acest instrument și cât de ușor gestionează tentativele noastre de a distruge clusterul. Cu toate acestea, în practică, în medii de producție, nu totul decurge atât de frumos și elegant, cum se întâmplă în laboratoarele de testare.
Voi povesti puțin despre mine. Am început ca administrator de sistem. Am lucrat în dezvoltarea web. Din 2014, lucrez la Data Egret. Compania se ocupă cu consultanța în domeniul Postgres. Și noi ne concentrăm pe Postgres, lucrând cu acesta în fiecare zi, astfel încât avem diferite expertize legate de exploatarea acestuia.
Și la sfârșitul anului 2018, am început treptat să folosim Patroni. Am acumulat un anumit nivel de experiență. L-am diagnosticat, l-am optimizat și am ajuns la cele mai bune practici. Iar în această prezentare voi vorbi despre acestea.
Pe lângă Postgres, îmi place Linux. Îmi place să mă ocup cu el și să explorez, îmi place să compilez kerneluri. Îmi place virtualizarea, containerele, Docker, Kubernetes. Mă interesează toate acestea deoarece se resimt vechile obiceiuri de administrator. Îmi place să mă ocup de monitorizare. Și îmi plac lucrurile legate de administrarea PostgreSQL, adică replicarea, backup-ul. În timpul liber, scriu în Go. Nu sunt inginer software, scriu doar pentru mine în Go. Și îmi face plăcere.
- Cred că mulți dintre voi știu că în Postgres nu există HA (Disponibilitate Ridicată) din fabrică. Pentru a obține HA, trebuie să instalați ceva, să configurați, să depuneți eforturile necesare și să obțineți rezultatul.
- Există câteva instrumente, iar Patroni este unul dintre ele, care rezolvă HA într-un mod destul de grozav și eficient. Dar după ce am instalat totul într-un laborator de testare și l-am pornit, putem observa că totul funcționează. Putem reproduce anumite probleme și putem vedea cum le gestionează Patroni. Și vom constata că totul funcționează minunat.
- Dar în practică ne-am confruntat cu diverse probleme. Iar despre aceste probleme voi vorbi.
- Voi povesti cum le-am diagnosticat, ce am ajustat – ne-a ajutat sau nu.
- Nu voi povesti despre cum să instalez Patroni, deoarece poate fi găsit pe internet, se pot consulta fișierele de configurație pentru a înțelege cum se pornește și cum se configurează totul. Poți să te familiarizezi cu schemele, arhitecturile, găsind informații despre acestea pe internet.
- Nu voi vorbi despre experiențele altora. Voi vorbi doar despre problemele cu care ne-am confruntat noi.
- Și nu voi discuta despre problemele din afara Patroni și PostgreSQL. De exemplu, problemele legate de echilibrarea încărcării, când clusterele noastre au căzut, despre acestea nu voi vorbi.
Și un mic disclaimer înainte de a începe prezentarea noastră.
Toate aceste probleme cu care ne-am confruntat au apărut în primele 6-7-8 luni de utilizare. Cu timpul, am ajuns la propriile noastre bune practici. Și problemele au dispărut. Această prezentare a fost planificată acum aproximativ șase luni, când totul era încă proaspăt în minte și îmi aminteam foarte bine.
În timpul pregătirii prezentării, am revizuit vechile postmortem-uri, am verificat jurnalele. Unele detalii ar fi putut fi uitate, sau unele detalii ar fi putut să nu fie suficient cercetate în analiza problemelor, așa că în unele momente poate părea că problemele nu au fost examinate complet sau există o lipsă de informații. De aceea, vă rog să-mi iertați acest aspect.
Ce este Patroni?
- Este un șablon pentru construirea HA. Așa este scris în documentație. Și din punctul meu de vedere, este o clarificare foarte corectă. Patroni nu este o soluție miraculoasă care va rezolva toate problemele tale, adică trebuie să depui efort pentru a începe să funcționeze și să aducă beneficii.
- Este un serviciu agenție care se instalează pe fiecare serviciu cu baza de date și care este, într-un fel, un sistem init pentru PostgreSQL-ul tău. Acesta pornește PostgreSQL, îl oprește, îl repornește, schimbă configurația și modifică topologia cluster-ului tău.
- Prin urmare, pentru a păstra starea cluster-ului, imaginea sa actuală, așa cum arată, este nevoie de un tip de stocare. Și din acest punct de vedere, Patroni a optat pentru stocarea stării într-un sistem extern. Acesta este un sistem distribuit de stocare a configurației. Acestea pot fi Etcd, Consul, ZooKeeper, sau Etcd-ul din Kubernetes, adică una dintre aceste opțiuni.
- Una dintre caracteristicile Patroni este că obții un failover automat din cutie, doar prin configurare. Comparativ cu Repmgr, unde failover-ul este inclus, în Repmgr avem un switchover, dar dacă dorim un failover automat, trebuie să-l configurăm suplimentar. Patroni vine cu failover automat din cutie.
- Și mai sunt multe alte lucruri. De exemplu, gestionarea configurațiilor, adăugarea de replici noi, backup-uri etc. Dar acestea sunt în afara prezentării, nu voi vorbi despre ele.
Și un mic rezumat este că principala sarcină a Patroni este să efectueze un failover automat bine și fiabil, astfel încât clusterul nostru să rămână funcțional și aplicația să nu observe modificările în topologia clusterului.
Dar atunci când începem să folosim Patroni, sistemul nostru devine un pic mai complex. Dacă înainte aveam Postgres, acum, folosind Patroni, obținem Patroni în sine, DCS-ul, unde este stocat starea. Și toate acestea trebuie să funcționeze într-un fel. De aceea, ce se poate defecta?
Se poate defecta:
- Postgres se poate defecta. Acesta poate fi un master sau o replică, oricare dintre ele poate ieși din funcțiune.
- Se poate defecta însuși Patroni.
- Se poate defecta DCS-ul, unde este stocat starea.
- Și se poate defecta rețeaua.
Toate aceste probleme le voi analiza în prezentare.
Voi analiza cazurile pe măsură ce devin mai complexe, nu din perspectiva că un caz implică multe componente, ci din perspectiva sentimentului subiectiv că acest caz a fost complicat pentru mine, că a fost dificil de descompus... și invers, un caz a fost simplu și a fost ușor de analizat.
Și primul caz este cel mai simplu. Este cazul în care am luat un cluster de baze de date și pe același cluster am desfășurat sistemul nostru de stocare DCS. Aceasta este cea mai comună eroare. Este o eroare de construcție a arhitecturii, adică combinarea diferitelor componente într-un singur loc.
Așadar, a avut loc un failover, să vedem ce s-a întâmplat.
Și aici ne interesează momentul în care a avut loc failover-ul. Adică, ne interesează acel moment în care a avut loc schimbarea stării clusterului.
Dar failover-ul nu este întotdeauna instantaneu, adică nu durează o unitate de timp, poate fi prelungit. Poate dura mult timp.
Prin urmare, acesta are un timp de început și un timp de finalizare, adică este un eveniment de durată. Împărțim toate evenimentele în trei intervale: avem timp înainte de failover, timpul during failover și după failover. Adică, analizăm toate evenimentele în această linie de timp.
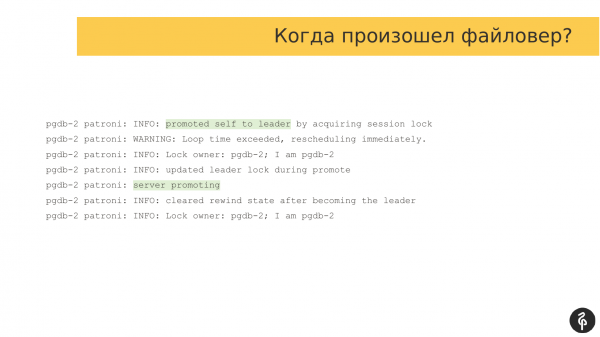
Și primul lucru atunci când a avut loc failoverul, căutăm cauza, ce s-a întâmplat, ce a dus la failover.
Dacă ne uităm la loguri, acestea vor fi logurile clasice Patroni. Ele ne informează că serverul a devenit master și rolul de master a fost transferat pe acest nod. Aici este evidențiat.
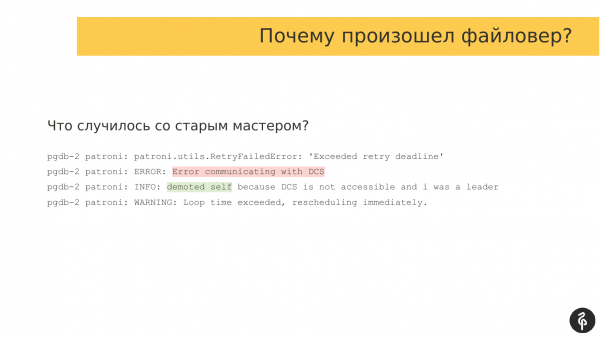
Mai departe, trebuie să înțelegem de ce s-a produs failoverul, adică ce evenimente au avut loc care au determinat rolul de master să se mute de pe un nod pe altul. În acest caz, totul este simplu. Avem o eroare de interacțiune cu sistemul de stocare. Masterul a realizat că nu poate lucra cu DCS, adică a apărut o problemă de interacțiune. Și spune că nu mai poate fi master și renunță la atribuții. Această linie „demoted self” spune exact despre asta.
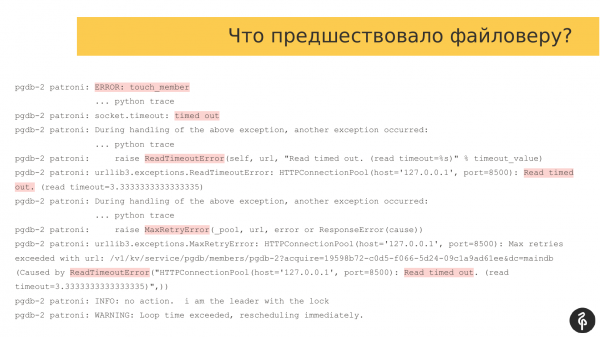
Dacă examinăm evenimentele care au precedat failoverul, atunci putem vedea acele cauze care au reprezentat o problemă pentru continuarea activității masterului.
Dacă ne uităm la logurile Patroni, vom observa că avem multe erori, timp de așteptare, adică agentul Patroni nu poate comunica cu DCS. În acest caz, este agentul Consul, cu care se comunică pe portul 8500.
Și problema aici constă în faptul că Patroni și baza de date sunt pornite pe același host. Și pe acest nod au fost pornite serverele Consul. Creând o încărcătură pe server, am creat probleme și pentru servere Consul. Acestea nu au putut comunica corect.
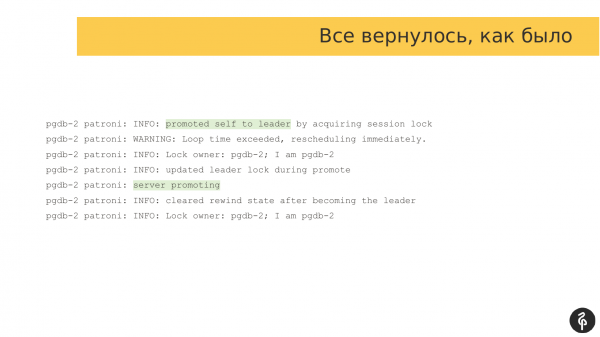
După un timp, când sarcina a scăzut, Patroni nostru a reușit din nou să comunice cu agenții. Activitatea normală a fost reluată. Și același server Pgdb-2 a devenit din nou master. Adică, a fost o mică revenire, din cauza căreia nodul a renunțat la atribuții de master, iar apoi le-a preluat din nou, adică totul a revenit la cum a fost.
Și aceasta poate fi interpretată ca o eroare falsă, sau poate fi văzută că Patroni a acționat corect. Adică, a realizat că nu poate menține starea clusterului și a renunțat la atribuții.
Și aici problema a apărut pentru că serverele Consul se află pe aceeași infrastructură ca bazele de date. Prin urmare, orice încărcare: fie că este vorba despre încărcarea pe discuri sau procesoare, aceasta afectează și interacțiunea cu clusterul Consul.
Și am decis că acestea nu ar trebui să existe împreună, am alocat un cluster separat pentru Consul. Și Patroni a lucrat deja cu un Consul separat, adică a existat un cluster Postgres separat, un cluster Consul separat. Aceasta este instrucțiunea de bază despre cum trebuie gestionate toate aceste aspecte pentru a nu exista împreună.
Ca o opțiune, putem ajusta parametrii ttl, loop_wait, retry_timeout, adică să încercăm să supraviețuim acestor vârfuri temporare de încărcare prin creșterea acestor parametri. Dar nu este cea mai potrivită opțiune, deoarece această încărcare poate fi de lungă durată. Și pur și simplu vom depăși limitele acestor parametri. Și s-ar putea să nu ajute deloc.
Prima problemă, după cum ați înțeles, este simplă. Am luat DCS-ul și l-am pus împreună cu baza, am obținut o problemă.
A doua problemă este similară cu prima. Este asemănătoare prin faptul că din nou avem probleme de interacțiune cu sistemul DCS.
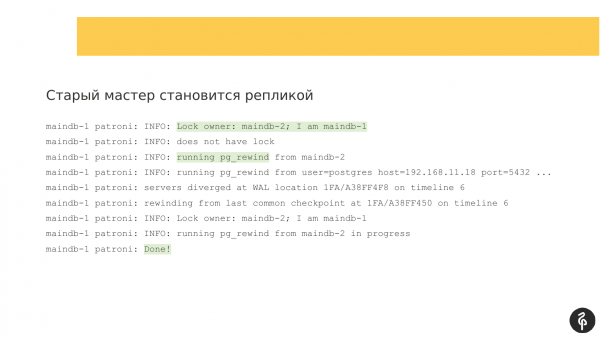
Dacă ne uităm la jurnale, vom observa din nou o eroare de comunicare. Și Patroni spune că nu pot interacționa cu DCS, prin urmare, actualul master trece în modul replică.
Fostul master devine replică, aici Patroni lucrează așa cum trebuie. El pornește pg_rewind pentru a răsfoi jurnalul de tranzacții și apoi se conectează la noul master, urmând să ajungă din urmă noul master. Aici Patroni funcționează așa cum este corect.
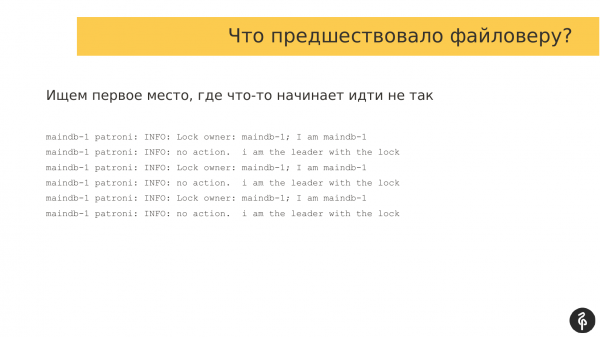
Aici trebuie să găsim locul care a precedat erorile, adică acele erori care au fost cauza pentru care a avut loc eroarea de fișier. În acest sens, lucrul cu jurnalele Patroni este destul de convenabil. La intervale regulate, el scrie aceleași mesaje. Și dacă începem să derulăm rapid aceste jurnale, vom observa că jurnalele s-au schimbat, ceea ce înseamnă că au apărut probleme. Ne întoarcem rapid la acel loc și vedem ce se întâmplă.
Și în situații normale, jurnalele arată cam așa. Se verifică proprietarul blocării. Și dacă proprietarul, de exemplu, s-a schimbat, atunci pot apărea anumite evenimente la care Patroni trebuie să reacționeze. Dar în acest caz, avem totul în regulă. Căutăm acel loc unde au început erorile.
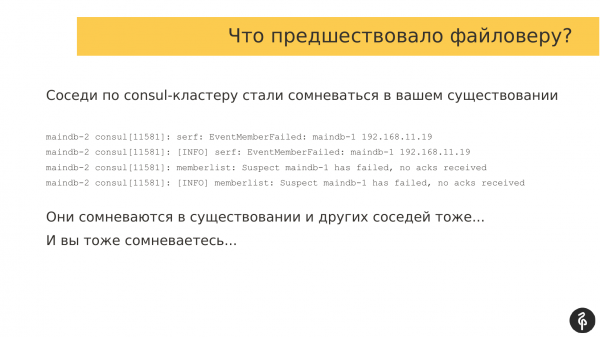
Și dacă derulăm înapoi la momentul în care au început să apară erorile, observăm că a avut loc un auto-failover. Și deoarece erorile noastre au fost legate de interacțiunea cu DCS și în cazul nostru am utilizat Consul, ne uităm și la logurile Consul pentru a vedea ce s-a întâmplat acolo.
Comparând aproximativ momentul failover-ului cu timestamp-urile din logurile Consul, observăm că vecinii din clusterul Consul au început să se îndoiască de existența altor membri ai clusterului Consul.
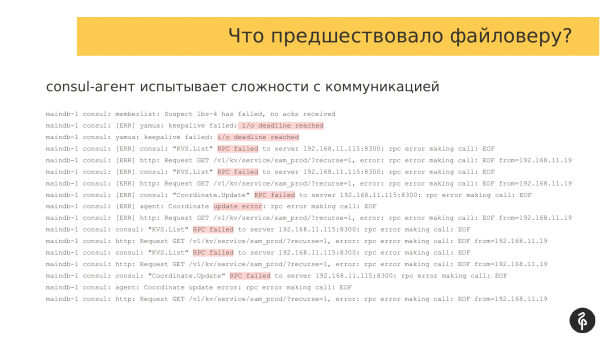
Dacă ne uităm și la logurile altor agenți Consul, se poate vedea că acolo se întâmplă un colaps rețea. Toți membrii clusterului Consul se îndoiesc de existența celorlalți. Acesta a fost un factor care a dus la failover.
Dacă analizăm ce s-a întâmplat înainte de aceste erori, putem observa că există diverse erori, cum ar fi deadline, RPC failed, adică clar există o problemă în interacțiunea membrilor clusterului Consul între ei.
Cel mai simplu răspuns ar fi să reparăm rețeaua. Dar pentru mine, aflându-mă la tribună, este ușor să fac această afirmație. Însă situația este astfel încât nu întotdeauna clientul își poate permite să repare rețeaua. El poate locui în DC și poate să nu aibă capacitatea de a repara rețeaua sau de a influența echipamentele. Prin urmare, sunt necesare alte opțiuni.
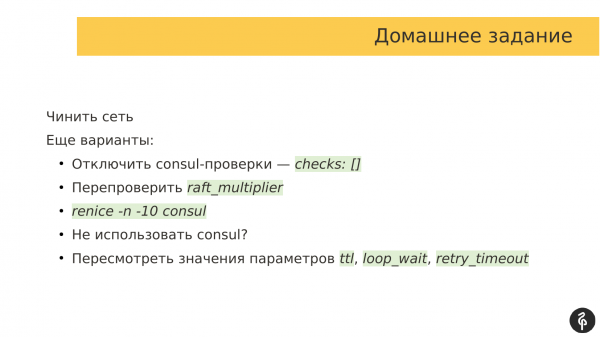
Există opțiuni:
- Cea mai simplă opțiune, despre care cred că este menționată chiar în documentație, este să dezactivăm verificările Consul, adică pur și simplu să furnizăm un array gol. Și spunem agentului Consul să nu utilizeze nicio verificare. Prin aceste verificări, putem ignora aceste furtuni de rețea și să nu inițiem failover.
- O altă opțiune este să revizuim raft_multiplier. Acest parametru aparține serverului Consul. Implicit, este setat la valoarea 5. Această valoare este recomandată în documentație pentru medii de staging. Practic, aceasta influențează frecvența schimbului de mesaje între membrii rețelei Consul. Acest parametru influențează viteza comunicării între membrii clusterului Consul. Și pentru producție, se recomandă reducerea sa pentru a permite nodurilor să schimbe mesaje mai frecvent.
- O altă variantă pe care am început să o folosim este creșterea priorității proceselor Consul în comparație cu celelalte procese din planificatorul de procese al sistemului de operare. Există un parametru numit „nice”, care determină exact prioritatea proceselor luată în considerare de planificatorul OS. Am redus valoarea nice pentru agenții Consul, adică le-am crescut prioritatea, astfel încât sistemul de operare să aloce mai mult timp proceselor Consul pentru a-și executa codul. În cazul nostru, aceasta a rezolvat problema.
- O altă variantă este să nu folosești Consul. Am un prieten care este un mare susținător al Etcd. Și ne certăm regulat despre care este mai bun, Etcd sau Consul. Dar, în ceea ce privește ce este mai bun, de obicei ajungem la concluzia că Consul are un agent care trebuie să fie rulat pe fiecare nod cu baza de date. Adică interacțiunea dintre Patroni și clusterul Consul se face prin acest agent. Și acest agent devine un punct slab. Dacă se întâmplă ceva cu agentul, Patroni nu mai poate funcționa cu clusterul Consul. Și aceasta este o problemă. În cazul Etcd, nu există niciun agent. Patroni poate lucra direct cu lista serverelor Etcd și poate comunica deja cu ele. În această privință, dacă folosești Etcd în compania ta, acesta ar fi, probabil, cea mai bună alegere comparativ cu Consul. Dar noi, la clienții noștri, suntem adesea limitați de ceea ce a ales și folosește clientul. Și, în cea mai mare parte, Consul este folosit de toți clienții.
- Iar ultimul punct este să revizuim valorile parametrilor. Putem crește aceste valori, sperând că problemele noastre temporare de rețea vor fi scurte și nu vor depăși intervalul acestor parametrii. Astfel, putem reduce agresivitatea lui Patroni în executarea failover-ului automat atunci când apar probleme de rețea.
Cred că mulți dintre cei care folosesc Patroni sunt familiarizați cu acest comanda.
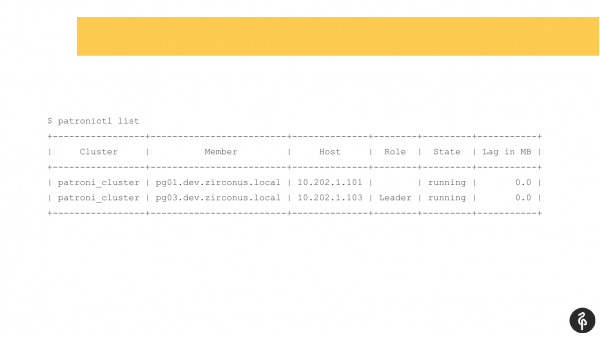
Această comandă arată starea curentă a clusterului. Și, la prima vedere, această imagine poate părea normală. Avem un master, avem o replică, nu există întârziere în replicare. Dar această imagine este normală doar până când nu știm că în acest cluster ar trebui să fie trei noduri, nu două.
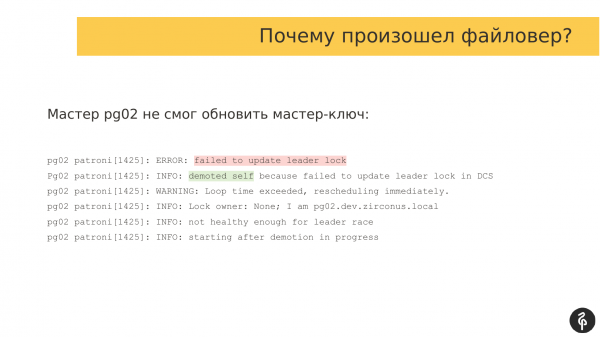
Așadar, a avut loc o auto-încărcare de fișiere. După această auto-încărcare, replica noastră a dispărut. Trebuie să aflăm de ce a dispărut și să o readucem, să o restabilim. Și ne întoarcem din nou în jurnale pentru a vedea de ce a avut loc auto-încărcarea.
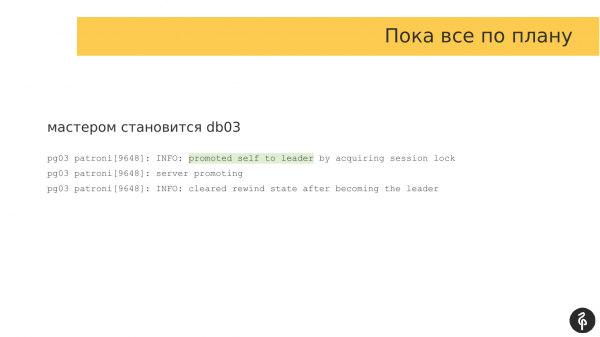
În acest caz, a doua replică a devenit master. Aici totul este în regulă.
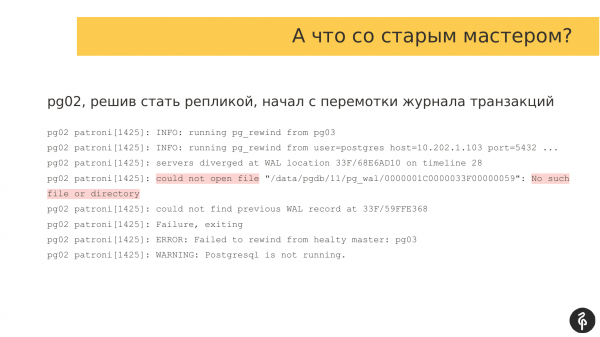
Trebuie să ne uităm acum la replica care a căzut și care nu se află în cluster. Deschidem jurnalele Patroni și vedem că a avut loc o problemă în timpul conectării la cluster la etapa pg_rewind. Pentru a ne conecta la cluster, trebuie să revenim în jurnalul de tranzacții, să cerem jurnalul de tranzacții necesar de la master și să-l ajungem pe master.
În acest caz, nu avem jurnal de tranzacții și replica nu se poate porni. Așadar, oprim Postgres cu o eroare. Și de aceea nu se află în cluster.
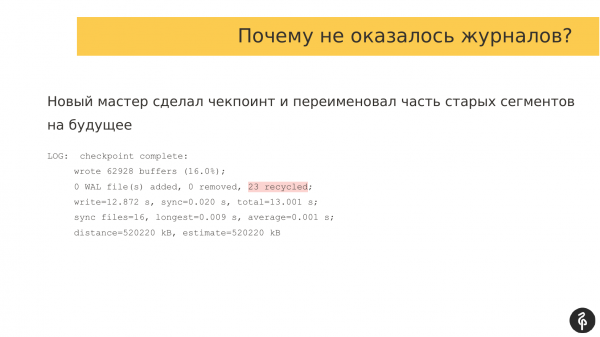
Trebuie să înțelegem de ce nu se află în cluster și de ce nu au existat jurnale. Ne îndreptăm spre noul master și vedem ce are în jurnale. Se dovedește că, atunci când s-a efectuat pg_rewind, a avut loc un checkpoint. Și o parte din jurnalele vechi de tranzacții au fost pur și simplu redenumite. Atunci când vechiul master a încercat să se conecteze la noul master și să ceară aceste jurnale, ele deja fuseseră redenumite, de fapt nu au existat.
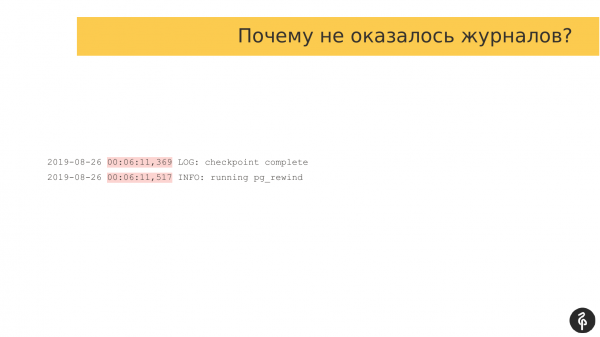
Am comparat timestamp-urile când s-au întâmplat aceste evenimente. Iar diferența era de doar 150 de milisecunde, adică în 369 de milisecunde s-a finalizat checkpoint-ul și segmentele WAL au fost redenumite. Și la 517, după 150 de milisecunde, s-a pornit rewind-ul pe vechea replică. Adică, cu adevărat 150 de milisecunde ne-au fost suficiente pentru ca replica să nu se poată conecta și să funcționeze.
Ce opțiuni avem?
Inițial, am folosit sloturi de replicare. Ni s-a părut că este bine. Deși în prima etapă a exploatării am dezactivat sloturile. Ne-am gândit că, dacă sloturile vor acumula multe segmente WAL, putem provoca o cădere a master-ului. Acesta va cădea. Ne-am chinuit o vreme fără sloturi. Și ne-am dat seama că avem nevoie de sloturi, așa că le-am recuperat.
Dar există o problemă, că atunci când masterul trece la replică, acesta șterge sloturile și odată cu sloturile șterge segmentele WAL. Pentru a exclude apariția acestei probleme, am decis să creștem parametrul wal_keep_segments. Implicit este de 8 segmente. L-am crescut la 1.000 și am verificat cât spațiu liber avem. Și am câștigat 16 gigaocteți pentru wal_keep_segments. Adică, în timpul comutării, avem întotdeauna un surplus de 16 gigaocteți de jurnale de tranzacții pe toate nodurile.
Și plus – este de actualitate și pentru sarcini de întreținere de lungă durată. Să presupunem că trebuie să actualizăm una dintre replici. Iar noi dorim să o oprim. Trebuie să actualizăm software-ul, poate sistemul de operare, altceva. Și când oprim replica, pentru acea replică se șterge și slotul. Și dacă utilizăm un wal_keep_segments mic, în absența prelungită a replicii, jurnalele de tranzacții vor fi pierdute. Vom reporni replica, aceasta va solicita acele jurnale de tranzacții de unde se oprise, dar la master poate să nu existe. Și replica nu se va putea conecta. De aceea, menținem un stoc mare de jurnale.
Avem o bază de date de producție. Acolo funcționează deja proiecte.
A avut loc o eroare de sistem. Am intrat și am verificat – totul în regulă, replicile sunt la locul lor, nu există întârziere în replicare. Nu sunt erori în jurnale, totul este în regulă.
Echipa de produs spune că ar trebui să existe unele date, dar le vedem dintr-o singură sursă, iar în bază nu le vedem. Și trebuie să înțelegem ce s-a întâmplat cu ele.
Este clar că pg_rewind le-a șters. Ne-am dat seama imediat, dar am mers să verificăm ce s-a întâmplat.
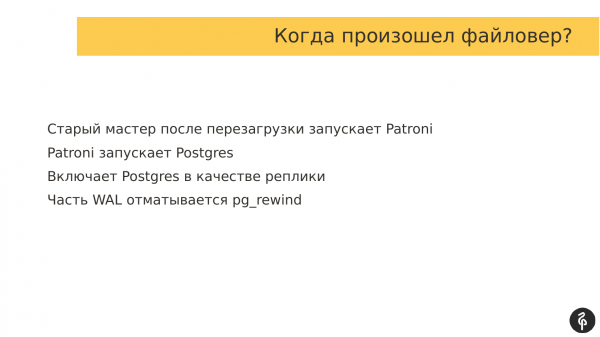
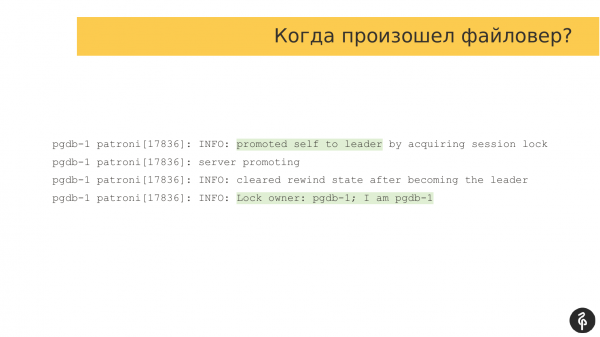
În jurnale, putem găsi întotdeauna când s-a întâmplat eroarea de sistem, cine a devenit master și putem determina cine a fost vechiul master și când a dorit să devină replică, adică avem nevoie de aceste jurnale pentru a stabili volumul jurnalele de tranzacții care au fost pierdute.
Vechiul nostru master s-a repornit. Și în autostart a fost configurat Patroni. A fost lansat Patroni. Acesta a lansat apoi Postgres. Mai precis, înainte de a lansa Postgres și înainte de a-l face replică, Patroni a lansat procesul pg_rewind. Prin urmare, a șters o parte din jurnalele de tranzacții, a descărcat altele noi și s-a conectat. Aici Patroni a funcționat excelent, adică așa cum era de așteptat. Clusterul nostru s-a recuperat. Am avut 3 noduri, după eroare de sistem tot 3 noduri – totul este grozav.
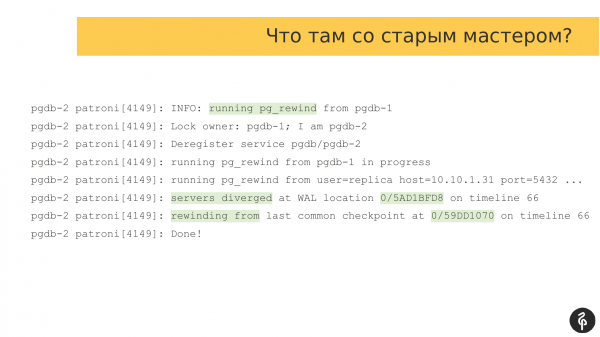
Am pierdut o parte din date. Trebuie să înțelegem cât am pierdut. Căutăm momentul exact în care a avut loc rewind. Putem găsi acest lucru din jurnalele de înregistrare. Rewind a început, a făcut ceva acolo și s-a încheiat.
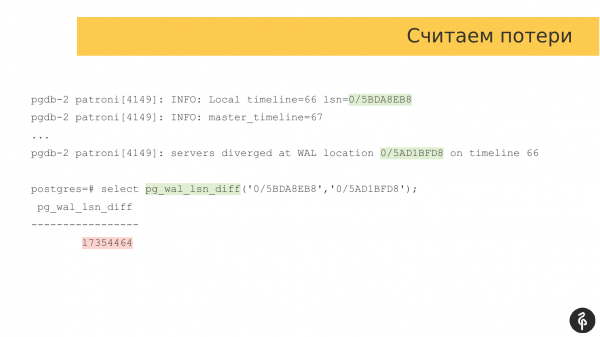
Trebuie să găsim poziția din jurnalul de tranzacții la care s-a oprit vechiul master. În acest caz – acesta este marcajul respectiv. Și avem nevoie de un al doilea marcaj, adică distanța la care se diferențiază vechiul master de noul.
Folosim diferența pg_wal_lsn_diff și comparăm aceste două marcaje. În acest caz obținem 17 megabiți. Este mult sau puțin, fiecare decide pentru sine. Pentru unii, 17 megabiți reprezintă puțin, pentru alții este mult și inacceptabil. Aici fiecare își definește individual în funcție de nevoile afacerii.
Dar ce am stabilit pentru noi?
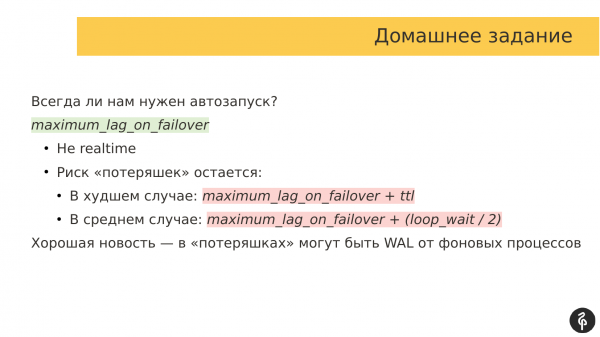
În primul rând, trebuie să ne decidem – avem întotdeauna nevoie de pornirea automată Patroni după repornirea sistemului? De cele mai multe ori, trebuie să ne conectăm la vechiul master, să vedem cât de departe a ajuns. Poate trebuie să inspectăm segmentele jurnalului de tranzacții, să vedem ce este acolo. Și să înțelegem – putem pierde aceste date sau trebuie să pornim vechiul master în mod standalone pentru a recupera aceste date.
Și doar după aceea trebuie să luăm decizii dacă putem să abandonăm aceste date sau dacă le putem recupera, conectând acest nod ca replică în clusterele noastre.
În plus, există parametrul „maximum_lag_on_failover”. Din câte mi-aduc aminte, acest parametru are valoarea de 1 megabit în mod implicit.
Cum funcționează? Dacă replica noastră este cu 1 megabit în urmă în raport cu lag-ul de replicare, atunci această replică nu participă la alegeri. Și dacă apare un failover, Patroni verifică ce replici sunt în întârziere. Dacă sunt în urmă cu un număr mare de jurnale de tranzacții, ele nu pot deveni master. Aceasta este o funcție de protecție foarte bună care ajută la prevenirea pierderii unei cantități mari de date.
Dar există o problemă în faptul că lag-ul de replicare în clusterul Patroni și DCS este actualizat la intervale specificate. Cred că valoarea ttl implicit este de 30 de secunde.
Prin urmare, poate exista o situație în care întârzierea replicării pentru replicile din DCS este una, dar în realitate poate fi complet diferită sau poate chiar să nu existe deloc întârziere, adică acest proces nu este în timp real. Și nu reflectă întotdeauna imaginea reală. Nu ar trebui să construim o logică complexă pe baza acesteia.
Și riscul de pierderi rămâne întotdeauna. Și în cel mai rău caz o formulă, iar în cazul mediu o altă formulă. Adică, atunci când planificăm implementarea Patroni și evaluăm câte date băm putea pierde, trebuie să ne bazăm pe aceste formule și să avem o idee despre câte date putem pierde.
Și există o veste bună. Când vechiul master a avansat, el poate avansa datorită unor procese de fundal. Adică, a existat un auto-vacuum, a scris datele, le-a salvat în jurnalul de tranzacții. Și aceste date putem să le ignorăm cu ușurință și să le pierdem. Nu este nicio problemă în asta.
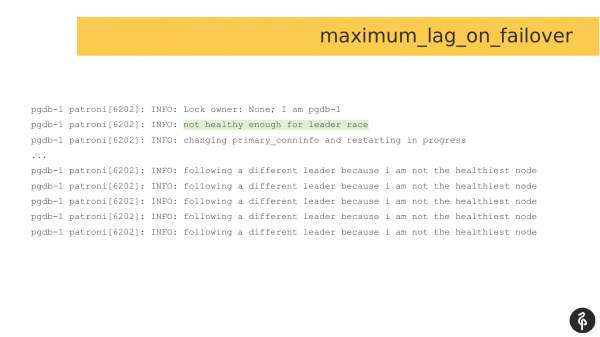
Și așa arată jurnalele în cazul în care este setat maximum_lag_on_failover și a avut loc un failover, iar un nou master trebuie ales. Replica se evaluează ca incapabilă să participe la alegeri. Și refuză participarea în cursa pentru lider. Așteaptă să fie ales un nou master, pentru a se conecta ulterior la el. Aceasta este o măsură suplimentară împotriva pierderii de date.
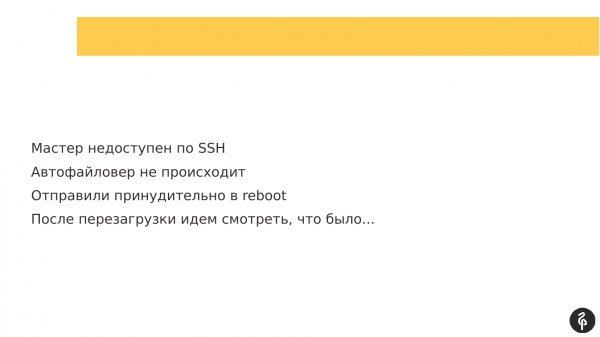
Aici echipa de produs ne-a informat că produsul lor întâmpină probleme în lucrul cu Postgres. În același timp, nu se poate accesa masterul, deoarece nu este disponibil prin SSH. Și auto-failover-ul nu se întâmplă.
Acest host a fost forțat să se repornească. Din cauza repornirii a avut loc un auto-failover, deși ar fi putut fi realizat și un failover manual, așa cum înțeleg acum. Și după repornire, vom verifica ce s-a întâmplat cu masterul actual.
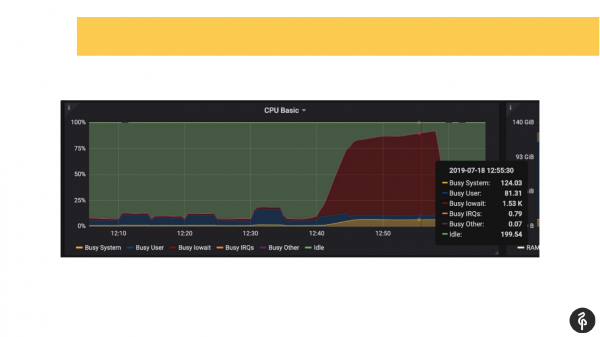
De asemenea, știam dinainte că aveam probleme cu discurile, adică deja știam din monitorizare unde să căutăm și ce să căutăm.
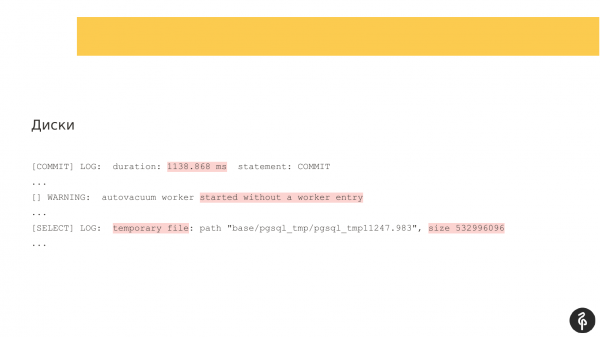
Am intrat în jurnalul postgres, am început să vedem ce se întâmplă. Am observat comitente care durează câte una, două, trei secunde, ceea ce nu este normal. Am observat că auto-vacuum-ul se pornește foarte lent și ciudat. Și am văzut fișiere temporare pe disc. Adică, acestea sunt toate semnele problemelor cu discurile.
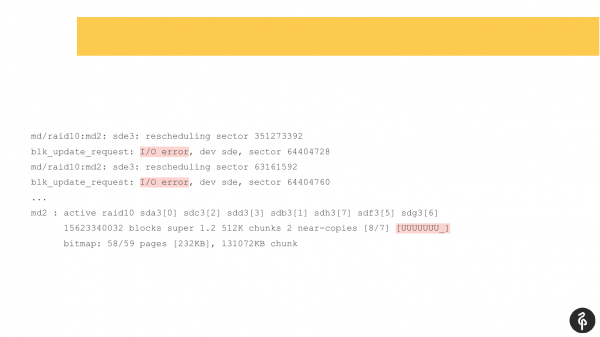
Am verificat în logul dmesg al sistemului (jurnalul mesajelor kernel). Și am constatat că avem probleme cu unul dintre disque. Subsistemul de stocare era un RAID software. Am privit în /proc/mdstat și am observat că ne lipsește un disk. Adică, avem un RAID din 8 disque, iar unul lipsește. Dacă ne uităm cu atenție la slide, putem observa că avem sde absent. Practic, un disk a fost pierdut. Aceasta a declanșat problemele de stocare, iar aplicațiile au avut de suferit în interacțiunea cu clusterul Postgres.
În această situație, Patroni nu ne-ar fi ajutat, deoarece Patroni nu are sarcina de a monitoriza starea serverului sau a disque-ului. Trebuie să monitorizăm astfel de situații cu un sistem de monitorizare extern. Am adăugat rapid monitorizarea disque-urilor în monitorizarea externă.
A fost o idee – ne-ar fi putut ajuta fencing-ul sau un watchdog software? Ne-am gândit că este puțin probabil să ne ajute în această situație, deoarece în timpul problemelor Patroni a continuat să interacționeze cu clusterul DCS și nu a observat nicio problemă. Adică, din perspectiva DCS și Patroni, totul părea în regulă, deși, de fapt, existau probleme cu disque-urile și accesibilitatea bazei de date.
Din punctul meu de vedere, aceasta este una dintre cele mai ciudate probleme pe care le-am investigat mult timp, am citit foarte multe loguri și am numit-o cluster-simulant.
Problema era că vechiul master nu putea deveni o replică normală, adică Patroni îl pornea, Patroni arăta că acest nod este prezent ca replică, dar, în același timp, nu era o replică normală. Acum veți înțelege de ce. Aceasta a fost păstrată din analiza acelei probleme.
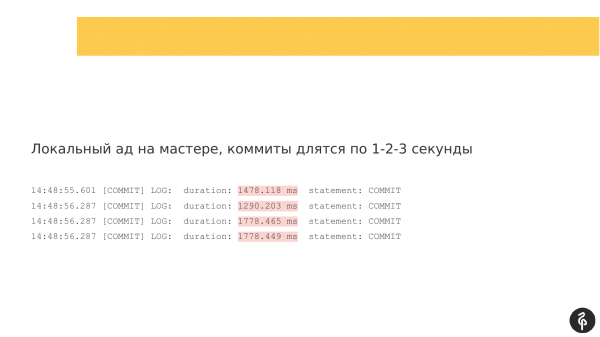
Și de unde a început totul? A început, la fel ca în problema anterioară, cu întârzieri de disk. Aveam comenzi de un commit pe secundă, două.
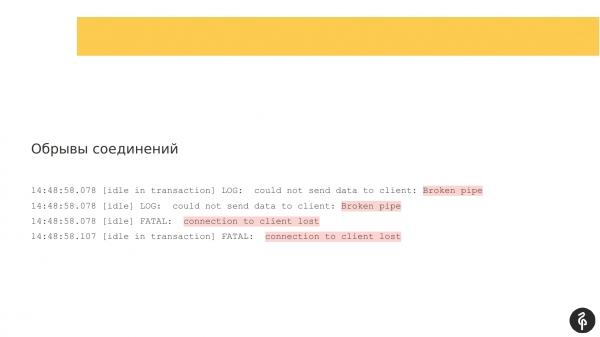
Au fost întreruperi ale conexiunilor, adică clienții se deconectau.
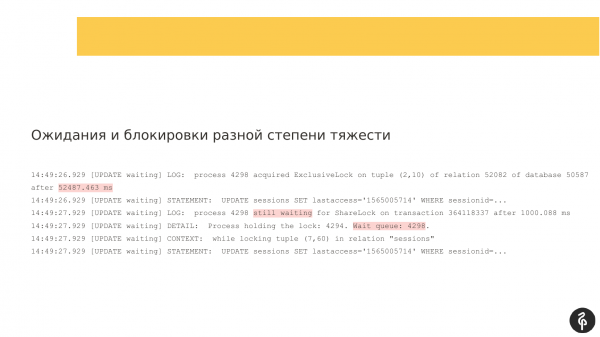
Au fost blocaje de diferite grade de severitate.
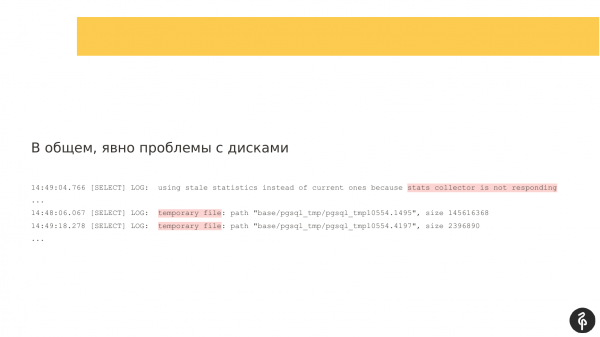
Și, prin urmare, subsistemul de stocare nu era foarte reactiv.
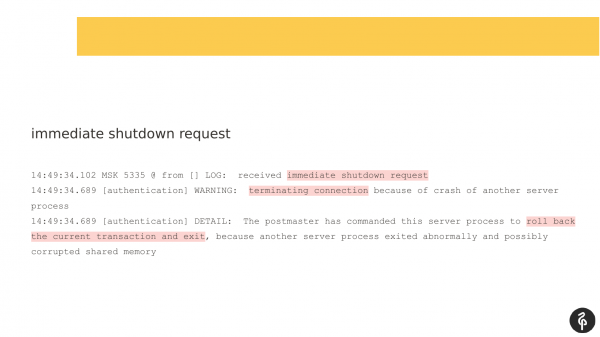
Și cel mai misterios pentru mine a fost cererea de oprire imediată. Postgres are trei moduri de oprire:
- Este mod graceful, când așteptăm ca toți clienții să se deconecteze de la sine.
- Există un mod fast, când îi forțăm pe clienți să se deconecteze, deoarece ne pregătim să ne oprim.
- Și immediate. În acest caz, immediate nici măcar nu îi informează pe clienți că trebuie să se deconecteze, pur și simplu se oprește fără avertisment. Iar tuturor clienților, sistemul de operare le trimite un mesaj RST (mesaj TCP, că conexiunea a fost întreruptă și clientului nu îi mai rămâne nimic de făcut).
Cine a trimis acest semnal? Procesele în fundal Postgres nu se trimit între ele astfel de semnale, adică este vorba de un kill -9. Ele nu își trimit între ele asemenea semnale, ci doar reacționează la acestea, adică este o repornire de urgență a Postgres. Cine l-a trimis, nu știu.
Am verificat comanda „last” și am văzut o persoană care s-a conectat la acest server împreună cu noi, dar mi-a fost jenă să întreb. Poate că a fost un kill -9. Aș fi văzut în loguri kill -9, deoarece Postgres scrie că a primit kill -9, dar nu am văzut asta în loguri.
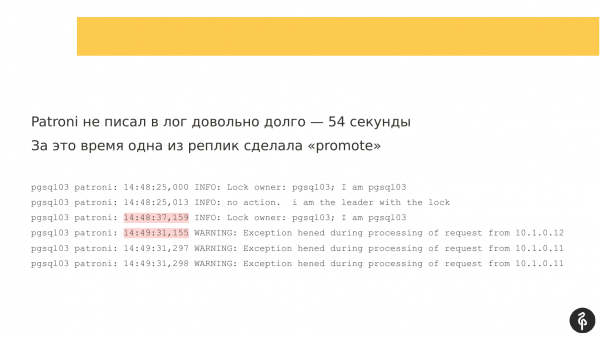
Pe măsură ce am investigat mai departe, am observat că Patroni nu a scris în log pentru o perioadă destul de lungă – 54 de secunde. Și dacă compar timestamp-urile, aici au fost aproximativ 54 de secunde fără mesaje.
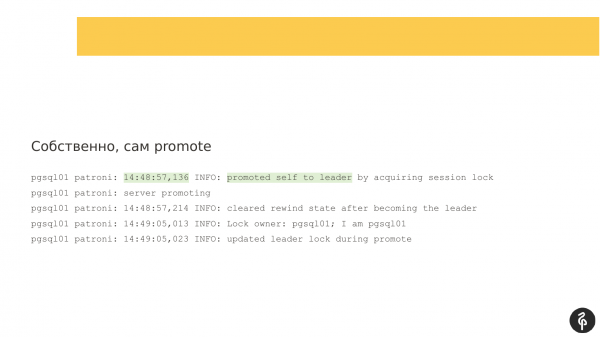
Și în acest interval a avut loc un failover automat. Patroni a funcționat din nou perfect. Maestrul nostru vechi a fost indisponibil, ceva se întâmpla cu el. Și au început alegerile pentru un nou maestru. Aici totul a funcționat bine. pgsql01 a devenit noul lider.
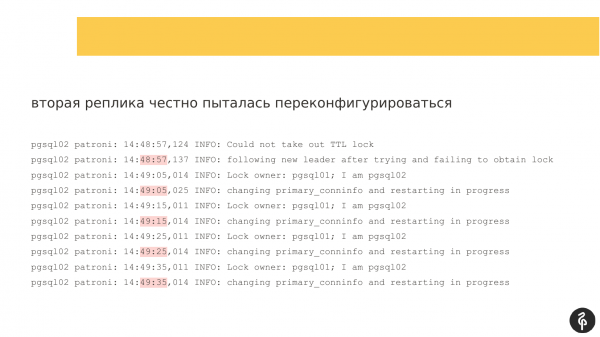
Avem o replică care a devenit maestru. Și există o a doua replică. Iar cu cea de-a doua replică au fost probleme. Încerca să se reconfigureze. Din câte înțeleg, încerca să schimbe recovery.conf, să repornească Postgres și să se conecteze la noul maestru. La fiecare 10 secunde trimite mesaje că încearcă, dar nu reușește.
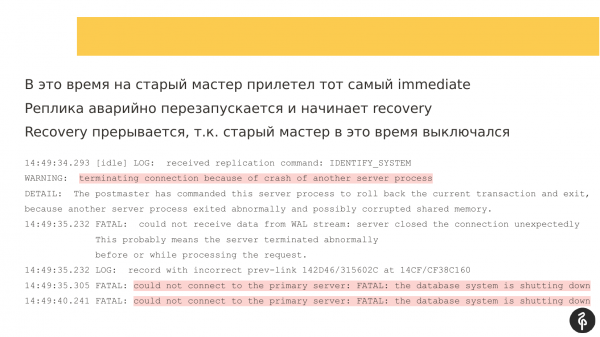
Și în timpul acestor încercări, un semnal de immediate-shutdown ajunge la vechiul maestru. Maestrul se repornește. Și de asemenea, recuperarea se oprește, deoarece vechiul maestru iese din funcțiune. Adică, replica nu se poate conecta la el, deoarece este în modul de oprire.
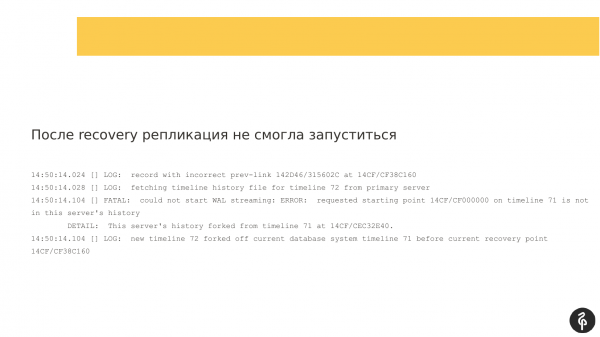
La un moment dat a funcționat, dar replicarea nu s-a activat.
Am o singură ipoteză, că în recovery.conf era adresa vechiului maestru. Și când a apărut noul maestru, a doua replică continua să încerce să se conecteze la vechiul maestru.
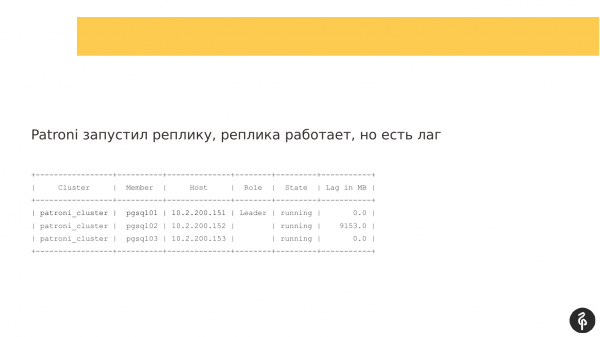
Când Patroni a pornit pe a doua replică, nodul s-a pornit, dar nu a putut să se conecteze prin replicare. Și a apărut o întârziere în replicare care arăta cam așa. Adică toate cele trei noduri erau la locul lor, dar al doilea nod întârziase.
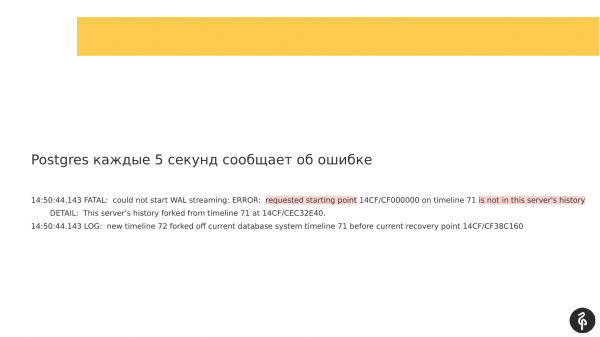
În acest timp, dacă ne uităm la logurile scrise, am putut observa că replicarea nu se poate iniția deoarece jurnalele de tranzacții sunt diferite. Și acele jurnale de tranzacții oferite de maestru, menționate în recovery.conf, pur și simplu nu se potrivesc cu nodul nostru curent.
Și aici am făcut o greșeală. Ar fi trebuit să merg să verific ce este în recovery.conf, pentru a-mi verifica ipoteza că ne conectăm la un alt maestru. Dar, la acea vreme, abia învățam despre asta și acest lucru nu mi-a venit în minte, ori am văzut că replica întârzie și va trebui să o reconectez, adică am abordat totul într-un mod destul de superficial. A fost greșeala mea.
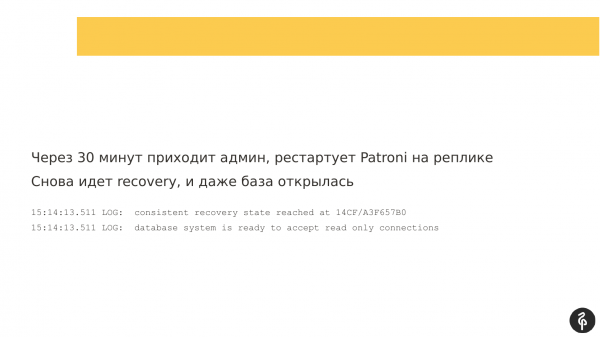
După 30 de minute a venit administratorul, adică am repornit Patroni pe replică. Eu deja renunțasem la ea, credeam că va trebui să o reconectez. Și m-am gândit – o să repornesc Patroni, poate va ieși ceva bun. A început procesul de recuperare. Și baza de date s-a deschis, era gata să accepte conexiuni.
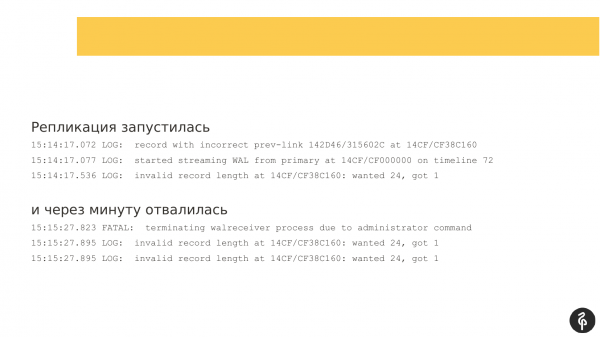
Replicarea a pornit. Dar după un minut s-a oprit cu o eroare care spunea că jurnalele de tranzacții nu se potrivesc.
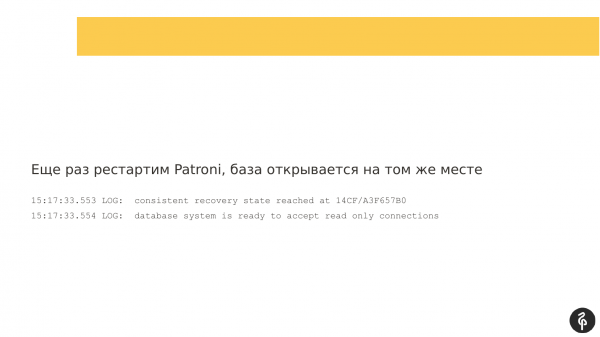
M-am gândit că voi reporni din nou. Am repornit din nou Patroni, și nu am repornit Postgres, ci am repornit tocmai Patroni în speranța că va porni baza de date ca prin magie.
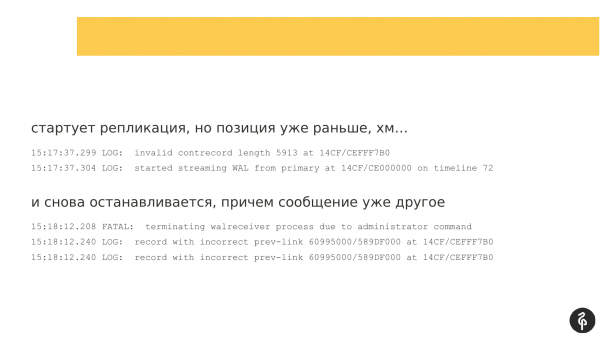
Replicarea a pornit din nou, dar marcajele din jurnalul de tranzacții erau diferite, nu erau cele care erau în timpul încercării anterioare de pornire. Replicarea s-a oprit din nou. Și mesajul era deja puțin diferit. Și nu era foarte informativ pentru mine.
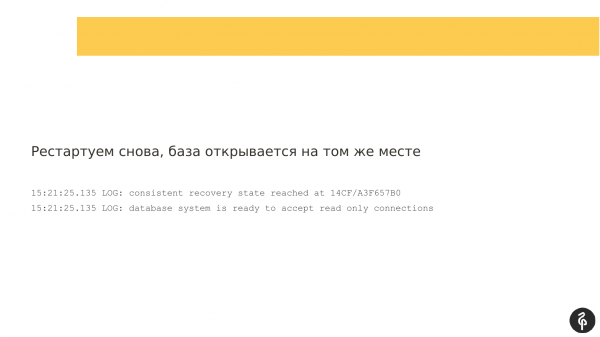
Și atunci mi-a venit în minte – ce ar fi dacă aș reporni Postgres, în același timp să fac un checkpoint pe maestru, pentru a mișca punctul în jurnalul de tranzacții puțin mai departe, astfel încât recuperarea să înceapă dintr-un alt moment? Plus că mai aveam resurse WAL disponibile.
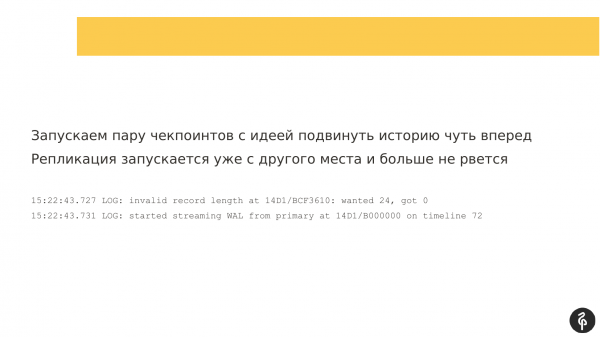
Am repornit Patroni, am făcut câteva checkpoints pe maestru, câteva puncte de restart pe replică, când s-a deschis. Și asta a ajutat. M-am gândit mult de ce a ajutat și cum a funcționat. Și replicarea a fost inițiată. Și replicarea nu s-a mai întrerupt.
Această problemă pentru mine este una dintre cele mai misterioase, asupra căreia încă mă gândesc, ce se întâmpla de fapt.
Ce concluzii putem trasa de aici? Patroni poate funcționa așa cum este planificat, fără erori. Dar aceasta nu oferă o garanție de 100%, că totul este în regulă. Replica poate porni, dar poate fi în stare semi-funcțională, iar aplicația nu poate lucra cu o astfel de replică, deoarece acolo vor fi date vechi.
După fiecare failover, trebuie să verificăm întotdeauna dacă totul este în regulă cu clusterul, adică avem numărul necesar de replici și nu există întârziere în replicare.
Pe parcursul analizei acestor probleme, voi formula recomandări. Am încercat să le combin în două slide-uri. Probabil, toate povestirile ar fi putut fi unite în două slide-uri și doar acestea să fie prezentate.
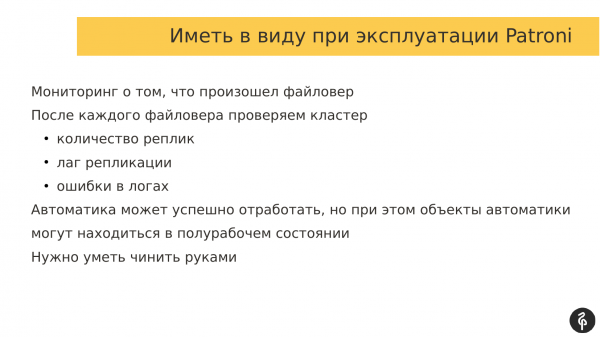
Când folosiți Patroni, trebuie să aveți monitorizare. Trebuie să știți întotdeauna când a avut loc un failover automat, pentru că dacă nu știți că a avut loc un failover automat, nu controlați clusterul. Și asta este rău.
După fiecare failover, trebuie să verificăm manual clusterul. Trebuie să ne asigurăm că avem întotdeauna numărul corect de replici, că nu există întârziere în replicare, că în loguri nu sunt erori legate de replicarea în flux, de Patroni, de sistemul DCS.
Automatizarea poate funcționa cu succes, Patroni este un instrument foarte bun. Poate funcționa, dar acest lucru nu va duce clusterul în starea dorită. Și dacă nu aflăm despre asta, vom avea probleme.
Și Patroni nu este o soluție miraculoasă. Trebuie să avem o înțelegere a modului în care funcționează Postgres, cum funcționează replicarea și cum interacționează Patroni cu Postgres, precum și modul în care are loc comunicarea între noduri. Acest lucru este necesar pentru a putea rezolva manual problemele apărute.
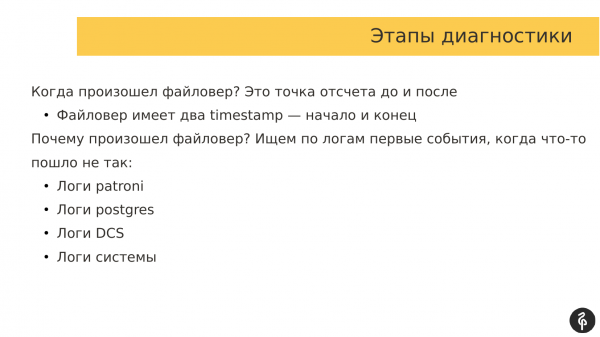
Cum abordează diagnosticarea? S-a întâmplat că lucrăm cu diferiți clienți și nimeni nu are un stack ELK, așa că trebuie să ne descurcăm cu logurile, deschizând 6 consoluri și 2 tab-uri. Într-un tab, sunt logurile Patroni pentru fiecare nod, iar în celălalt tab sunt logurile Consul sau Postgres, după caz. Este foarte greu să diagnostichez aceasta.
Ce abordări am dezvoltat? În primul rând, am grijă să privesc când a avut loc failover-ul. Pentru mine, acesta este un punct de cotitură. Mă uit la ce s-a întâmplat înainte de failover, în timpul failover-ului și după failover. Failover-ul are două marcaje: ora de început și ora de sfârșit.
Apoi, mă uit în jurnalele de evenimente înainte de failover, ceea ce a precedat failover-ul, adică caut motivele pentru care a avut loc failover-ul.
Și asta oferă o imagine clară despre ce s-a întâmplat și ce se poate face în viitor pentru a preveni astfel de circumstanțe (și, prin urmare, a evita un failover).
Și unde ne uităm de obicei? Mă uit la:
- În primul rând, la jurnalele Patroni.
- Apoi, mă uit la jurnalele Postgres sau la jurnalele DCS, în funcție de ce am găsit în jurnalele Patroni.
- Și jurnalele sistemului oferă de asemenea uneori informații despre ce a cauzat failover-ul.
Cum privesc eu Patroni? Îmi place foarte mult Patroni. În opinia mea, este cea mai bună soluție disponibilă astăzi. Știu multe alte produse. Acestea sunt Stolon, Repmgr, Pg_auto_failover, PAF. 4 instrumente. Le-am încercat pe toate. Patroni mi-a plăcut cel mai mult.
Dacă cineva mă întreabă: „Recomand Patroni?”. Voi răspunde că da, pentru că îmi place Patroni. Și cred că am învățat să-l configurez.
Dacă sunteți interesați să vedeți ce alte probleme pot apărea cu Patroni, în afară de cele pe care le-am menționat, mereu puteți vizita pagina de pe GitHub. Acolo sunt multe povești diferite și se discută despre multe probleme interesante. Și, în final, unele bug-uri au fost raportate și rezolvate, adică este o lectură interesantă.
Acolo sunt povești interesante despre cum oamenii își dau singuri în picior. Foarte instructiv. Citești și înțelegi că nu trebuie să faci așa. Mi-am pus o bifă.
Și aș dori să mulțumesc companiei Zalando pentru că dezvoltă acest proiect, adică lui Alexandru Cucushkin și lui Aleksei Kliukin. Aleksei Kliukin este unul dintre co-autori, nu mai lucrează la Zalando, dar sunt două persoane care au început să lucreze cu acest produs.
Și consider că Patroni este o soluție foarte tare. Sunt mulțumit că există, este interesant de folosit. Și mulțumesc tuturor contribuitorilor care scriu patch-uri pentru Patroni. Sper că Patroni va deveni mai matur, mai tare și mai eficient pe măsură ce îmbătrânește. Este deja funcțional, dar sper că va deveni și mai bun. Așadar, dacă planificați să folosiți Patroni, nu vă temeți. Este o soluție bună, o puteți implementa și folosi.
Asta este tot. Dacă aveți întrebări, întrebați.
Întrebări
Mulțumesc pentru prezentare! Dacă după failover tot trebuie să ne uităm acolo foarte atent, atunci de ce avem nevoie de un failover automat?
Pentru că este o nouă tehnologie. Lucrăm cu ea de doar un an. Mai bine să ne asigurăm. Vrem să intrăm și să vedem dacă totul a funcționat așa cum trebuie. Este un nivel de neîncredere matur – mai bine să verificăm și să ne asigurăm.
De exemplu, am intrat dimineața și am verificat, nu?
Nu dimineața, de obicei aflăm despre auto-failover aproape imediat. Primim notificări, vedem că a avut loc un auto-failover. Intru practic imediat și verific. Dar toate aceste verificări ar trebui să fie externalizate la nivelul de monitorizare. Dacă apelăm la Patroni prin API REST, există un istoric. Din istoric putem observa timpii în care a avut loc failover-ul. Pe baza acestuia putem crea un sistem de monitorizare. Putem observa isticul, câte evenimente au avut loc. Dacă am avut o creștere a evenimentelor, înseamnă că a avut loc un auto-failover. Putem verifica. Sau automatizarea noastră în monitorizare a verificat că toate replicile sunt la locul lor, nu este întârziere și totul este în regulă.
Mulțumesc!
Îți mulțumesc foarte mult pentru povestea minunată! Dacă am mutat clusterul DCS undeva departe de clusterul Postgres, trebuie să întreținem acest cluster periodic? Care sunt cele mai bune practici pentru a opri anumite părți ale clusterului DCS, pentru a face ceva cu ele etc.? Cum funcționează întreaga structură în acest caz? Și cum ar trebui să facem aceste lucruri?
Pentru o companie a fost necesar să creăm o matrice a problemelor, care să descrie ce se întâmplă dacă unul sau mai multe componente eșuează. Pe baza acestei matrici analizăm secvențial toate componentele și construim scenarii pentru cazurile de eșec ale acestora. În consecință, pentru fiecare scenariu de eșec, putem avea un plan de acțiune pentru recuperare. Și în cazul DCS, acesta este parte a infrastructurii standard. Administratorul se ocupă de administrare, iar noi ne bazăm pe administratori, care se ocupă de aceasta și pe abilitățile lui de a remedia problemele în caz de urgență. Dacă DCS nu este disponibil, îl implementăm noi, dar în acest caz nu ne monitorizăm foarte mult, deoarece nu ne asumăm răspunderea pentru infrastructură, dar oferim recomandări cu privire la ce și cum ar trebui să monitorizăm.
Adică, am înțeles corect că trebuie să dezactivăm Patroni, să dezactivăm failover-ul, să dezactivăm totul înainte de a face ceva cu gazdele?
Acesta depinde de câte noduri avem în clusterul DCS. Dacă sunt multe noduri și dacă dezactivăm doar unul dintre noduri (replica), atunci clusterul păstrează cvorumul. Și Patroni rămâne funcțional. Și nimic nu se declanșează. Dacă avem operațiuni complexe care afectează mai multe noduri, absența cărora poate distruge cvorumul, atunci - da, poate merită să punem Patroni pe pauză. Are comanda corespunzătoare - patronictl pause, patronictl resume. Pur și simplu punem pe pauză, iar failover-ul automat nu se activează în acest timp. Facem întreținere pe clusterul DCS, apoi ridicăm pauza și continuăm activitatea.
Mulțumesc foarte mult!
Vă mulțumesc mult pentru prezentare! Cum consideră echipa de produs că poate fi pierdută informația?
Echipele de produs nu îi pasă, dar șefii de echipă se îngrijorează.
Ce garanții sunt disponibile acolo?
Garanțiile sunt foarte dificile. Există o prezentare de Alexandr Kukushkin „Cum să calculăm RPO și RTO”, adică timpul de recuperare și cât de multe date putem pierde. Cred că trebuie să găsim aceste slide-uri și să le studiem. Din câte îmi amintesc, acolo sunt pași specifici despre cum să facem aceste calcule. Câte tranzacții putem pierde, câte date putem pierde. Ca opțiune putem folosi replicarea sincronă la nivelul Patroni, dar este o sabie cu două tăișuri: fie avem fiabilitate a datelor, fie pierdem în viteză. Există replicare sincronă, dar nici aceasta nu garantează o protecție de 100% împotriva pierderii de date.
Alexei, mulțumesc pentru prezentarea excelentă! Aveți experiență în utilizarea Patroni pentru protecție de nivel zero? Adică, în combinație cu standby sincron? Aceasta este prima întrebare. Și a doua întrebare. Ați folosit diferite soluții. Noi am folosit Repmgr, dar fără failover automat și acum plănuim să conectăm failover-ul automat. Și luăm în considerare Patroni ca soluție alternativă. Ce puteți spune ca avantaje în comparație cu Repmgr?
Prima întrebare a fost despre replicile sincrone. Nimeni dintre noi nu folosește replicarea sincronă, pentru că tuturor le este frică (Deja o folosesc câțiva clienți, nu au observat probleme de performanță în principiu - Comentariul prezentatorului). Dar pentru noi, am stabilit regula ca în clusterul de replicare sincronă să fie minimum trei noduri, pentru că, dacă avem două noduri și masterul sau replica ieșeștep din funcțiune, Patroni transformă acest nod în mod Standalone, astfel încât aplicația să continue să funcționeze. În acest caz există riscuri de pierdere a datelor.
Referitor la a doua întrebare, am folosit Repmgr și continuăm să-l folosim în unele cazuri la clienți din motive istorice. Ce se poate spune? În Patroni, failover-ul automat este integrat, în timp ce în Repmgr, acesta vine ca o opțiune suplimentară care trebuie activată. Trebuie să pornim daemonul Repmgr pe fiecare nod și atunci putem configura failover-ul automat.
Repmgr verifică dacă nodurile Postgres sunt active. Procesele Repmgr verifică existența reciprocă, ceea ce nu este un mod foarte eficient, deoarece pot apărea cazuri complicate de izolare a rețelei în care un mare cluster Repmgr se poate diviza în mai multe mici și continua să funcționeze. Nu am urmărit Repmgr de mult timp, poate că au rezolvat asta... sau poate nu. Dar extragerea informațiilor despre starea clusterului în DCS, așa cum face Stolon, Patroni, este cea mai viabilă opțiune.
Alexei, am o întrebare, poate fi considerată naivă. În unul dintre primele exemple DCS ați mutat de pe mașina locală pe un nod de distanță. Înțelegem că rețeaua este un element care are propriile sale particularități, ea trăiește de la sine. Și ce se întâmplă dacă dintr-un anumit motiv clusterul DCS devine inaccesibil? Nu voi detalia cauzele, pot fi multe: de la greșelile rețelistilor până la problemele reale.
Nu am menționat asta cu voce tare, dar clusterul DCS trebuie să fie, de asemenea, tolerant la defecte, adică să aibă un număr impar de noduri, astfel încât să poată fi obținut un quorum. Ce se întâmplă dacă clusterul DCS devine inaccesibil sau nu poate obține quorumul, adică există o împărțire a rețelei sau o defecțiune a nodurilor? În acest caz, clusterul Patroni trece în modul de citire. Clusterul Patroni nu poate determina starea clusterului și ce să facă. Nu se poate conecta la DCS și salva noua stare a clusterului, prin urmare întreg clusterul trece în modul de citire. Și așteaptă fie o intervenție manuală din partea operatorului, fie restaurarea DCS.
Pe scurt, DCS devine pentru noi un serviciu la fel de important ca și baza de date în sine?
Da, da. În foarte multe companii moderne, Service Discovery este o parte integrantă a infrastructurii. Acesta este implementat chiar înainte ca baza de date să apară în infrastructură. Cu alte cuvinte, infrastructura a fost lansată, datacenterele au fost desfășurate, iar noi avem deja Service Discovery. Dacă este vorba despre Consul, atunci pe acesta poate fi construit și DNS-ul. Dacă este Etcd, atunci poate face parte din clusterul Kubernetes, în care se va desfășura tot restul. Mi se pare că Service Discovery este deja o parte indispensabilă a infrastructurilor moderne. Și la aceasta se gândesc mult mai devreme decât la bazele de date.
Mulțumesc!
Sursa: habr.com
