

În SQL, descrieți «ce» doriți să obțineți, nu «cum» ar trebui să se execute. De aceea, problema dezvoltării interogărilor SQL în stilul «cum sună, așa se scrie» își ocupă locul de cinste, alături de .
Astăzi, prin exemple extrem de simple, vom analiza la ce poate duce asta în contextul utilizării GROUP/DISTINCT și LIMIT împreună cu acestea.
Dacă ați scris în interogare «mai întâi, unește aceste tabele, iar apoi elimină toate dublurile, trebuie să rămână doar un exemplu pentru fiecare cheie» — exact așa va funcționa, chiar dacă unirea nu a fost necesară.
Și uneori aveți noroc și «funcționează pur și simplu», alteori — afectează neplăcut performanța, iar uneori dă efecte complet neașteptate din perspectiva dezvoltatorului.
Bine, poate nu atât de spectaculoase, dar...
«Cuplul dulce»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Este evident ce doriți să selectați astfel de înregistrări X pentru care în Y există legături cu condiția în execuție. Ați scris interogarea prin JOIN — ați obținut unele valori pk de mai multe ori (exact câte înregistrări potrivite au fost în Y). Cum să eliminați? Desigur DISTINCT!
Este cu adevărat «încântător», când pentru fiecare înregistrare X se găsesc câteva sute de înregistrări Y legate, iar apoi eroic se elimină dublurile...
Cum să corectați? În primul rând, trebuie să înțelegeți că sarcina poate fi modificată la «să selectați astfel de înregistrări X pentru care în Y există CEL PUȚIN O legătură cu condiția în execuție» — deoarece din înregistrarea Y nu ne trebuie nimic.
EXISTS în interior
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Unele versiuni PostgreSQL înțeleg că în EXISTS este suficient să găsești prima înregistrare care apare, versiuni mai vechi — nu. De aceea, prefer întotdeauna să specific LIMIT 1 inside [START WITH …] CONNECT BY.
JOIN LATERAL
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Această variantă permite să returnați, dacă este necesar, imediat și unele date din înregistrarea Y găsită. O variantă similară a fost discutată în articolul .
«De ce să plătești mai mult»: DISTINCT [ON] + LIMIT 1
Un avantaj suplimentar al acestor transformări de cerere este capacitatea de a restricționa ușor lista de înregistrări, dacă este necesară doar una sau mai multe dintre ele, ca în cazul următor:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Acum citim cererea și încercăm să înțelegem ce se propune a fi făcut de SGBD:
- combinăm tabelele
- unicizăm după X.pk
- din înregistrările rămase alegem una
Așadar, ce am obținut? "O înregistrare" din cele unicizate — dar dacă luăm această una din cele neunicizate, rezultatul se va schimba oare?... "Dacă nu este nicio diferență, de ce să plătim mai mult?"
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- aici pot fi adăugate condiții potrivite
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Și aceeași situație este cu GROUP BY + LIMIT 1.
"Doar să întreb": GROUP implicit + LIMIT
Astfel de lucruri apar în diferite verificări de non-vacuitate a tabelului sau a CTE-ului pe parcursul execuției cererii:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Funcții agregate (count/min/max/sum/...) se execută cu succes pe întregul set, chiar și fără o specificare explicită COUNT_BIG(*). Numai că cu LIMIT nu se împacă foarte bine.
Dezvoltatorul poate crede "ei bine, dacă acolo sunt înregistrări, atunci nu trebuie să depășesc LIMIT".. Dar nu trebuie să fie așa! Pentru că pentru o bază de date este:
- să calculeze ce doresc să returneze atât de multe rânduri cât cer.
- În funcție de condițiile țintă, este potrivit să facem una dintre următoarele înlocuiri:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)pe(count + LIMIT 1) > 0EXISTS(LIMIT 1)pecount >= N(SELECT count(*) FROM (... LIMIT N))pe"Câte să pun în grame": DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
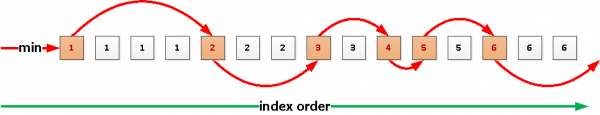
Un dezvoltator naiv poate crede sincer că execuția cererii se va opri,de îndată ce găsim $1 primele valori diferite apărute odată. Într-o zi, acest lucru ar putea funcționa astfel datorită unui nou nod.
Index Skip Scan , implementarea căruia este în prezent analizată, dar deocamdată — nu.Până acum, întâi
vor fi extrase toate înregistrările , unicizate și doar apoi din ele va returna cât este solicitat. Este cu atât mai trist dacă am vrut ceva de genul, iar înregistrările din tabel sunt sute de mii... $1 = 4Pentru a nu fi triști fără motiv, vom folosi o cerere recursivă
"DISTINCT pentru săraci" din PostgreSQL Wiki :
Sursa: habr.com
