

Bună, Habr! Chiar acum, OTUS a deschis înscrierea pentru noul flux al cursului . În ajunul începerii cursului, am pregătit în mod tradițional pentru voi traducerea unui material interesant.
În fiecare zi, peste o sută de milioane de oameni vizitează Twitter pentru a afla ce se întâmplă în lume și pentru a discuta despre asta. Fiecare tweet și orice altă acțiune a utilizatorului generează un eveniment disponibil pentru analiza internă a datelor în Twitter. Sute de angajați analizează și vizualizează aceste date, iar îmbunătățirea experienței lor este prioritatea principală pentru echipa Twitter Data Platform.
Credem că utilizatorii cu o gamă largă de abilități tehnice ar trebui să aibă posibilitatea de a găsi date și de a avea acces la instrumente de analiză și vizualizare care funcționează bine, bazate pe SQL. Acest lucru ar permite unei noi grupi de utilizatori cu mai puțin background tehnic, inclusiv analiști de date și manageri de produse, să extragă informații din date, permițându-le să înțeleagă mai bine și să folosească oportunitățile Twitter. Astfel, democratizăm analiza datelor în Twitter.
Pe măsură ce ne îmbunătățim instrumentele și capacitățile pentru analiza internă a datelor, am fost martorii unei îmbunătățiri a serviciului Twitter. Cu toate acestea, mai avem mult de crescut. Instrumentele curente, precum Scalding, necesită expertiză în programare. Instrumentele de analiză bazate pe SQL, cum ar fi Presto și Vertica, au probleme de performanță la scară mare. De asemenea, avem o problemă cu distribuția datelor între mai multe sisteme fără acces constant la acestea.
Anul trecut, am anunțat despre , în cadrul căreia transferăm părți din pe Google Cloud Platform (GCP). Am ajuns la concluzia că instrumentele Google Cloud ne pot ajuta în inițiativele noastre de democratizare a analizei, vizualizării și învățării automate în Twitter:
- : un depozit de date corporative cu un motor SQL bazat pe , renumit pentru rapiditate, simplitate și care se descurcă cu .
- un instrument pentru vizualizarea datelor mari cu funcții de colaborare, asemănătoare cu Google Docs.
Din acest articol veți învăța despre experiența noastră cu aceste instrumente: ce am realizat, ce am învățat și ce vom face în continuare. Acum ne vom concentra pe analiza de tip batch și interactivă. Analiza în timp real o vom discuta în articolul următor.
Istoria depozitelor de date în Twitter
Înainte de a ne aprofunda în BigQuery, merită să reamintim pe scurt istoria depozitelor de date în Twitter. În 2011, analiza datelor în Twitter era realizată în Vertica și Hadoop. Pentru a construi lucrările MapReduce ale Hadoop, am folosit Pig. În 2012 am înlocuit Pig cu Scalding, care avea un API Scala cu avantaje precum posibilitatea de a crea pipeline-uri complexe și ușurința în testare. Totuși, pentru mulți analiști de date și manageri de produs, care se simțeau mai confortabil lucrând cu SQL, aceasta reprezenta o curbă de învățare destul de abruptă. Aproximativ în 2016 am început să folosim Presto ca interfață SQL pentru datele Hadoop. Spark oferea o interfață Python, ceea ce îl făcea o alegere bună pentru cercetarea ad hoc a datelor și învățarea automată.
Începând din 2018, am folosit următoarele instrumente pentru analiza și vizualizarea datelor:
- Scalding pentru pipeline-uri de producție
- Scalding și Spark pentru analize ad hoc și învățare automată
- Vertica și Presto pentru analize SQL ad hoc și interactive
- Druid pentru interacțiune mică, exploratorie și acces cu întârziere mică la metricile de serii temporale
- Tableau, Zeppelin și Pivot pentru vizualizarea datelor
Am descoperit că, deși aceste instrumente oferă capabilități foarte puternice, ne-am confruntat cu dificultăți în a face aceste capabilități accesibile pentru un public mai larg în Twitter. Extinzând platforma noastră cu ajutorul Google Cloud, ne concentrăm pe simplificarea instrumentelor noastre analitice pentru întreaga comunitate Twitter.
Depozitul de date BigQuery de la Google
Câteva echipe de pe Twitter au integrat deja BigQuery în unele dintre fluxurile lor de producție. Folosindu-ne de experiența lor, am început să evaluăm capacitățile BigQuery pentru toate scenariile de utilizare Twitter. Scopul nostru a fost să oferim BigQuery întregii companii, precum și să o standardizăm și să o suportăm în cadrul setului de instrumente Data Platform. Acest lucru a fost dificil din multe motive. A trebuit să dezvoltăm o infrastructură pentru a gestiona eficient volume mari de date, sprijinind gestionarea datelor la nivelul întregii companii, asigurând un control de acces adecvat și menținând confidențialitatea clienților. De asemenea, a fost necesar să creăm sisteme pentru distribuirea resurselor, monitorizarea și gestionarea plăților, astfel încât echipele să poată utiliza BigQuery eficient.
În noiembrie 2018, am lansat versiunea alpha a BigQuery și Data Studio pentru întreaga companie. Am oferit angajaților de la Twitter unele dintre cele mai folosite tabele cu date personale curate. BigQuery a fost utilizat de peste 250 de utilizatori din echipe diverse, inclusiv inginerie, finanțe și marketing. Recent, ei au efectuat aproximativ 8.000 de interogări, procesând aproximativ 100 PB pe lună, fără a include interogările programate. Primind feedback extrem de pozitiv, am decis să mergem înainte și să oferim BigQuery ca resursă principală pentru interacțiunea cu datele în Twitter.
Iată schema arhitecturii noastre de nivel înalt pentru depozitul de date Google BigQuery.
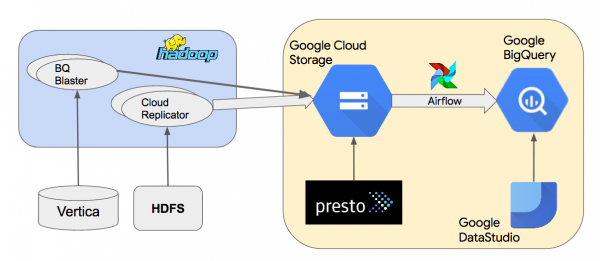
Copiem datele din clusterele Hadoop locale în Google Cloud Storage (GCS), folosind un instrument intern Cloud Replicator. Apoi folosim Apache Airflow pentru a construi fluxuri de lucru care utilizează „” pentru a încărca datele din GCS în BigQuery. Folosim Presto pentru a interoga seturile de date Parquet sau Thrift-LZO din GCS. BQ Blaster este un instrument intern Scalding pentru a încărca seturi de date HDFS Vertica și Thrift-LZO în BigQuery.
În secțiunile următoare, vom discuta despre abordarea noastră și cunoștințele în ceea ce privește ușurința de utilizare, performanța, gestionarea datelor, fiabilitatea sistemului și costurile.
Facilitatea de utilizare
Am descoperit că utilizatorii au găsit ușor să înceapă cu BigQuery, deoarece nu necesita instalarea de software, iar utilizatorii au putut accesa printr-o interfață web intuitivă. Cu toate acestea, utilizatorii trebuiau să se familiarizeze cu unele funcții GCP și conceptele sale, inclusiv resurse precum proiecte, seturi de date și tabele. Am dezvoltat materiale educaționale și tutoriale pentru a ajuta utilizatorii să înceapă. Odată ce au dobândit o înțelegere de bază, utilizatorii au început să navigheze ușor prin seturile de date, să vizualizeze schema și datele tabelelor, să execute interogări simple și să vizualizeze rezultatele în Data Studio.
Obiectivul nostru cu privire la introducerea datelor în BigQuery a fost să asigurăm o încărcare fluidă a seturilor de date HDFS sau GCS cu un singur clic. Am considerat (Airflow gestionat), dar nu am reușit să-l utilizăm din cauza modelului nostru de securitate „Domain Restricted Sharing” (mai multe informații în secțiunea „Managementul datelor” de mai jos). Am experimentat utilizarea Google Data Transfer Service (DTS) pentru organizarea sarcinilor de lucru BigQuery. Deși DTS se configura rapid, nu era flexibil pentru construirea de fluxuri de lucru cu dependențe. Pentru versiunea noastră alfa, am creat propriul mediu Apache Airflow în GCE și ne pregătim să-l punem în producție și să susținem mai multe surse de date, precum Vertica.
Pentru a transforma datele în BigQuery, utilizatorii creează fluxuri de date SQL simple, utilizând interogări planificate. Pentru fluxuri de lucru complexe, multi-etapă cu dependențe, plănuim să utilizăm fie infrastructura noastră Airflow, fie Cloud Composer, împreună cu .
Performanță
BigQuery este conceput pentru interogări SQL de uz general care procesează volume mari de date. Nu este destinat interogărilor cu latență scăzută și lățimi de bandă mari necesare pentru o bază de date tranzacțională sau analizei seriilor temporale cu latență scăzută, implementată . Pentru interogările analitice interactive, utilizatorii noștri așteaptă un timp de răspuns de mai puțin de un minut. A trebuit să proiectăm utilizarea BigQuery astfel încât să corespundă acestor așteptări. Pentru a asigura o performanță previzibilă pentru utilizatorii noștri, am folosit funcționalitățile BigQuery disponibile pentru clienții cu plată fixă, care permit deținătorilor de proiecte să rezerve sloturi minime pentru interogările lor. BigQuery este unitatea de putere de calcul necesară pentru a executa interogări SQL.
Am analizat peste 800 de interogări, procesând aproximativ 1 TB de date fiecare, și am descoperit că timpul mediu de execuție a fost de 30 de secunde. De asemenea, am aflat că performanța depinde foarte mult de utilizarea sloturilor noastre în diferite proiecte și sarcini. A trebuit să delimităm clar rezervele noastre de sloturi pentru producție și cele ad hoc, pentru a menține performanța în scenariile de utilizare a producției și analizei interaktive. Aceasta a avut un impact semnificativ asupra designului nostru pentru rezervarea sloturilor și ierarhia proiectelor.
Despre gestionarea datelor, funcționalitate și costul sistemelor, vom discuta în zilele următoare în a doua parte a traducerii, iar acum invităm pe toți cei interesați la , în cadrul căruia veți putea afla detalii despre curs și de asemenea să adresați întrebări expertului nostru — Egor Mateșuk (Senior Data Engineer, MaximaTelecom).
Citește mai mult:
Sursa: habr.com
