

La început a fost tehnologia, numită BPF. Ne-am uitat la ea în , articolul vechi-testamental al acestui ciclu. În 2013, prin eforturile lui Alexei Starovoitov și Daniel Borkman, a fost dezvoltată și inclusă în nucleul Linux o versiune îmbunătățită, optimizată pentru mașinile moderne pe 64 de biți. Această nouă tehnologie a purtat pentru scurt timp numele de Internal BPF, apoi a fost redenumită în Extended BPF, iar acum, după câțiva ani, toată lumea o numește pur și simplu BPF.
În termeni simpli, BPF permite rularea codului arbitrar furnizat de utilizator în spațiul nucleului Linux, iar noua arhitectură s-a dovedit atât de reușită, încât ne va trebui încă un zeciu de articole pentru a descrie toate aplicațiile sale. (Singurul lucru cu care dezvoltatorii nu au reușit, așa cum puteți vedea în imaginea de mai jos, este crearea unei sigle decente.)
În acest articol, vom descrie structura mașinii virtuale BPF, interfețele nucleului pentru lucrul cu BPF, instrumentele de dezvoltare, precum și o scurtă, foarte scurtă, privire de ansamblu asupra posibilităților existente, adică tot ceea ce ne va fi necesar pentru o înțelegere mai profundă a aplicațiilor practice ale BPF.
Rezumatul articolului
La început, ne vom uita la arhitectura BPF dintr-o înălțime de pasăre și vom marca componentele principale.
Având deja o idee generală despre arhitectură, vom descrie structura mașinii virtuale BPF.
În această secțiune, ne vom uita mai atent la ciclul de viață al obiectelor BPF – programe și mape.
Având deja o oarecare înțelegere a sistemului, în sfârșit, ne vom uita la cum să creăm și să gestionăm obiecte din spațiul utilizatorului printr-un apel de sistem special – bpf(2).
Sigur, se pot scrie programe folosind apelul de sistem, dar este complicat. Pentru un scenariu mai realist, programatorii de nucleu au dezvoltat o bibliotecă libbpf. Vom crea cel mai simplu schelet de aplicație BPF, pe care îl vom folosi în exemplele viitoare.
Aici vom învăța cum programele BPF pot apela funcții de asistență ale nucleului — un instrument care, împreună cu hărțile, extinde în mod semnificativ capacitățile noului BPF în comparație cu cel clasic.
Până la acest moment, vom ști suficient pentru a înțelege cum pot fi create programe care utilizează hărți. Și chiar vom arunca o privire în marea și puternica verificare.
Secțiune de referință despre cum să adunați utilitarele și nucleul necesar pentru experimente.
La sfârșitul articolului, cei care ajung până acolo vor găsi cuvinte de încurajare și o scurtă descriere a ceea ce va urma în articolele următoare. De asemenea, vom enumera câteva linkuri pentru studiu independent pentru cei care nu doresc sau nu pot aștepta continuarea.
Introducere în arhitectura BPF
Înainte de a începe să examinăm arhitectura BPF, ne vom referi pentru ultima dată (sau nu) la , care a fost dezvoltat ca un răspuns la apariția mașinilor RISC și a rezolvat problema filtrării eficiente a pachetelor. Arhitectura s-a dovedit atât de reușită, încât, născută în anii dificili '90 în Berkeley UNIX, a fost portată pe majoritatea sistemelor de operare existente, a supraviețuit nebunilor ani '20 și continuă să găsească aplicații noi.
Noul BPF a fost dezvoltat ca un răspuns la răspândirea pe scară largă a mașinilor de 64 de biți, serviciilor cloud și cerințelor crescute pentru instrumentele de creație SDN (Srețea-ddefinită nprin software). Dezvoltat de inginerii de rețea ai nucleului ca o înlocuire îmbunătățită a BPF-ului clasic, noul BPF și-a găsit aplicarea în urmă cu doar șase luni într-o sarcină dificilă de trasare a sistemelor Linux, iar acum, la șase ani de la apariție, ne va trebui un întreg articol următor doar pentru a enumera diferitele tipuri de programe.
VeSöLe KarTinKi
La baza sa, BPF este o mașină virtuală sandbox care permite rularea de cod "arbitrar" în spațiul nucleului fără a compromite securitatea. Programele BPF sunt create în spațiul utilizatorului, încărcate în nucleu și conectate la o anumită sursă de evenimente. Un exemplu de eveniment ar putea fi livrarea unui pachet pe o interfață de rețea, apelarea unei funcții din nucleu etc. În cazul pachetului, datele și metadatele acestuia vor fi disponibile programului BPF (pentru citire și, poate, și pentru scriere, în funcție de tipul programului), iar în cazul apelării unei funcții din nucleu — argumentele funcției, inclusiv pointerii către memoria nucleului etc.
Să ne uităm la acest proces în detaliu. Pentru început, să discutăm despre prima diferență față de BPF clasic, pentru care programele erau scrise în limbaj de asamblare. În noua versiune, arhitectura a fost extinsă astfel încât programele să poată fi scrise în limbaje de programare de nivel înalt, în primul rând, desigur, în C. Pentru aceasta a fost dezvoltat un backend pentru llvm, care permite generarea de bytecode pentru arhitectura BPF.
Arhitectura BPF a fost dezvoltată, printre altele, pentru a fi eficientă pe mașinile moderne. Pentru ca acest lucru să funcționeze în practică, bytecode-ul BPF, după ce a fost încărcat în nucleu, este transformat în cod nativ cu ajutorul unui component numit JIT compiler (Just In Time). Apoi, dacă vă amintiți, în BPF clasic, programul era încărcat în nucleu și se conecta la sursa de evenimente atomic într-un singur apel de sistem. În noua arhitectură, acest proces se desfășoară în două etape — mai întâi codul este încărcat în nucleu printr-un apel de sistem bpf(2), iar apoi, ulterior, prin alte mecanisme, diferite în funcție de tipul programului, programul se atașează (attaches) la sursa de evenimente.
Aici, cititorul ar putea avea o întrebare: așa se putea? Cum se garantează securitatea execuției unui astfel de cod? Securitatea execuției este garantată de etapa de încărcare a programelor BPF numită verificator (în engleză, această etapă se numește verifier și voi folosi termenul englez în continuare):
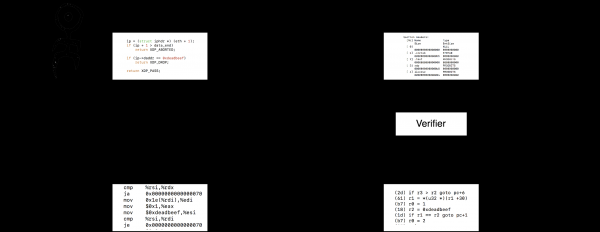
Verifier — este un analizator static care garantează că programul nu va interfere cu funcționarea normală a nucleului. Acest lucru nu înseamnă, de altfel, că programul nu poate interveni în activitatea sistemului — programele BPF, în funcție de tip, pot citi și rescrie zone de memorie ale nucleului, returna valori ale funcțiilor, tăia, completa, rescrie și chiar redirecționa pachete de rețea. Verifier garantează că nucleul nu se va prăbuși din cauza execuției programului BPF și că programul care, conform regulilor, are acces în scriere la date, precum cele ale pachetului de ieșire, nu va putea rescrie memoria nucleului în afara pachetului. Vom analiza mai detaliat verifier-ul în secțiunea corespunzătoare, după ce ne vom familiariza cu toate celelalte componente BPF.
Așadar, ce am învățat până acum? Utilizatorul scrie un program în limbajul C, îl încarcă în nucleu printr-un apel de sistem bpf(2), unde acesta trece prin verificare la verifier și este transformat în bytecode nativ. Apoi, același utilizator sau un altul conectează programul la o sursă de evenimente și acesta începe să ruleze. Separarea încărcării și conectării este necesară din mai multe motive. În primul rând, rularea verifier-ului este relativ costisitoare, iar încărcarea aceleași programe de mai multe ori consumă timp de calcul în mod inutil. În al doilea rând, modul în care programul se conectează depinde de tipul său, iar un „interfață universală” dezvoltată cu un an în urmă poate să nu fie potrivită pentru noile tipuri de programe. (Deși în prezent, având în vedere că arhitectura devine mai matură, există ideea de a unifica această interfață la nivelul libbpf.)
Cine citește cu atenție poate observa că încă nu am terminat cu imaginile. De fapt, tot ce s-a spus mai sus nu explică cum BPF schimbă radical situația comparativ cu BPF clasic. Două noutăți care extind semnificativ domeniul de aplicabilitate sunt posibilitatea utilizării memoriei partajate și a funcțiilor ajutătoare din nucleu (kernel helpers). În BPF, memoria partajată este implementată prin așa-numitele maps — structuri de date partajate cu un API specific. Acest nume a fost probabil ales deoarece primul tip de map care a apărut a fost o tabelă hash. Ulterior, au apărut array-uri, tabele hash locale (per-CPU) și array-uri locale, arbori de căutare, map-uri care conțin pointeri către programele BPF și multe altele. Ceea ce ne interesează acum este faptul că programele BPF au obținut posibilitatea de a-și salva starea între apeluri și de a o partaja cu alte programe și cu spațiul utilizatorului.
Accesul la maps se realizează din procesele utilizatorului prin intermediul apelului de sistem bpf(2), iar din programele BPF care rulează în nucleu — prin intermediul funcțiilor ajutătoare. Mai mult, helpers nu există doar pentru lucrul cu maps, ci și pentru accesul la alte posibilități ale nucleului. De exemplu, programele BPF pot utiliza funcții ajutătoare pentru a redirecționa pachete către alte interfețe, pentru a genera evenimente în subsistemul perf, pentru a accesa structuri de nucleu etc.
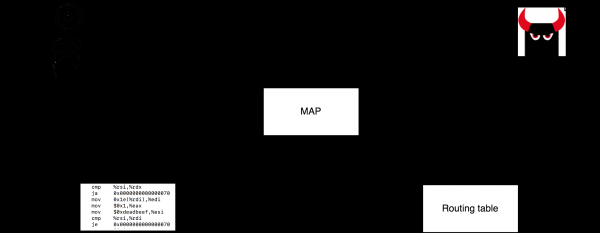
În concluzie, BPF oferă posibilitatea de a încărca cod arbitrar, adică, care a trecut verificarea pe verifier, al utilizatorului în spațiul nucleului. Acest cod poate salva starea între apeluri și schimba date cu spațiul utilizatorului, având în plus acces la subsistemele nucleului permise pentru acest tip de programe.
Acestea seamănă deja cu funcționalitățile oferite de modulele nucleului, în comparație cu care BPF are unele avantaje (desigur, comparația se poate face doar între aplicații similare, de exemplu, trasarea sistemului — nu se poate scrie un driver arbitrar pe BPF). Se poate menționa un prag de intrare mai scăzut (unele utilitare care utilizează BPF nu presupun ca utilizatorul să aibă cunoștințe de programare a nucleului, și, în general, abilități de programare), securitatea timpului de execuție (ridicați mâna în comentarii cei care nu au spart sistemul în timpul scrierii sau testării modulelor), atomicitatea — la rein Asa modulilor există timp de nefuncționare, iar subsistemul BPF garantează că niciun eveniment nu va fi ratat (pentru a fi corect, aceasta nu este adevărat pentru toate tipurile de programe BPF).
Existența unor astfel de funcționalități face din BPF un instrument versatil pentru extinderea nucleului, ceea ce este confirmat în practică: tot mai multe tipuri de programe sunt adăugate în BPF, tot mai multe companii mari folosesc BPF pe servere de producție 24×7, tot mai multe startup-uri își construiesc afacerile pe soluții bazate pe BPF. BPF este utilizat peste tot: în protecția împotriva atacurilor DDoS, în crearea SDN (de exemplu, implementările rețelei pentru kubernetes), ca principal instrument de trasare a sistemului și colectare a statisticilor, în sistemele de detectare a intruziunilor și în sistemele sandboxing etc.
Să încheiem această parte de introducere a articolului și să examinăm mașina virtuală și ecosistemul BPF mai în detaliu.
Divagare: utilitare
Pentru a putea executa exemplele din secțiunile următoare, poate fi necesar un anumit număr de utilitare, minim llvm/clang cu suport bpf și bpftool. În secțiunea puteți citi instrucțiunile pentru construirea utilitarelor, precum și a nucleului vostru. Această secțiune este plasată mai jos pentru a nu perturba claritatea expunerii noastre.
Registrele și sistemul de comenzi al mașinii virtuale BPF
Arhitectura și sistemul de comenzi BPF au fost dezvoltate având în vedere că programele vor fi scrise în limbajul C și, după încărcarea în nucleu, vor fi traduse în cod nativ. Prin urmare, numărul de registre și multitudinea de comenzi au fost alese cu gândul la intersecția, în sens matematic, a capacităților mașinilor moderne. În plus, programele erau supuse diferitelor limitări, de exemplu, până de curând nu era posibil să se scrie bucle și subprograme, iar numărul de instrucțiuni era limitat la 4096 (acum, programele privilegiate pot încărca până la un milion de instrucțiuni).
În BPF există unsprezece registre de 64 de biți accesibile utilizatorului. r0—r10 și contorul de instrucțiuni (program counter). Registrul r10 conține pointerul spre stivă (frame pointer) și este accesibil doar în modul de citire. Programele au la dispoziție o stivă de 512 octeți și o cantitate nelimitată de memorie comună sub formă de maps.
Programelor BPF le este permis să execute un set de funcții de ajutor (kernel helpers) definite în funcție de tipul programului și, de curând, și funcții obișnuite. Fiecare funcție apelată poate primi până la cinci argumente, transmise în registre r1—r5, iar valoarea returnată este transmisă în r0. Se garantează că, după returnarea din funcție, conținutul registrelor r6—r9 nu se va schimba.
Pentru o traduce eficientă a programelor, registrele r0—r11 pentru toate arhitecturile suportate se mapează clar pe registrele reale, ținând cont de particularitățile ABI ale arhitecturii curente. De exemplu, pentru x86_64 registrele r1—r5, utilizate pentru transmiterea parametrilor funcțiilor, se mapează pe rdi, rsi, rdx, rcx, r8, care sunt utilizate pentru a transmite parametrii în funcțiile de pe x86_64. De exemplu, codul din stânga este tradus în codul din dreapta astfel:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
Registrul r0 de asemenea, este utilizat pentru a returna rezultatul execuției programului, iar în registrul r1 programului se transmite un pointer către context — în funcție de tipul programului, acesta poate fi, de exemplu, o structură (pentru XDP) sau o structură (pentru diverse programe de rețea) sau o structură (pentru diferite tipuri de programe de tracing) etc.
Așadar, am avut un set de registre, kernel helpers, un stivă, un pointer pe context și memorie partajată sub formă de maps. Nu că toate acestea ar fi fost absolut necesare în călătorie, dar...
Hai să continuăm descrierea și să vorbim despre sistemul de instrucțiuni pentru a lucra cu aceste obiecte. Toate () instrucțiunile BPF au o dimensiune fixă de 64 biți. Dacă te uiți la o instrucțiune pe o mașină Big Endian de 64 biți, vei vedea

Aici Cod — aceasta este codificarea instrucțiunii, Dst/Src — acestea sunt codificările receptorului și sursei, respectiv, Dezactivat — un offset semnat de 16 biți, iar Imm — este un număr întreg semnat de 32 biți, folosit în unele instrucțiuni (analog constantului K din cBPF). Codificarea Cod are una din cele două forme:
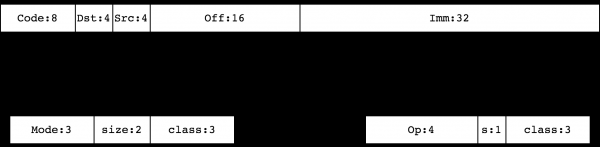
Clasele de instrucțiuni 0, 1, 2, 3 definesc instrucțiuni pentru lucrul cu memoria. Ele , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, respectiv. Clasele 4, 7 (BPF_ALU, BPF_ALU64) constituie un set de instrucțiuni ALU. Clasele 5, 6 (BPF_JMP, BPF_JMP32) includ instrucțiuni de salt.
Planul nostru de studiu al sistemului de instrucțiuni BPF este următorul: în loc să enumerăm minuțios toate instrucțiunile și parametrii lor, vom analiza câteva exemple în această secțiune, iar din acestea va deveni clar cum sunt de fapt structurate instrucțiunile și cum să dezasemblăm manual orice fișier binar pentru BPF. Pentru a fixa materialul, mai devreme în articol ne vom întâlni din nou cu instrucțiuni individuale în secțiunile despre Verifier, compilatorul JIT, traducerea BPF clasic și, de asemenea, în studiul maps, apelarea funcțiilor etc.
Atunci când vorbim despre instrucțiuni individuale, ne vom referi la fișierele nucleului și , în care sunt definite codurile numerice ale instrucțiunilor BPF. În timpul studiului autonom al arhitecturii și/sau analizei binarilor, semantica o poți găsi în următoarele surse, sortate după dificultate: , , și, desigur, în codul sursă Linux – verifier, JIT, interpretator BPF.
Exemplu: dezassemblarea BPF în minte
Să analizăm un exemplu, în care vom compila programul readelf-example.c și să privim binarul rezultat. Vom dezvălui conținutul original readelf-example.c mai jos, după ce îi vom recupera logica din codurile binare:
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Prima coloană în ieșire readelf — este indentarea și programul nostru constă, astfel, din patru comenzi:
Cod Dest Src Off  Imediat
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Codurile comenzii sunt egale b7, 15, b7 și 95. Să ne amintim că cele trei biți cei mai puțini reprezintă clasa instrucțiunii. În cazul nostru, al patrulea bit este gol pentru toate instrucțiunile, deci clasele instrucțiunilor sunt egale, respectiv, 7, 5, 7, 5. Clasa 7 este BPF_ALU64, iar 5 este BPF_JMP. Pentru ambele clase, formatul instrucțiunii este același (vezi mai sus) și putem rescrie programul nostru astfel (în același timp, vom scrie și celelalte coloane într-un mod mai uman):
Op S  Clasă   Dest Src Off  Imediat
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operația b clasei ALU64 — acesta este . Aceasta atribuie o valoare registrului de destinație. Dacă bitul s (sursa), atunci valoarea este preluată din registrul sursă, iar dacă, așa cum este cazul nostru, acesta nu este setat, valoarea este preluată din câmpul Imm. Astfel, în prima și a treia instrucțiune, efectuăm operația r0 = Imediat. Apoi, operația 1 din clasa JMP este (jump if equal). În cazul nostru, deoarece bitul S este zero, compară valoarea registrului sursă cu câmpul Imm. Dacă valorile coincid, saltul se va face la PC + Off, unde PC, așa cum se știe, conține adresa următoarei instrucțiuni. În cele din urmă, operația 9 din clasa JMP este . Această instrucțiune încheie execuția programului, returnând către nucleu r0. Să adăugăm o nouă coloană la tabelul nostru:
Op    S  Clasă   Dest Src Off  Imediat    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
Putem rescrie acest lucru într-un mod mai convenabil:
     r0 = 1
     if (r1 == 0) goto END
     r0 = 2
END:
     exit
Dacă ne amintim că în registrul r1 este transmis un pointer către context de la nucleu, iar în registrul r0 reîntoarce o valoare în nucleu, putem observa că dacă pointerul către context este zero, atunci returnăm 1, iar altfel returnăm 2. Să verificăm dacă avem dreptate, privind sursa:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Da, este un program lipsit de sens, dar se compilează în doar patru instrucțiuni simple.
Exemplu de excepție: instrucțiune de 16 biți
Anterioar, am menționat că unele instrucțiuni ocupă mai mult decât 64 de biți. Aceasta se referă, de exemplu, la instrucțiunea lddw (Cod = 0x18 = | | ) — pentru a încărca într-un registru o dublă valoare din câmpurile Imm. Problema este că Imm are 32 bits, and a double word is 64 bits, so loading a 64-bit immediate value into a register in one 64-bit instruction is not possible. Therefore, two adjacent instructions are used to store the second part of the 64-bit value in the field Imm. Exemplu:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
In the binary program, there are only two instructions:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
We will also encounter the instruction lddw, when we talk about relocations and working with maps.
Example: disassembling BPF with standard tools
So, we have learned to read BPF binary codes and are ready to analyze any instruction if necessary. However, it is worth noting that in practice, it is more convenient and faster to disassemble programs using standard tools, for example:
$ llvm-objdump -d x64.o

Disassembly of section .text:

0000000000000000 :
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Lifecycle of BPF objects, bpffs filesystem
(Some details described in this subsection were first learned from Alexei Starovoitov in .)
BPF objects — programs and maps — are created from user space using the commands BPF_PROG_LOAD și BPF_MAP_CREATE a apelului sistemic bpf(2), we will talk about how this happens in the next section. At this point, kernel data structures are created, and for each of them refcount (reference count) is set to one, and the user is returned a file descriptor pointing to the object. After closing the descriptor refcount the object decreases by one, and when it reaches zero, the object is destroyed.
If the program uses maps, then refcount the reference count of these maps increases by one after the program is loaded, meaning their file descriptors can be closed from the user process and still refcount will not become zero:
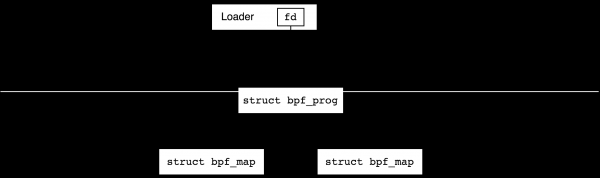
After successfully loading the program, we usually attach it to some event generator. For example, we can attach it to a network interface to process incoming packets or connect it to some tracepoint in the kernel. At this moment, the reference count will also increase by one, allowing us to close the file descriptor in the loading program.
Ce se va întâmpla dacă acum finalizăm activitatea încărcătorului? Acest lucru depinde de tipul de generator de evenimente (hook). Toate hook-urile de rețea vor exista după finalizarea încărcătorului, acestea fiind așa-numitele hook-uri globale. De exemplu, programele de urmărire vor fi eliberate după finalizarea procesului care le-a creat (de aceea sunt numite locale, adică „local la proces”). Tehnic, hook-urile locale au întotdeauna un descriptor de fișier corespunzător în spațiul utilizatorului și, prin urmare, sunt închise odată cu închiderea procesului, în timp ce hook-urile globale nu sunt. În următoarea imagine, cu ajutorul unor cruci roșii încerc să arăt cum finalizarea programului încărcător influențează timpul de viață al obiectelor în cazul hook-urilor locale și globale.
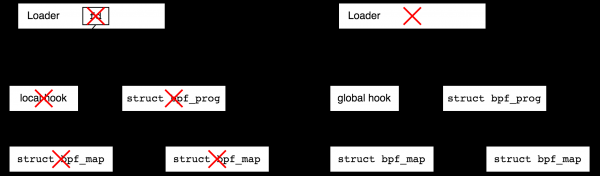
De ce există divizarea în hook-uri locale și globale? Rularea unor tipuri de programe de rețea are sens și fără spațiu utilizator, de exemplu, imaginați-vă o protecție împotriva DDoS — încărcătorul scrie reguli și conectează un program BPF la interfața de rețea, după care încărcătorul poate merge și se poate închide. Pe de altă parte, imaginați-vă un program de depanare a urmăriri pe care l-ați scris în zece minute — după finalizarea acestuia, v-ați dori ca sistemul să nu rămână cu resturi, iar hook-urile locale sunt cele care garantează acest lucru.
Pe de altă parte, imaginați-vă că doriți să vă conectați la un tracepoint din nucleu și să colectați statistici timp de mulți ani. În acest caz, v-ați dori să finalizați partea utilizator și să reveniți la statistici din când în când. O astfel de posibilitate este oferită de sistemul de fișiere bpf. Acesta este un sistem de fișiere pseudo, existent doar în memorie, care permite crearea de fișiere care fac referire la obiecte BPF și, astfel, cresc refcount numărul de obiecte. După aceea, încărcătorul poate închide activitatea, iar obiectele create de el vor rămâne active.
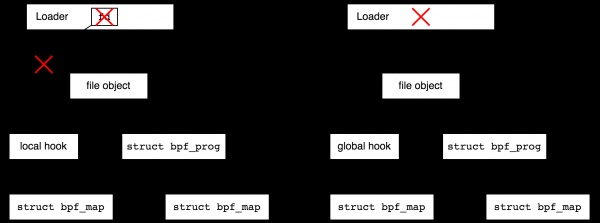
Crearea de fișiere în bpffs, care fac referire la obiecte BPF se numește „fixare” („pin”, ca în următoarea frază: „process can pin a BPF program or map”). Crearea de obiecte fișier pentru obiecte BPF are sens nu doar pentru prelungirea vieții obiectelor locale, ci și pentru comoditatea utilizării obiectelor globale — revenind la exemplul cu programul global pentru protecție împotriva DDoS, dorim să avem posibilitatea de fiecare dată când venim să consultăm statisticile.
Sistemul de fișiere BPF este de obicei montat în /sys/fs/bpf, dar îl poți monta și local, de exemplu, astfel:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Numele din sistemul de fișiere sunt create cu comanda BPF_OBJ_PIN a apelului de sistem BPF. Ca ilustrare, să luăm un program, să-l compilăm, să-l încărcăm și să-l pinăm în bpffs. Programul nostru nu face nimic util, aducem codul său doar pentru a putea reproduce exemplul:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Să compilăm acest program și să creăm o copie locală a sistemului de fișiere bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Acum să încărcăm programul nostru folosind utilitarul bpftool și să ne uităm la apelurile de sistem asociate bpf(2) (din ieșirea strace au fost eliminate unele linii necorespunzătoare):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Aici am încărcat programul folosind BPF_PROG_LOAD, am primit un descriptor de fișier de la kernel 3 și cu comanda BPF_OBJ_PIN am pinat acest descriptor de fișier sub forma unui fișier "bpf-mountpoint\/test". După aceasta, programul de încărcare bpftool s-a terminat, dar programul nostru a rămas în kernel, deși nu l-am atașat la niciun interfață de rețea:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Putem șterge obiectul de fișier folosind unlink(2) și după aceasta programul corespunzător va fi șters:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Ștergerea obiectelor
Vorbind despre ștergerea obiectelor, trebuie să precizăm că după ce am deconectat programul de hook (generator de evenimente), niciun eveniment nou nu va provoca lansarea acestuia, totuși, toate instanțele curente ale programului vor fi terminate în mod normal.
Unele tipuri de programe BPF permit înlocuirea programului în mișcare, adică oferă atomicitate secvenței replace = detach old program, attach new program. În acest caz, toate instanțele active ale versiunii vechi a programului își vor încheia activitatea, iar noii handleri de evenimente vor fi creați din programul nou, iar „atomicitatea” înseamnă aici că niciun eveniment nu va fi ratat.
Conectarea programelor la sursele de evenimente
În acest articol nu vom descrie separat conectarea programelor la sursele de evenimente, deoarece are sens să studiem acest lucru în contextul unui anumit tip de program. Vezi. mai jos, în care arătăm cum se conectează programele de tip XDP.
Gestionarea obiectelor prin apelul de sistem bpf
Programele BPF
Toate obiectele BPF sunt create și gestionate din spațiul utilizatorului prin apelul de sistem bpf, având următoarea semnătură:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Aici comanda cmd — este una dintre valorile de tip , attr — o referință la parametrii pentru programul specific și dimensiune — dimensiunea obiectului la referință, adică, de obicei, este sizeof(*attr). În kernelul 5.8, apelul de sistem bpf suportă 34 de comenzi diferite, iar union bpf_attr ocupă 200 de linii. Dar asta nu ar trebui să ne sperie, deoarece ne vom familiariza cu comenzile și parametrii pe parcursul mai multor articole.
Vom începe cu comanda BPF_PROG_LOAD, care creează programe BPF – preia un set de instrucțiuni BPF și îl încarcă în kernel. În momentul încărcării, se activează verifier-ul, și apoi JIT compiler-ul și, după finalizarea cu succes, utilizatorului îi este returnat un descriptor de fișier al programului. Am văzut ce se întâmplă cu el mai departe în secțiunea anterioară .
În prezent, vom scrie un program utilizator care va încărca un program BPF simplu, dar mai întâi trebuie să decidem ce fel de program dorim să încărcăm – va trebui să alegem și în cadrul acestui tip să scriem un program care va trece verificarea la verifier. Totuși, pentru a nu complica procesul, iată o soluție gata: vom lua un program de tip BPF_PROG_TYPE_XDP, care va returna valoarea XDP_PASS (a trece toate pachetele). În assemblerul BPF, acest lucru arată foarte simplu:
r0 = 2
exit
După ce ne-am decis ce utilizatorul (sau atacatorul) încearcă să facă, ci și vom încărca, putem povesti cum vom face acest lucru:
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Evenimentele interesante în program încep cu definirea array-ului insns — programul nostru BPF în coduri mașină. În acest context, fiecare instrucțiune a programului BPF este ambalată într-o structură . Primul element insns corespunde instrucțiunii r0 = 2, al doilea — exit.
O digresiune. În kernel, sunt definite macro-uri mai convenabile pentru scrierea codurilor mașină, iar, folosind fișierul de antet al kernel-ului tools/include/linux/filter.h am putea scrie
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Dar deoarece scrierea programelor BPF în coduri mașină este necesară doar pentru scrierea testelor în kernel și articole despre BPF, absența acestor macrocomenzi nu complică viața dezvoltatorului.
După definirea programului BPF, trecem la încărcarea acestuia în kernel. Setul nostru minimalist de parametri attr include tipul programului, setul și numărul de instrucțiuni, licența obligatorie, precum și numele "woo", pe care îl folosim pentru a găsi programul nostru în sistem după încărcare. Programul, așa cum a fost promis, este încărcat în sistem printr-o apelare de sistem bpf.
La sfârșitul programului ajungem într-un ciclu infinit care imită sarcina utilă. Fără acesta, programul va fi distrus de kernel la închiderea descriptorului de fișier, pe care ni l-a returnat apelul de sistem bpf, și nu îl vom vedea în sistem.
Ei bine, suntem gata de testare. Să compilăm și să rulăm programul sub strace, pentru a verifica dacă totul funcționează așa cum trebuie:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace .\/simple-prog
execve(".\/simple-prog", [".\/simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Totul este în regulă, bpf(2) ne-a returnat descriptorul 3 și am intrat în ciclu infinit cu pause(). Hai să încercăm să găsim programul nostru în sistem. Pentru aceasta, vom merge într-un alt terminal și vom folosi utilitarul bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Vedem că în sistem există un program încărcat woo al cărui ID global este 390 și că în prezent în procesul simple-prog există un descriptor de fișier deschis care indică programul (și dacă simple-prog se va termina, atunci woo va dispărea). Așa cum ne așteptam, programul woo ocupă 16 octeți — două instrucțiuni — coduri binare în arhitectura BPF, dar în formă nativă (x86_64) — aceasta deja ocupă 40 de octeți. Hai să ne uităm la programul nostru în forma sa originală:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
fără surprize. Acum să vedem codul generat de compilatorul JIT:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
nu foarte eficient pentru exit(2), dar în numele adevărului, programul nostru este prea simplu, iar pentru programele netriviale, prologul și epilogul adăugate de compilatorul JIT sunt, desigur, necesare.
Hărți
Programele BPF pot utiliza zone de memorie structurate, accesibile atât altor programe BPF, cât și programelor din spațiul utilizatorului. Aceste obiecte se numesc maps și în această secțiune vă vom arăta cum să le gestionăm prin apeluri de sistem. bpf.
Să spunem imediat că posibilitățile map-urilor nu se limitează doar la accesul la memoria comună. Există map-uri cu destinație specială, care conțin, de exemplu, pointere către programele BPF sau pointere către interfețele de rețea, map-uri pentru lucru cu evenimente perf etc. Nu vom discuta despre acestea aici, pentru a nu confunda cititorul. În plus, ignorăm problemele de sincronizare, deoarece nu sunt relevante pentru exemplele noastre. Lista completă a tipurilor de map-uri disponibile poate fi găsită în , iar în această secțiune, ca exemplu, vom lua primul tip istoric, tabela hash. BPF_MAP_TYPE_HASH.
Dacă creați o tabelă hash, să zicem, în C++, veți spune unordered_map woo, ceea ce înseamnă, în română, „am nevoie de o tabelă woo de dimensiune nelimitată, ale cărei chei au tipul int, iar valorile — tipul long”. Pentru a crea o tabelă hash BPF, trebuie să facem cam același lucru, cu mențiunea că va trebui să specificăm dimensiunea maximă a tabelei și, în loc de tipurile cheilor și valorilor, trebuie să indicăm dimensiunile lor în octeți. Comanda utilizată pentru a crea map-uri este BPF_MAP_CREATE a apelului sistemic bpf. Să ne uităm la un program mai mult sau mai puțin minimal, care creează un map. După programul anterior care încarcă programele BPF, acesta ar trebui să vi se pară simplu:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Aici definim un set de parametrii attr, în care spunem „am nevoie de o tabelă hash cu chei și valori de dimensiune sizeof(int), în care pot pune maximum patru elemente”. La crearea map-urilor BPF pot fi specificați și alți parametri, de exemplu, așa cum am făcut în exemplul cu programul, am specificat numele obiectului ca "woo".
Să compilăm și să rulăm programul:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Aici este apelul de sistem bpf(2) ne-a întors descriptorul hărții numărul 3 și apoi programul, așa cum era de așteptat, așteaptă instrucțiuni suplimentare în apelul de sistem pause(2).
Acum vom trimite programul nostru în fundal sau vom deschide un alt terminal și vom verifica obiectul nostru folosind utilitarul bpftool (putem distinge harta noastră de altele după numele ei):
$ sudo bpftool map
...
114: hash  name woo  flags 0x0
        key 4B  value 4B  max_entries 4  memlock 4096B
...
Numărul 114 este ID-ul global al obiectului nostru. Orice program din sistem poate folosi acest ID pentru a deschide o hartă existentă folosind comanda BPF_MAP_GET_FD_BY_ID a apelului sistemic bpf.
Acum putem experimenta cu tabela noastră hash. Să vedem ce conține:
$ sudo bpftool map dump id 114
Found 0 elements
Este gol. Să adăugăm o valoare în ea hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Să aruncăm o privire la tabelă din nou:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
Found 1 element
Ura! Am reușit să adăugăm un element. Observați că pentru aceasta trebuie să lucrăm la nivel de biți, deoarece bptftool nu știe ce tip au valorile în tabela hash. (I se poate transmite această informație folosind BTF, dar nu acum.)
Cum anume citeste și adaugă elemente bpftool? Să aruncăm o privire sub capotă:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
key: 01 00 00 00  value: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Mai întâi am deschis harta folosind ID-ul său global cu comanda BPF_MAP_GET_FD_BY_ID și bpf(2) ne-a întors descriptorul 3. Apoi, cu comanda BPF_MAP_GET_NEXT_KEY am găsit prima cheie din tabelă, trecând NULL ca pointer către cheie „anterior”. Când avem o cheie, putem folosi BPF_MAP_LOOKUP_ELEM, care ne returnează valoarea în pointerul valoare. Pasul următor este să încercăm să găsim următorul element, trecând pointerul la cheia curentă, dar tabela noastră conține doar un element și comanda BPF_MAP_GET_NEXT_KEY întoarce ENOENT.
Bine, să schimbăm valoarea pentru cheia 1, să zicem că logica noastră de afaceri necesită să scriem hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Așa cum era de așteptat, este foarte simplu: comanda BPF_MAP_GET_FD_BY_ID deschide harta noastră după ID, iar comanda BPF_MAP_UPDATE_ELEM rescrie elementul.
Prin urmare, după crearea unei hărți hash dintr-un program, putem citi și scrie conținutul său din alt program. Observați că dacă am reușit să facem acest lucru din linia de comandă, atunci orice alt program din sistem poate face la fel. Pe lângă comenzile descrise mai sus, pentru lucrul cu hărțile din spațiul utilizatorului sunt disponibile :
BPF_MAP_LOOKUP_ELEM: găsește valoarea după cheieBPF_MAP_UPDATE_ELEM: actualizează/crează o valoareBPF_MAP_DELETE_ELEM: șterge cheiaBPF_MAP_GET_NEXT_KEY: găsește următoarea (sau prima) cheieBPF_MAP_GET_NEXT_ID: permite parcurgerea tuturor hărților existente, funcționează astfelbpftool mapBPF_MAP_GET_FD_BY_ID: deschide o hartă existentă după ID-ul său globalBPF_MAP_LOOKUP_AND_DELETE_ELEM: actualizează atomic valoarea obiectului și returnează cea vecheBPF_MAP_FREEZE: face harta nemodificabilă din spațiul utilizatorului (această operațiune nu poate fi anulată)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: operațiuni în masă. De exemplu,BPF_MAP_LOOKUP_AND_DELETE_BATCH— acesta este singurul mod fiabil de a citi și reseta toate valorile din hartă
Nu toate aceste comenzi funcționează pentru toate tipurile de hărți, dar în general, lucrul cu alte tipuri de hărți din spațiul utilizatorului arată exact la fel ca lucrul cu hărțile hash.
Pentru ordine, să încheiem experimentele noastre cu harta hash. Amintiti-vă că am creat o hartă care poate conține până la patru chei? Să adăugăm încă câteva elemente:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Până acum este bine:
$ sudo bpftool map dump id 114
cheie: 01 00 00 00  valoare: 01 00 00 00
cheie: 02 00 00 00  valoare: 01 00 00 00
cheie: 04 00 00 00  valoare: 01 00 00 00
cheie: 03 00 00 00  valoare: 01 00 00 00
Am găsit 4 elemente
Să încercăm să adăugăm încă unul:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Eroare: actualizarea a eșuat: Lista de argumente prea lungă
Așa cum ne așteptam, nu am reușit. Să ne uităm mai în detaliu la eroare:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Lista de argumente prea lungă)
Eroare: actualizarea a eșuat: Lista de argumente prea lungă
+++ a ieșit cu 255 +++
Totul este în regulă: așa cum ne așteptam, comanda BPF_MAP_UPDATE_ELEM încercă să creeze o nouă, a cincea, cheie, dar eșuează cu E2BIG.
Așadar, știm să creăm și să încărcăm programe BPF, precum și să creăm și să gestionăm hărțile din spațiul utilizatorului. Acum, logic, ar fi să ne uităm la modul în care putem folosi hărțile din programele BPF în sine. Am putea să discutăm despre asta în limbajul greu de citit al programelor în cod mașină-macro, dar, de fapt, a venit momentul să arătăm cum se scriu și se întrețin programele BPF cu adevărat — prin intermediul libbpf.
(Pentru cititorii care nu sunt mulțumiți de absența unui exemplu de nivel inferior: vom detalia programele care folosesc hărțile și funcțiile ajutătoare create prin intermediul libbpf și vom explica ce se întâmplă la nivel de instrucțiuni. Pentru cititorii care sunt nemulțumiți de foarte mult, am adăugat în locul corespunzător al articolului.)
Scriem programe BPF folosind libbpf
A scrie programe BPF folosind coduri mașină poate fi interesant doar pentru o perioadă, apoi apare saturația. În acel moment, trebuie să ne întoarcem privirea către llvm, care are un backend pentru generarea de cod pentru arhitectura BPF, precum și către biblioteca libbpf, care permite scrierea părții utilizatorului a aplicațiilor BPF și încărcarea codului programelor BPF generate prin intermediul llvm/clang.
De fapt, așa cum vom vedea în acest articol și în cele următoare, libbpf face o mulțime de muncă și fără aceasta (sau instrumente similare — iproute2, libbcc, libbpf-go, etc.) este imposibil să trăiești. Una dintre caracteristicile esențiale ale proiectului libbpf este BPF CO-RE (Compile Once, Run Everywhere) — un proiect care permite scrierea programelor BPF portabile de la un nucleu la altul, cu posibilitatea de a rula pe diferite API-uri (de exemplu, atunci când structura nucleului se schimbă de la versiune la versiune). Pentru a putea lucra cu CO-RE, nucleul dvs. trebuie să fie compilat cu suport pentru BTF (cum să faceți asta, explicăm în secțiunea . Puteți verifica dacă nucleul dvs. a fost compilat cu BTF sau nu foarte simplu — după existența următorului fișier:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Acest fișier conține informații despre toate tipurile de date utilizate în nucleu și este folosit în toate exemplele noastre care utilizează libbpf. Vom discuta detaliat despre CO-RE în următorul articol, iar în acesta — pur și simplu construiți-vă nucleul cu CONFIG_DEBUG_INFO_BTF.
Biblioteca libbpf care se află chiar în directorul tools/lib/bpf al nucleului și dezvoltarea sa se desfășoară prin lista de discuții bpf@vger.kernel.org. Cu toate acestea, pentru nevoile aplicațiilor care funcționează în afara nucleului, este susținut un depozit separat în care biblioteca kernel este replicată pentru acces în citire mai mult sau mai puțin așa cum este.
În această secțiune, ne vom uita la cum putem crea un proiect care folosește libbpf, vom scrie câteva programe de testare (mai mult sau mai puțin fără sens) și vom analiza în detaliu cum funcționează toate acestea. Aceasta ne va permite, în secțiunile următoare, să explice mai ușor cum anume interacționează programele BPF cu maps, kernel helpers, BTF etc.
De obicei, proiectele care folosesc libbpf adaugă un depozit de pe GitHub ca submodul git, așa că vom face și noi asta:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Initialized empty Git repository in /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Cloning into '/tmp/libbpf-example/libbpf'...
remote: Enumerating objects: 200, done.
remote: Counting objects: 100% (200/200), done.
remote: Compressing objects: 100% (103/103), done.
remote: Total 3354 (delta 101), reused 118 (delta 79), pack-reused 3154
Receiving objects: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, done.
Resolving deltas: 100% (2176/2176), done.
Se compilează libbpf foarte simplu:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Planul nostru în această secțiune este următorul: vom scrie un program BPF de tip BPF_PROG_TYPE_XDP, același cu exemplul anterior, dar în C, îl vom compila cu ajutorul clang, și vom scrie un program-helper care îl va încărca în nucleu. În secțiunile următoare, vom extinde funcționalitățile atât ale programului BPF, cât și ale programului-helper.
Exemplu: creăm o aplicație completă cu ajutorul libbpf
Mai întâi, folosim fișierul /sys/kernel/btf/vmlinux, despre care am discutat mai devreme, și vom crea echivalentul său sub formă de fișier header:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hÎn acest fișier vor fi stocate toate structurile de date disponibile în nucleul nostru, de exemplu, iată cum este definit headerul IPv4 în nucleu:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Acum vom scrie programul nostru BPF în limbaj C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Deși programul nostru a ieșit foarte simplu, totuși trebuie să acordăm atenție la multe detalii. În primul rând, primul fișier de antet pe care îl includem este vmlinux.h, pe care l-am generat de curând cu ajutorul bpftool btf dump — acum nu mai trebuie să instalăm pachetul kernel-headers pentru a înțelege cum arată structurile nucleului. Următorul fișier de antet provine din biblioteca libbpf. Acum avem nevoie de el doar pentru a defini macro-ul SEC, care trimite simbolul în secțiunea corespunzătoare a fișierului obiect ELF. Programul nostru se află în secțiunea xdp/simple, unde înainte de slash definim tipul programului BPF — aceasta este convenția utilizată în libbpf, pe baza numelui secțiunii va aplica tipul corect la rulare bpf(2). Programul BPF este C — foarte simplu și constă dintr-o singură linie return XDP_PASS. În cele din urmă, o secțiune separată "license" conține numele licenței.
Putem să ne compilăm programul cu ajutorul llvm/clang, versiunea >= 10.0.0, și mai bine — mai recent (vezi secțiunea ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Printre trăsăturile interesante: specificăm arhitectura țintă -target bpf și calea către antete libbpf, pe care le-am instalat recent. De asemenea, nu uitați de -O2, fără această opțiune vă pot surprinde niște neplăceri mai târziu. Să vedem codul nostru, am reușit să scriem programul pe care îl doream?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Da, am reușit! Acum avem un fișier binar cu programul și dorim să creăm o aplicație care să-l încarce în nucleu. Pentru aceasta, biblioteca libbpf ne oferă două opțiuni — să folosim un API de nivel inferior sau un API de nivel superior. Noi vom urma calea a doua, deoarece ne dorim să învățăm să scriem, să încărcăm și să conectăm programele BPF cu un efort minim pentru a le studia ulterior.
Pentru început, trebuie să generăm «scheletul» programului nostru din binar cu ajutorul aceleași utilitare bpftool — cuțitul elvețian al lumii BPF (ceea ce poate fi înțeles și literar, deoarece Daniel Borkman — unul dintre creatorii și întreținătorii BPF — este elvețian):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hÎn fișierul xdp-simple.skel.h conține codul binar al programului nostru și funcțiile pentru gestionarea — încărcarea, conectarea, ștergerea obiectului nostru. În cazul nostru simplu, pare exagerat, dar funcționează și atunci când fișierul obiect conține multe programe BPF și hărți, iar pentru a încărca acest gigant ELF avem nevoie doar să generăm scheletul și să apelăm una-două funcții din aplicația utilizator, la scrierea căreia ne vom îndrepta acum.
De fapt, programul nostru de încărcare este trivial:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Aici struct xdp_simple_bpf este definit în fișierul xdp-simple.skel.h și descrie fișierul nostru obiect:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Putem observa aici urme ale API-ului de nivel scăzut: structura struct bpf_program *simple și struct bpf_link *simple. Prima structură descrie în mod specific programul nostru, scris în secțiunea xdp/simple, iar a doua — descrie modul în care programul se conectează la sursa de evenimente.
Funcția xdp_simple_bpf__open_and_load, deschide obiectul ELF, îl analizează, creează toate structurile și substructurile (pe lângă program, în ELF se află și alte secțiuni — date, date doar pentru citire, informații de depanare, licență etc.), și apoi îl încarcă în nucleu printr-un apel de sistem bpf, ceea ce putem verifica compilând și rulând programul:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Acum să ne uităm la programul nostru folosind bpftool. Să-i găsim ID-ul:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
și să-l dump (folosim forma scurtă a comenzii bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Ceva nou! Programul a imprimat fragmente din fișierul nostru sursă în limbaj C. Acest lucru a fost realizat de biblioteca libbpf, care a găsit secțiunea de depanare în binar, a compilat-o într-un obiect BTF, l-a încărcat în nucleu prin BPF_BTF_LOAD, și apoi a indicat descriptorul de fișier obținut la încărcarea programului cu comanda BPG_PROG_LOAD.
Kernel Helpers
Programele BPF pot lansa funcții „extern” - kernel helpers. Aceste funcții-helper permit programelor BPF să acceseze structuri de kernel, să gestioneze maps și să comunice cu „lumea reală” - să creeze evenimente perf, să gestioneze hardware-ul (de exemplu, să redirecționeze pachete) etc.
Exemplu: bpf_get_smp_processor_id
În cadrul paradigmei „învățăm din exemple”, să analizăm una dintre funcțiile-helper, bpf_get_smp_processor_id(), în fișierul kernel/bpf/helpers.c. Aceasta returnează numărul procesorului pe care se execută programul BPF care a invocat-o. Dar ceea ce ne interesează nu este semantică sa, ci faptul că implementarea sa ocupă o singură linie:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Definițiile funcțiilor-helper BPF sunt asemănătoare cu definirea apelurilor de sistem Linux. Aici, de exemplu, se definește o funcție fără argumente. (O funcție care primește, să zicem, trei argumente, se definește folosind macro-ul BPF_CALL_3. Numărul maxim de argumente este cinci.) Totuși, aceasta este doar prima parte a definiției. A doua parte constă în definirea structurii de tip struct bpf_func_proto, care conține o descriere a funcției-helper, pe care o înțelege verifier:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Înregistrarea funcțiilor-helper
Pentru ca programele BPF de un anumit tip să poată utiliza această funcție, trebuie să o înregistreze, de exemplu, pentru tipul BPF_PROG_TYPE_XDP în kernel se definește funcția xdp_func_proto, care, pe baza ID-ului funcției-helper, determină dacă XDP suportă această funcție sau nu. Funcția noastră :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Noile tipuri de programe BPF „se definesc” în fișierul prin macro-ul BPF_PROG_TYPE. Definirea este pusă între ghilimele, deoarece aceasta este o definiție logică, iar în termenii limbajului C, definiția unui întreg set de structuri specifice se realizează în alte locuri. În special, în fișierul kernel/bpf/verifier.c toate definițiile din fișierul bpf_types.h sunt utilizate pentru a crea un array de structuri bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = &_name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Deci, pentru fiecare tip de program BPF se definește un pointer pentru structura de date de tip struct bpf_verifier_ops, care este inițializat cu valoarea _name ## _verifier_ops, adică, xdp_verifier_ops pentru xdp. Structura xdp_verifier_ops în fișierul net/core/filter.c în următorul mod:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Aici vedem funcția noastră cunoscută xdp_func_proto, care va fi apelată de verifier de fiecare dată când întâlnește un apel al unei funcții din programul BPF, vezi. .
Să vedem cum un program ipotetic BPF folosește funcția bpf_get_smp_processor_id. Pentru aceasta, să rescriem programul din secțiunea noastră anterioară astfel:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Simbolul bpf_get_smp_processor_id în <bpf/bpf_helper_defs.h> NanoGUI libbpf cum
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;adică, bpf_get_smp_processor_id — este un pointer către funcție, al cărei valoare este 8, unde 8 este valoarea BPF_FUNC_get_smp_processor_id de tip enum bpf_fun_id, care este definit pentru noi în fișierul vmlinux.h (fișierul bpf_helper_defs.h în nucleu este generat de un script, deci numerele "magice" sunt acceptabile). Această funcție nu primește argumente și returnează o valoare de tip __u32. Când o apelăm în programul nostru, clang generează o instrucțiune BPF_CALL "corectă". Să compilăm programul și să vedem secțiunea xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       format fișier elf64-bpf

Dezasamblarea secțiunii xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
În prima linie vedem instrucțiunea call, parametrul IMM care are valoarea 8, iar SRC_REG — nul. Conform convenției ABI folosite de verifier, aceasta este apelarea funcției de ajutor numărul opt. După ce este apelată, logica este simplă. Valoarea returnată din registru r0 este copiată în r1 și pe liniile 2, 3 este convertită la tipul u32 — primii 32 de biți sunt resetați. Pe liniile 4, 5, 6, 7 returnăm 2 (XDP_PASS) sau 1 (XDP_DROP) în funcție de faptul dacă funcția de ajutor de pe linia 0 a returnat o valoare nulă sau nenulă.
Să ne verificăm: să încărcăm programul și să vedem ieșirea bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Bine, verifier a găsit kernel-helperul corect.
Exemplu: transmitem argumentele și, în cele din urmă, lansăm programul!
Toate funcțiile de ajutor la nivel de execuție au prototip
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Parametrii funcțiilor de ajutor sunt transmişi în registre r1—r5, iar valoarea returnată este înregistrată în registru r0. Nu există funcții care să accepte mai mult de cinci argumente și nu se preconizează adăugarea suportului pentru acestea în viitor.
Să ne uităm la noul kernel helper și la modul în care BPF transmite parametrii. Să rescriem xdp-simple.bpf.c în următorul mod (restul rândurilor nu s-au schimbat):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Programul nostru imprimă numărul CPU pe care rulează. Să-l compilăm și să ne uităm la cod:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
În rândurile 0-7, salvăm pe stivă șirul running on CPU%un, iar apoi în rândul 8 lansăm ceea ce ne este cunoscut bpf_get_smp_processor_id. În rândurile 9-12, ne pregătim argumentele helperului bpf_printk — registrele r1, r2, r3.De ce sunt trei și nu două? Pentru că bpf_printk — în jurul adevăratului helper bpf_trace_printk, care necesită transmiterea dimensiunii șirului de format.
Acum să adăugăm câteva linii la xdp-simple.c, astfel încât programul nostru să se conecteze la interfață lo și să se execute cu adevărat!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Aici folosim funcția bpf_set_link_xdp_fd, care conectează programele BPF de tip XDP la interfețele de rețea. Am codificat numărul interfeței lo, care este întotdeauna egal cu 1. Rulăm funcția de două ori pentru a deconecta mai întâi vechia aplicație, dacă a fost conectată. Observați că acum nu avem nevoie de apelul pause sau de un ciclu infinit: aplicația noastră de încărcare se va încheia, dar programul BPF nu va fi distrus, deoarece este conectat la sursa de evenimente. După ce încărcarea și conectarea au fost finalizate, programul se va lansa pentru fiecare pachet de rețea care sosește la lo.
Să încărcăm programul și să ne uităm la interfață lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  name simple  tag 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Programul pe care l-am încărcat are ID 669 și același ID îl vedem pe interfață lo. Vom trimite câteva pachete către 127.0.0.1 (request + reply):
$ ping -c1 localhostși acum să ne uităm la conținutul fișierului virtual de depanare /sys/kernel/debug/tracing/trace_pipe, în care bpf_printk își scrie mesajele:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Două pachete au fost observate la lo și procesate pe CPU0 — prima noastră aplicație completă BPF a funcționat!
Merită menționat că bpf_printk nu scrie în fișierul de depanare fără motiv: acest lucru nu este cel mai bun ajutor pentru utilizarea în producție, dar scopul nostru a fost să arătăm ceva simplu.
Accesul la maps din programele BPF
Exemplu: utilizăm o mapă dintr-o programă BPF
În secțiunile anterioare, am învățat să creăm și să utilizăm mape din spațiul utilizatorului, acum să ne uităm la partea de kernel. Să începem, ca de obicei, cu un exemplu. Să rescriem aplicația noastră xdp-simple.bpf.c în următorul mod:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
La începutul programului am adăugat definiția unei mape woo: este un array de 8 elemente, în care sunt stocate valori de tip și o valoare de tip (în C am defini un astfel de array ca u64 woo[8]). În programul "xdp/simple" obținem numărul procesorului curent în variabila key și apoi, folosind funcția de asistență bpf_map_lookup_element obținem un pointer la înregistrarea corespunzătoare din array, pe care o incrementăm cu unu. Tradus în română: numărăm statisticile despre pe ce CPU au fost procesate pachetele primite. Să încercăm să rulăm programul:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Să verificăm că s-a conectat la lo și să trimitem câteva pachete:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Acum, să ne uităm la conținutul array-ului:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Aproape toate procesele au fost procesate pe CPU7. Nu este important pentru noi, esențial este că programul funcționează și am înțeles cum să obținem acces la hărți din programele BPF — prin intermediul .
Punctul mistic
Deci, putem accesa harta din programul BPF folosind apeluri de tipul
val = bpf_map_lookup_elem(&woo, &key);unde funcția helper arată așa
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)dar noi transmitem un pointer &woo la o structură anonimă struct { ... }…
Dacă ne uităm la assemblerul programului, vom vedea că valoarea &woo de fapt nu este definită (linia 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
și este conținut în relocări:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Relocation section '.relxdp/simple' at offset 0xe18 contains 1 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Dar dacă ne uităm la programul deja încărcat, vom vedea un pointer la harta corectă (linia 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Astfel, putem concluziona că, în momentul lansării programului nostru de încărcare, referința la &woo a fost înlocuită cu ceva de către bibliotecă libbpf. La început, vom analiza ieșirea strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Vedem că libbpf a creat o hartă woo și apoi a încărcat programul nostru simple. Haideți să analizăm mai atent cum încărcăm programul:
- apelăm
xdp_simple_bpf__open_and_loaddintr-un fișierxdp-simple.skel.h - care invocă
xdp_simple_bpf__loaddintr-un fișierxdp-simple.skel.h - care invocă
bpf_object__load_skeletondintr-un fișierlibbpf/src/libbpf.c - care invocă
bpf_object__load_xattrdinlibbpf/src/libbpf.c
Ultima funcție, printre altele, va invoca bpf_object__create_maps, care creează sau deschide hărți existente, transformându-le în descriptorii de fișiere. (Acesta este locul unde vedem BPF_MAP_CREATE în output strace.) Apoi, se apelează funcția bpf_object__relocate , iar aceasta ne interesează, deoarece ne amintim că am văzut woo în tabelul de relocări. Explorându-l, ajungem, în cele din urmă, la funcția bpf_program__relocate, care se ocupă de :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Așadar, luăm instrucțiunea noastră
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llși înlocuim registrul sursă cu BPF_PSEUDO_MAP_FD, iar primul IMM cu descriptorul de fișier al hărții noastre și, dacă este, de exemplu, 0xdeadbeef, atunci, ca rezultat, vom obține instrucțiunea
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llExact așa este transmisă informația despre hărți într-o programă BPF specifică. Astfel, harta poate fi fie creată cu ajutorul BPF_MAP_CREATE, fie deschisă prin ID cu ajutorul BPF_MAP_GET_FD_BY_ID.
Așadar, utilizând libbpf algoritmul este următorul:
- în timpul compilării, pentru referințele la hărți se creează înregistrări în tabelul de relocare
libbpfdeschide obiectul ELF, găsește toate hărțile folosite și creează pentru ele descriptoare de fișiere- descriptoarele de fișiere sunt încărcate în kernel ca parte a instrucțiunii
LD64
După cum înțelegeți, acestea nu sunt toate, și va trebui să ne uităm în kernel. Din fericire, avem un indiciu - am introdus valoarea BPF_PSEUDO_MAP_FD în registrul sursă și putem să-l căutăm, ceea ce ne va duce în locul sacru al tuturor sacrelor - kernel/bpf/verifier.c, unde funcția cu nume caracteristic înlocuiește descriptorul de fișier cu adresa structurii de tip struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(codul complet poate fi găsit ). Așa că putem completa algoritmul nostru:
- în timpul încărcării programului, verifier-ul verifică corectitudinea utilizării hărții și introduce adresa structurii corespunzătoare
struct bpf_map
La încărcarea binarului ELF cu ajutorul libbpf se întâmplă multe alte evenimente, dar le vom discuta în articole separate.
Încărcăm programele și hărțile fără libbpf
Așa cum a fost promis, iată un exemplu pentru cititorii care doresc să știe cum să creeze și să încarce un program care utilizează hărțile, fără ajutor libbpf. Acesta poate fi util atunci când lucrați într-un mediu pentru care nu puteți aduna dependențe, sau economisiți fiecare bit, sau scrieți un program de tip , care generează cod binar BPF la cerere.
Pentru a facilita urmărirea logicii, pentru aceste scopuri, vom rescrie exemplul nostru xdp-simple. Codul complet și puțin extins al programului, discutat în acest exemplu, îl puteți găsi în acest .
Logica aplicației noastre este următoarea:
- creați o hartă de tip
BPF_MAP_TYPE_ARRAYfolosind comandaBPF_MAP_CREATE, - creați un program care folosește această hartă,
- atașați programul la interfață
lo,
ceea ce se traduce în termeni umani ca
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Aici map_create creează o hartă exact așa cum am făcut în primul exemplu despre apelul de sistem bpf — „kernel, te rog, fă-mi o hartă nouă sub formă de array din 8 elemente de tip __u64 și restituie-mi un descriptor de fișier”:
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Programul se încarcă de asemenea simplu:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Partea complexă prog_load — este definiția programului nostru BPF sub formă de array de structuri struct bpf_insn insns[]. Dar deoarece folosim un program pe care îl avem în C, putem trișa puțin:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Deci, trebuie să scriem 14 instrucțiuni sub formă de structuri de tip struct bpf_insn (sugestie: faceți un dump de sus, recitiți secțiunea despre instrucțiuni, deschideți și și încercați să determinați struct bpf_insn insns[] în mod autonom):
struct bpf_insn insns[] = {

 /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },


 /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    0a /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    0a /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    0a /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, 0a/* placeholder */

    0a /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    0a/* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    0a/* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    0a/* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    0a/* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    0a/* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    0a/* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    0a/* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    0a/* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Exercițiu pentru cei care nu au scris asta singuri – găsiți map_fd.
Mai avem o parte neexploatată în programul nostru – xdp_attach. Din păcate, programele de tip XDP nu pot fi atașate prin apel de sistem bpf. Oamenii care au creat BPF și XDP erau din comunitatea de rețea Linux, așa că ei au folosit cea mai familiară pentru ei (dar nu pentru oamenii ) interfață de interacțiune cu nucleul: , vezi de asemenea . Cel mai simplu mod de implementare xdp_attach este copierea codului din libbpf, și anume, din fișierul , ceea ce am făcut, scurtându-l puțin:
Bine ați venit în lumea socket-urilor netlink
Deschidem socket netlink de tip NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("raportarea erorilor netlink nu este suportată");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Citirea din acest socket:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "pid greșit");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); prea mult cod de copiat...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
În final, iată funcția noastră care deschide socket-ul și trimite un mesaj special în acesta, conținând un descriptor de fișier:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Așadar, totul este pregătit pentru testare:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Să vedem dacă programul nostru s-a conectat la lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Vom trimite ping-uri și ne vom uita la map:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Found 8 elements
Ura, totul funcționează. Remarcați, de asemenea, că mapa noastră apare din nou ca o serie de byte-uri. Acest lucru se întâmplă deoarece, spre deosebire de libbpf nu am încărcat informațiile despre tipuri (BTF). Dar vom vorbi mai în detaliu despre aceasta data viitoare.
Instrumente de dezvoltare
În această secțiune, vom explora setul minim de instrumente pentru dezvoltatorul BPF.
În general, pentru dezvoltarea programelor BPF nu este nevoie de nimic special — BPF funcționează pe orice nucleu decent de distribuție, iar programele sunt compilate cu ajutorul clang, care poate fi instalat din pachet. Totuși, deoarece BPF este în proces de dezvoltare, nucleul și instrumentele se schimbă constant. Dacă nu doriți să scrieți programe BPF folosind metode vechi din 2019, va trebui să compilați
llvm/clangpahole- nucleul vostru
bpftool
(Pentru referință: această secțiune și toate exemplele din articol au fost rulate pe Debian 10.)
llvm/clang
BPF colaborează cu LLVM și, deși recent programele pentru BPF pot fi compilate și cu gcc, toată dezvoltarea curentă se desfășoară pentru LLVM. Așadar, primul lucru pe care îl vom face este să compilăm versiunea curentă clang din git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... multe momente mai târziu
$
Acum putem verifica dacă totul s-a compilat corect:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  Versiune LLVM 11.0.0git
  Compilare optimizată.
  Țintă implicită: x86_64-unknown-linux-gnu
  CPU gazdă: znver1

  Ţinte înregistrate:
    bpf    - BPF (endianness gazdă)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - X86 de 32 de biți: Pentium-Pro și mai sus
    x86-64 - X86 de 64 de biți: EM64T și AMD64
(Instrucțiunile pentru compilare clang le-am luat din .)
Nu vom instala programele recent compilate, ci, în schimb, le vom adăuga în PATH, de exemplu:
export PATH="`pwd`/bin:$PATH"(Aceasta poate fi adăugată în .bashrc sau într-un fișier separat. Personal, eu adaug astfel de lucruri în ~/bin/activate-llvm.sh și când este nevoie fac . activate-llvm.sh.)
Pahole și BTF
Utilitarul pahole sunt utilizate la compilarea nucleului pentru a crea informații de depanare în formatul BTF. Nu ne vom opri în detaliile tehnologiei BTF în acest articol, cu excepția faptului că este convenabil și dorim să-l folosim. Așadar, dacă intenționați să compilați nucleul vostru, începeți prin a compila pahole (fără pahole nu veți putea compila nucleul cu opțiunea CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Nuclee pentru experimente cu BPF
Când explorați posibilitățile BPF, doriți să construiți propriul kernel. De fapt, acest lucru nu este obligatoriu, deoarece puteți să creați și să încărcați programe BPF și pe un kernel distribuit, totuși, având propriul kernel vă permite să utilizați cele mai noi funcționalități BPF care vor apărea în distribuția dumneavoastră, în cel mai bun caz, peste câteva luni sau, în cazul unor instrumente de depanare, deloc în viitorul apropiat. De asemenea, având propriul kernel, vă simțiți important experimentând cu codul.
Pentru a construi un kernel, aveți nevoie, mai întâi, de kernelul în sine și, în al doilea rând, de fișierul de configurare a kernelului. Pentru experimentele cu BPF, putem folosi un sau unul dintre kernelurile de dezvoltare. Din punct de vedere istoric, dezvoltarea BPF are loc în comunitatea de rețea Linux, iar toate modificările, mai devreme sau mai târziu, trec prin David Miller — mentenorul părții de rețea a Linux. În funcție de natura sa — modificări sau caracteristici noi — modificările de rețea ajung într-unul din cele două kerneluri — sau . Modificările pentru BPF sunt distribuite în mod similar între și , care apoi se lansează în net și net-next, respectiv. Mai multe detalii pot fi găsite în și . Așadar, alegeți kernelul în funcție de preferințele și nevoile de stabilitate a sistemului pe care testați (*-next kernelurile sunt cele mai instabile dintre cele enumerate).
Acest articol nu include explicații despre cum să gestionați fișierele de configurare a kernelului — se presupune că deja știți cum să faceți acest lucru sau în mod autonom. Cu toate acestea, următoarele instrucțiuni ar trebui să fie suficient de clare pentru a obține un sistem funcțional cu suport BPF.
Descărcați unul dintre kernelurile menționate mai sus:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Construiți un config minim funcțional pentru kernel:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Activați opțiunile BPF în fișierul .config alegerii dumneavoastră (cel mai probabil, însuși CONFIG_BPF va fi deja activat, deoarece este utilizat de systemd). Iată lista opțiunilor din kernelul folosit pentru acest articol:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Apoi, putem să compilăm și să instalăm cu ușurință modulele și nucleul (de altfel, nucleul poate fi compilat folosind tocmai compilatul clang, adăugând CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
și să repornim cu noul nucleu (eu folosesc pentru aceasta kexec din pachetul kexec-tools):
v=5.8.0-rc6+ # dacă recompiliți nucleul curent, puteți seta v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
Utilitarul folosit cel mai frecvent în articol va fi utilitarul bpftool, oferit ca parte a nucleului Linux. Acesta este scris și întreținut de dezvoltatorii BPF pentru dezvoltatorii BPF și cu ajutorul său puteți gestiona toate tipurile de obiecte BPF — încărca programe, crea și modifica hărți, explora ecosistemul BPF etc. Documentația sub formă de surse pentru paginile man poate fi găsită sau, deja compilată, .
La momentul redactării articolului bpftool este disponibilă în formă gata făcută doar pentru RHEL, Fedora și Ubuntu (vezi, de exemplu, , în care se povestește despre istoria neterminată a împachetării bpftool în Debian). Dar dacă ați compilat deja nucleul, atunci compilarea bpftool este foarte simplă:
$ cd ${linux}/tools/bpf/bpftool
# ... scrieți căile către ultima versiune de clang, așa cum s-a explicat mai sus
$ make -s

Auto-detecting system features:
...                        libbfd: [ on  ]
...        disassembler-four-args: [ on  ]
...                          zlib: [ on  ]
...                        libcap: [ on  ]
...               clang-bpf-co-re: [ on  ]

Auto-detecting system features:
...                        libelf: [ on  ]
...                          zlib: [ on  ]
...                           bpf: [ on  ]

$
(aici ${linux} — este directorul dumneavoastră cu nucleul.) După executarea acestor comenzi bpftool va fi compilat în directorul ${linux}/tools/bpf/bpftool și poate fi adăugat în cale (în primul rând utilizatorului root) sau pur și simplu copiat în /usr/local/sbin.
Compilarea bpftool este cel mai bine să o faceți folosind ultimul clang, compilat, așa cum s-a explicat mai sus, iar pentru a verifica dacă s-a compilat corect — prin intermediul, de exemplu, comenzii
$ sudo bpftool feature probe kernel
Scanning system configuration...
bpf() syscall for unprivileged users is enabled
JIT compiler is enabled
JIT compiler hardening is disabled
JIT compiler kallsyms exports are enabled for root
...
care va arăta ce caracteristici BPF sunt activate în nucleul dumneavoastră.
Apropo, comanda anterioară poate fi rulată ca
# bpftool f p kAceasta este făcută prin analogie cu utilitarele din pachet iproute2, unde putem spune, de exemplu, ip a s eth0 în loc de ip addr show dev eth0.
Concluzie
BPF permite cu succes să modificăm eficient funcționalitatea nucleului și să măsurăm. Sistemul s-a dovedit a fi foarte reușit, în cele mai bune tradiții UNIX: un mecanism simplu care permite (re)programarea nucleului a permis unui număr foarte mare de oameni și organizații să experimenteze. Și, deși experimentele, la fel ca și dezvoltarea infrastructurii BPF, nu s-au încheiat, sistemul are deja un ABI stabil, care permite construirea unei logici de afaceri fiabile și, mai ales, eficiente.
Este de remarcat faptul că, în opinia mea, tehnologia a devenit atât de populară tocmai pentru că, pe de o parte, o putem explora (arhitectura mașinii poate fi înțeleasă mai mult sau mai puțin într-o seară), iar pe de altă parte — să rezolvăm probleme care nu erau rezolvabile (frumos) până la apariția ei. Aceste două componente, împreună, îi determină pe oameni să experimenteze și să viseze, ceea ce duce la apariția de noi și noi soluții inovatoare.
Acest articol, deși nu foarte scurt, este doar o introducere în lumea BPF și nu descrie funcțiile „avansate” și părțile importante ale arhitecturii. Planul următor este, în mare parte, următorul: articolul următor va fi o revizuire a tipurilor de programe BPF (în nucleul 5.8 sunt suportate 30 de tipuri de programe), apoi, în sfârșit, vom analiza cum să scriem aplicații reale pe BPF folosind programele pentru urmărirea nucleului, apoi va veni timpul pentru un curs mai profund despre arhitectura BPF, iar apoi — pentru exemple de aplicații BPF în domeniul rețelelor și securității.
Articolele anterioare din acest ciclu
Linkuri
— documentația BPF de la cilium, mai exact de la Daniel Borkman, unul dintre creatorii și întreținătorii BPF. Este una dintre primele descrieri serioase, care se deosebește de celelalte prin faptul că Daniel știe exact despre ce vorbește și nu sunt greșeli acolo. În special, în acest document se explică cum să lucrăm cu programele BPF de tip XDP și TC folosind cunoscuta utilitate
ipdin pachetuliproute2.— fișierul original cu documentația pentru BPF clasic și apoi pentru BPF extins. Este util de citit dacă doriți să explorați asamblarea și detalii tehnice ale arhitecturii.
. Se actualizează rar, dar relevant, deoarece scriu acolo Alexei Starovoitov (autorul eBPF) și Andrii Nakryiko — (întreținătorul
libbpf).. Un thread interesant pe Twitter de la Quentin Monnet cu exemple și secrete de utilizare a bpftool.
. O listă uriașă (încă susținută) de linkuri către documentația BPF de la Quentin Monnet.
Sursa: habr.com
