

Având în vedere că ClickHouse este un sistem specializat, este important să ținem cont de particularitățile arhitecturii sale în utilizarea acestuia. În această prezentare, Alexey va discuta despre exemplele tipice de greșeli în utilizarea ClickHouse care pot duce la o funcționare ineficientă. Vor fi prezentate exemple practice care vor arăta cum alegerea unei anumite scheme de prelucrare a datelor poate schimba semnificativ performanța.
Salut tuturor! Mă numesc Alexey și lucrez cu ClickHouse.
Întâi de toate, trebuie să vă bucur că astăzi nu voi vorbi despre ce este ClickHouse. Sincer, mi s-a săturat să explic asta. Cred că toată lumea știe deja.
În schimb, voi discuta despre posibilele capcane, adică despre cum poate fi utilizat greșit ClickHouse. De fapt, nu trebuie să vă fie frică, deoarece dezvoltăm ClickHouse ca un sistem care este simplu, convenabil și funcționează din prima. L-ai instalat și asta e, fără probleme.
Dar, cu toate acestea, trebuie să ținem cont că acest sistem este specializat și este ușor să te lovești de un scenariu neobișnuit de utilizare care să scoată sistemul din zona sa de confort.
Așadar, care sunt capcanele? În principal, voi vorbi despre lucruri evidente. Toată lumea știe, toți înțeleg și se pot bucura că sunt atât de deștepți, iar cei care nu înțeleg vor învăța ceva nou.
Primul și cel mai simplu exemplu, care din păcate se întâlnește frecvent, este un număr mare de inserții cu loturi mici, adică un număr mare de inserții mici.
Dacă ne uităm la modul în care ClickHouse efectuează inserțiile, puteți trimite un flux de date de până la un terabyte cu o singură cerere. Asta nu este o problemă.
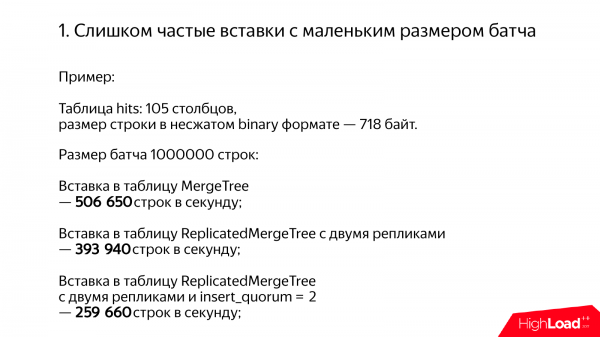
Să vedem care ar fi o performanță tipică. De exemplu, avem o masă cu date de la Yandex.Metrica. Afișări. 105 coloane de orice fel. 700 de bytes în formă necomprimată. Și vom insera, în mod corespunzător, loturi de câte un milion de rânduri.
Inserăm în tabela MergeTree, rezultând jumătate de milion de rânduri pe secundă. Excelent. În tabela replicată – va fi puțin mai puțin, aproximativ 400.000 de rânduri pe secundă.
Dacă activăm inserția cu cvorum, vom obține puțin mai puțin, dar totuși o performanță decentă, 250.000 de rânduri pe secundă. Inserția cu cvorum – este o funcționalitate nedocumentată în ClickHouse*.
* la data de 2020, .
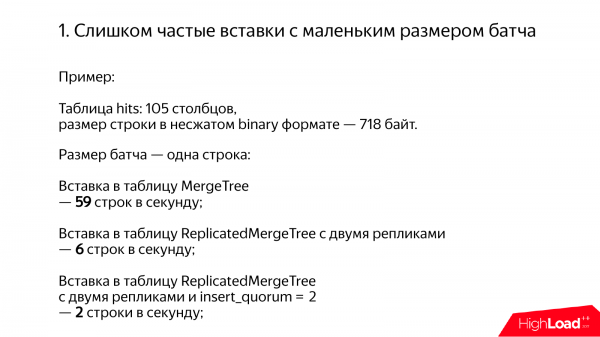
Ce se întâmplă dacă facem lucruri prost? Introducem câte un rând în tabelul MergeTree și obținem 59 de rânduri pe secundă. Asta e de 10.000 de ori mai lent. În ReplicatedMergeTree – 6 rânduri pe secundă. Și dacă se adaugă un cvorum, atunci obținem 2 rânduri pe secundă. Părerea mea este că asta e o adevărată prostie. Cum poți să te miști atât de lent? Chiar și pe tricoul meu scrie că ClickHouse nu ar trebui să fie lent. Dar, totuși, se mai întâmplă uneori.
De fapt – acesta este defectul nostru. Am fi putut foarte bine să facem astfel încât totul să funcționeze normal, dar nu am făcut. Și nu am făcut acest lucru pentru că pentru scenariul nostru – nu era necesar. Aveam deja batch-uri. Pur și simplu primeam batch-uri, și nu erau probleme. Introducem și totul funcționează bine. Dar, desigur, pot apărea tot felul de scenarii. De exemplu, când ai o mulțime de servere pe care datele sunt generate. Și acestea introduc date nu atât de des, dar totuși obții inserții frecvente. Și trebuie să eviți asta cumva.
Din punct de vedere tehnic, esența este că atunci când faci un insert în ClickHouse, datele nu intră în niciun memtable. Noi chiar nu avem un MergeTree cu structură de log, ci doar un MergeTree, pentru că nu există niciun log, niciun memTable. Pur și simplu scriem datele direct în sistemul de fișiere, deja organizate pe coloane. Și dacă ai 100 de coloane, atunci va trebui să scrii mai mult de 200 de fișiere într-un director separat. Toate acestea sunt destul de voluminoase.
Și apare întrebarea: „Cum se face corect?”, în cazul în care este o astfel de situație, că trebuie totuși să înregistrezi datele în ClickHouse.
Metoda 1. Aceasta este cea mai simplă metodă. Folosește o coadă distribuită. De exemplu, Kafka. Pur și simplu scoți datele din Kafka, le grupezi la fiecare secundă. Și totul va fi bine, înregistrezi, totul funcționează bine.
Dezavantajele sunt că Kafka este încă un alt sistem distribuit voluminos. Înțeleg dacă în compania ta există deja Kafka. Este bine, este convenabil. Dar dacă nu există, atunci merită să te gândești de trei ori înainte de a aduce un alt sistem distribuit în proiectul tău. Așadar, ar trebui să consideri alternative.
Metoda 2. Este o alternativă old-school, dar foarte simplă. Aveți un server care generează jurnalele dvs. și le scrie într-un fișier. O dată pe secundă, de exemplu, redenumiți acest fișier, deschideți unul nou. Și un script separat, fie prin cron, fie un daemon, preia cel mai vechi fișier și îl scrie în ClickHouse. Dacă înregistrați jurnalele o dată pe secundă, totul va fi perfect.
Dar dezavantajul acestei metode este că, dacă serverul de pe care sunt generate jurnalele dispare, și datele vor dispărea.
Metoda 3. Există o altă metodă interesantă, care nu folosește fișiere temporare. De exemplu, aveți un agent de publicitate sau un alt daemon interesant care generează date. Puteți acumula un pachet de date direct în RAM, în buffer. Și după ce a trecut o perioadă suficientă de timp, puneți acest buffer deoparte, creați unul nou, iar într-un fir separat, ceea ce a fost deja acumulat, îl inserați în ClickHouse.
Pe de altă parte, datele se pierd și în caz de kill -9. Dacă serverul dvs. cade, veți pierde aceste date. Și există o altă problemă, că dacă nu ați reușit să scrieți în bază, datele se vor acumula în RAM. Și fie se va termina RAM-ul, fie veți pierde pur și simplu datele.
Metoda 4. O altă metodă interesantă. Aveți un proces server care poate trimite date către ClickHouse imediat, dar făcând asta într-o singură conexiune. De exemplu, a trimis o cerere http cu transfer-encoding: chunked cu un insert. Și generează fragmente nu foarte rar, se poate trimite fiecare linie, deși va exista un overhead pe cadrul acestor date.
Dar, cu toate acestea, în acest caz, datele vor fi trimise imediat în ClickHouse. Și ClickHouse le va bufferiza singur.
Dar apar și probleme. Acum veți pierde date, inclusiv atunci când procesul dvs. se oprește și, dacă procesul ClickHouse se oprește, pentru că va fi un insert neterminat. În ClickHouse, inserțiile sunt atomice până la un anumit prag specificat în numărul de linii. În principiu, aceasta este o metodă interesantă. Poate fi utilizată și ea.
Metoda 5. Iată încă o metodă interesantă. Este un server dezvoltat de comunitate pentru procesarea batch a datelor. Eu nu l-am verificat, așa că nu pot garanta nimic. Totuși, nici pentru ClickHouse nu se oferă garanții. Este, de asemenea, open source, dar pe de altă parte, s-ar putea să te fi obișnuit cu un anumit standard de calitate pe care încercăm să-l asigurăm. Dar pentru această soluție – nu știu, intră pe GitHub, verifică codul. Poate au scris ceva rezonabil.
* la data de 2020, ar trebui să adăugăm la considerare .
Metoda 6. O altă metodă este utilizarea tabelelor Buffer. Avantajele acestei metode sunt că este foarte simplu să începi să o folosești. Creezi o tabelă Buffer și inserezi în ea.
Dezavantajul este că problema nu este rezolvată complet. Dacă la inserția de tip MergeTree trebuie să grupezi datele la un lot pe secundă, atunci la inserția în tabela buffer, trebuie să grupezi cel puțin câteva mii pe secundă. Dacă vor fi mai mult de 10 000 pe secundă, va fi tot rău. Și dacă inserezi în loturi, ai văzut că acolo obții sute de mii de rânduri pe secundă. Iar asta se întâmplă deja pe date destul de grele.
De asemenea, tabelele buffer nu au jurnal. Și dacă ceva nu merge bine cu serverul tău, datele vor fi pierdute.
Și ca un bonus, recent a apărut în ClickHouse posibilitatea de a prelua date din Kafka. Există un motor de tabele – Kafka. Pur și simplu creezi. Și poți să atașezi vizualizări materializate. În acest caz, el va extrage automat datele din Kafka și le va insera în tabelele de care ai nevoie.
Și ceea ce este deosebit de încântător la această posibilitate este că nu noi am dezvoltat-o. Este o funcție a comunității. Și când spun „funcție a comunității”, spun fără niciun fel de dispreț. Am citit codul, am făcut recenzia, ar trebui să funcționeze bine.
* la data de 2020, a apărut un suport similar pentru .
Ce altceva poate fi inconvenient sau neașteptat la inserția de date? Dacă faci o cerere insert values și în values scrii expresii calculabile. De exemplu, now() – aceasta este o expresie calculabilă. În acest caz, ClickHouse este nevoit să lanseze interpretatorul pentru fiecare rând, iar performanța va scădea drastic. Ar fi mai bine să eviți asta.
* în prezent, problema a fost complet rezolvată, regresiile de performanță la utilizarea expresiilor în VALUES nu mai există.
Un alt exemplu de probleme poate apărea atunci când, într-un singur lot, datele se referă la mai multe partiții. În mod default, în ClickHouse, partițiile sunt pe luni. Dacă inserați un lot de un milion de rânduri și datele sunt pe parcursul mai multor ani, atunci veți avea zeci de partiții. Este echivalent cu a avea loturi de dimensiuni de câteva zeci de ori mai mici, deoarece acestea sunt întotdeauna împărțite mai întâi pe partiții.
* recent, în ClickHouse, a fost adăugată în modul experimental suportul pentru un format compact de bucăți și bucăți în memorie cu write-ahead log, ceea ce rezolvă aproape complet problema.
Acum să analizăm al doilea tip de problemă – acest lucru se referă la tipizarea datelor.
Tipizarea datelor poate fi strictă sau bazată pe string. Tipul string este când ați declarat că toate câmpurile sunt de tip string. Asta este inacceptabil. Nu trebuie să procedați astfel.
Hai să vedem cum să facem corect în cazurile în care vrem să spunem că un anumit câmp este un string și lăsăm ClickHouse să se descurce, fără să ne stresăm. Totuși, merită să depunem ceva efort.
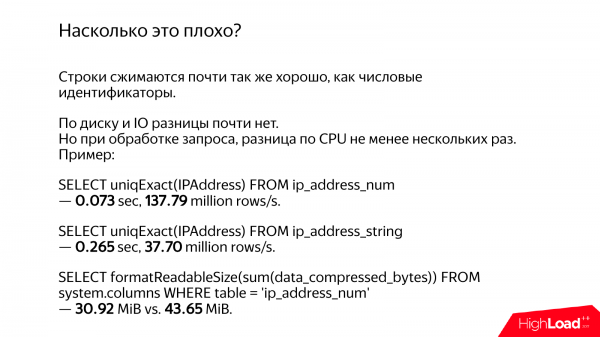
De exemplu, avem o adresă IP. Într-un caz, am păstrat-o ca string. De exemplu, 192.168.1.1. În alt caz, va fi un număr de tip UInt32*. 32 de biți sunt suficienți pentru o adresă IPv4.
În primul rând, ciudat cum poate părea, datele se vor comprima aproximativ la fel. Vor exista, desigur, diferențe, dar nu sunt atât de mari. Așadar, nu există probleme semnificative în ceea ce privește input-ul/output-ul pe disc.
Dar există o diferență semnificativă în ceea ce privește timpul de procesor și timpul de executare a interogării.
Să calculăm numărul de adrese IP unice, dacă sunt stocate sub formă de numere. Rezultatul este de 137 de milioane de rânduri pe secundă. Dacă facem aceeași interogare sub formă de stringuri, obtinem 37 de milioane de rânduri pe secundă. Nu știu de ce s-a întâmplat o astfel de coincidență. Eu însumi am efectuat aceste interogări. Totuși, este aproximativ de 4 ori mai lent.
Dacă calculăm diferența în ceea ce privește spațiul pe disc, există de asemenea o diferență. Și aceasta este de aproximativ un sfert, deoarece există multe adrese IP unice. Dacă ar fi fost rânduri cu un număr mic de valori diferite, acestea s-ar fi comprimat relativ la același volum.
Și o diferență de patru ori în timp pe drum nu este de ignorat. Poate că pentru tine nu contează, dar atunci când văd o astfel de diferență, mă întristează.
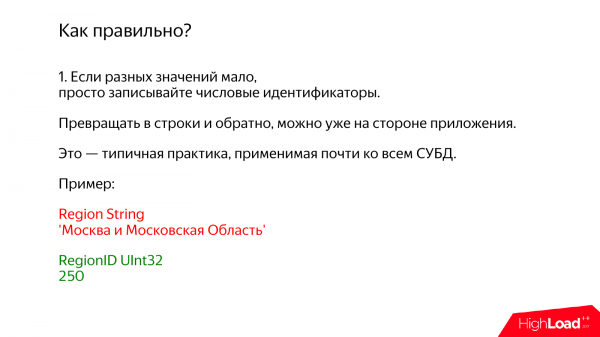
Să analizăm diferite cazuri.
1. Un caz este atunci când aveți puține valori unice. În acest caz, folosim o practică simplă pe care probabil o cunoașteți și o puteți aplica în orice sistem de gestionare a bazelor de date. Acest lucru are sens nu doar pentru ClickHouse. Pur și simplu introduceți identificatori numerici în bază. Conversia în șiruri și invers se poate face la nivelul aplicației dumneavoastră.
De exemplu, aveți o regiune. Și încercați să o salvați ca un șir. Acolo va fi scris: Moscova și MO. Și când văd că este scris „Moscova”, nu e nimic, dar când vine vorba și de MO, devine oarecum trist. Ce mulți biți trebuie să aibă.
În loc de aceasta, pur și simplu scriem numărul Ulnt32 și 250. Avem 250 în Yandex, iar la voi ar putea fi diferit. Pentru că, în ClickHouse, există o funcționalitate încorporată pentru gestionarea bazei de date geografice. Pur și simplu scrieți un dicționar cu regiunile, inclusiv ierarhic, adică va fi atât Moscova, cât și MO, și tot ce aveți nevoie. Și se poate realiza conversia la nivel de interogare.
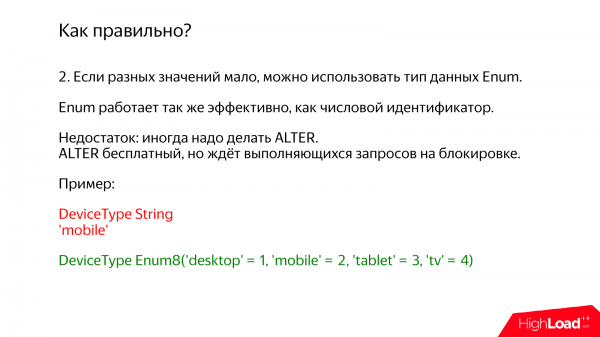
A doua opțiune este similară, dar cu suport în interiorul ClickHouse. Acesta este tipul de date Enum. Pur și simplu în Enum specificați toate valorile necesare. De exemplu, tipul de dispozitiv și scrieți: desktop, mobil, tabletă, televizor. În total, 4 variante.
Dezavantajul este că trebuie să faceți periodic modificări. Ați adăugat doar o variantă. Facem alter table. În realitate, alter table în ClickHouse este gratuit. Mai ales pentru Enum, deoarece datele de pe disc nu se schimbă. Totuși, o modificare captează blocarea* pe tabel și trebuie să aștepte până se finalizează toate selects-urile. Și abia apoi alter va fi efectuat, adică totuși anumite neplăceri există.
* în versiunile recente ale ClickHouse, ALTER a fost realizat complet fără blocare.
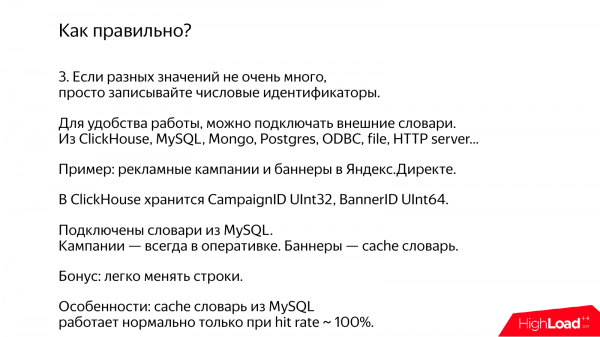
O altă opțiune destul de unică pentru ClickHouse este conectarea dicționarelor externe. Puteți introduce numere în ClickHouse, iar dicționarele să le păstrați în orice sistem convenabil. De exemplu, puteți folosi: MySQL, Mongo, Postgres. Puteți chiar să construiți un microserviciu care va returna aceste date prin http. Și la nivelul ClickHouse scrieți o funcție care va transforma aceste date din numere în șiruri.
Aceasta este o metodă specializată, dar foarte eficientă de a efectua un join cu o tabelă externă. Există două variante. Într-o variantă, aceste date vor fi complet cache-uite, vor fi complet prezente în memorie și se vor actualiza periodic. În cealaltă variantă, dacă aceste date nu încap în memorie, atunci le putem cache-ui parțial.
Iată un exemplu. Există Yandex.Direct. Și acolo există o campanie publicitară și bannere. Numărul campaniilor publicitare este probabil de ordinul zecilor de milioane. Și se pot încadra în memorie. Iar bannerele – miliarde, nu încap. Și folosim un dicționar cache-uit din MySQL.
Singura problemă este că dicționarul cache-uit va funcționa corect dacă rata de hit-uri este aproape de 100 %. Dacă este mai mică, atunci la procesarea cererilor pentru fiecare lot de date va trebui să luăm efectiv cheile lipsă și să aducem datele din MySQL. În ceea ce privește ClickHouse, pot garanta că nu întâmpină întârzieri, dar nu voi comenta despre alte sisteme.
Ca bonus, dicționarele sunt o modalitate foarte simplă de a actualiza datele în ClickHouse retroactiv. Adică, dacă ați avut un raport pe campanii publicitare, utilizatorul a schimbat pur și simplu campania publicitară, iar în toate datele vechi, în toate rapoartele, aceste date s-au schimbat și ele. Dacă ați scrie rânduri direct în tabelă, actualizarea lor ar fi imposibilă.
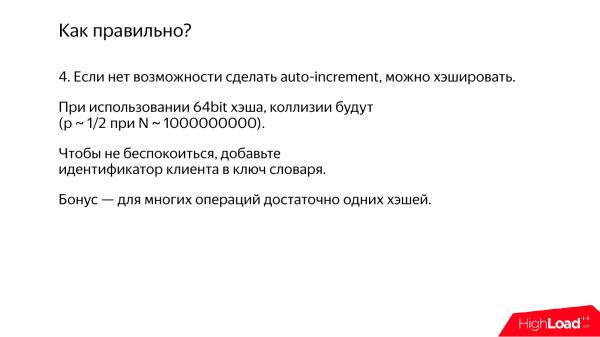
O altă metodă, atunci când nu știți de unde să obțineți identificatorii pentru rândurile dvs., este să faceți pur și simplu un hash. Cea mai simplă variantă este să luați un hash de 64 de biți.
Singura problemă este că, dacă hash-ul este de 64 de biți, coliziunile vor apărea aproape cu siguranță. Deoarece, dacă aveți un miliard de rânduri, probabilitatea devine semnificativă.
Și nu ar fi foarte bine să hash-uiți numele campaniilor publicitare astfel. Dacă campaniile publicitare ale diferitelor companii se împărtășesc, atunci va apărea ceva neclar.
Și există un truc simplu. Adevărul este că pentru datele serioase nu se potrivește foarte bine, dar dacă este ceva care nu este foarte serios, atunci pur și simplu adăugați un identificator al clientului în cheia dicționarului. Astfel, veți avea coliziunile, dar numai în cadrul unui singur client. Această metodă este utilizată pentru harta linkurilor în Yandex.Metrica. Avem acolo URL-uri, stocăm hash-uri. Știm că, desigur, coliziunile există. Dar atunci când se afișează pagina, probabilitatea ca pe o singură pagină, pentru un singur utilizator, să existe anumite URL-uri care se suprapun și să fie observate este atât de scăzută încât se poate neglija.
Ca bonus – pentru multe operații, doar hash-urile sunt suficiente și nu este nevoie să stocați șirurile în vreun loc.
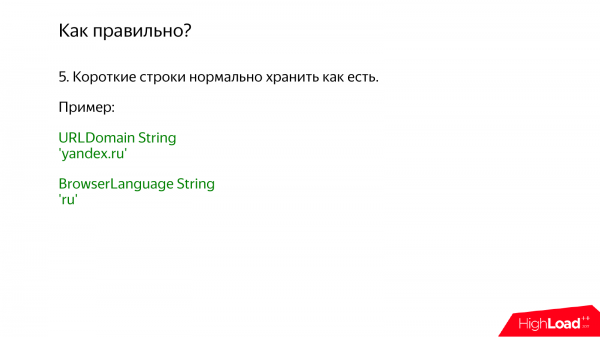
Un alt exemplu, dacă șirurile sunt scurte, cum ar fi domeniile site-urilor. Le puteți stoca așa cum sunt. Sau, de exemplu, limba browser-ului ru – 2 bytes. Mi-e sincer, foarte milă de bytes, dar nu vă faceți griji, 2 bytes nu afectează. Vă rog, stocați așa cum sunt, nu vă stresați.
O altă situație este când există foarte multe șiruri și acestea conțin extrem de multe unice, iar numărul lor poate fi potențial nelimitat. Un exemplu tipic sunt expresiile de căutare sau URL-urile. Expresiile de căutare, inclusiv din cauza greșelilor de tipar. Să vedem câte expresii de căutare unice sunt într-o zi. Și se dovedește că aproape jumătate din toate evenimentele sunt acestea. Și în acest caz, s-ar putea să te gândești că ar trebui să normalizezi datele, să numeri identificatorii, să le pui într-un tabel separat. Dar nu trebuie să faci asta. Pur și simplu stochează aceste șiruri așa cum sunt.
Cel mai bine – nu inventa nimic, pentru că dacă le stochezi separat, va fi necesar să faci un join. Iar acest join – în cel mai bun caz, va necesita acces aleator în memorie, dacă mai încape în memorie. Dacă nu încape, vor fi probleme.
Dacă datele sunt stocate în in place, atunci ele sunt pur și simplu citite în ordinea necesară din sistemul de fișiere și totul este în regulă.
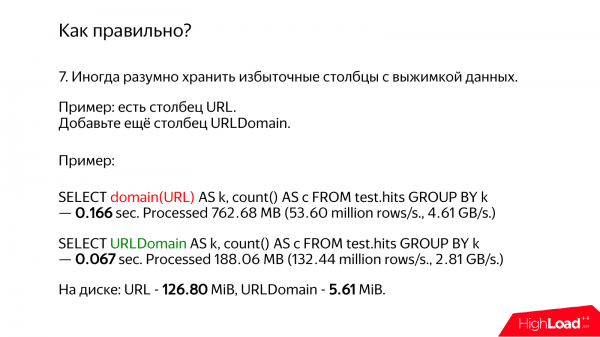
Dacă aveți URL-uri sau orice alt șir lung sau complex, trebuie să vă gândiți că ar putea fi calculată o reducere anticipată și înregistrată într-o coloană separată.
Pentru URL-uri, de exemplu, puteți stoca separat domeniul. Și dacă aveți cu adevărat nevoie de domeniu, folosiți pur și simplu această coloană, iar URL-urile vor rămâne acolo și nu le veți atinge niciodată.
Hai să vedem care este diferența. În ClickHouse există o funcție specializată care calculează domeniul. Este foarte rapidă, am optimizat-o. Și, ca să fiu sincer, nu respectă RFC, dar totuși calculează tot ce ne trebuie.
Într-un caz, vom extrage pur și simplu URL-urile și vom calcula domeniul. Asta durează 166 de milisecunde. Dacă luăm un domeniu deja pregătit, durează doar 67 de milisecunde, adică aproape de trei ori mai repede. De fapt, mai repede nu pentru că ar trebui să facem niște calcule, ci pentru că citim mai puține date.
Dintr-un motiv oarecare, unii interogări, care sunt mai lente, au o viteză mai mare în gigabiți pe secundă. Pentru că citesc mai mulți gigabiți. Acestea sunt date complet inutile. Interogarea pare să funcționeze mai repede, dar durează mai mult timp.
Dacă ne uităm la volumul de date pe disc, URL-ul are 126 de megabaiți, iar domeniul doar 5 megabaiți. Asta înseamnă de 25 de ori mai puțin. Cu toate acestea, interogarea se execută de doar 4 ori mai repede. Dar asta se datorează faptului că datele sunt fierbinți. Dacă ar fi fost reci, ar fi fost cu siguranță de 25 de ori mai repede din cauza intrării/ieșirii de pe disc.
Apropo, dacă evaluăm cât de mult mai mic este domeniul comparativ cu URL-ul, rezultă că este de aproximativ 4 ori mai mic. Dar dintr-un motiv oarecare, pe disc datele ocupă de 25 de ori mai puțin. De ce? Din cauza compresiei. Atât URL-urile, cât și domeniile sunt comprimate. Dar adesea URL-urile conțin o mulțime de gunoi.
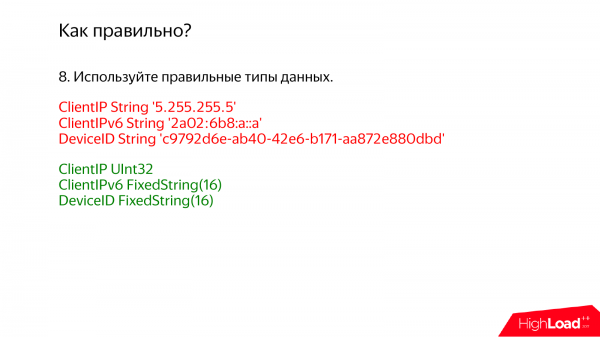
Și, desigur, ar trebui să folosiți tipurile de date corecte, care sunt special concepute pentru valorile necesare sau care se potrivesc. Dacă aveți IPv4, păstrați-l ca UInt32*. Dacă este IPv6, utilizați FixedString(16), pentru că adresa IPv6 are 128 de biți, adică păstrați-o direct în format binar.
Ce să faceți dacă aveți uneori adrese IPv4 și alteori IPv6? Da, puteți stoca ambele. O coloană pentru IPv4, alta pentru IPv6. Desigur, există opțiunea de a mapă IPv4 în IPv6. Aceasta va funcționa de asemenea, dar dacă aveți nevoie adesea de adresa IPv4 în interogări, ar fi bine să o puneți într-o coloană separată.
* Acum, în ClickHouse există tipuri de date separate pentru IPv4 și IPv6, care stochează datele la fel de eficient ca numerele, dar le prezintă la fel de comod ca și șiruri.
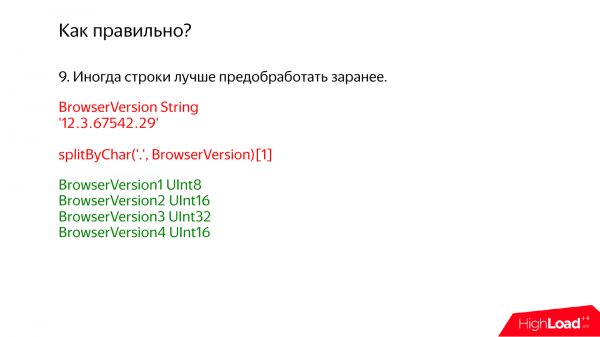
De asemenea, este important să observați că datele ar trebui preprocesate în avans. De exemplu, dacă primiți unele jurnale brute. Și poate că nu ar trebui să le introduceți imediat în ClickHouse, deși este foarte tentant să nu faceți nimic și să funcționeze totul. Totuși, este mai bine să efectuați acele calcule posibile.
De exemplu, versiunea browserului. Într-un alt departament din vecinătate, pe care nu vreau să-l indic cu degetul, versiunea browserului este păstrată astfel, adică ca un șir: 12.3. Apoi, pentru a genera un raport, ei iau acest șir și îl împart la un array, iar apoi la primul element al array-ului. Evident, totul se blochează. Am întrebat de ce fac asta. Ei mi-au răspuns că nu le place optimizarea prematură. Eu nu iubesc, în schimb, pesimismul prematur.
Așadar, în acest caz, ar fi mai corect să împărțiți în 4 coloane. Nu vă temeți, deoarece acesta este ClickHouse. ClickHouse este o bază de date pe coloane. Și cu cât aveți mai multe coloane mici și îngrijite, cu atât mai bine. Dacă va fi 5 BrowserVersion, creați 5 coloane. Este normal.
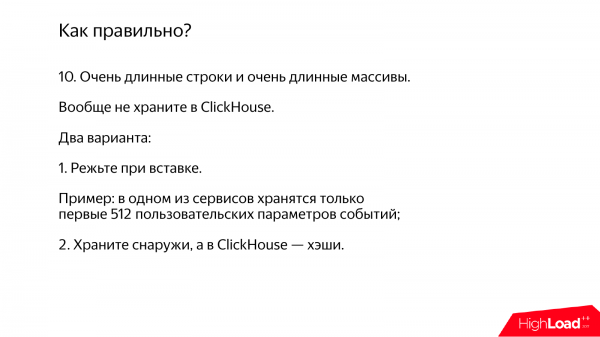
Acum să luăm în considerare ce să faceți dacă aveți multe șiruri foarte lungi, foarte multe array-uri lungi. Nu ar trebui să le păstrați în ClickHouse deloc. În locul acesta, puteți să salvați în ClickHouse doar un identificator. Iar aceste șiruri lungi să le mutați în vreun alt sistem.
De exemplu, într-unul dintre serviciile noastre analitice, există anumite parametrii ai evenimentelor. Și dacă la evenimente vin mulți parametri, pur și simplu păstrăm primele 512 întâlnite. Pentru că 512 nu este mult.
Și dacă nu vă puteți decide asupra tipurilor de date, atunci puteți de asemenea scrie datele în ClickHouse, dar într-o tabelă temporară, de tip Log, special pentru date temporare. După aceea, puteți analiza ce distribuție a valorilor aveți acolo, ce există de fapt și să compuneți tipurile corecte.
* acum în ClickHouse există un tip de date care permite stocarea eficientă a șirurilor cu un consum mai mic de resurse.
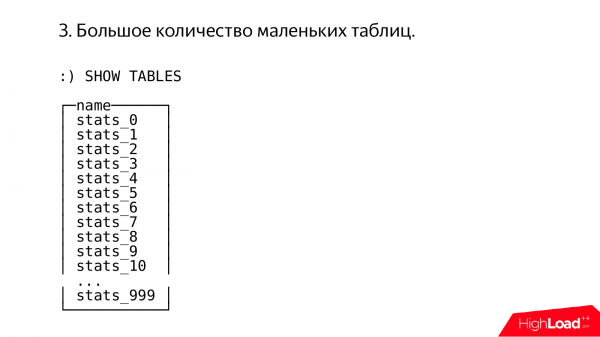
Acum să luăm în considerare un alt caz interesant. Uneori, lucrurile funcționează ciudat pentru oameni. Intru și văd așa ceva. Și imediat îmi imaginez că acest lucru a fost făcut de un administrator foarte experimentat și inteligent, care are multă experiență în configurarea MySQL versiunea 3.23.
Aici vedem o mie de tabele, fiecare dintre ele având scris restul unei împărțiri neclare la o mie.
În principiu, respect experiența altora, inclusiv înțeleg cu ce suferințe a fost obținută această experiență.
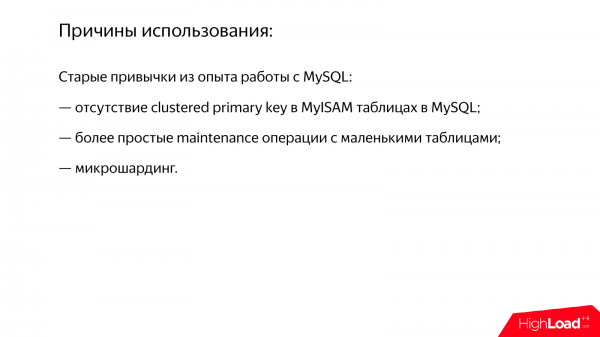
Iar motivele sunt mai mult sau mai puțin clare. Acestea sunt stereotipuri vechi care s-au acumulat în urma lucrului cu alte sisteme. De exemplu, în tabelele MyISAM nu există cheie primară clusterizată. Iar această metodă de separare a datelor poate fi o încercare disperată de a obține aceeași funcționalitate.
O altă cauză este că operații de tip alter pe tabele mari sunt greu de realizat. Totul va fi blocat. Cu toate acestea, în versiunile moderne ale MySQL, această problemă nu mai este atât de gravă.
Sau, de exemplu, micro-sharding, dar despre asta puțin mai târziu.
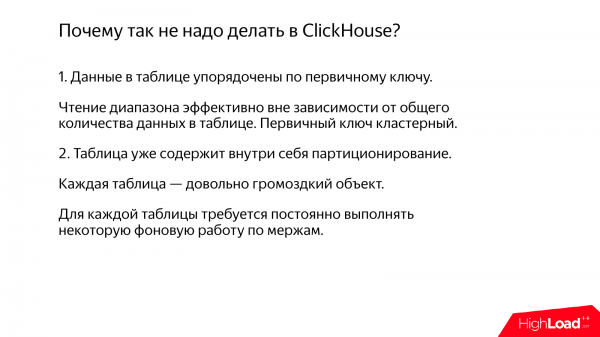
În ClickHouse nu este necesar să procedați astfel, deoarece, pe de o parte, cheia primară este clusterizată, iar datele sunt ordonate după cheia primară.
Și uneori mă întreabă: „Cum se modifică performanța interogărilor pe interval în ClickHouse în funcție de dimensiunea tabelului?”. Eu spun că nu se modifică. De exemplu, aveți un tabel cu un miliard de rânduri și citiți un interval de un milion de rânduri. Totul este în regulă. Dacă tabelul are un trilion de rânduri și citiți un milion de rânduri, atunci va fi aproape la fel.
Și, pe de altă parte, nu sunt necesare lucruri precum partiții manuale. Dacă intrați și verificați ce se întâmplă în sistemul de fișiere, veți observa că tabelul este o entitate destul de serioasă. Și acolo în interior există ceva asemănător partitiilor. Adică, ClickHouse face totul pentru dumneavoastră și nu trebuie să suferiți.
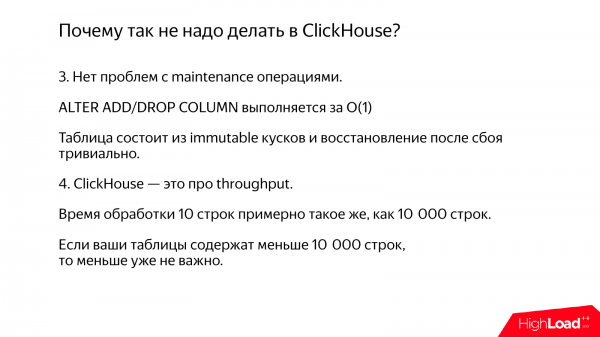
Alter în ClickHouse este gratuit, dacă se face add/drop column.
Și nu este bine să aveți tabele mici, pentru că dacă aveți 10 rânduri sau 10.000 de rânduri în tabel, acest lucru nu contează deloc. ClickHouse este un sistem care optimizează throughput-ul, nu latența, astfel că procesarea a 10 rânduri nu are sens.
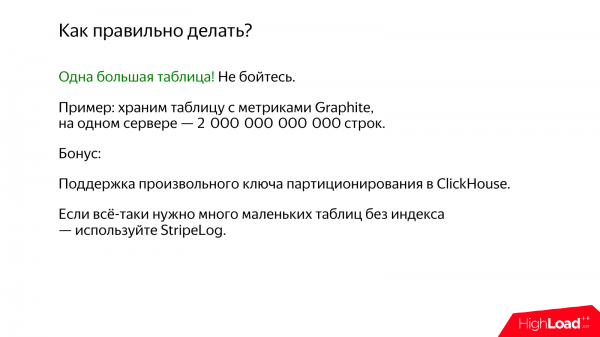
Este corect să folosiți un singur tabel mare. Scăpați de stereotipurile vechi, totul va fi bine.
Și ca bonus, în ultima versiune am introdus posibilitatea de a crea o cheie de partiționare arbitrară pentru a putea efectua diverse operații de întreținere asupra partițiilor individuale.
De exemplu, aveți nevoie de multe tabele mici, de exemplu, atunci când este necesar să procesați anumite date intermediare, primiți bucăți și trebuie să efectuați transformări asupra lor înainte de a le scrie în tabela finală. Pentru acest caz, există un motor excelent pentru tabele – StripeLog. Este cam ca TinyLog, doar că mai bun.
* Acum în ClickHouse există și .
O altă antipattern este microsharding. De exemplu, trebuie să shard-uiți datele și aveți 5 servere, iar mâine vor fi 6 servere. Și vă gândiți cum să reechilibrați aceste date. Și în loc să le împărțiți în 5 sharding-uri, le împărțiți în 1 000 sharding-uri. Apoi, fiecare dintre aceste microsharding-uri este mapat pe un server separat. Și, de exemplu, pe un singur server veți avea 200 ClickHouse, fiecare instanță pe porturi separate sau baze de date separate.
Dar în ClickHouse, acest lucru nu este foarte bine. Deoarece chiar și o singură instanță ClickHouse încearcă să utilizeze toate resursele disponibile ale serverului pentru a procesa o singură interogare. Adică, aveți un server care, de exemplu, dispune de 56 de nuclee de procesor. Rulați o interogare care durează o secundă și va utiliza cele 56 de nuclee. Iar dacă ați plasat 200 ClickHouse pe un singur server, atunci vor fi lansate 10 000 de fire. În concluzie, totul va decurge foarte prost.
O altă cauză este că distribuția muncii între aceste instanțe va fi inegală. Unele vor termina mai devreme, altele mai târziu. Dacă totul ar avea loc într-o singură instanță, ClickHouse ar ști cum să distribuie corect datele între fire.
Și încă o cauză este că va exista interacțiune între procesoare prin TCP. Datele vor trebui să fie serializate, deserializate și acest număr mare de microsharding-uri este pur și simplu ineficient.
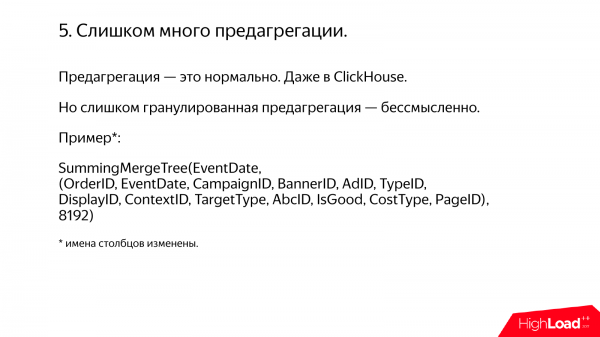
O altă antipattern, deși este greu de numit așa. Este un număr mare de pre-agregare.
În general, pre-agregarea este o idee bună. Ați avut un miliard de rânduri, le-ați agregat și au devenit 1 000 de rânduri, iar acum interogarea se execută instantaneu. Totul este minunat. Așa se poate face. Și pentru asta, chiar și în ClickHouse există un tip special de tabel AggregatingMergeTree, care face agregare incrementală pe măsură ce datele sunt inserate.
Dar există cazuri în care credeți că vom agrega datele astfel și încă astfel. Și într-un departament vecin, nu vreau să spun care, folosesc tabelele SummingMergeTree pentru a suma după cheia primară, iar ca cheie primară utilizează vreo 20 de coloane. Am schimbat numele unor coloane pentru a păstra confidențialitatea, dar cam așa este.
Și apar astfel de probleme. În primul rând, volumul de date nu se reduce prea mult. De exemplu, se reduce de trei ori. De trei ori – ar fi fost un preț bun pentru a avea posibilități nelimitate pentru analiză, care apar atunci când datele nu sunt agregate. Dacă datele sunt agregate, atunci în loc de analiză obțineți doar o statistică lamentabilă.
Și ce deranjează în special? Că acești oameni din departamentul vecin vin și cer uneori să adauge încă o coloană în cheia primară. Adică, am agregat datele astfel, iar acum vrem puțin mai mult. Dar în ClickHouse nu există alterare a cheii primare. Așa că trebuie să scriem diverse scripturi în C++. Și nu îmi plac scripturile, nici măcar cele în C++.
Și dacă ne uităm pentru ce a fost creat ClickHouse, datele neagregate sunt exact scenariul pentru care a fost conceput. Dacă folosiți ClickHouse pentru date neagregate, faceți totul corect. Dacă agregați, atunci este uneori iertabil.
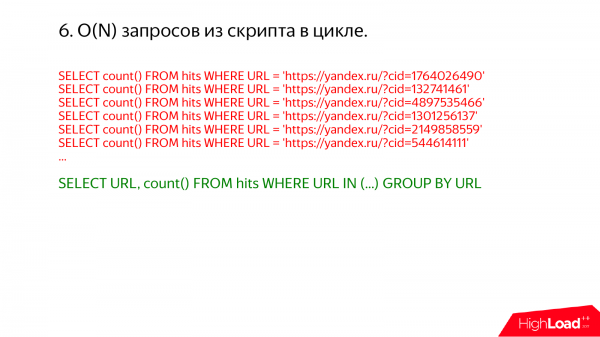
O altă situație interesantă este cererile într-un ciclu infinit. Uneori intru pe un server de producție și mă uit la show processlist. Și de fiecare dată descopăr că se întâmplă ceva teribil.
De exemplu, așa. Aici este clar că totul putea fi executat într-o singură cerere. Pur și simplu scrieți acolo url in și lista.
De ce sunt atât de multe cereri într-un ciclu infinit – este rău? Dacă indexul nu este folosit, veți avea multe treceri prin aceleași date. Dar dacă indexul este folosit, de exemplu, aveți o cheie primară pe ru și scrieți url = ceva anume. Și credeți că va fi citit din tabel un singur url, va fi totul în regulă. Dar de fapt nu este așa. Pentru că ClickHouse face totul pe grupuri.
Când trebuie să citească un anumit interval de date, citește puțin mai mult, deoarece indexul în ClickHouse este sparse. Acest index nu permite găsirea unei singure linii în tabel, ci doar a unui anumit interval. Iar datele sunt comprimate pe blocuri. Pentru a citi o linie, trebuie să iei întregul bloc și să-l decomprimi. Și dacă faceți o mulțime de interogări, veți avea multe suprapuneri și o mulțime de muncă va fi efectuată din nou și din nou.
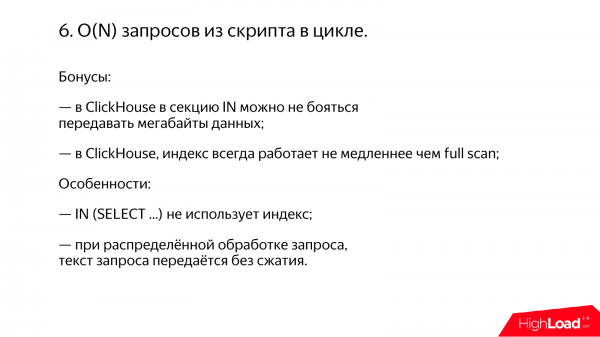
Și ca bonus, se poate observa că în ClickHouse nu trebuie să vă fie frică să transmiteți chiar și megabyte și sute de megabyte în secțiunea IN. Îmi amintesc din practica noastră că, dacă în MySQL transmitem o mulțime de valori în secțiunea IN, de exemplu, 100 de megabytes de numere, MySQL consumă 10 gigabytes de memorie și nimic mai mult nu se întâmplă, totul funcționează prost.
Iar al doilea aspect este că, în ClickHouse, dacă interogările dvs. folosesc indexul, atunci aceasta nu este niciodată mai lent decât o scanare completă, adică, dacă trebuie să citiți aproape întregul tabel, acesta va merge secvențial și va citi întregul tabel. În general, se va descurca singur.
Dar totuși există unele dificultăți. De exemplu, faptul că IN cu subinterogarea nu folosește indexul. Dar aceasta este problema noastră și trebuie să o corectăm. Nu este nimic fundamental aici. O să reparăm.
Iar o altă chestiune interesantă este că, dacă aveți o interogare foarte lungă și procesarea distribuită a interogărilor are loc, atunci această interogare foarte lungă va fi trimisă pe fiecare server fără compresie. De exemplu, 100 de megabytes și 500 de servere. Și, în consecință, 50 de gigabytes vor fi transmise prin rețea. Va fi transmis și apoi totul se va finaliza cu succes.
* deja folosește; totul a fost reparat, așa cum am promis.
Și este un caz destul de frecvent ca interogările să vină din API. De exemplu, ați creat un serviciu propriu. Și dacă serviciul dvs. este necesar cuiva, ați deschis API-ul și, aproape imediat, după două zile vedeți că se întâmplă ceva neclar. Totul este supraîncărcat și vin unele interogări teribile care nu ar fi trebuit să existe niciodată.
Și soluția aici este una. Dacă ați deschis API-ul, va trebui să-l restricționați. De exemplu, să introduceți niște cote. Nu există alte opțiuni normale. Altfel, imediat vor scrie un script și vor apărea probleme.
Și ClickHouse are o capacitate specială – calcularea cotelor. De asemenea, poți transmite cheia ta de cotă. De exemplu, un identificator intern al utilizatorului. Și cotele vor fi calculate independent pentru fiecare dintre ele.
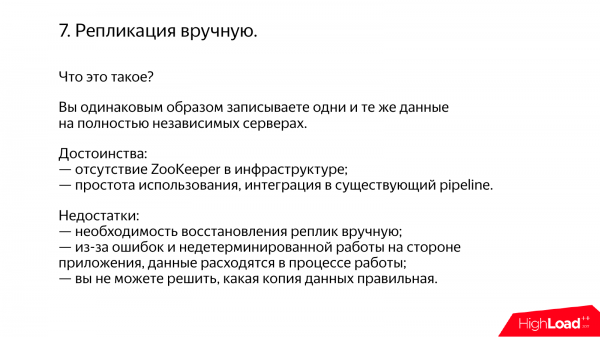
Acum, un alt lucru interesant. Este replicarea manuală.
Știu multe cazuri în care, deși ClickHouse are suport încorporat pentru replicare, oamenii replică ClickHouse manual.
Care este principiul? Ai un pipeline de procesare a datelor. Și funcționează independent, de exemplu, în centre de date diferite. Scrii aceleași date în același mod în ClickHouse. Totuși, practica arată că datele tot vor diverge din cauza anumitor particularități din codul tău. Sper că nu îi ai.
Și periodic va trebui să sincronizezi manual. De exemplu, o dată pe lună, administratorii fac rsync.
De fapt, este mult mai simplu să folosești replicarea încorporată în ClickHouse. Dar aici pot exista unele contraindicații, deoarece pentru asta trebuie să folosești ZooKeeper. Nu am nimic rău de spus despre ZooKeeper; în principiu, sistemul funcționează, dar uneori oamenii nu îl folosesc din cauza fobiei de Java, deoarece ClickHouse este un sistem bun, scris în C++, care poate fi utilizat și va funcționa excelent. Iar ZooKeeper este pe Java. Și cumva, nici nu vrei să te uiți, dar poți folosi replicarea manuală.
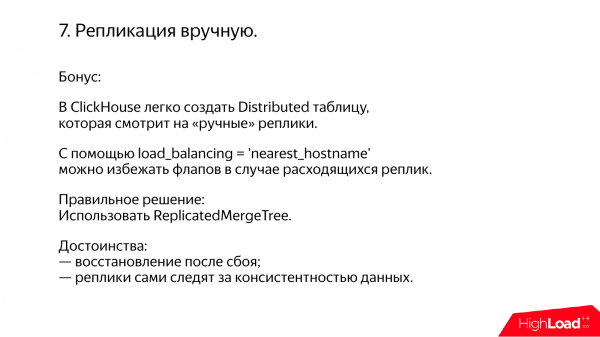
ClickHouse este un sistem practic. Ia în considerare nevoile tale. Dacă ai replicare manuală, poți crea o tabelă Distribuită care se uită la replicile tale manuale și face failover între ele. Există chiar și o opțiune specială care permite evitarea flapping-urilor, chiar dacă replicile tale deviază sistematic.
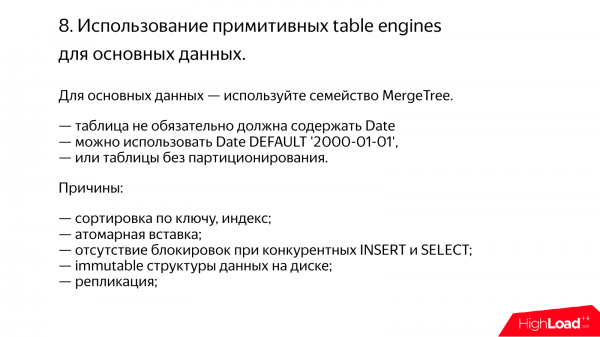
Apoi pot apărea probleme dacă folosești motoare de tabel primitive. ClickHouse este un constructor care are o mulțime de motoare de tabele diferite. Pentru toate cazurile serioase, așa cum este scris în documentație, folosește tabele din familia MergeTree. Iar celelalte sunt doar pentru cazuri specifice sau pentru teste.
În tabelul MergeTree nu este obligatoriu să ai o dată și o oră. Poți folosi oricum. Dacă nu ai dată și oră, scrie că default – 2000. Aceasta va funcționa și nu va necesita resurse.
În noua versiune a serverului, poți chiar să specifici că vrei o particionare personalizată fără o cheie de partiție. Va fi la fel.
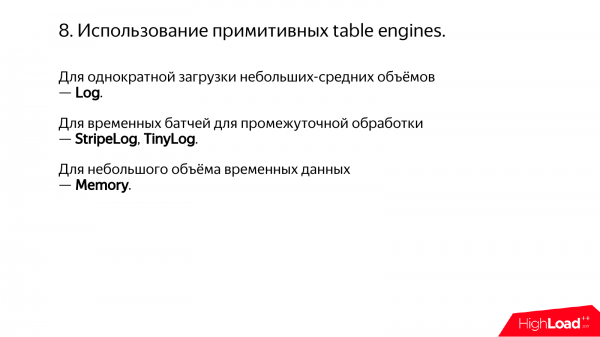
Pe de altă parte, poți folosi motoare de tabele primitiv. De exemplu, poți încărca datele o dată și apoi să le vizualizezi, să le manipulezi și să le ștergi. Poți folosi Log.
Sau stocarea unor cantități mici pentru procesare intermediară – este StripeLog sau TinyLog.
Memory poate fi utilizat dacă ai o cantitate mică de date și vrei doar să manipulezi ceva în RAM.
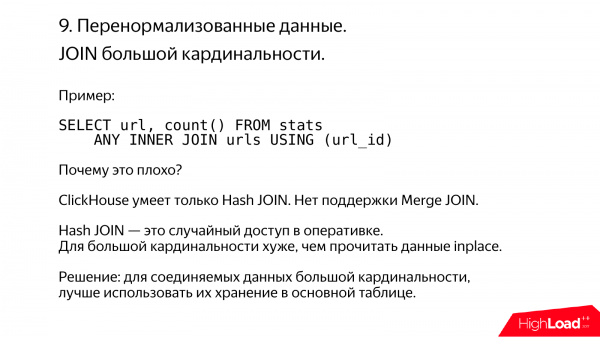
ClickHouse nu prea-i place datele supranormalizate.
Iată un exemplu tipic. Este un număr uriaș de URL-uri. Le-ai pus într-un tabel adiacent. Apoi ai decis să faci JOIN cu ele, dar nu va funcționa, de obicei, pentru că ClickHouse suportă doar Hash JOIN. Dacă nu ai suficientă RAM pentru cantitatea de date cu care trebuie să faci conexiuni, nu vei putea realiza JOIN-ul*.
Dacă datele au o cardinalitate mare, nu te stresa, stochează-le în formă denormalizată, URL-urile direct în tabelul principal.
* De acum, ClickHouse are și merge join, care funcționează în condiții când datele intermediare nu încap în RAM. Dar aceasta este ineficient și recomandarea rămâne valabilă.
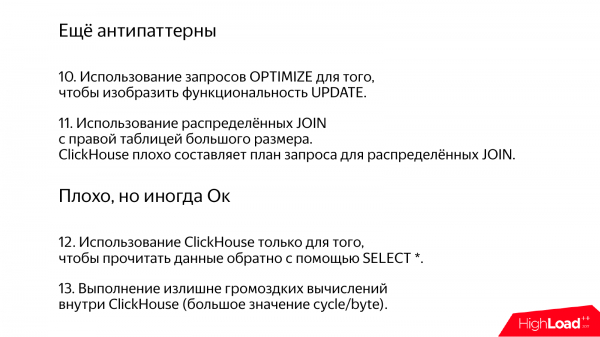
Încă câteva exemple, dar mă îndoiesc dacă sunt anti-modele sau nu.
În ClickHouse există un dezavantaj cunoscut. Nu suportă actualizări*. Într-un fel, acesta este un lucru bun. Dacă ai date importante, de exemplu, contabilitate, nimeni nu le poate modifica, deoarece nu există actualizări.
* suportul pentru update și delete în mod batch este deja disponibil de mult timp.
Dar există unele modalități speciale care permit actualizările să fie făcute ca și cum ar fi în fundal. De exemplu, tabelele de tip ReplaceMergeTree. Ele fac actualizări în timpul fuziunilor de fundal. Poți forța acest proces folosind optimize table. Dar nu face asta prea des, pentru că va fi o rescriere completă a partiției.
JOIN-urile distribuite în ClickHouse sunt, de asemenea, slab gestionate de planificatorul de interogări.
Slab, dar uneori acceptabil.
Folosirea ClickHouse numai pentru a citi datele înapoi cu ajutorul select*.
Nu aș recomanda utilizarea ClickHouse pentru calcule complexe. Totuși, lucrurile s-au schimbat puțin, deoarece ne îndepărtăm de această recomandare. Recent, am adăugat posibilitatea de a aplica modele de învățare automată în ClickHouse – Catboost. Acest lucru mă îngrijorează, pentru că mă gândesc: „Ce groaznic. Câte cicluri pe octet facem aici!”. Îmi pare foarte rău să risipesc cicluri pe octeți.
Dar nu vă temeți, instalați ClickHouse, totul va fi bine. Și dacă aveți probleme, aveți comunitatea noastră. Apropo, comunitatea sunteți voi. Dacă aveți vreo problemă, puteți să intrați în chatul nostru și, sper, să primiți ajutor.
Întrebări
Mulțumesc pentru prezentare! Unde pot face plângere pentru căderea ClickHouse?
Puteți să vă plângeți direct mie chiar acum.
Recent am început să folosesc ClickHouse. Imediat am căzut cli-ul.
Ați avut noroc.
Puțin mai târziu, am căzut serverul cu un select mic.
Aveți talent.
Am deschis un bug pe GitHub, dar a fost ignorat.
Să vedem.
Alexey m-a adus cu viclenie la prezentare, promițând că va vorbi despre cum înghesuiți datele.
Foarte simplu.
Asta am realizat încă de ieri. Mai multe detalii.
Nu sunt trucuri groaznice. Este pur și simplu o comprimare pe blocuri. Din default se folosește LZ4; se poate activa ZSTD*. Blocurile variază de la 64 de kilobyte la 1 megabyte.
* există suport pentru codecuri specializate de comprimare care pot fi utilizate în lanț cu alte algoritmi.
În blocuri sunt doar date brute?
Nu tocmai brute. Acolo sunt array-uri. Dacă aveți o coloană numerică, numerele sunt stocate într-un array unul după altul.
Înțeles.
Alexey, exemplul pe care l-ați avut cu uniqExact pe adrese IP, adică ceea ce ați spus că uniqExact pe șiruri se calculează mai lent decât pe numere etc. Și dacă aplicăm un truc și facem conversia în timpul citirii? Adică, ați spus că pe disc nu se deosebește prea mult. Dacă citim șirurile de pe disc, facem conversia, atunci agregatele noastre vor fi mai rapide sau nu? Sau totuși nu vom câștiga semnificativ aici? Mi se pare că ați testat asta, dar dintr-un motiv oarecare nu ați menționat în benchmark.
Cred că va fi mai lent decât fără cast. În acest caz, adresa IP trebuie să fie extrasă din șir. Desigur, în ClickHouse, parsarea adreselor IP este optimizată. Am încercat foarte mult, dar acolo aveți numerele scrise în forma zecimală. Foarte incomod. Pe de altă parte, funcția uniqExact va funcționa mai lent pe șiruri nu doar pentru că sunt șiruri, ci și pentru că se alege o altă specializare a algoritmului. Șirurile sunt procesate complet diferit.
Dar dacă luăm un tip de date mai primitiv? De exemplu, am scris user id-ul, care este în, l-am scris ca pe un șir și apoi l-am convertit, va fi mai distractiv sau nu?
Mă îndoiesc. Cred că va fi chiar mai trist, pentru că, totuși, parsarea numerelor este o problemă serioasă. Mi se pare că acest coleg a avut chiar o prezentare despre cât de greu este să parsem numere în forma zecimală, dar poate că nu.
Alexey, mulțumesc foarte mult pentru prezentare! Și, de asemenea, mulțumesc pentru ClickHouse! Am o întrebare legată de planuri. Există planuri pentru o funcționalitate de actualizare a dicționarelor parțial?
Adică, reîncărcare parțială?
Da-da. O posibilitate de a specifica acolo un câmp MySQL, adică de a actualiza după, pentru a încărca doar acele date, dacă dicționarul este foarte mare.
O caracteristică foarte interesantă. Și, mi se pare, cineva a propus-o în chat-ul nostru. Poate chiar ați fost dumneavoastră.
Nu cred că eu.
Excelent, acum se dovedește că sunt două cereri. Și putem începe cu calm. Dar vreau să vă avertizez imediat că această caracteristică este destul de simplă de implementat. Adică, în principiu, trebuie doar să scrieți un număr de versiune în tabel și apoi să scrieți: versiunea este mai mică decât asta. Și asta înseamnă că, cel mai probabil, vom propune să facem asta entuziaștilor. Sunteți entuziast?
Da, dar, din păcate, nu în C++.
Colegul vostru știe să scrie în C++?
O să găsesc pe cineva.
Excelent*.
* posibilitatea a fost adăugată la două luni după prezentare – a fost dezvoltată de autorul întrebării și trimisă. .
Mulțumesc!
Bună ziua! Vă mulțumesc pentru prezentare! Ați menționat că ClickHouse consumă foarte bine toate resursele disponibile. Iar prezentatorul de lângă Luxoft a vorbit despre soluția sa pentru Poșta Rusă. El a spus că le-a plăcut foarte mult ClickHouse, dar nu l-au folosit în locul principalului lor competitor tocmai pentru că consuma tot procesorul. Și nu au putut să-l integreze în arhitectura lor, în ZooKeeper-ul lor cu containere. Există vreo posibilitate de a limita somehow ClickHouse, astfel încât să nu consume tot ce îi devine disponibil?
Da, se poate și foarte ușor. Dacă doriți să consume mai puține nuclee, pur și simplu scrieți set max_threads = 1. Și gata, va executa cererea pe un singur nucleu. De altfel, puteți specifica utilizatori diferiți pentru această setare. Așa că nu sunt probleme. Și colegilor de la Luxoft transmiteți că nu e bine că nu au găsit această setare în documentație.
Alexey, bună ziua! Aș dori să întreb un astfel de lucru. Nu pentru prima dată aud că mulți încep să folosească ClickHouse ca depozit pentru loguri. La prezentare ați spus că nu trebuie să facem asta, adică nu trebuie să stocăm șiruri lungi. Ce părere aveți despre asta?
În primul rând, logurile nu sunt, de obicei, șiruri lungi. Există, desigur, excepții. De exemplu, un serviciu scris în Java aruncă excepții, care sunt înregistrate. Și așa într-un ciclu infinit, terminând spațiul pe discul dur. Soluția este foarte simplă. Dacă șirurile sunt foarte lungi, atunci tăiați-le. Ce înseamnă lungi? Zecile de kilobiți – aceasta este o problemă.*
* în versiunile recente ale ClickHouse, a fost inclusă "granularitatea adaptivă a indexului", care în mare parte elimină problema stocării șirurilor lungi.
Dar un kilobit este ok?
Ok.
Bună ziua! Vă mulțumesc pentru prezentare! Am întrebat deja despre asta în chat, dar nu-mi amintesc dacă am primit un răspuns. Se planifică extinderea secțiunii WITH în stil CTE?
Deocamdată nu. Secțiunea WITH este oarecum neserioasă. Este o caracteristică mică.
Am înțeles. Mulțumesc!
Vă mulțumesc pentru prezentare! Foarte interesant! O întrebare globală. Se planifică să facem, poate, o modificare a eliminării datelor sub formă de anumite stub-uri?
Cu siguranță. Aceasta este prima noastră sarcină pe lista noastră. Acum ne gândim activ la cum să facem totul corect. Și ar trebui să începem să apăsăm pe tastatură*.
* am apăsat taste pe tastatură și am făcut totul.
Va afecta asta cumva performanța sistemului sau nu? Inserarea va fi la fel de rapidă ca acum?
Poate că delete-urile și update-urile în sine vor fi foarte grele, dar asta nu va afecta performanța select-urilor și performanța insert-urilor.
Și încă o întrebare mică. La prezentare ați vorbit despre cheia primară. Deci, avem partiționare care, implicit, sunt lunare, corect? Și când definim un interval de date care se încadrează într-o lună, atunci se citește doar această partiție, nu-i așa?
Da.
Am o întrebare. Dacă nu putem identifica o cheie primară, este corect să o facem pe baza câmpului „Dată” pentru a reduce reorganizarea acestor date în fundal, astfel încât să fie mai ordonate? Dacă nu aveți cereri pe baze de interval și niciun fel de cheie primară, merită să includem data în cheia primară?
Da.
Poate că are sens să incluzi în cheia primară un câmp pe baza căruia datele se vor comprima mai bine, dacă acestea sunt sortate după acest câmp. De exemplu, identificatorul utilizatorului. Utilizatorul, de exemplu, accesează același site. În acest caz, incluzi id-ul utilizatorului și timpul. Astfel, datele tale se vor comprima mai bine. În ceea ce privește data, dacă nu aveți și nu veți avea niciodată cereri pe interval de date, nu este nevoie să includeți data în cheia primară.
Bine, mulțumesc mult!
Sursa: habr.com
