

Bună ziua tuturor! Numele meu este Nikolai Golov. Am lucrat anterior la Avito și timp de șase ani am condus Data Platform, ocupându-mă de toate bazele de date: analitice (Vertica, ClickHouse), de flux și OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). În această perioadă, am învățat despre un număr mare de baze de date - foarte diverse și neobișnuite, precum și despre cazuri non-standard de utilizare a acestora.
În prezent, lucrez la ManyChat. Practic, este o start-up - nou, ambițios și în continuă creștere. Și când am început să lucrez pentru companie, a apărut întrebarea clasică: „Ce ar trebui să alegă un start-up tânăr de pe piața sistemelor de gestionare a bazelor de date?”.
În acest articol, bazat pe prezentarea mea la , voi răspunde la această întrebare. Versiunea video a prezentării este disponibilă pe .
Baze de date cunoscute din 2020
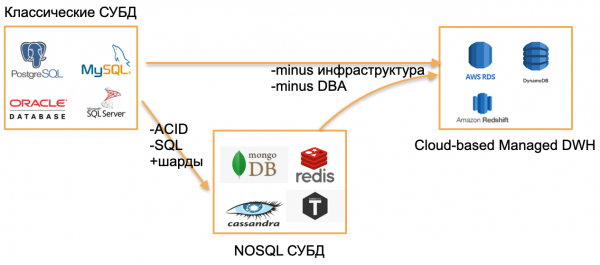
Suntem în anul 2020, m-am uitat în jur și am observat trei tipuri de baze de date.
Primul tip - baze de date OLTP clasice: PostgreSQL, SQL Server, Oracle, MySQL. Acestea au fost scrise cu mult timp în urmă, dar sunt în continuare relevante, deoarece sunt bine cunoscute comunității dezvoltatorilor.
Al doilea tip - baze de date din anii 2000. Acestea au încercat să scape de modelele clasice, renunțând la SQL, structurile tradiționale și ACID, prin adăugarea de sharding integrat și alte caracteristici atractive. De exemplu, acestea sunt Cassandra, MongoDB, Redis sau Tarantool. Toate aceste soluții au dorit să ofere piața ceva cu adevărat nou și și-au găsit o nișă, fiind extrem de utile în anumite sarcini. Aceste baze vor fi denumite prin termenul umbrelă NOSQL.
Anii 2000 s-au încheiat, bazele NOSQL s-au obișnuit, iar lumea, din punctul meu de vedere, a făcut următorul pas - către baze de date gestionate. Aceste baze au un nucleu similar cu cel al bazelor OLTP clasice sau al noilor NoSQL. Dar ele nu au nevoie de DBA și DevOps și funcționează pe hardware gestionat în cloud. Pentru dezvoltator, este „doar o bază”, care funcționează undeva, iar cum este instalată pe server, cine a configurat serverul și cine îl actualizează nu îi preocupă pe nimeni.
Exemple de astfel de baze:
- AWS RDS - o soluție gestionată pentru PostgreSQL/MySQL.
- DynamoDB - echivalentul AWS al unei baze de date de tip document, asemănătoare cu Redis și MongoDB.
- Amazon Redshift - o bază de date analitică gestionată.
Acestea se bazează pe baze mai vechi, dar sunt implementate într-un mediu gestionat, fără a fi necesară o administrare a hardware-ului.
Notă. Exemplele sunt luate pentru mediul AWS, dar existența lor este similară și în Microsoft Azure, Google Cloud sau Yandex.Cloud.
Ce este nou în acest context? Nimic din toate acestea în 2020.
Conceptul de Serverless
Cu adevărat nou pe piață în 2020 este serverless sau soluțiile fără server.
Voi încerca să explic ce înseamnă asta, folosind exemplul unui serviciu obișnuit sau a unei aplicații backend.
Pentru a desfășura o aplicație backend obișnuită, cumpărăm sau închiriem un server, copiem codul pe acesta, publicăm un endpoint în exterior și plătim regulat pentru închiriere, electricitate și servicii de data center. Aceasta este schema standard.
Se poate face altfel? Cu serviciile serverless, se poate.
Care este foca acestui concept: nu există server, nu există chiar nici o închiriere a unui instant virtual în cloud. Pentru a desfășura serviciul, copiem codul (funcțiile) în repository și publicăm un endpoint în exterior. Apoi plătim doar pentru fiecare apel al acestei funcții, ignorând complet hardware-ul pe care aceasta rulează.
Voi încerca să ilustrez acest concept cu imagini.
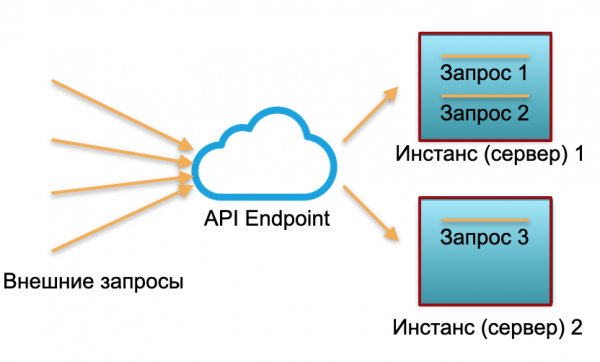
Dezvoltare clasică. Avem un serviciu cu o anumită sarcină. Ridicăm două instanțe: servere fizice sau instanțe în AWS. Aceste instanțe primesc cereri externe, care sunt procesate acolo.
După cum se vede în imagine, serverele sunt utilizate inegal. Unul este utilizat 100%, cu două cereri, iar unul doar 50% — este parțial inactiv. Dacă vin nu trei cereri, ci 30, atunci întregul sistem nu va putea face față sarcinii și va începe să se blocheze.
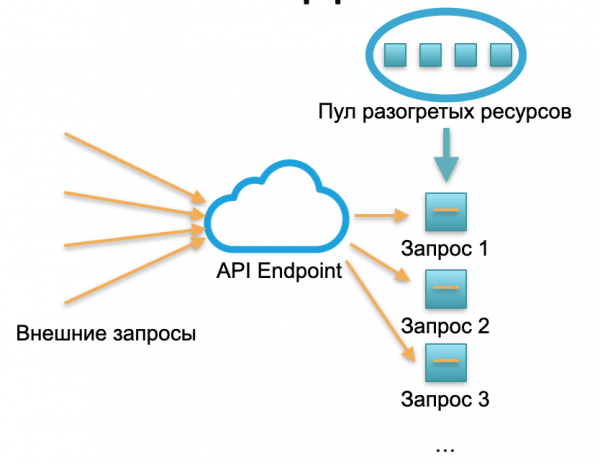
Dezvoltare fără server. Într-un mediu serverless, un asemenea serviciu nu are instanțe și servere. Există un anumit pool de resurse pregătite — mici containere Docker echipate cu codul funcției. Sistemul primește cereri externe și, pentru fiecare, framework-ul serverless ridică un mic container cu cod: procesează exact această cerere și distruge containerul.
O cerere — un container ridicat, 1000 de cereri — 1000 de containere. Iar desfășurarea pe servere fizice este deja treaba furnizorului de cloud. Aceasta este complet ascunsă de framework-ul serverless. În acest concept, plătim pentru fiecare apel. De exemplu, a venit un apel pe zi — am plătit pentru un apel, a venit un milion pe minut — am plătit pentru un milion. Sau pe secundă, se poate întâmpla și așa.
Conceptul publicării unei funcții fără server este potrivit pentru un serviciu stateless. Iar dacă aveți nevoie de un serviciu statefull, atunci adăugăm o bază de date la serviciu. În acest caz, când vine vorba de lucrul cu state, fiecare funcție statefull pur și simplu scrie și citește din baza de date. Și anume dintr-o bază de date de oricare dintre cele trei tipuri descrise la începutul articolului.
Care este limita comună pentru toate aceste baze? Costul serverului cloud sau hardware constant utilizat (sau mai multor servere). Indiferent dacă folosim o bază de date clasică sau una gestionată, indiferent dacă avem DevOps și admin sau nu, tot plătim constant pentru hardware, electricitate și chiria data center-ului, 24 din 7. Dacă avem o bază de date clasică, plătim pentru master și slave. Dacă este o bază sharded cu o încărcare mare — plătim pentru 10, 20 sau 30 de servere și plătim constant.
Prezența serverelor rezervate permanent în structura cheltuielilor era percepută anterior ca un rău inevitabil. Baze de date obișnuite au și alte complexități, cum ar fi limitele de conexiuni, restricții de scalabilitate, consens geografic — acestea pot fi soluționate în anumite baze de date, dar nu toate deodată și nu perfect.
Baza de date serverless — teorie
Întrebarea anului 2020: putem să facem o bază de date să fie serverless? Toată lumea a auzit despre backend-ul serverless... dar hai să încercăm să facem și o bază de date serverless?
Aceasta sună ciudat, deoarece o bază de date este un serviciu statefull, nu foarte potrivit pentru infrastructura serverless. În același timp, state-ul bazei de date este foarte mare: gigabyte, terabyte, iar în bazele analitice chiar petabytes. Nu este atât de simplu să-l ridici în containere Docker ușoare.
Pe de altă parte, aproape toate bazele de date moderne conțin o cantitate imensă de logică și componente: tranzacții, asigurarea integrității, proceduri, dependențe relaționale și multe logici. O parte semnificativă a logicii bazei de date necesită un state relativ mic. Gigabyte și terabyte sunt utilizate direct doar de o mică parte din logica bazei de date, care este legată de executarea imediată a interogărilor.
Prin urmare, ideea este: dacă o parte a logicii permite executarea stateless, de ce să nu împărțim baza pe părți Stateful și Stateless.
Serverless pentru soluții OLAP
Să vedem cum poate arăta împărțirea unei baze de date în părți Stateful și Stateless prin exemple practice.
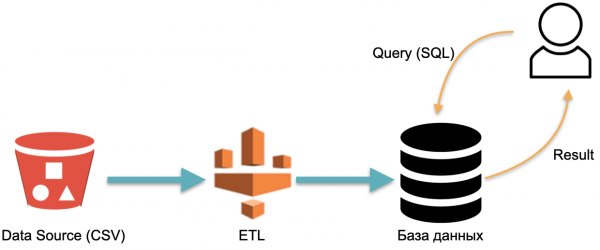
De exemplu, avem o bază de date analitică: date externe (cilindrul roșu din stânga), un proces ETL care încarcă datele în bază, și un analist care trimite interogări SQL către bază. Aceasta este o schemă clasică de lucru a unui depozit de date.
În această schemă, condiționat, procesul ETL se realizează o singură dată. Apoi trebuie să plătim continuu pentru serverele pe care rulează baza cu datele încărcate prin ETL, pentru a avea un loc unde să trimitem interogări.
Să luăm în considerare o abordare alternativă, implementată în baza AWS Athena Serverless. Aici nu există hardware dedicat constant, pe care să fie stocate datele încărcate. În schimb:
- Utilizatorul trimite o interogare SQL către Athena. Optimizerul Athena analizează interogarea SQL și caută în depozitul de metadate datele specifice necesare pentru a executa interogarea.
- Optimizerul, pe baza datelor colectate, descarcă datele necesare din sursele externe într-un depozit temporar (bază de date temporară).
- În depozitul temporar, interogarea SQL de la utilizator este executată, iar rezultatul este returnat utilizatorului.
- Depozitul temporar este curățat, resursele sunt eliberate.
În această arhitectură, plătim doar pentru procesul de execuție a interogării. Fără interogări — fără cheltuieli.
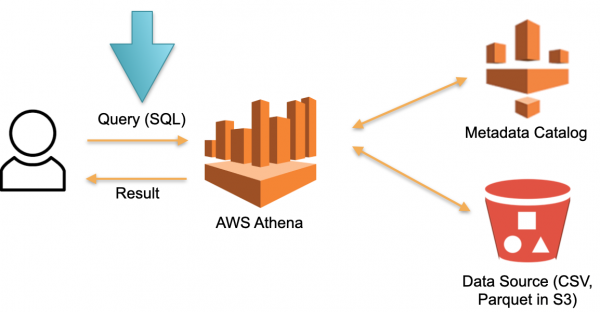
Aceasta este o abordare de lucru și se implementează nu doar în Athena Serverless, ci și în Redshift Spectrum (în AWS).
Din exemplul Athena, se observă că baza de date Serverless funcționează cu interogări reale având zeci și sute de Terabaiți de date. Pentru sute de Terabaiți vor fi necesari sute de servere, dar nu trebuie să plătim pentru acestea — plătim pentru interogări. Viteza fiecărei interogări este (foarte) scăzută în comparație cu bazele de date analitice specializate precum Vertica, dar în schimb nu plătim pentru perioadele de nefuncționare.
Această bază de date este aplicabilă pentru interogări analitice ad-hoc mai rare. De exemplu, atunci când decidem spontan să verificăm o ipoteză pe o cantitate uriașă de date. Pentru aceste cazuri, Athena este perfectă. Pentru interogările regulate, un astfel de sistem devine costisitor. În acest caz, faceți cache pentru date într-o soluție specializată.
Serverless pentru soluții OLTP
În exemplul anterior, au fost discutate sarcinile OLAP (analitice). Acum să analizăm sarcinile OLTP.
Să ne imaginăm un PostgreSQL sau MySQL scalabil. Să ridicăm o instanță gestionată obișnuită de PostgreSQL sau MySQL pe resurse minime. Când instanța va primi mai multă încărcare, vom conecta replici suplimentare, pe care vom distribui o parte din sarcina de citire. Dacă nu sunt cereri și încărcare, dezactivăm replicile. Prima instanță este master, iar celelalte sunt replici.
Această idee este implementată în baza numită Aurora Serverless AWS. Principiul este simplu: cererile din aplicații externe sunt preluate de o flotă proxy. Observând creșterea încărcării, acesta alocă resurse de calcul din instanțele minime preîncălzite - conectarea se face cât mai rapid posibil. Deconectarea instanțelor se realizează la fel.
În cadrul Aurora există conceptul de Aurora Capacity Unit, ACU. Acesta este (în mod arbitrar) o instanță (server). Fiecare ACU specific poate fi master sau slave. Fiecare Capacity Unit dispune de propria memorie RAM, procesor și disc minim. Astfel, un master și celelalte replici sunt doar pentru citire.
Numărul acestor Aurora Capacity Units active este un parametru configurabil. Numărul minim poate fi unul sau zero (în acest caz baza nu funcționează, dacă nu există cereri).
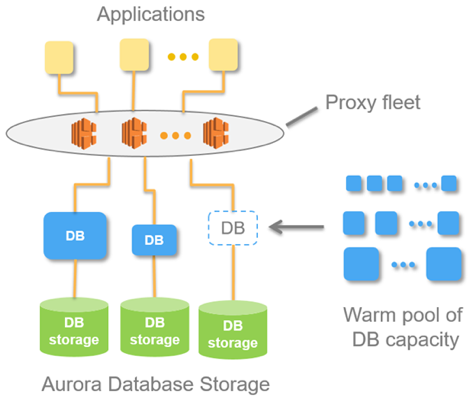
Când baza primește cereri, flota proxy ridică Aurora Capacity Units, crescând resursele sistemului. Capacitatea de a crește și a reduce resursele permite sistemului să „jongleze” cu resursele: scoate automat anumite ACU (înlocuindu-le cu altele) și aplică toate actualizările relevante pe resursele scoase.
Baza Aurora Serverless poate scala sarcina de citire. Dar în documentație nu se spune acest lucru în mod direct. Poate apărea senzația că ar putea ridica multi-master. Totuși, nu este vorba de magie.
Această bază este binevenită pentru a nu cheltui o sumă uriașă pe sisteme cu acces imprevizibil. De exemplu, atunci când creăm un MVP sau site-uri de marketing, în general nu ne așteptăm la o sarcină stabilă. Astfel, în cazul în care nu există acces, nu plătim pentru instanțe. Când apare brusc o încărcare, cum ar fi după o conferință sau o campanie publicitară, mulțimi de oameni accesează site-ul și sarcina crește brusc, Aurora Serverless preia automat această sarcină și conectează rapid resursele lipsă (ACU). Apoi, după conferință, toată lumea uită de prototip, serverele (ACU) se opresc, iar cheltuielile scad la zero - convenabil.
Această soluție nu este potrivită pentru un highload stabil, deoarece nu poate scala sarcina de scriere. Toate aceste conexiuni și deconectări de resurse au loc în momentul așa-numitului „scale point” - momentul în care baza nu este ținută de o tranzacție, nu sunt tabele temporare. De exemplu, pe parcursul unei săptămâni, este posibil să nu se producă scale point, iar baza funcționează pe aceleași resurse și pur și simplu nu poate fi extinsă sau restrânsă.
Nu există magie - este doar un PostgreSQL obișnuit. Dar procesul de adăugare a mașinilor și de deconectare este parțial automatizat.
Serverless by design
Aurora Serverless este o bază veche, rescrisă pentru cloud pentru a utiliza avantajele Serverless. Acum vă voi vorbi despre o bază care a fost scrisă din start pentru cloud, sub abordarea serverless - Serverless-by-design. A fost dezvoltată fără să se presupună că funcționează pe servere fizice.
Această bază se numește Snowflake. Are trei blocuri cheie.
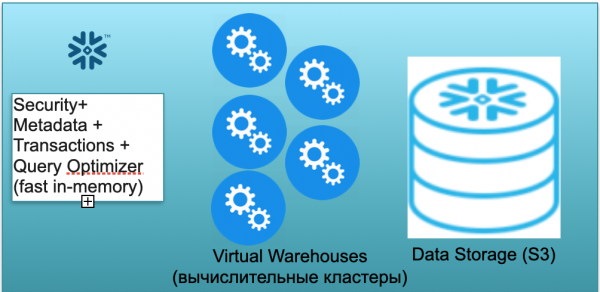
Primul - este blocul de metadate. Este un serviciu rapid în memorie, care rezolvă problemele legate de securitate, metadate, tranzacții, optimizarea interogărilor (în ilustrația din stânga).
Al doilea bloc - este format din numeroase clustere virtuale de calcul pentru calcule (în ilustrație - un set de cercuri albastre).
Al treilea bloc - este sistemul de stocare a datelor pe baza S3. S3 este un spațiu de stocare de obiecte nelimitat în AWS, ceva asemănător unui Dropbox nelimitat pentru afaceri.
Să vedem cum funcționează Snowflake, presupunând că avem un start rece. Cu alte cuvinte, baza de date este prezentă, datele sunt încărcate în aceasta, dar nu există interogări active. Prin urmare, dacă nu sunt interogări către baza de date, avem un serviciu rapid de Metadata în memorie (primul bloc). Și avem un stocare S3, unde sunt păstrate datele din tabele, împărțite în așa-numitele micro-partiții. Pentru simplificare: dacă în tabel sunt tranzacții, micro-partițiile sunt zilele tranzacțiilor. Fiecare zi este o micro-partiție separată, un fișier separat. Și atunci când baza de date funcționează în acest mod, plătiți doar pentru spațiul ocupat de date. De asemenea, tariful pentru spațiu este foarte mic (mai ales având în vedere compresia semnificativă). Serviciul de metadata funcționează constant, dar pentru optimizarea interogărilor nu sunt necesare multe resurse, iar serviciul poate fi considerat condiționat gratuit.
Acum să ne imaginăm că un utilizator a venit la baza noastră de date și a trimis o interogare SQL. Interogarea SQL este trimisă imediat către serviciul Metadata pentru procesare. Așadar, primind interogarea, acest serviciu analizează interogarea, datele disponibile, drepturile utilizatorului și, dacă totul este în regulă, elaborează un plan pentru procesarea interogării.
Apoi, serviciul inițiază lansarea unui cluster de calcul. Un cluster de calcul este un grup de servere care efectuează calcule. Cu alte cuvinte, este un cluster care poate conține 1 server, 2 servere, 4, 8, 16, 32 — câte doriți. Trimiteți interogarea și clusterul începe să se lanseze instantaneu pentru aceasta. Acest proces durează, de fapt, câteva secunde.
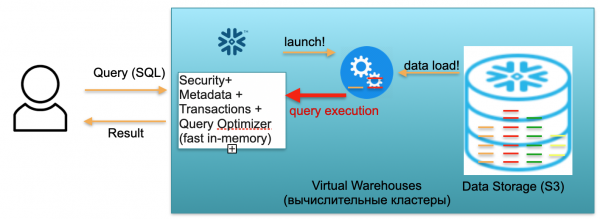
Apoi, după ce clusterul a fost pornit, micropartițiile necesare pentru procesarea solicitării tale sunt copiate din S3 în cluster. Cu alte cuvinte, să presupunem că pentru a executa o interogare SQL sunt necesare două partiții dintr-un tabel și una din altul. În acest caz, în cluster vor fi copiate doar cele trei partiții necesare, nu toate tabelele în întregime. Acesta este motivul pentru care, și datorită faptului că totul se află în cadrul aceluiași centru de date și este conectat prin canale foarte rapide, întregul proces de transfer se desfășoară foarte rapid: în câteva secunde, foarte rar în câteva minute, dacă nu este vorba despre interogări extrem de complexe. Prin urmare, micropartițiile sunt copiate în clusterul de calcul, iar, la final, pe acest cluster de calcul este executată interogarea SQL. Rezultatul acestei interogări poate fi o linie, mai multe linii sau un tabel — acestea sunt trimise utilizatorului pentru a fi descărcate, afișate în instrumentul BI, sau utilizate în alt mod.
Fiecare interogare SQL poate nu doar să calculeze agregate din datele deja încărcate, ci și să încarce/formateze date noi în baza de date. Asta înseamnă că poate fi o interogare care, de exemplu, realizează inserții de noi înregistrări într-un alt tabel, ceea ce duce la crearea unei noi partiții în clusterul de calcul, care, la rândul său, este salvată automat în depozitul S3 unic.
Scenariul descris mai sus, de la sosirea utilizatorului până la pornirea clusterului, încărcarea datelor, executarea interogărilor, primirea rezultatelor, este tarifat pe baza minutei de utilizare a clusterului virtual de calcul ridicat, warehouse-ului virtual. Tariful variază în funcție de zona AWS și dimensiunea clusterului, dar, în medie, costă câțiva dolari pe oră. Un cluster format din patru mașini costă de două ori mai mult decât unul format din două mașini, iar unul din opt mașini costă de încă două ori mai mult. Sunt disponibile opțiuni de 16, 32 mașini, în funcție de complexitatea interogărilor. Dar plătești doar pentru minutele în care clusterul este cu adevărat activ, deoarece, atunci când nu sunt interogări, practic îi dai drumul, iar după 5-10 minute de așteptare (parametru configurabil) se va opri singur, eliberând resursele și devenind gratuit.
Există un scenariu complet real în care trimiteți o solicitare, clusterul apare, să zicem, într-un minut, se gândește timp de încă un minut, apoi cinci minute pentru a se opri, și în final plătiți pentru șapte minute de funcționare a acestui cluster, nu pentru luni și ani.
Primul scenariu descria utilizarea Snowflake într-o variantă pentru un singur utilizator. Acum să ne imaginăm că sunt mulți utilizatori, ceea ce se apropie mai mult de un scenariu real.
Să presupunem că avem mulți analiști și rapoarte Tableau care bombardează constant baza noastră cu un număr mare de interogări SQL de analiză simple.
În plus, să presupunem că avem Data Scientists inventivi care încearcă să facă lucruri monstruoase cu datele, operând cu zeci de terabytes, analizând miliarde și trilioane de rânduri de date.
Pentru cele două tipuri de sarcini descrise mai sus, Snowflake permite ridicarea mai multor clustere de calcul independente de putere diferită. Aceste clustere de calcul funcționează independent, dar cu date comune consistente.
Pentru un număr mare de interogări ușoare, se pot ridica 2-3 clustere mici, fiecare având, să zicem, 2 mașini. Acest comportament poate fi realizat, de asemenea, prin setări automate. Asta înseamnă că spuneți: „Snowflake, ridică un cluster mic. Dacă încărcarea pe acesta depășește un anumit parametru, ridică un al doilea, al treilea similar. Când încărcarea începe să scadă, oprește cele în plus.” Astfel, indiferent de câți analiști vin și încep să vizioneze rapoartele, toată lumea are suficiente resurse.
În acest context, dacă analiștii dorm și nimeni nu vizionează rapoartele, clusterele se pot opri complet, iar dumneavoastră nu mai plătiți pentru ele.
În plus, pentru interogările complexe (de la Data Scientists), puteți ridica un singur cluster foarte mare cu 32 de mașini, de exemplu. Acest cluster va fi de asemenea plătit doar pentru minutele și orele în care funcționează uriașa dumneavoastră interogare.
Posibilitatea descrisă mai sus permite separarea nu doar a două, ci și a mai multor tipuri de sarcini prin clustere (ETL, monitorizare, materializare a rapoartelor,…).
Să rezumăm Snowflake. Baza combină o idee frumoasă cu o implementare funcțională. În ManyChat, folosim Snowflake pentru analiza tuturor datelor disponibile. Noi avem nu doar trei clustere, ca în exemplu, ci între 5 și 9, de dimensiuni diferite. Avem clustere de 16 mașini, de 2 mașini, dar și super-mici de 1 mașină pentru anumite sarcini. Ele distribuie eficient sarcina și ne permit să economisim considerabil.
Baza scalează cu succes sarcina de citire și scriere. Aceasta este o diferență uriașă și o mare progrese față de „Aurora”, care gestiona doar sarcina de citire. Snowflake permite scalarea sarcinii de scriere prin aceste clustere de calcul. Așa cum am menționat, în ManyChat folosim mai multe clustere, iar clusterele mici și super-mici sunt folosite în principal pentru ETL, pentru încărcarea datelor. Iar analiștii lucrează pe clusterele medii, care nu sunt afectate de sarcina ETL, așa că funcționează foarte rapid.
Prin urmare, baza se pretează bine pentru sarcini OLAP. Din păcate, pentru sarcinile OLTP, aceasta nu este încă aplicabilă. În primul rând, aceasta este o bază de date pe coloane, cu toate consecințele decurgătoare. În al doilea rând, abordarea de a ridica un cluster de calcul pentru fiecare cerere și de a-l alimenta cu date, din păcate, nu este rapidă suficient pentru sarcinile OLTP. Secunde de așteptare pentru sarcinile OLAP sunt acceptabile, dar pentru OLTP sunt inacceptabile; ar trebui să fie 100 ms, iar ideal 10 ms.
Rezultatul
O bază de date fără server este posibilă prin separarea acesteia în părți Stateless și Stateful. Probabil ați observat că în toate exemplele date, partea Stateful este, să zicem, stocarea micro-partițiilor în S3, iar Stateless este optimizatorul, gestionarea metadatelor, tratarea problemelor de securitate, care pot fi ridicate ca servicii independente, ușoare, Stateless.
Executarea interogărilor SQL poate fi văzută și ca servicii cu un stat ușor, care pot apărea în modul fără server, asemenea clustrelor de calcul Snowflake, descărcând doar datele necesare, executând interogarea și „stingându-se”.
Bazele de date serverless de nivel de producție sunt deja disponibile pentru utilizare, funcționează. Aceste baze de date serverless sunt deja pregătite să facă față sarcinilor OLAP. Din păcate, pentru sarcinile OLTP sunt aplicate... cu nuanțe, deoarece există limitări. Pe de o parte, acesta este un dezavantaj. Dar, pe de altă parte, este o oportunitate. Poate că cineva dintre cititori va găsi o modalitate de a transforma o bază de date OLTP în una complet serverless, fără limitări Aurora.
Sper că v-a fost interesant. Spre viitorul Serverless 🙂
Sursa: habr.com
