

Venind dintr-un produs care s-a dezvoltat timp de mai bine de un deceniu, nu este surprinzător să întâlnești tehnologii învechite. Dar ce se întâmplă dacă, în termen de șase luni, trebuie să gestionezi o sarcină de zece ori mai mare, iar costul căderilor crește de sute de ori? În acest caz, ai nevoie de un inginer Highload experimentat. Dar, din lipsă de personal specializat, problema a fost încredințată mie. În prima parte a articolului, voi povesti cum am migrat de la Redis la Redis-cluster, iar în a doua parte voi oferi sfaturi despre cum să începi utilizarea clusterului și la ce să fii atent în exploatarea sa.
Alegerea tehnologiei
Este atât de rău Redis separat (redis standalone) în configurația 1 master și N slave? De ce îl numesc tehnologie învechită?
Nu, Redis nu este atât de rău... Totuși, există câteva neajunsuri pe care nu le poți ignora.
În primul rând, Redis nu suportă mecanisme de recuperare în caz de cădere a masterului. Pentru a rezolva această problemă, am folosit o configurație cu comutarea automată a VIP-urilor pe un nou master, schimbând rolul unuia dintre slave și comutând celelalte. Acest mecanism a funcționat, dar nu se putea numi o soluție fiabilă. În primul rând, au existat alarme false, iar în al doilea rând, era o soluție temporară, iar după activare erau necesare acțiuni manuale pentru a restabili sistemul.
În al doilea rând, existenta unui singur master a dus la probleme de shardare. A fost necesar să cream mai multe clustere independente „1 master și N slave”, apoi să distribuim manual bazele pe aceste mașini și să sperăm că mâine una dintre baze nu se va extinde atât de mult încât va trebui să o mutăm pe o instanță separată.
Ce opțiuni avem?
- Cea mai costisitoare și sofisticată soluție este Redis-Enterprise. Aceasta este o soluție de tip cutie, cu suport tehnic complet. Cu toate că arată ideal din punct de vedere tehnic, nu ni se potrivește din motive ideologice.
- Redis-cluster. Din cutie, oferă suport pentru comutarea automată a masterului și shardare. Interfața este aproape identică cu versiunea obișnuită. Arată promițător, iar despre capcanele ascunse vom vorbi mai departe.
- Tarantool, Memcache, Aerospike și altele. Toate aceste instrumente fac cam același lucru. Dar fiecare are propriile sale dezavantaje. Am decis să nu punem toate ouăle într-un singur coș. Memcache și Tarantool le folosim pentru alte sarcini și, anticipez, voi spune că în practica noastră am avut mai multe probleme cu ele.
Specifica utilizării
Să ne uităm la ce sarcini am rezolvat istoric cu Redis și ce funcționalitate am folosit:
- Cache înainte de cererile către servicii externe precum 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache înainte de MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Stocare principală pentru serviciul de gestionare a sesiunilor și coordonatele șoferilor | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
După cum vezi, nu este nicio matematică avansată. Care este, așadar, dificultatea? Să analizăm fiecare metodă în parte.
Metoda
Descriere
Particularitățile Redis-cluster
Soluție
GET SET
Scrie/citește o cheie
MGET MSET
Scrie/citește mai multe chei
Cheile vor fi distribuite pe diferite noduri. Bibliotecile disponibile pot face operații multi doar în cadrul unui singur nod
Înlocuiește MGET cu un pipeline din N operații GET
SELECT DB
Alege baza cu care vom lucra
Nu suportă mai multe baze de date
Să stocăm totul într-o singură bază. Adaugă prefixe la chei
SCAN
Parcurge toate cheile din bază
Deoarece avem o singură bază, a parcurge toate cheile din cluster este prea costisitor
Să menținem invarianta într-o singură cheie și să facem HSCAN pe această cheie. Sau să renunțăm complet
GEO
Operații cu geocheia
Geocheia nu este sharduită
KEY BY PATTERN
Caută cheia după pattern
Deoarece avem o singură bază, vom căuta printre toate cheile din cluster. Este prea costisitor
Renunțăm sau menținem invarianta, așa cum este cazul cu SCAN-ul
Redis vs Redis-cluster
Ce pierdem și ce câștigăm la trecerea la cluster?
- Dezavantaje: pierdem funcționalitatea mai multor baze.
- Dacă dorim să stocăm date logic necorelate într-un singur cluster, va trebui să facem soluții temporare sub formă de prefixe.
- Pierd toate operațiile „pe bază”, cum ar fi SCAN, DBSIZE, CLEAR DB etc.
- Operațiile multi au devenit semnificativ mai complexe, deoarece poate fi necesară interacțiunea cu mai multe noduri.
- Avantaje:
- Toleranță la erori în formă de comutare de urgență a masterului.
- Sharduri pe partea de Redis.
- Transferarea datelor între noduri atomar și fără întreruperi.
- Adăugarea și redistribuirea resurselor și a încărcărilor fără întreruperi.
Aș concluziona că, dacă nu este necesară asigurarea unui nivel înalt de fiabilitate, mutarea pe un cluster nu merită, deoarece poate fi o sarcină complicată. Dar, dacă trebuie să alegem între o versiune separată și una cluster, ar trebui să alegem clusterul, deoarece nu este cu nimic mai prejos și, în plus, va elimina o parte din durerea de cap.
Pregătirea pentru mutare
Să începem cu cerințele pentru mutare:
- Aceasta trebuie să fie fără întreruperi. O oprire completă a serviciului timp de 5 minute nu este acceptabilă pentru noi.
- Trebuie să fie cât mai sigură și graduală. Ne dorim să avem un control asupra situației. Nu dorim să mutăm totul deodată și să ne rugăm la butonul de revenire.
- Pierderi minime de date în timpul mutării. Înțelegem că mutarea atomică va fi foarte complicată, prin urmare, acceptăm o oarecare desincronizare între datele din Redis-ul obișnuit și cel cluster.
Întreținerea clusterului
Înainte de a efectua mutarea, ar trebui să ne întrebăm dacă putem întreține clusterul:
- Grafice. Folosim Prometheus și Grafana pentru graficele de încărcare a procesoarelor, utilizarea memoriei, numărul de clienți, numărul de operații GET, SET, AUTH etc.
- Expertiză. Imaginează-ți că, de mâine, vei avea sub responsabilitate un cluster imens. Dacă se strică, nimeni în afară de tine nu îl va putea repara. Dacă începe să fie lent - toți se vor îndrepta spre tine. Dacă trebuie să adaugi resurse sau să redistribui sarcina - din nou, la tine. Pentru a nu albi prematur, este recomandat să avem în vedere aceste situații și să verificăm din timp cum se va comporta tehnologia în diferite acțiuni. Vom discuta acest subiect mai în detaliu în secțiunea „Expertiză”.
- Monitorizări și alerte. Atunci când clusterul se strică, ne dorim să fim primii care află. Aici ne-am limitat la a fi anunțați că toate nodurile returnează aceeași informație despre starea clusterului (da, se poate întâmpla și altfel). Alte probleme se pot observa mai rapid prin alertele serviciilor client Redis.
Mutare
Cum ne vom muta:
- În primul rând, trebuie să pregătim biblioteca pentru a funcționa cu clusterul. Ca bază pentru versiunea în Gо, am folosit go-redis și am făcut câteva modificări. Am implementat metodele Multi prin pipeline-uri și am ajustat puțin regulile pentru repetarea cererilor. Cu versiunea pentru PHP au fost mai multe probleme, dar în cele din urmă ne-am oprit asupra php-redis. Recent, au implementat suport pentru cluster, iar în opinia noastră, arată bine.
- Apoi trebuie să desfășurăm clusterul propriu-zis. Acest lucru se face literalmente în două comenzi, pe baza fișierului de configurație. Vom discuta despre configurare mai în detaliu mai jos.
- Pentru o tranziție graduală, folosim dry-mode. Deoarece avem două versiuni ale bibliotecii cu aceeași interfață (una pentru versiunea obișnuită, alta pentru cluster), nu este nicio problemă să creăm un wrapper care va funcționa cu versiunea separată și va duplica toate cererile în cluster, comparând răspunsurile și scriind abaterile în jurnale (în cazul nostru în NewRelic). Astfel, chiar dacă versiunea cluster se va strica în timpul implementării, producția noastră nu va fi afectată.
- După ce am desfășurat clusterul în dry-mode, putem observa liniștit graficul abaterilor răspunsurilor. Dacă procentajul erorilor se îndreaptă lent, dar sigur, către o constantă mică, înseamnă că totul este în regulă. De ce există totuși abateri? Pentru că scrierea în versiunea separată se face puțin mai devreme decât în cluster, iar din cauza micro-logurilor, datele pot diverge. Rămâne doar să ne uităm la jurnalele abaterilor, iar dacă toate sunt explicabile prin neatomaritatea scrierii, putem merge mai departe.
- Acum putem schimba dry-mode în direcția opusă. Vom scrie și citi din cluster, iar dublăm în versiunea separată. De ce? În următoarea săptămână dorim să observăm funcționarea clusterului. Dacă se va dovedi că există probleme în timpul vârfurilor de încărcare sau că am omis ceva, avem întotdeauna o revenire de urgență la codul vechi și datele actuale datorită dry-mode.
- Rămâne să dezactivăm dry-mode și să demontăm versiunea separată.
Expertiză
Începeți prin a vorbi pe scurt despre arhitectura clusterului.
În primul rând, Redis este un magazin de tip key-value. Ca și cheie se utilizează șiruri de caractere arbitrare. Ca valori pot fi utilizate numere, șiruri de caractere și structuri întregi. Acestea din urmă sunt foarte numeroase, dar pentru a înțelege arhitectura generală, acest aspect nu este important.
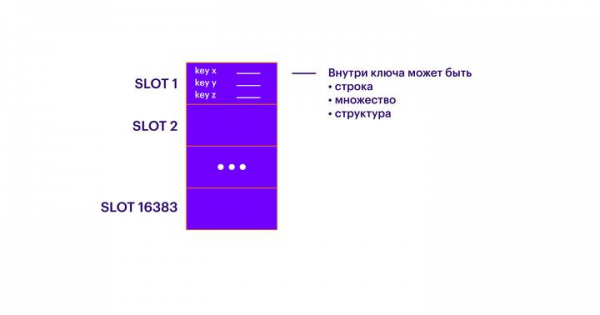
Următoarea nivel de abstractizare după chei sunt sloturile (SLOTS). Fiecare cheie aparține uneia dintre cele 16 383 de sloturi. În fiecare slot pot fi câte chei dorim. Astfel, toate cheile se împart în 16 383 de mulțimi distincte.
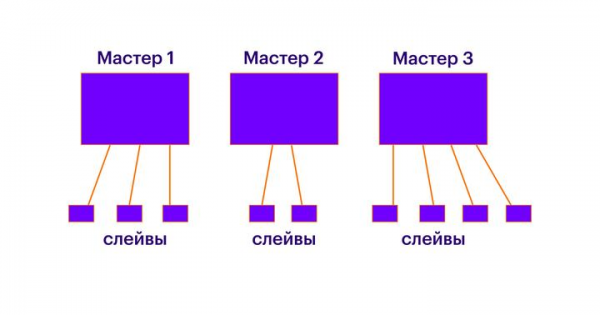
Apoi, în cluster trebuie să existe N noduri master. Fiecare nod poate fi considerat ca un instanț de Redis separat, care știe totul despre celelalte noduri din cluster. Fiecare nod master conține un anumit număr de sloturi. Fiecare slot aparține doar unui nod master. Toate sloturile trebuie distribuite între noduri. Dacă unele sloturi nu sunt distribuite, cheile stocate în ele nu vor fi accesibile. Fiecare nod master are sens să fie pornit pe o mașină logică sau fizică separată. De asemenea, trebuie să reținem că fiecare nod funcționează pe un singur nucleu, iar dacă doriți să rulați mai multe instanțe Redis pe aceeași mașină logică, asigurați-vă că acestea vor rula pe nuclee diferite (nu am încercat așa, dar în teorie ar trebui să funcționeze). Practic, nodurile master asigură o fragmentare obișnuită, iar un număr mai mare de noduri master permite scalarea cererilor de scriere și citire.
După ce toate cheile sunt distribuite pe sloturi, iar sloturile sunt împărțite între nodurile master, la fiecare nod master se pot adăuga un număr nelimitat de noduri slave. În interiorul fiecărei astfel de legături „master-slave” va funcționa replicarea obișnuită. Slavele sunt necesare pentru scalarea cererilor de citire și pentru comutarea de urgență în caz de defectare a masterului.
Acum să discutăm despre operațiile pe care ar trebui să le putem executa.
Vom accesa sistemul prin Redis-CLI. Deoarece Redis nu are un punct unic de acces, putem efectua următoarele operații pe oricare dintre noduri. Fiecare punct accentuează posibilitatea de a efectua operația sub sarcină.
- Primul și cel mai important lucru de care avem nevoie: operația cluster nodes. Aceasta returnează starea clusterului, arată lista nodurilor, rolurile lor, distribuția sloturilor etc. Informații suplimentare pot fi obținute folosind cluster info și cluster slots.
- Ar fi bine să poți adăuga și elimina noduri. Pentru aceasta există operațiile cluster meet și cluster forget. Rețineți că trebuie aplicat cluster forget pentru FIECARE nod, atât pentru mastere, cât și pentru replici. Cluster meet trebuie apelat doar pe un singur nod. Această diferență poate fi descurajantă, așa că e mai bine să o cunoști înainte de a pune în funcțiune clusterul. Adăugarea unui nod se realizează în siguranță în timpul funcționării și nu afectează activitatea clusterului (ceea ce este logic). Dacă doriți să eliminați un nod din cluster, asigurați-vă că nu mai are sloturi (altfel riscați să pierdeți accesul la toate cheile de pe acest nod). De asemenea, nu eliminați masterul care are slave-uri, altfel va avea loc o votare inutilă pentru un nou master. Dacă pe noduri nu mai sunt sloturi, atunci aceasta este o problemă minoră, dar de ce să avem alegeri inutile când putem elimina mai întâi slave-urile.
- Dacă trebuie să schimbi forțat locurile între master și slave, atunci comanda cluster failover este potrivită. Atunci când o chemi în timpul funcționării, trebuie să înțelegi că, pe durata operației, masterul va fi inaccesibil. De obicei, schimbarea se realizează în mai puțin de o secundă, dar nu este atomică. Poți să te aștepți ca o parte din cererile către master în acel moment să se finalizeze cu o eroare.
- Înainte de a elimina un nod din cluster, nu trebuie să mai rămână sloturi pe acesta. Este mai bine să le redistribuiți folosind comanda cluster reshard. Sloturile vor fi mutate de la un master la altul. Întreaga operațiune poate dura câteva minute, în funcție de volumul de date transferate; însă, procesul de transfer este sigur și nu afectează funcționarea cluster-ului. Astfel, toate datele pot fi transferate de la un nod la altul chiar sub sarcină, fără a trebuie să vă faceți griji cu privire la disponibilitatea lor. Totuși, există și unele nuanțe. În primul rând, transferul datelor implică o anumită sarcină asupra nodului destinatar și asupra celui de expediere. Dacă nodul destinat este deja foarte solicitat din punct de vedere al procesorului, nu ar trebui să îl supraîncărcați și cu primirea de noi date. În al doilea rând, odată ce pe masterul-expeditor nu vor mai rămâne sloturi, toate replicile sale vor trece imediat la masterul pe care au fost mutate aceste sloturi. Problema este că toate aceste replici vor dori să sincronizeze datele simultan. Și veți avea noroc dacă va fi o sincronizare parțială, nu una completă. Luați asta în considerare și combinați operațiunile de transfer al sloturilor și de deconectare/transfer al replicilor. Sau, sperați că aveți suficiente resurse disponibile.
- Ce să faceți dacă, în timpul transferului, ați descoperit că ați pierdut sloturi? Sper că această problemă nu va apărea pentru dumneavoastră, dar, în caz contrar, există operația cluster fix. Aceasta va redistribui sloturile pe noduri într-o ordine aleatorie. Recomand să verificați cum funcționează, eliminând anterior un nod din cluster care are sloturi distribuite. Deoarece datele în sloturile nedistribuite sunt oricum inaccesibile, este prea târziu să vă preocupați de problemele de disponibilitate ale acestor sloturi. În schimb, operația nu va afecta sloturile distribuite.
- O altă operațiune utilă este monitor. Aceasta permite vizualizarea în timp real a întregii liste de cereri care vin către nod. Mai mult, pe baza acesteia se poate realiza un grep pentru a verifica dacă există traficul dorit.
De asemenea, merită menționată procedura de comutare de urgență a masterului. Pe scurt, există, și, în opinia mea, funcționează perfect. Cu toate acestea, nu trebuie să credeți că, dacă deconectați cablul din priză de la mașina cu nod master, Redis se va comuta imediat și clienții nu vor observa pierderea. Din experiența mea, comutarea durează câteva secunde. În acest timp, o parte din date va fi indisponibilă: se detectează indisponibilitatea masterului, nodurile votează pentru un nou master, slavele se comută, datele se sincronizează. Cea mai bună modalitate de a verifica pe cont propriu că schema funcționează este să efectuați exerciții locale. Lansați un cluster pe laptopul dumneavoastră, aplicați o sarcină minimă, simulați o cădere (de exemplu, blocând porturile), evaluați viteza de comutare. În opinia mea, doar jucându-vă în acest mod timp de o zi-două, puteți fi siguri de funcționarea tehnologiei. Sau, altfel spus, să sperăm că software-ul utilizat de jumătate din internet funcționează cu adevărat.
Configurație
Adesea, configurația este primul lucru necesar pentru a începe lucrul cu instrumentul. Și când totul funcționează, nu dorim să atingem configurația. Sunt necesare eforturi considerabile pentru a te determina să te întorci la setări și să le examinezi cu atenție. Din câte îmi amintesc, am avut cel puțin două eșecuri serioase din cauza neatenției față de configurație. Acordați o atenție deosebită urmând puncte:
- timeout 0
Timpul după care se închid conexiunile inactive (în secunde). 0 – nu se închid
Nu fiecare dintre bibliotecile noastre reușea să închidă corect conexiunile. Dezactivând această setare, riscăm să ne lovim de limita numărului de clienți. Pe de altă parte, dacă există o astfel de problemă, întreruperea automată a conexiunilor pierdute o va masca, iar noi s-ar putea să nu o observăm. De asemenea, nu ar trebui să activăm această setare la utilizarea conexiunilor persistente. - Save x y & appendonly yes
Salvarea RDB-snapshot-ului.
Problemele RDB/AOF le vom discuta în detaliu mai jos. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Dacă este activat, atunci în cazul unei erori a RDB-snapshot-ului, masterul va înceta să primească cereri de modificare. Dacă conexiunea cu masterul este pierdută, atunci slave-ul poate continua să răspundă la cereri (da). Sau poate înceta să răspundă (nu)
Nu ne mulțumește situația în care Redis se transformă în o dovleac. - repl-ping-slave-period 5
După acest interval de timp, ne vom începe să ne facem griji că masterul s-a stricat și că ar trebui să inițiem procedura de failover.
Va trebui să găsim manual echilibrul între alertele false și inițierea failover-ului. În experiența noastră, aceasta durează aproximativ 5 secunde. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Atât de multe date putem stoca în buffer pentru replica căzută. Dacă bufferul se umple, va trebui să ne sincronizăm complet.
Practică ne arată că este mai bine să setăm o valoare mai mare. Există destule motive pentru care replica ar putea începe să întârzie. Dacă întârzie, este foarte probabil că masterul tău se confruntă deja cu dificultăți, iar sincronizarea completă va fi ultimul picur. - maxclients 10000
Numărul maxim de clienți simultani.
Din experiența noastră, este mai bine să setăm o valoare mai mare. Redis se descurcă perfect cu 10.000 de conexiuni. Asigură-te doar că sistemul are suficiente socket-uri. - maxmemory-policy volatile-ttl
Regula după care se șterg cheile atunci când se atinge limita de memorie disponibilă.
Aici este important nu doar regula în sine, ci înțelegerea modului în care va fi aplicată. Redis merită lăudat pentru capacitatea sa de a funcționa eficient atunci când se atinge limita de memorie.
Problemele RDB și AOF
Deși Redis își stochează toate informațiile în memoria RAM, există și un mecanism de salvare a datelor pe disc. Mai exact, trei mecanisme:
- RDB-snapshot — o copie completă a tuturor datelor. Se configurează cu ajutorul SAVE X Y și se citește ca «Salvează o copie completă a tuturor datelor la fiecare X secunde, dacă s-au schimbat măcar Y chei».
- Append-only file — o listă de operații în ordinea în care sunt executate. Adaugă noile operații în fișier la fiecare X secunde sau la fiecare Y operații.
- RDB și AOF — combinația celor două anterioare.
Toate metodele au propriile avantaje și dezavantaje; nu voi enumera toate, ci voi sublinia doar aspectele care, în opinia mea, nu sunt evidente.
În primul rând, pentru salvarea unui snapshot RDB, este necesar să se apeleze FORK. Dacă sunt multe date, acest lucru poate bloca întreg Redis-ul pentru o perioadă de câteva milisecunde până la o secundă. În plus, sistemul necesita memorie pentru un astfel de snapshot, ceea ce duce la necesitatea de a avea pe mașina logică o rezervă dublă de RAM: dacă pentru Redis sunt alocați 8 GB, atunci pe mașina virtuală cu el trebuie să fie disponibili 16.
În al doilea rând, există probleme cu sincronizarea parțială. În modul AOF, la reconectarea slave-ului, în loc de sincronizarea parțială, poate fi efectuată o sincronizare completă. Nu am reușit să înțeleg de ce se întâmplă acest lucru. Dar merită să ne amintim acest aspect.
Aceste două puncte deja ne fac să ne gândim dacă este necesar să păstrăm aceste date pe disc, dacă oricum sunt duplicate de slave-uri. Datele pot fi pierdute doar în cazul în care toate slave-urile au o defecțiune, iar aceasta este o problemă de nivel „incendiu în DC”. Ca un compromis, se poate propune păstrarea datelor doar pe slave-uri, dar în acest caz trebuie să ne asigurăm că aceste slave-uri nu devin niciodată master în cazul unei recuperări după o defecțiune (pentru asta există setarea prioritară a slave-urilor în configurația lor). Noi, în fiecare caz concret, ne gândim dacă trebuie să păstrăm datele pe disc, și de cele mai multe ori răspundem „nu”.
Concluzie
În concluzie, sper că am reușit să ofer o idee generală despre funcționarea redis-cluster-ului celor care nu au auzit deloc despre el, precum și să atrag atenția asupra unor aspecte mai puțin evidente pentru cei care îl folosesc de mult timp.
Vă mulțumesc pentru timpul acordat și, ca de obicei, comentariile pe această temă sunt binevenite.
Sursa: habr.com
