

– O, niciun adăpost nu va rezista impactului unui meteorit. Dar, ca fiecare, aveți un rezervor, deci nu trebuie să vă faceți griji.
Stanislav Lem, „Jurnalele stelare ale lui Iyon Tihy”
Backup-ul se referă la salvarea unei copii a datelor undeva în afara locului principal de stocare.
Principala destinație a backup-ului este recuperarea datelor după pierderea acestora. În acest context se aude adesea că, având o replică a bazei de date, se pot recupera întotdeauna datele, iar backup-ul nu este necesar. De fapt, backup-ul permite rezolvarea a cel puțin trei sarcini care nu pot fi rezolvate printr-o replică, iar replica nu poate fi inițiată fără un backup.
În primul rând, un backup permite recuperarea datelor după o eroare logică. De exemplu, un contabil a șters un grup de înregistrări sau un administrator de baze de date a distrus un spațiu de tabel. Ambele operațiuni sunt complet legitime din punctul de vedere al bazei de date, iar procesul de replicare le va reproduce în baza-replică.
În al doilea rând, sistemele moderne de gestionare a bazelor de date sunt programe relativ fiabile, însă, ocazional, se întâmplă deteriorări ale structurilor interne ale bazei de date, după care accesul la date devine imposibil. Ceea ce este cu adevărat frustrant este că aceste daune apar de obicei în timpul unei încărcări mari sau în timpul instalării unui fel de actualizare. Dar atât încărcările mari, cât și actualizările regulate indică că baza de date nu este, cu siguranță, una de testare, iar datele stocate în aceasta sunt valoroase.
În cele din urmă, a treia sarcină, a cărei rezolvare necesită un backup, este clonarea bazei de date, de exemplu, în scopuri de testare.
Backup-ul bazelor de date se bazează, într-un fel sau altul, pe unul dintre cele două principii:
- Extracția datelor cu salvarea lor ulterioară într-un format arbitrar;
- Captura stării fișierelor bazei de date și salvarea jurnalelor.
Să analizăm aceste principii și instrumentele care le implementează mai în detaliu.
Exportul de date
În setul de instrumente care vin împreună cu orice SGBD, există cu siguranță instrumente pentru exportul și importul datelor. Datele sunt salvate fie în format text, fie în format binar specific pentru SGBD-ul respectiv. În tabelul de mai jos este prezentată o listă a acestor instrumente:
Format binar
Format text
Oracle
DataPump Export/DataPump Import
Export/Import
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
unload/load
unload/load
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Formatul text este avantajos deoarece poate fi editat sau chiar creat de programe externe, iar formatul binar este bun deoarece permite încărcarea și descărcarea mai rapidă a datelor datorită economiei de resurse pentru conversia formatelor.
În ciuda simplității și evidenței ideii de descărcare a datelor, această metodă este utilizată rar pentru rezervarea bazelor de date industriale supraaglomerate. Iată motivele pentru care descărcarea nu este potrivită pentru o rezervare completă:
- procesul de descărcare generează o sarcină semnificativă pe sistemul sursă;
- descărcarea durează mult timp - la momentul finalizării, aceasta devine deja inactuală;
- este practic imposibil să faci o descărcare consistentă a întregii baze de date în condiții de sarcină mare, deoarece SGBD-ul este obligat să păstreze o captură a stării sale în momentul începerii descărcării. Cu cât mai multe tranzacții au avut loc de la începutul descărcării, cu atât volumul capturii este mai mare (copia inactuală a datelor în PostgreSQL, spațiul undo în Oracle, tempdb în Microsoft SQL Server etc.);
- descărcarea păstrează structura logică a datelor, dar nu păstrează structura lor fizică - parametrii de stocare fizică a tabelelor, indecșii etc.
Cu toate acestea, descărcarea are și avantajele sale:
- selectivitate ridicată: se pot descărca tabele individuale, câmpuri individuale și chiar linii individuale;
- datele descărcate pot fi încărcate într-o bază de date de o altă versiune, iar dacă descărcarea a fost realizată în format text, atunci și într-o altă bază de date.
Astfel, descărcarea este utilizată în principal pentru sarcini precum rezervarea tabelelor mici (de exemplu, a dicționarelor) sau distribuirea seturilor de date împreună cu o nouă versiune a aplicației.
Cea mai comună metodă de rezervare a bazelor de date este copierea fișierelor bazei.
"Salvarea" rece a fișierelor DB
Ideea evidentă este de a opri baza de date și a copia toate fișierele sale. Această copie de rezervă se numește "rece". Metoda este extrem de fiabilă și simplă, dar are două dezavantaje evidente:
- Dintr-o copie de rezervă „rece” se poate restaura doar starea bazei de date care era în momentul opririi; tranzacțiile efectuate după repornirea bazei nu vor fi incluse în copia de rezervă „rece”.
- Nu toate bazele de date au un fereastră tehnologică în care baza poate fi oprită.
Dacă backupul „rece” este ceea ce doriți, trebuie să rețineți că
- Copia „rece” trebuie uneori să includă și jurnalele. Metodele de determinare a jurnalelor care trebuie incluse în copia de rezervă „rece” sunt individuale pentru fiecare SGBD. De exemplu, în Oracle este necesar să copiați așa-numitele online redo, adică un număr fix de fișiere jurnal într-un director special, chiar și atunci când baza este oprită corect. În PostgreSQL trebuie să salvați toate jurnalele începând cu jurnalul care conține ultima punct de control, informația despre care este conținută în fișierul de control.
- Directorul bazei de date poate conține fișiere destul de mari de spații de tabel temporar, care nu trebuie incluse în copia de rezervă. Apropo, această observație este valabilă și pentru backupul „fierbinte”.
Salvarea „fierbinte” a fișierelor
Cea mai mare parte a copiilor de rezervă ale bazelor de date moderne se efectuează prin copierea fișierelor bazei de date fără oprirea acesteia. Aici apar câteva probleme:
- În momentul începerii copiei, conținutul bazei de date poate să nu corespundă cu conținutul fișierelor, deoarece o parte din informație se afla în cache și nu a fost încă scrisă pe disk.
- În timpul copierii, conținutul bazei poate fi modificat. Dacă se utilizează structuri de date modificabile, conținutul fișierelor se schimbă, iar dacă se utilizează structuri imuabile, setul de fișiere se schimbă: fișiere noi apar, iar cele vechi sunt eliminate.
- Deoarece scrierea datelor în bază și citirea fișierelor DB nu sunt sincronizate, programul de backup poate citi o pagină incorectă, în care o jumătate provine din versiunea veche a paginii, iar cealaltă jumătate din cea nouă.
Pentru ca o copie de rezervă să fie consistentă, fiecare SGBD are o comandă care comunică că a început procesul de backup. Sintactic, această comandă poate părea diferită:
- în Oracle, aceasta este o comandă separată ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- în PostgreSQL – funcția pg_start_backup();
- În Microsoft SQL Server și DB2, pregătirea pentru backup se efectuează implicit în timpul executării comenzii BACKUP DATABASE;
- În MySQL Enterprise, Cassandra și MongoDB, pregătirea se face implicit printr-un utilitar extern – mysqlbackup, OpsCenter și Ops Manager respectiv.
În ciuda diferențelor sintaxice, procesul de pregătire pentru backup arată similar.
Iată cum se desfășoară pregătirea pentru backup în SGBD-urile cu structuri de disc modulabile, adică în toate sistemele relaționale tradiționale pe disc:
- Se înregistrează momentul începutului backup-ului; copia de rezervă va trebui să conțină jurnalele bazei de date începând din acest moment.
- Se efectuează o punctare, adică toate modificările care au avut loc pe paginile de date până la momentul înregistrat sunt scrise pe disc. Aceasta garantează că jurnalele de dinainte de începutul backup-ului nu vor fi necesare la restaurare.
- Se activează un mod special de jurnalizare: dacă o pagină de date a fost modificată prima dată după ce a fost încărcată de pe disc, atunci în loc să scrie în jurnal modificarea paginii, baza de date va înregistra întreaga pagină. În timpul procedurii de pregătire, toate paginile sunt scrise pe disc, iar prin urmare, la prima modificare, blocul va fi întotdeauna înregistrat în jurnal în întregime. Dar dacă în timpul backup-ului pagina este din nou scrisă pe disc, atunci următoarea sa modificare va duce, de asemenea, la apariția unei copii complete a paginii în jurnal. Acest lucru garantează că, în cazul în care, dintr-un motiv necunoscut, pagina este coruptă în timpul copieri fișierului cu date, aplicarea jurnalului o va reface corect.
- Se blochează modificarea antetelor fișierelor de date, adică acelei părți care nu apare în jurnale. Acest lucru garantează că antetul va fi copiat corect, iar apoi jurnalele vor fi aplicate corect fișierului de date.
După ce toate procedurile enumerate mai sus au fost finalizate, se pot copia fișierele de date folosind mijloacele sistemului de operare – cp, rsync și altele. Activarea modului de rezervă reduce performanța bazei de date: pe de o parte, volumul jurnalelor crește, iar pe de altă parte, dacă în timpul modului de rezervă apare o eroare, restaurarea va dura mai mult, deoarece anteturile fișierelor de date nu sunt actualizate. Cu cât rezervarea se termină mai repede, cu atât mai bine pentru baza de date, așa că utilizarea unor instrumente precum snapshot-ul sistemului de fișiere sau întreruperea miroirului (BCV) în matricea de discuri este adecvată. Unele SGBD-uri (Oracle, PostgreSQL) lasă administratorilor posibilitatea de a alege modalitatea de copiere, iar altele (Microsoft SQL Server) oferă o interfață pentru integrarea propriilor utilitare de rezervare cu mecanismele sistemelor de fișiere sau SCD.
După finalizarea rezervării, baza de date trebuie returnată la starea normală. În Oracle, acest lucru se face cu comanda ALTER DATABASE/TABLESPACE END BACKUP, în PostgreSQL – prin apelarea funcției pg_stop_backup(), iar în alte baze – prin subprograme interne ale comenzii corespunzătoare sau servicii externe.
Iată cum arată o diagramă temporară a procesului de rezervare:
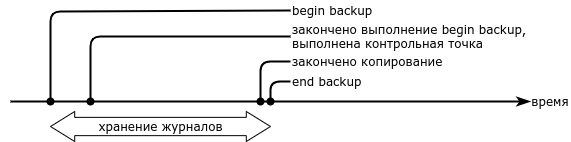
- Pregătirea pentru rezervare (begin backup) consumă timp, uneori semnificativ. Chiar și atunci când se utilizează volumuri miroir sau sisteme de fișiere capabile să realizeze snapshot-uri, procesul de rezervare nu va fi instantaneu.
- Împreună cu fișierele de date, este necesar să se păstreze jurnalele începând de la momentul începerii pregătirii pentru rezervare și până la momentul în care baza revine la starea normală.
- Se poate restaura din această rezervă la momentul întoarcerii bazei la starea normală. Restaurarea la un moment anterior nu este posibilă.
Situația este mai simplă cu bazele de date care folosesc structuri de date imuabile (snapshot-uri de memorie, arbori LSM). Pregătirea pentru rezervare constă în următorii pași:
- Datele din memorie sunt scrise pe disc.
- Se fixează lista fișierelor care intră în rezervă. Până la finalizarea procesului de rezervare, bazei îi este interzis să șteargă aceste fișiere, chiar dacă ele devin inutile.
La semnalul de încheiere a copiei de rezervă, baza cu structuri nemodificabile poate din nou să șteargă fișierele inutile.
Restaurare la un punct
Copia de rezervă permite restaurarea stării bazei de date la momentul în care comanda de revenire din modul de rezervare s-a încheiat. Cu toate acestea, o defecțiune, după care va fi necesară restaurarea, se poate produce în orice moment. Sarcina de a restaura starea Bazei de Date la un moment ales se numește „restaurare la un punct” (point-in-time recovery).
Pentru a asigura această posibilitate, trebuie să se păstreze jurnalul Bazei de Date începând din momentul încheierii copiei de rezervă, iar în timpul restaurării să se aplice în continuare jurnalele la copia restaurată. După ce Baza de Date este restaurată din copia de rezervă la momentul încheierii copiilor, starea bazei (fișierele și paginile de memorie cache) este garantat corectă, așadar nu este nevoie de un mod special de jurnalizare. Aplicând jurnalele până la momentul dorit, se poate obține starea bazei de date în orice punct în timp.
Dacă viteza de restaurare a copiei de rezervă este limitată doar de lățimea de bandă a discului, atunci viteza de aplicare a jurnalelelor este de obicei limitată de performanța procesorului. Dacă în baza de date principală se produc modificări în mod paralel, atunci la restaurare toate modificările sunt efectuate secvențial - în ordinea citirii din jurnal. Astfel, timpul de restaurare depinde liniar de cât de departe este punctul de restaurare față de punctul de încheiere a copiei de rezervă. Din această cauză, este necesar să se facă destul de frecvent copii de rezervă complete - cel puțin o dată pe săptămână pentru bazele cu o sarcină de tranzacții mică și până la copii zilnice pentru bazele cu o încărcare mare.
Copia de rezervă incrementală
Pentru a accelera restaurarea la un punct, s-ar dori să avem posibilitatea de a efectua copii de rezervă cât mai des posibil, dar fără a ocupa spațiu suplimentar pe discuri și fără a suprasolicita baza cu sarcini de copiere.
Soluția problemei este copierea de rezervă incrementală, adică copierea doar a acelora pagini de date care s-au modificat de la ultima copiere de rezervă.
Backup-urile incrementale au sens doar pentru SGBD-uri care utilizează structuri de date modificabile.
Incrementul poate fi calculat fie de la o copie de rezervă completă (copie cumulativă), fie de la orice copie anterioară (copie diferențială).
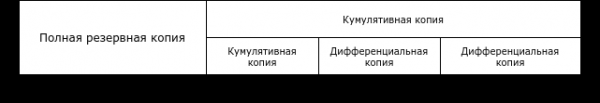
Din păcate, nu există o terminologie unificată, iar diferiți furnizori folosesc termeni diferiți:
Diferențială
Cumulativă
Oracle
Diferențial
Cumulativ
PostgresPro
Incremental
—
Microsoft SQL Server
—
Diferențial
IBM DB2
Delta
Incremental
În cazul copiilor incrementale, procesul de restaurare la un punct arată astfel:
- se restaurează ultima copie de rezervă completă efectuată înainte de momentul restaurării;
- peste copia completă se restaurează copiile incrementale;
- se aplică jurnalele de la punctul de început al copiei de rezervă până la punctul de restaurare.
Existenta unei copii cumulative accelerează procesul de restaurare. De exemplu, pentru a restaura starea bazei de date la un punct între T3 și T4 este necesară restaurarea a două copii incrementale, iar pentru restaurarea la un punct după T4 – doar una.
Este evident că volumul unei copii cumulative este mai mic decât volumul mai multor copii diferentiale, deoarece unele pagini s-au modificat de mai multe ori, iar fiecare copie incrementală conține propria versiune a paginii.
Există trei moduri de a crea o copie incrementală:
- crearea unei copii complete și calcularea diferenței față de copia completă anterioară;
- analiza jurnale, crearea unei liste de pagini modificate și rezervarea paginilor incluse în listă;
- solicitarea paginilor modificate din baza de date.
Prima metodă economisește spațiu pe disc, dar nu rezolvă problema reducerii încărcării pe baza de date. Mai mult, dacă avem o copie de rezervă completă, transformarea acesteia într-o copie incrementală nu are sens, deoarece restaurarea unei copii complete este mai rapidă decât restaurarea unei copii complete anterioare și a unui increment. Problema economiei de spațiu pe disc cu această abordare ar trebui mai bine transfomată pe componente speciale cu mecanisme integrate de deduplicare. Acestea pot fi fie sisteme de stocare specializate (EMC DataDomain, HPE StorageWorks VLS, întreaga gamă NetApp), fie produse software (ZFS, Veritas NetBackup PureFile, Deduplicare de date Windows Server).
Al doilea și al treilea mod diferă prin mecanismul de determinare a listei paginilor modificate. Analiza jurnalelor este mai consumatoare de resurse, plus că pentru implementarea sa este necesar să se cunoască structura fișierelor jurnal. Cel mai simplu este să întrebi baza de date care pagini s-au modificat, dar pentru aceasta nucleul SGBD-ului trebuie să aibă funcționalitatea de urmărire a blocurilor modificate (block change tracking).
Funcționalitatea de backup incrementale a fost creată pentru prima dată în software-ul Oracle Recovery Manager (RMAN), apărut în versiunea Oracle 8i. Oracle a implementat imediat urmărirea blocurilor modificate, așa că nu este necesară analiza jurnalelor.
PostgreSQL nu urmărește blocurile modificate, astfel că utilitarul pg_probackup, dezvoltat de compania rusă Postgres Professional, determină paginile modificate prin analiza jurnalului. Totuși, compania furnizează și SGBD-ul PostgresPro, care include extensia ptrack, ce urmărește modificările paginilor. Atunci când se folosește pg_probackup cu SGBD-ul PostgresPro, utilitarul solicită paginile modificate direct de la baza de date – la fel ca RMAN.
Microsoft SQL Server, la fel ca Oracle, urmărește paginile modificate, dar comanda BACKUP permite realizarea doar a backup-urilor complete și cumulative.
În DB2 există posibilitatea de a urmări paginile modificate, dar în mod implicit aceasta este dezactivată. După activare, DB2 va permite realizarea de backup-uri complete, diferențiale și cumulative.
O diferență importantă între instrumentele descrise în această secțiune (cu excepția pg_probackup) și instrumentele de backup pe fișiere este că acestea solicită imagini ale paginilor de la baza de date, și nu citesc datele de pe disc pe cont propriu. Dezavantajul acestui abordări este o sarcină suplimentară minoră pe baza de date. Totuși, acest dezavantaj este compensat pe deplin de faptul că pagina citită este întotdeauna corectă, deci nu este necesar să se activeze un mod special de jurnalizare în timpul backup-ului.
Încă o dată, rețineți că existența copiilor incrementale nu anulează cerințele de a avea jurnale pentru restaurarea la un punct arbitrar în timp. De aceea, în bazele de date industriale, jurnalele sunt scrise constant pe un mediu extern, iar backup-urile, complete și/sau incrementale, sunt realizate conform unui program.
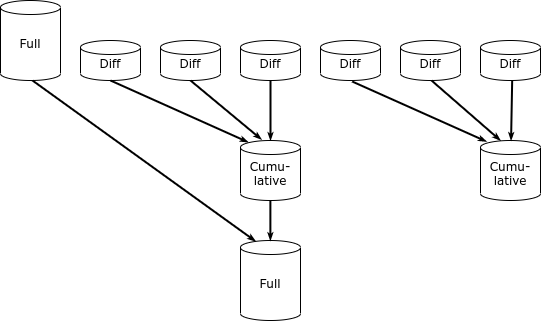
Cea mai bună implementare a ideii de backup incremental disponibilă astăzi este complexul software-hardware (în terminologia Oracle - sistem proiectat) Zero Data Loss Recovery Appliance - o soluție specializată Oracle pentru backup-ul bazei de date proprii. Complexul reprezintă un cluster servere cu un volum mare de discuri, pe care este instalată o versiune modificată a software-ului Recovery Manager și poate funcționa atât cu alte complexe software-hardware Oracle (Database Appliance, Exadata, SPARC Supercluster), cât și cu bazele de date Oracle pe o infrastructură tradițională. Spre deosebire de RMAN „obișnuit”, în ZDLRA este implementată concepția de „incremental forever”. Sistemul creează o copie completă a bazei de date o singură dată, iar apoi realizează doar copii incrementale. Modulele suplimentare RMAN permit combinarea copiilor, creând noi copii complete din cele incrementale.
În onoarea dezvoltatorilor ruși, trebuie menționat că și pg_probackup poate combina copiile incrementale.
Spre deosebire de multe întrebări asemănătoare, întrebarea „care metodă de backup este cea mai bună” are un răspuns clar - cel mai bine este utilizată utilitarul nativ pentru SGBD-ul utilizat, care oferă posibilitatea de backup incremental.
Pentru administratorul de baze de date, întrebările legate de alegerea strategiei de backup și integrarea instrumentelor de backup ale bazelor de date în infrastructura corporativă sunt mult mai importante. Dar aceste întrebări depășesc cadrul acestui articol.
Sursa: habr.com
