

Să examinăm conceptul de monitorizare Kubernetes, să ne familiarizăm cu instrumentul Prometheus și să discutăm despre alertele.
Tema monitorizării este amplă, nu poate fi acoperită într-un singur articol. Scopul acestui text este de a oferi o prezentare generală a instrumentelor, conceptelor și abordărilor.
Materialul articolului este o sinteză din . Dacă doriți să urmați o pregătire completă - înscrieți-vă la cursul despre .
Ce se monitorizează în clusterul Kubernetes
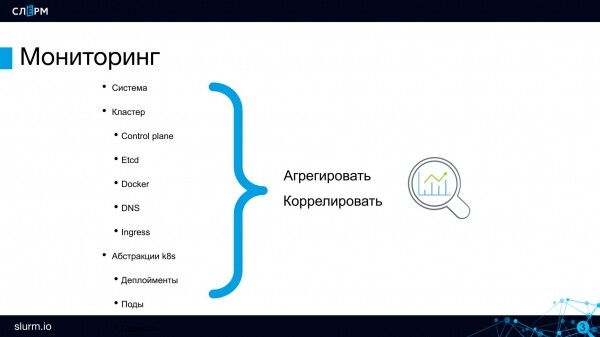
Servere fizice. Dacă clusterul Kubernetes este desfășurat pe serverele proprii, trebuie să urmăriți starea acestora. Această sarcină este gestionată de Zabbix; dacă lucrați cu acesta, nu trebuie să renunțați, nu vor apărea conflicte. Starea serverelor noastre este monitorizată de Zabbix.
Să trecem la monitorizarea la nivel de cluster.
Componentele Control Plane: API, Scheduler și altele. Cel puțin, trebuie să urmăriți ca serverele API sau etcd să fie mai mult de 0. Etcd poate oferi multe metrice: despre discurile pe care rulează, despre sănătatea propriului cluster etcd și altele.
Docker a apărut demult și problemele sale sunt bine cunoscute: numeroasele containere provoacă blocaje și alte probleme. De aceea, trebuie să monitorizăm și Docker-ul ca sistem, măcar pentru disponibilitatea acestuia.
DNS-ului. Dacă DNS-ul din cluster se oprește, atunci tot serviciul de Discovery se va opri, iar cererile dintre poduri nu vor mai funcționa. În practică, nu am întâmpinat astfel de probleme, dar asta nu înseamnă că nu trebuie să urmăriți starea DNS-ului. Întârzierile în cereri și alte metrice pot fi monitorizate pe CoreDNS.
Ingress. Trebuie să monitorizăm disponibilitatea ingress-urilor (inclusiv Ingress Controller) ca puncte de acces în proiect.
Am discutat despre componentele principale ale clusterului - acum să coborâm mai jos, la nivelul abstracțiilor.
Se părea că aplicațiile rulează în poduri, așa că ar trebui să fie monitorizate, dar de fapt nu este necesar. Podurile sunt efemere: astăzi rulează pe un server, mâine pe altul; astăzi sunt 10, mâine 2. Prin urmare, nimeni nu monitorizează doar podurile. În cadrul arhitecturii microserviciilor, este mai important să monitorizăm disponibilitatea aplicației în ansamblu. În special, să verificăm dacă end-point-urile serviciului sunt disponibile: funcționează ceva? Dacă aplicația este disponibilă, atunci ce se întâmplă în spatele ei, câte replici sunt acum - aceste întrebări sunt de ordine secundară. Nu este necesar să urmăriți instanțele individuale.
La nivelul final, trebuie să monitorizăm funcționarea aplicației în sine, să extragem metricile de afaceri: numărul de comenzi, comportamentul utilizatorilor și altele.
Prometheus
Cea mai bună sistemă pentru monitorizarea clusterului este . Nu cunosc nici un instrument care să se compare cu Prometheus în ceea ce privește calitatea și ușurința utilizării. Este excelent pentru infrastructuri flexibile, așa că atunci când se vorbește despre „monitorizarea Kubernetes”, de obicei, se referă la Prometheus.
Există câteva opțiuni pentru a începe să lucrăm cu Prometheus: cu ajutorul Helm putem instala fie Prometheus obișnuit, fie Prometheus Operator.
- Prometheus obișnuit. Funcționează bine, dar trebuie să configurăm ConfigMap — practic, să scriem fișiere de configurare textuale, așa cum făceam înainte de arhitectura microservicii.
- Prometheus Operator este puțin mai complex, mai greu de înțeles pe interior, dar este mai ușor de utilizat: există obiecte separate, aberațiile sunt adăugate în cluster, de aceea este mult mai convenabil să le controlezi și să le configurezi.
Pentru a înțelege produsul, recomand mai întâi să instalați Prometheus obișnuit. Va trebui să configurați totul prin configurație, dar aceasta vă va ajuta: veți înțelege ce este ce și cum se configurează. Cu Prometheus Operator, începeți imediat pe un nivel superior de abstractizare, deși, dacă doriți să explorați adâncurile, și acest lucru va fi posibil.
Prometheus este bine integrat cu Kubernetes: poate accesa API Server și interacționa cu acesta.
Prometheus este popular, astfel că este susținut de un număr mare de aplicații și limbaje de programare. Suportul este necesar, deoarece Prometheus are propriul format de metrici, iar pentru a-l transmite este nevoie fie de o bibliotecă în aplicație, fie de un exportator gata făcut. Există destul de multe asemenea exportatoare. De exemplu, există PostgreSQL Exporter: acesta extrage date din PostgreSQL și le convertește în formatul Prometheus, astfel încât Prometheus să poată lucra cu ele.
Arhitectura Prometheus
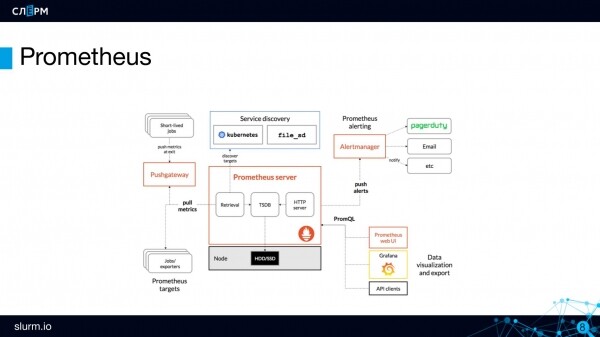
Serverul Prometheus — este partea server side, creierul lui Prometheus. Aici sunt stocate și procesate metricile.
Metricile sunt stocate într-o bază de date time series (TSDB). TSDB nu este o bază de date separată, ci un pachet în limbajul Go, care este înglobat în Prometheus. În linii mari, totul se află într-un singur binar.
Nu păstrați datele în TSDB pentru o perioadă lungă.
Infrastructura Prometheus nu este potrivită pentru stocarea pe termen lung a metricilor. Implicit, perioada de stocare este de 15 zile. Această limitare poate fi depășită, dar trebuie să aveți în vedere: cu cât stocați mai multe date în TSDB și cu cât mai mult timp, cu atât mai multe resurse va consuma. Stocarea datelor istorice în Prometheus este considerată o practică proastă.
Dacă aveți un trafic imens, iar numărul metricilor se ridică la sute de mii pe secundă, este mai bine să limitați stocarea acestora în funcție de capacitatea de disc sau de termen. De obicei, în TSDB sunt stocate „datele calde”, metricile de câteva ore. Pentru stocarea pe termen lung se folosesc stocări externe în baze de date care sunt cu adevărat potrivite pentru aceasta, cum ar fi InfluxDB, ClickHouse și altele. Am văzut mai multe recenzii bune despre ClickHouse.
Prometheus Server funcționează pe modelul pull: el se ocupă singur de obținerea metricilor de la acele end-point-uri pe care le-am furnizat. Am spus: „mergi la API Server”, iar el accesează acolo la fiecare n-seconds și preia metricile.
Pentru obiectele cu o durată scurtă de viață (job sau cron job), care pot apărea între perioadele de scrapping, există componenta Pushgateway. Metricile sunt trimise în Pushgateway de către obiectele pe termen scurt: jobul s-a ridicat, a efectuat acțiunea, a trimis metricile în Pushgateway și s-a finalizat. După un timp, Prometheus își va relua ciclul și va prelua acele metrici din Pushgateway.
Pentru configurarea notificărilor în Prometheus există o componentă separată — Alertmanager. Iar regulile de alertare — alerting rules. De exemplu, trebuie să creăm un alert în cazul în care serverele API ajung la 0. Când evenimentul se declanșează, alertul este transmis către alert manager pentru trimitere ulterioară. În alert manager există setări de rutare destul de flexibile: un grup de alerte poate fi trimis în chat-ul de Telegram al administratorilor, altul în chat-ul dezvoltatorilor, iar al treilea în chat-ul infrastructuriștilor. Notificările pot veni prin Slack, Telegram, pe email și în alte canale.
Și, în final, vreau să vă povestesc despre funcția remarcabilă a Prometheus — Discovering. Când lucrați cu Prometheus, nu trebuie să specificați adresele exacte ale obiectelor pentru monitorizare, ci este suficient să definiți tipul lor. Adică nu trebuie să scrieți „iată IP-ul, iată portul — monitorizează”, ci trebuie să definiți pe ce principii să găsiți aceste obiecte (ținte — ținte). Prometheus se ocupă singur, în funcție de obiectele active, de aducerea acestora și de adăugarea lor la monitorizare.
Această abordare se integrează bine în structura Kubernetes, unde totul este fluctuant: azi 10 servere, mâine 3. Pentru a nu trebui să indicăm de fiecare dată adresa IP a serverului, am scris o dată cum să îl găsim - și Discovering va face acest lucru.
Limbajul Prometheus se numește PromQL. Cu acest limbaj, se pot extrage valorile unor metrici specifice și apoi le putem transforma, construind analize pe baza lor.
https://prometheus.io/docs/prometheus/latest/querying/basics/

O interogare simplă

    container_memory_usage_bytes

Operații matematice

    container_memory_usage_bytes / 1024 / 1024

Funcții încorporate

    sum(container_memory_usage_bytes) / 1024 / 1024

Clarificarea interogării

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Interfața web Prometheus
Prometheus are o interfață web destul de minimalistă. Acesta este mai degrabă potrivită pentru debugging sau demonstrare.
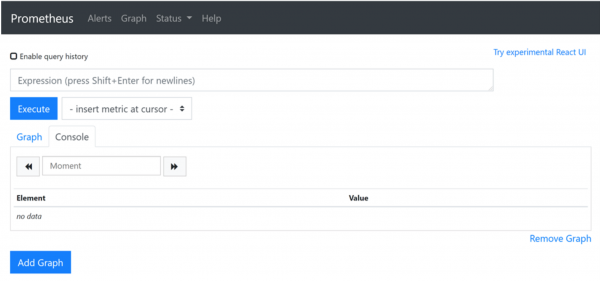
În câmpul Expression se poate scrie o interogare în limba PromQL.
În tab-ul Alerts se află regulile de alertă - alerting rules, care au trei stări:
- inactive - dacă alerta nu este activă în momentul de față, adică totul este bine și nu a fost declanșată;
- pending - în cazul în care alerta a fost declanșată, dar trimiterea nu a avut loc încă. Întârzierea se stabilește pentru a compensa fluctuațiile rețelei: dacă un serviciu a fost repornit în termen de un minut, nu este necesar să se genereze alarmă;
- firing - acesta este al treilea statut, când alerta se aprinde și trimite mesaje.
În meniul Status veți găsi acces la informații despre ce reprezintă Prometheus. Acolo există de asemenea o legătură către țintele (targets) despre care am vorbit mai sus.
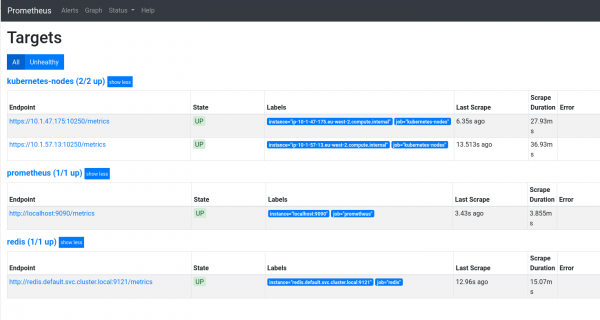
Pentru o evaluare mai detaliată a interfeței Prometheus, consultați .
Integrarea cu Grafana
În interfața web Prometheus nu veți găsi grafice frumoase și clare din care să se poată deduce starea clusterului. Pentru a le construi, Prometheus se integrează cu Grafana. Rezultă astfel de dashboards.
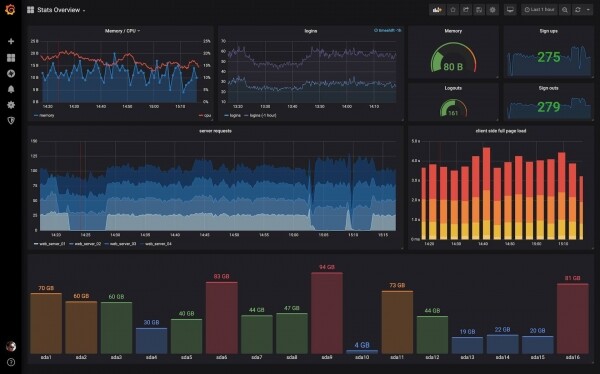
Configurarea integrării între Prometheus și Grafana nu este deloc complicată, găsiți instrucțiunile în documentație: , iar eu voi încheia aici.
În următoarele articole vom continua tema monitorizării: vom discuta despre colectarea și analiza logurilor folosind Grafana Loki și instrumente alternative.
Autor: Marcel Ibraev, administrator certificat Kubernetes, inginer practicant la compania , speaker și dezvoltator al cursurilor Slurm.
Sursa: habr.com
