

Am început să ne gândim la crearea unui sistem de monitorizare în etapa de formare a echipelor de produs. A devenit clar că activitatea noastră — operarea — nu face parte din aceste echipe. De ce este așa?
Problema este că toate echipele noastre sunt construite în jurul unor sisteme informaționale separate, microservicii și fronturi, de aceea starea generală de sănătate a întregului sistem nu este vizibilă pentru echipe. De exemplu, ele pot să nu știe cum o mică parte dintr-un backend profund influențează partea de front. Domeniul lor de interes este limitat la sistemele cu care sistemul lor este integrat. Dacă echipa și serviciul A nu sunt aproape deloc legați de serviciul B, atunci acest serviciu pentru echipă devine aproape invizibil.
Echipa noastră, pe de altă parte, lucrează cu sisteme care sunt foarte interconectate: între ele există multe legături, ceea ce formează o infrastructură destul de mare. Și funcționarea tuturor acestor sisteme (care, de altfel, sunt foarte multe) depinde de funcționarea magazinului online.
Astfel, departamentul nostru nu aparține niciunei echipe și se află puțin în afară. În toată această poveste, sarcina noastră este să înțelegem în ansamblu cum funcționează sistemele informaționale, funcționalitatea lor, integrările, software-ul, rețeaua, hardware-ul și cum sunt toate acestea interconectate.
Platforma pe care funcționează magazinele noastre online arată astfel:
- front
- middle-office
- back-office
Oricât de mult ne-am dori, nu existe o situație în care toate sistemele să funcționeze fără probleme și impecabil. Din nou, acest lucru se datorează numărului de sisteme și integrări — cu un număr așa cum avem noi, anumite incidente sunt inevitabile, în ciuda calității testării. Acest lucru se aplică atât în interiorul unui sistem separat, cât și în ceea ce privește integrările lor. Este necesar să monitorizăm starea întregii platforme în ansamblu, și nu doar a unei părți separate a acesteia.
În ideal, monitorizarea stării de sănătate a întregii platforme ar trebui automatizată. Și am ajuns la monitorizare ca la o parte inevitabilă a acestui proces. Inițial, a fost construită doar pentru partea de front, având în vedere că sistemele de monitorizare pe straturi existau și există pentru rețelari, administratori de software și hardware. Toți acești oameni monitorizau doar la nivelul lor, fără a avea o înțelegere complexă.
De exemplu, dacă o mașină virtuală cade, de cele mai multe ori, doar administratorul responsabil cu hardware-ul și cu mașina virtuală este la curent cu acest lucru. Echipa de front-end, în astfel de cazuri, a observat doar faptul că aplicația a picat, dar nu avea date despre căderea mașinii virtuale. Iar administratorul poate ști cine este clientul și își poate imagina ce rulează în acel moment pe această mașină virtuală, cu condiția să fie un proiect mare. Probabil că nu știe despre cele mici. Oricum, administratorul trebuie să meargă la proprietar, să întrebe ce a fost pe această mașină, ce trebuie restaurat și ce trebuie schimbat. Iar dacă s-a defectat ceva cu adevărat grav, începea alergătura, pentru că nimeni nu vedea sistemul în ansamblu.
În cele din urmă, aceste povești disparate influențează întreg front-end-ul, utilizatorii și funcția noastră principală de afaceri – vânzările online. Deoarece nu facem parte din echipe, ci ne ocupăm de operarea tuturor aplicațiilor de comerț electronic din cadrul magazinului online, ne-am asumat sarcina de a crea un sistem de monitorizare complex pentru platforma de comerț electronic.
Structura sistemului și tehnologia
Am început prin a identifica câteva straturi de monitorizare pentru sistemele noastre, pe care va trebui să le colectăm metricile. Și toate acestea trebuiau integrate, ceea ce am realizat în prima etapă. În prezent, pentru această etapă, îmbunătățim colectarea metricilor în mod cât mai calitativ pentru toate straturile noastre, astfel încât să putem stabili corelații și să înțelegem cum se influențează sistemele între ele.
Lipsa monitorizării complexe în etapele inițiale de lansare a aplicațiilor (deoarece am început să o construim când cea mai mare parte a sistemelor era deja în exploatare) a dus la acumularea unei datorii tehnice semnificative privind configurarea monitorizării întregii platforme. Nu ne-am putut permite să ne concentrăm pe configurarea monitorizării unei singure IS și să o detaliem, deoarece celelalte sisteme ar fi rămas fără monitorizare pentru o vreme. Pentru a rezolva această problemă, am definit o listă a celor mai necesare metrici pentru evaluarea stării sistemului informațional pe straturi și am început să o implementăm.
Așa că am decis să mâncăm elefantul pe bucăți.
Sistemul nostru este compus din:
- hardware;
- sistem de operare;
- software;
- Părțile UI din aplicația de monitorizare;
- metricele de afaceri;
- aplicațiile de integrare;
- securitatea informației;
- rețele;
- echilibrorul de trafic.
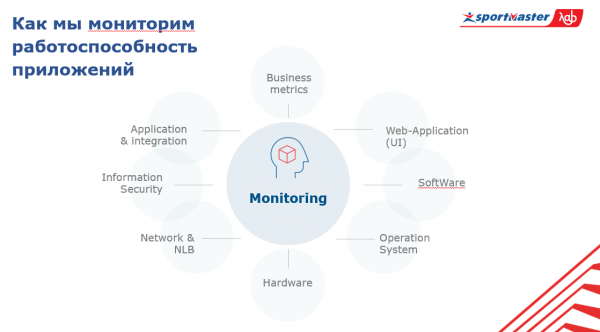
În centrul acestui sistem se află propriul proces de monitorizare. Pentru a înțelege starea întregului sistem, trebuie să știm ce se întâmplă cu aplicațiile pe toate aceste straturi și în cadrul întregului ansamblu de aplicații.
Așadar, despre stivă.
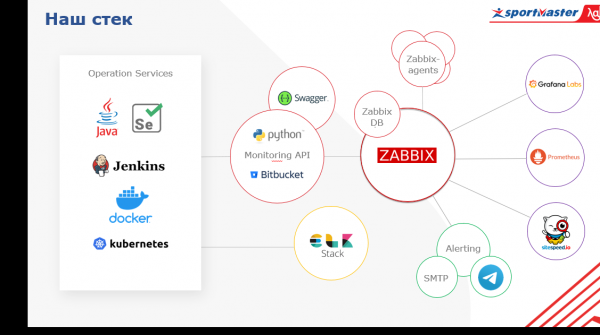
Folosim software cu sursă deschisă. În centrul nostru se află Zabbix, pe care îl folosim în primul rând ca sistem de alertare. Toată lumea știe că este ideal pentru monitorizarea infrastructurii. Ce se înțelege aici? Exact acele metrice de nivel scăzut, care sunt prezente în fiecare companie care deține propriul său datacenter (iar Sportmaster are propriile sale datacentere) — temperatura serverului, starea memoriei, RAID-ului, metricele dispozitivelor de rețea.
Am integrat Zabbix cu messenger-ul Telegram și Microsoft Teams, utilizate activ în echipe. Zabbix acoperă stratul rețelei fizice, hardware-ului și parțial al software-ului, dar nu este o panaceu. Îmbogățim aceste date din alte servicii. De exemplu, la nivelul hardware-ului ne conectăm direct prin API în sistemul nostru de virtualizare și extragem datele.
Ce încă. Pe lângă Zabbix, folosim Prometheus, care permite monitorizarea metricilor în aplicația mediului dinamic. Asta înseamnă că putem obține metricele aplicației prin endpoint HTTP și nu ne facem griji cu privire la ce metrice să încărcăm în ea, și care nu. Pe baza acestor date, putem dezvolta interogări analitice.
Sursele datelor pentru celelalte straturi, de exemplu, metricele de afaceri, se împart în trei componente.
În primul rând, sunt sistemele externe de afaceri, Google Analytics, colectăm metrice din loguri. Din acestea obținem date despre utilizatorii activi, conversie și tot ce ține de afaceri. În al doilea rând, este sistemul de monitorizare UI. Acesta merită o descriere mai detaliată.
Cândva am început cu testarea manuală și a evoluat în teste automate de funcționalitate și integrare. Din acestea am realizat monitorizarea, păstrând doar funcționalitatea de bază, și ne-am legat de markerii care sunt cei mai stabili și nu se schimbă frecvent în timp.
Noua structură a echipelor presupune că întreaga activitate legată de aplicații este coordonată de echipele de produs, așa că ne-am oprit să ne mai ocupăm de testarea pură. În schimb, am transformat testele în monitorizare UI, scrisă în Java, Selenium și Jenkins (folosit ca sistem de lansare și generare de rapoarte).
Am avut multe teste, dar, în cele din urmă, am decis să ne concentrăm pe drumul principal, o metrică de nivel superior. Și dacă avem multe teste specifice, va fi dificil să menținem actualitatea datelor. Fiecare lansare ulterioară va rupe semnificativ întreaga sistemă, iar noi ne vom ocupa doar de repararea acesteia. Prin urmare, ne-am axat pe lucruri fundamentale, care se schimbă rar, și monitorizăm doar aceste aspecte.
În cele din urmă, sursa de date este un sistem centralizat de logare. Folosim Elastic Stack pentru loguri, iar apoi putem extrage aceste date în sistemul nostru de monitorizare pe baza metricilor de afaceri. În plus, avem propriul nostru serviciu Monitoring API, scris în Python, care interoghează orice servicii prin API și extrage date din acestea în Zabbix.
Un alt atribut indispensabil al monitorizării este vizualizarea. La noi, aceasta este construită pe baza Grafana. Printre alte sisteme de vizualizare, se remarcă prin faptul că pe tabloul de bord se pot vizualiza metricile din diferite surse de date. Putem aduna metrici de nivel superior pentru un magazin online, cum ar fi numărul de comenzi plasate în ultima oră, din baza de date, metrici de performanță ale sistemului de operare pe care rulează acest magazin online, din Zabbix, și metrici ale instanțelor acestei aplicații din Prometheus. Și toate acestea vor apărea pe un singur tablou de bord. Clar și accesibil.
Îmi permit să menționez securitatea — acum finalizăm sistemul pe care ulterior îl vom integra cu sistemul global de monitorizare. Din punctul meu de vedere, problemele principale cu care se confruntă sectorul de e-commerce în domeniul securității informației sunt legate de boți, parseri și atacuri de tip bruteforce. Este important să monitorizăm aceste aspecte, deoarece ele pot afecta critic atât funcționarea aplicațiilor noastre, cât și reputația din punct de vedere al afacerii. Cu stiva aleasă, acoperim aceste sarcini cu succes.
Un alt aspect important este că nivelul aplicațiilor este compilat de Prometheus. Acesta este, de asemenea, integrat cu Zabbix. De asemenea, avem sitespeed, un serviciu care ne permite să monitorizăm parametri precum viteza de încărcare a paginii noastre, blocajele, redarea paginii, încărcarea scripturilor și altele, care sunt integrate prin API. Astfel, metricile sunt colectate în Zabbix, iar alertele sunt trimise tot de acolo. Toate alertele sunt trimise momentan prin principalele metode (până acum email și telegram, recent am conectat și MS Teams). Planificăm să îmbunătățim sistemul de alarmare pentru a permite boturilor inteligente să funcționeze ca un serviciu și să furnizeze informații despre monitorizare tuturor echipelor de produs interesate.
Pentru noi, metricile sunt importante nu doar pentru sistemele informatice individuale, ci și metricile generale pentru întreaga infrastructură utilizată de aplicații: clustere servere fizice, pe care rulează mașinile virtuale, balanțatoare de trafic, Network Load Balancer-uri, rețeaua în sine, utilizarea canalelor de comunicație. În plus, avem metrici pentru centrele noastre de date (avem mai multe și infrastructura este de dimensiuni destul de semnificative).
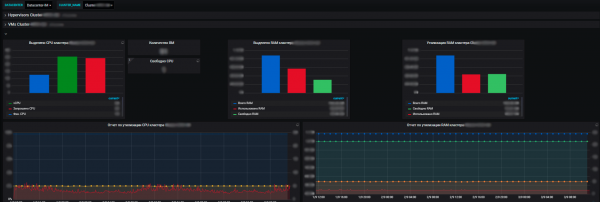
Avantajele sistemului nostru de monitorizare sunt că ne permite să vedem starea de funcționare a tuturor sistemelor, putem evalua impactul pe care îl au asupra unii altora și asupra resurselor generale. În cele din urmă, ne ajută să planificăm resursele, ceea ce este, de asemenea, în responsabilitatea noastră. Gestionăm resursele serverelor — un pool în cadrul e-commerce, introducem și scoatem din exploatare echipamente noi, achiziționăm echipamente suplimentare, efectuăm audite ale utilizării resurselor și altele. În fiecare an echipele planifică proiecte noi, dezvoltă sistemele proprii, și este important pentru noi să le asigurăm resursele necesare.
Și prin intermediul metricilor vedem tendințele de consum de resurse ale sistemelor noastre informatice. Pe baza acestora, putem planifica ceva. La nivelul virtualizării, colectăm date și vedem informațiile despre cantitatea disponibilă de resurse în funcție de centrele de date. Iar în interiorul unui centru de date, se poate observa atât utilizarea, cât și distribuția efectivă și consumul de resurse. Acest lucru se aplică atât serverelor standalone, cât și mașinilor virtuale și clusterelor de servere fizice, pe care toate aceste mașini virtuale rulează eficient.
Perspective
Acum avem nucleul sistemului pregătit în linii mari, însă mai sunt suficiente aspecte la care trebuie să lucrăm. Cel puțin, acesta este stratul de securitate informațională, dar este important să ajungem și la rețea, să dezvoltăm un sistem de alertare și să rezolvăm problema corelației. Avem multe straturi și sisteme, iar pe fiecare strat există multe metrici. Rezultatul este un matrioshka în gradul matrioshka.
Sarcina noastră finală este de a crea alerte corecte. De exemplu, dacă apare o problemă cu partea hardware, din nou, cu mașina virtuală, unde era o aplicație importantă, iar serviciul nu era deloc rezervat. Vom afla că mașina virtuală a ceda. Apoi, vor fi alertate metricile de afaceri: utilizatorii au dispărut, nu există conversii, UI-ul din interfață este inaccesibil, software-ul și serviciile au cedat, de asemenea.
În această situație, vom obține spam din alerte, ceea ce deja nu se potrivește cu formatul unui sistem de monitorizare corect. Apare întrebarea corelației. De aceea, idealul pentru sistemul nostru de monitorizare ar trebui să fie: „Băieți, v-a murit mașina fizică, iar împreună cu ea, această aplicație și aceste metrici”, cu ajutorul unei singure alerte, în loc să fim bombardați cu o sută de alerte. Trebuie să informeze despre esențial - despre cauza, ceea ce contribuie la rapiditatea soluționării problemei prin localizarea acesteia.
Sistemul nostru de notificare și procesarea alertelor este construit în jurul unei linii telefonice de urgență disponibile 24/7. Toate alertele care sunt considerate esențiale și sunt incluse în lista de verificare sunt transmise acolo. Fiecare alertă trebuie să aibă neapărat o descriere: ce s-a întâmplat, ce înseamnă aceasta, asupra a ce influențează. De asemenea, un link către tabloul de bord și un ghid despre ce trebuie să facem în acest caz.
Acestea sunt toate cerințele privind construirea alertelor. În continuare, situația se poate dezvolta în două direcții - fie există o problemă și trebuie să o soluționăm, fie a avut loc o defecțiune în sistemul de monitorizare. Dar, în orice caz, trebuie să mergem și să investigăm.
În medie, în prezent primeam aproximativ o sută de alerte pe zi, ținând cont de faptul că corelația alertelor nu este încă configurată corespunzător. Și dacă avem nevoie să efectuăm lucrări tehnice, iar noi deconectăm ceva forțat, numărul lor crește de câteva ori.
Pe lângă monitorizarea sistemelor pe care le exploatăm și colectarea metrilor considerați importanți de echipa noastră, sistemul de monitorizare permite colectarea datelor pentru echipele de produs. Acestea pot influența compunerea metrilor în cadrul sistemelor informaționale pe care le monitorizăm.
Coloaboratorul nostru poate veni și poate cere adăugarea unei metrici care ar putea fi utilă atât pentru noi, cât și pentru echipă. Sau, de exemplu, echipei i-ar putea lipsi acele metrice de bază pe care le avem, având nevoie să monitorizeze o metrică specifică. În Grafana, creăm un spațiu pentru fiecare echipă și le oferim drepturi de administrator. De asemenea, dacă echipa are nevoie de tablouri de bord și ei nu pot sau nu știu cum să le creeze, îi ajutăm.
Fiindcă suntem în afara fluxului de creare a valorii echipei, a lansărilor și a planificării, ajungem treptat să avem lansări ale tuturor sistemelor fără sincope, care pot fi implementate zilnic, fără a ne coordona cu noi. Este important pentru noi să monitorizăm aceste lansări, deoarece pot afecta funcționarea aplicației și pot provoca probleme, ceea ce este critic. Pentru gestionarea lansărilor, folosim Bamboo, de unde primim date prin API și putem vedea ce lansări au avut loc în ce sisteme informaționale și statutul acestora. Cel mai important — la ce oră. Marcajele de lansare le suprapunem pe principalele metrici critice, ceea ce este foarte indicativ în caz de probleme.
Astfel, putem vedea corelația între noile lansări și problemele care apar. Ideea principală este de a înțelege cum funcționează sistemul la toate nivelurile, de a localiza rapid problema și de a o corecta la fel de repede. Fiindcă, adesea, ceea ce ia cel mai mult timp nu este soluționarea problemelor, ci găsirea cauzei acestora.
În acest domeniu, ne dorim să ne concentrăm pe proactivitate în viitor. Ideal ar fi să aflăm din timp despre o problemă iminentă, nu după ce aceasta a apărut, pentru a putea preveni, nu pentru a soluționa. Uneori, sistemul de monitorizare generează alarme false, fie din cauza erorilor umane, fie din cauza modificărilor în aplicație. Lucrăm la acest aspect, perfecționându-l, și ne străduim să informăm utilizatorii care lucrează cu noi despre orice manevre efectuate asupra sistemului de monitorizare, fie înainte de a le face, fie să le realizăm în feroneria tehnică.
Așadar, sistemul a fost lansat și funcționează cu succes de la începutul primăverii... și prezintă profituri destul de semnificative. Desigur, aceasta nu este versiunea finală, vom implementa multe alte funcționalități utile. Dar în acest moment, având în vedere numărul mare de integrații și aplicații, fără automatizarea monitorizării nu ne putem descurca.
Dacă și tu monitorizezi mari proiecte cu un număr considerabil de integrații, scrie în comentarii ce soluții eficiente ai găsit pentru asta.
Sursa: habr.com
