

Multe persoane sunt familiarizate cu sistemul de gestiune a bazelor de date PostgreSQL, care a dovedit că funcționează excelent în instalări mai mici. Totuși, tendința de adoptare a soluțiilor Open Source devine tot mai evidentă, chiar și în cazul companiilor mari și al cerințelor enterprise. În acest articol, vom explora modul de integrare a Postgres în medii corporative și vom împărtăși experiența noastră în crearea unui sistem de backup (SRK) pentru această bază de date, folosind exemplul sistemului de backup Commvault.
PostgreSQL și-a dovedit deja eficiența—sistemul de gestiune a bazelor de date funcționează perfect, fiind utilizat de afaceri digitale contemporane precum Alibaba și TripAdvisor, iar absența costurilor de licențiere face din aceasta o alternativă atrăgătoare la monștri precum MS SQL sau Oracle DB. Dar, de îndată ce începem să ne gândim la PostgreSQL în peisajul Enterprise, ne lovim imediat de cerințe stricte: „Dar ce este cu disponibilitatea configurației? ce zici de recuperarea în caz de dezastru? unde este monitorizarea cuprinzătoare? ce este cu backup-ul automatizat? și utilizarea bibliotecilor de benzi atât direct, cât și pentru stocare secundară?”
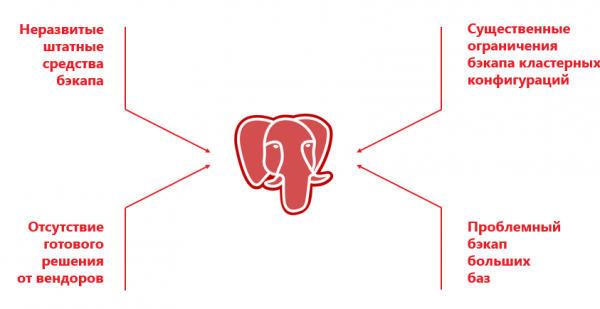
Pe de o parte, PostgreSQL nu dispune de instrumente integrate de backup precum „soluțiile mature” RMAN de la Oracle DB sau SAP Database Backup. Pe de altă parte, furnizorii de soluții de backup pentru companii (Veeam, Veritas, Commvault) deși suportă PostgreSQL, în realitate funcționează doar cu configurații specifice (de obicei standalone) și cu un set de diverse restricții.
Sisteme de backup special concepute pentru PostgreSQL, precum Barman, Wal-g, pg_probackup, sunt extrem de populare în instalările mai mici ale sistemului de gestiune a bazelor de date PostgreSQL sau în situațiile în care nu sunt necesare backup-uri grele ale altor elemente din peisajul IT. De exemplu, în infrastructură pot exista atât baze de date fizice și virtuale. servere, OpenShift, Oracle, MariaDB, Cassandra etc. Este de preferat să se facă backup comun. Implementarea unei soluții separate exclusiv pentru PostgreSQL este o idee proastă: datele vor fi copiate undeva pe un disc, iar apoi trebuie mutate pe bandă. Această duplicare a procesului de backup crește timpul de backup și, ceea ce este și mai critic, timpul de recuperare.
În soluția enterprise, backup-ul instalării se face cu un anumit număr de noduri dintr-un cluster dedicat. De exemplu, Commvault poate lucra doar cu un cluster cu două noduri, în care Primary și Secondary sunt fixate pe anumite noduri. Și are sens să faci backup doar de pe Primary, deoarece backup-ul de pe Secondary are propriile sale limitări. Datorită specificităților SGBD-ului, dump-ul pe Secondary nu este creat, așa că rămâne doar opțiunea backup-ului de fișiere.
Pentru a reduce riscurile de nefuncționare, la crearea unui sistem tolerant la erori se formează o configurație de cluster „vie”, iar Primary poate migra treptat între diferite servere. De exemplu, software-ul Patroni pornește automat Primary pe un nod ales aleatoriu din cluster. SRK nu are o metodă de a urmări acest lucru „din cutie”, iar dacă configurația se schimbă, procesele se rup. Asta înseamnă că implementarea unei gestionări externe împiedică SRK să funcționeze eficient, deoarece serverul de management pur și simplu nu înțelege de unde și ce date trebuie să copie.
O altă problemă este implementarea backup-ului în Postgres. Aceasta este posibilă prin dump, și funcționează bine pe baze mici. Dar în baze de date mari, dump-ul durează mult, necesită multe resurse și poate duce la eșecul instanței DB.
Backup-ul de fișiere rezolvă situația, dar pe baze mari acesta se desfășoară lent, deoarece lucrează în modul monocoric. De asemenea, furnizorii impun o serie de restricții suplimentare. Uneori nu se poate utiliza simultan backup-ul de fișiere și cel bazat pe dump, alteori nu se suportă deduplicarea. Apar multe probleme, iar cel mai adesea este mai simplu să alegi o SGBD scumpă, dar verificată, în loc de Postgres.
Nu mai estе cale de întoarcere! În spate sunt dezvoltatorii din Moscova!
Cu toate acestea, recent echipa noastră s-a confruntat cu o provocare dificilă: în proiectul de creare a sistemului de informații pentru RCA 2.0, unde am dezvoltat infrastructura IT, dezvoltatorii au ales PostgreSQL pentru noul sistem.
Dezvoltatorilor mari de software le este mult mai ușor să folosească soluții open-source „moderne”. În cadrul Facebook, există suficienți specialiști pentru a susține funcționarea acestui SGBD. În cazul RSAs, toate sarcinile „zilei a doua” cădeau pe umerii noștri. Ni s-a cerut să asigurăm toleranța la erori, să construim un cluster și, desigur, să configurăm backup-ul. Logica acțiunilor a fost următoarea:
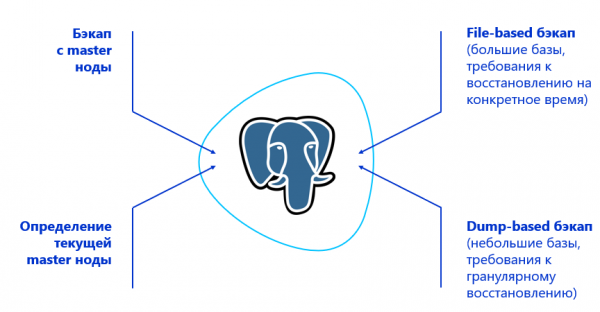
- Învățarea SRK-ului de a face backup de la nodul principal al clusterei. Pentru aceasta, SRK trebuie să-l identifice — ceea ce necesită integrarea cu o soluție de gestionare a clusterei PostgreSQL. În cazul RSA, s-a utilizat software-ul Patroni.
- Stabilirea tipului de backup, bazându-se pe volumele de date și cerințele de recuperare. De exemplu, atunci când trebuie să recuperăm pagini granular, să utilizăm un dump, iar dacă bazele sunt mari și recuperarea granulară nu este necesară — să lucrăm la nivel de fișiere.
- Implementarea unei soluții pentru backup-ul pe blocuri, pentru a crea o copie de rezervă în modul multithread.
În acest context, inițial ne-am propus să creăm un sistem eficient și simplu, fără o compunere monstruoasă de componente suplimentare. Cu cât mai puține soluții improvizate, cu atât mai mică este încărcătura asupra personalului și cu atât mai mic este riscul de a avea SRK-ul nefuncțional. Abordările care foloseau Veeam și RMAN au fost imediat excluse, deoarece ansamblul celor două soluții sugerează deja o fiabilitate scăzută a sistemului.
Un strop de magie pentru enterprise
Așadar, trebuia să garantăm un backup fiabil pentru 10 clustere, fiecare cu 3 noduri, având în același timp o infrastructură identică în DC-ul de rezervă. DC-urile, în ceea ce privește PostgreSQL, funcționează pe principiul active-passive. Volumul total al bazelor de date era de 50 TB. Orice SRK de nivel corporate poate gestiona acest lucru cu ușurință. Dar nuanța este că inițial în Postgres nu există puncte de integrare pentru compatibilitate completă și profundă cu sistemele de backup. Prin urmare, a trebuit să căutăm o soluție care să aibă de la bun început un maximum de funcționalitate în combinație cu PostgreSQL și să dezvoltăm sistemul.
Am desfășurat 3 hackathoane interne — am revizuit mai mult de cinci zeci de proiecte, le-am testat, am făcut modificări pe baza ipotezelor noastre, le-am verificat din nou. După ce am analizat opțiunile disponibile, am ales Commvault. Acest produs putea deja „din cutie” să funcționeze cu cele mai simple instalații cluster PostgreSQL, iar arhitectura sa deschisă a inspirat speranța (care s-a dovedit a fi justificată) pentru o dezvoltare și integrare de succes. De asemenea, Commvault este capabil să efectueze backup-uri pentru logurile PostgreSQL. De exemplu, Veritas NetBackup, în ceea ce privește PostgreSQL, poate realiza doar backup-uri complete.
Mai multe despre arhitectură. Serverele de control Commvault au fost instalate în fiecare dintre cele două centre de date în configurația CommServ HA. Sistemul este replicat, gestionat printr-o singură consolă și îndeplinește toate cerințele de HA ale întreprinderii.
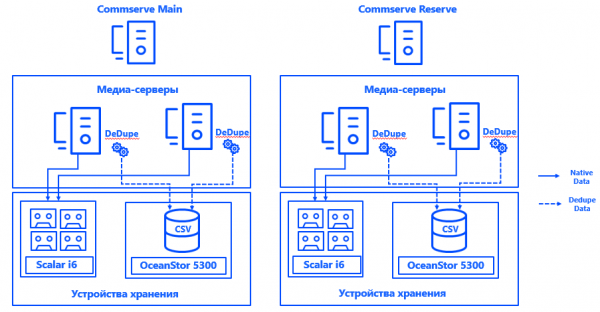
De asemenea, în fiecare centru de date am implementat câte două servere de medii fizice, la care am conectat prin SAN, prin Fibre Channel, array-uri de discuri dedicate special pentru backupuri și biblioteci de bandă. Baze de deduplicare extinse au asigurat redundanța serverelor de medii, iar conectarea fiecărui server la fiecare CSV permite continuitatea operațiunilor în cazul defectării oricărei componente. Arhitectura sistemului permite continuarea backupului, chiar dacă unul dintre centrele de date se defectează.
Patroni pentru fiecare cluster identifică nodul principal. Acesta poate fi orice nod liber în centru de date - dar doar în principal. În cel de rezervă, toate nodurile sunt secundare.
Pentru ca Commvault să înțeleagă care nod de cluster este principal, am integrat sistemul (mulțumită arhitecturii deschise a soluției) cu Postgres. Pentru acest lucru a fost creat un script care raportează locația curentă a nodului principal controlerului. server Commvault.
În general, procesul arată astfel:
Patroni alege nodul principal → Keepalived ridică IP-ul clusterului și lansează scriptul → agentul Commvault de pe nodul ales al clusterului primește o notificare că acesta este principal → Commvault reconfigurează automat backupul în cadrul pseudoclientului.
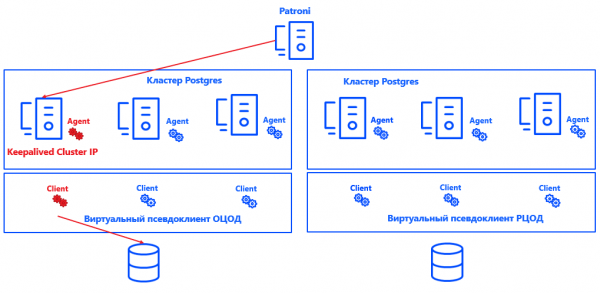
Avantajul acestei abordări este că soluția nu afectează nici consistența, nici corectitudinea logurilor, nici recuperarea instanței Postgres. De asemenea, este ușor de scalat, pentru că acum nu este necesar să se fixeze pentru Commvault nodurile principale și secundare. Este suficient ca sistemul să înțeleagă unde este nodul principal, iar numărul de noduri poate fi crescut practic la orice valoare.
Soluția nu pretinde a fi perfectă și are propriile sale nuanțe. Commvault poate face backup doar întregului instanțe, nu a bazelor de date individuale. Prin urmare, pentru fiecare BD a fost creată o instanță separată. Clienții reali sunt grupati în pseudoclienți virtuali. Fiecare pseudoclient Commvault reprezintă un cluster UNIX. În acesta sunt adăugate nodurile clusterului pe care este instalat agentul Commvault pentru Postgres. Ca urmare, toate nodurile virtuale ale pseudoclientului sunt salvate ca o singură instanță.
În fiecare pseudoclient este specificat un nod activ al clusterei. Acesta este determinat de soluția noastră de integrare pentru Commvault. Principiul său de funcționare este destul de simplu: dacă un IP de cluster este activat pe nod, scriptul stabilește în binarul agentului Commvault parametrul „nod activ” — practic, scriptul setează „1” în partea corectă a memoriei. Agentul transmite aceste date către CommServe, iar Commvault efectuează backup de pe nodul corespunzător. În plus, la nivel de script se verifică corectitudinea configurației pentru a evita erorile la inițierea rezervelor de siguranță.
În acest context, bazele de date mari sunt salvate în blocuri pe mai multe fluxuri, respectând cerințele RPO și fereastra de backup. Suprasarcina pentru sistem este neglijabilă: copiile complete nu au loc foarte des, iar în celelalte zile sunt adunate doar loguri, de obicei în perioade de mică încărcare.
Apropo, am aplicat politici distincte pentru backup-ul jurnalelor arhivă PostgreSQL — acestea sunt păstrate conform altor reguli, copiate conform altui program și pentru ele nu se activează deduplicarea, deoarece aceste jurnale conțin date unice.
Pentru a asigura consistența întregii infrastructuri IT, clienții de fișiere Commvault sunt instalați pe fiecare nod al clusterei. Aceștia exclud din backup-uri fișierele Postgres și sunt destinați doar pentru backup-ul sistemului de operare și aplicațiilor. Există de asemenea o politică separată și un termen de păstrare pentru acest set de date.
În prezent, SRK nu afectează serviciile productive, dar, dacă situația se va schimba, în Commvault se va putea activa sistemul de limitare a încărcării.
Este bun? Este bun!
Așadar, am obținut nu doar un backup funcțional, ci și unul complet automatizat pentru instalarea clusterului PostgreSQL, care îndeplinește toate cerințele impuse de provocările enterprise.
Parametrii RPO și RTO de 1 oră și 2 ore sunt depășiți cu rezervă, ceea ce înseamnă că sistemul va respecta aceste valori și în cazul unei creșteri semnificative a volumelor de date stocate. În ciuda multor îndoieli, PostgreSQL și mediul enterprise s-au dovedit a fi complet compatibile. Și acum știm din propria experiență că backup-ul pentru astfel de SGBD-uri este posibil în cele mai diverse configurații.
Desigur, pe acest drum a fost necesar să uzăm șapte perechi de bocanci metalici, să depășim o serie de dificultăți, să călcăm pe câteva greble și să corectăm un anumit număr de erori. Dar acum abordarea a fost testată și poate fi aplicată pentru implementarea Open Source în locul DBMS-urilor proprietare în condiții dure de enterprise.
Ați încercat să lucrați cu PostgreSQL în mediul corporativ?
Autori:
Oleg Lavrenov, inginer proiectant al sistemelor de stocare a datelor de la «Infossisteme Jet»
Dmitry Erikin, inginer proiectant al complexelor de calcul de la «Infossisteme Jet»
Sursa: habr.com
