

Să discutăm de ce uneltele CI și CI-ul în sine sunt complet diferite.
Ce problemă trebuie să rezolve CI, de unde a apărut ideea, care sunt ultimele dovezi că funcționează, cum putem înțelege că aveți cu adevărat o practică, nu doar un Jenkins instalat.
Gândul de a face o prezentare despre Continuous Integration a apărut acum un an, când căutam un loc de muncă prin intermediul interviurilor. Am interacționat cu 10-15 companii, dintre care doar una a reușit să răspundă clar ce este CI și să explice cum au conștientizat că nu îl au. Celelalte au spus lucruri neclare despre Jenkins 🙂 Ei bine, avem Jenkins, face build-uri, CI! În prezentare voi încerca să explic ce este de fapt Continuous Integration și de ce Jenkins și uneltele similare au o legătură foarte slabă cu acest concept.
Și așadar, ce îi vine în minte unui om când aude cuvântul CI? Majorității oamenilor le va veni în minte Jenkins, Gitlab CI, Travis și altele.
Chiar și dacă căutăm pe Google, aceste unelte vor apărea.
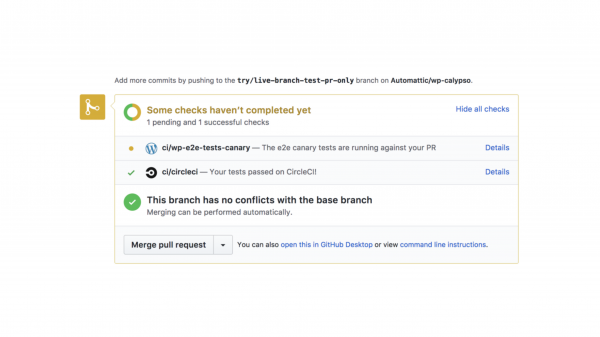
Dacă întrebăm cunoscuți, imediat după ce enumera uneltele, vă vor spune că CI este atunci când în Pull Request-ul de pe commit se face build și se rulează teste.
Continuous Integration nu este despre unelte, nu este despre build-uri cu teste în ramură! Continuous Integration este o practică de integrare foarte frecventă a noului cod, iar pentru a o aplica nu trebuie neapărat să folosești Jenkins, GitLab și altele.
Înainte să discutăm despre cum arată un CI complet, haideți mai întâi să ne scufundăm în contextul persoanelor care l-au gândit și să resimțim durerea pe care au încercat să o rezolve.
Și durerea pe care o rezolvau era colaborarea în echipă!
Să ne uităm la exemple, cu ce dificultăți se confruntă dezvoltatorii în timpul dezvoltării în echipă. Iată, avem un proiect, ramura master în git și doi dezvoltatori.
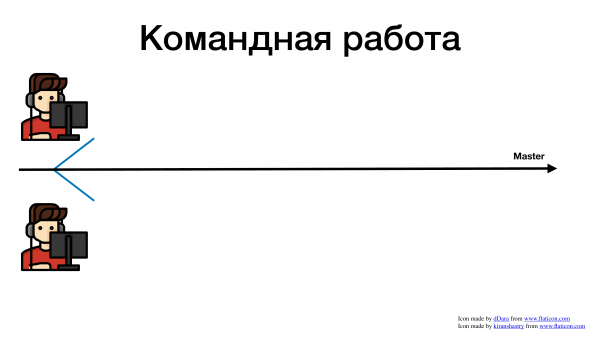
Și au început să lucreze așa cum au făcut toți până acum. Au luat o sarcină în Jira, au creat o ramură de feature și au început să scrie cod.
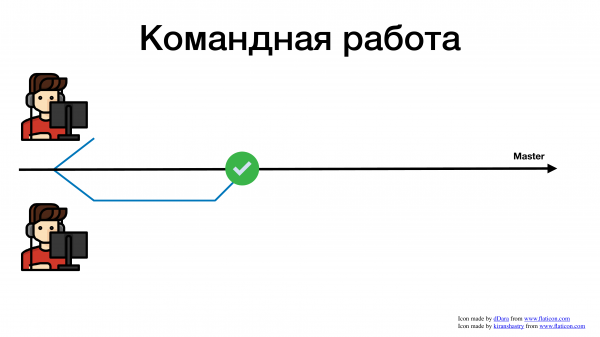
Unul a terminat fisa mai repede și a fuzionat în master.
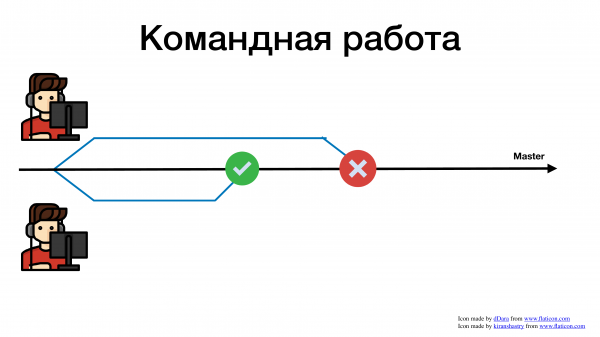
Celuilalt i-a luat mai mult timp, s-a fuzionat mai târziu și a întâmpinat un conflict. Acum, în loc să scrie funcții necesare afacerii, dezvoltatorul își pierde timpul și energia rezolvând conflicte.
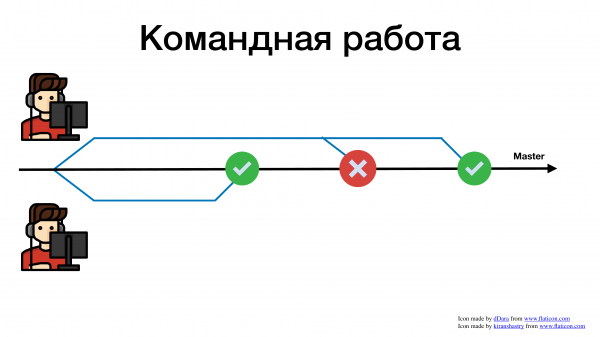
Cu cât este mai complicat să îmbinăm caracteristica noastră cu masterul comun, cu atât mai mult timp ne consumă acest proces. Iar acesta este doar un exemplu destul de simplu. Este un exemplu în care există doar 2 dezvoltatori. Imaginați-vă dacă sunt 10, 15 sau 100 de persoane într-o companie care scriu în același depozit. Vei înnebuni încercând să rezolvi toate aceste conflicte.
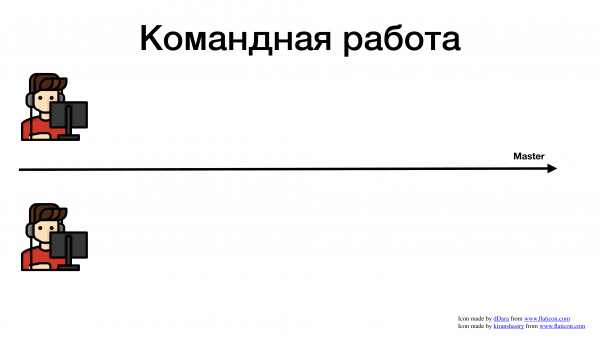
Există un alt caz. Avem un master și câțiva dezvoltatori care lucrează la ceva.
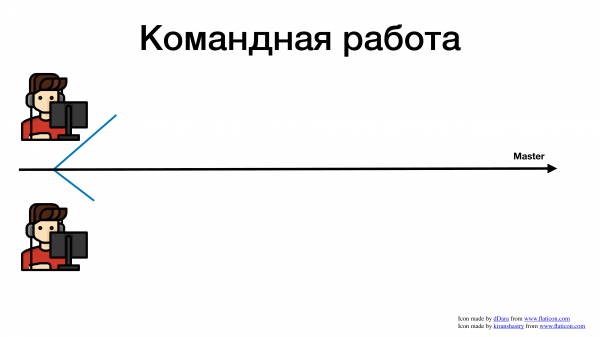
Ei au creat câte o ramură.
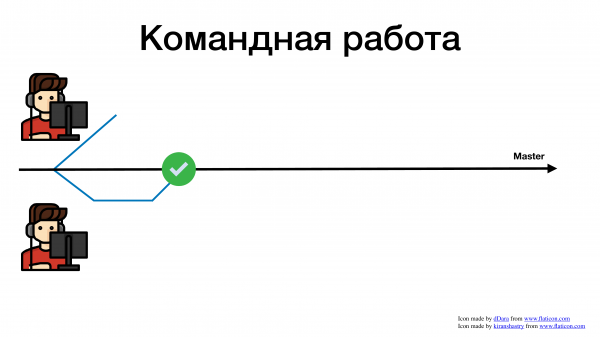
Unul s-a integrat, totul este în regulă, a predat sarcina.
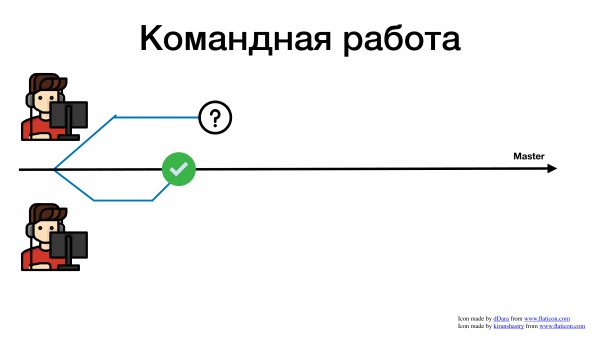
Între timp, al doilea dezvoltator și-a predat sarcina. Să presupunem că a trimis-o pentru revizuire. În multe companii, există practica de a face revizuiri. Pe de o parte, aceasta este o practică bună și utilă, pe de altă parte, ne încetinește în multe privințe. Nu vom intra în acest subiect, dar iată un exemplu excelent despre ce poate duce o istorie necontrolată cu revizuirile. Ai trimis o cerere de pull pentru revizuire. Dezvoltatorului nu-i mai rămâne nimic de făcut. Ce începe să facă? Începe să ia alte sarcini.
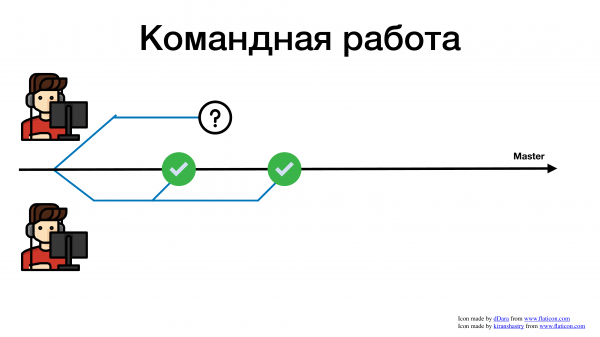
Între timp, al doilea dezvoltator a mai făcut ceva.
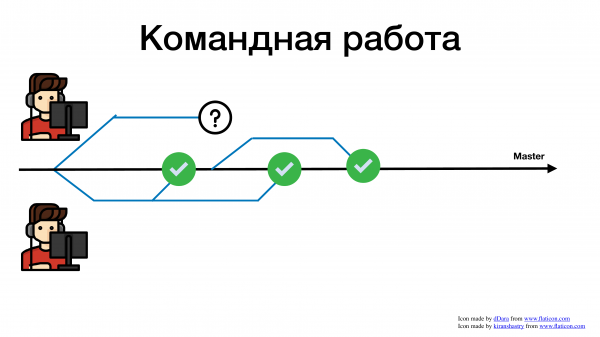
Primul a finalizat a treia sarcină.
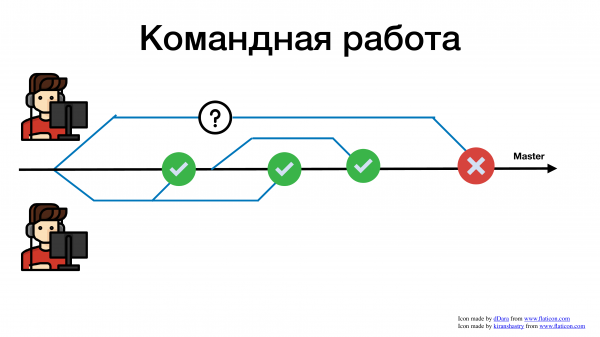
Și după un timp considerabil, revizuirea lui a fost testată și încearcă să se integreze. Ce se întâmplă? Prinde o cantitate uriașă de conflicte. De ce? Pentru că în timp ce cererea lui de pull a fost în revizuire, în cod s-au schimbat deja multe lucruri.
Pe lângă problemele cu conflictele, există și problema comunicării. Atunci când ramura ta este în revizuire, când așteaptă ceva, când ai petrecut mult timp lucrând la o caracteristică, încetezi să mai urmărești ce se schimbă în baza de cod a serviciului tău. Poate că ceea ce încerci să rezolvi acum a fost deja soluționat ieri și poți prelua o metodă pe care să o reutilizezi. Dar nu vei vedea asta deoarece lucrezi mereu cu o ramură depășită. Iar această ramură depășită duce întotdeauna la necesitatea de a rezolva conflicte de integrare.
Deci, se dovedește că, dacă lucrăm în echipă, adică nu un singur om se ocupă de depozit, ci 5-10 persoane, cu cât mai mult întârziem să adăugăm codul nostru în master, cu atât mai mult suferim din cauza faptului că, în cele din urmă, trebuie să integrăm ceva. Și cu cât avem mai multe conflicte și lucrăm cu o versiune mai veche, cu atât mai multe probleme avem.
A face ceva împreună - este dureros! Ne punem mereu bețe în roate unii altora.
Această problemă a fost remarcată cu peste 20 de ani în urmă. Prima mențiune a practicii Continuous Integration am găsit-o în programarea extremă.
Programarea extremă este primul framework agile. Pagina a apărut în 1996. Ideea era de a folosi anumite practici de programare, planificare și altele, pentru a face dezvoltarea cât mai flexibilă, astfel încât să putem reacționa mai repede la schimbări și cerințele clienților noștri. Acum 24 de ani au început să se confrunte cu faptul că dacă faci ceva foarte mult timp în mod separat, pierzi mai mult timp datorită conflictelor.
În prezent, vom analiza expresia „Continuous Integration” pe cuvinte separate. Dacă traducem direct, rezultatul este integrare continuă. Dar cât de continuă este, nu este foarte clar, este de fapt foarte fragmentată. De asemenea, nu este foarte evident cât de mult este aceasta integrare.
De aceea, vă aduc acum citate din programarea extremă. Vom analiza ambele cuvinte separat.
Integration — Așa cum am spus, ne propunem ca fiecare inginer să lucreze cu cea mai actualizată versiune a codului, astfel încât codul său să fie adăugat cât mai des în ramura comună, pentru a fi ramuri mici. Pentru că dacă sunt mari, putem rămâne cu ușurință blocati timp de o săptămână din cauza conflictelor de fuziune. Este deosebit de complicat dacă avem un ciclu lung de dezvoltare tip waterfall, în care dezvoltatorul a plecat timp de o lună să facă o caracteristică foarte mare. Și el se va bloca mult timp în etapa de integrare.
Integration — este atunci când luăm ramura noastră și o integrăm cu ramura principală, o fuzionăm. Există o variantă ultimativă, când suntem transbase developer, unde ne propunem ca imediat să scriem în ramura principală fără ramuri intermediare.
În general, integration este să iei codul tău și să-l aduci în ramura principală.
Ce se înțelege prin termenul „continuu”, ce este continuitatea? Practica înseamnă că dezvoltatorul se străduiește să integreze codul său cât mai repede posibil. Aceasta este obiectivul său în îndeplinirea oricărei sarcini – să facă astfel încât codul său să apară în master cât mai repede. Într-o lume ideală, dezvoltatorii ar face acest lucru la fiecare câteva ore. Adică, iei o sarcină mică, o îmbini în master. Totul este minunat. La asta aspiri. Și trebuie să faci asta continuu. Ori de câte ori finalizezi ceva, lo apși imediat în master.
Iar dezvoltatorul care face ceva este responsabil pentru ceea ce a realizat, pentru a funcționa și pentru a nu strica nimic. Aici de obicei apare povestea cu testele. Vrem să rămânem să rulăm teste pe commit-ul nostru, pe îmbinarea noastră, pentru a ne asigura că funcționează. Iar aici Jenkins poate fi de mare ajutor.
Dar în legătură cu poveștile: hai să facem modificările mici, hai să facem sarcinile mici și hai să încercăm imediat să îmbinăm sarcina în master – aici nimic nu te va ajuta, chiar și Jenkins. Pentru că Jenkins te ajută exclusiv să rulezi testele.
Poți să te descurci și fără ele. Nu îți va afecta cu nimic. Pentru că scopul practicii este să îmbini cât mai des, pentru a nu pierde o cantitate imensă de timp pe conflicte în viitor.
Să presupunem că avem anul 2020 fără internet dintr-un motiv anume. Și lucrăm local. Nu avem Jenkins. Este în regulă. Poți să îți creezi o ramură locală. În ea ai scris un cod. Ai rezolvat o sarcină în 3-4 ore. Te-ai comutat pe master, ai făcut git pull, ai îmbinat ramura ta. Gata. Dacă faci asta des – felicitări, ai Continuous Integration!
Ce dovezi există în lumea modernă că merită să investești eforturi în asta? Pentru că, în general, este complicat. Dacă încerci să lucrezi astfel, vei înțelege că va trebui să-ți planifici mai bine timpul și să dedici mai mult timp descompunerii sarcinilor. Pentru că dacă vei face man..., nu vei putea să te îmbini rapid și, în consecință, vei fi în dificultate. Practica nu va mai fi eficientă.
Și va fi scump. Nu va fi posibil să lucrăm din prima zi cu Continuous Integration. Cu toții veți avea nevoie de mult timp pentru a vă obișnui, mult timp pentru a învăța să decompuneți sarcinile, mult timp pentru a învăța să refaceți practica de revizuire, dacă o aveți. Pentru că obiectivul nostru este să se facă merge astăzi. Iar dacă faceți revizuirea timp de trei zile, atunci aveți probleme și Continuous Integration nu va funcționa.
Dar avem câteva dovezi relevante chiar acum, care ne spun că merită să investim în această practică?
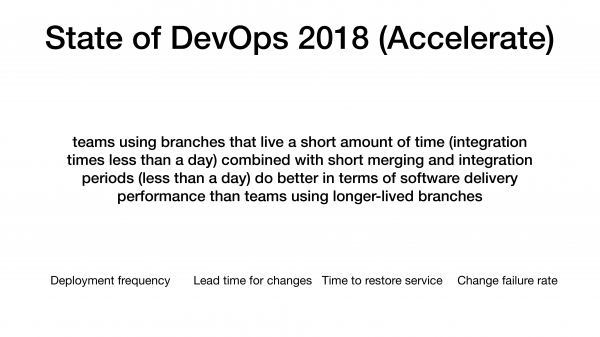
Primul lucru care mi-a venit în minte este State of DevOps. Este un studiu pe care echipa îl desfășoară de 7 ani. În prezent, îl fac ca organizație independentă, dar sub Google.
Iar studiul lor din 2018 a arătat o corelație între companiile care încearcă să folosească ramuri cu o durată scurtă de viață, care se integrează rapid, frecvent, având indicatori de performanță IT mai buni.
Ce indicatori sunt aceștia? Sunt 4 metrici pe care le colectează de la toate companiile în chestionarele lor: frecvența de implementare, timpul de răspuns pentru modificări, timpul de restaurare a serviciului, rata de eșec a modificărilor.
În primul rând, există această corelație, știm că companiile care se integrează frecvent au aceste metrici semnificativ mai bune. Și există o clasificare a companiilor în mai multe categorii: companii lente, care produc ceva încet, performer mediu, performer de înaltă calitate și elită. Elita este Netflix, Amazon, care sunt foarte rapide, fac totul repede, frumos și de calitate.
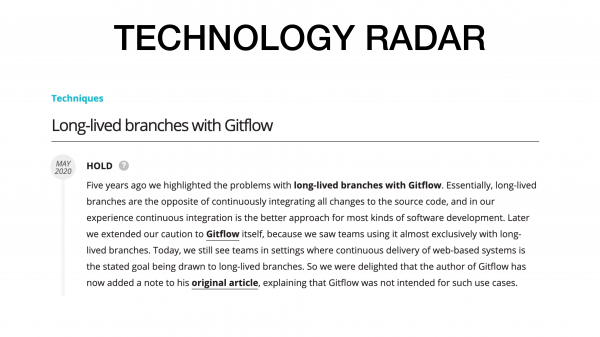
A doua poveste, care s-a întâmplat cu doar o lună în urmă. În Technology Radar a apărut un articol minunat despre Gitflow. Gitflow se deosebește de toate celelalte prin faptul că ramurile sale au o viață lungă. Există ramuri de lansare, care trăiesc mult timp, ramuri de funcționalități, care la fel au o durată lungă de viață. Această practică în Technology Radar a fost mutată în HOLD. De ce? Pentru că oamenii se confruntă cu dificultăți în integrare.
Dacă o ramură trăiește foarte mult, se blochează, devine învechită, începem să pierdem mai mult timp pentru a face o modificare în ea.
Recent authors of Gitflow have claimed that if you are aiming for Continuous Integration and wish to integrate as frequently as possible, then Gitflow is a poor choice. They further noted in an article that if you have a backend where you can strive for this, Gitflow is redundant for you because it will slow you down and create integration issues.
This does not mean that Gitflow is bad and that it shouldn't be used. It is suitable for other scenarios. For example, when you need to maintain multiple versions of a service or application, that is, when you need to provide support over an extended period.
However, if you talk to people who maintain such services, you will hear a lot of frustration about version 3.2, which was four months ago, and how a certain fix was missed in it, necessitating numerous changes to implement it. They find themselves stuck again, spending a week trying to merge a new feature.
As Alexander Kovalev correctly pointed out in the chat, correlation does not equal causation. This means that there is no direct link suggesting that having Continuous Integration will guarantee excellent metrics. However, there is a positive correlation—if one exists, the other is likely to follow. It’s not a certainty, but likely. It is merely correlation.
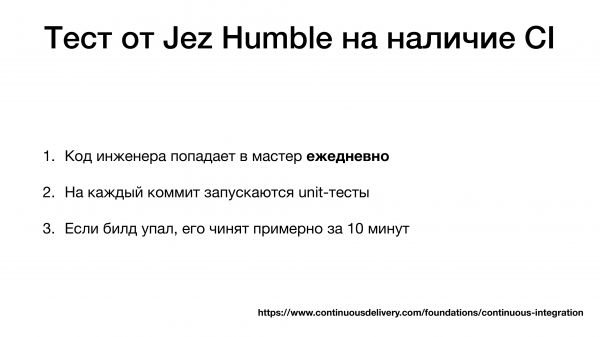
It seems we are doing something right; we are merging, but how can we determine if we actually have Continuous Integration and if we are merging frequently enough?
Jez Humble is the author of the Handbook, Accelerate, the Continuous Delivery website, and the book "Continuous Delivery." He proposes the following test:
- An engineer's code is merged into the master branch daily.
- You run unit tests for every commit.
- If the build in the master branch fails, it is fixed in about 10 minutes.
He suggests using this test to confirm that you indeed have the practice in place.
Ceea ce consider eu puțin discutabil. Adică, dacă puteți repara în 10 minute, înseamnă că aveți Continuous Integration, ceea ce sună puțin ciudat, în opinia mea, dar are sens. De ce? Pentru că, dacă faceți merge-uri frecvent, înseamnă că schimbările sunt mici. Dacă o mică schimbare a dus la defectarea build-ului master, puteți găsi rapid exemplul, pentru că schimbarea e mică. Așadar, ați avut un mic merge, în care s-au schimbat 20-30 de linii. Și, în consecință, puteți înțelege repede care a fost cauza, pentru că modificările sunt minuscule, aveți un domeniu foarte restrâns pentru a căuta problema.
Și chiar dacă după lansare ne distruge prod-ul, dacă avem practica Continuous Integration, ne va fi mult mai ușor să acționăm, deoarece schimbările sunt mici. Da, asta va afecta planificarea. Va fi dureros. Și, probabil, cel mai greu în această practică este să te obișnuiești să dezbăți sarcinile, adică, cum să faci ceva și să finalizezi asta în câteva ore și să treci prin revizie, dacă o ai. Revizia este o altă durere.
Testele unitare sunt doar un asistent care te ajută să înțelegi – dacă integrarea ta a trecut cu succes, dacă nimic nu s-a defectat. În opinia mea, acesta nu este un punct absolut obligatoriu, deoarece sensul practici nu stă în acest lucru.
Asta e o scurtă descriere despre Continuous Integration. Asta este tot ce conține această practică. Sunt deschis la întrebări.
Pe scurt, voi rezuma încă o dată:
- Continuous Integration nu este Jenkins, nu este Gitlab.
- Nu este un instrument, este o practică care presupune că noi integrăm codul nostru în master cât mai des posibil.
- Facem asta pentru a evita durerea uriașă care apare cu merge-urile în viitor, adică experimentăm o mică durere acum, pentru a nu avea o mare durere mai târziu. Acesta este tot sensul.
- Comunicația trece prin cod, dar rar văd asta, însă pentru asta a fost gândită.
Întrebări
Ce să facem cu sarcinile nedecopozate?
Decopozati-le. Care este problema? Puteți să oferiți un exemplu în care există o sarcină ce nu se poate decopozita?
Există sarcini care nu pot fi decopozitate deloc, de exemplu, cele care necesită o expertiză foarte profundă și care pot fi rezolvate doar pe parcursul unei luni, până la un rezultat care să fie acceptabil.
Dacă te-am înțeles corect, există o sarcină mare și complexă, al cărei rezultat va fi vizibil doar peste o lună?
Da, exact. Da, rezultatul poate fi evaluat nu mai devreme de o lună.
Bine. În general, nu este o problemă. De ce? Pentru că, în acest caz, când vorbim despre ramuri, nu ne referim la o ramură cu o funcționalitate. Funcționalitățile pot fi mari și complexe. Ele pot afecta un număr mare de componente. Și, posibil, nu le putem finaliza complet într-o singură ramură. Este în regulă. Trebuie doar să împărțim această poveste. Dacă funcționalitatea nu este complet gata, nu înseamnă că anumite părți ale codului ei nu pot fi integrate. Ai adăugat, de exemplu, o migrare și în interiorul funcționalității există anumite etape. Ai, de exemplu, o etapă – să faci migrarea, să adaugi o metodă nouă. Și poți deja integra aceste lucruri zilnic.
Bine. Care este, atunci, sensul acestui lucru?
Care este sensul de a integra lucruri mici zilnic?
Da.
Dacă au stricat ceva, vezi imediat. Ai o bucată mică care a stricat ceva, îți este mai ușor să repari asta. Sensul este că integrarea unei bucăți mici acum este mult mai ușoară decât integrarea unei lucruri mari după câteva săptămâni. Și al treilea sens este că alți ingineri vor lucra cu versiunea de cod actualizată. Ei vor vedea că aici au fost adăugate anumite migrații, iar aici a apărut o metodă despre care poate vor dori să folosească. Toată lumea va vedea ce se întâmplă în codul tău. Anume pentru aceste trei lucruri se face practica.
Mulțumesc, întrebarea este închisă!
(Oleg Soroka) Pot să adaug ceva? Ai spus totul corect, vreau doar să adaug o frază.
Așa.
În cadrul Continuous Integration, codul se integrează în ramura comună nu atunci când funcționalitatea este complet gata, ci atunci când construcția nu mai este broken. Și poți să faci commit în master de câte ori vrei pe zi. Al doilea aspect – dacă din anumite motive nu poți împărți o sarcină de o lună în sarcini de cel puțin trei zile, nu mai vorbesc de trei ore, înseamnă că ai o problemă imensă. Și faptul că nu ai Continuous Integration este cea mai mică dintre aceste probleme. Asta înseamnă că ai probleme cu arhitectura și practicile ingineresti sunt la zero. Pentru că chiar dacă este cercetare, în orice caz trebuie să fie formulată sub formă de ipoteze sau ciclu.
Am discutat despre 4 metrici care diferențiază companiile de succes de cele care stagnează. Până la aceste 4 metrici mai este mult de muncă. Dacă o sarcină medie durează o lună, m-aș concentra mai întâi pe această metrică. Aș reduce timpul la 3 zile. Abia apoi aș începe să mă gândesc la Continuous.
Am înțeles corect că tu crezi că, în general, nu are sens să investești în practici de inginerie dacă orice sarcină durează o lună?
Ai Continuous Integration. Și există o temă acolo, că în 10 minute poți fie să aplici o corectare, fie să dai înapoi. Imaginează-ți că l-ai implementat. Mai mult, ai chiar și continuous deployment, l-ai implementat pe prod și abia apoi ai observat că ceva nu a funcționat. Și trebuie să îl dai înapoi, dar deja ai avut o migrare a bazei de date. Schema bazei de date este deja actualizată, ba mai mult, poate a trecut și un backup, și deja s-au înregistrat date.
Și care este alternativa ta? Dacă dai înapoi codul, atunci acesta nu mai poate funcționa cu această bază de date actualizată.
Baza se deplasează doar înainte, da.
Oamenii care au practici de inginerie slabe nu au citit, cel mai probabil, nici o carte groasă despre… Ce trebuie să faci cu backup-ul? Dacă te recuperați dintr-un backup, asta înseamnă că pierzi datele acumulate în acel moment. De exemplu, ai lucrat trei ore cu noua versiune a bazei de date, utilizatorii s-au înregistrat. Te întorci la un backup vechi, pentru că schema nu funcționează cu noua versiune, așa că ai pierdut acești utilizatori. Și ei sunt nemulțumiți, se plâng.
Pentru a stăpâni întregul spectru de practici care susțin Continuous Integration și Continuous Delivery, nu este suficient să înveți pur și simplu să scrii …. În primul rând, acestea pot deveni foarte multe, ceea ce va fi impractic. În plus, există o grămadă de alte practici, cum ar fi cele științifice. Există o astfel de practică, pe care GitHub a popularizat-o la un moment dat. Este atunci când ai codul vechi și codul nou care rulează simultan. Este atunci când faci o caracteristică incompletă, dar aceasta poate returna un anumit rezultat: fie ca funcție, fie ca Rest API. Tu rulezi atât codul vechi, cât și codul nou, și compari diferența dintre ele. Și dacă există o diferență, atunci înregistrezi acel eveniment. Astfel, știi că noua ta caracteristică este gata să fie desfășurată peste cea veche, dacă în decursul unei anumite perioade nu a existat nicio divergență între cele două.
Există sute de astfel de practici. Aș sugera să începi cu transbase development. Nu este 100 % pe Continuous Integration, dar practicile sunt aceleași, unul fără altul trăiește prost.
Ai adus transbase development ca exemplu, unde se pot observa practicile sau sugerezi oamenilor să înceapă să folosească transbase development?
Să se uite, deoarece nu vor putea să le folosească. Pentru a le utiliza, trebuie să citească mult. Și când întrebarea unei persoane este: „Ce să fac cu o caracteristică care durează o lună?”, aceasta înseamnă că nu a citit despre transbase development. Nu aș recomanda încă. Aș sugera să te concentrezi exclusiv pe tema modului corect de a fragmenta sarcinile mari în sarcini mai mici. Aceasta este, de fapt, esența decompoziției.
Decompoziția este un instrument al arhitectului. Mai întâi facem analiza, apoi decompoziția, apoi sinteza, și apoi integrarea. Astfel, totul se îmbină. Și pentru a ajunge la Continuous Integration, trebuie să progresăm prin decompoziție. Întrebările apar în prima etapă, iar noi vorbim deja despre a patra etapă, adică cu cât faci integrarea mai des, cu atât mai bine. Este încă devreme să o facem, ar fi bine să ne războim întâi cu monolitul nostru.
Trebuie să desenăm câteva săgeți și pătrate pe un anumit grafic. Nu poți spune că acum voi arăta schema arhitecturală a unei noi aplicații și voi arăta un pătrat, în interiorul căruia este un buton verde pentru aplicație. În orice caz, vor fi mai multe pătrate și săgeți. Pe orice schemă pe care am văzut-o, erau mai multe decât unul. De aceea, decompunerea, chiar și la nivelul reprezentării grafice, este deja realizată. Așadar, pătratele pot fi independente. Dacă nu, atunci am întrebări mari pentru arhitect.
Există o întrebare din chat: „Dacă revizuirea este obligatorie și durează mult, undeva o zi sau mai mult?”.
Aveți probleme cu practica. Nu ar trebui ca revizuirea să dureze o zi sau mai mult. Aceasta este o poveste similară cu întrebarea anterioară, dar puțin mai blândă. Dacă revizuirea durează o zi, înseamnă că, cel mai probabil, este vorba despre o modificare foarte mare. Asta înseamnă că ar trebui să facem schimbările mai mici. În dezvoltarea transbase, pe care Oleg a recomandat-o, există o poveste numită revizuire continuă. Ideea ei este că facem cereri de pull atât de mici intenționat, deoarece ne străduim să ne unim constant și puțin câte puțin. Și astfel, cererea de pull schimbă o abstracție sau 10 linii. Datorită acestui lucru, revizuirea durează câteva minute.
Dacă revizuirea durează o zi sau mai mult, înseamnă că ceva nu este în regulă. În primul rând, este posibil să aveți unele probleme cu arhitectura. Sau este un cod mare, de exemplu, de 1.000 de linii. Sau arhitectura este atât de complicată încât persoana nu o poate înțelege. Aceasta este o problemă secundară, dar va trebui să o rezolvați și pe aceasta. Poate că nu este nevoie de revizuire deloc. Trebuie să vă gândiți și la asta. Revizuirea este acel lucru care vă încetinește. Ea aduce unele beneficii în general, dar trebuie să înțelegeți de ce faceți asta. Este pentru voi un mod rapid de a transmite informații, este pentru voi un mod de a stabili anumite standarde? De ce aveți nevoie de ea? Pentru că revizuirea trebuie să fie foarte rapidă sau, în general, să fie anulată. Este ca în dezvoltarea transbase – o poveste foarte frumoasă, dar numai pentru echipele mature.
Referitor la cele 4 metrici, aș recomanda totuși să le capturați, pentru a înțelege la ce duc. Să ne uităm la cifre, să vedem imaginea, cât de rău este totul.
(Dmitry) Sunt gata să intru în discuție pe acest subiect cu tine. Numerele și metricile sunt grozave, practicile sunt grozave. Dar trebuie să înțelegem dacă sunt necesare pentru afacere. Există afaceri pentru care nu este necesară o viteză atât de mare de schimbare. Cunosc companii în care nu se pot face schimbări la fiecare 15 minute. Și nu pentru că ar fi rele. Este un ciclu de viață. Și pentru a implementa funcționalități de ramuri, funcționalități toggle, sunt necesare cunoștințe profunde.
Este complicat. Dacă vrei să citești o poveste despre funcționalitatea toggle mai în detaliu, îți recomand cu căldură. . Și există un articol minunat de Martin Fowler despre funcțiile toggle: despre tipurile existente, ciclurile de viață etc. Funcționalitatea toggle este complicată.
Și totuși, nu ai răspuns la întrebare: "Este necesar Jenkins sau nu?"
Jenkins nu este necesar în niciun caz de fapt. Dacă vorbim serios, instrumentele: Jenkins, Gitlab îți vor aduce confort. Vei vedea dacă build-ul a fost realizat sau nu. Ele te pot ajuta, dar nu îți vor aduce practica. Ele îți pot da doar un cerc – Ok, nu Ok. Și asta, dacă scrii teste, pentru că dacă nu ai teste, devine aproape inutil. Așa că este necesar, pentru că este mai comod, dar în general poți trăi și fără el, nu vei pierde mult.
Deci, dacă ai practici, înseamnă că nu ai nevoie de el?
Exact. Recomand testul lui Jez Humble. Am o opinie mixtă despre ultimul punct. Dar în general, dacă ai trei lucruri, te unifici constant, rulezi teste la commit-uri în branșă, repari rapid build-ul în branșă, atunci, poate, nu mai ai nevoie de nimic altceva.
În timp ce așteptăm întrebările participanților, am o întrebare. Tocmai am vorbit despre codul de produs. L-ai folosit pentru codul de infrastructură? Este același cod, are aceleași principii și același ciclu de viață sau există cicluri și principii diferite acolo? De obicei, când toată lumea vorbește despre Integrarea și Dezvoltarea Continuă, uită că există și cod de infrastructură. Și în ultima vreme, acesta devine din ce în ce mai important. Ar trebui să aducem toate aceste reguli acolo?
Chiar nu este vorba că ar trebui, ar fi minunat, pentru că cu siguranță ar simplifica viața. De îndată ce lucrăm cu cod, nu cu scripturi Bash, ci avem un cod normal.
Stai-stai, un script Bash este și el cod. Nu atinge dragostea mea veche.
Bine, nu voi călca pe amintirile tale. Am o antipatie personală față de bash. Se strică într-un mod urât și înfiorător tot timpul. Și se strică adesea într-un mod imprevizibil, așa că nu-l plac. Dar bine, să presupunem că ai cod în bash. Poate că chiar nu mă pricep și există frameworkuri normale pentru testare. Pur și simplu nu sunt la curent. Și obținem aceleași avantaje.
De îndată ce lucrăm cu infrastructura ca și cum ar fi cod, ne confruntăm cu aceleași probleme ca dezvoltatorii. Cu câteva luni în urmă, am dat peste o situație în care un coleg mi-a trimis un pull request cu 1.000 de linii de bash. Și tu stai blocat la revizuire timp de 4 ore. Problemele sunt aceleași. Este tot cod. Și este în continuare un efort colaborativ. Ne blocăm cu pull request-ul și ne împotmolim cu aceleași conflicte de fuziune ale aceluiași bash, de exemplu.
Acum observ această întreagă chestiune la un programare cât mai frumoasă a infrastructurii. Am integrat acum Pulumi în infrastructură. Aceasta este programare în purul său sens. Acolo este și mai drăguț, deoarece am toate posibilitățile limbajului de programare, adică am realizat toggles frumoase cu aceleași if-uri pe un teren plat și totul este bine. Adică modificarea mea este deja în master. Toată lumea o vede deja. Alți ingineri sunt la curent cu ea. A avut deja un impact asupra a ceva. Dar a fost activată nu pentru toată infrastructura. A fost activată pentru standurile mele de testare, de exemplu. Prin urmare, răspunzând din nou la întrebarea ta, este necesară. Ne simplifică viața, ca ingineri care lucrăm cu cod.
Dacă mai are cineva întrebări?
Am o întrebare. Vreau să continui discuția cu Oleg. În general, cred că ai dreptate, că dacă o sarcină durează o lună, ai o problemă cu arhitectura, ai o problemă cu analiza, decompoziția, planificarea etc. Dar am senzația că, dacă începi să încerci să trăiești conform Continuous Integration, atunci vei începe să corectezi durerile cu planificarea, pentru că nu poți scăpa de asta.
(Oleg) Da, e adevărat. În ceea ce privește efortul, această practică este comparabilă cu orice altă practică serioasă care schimbă cultura. Cea mai dificilă parte a depășirii este obiceiurile, în special obiceiurile proaste. Și dacă pentru a implementa această practică este necesară o schimbare serioasă a obiceiurilor celor din jur: dezvoltatori, conducere, manageri de producție, vă așteaptă surprize.
Ce surprize ar putea să apară? Să presupunem că ați decis să faceți integrarea mai des. Și în integrare sunt legate și alte lucruri, de exemplu, artefacte. Iar în compania dumneavoastră există o politică conform căreia fiecare artefact trebuie să fie înregistrat într-un sistem de depozitare a artefactelor. Și aceasta durează un anumit timp. O persoană trebuie să bifeze că, în calitate de manager de versiune, a verificat acest artefact pentru a fi pregătit pentru publicație în producție. Dacă durează 5-10-15 minute, dar în același timp faceți livrări o dată pe săptămână, atunci a pierde o jumătate de oră o dată pe săptămână este un impozit mic.
Dacă faceți Continuous Integration de 10 ori pe zi, atunci trebuie să înmulțiți 10 cu 30 de minute. Și aceasta depășește timpul de lucru al acestui manager de versiune. Pur și simplu se obosește să facă acest lucru. Există cheltuieli constante pentru anumite practici. Și acesta este tot.
Și trebuie fie să anulați această regulă, astfel încât să nu mai faceți astfel de lucruri, adică să nu mai atribuiți manual un grad de conformitate a ceva cu altceva. Vă bazați complet pe un set automatizat de teste de pregătire.
Și dacă aveți nevoie de o aprobată de la cineva, astfel încât șeful să semneze, și nu intrați în producție fără ca Vasya să fi spus că permite și așa mai departe – toate aceste prostii stau în calea practică. Deoarece, dacă există activități legate de o povară, atunci totul se amplifică de 100 de ori. Prin urmare, schimbarea va fi adesea percepută cu reținere de către toți. Pentru că obiceiurile oamenilor sunt greu de corectat.
Când o persoană își îndeplinește sarcinile obișnuite, le face aproape fără să se gândească. Carga sa cognitivă este zero. Pur și simplu execută pas cu pas, are deja un checklist în minte, l-a făcut de o mie de ori. Și de îndată ce vii și îi spui: „Hai să anulăm această practică și de luni să implementăm una nouă” devine pentru el o mare povară cognitivă. În plus, această povară se instalează simultan pentru toți.
Așadar, cel mai simplu, de fapt, această luxurie nu o poate permite oricine, dar eu întotdeauna fac așa, acesta este următorul lucru. Dacă începe un nou proiect, de obicei toate practicile neexperimentate sunt imediat integrate în acest proiect. Atât timp cât proiectul este tânăr, nu risipim nimic. Prod nu există încă, nu este nimic de distrus. Așadar, ca antrenament, se poate utiliza. Această abordare funcționează. Dar nu toate companiile au posibilitatea de a lansa astfel de proiecte frecvent. Deși este puțin ciudat, deoarece acum există o transformare digitală constantă, toți ar trebui să lanseze experimente pentru a ține pasul cu concurența.
Aici ajungi la faptul că mai întâi trebuie să ai o înțelegere a ceea ce trebuie să faci. Lumea nu este perfectă, nici prod nu este perfect.
Da, aceste lucruri sunt interconectate.
De asemenea, companiile nu au întotdeauna înțelegerea că trebuie să meargă tocmai acolo.
Există o situație în care nicio schimbare nu este posibilă. Este o situație în care echipa este supusă unei presiuni mai mari. Echipa este deja destul de obosită. Nu are timp suplimentar pentru experimente. Ei dezvoltă caracteristici de dimineața până seara. Și conducerii i se cer din ce în ce mai multe caracteristici. Este nevoie de din ce în ce mai multe. Într-o astfel de situație, nicio schimbare nu este posibilă. Echipei i se poate spune doar că mâine vor face la fel ca ieri, trebuie doar să termine puțin mai multe caracteristici. Nicio tranziție spre alte practici nu este posibilă în acest sens. Este o situație clasică, în care nu este timp pentru a ascuți toporul, trebuie doar să tai copacii, așa că taie cu un topor bont. Aici nu există sfaturi simple.
(Dmitrii) Voi citi o clarificare din chat: „Dar este necesar un mare grad de acoperire prin teste la diferite niveluri. Cât timp este dedicat testării? Pare destul de scump, ia mult timp.”
(Oleg) Aceasta este o concepție greșită clasică. Trebuie să existe suficiente teste pentru a avea încredere în propriile abilități. Integrarea Continuă nu este ceva unde trebuie să ai 100% teste înainte de a începe să aplici această practică. Integrarea Continuă îți reduce încărcătura cognitivă prin faptul că fiecare modificare pe care o vezi cu ochii este atât de evidentă încât poți înțelege dacă va provoca sau nu o problemă, chiar și fără teste. Poți testa rapid în capul tău, deoarece modificările sunt mici. Chiar și dacă ai doar testeri manuali, le este și lor mai ușor. Ai lansat și ai spus: „Uită-te, nu s-a stricat nimic?”. Ei verifică și spun: „Nu, nu s-a stricat nimic”. Deoarece testerul știe unde să se uite. Ai un commit legat de un singur fragment de cod. Și acesta este exploatat printr-un comportament specific.
Aici ai, desigur, exagerat.
(Dmitry) Aici nu sunt de acord. Există practica dezvoltării prin testare, care te va salva tocmai de asta.
(Oleg) Aici nu am ajuns încă. Prima iluzie este că trebuie să scrii exact 100% teste sau să nu te ocupi deloc de Integrarea Continuă. Asta este fals. Acestea sunt două practici paralele și nu depind direct una de cealaltă. Acoperirea ta cu teste ar trebui să fie optimă. Optimă înseamnă că tu însuți ești sigur că calitatea maestrului, așa cum a rămas după commit, îți permite să apeși butonul „Deploy” cu încredere într-o seară de vineri, chiar și bând. Cum ajungi la asta? Prin revizuire, prin acoperire, printr-un bun monitorizare.
O bună monitorizare este indistinguibilă de teste. Dacă execuți teste o singură dată înainte de producție, atunci ele verifică toate scenariile tale utilizator într-o singură trecere. Dar dacă le execuți într-un ciclu infinit, atunci aceasta este sistemul tău extins de monitorizare, care testează constant – a căzut sau nu a căzut. În acest caz, diferența este doar în unicitate sau multiplicitate. Un set foarte bun de teste care …, executate continuu, este monitorizare. Și monitorizarea corectă ar trebui să fie astfel.
Și, prin urmare, cum exact vei atinge această stare în care te vei desploa într-o seară de vineri și vei merge acasă, este o altă întrebare. Poate ești doar un nebun curajos.
Să ne întoarcem puțin la Continuous Integration. Ne-am abătut puțin într-o altă practică complicată.
Și a doua iluzie este că MVP trebuie realizat rapid, deci nu sunt necesare teste. Nu este chiar așa. Când scrii user story pentru MVP, o poți dezvolta fie pe negru, adică ai auzit de o user story și ai început imediat să o codifici, fie să lucrezi conform TDD. Iar conform TDD, cum arată practica, nu durează mai mult, deci testele sunt un efect secundar. Practica TDD nu vizează testarea. Deși se numește Test Driven Development, nu este vorba în mod real despre teste. Este mai degrabă o abordare arhitecturală. Este o metodă de a scrie exact ceea ce este necesar, fără a scrie lucruri inutile. Această practică se concentrează pe următoarea iterație a dezvoltării tale în ceea ce privește arhitectura aplicației.
De aceea, nu este atât de simplu să scapi de aceste iluzii. MVP și teste nu se contrazic reciproc. Chiar, din contră, dacă realizezi un MVP conform practicii TDD, o vei face mai bine și mai repede decât dacă nu aplici deloc practica, lucrând pe negru.
Este o idee foarte subtilă și complicată. Când auzi că acum trebuie să scrii teste și că, în același timp, vei face ceva mai repede, pare absolut neloial.
(Dmitri) Multe persoane, când vorbesc despre MVP, sunt pur și simplu leneșe să scrie ceva de calitate. Și, totuși, aceste lucruri sunt diferite. Nu trebuie să transformi MVP într-o lucrare proastă care nu funcționează.
Da, ai dreptate.
Și apoi, brusc, MVP ajunge în producție.
Pentru totdeauna.
Și TDD sună foarte neobișnuit, când asculti că scrii teste și, pe deasupra, faci mai multă muncă. Pare foarte ciudat, dar, de fapt, rezultă că se face mai repede și mai frumos. Când scrii un test, deja în minte îți faci multe gânduri despre ce cod să scrii și cum va fi apelat, precum și ce comportament așteptăm de la el. Nu spui doar că ai scris o anumită funcție și ea face ceva. Te-ai gândit mai întâi că are anumite condiții, va fi apelată într-un anumit fel. Acoperi aceste aspecte cu teste și din asta înțelegi cum vor arăta interfețele din codul tău. Acest lucru influențează foarte mult arhitectura. Codul tău devine automat mai modular, deoarece mai întâi încerci să înțelegi cum să îl testezi, și abia apoi îl scrii.
Am avut astfel de experiențe cu TDD, încât, la un moment dat, am angajat un mentor pentru Ruby, când încă eram programator Ruby. Și el spune: „Hai să aplici TDD”. M-am gândit: „Wow, acum trebuie să scriu ceva în plus”. Ne-am înțeles că, timp de două săptămâni, voi scrie tot codul funcțional în Python folosind TDD. După două săptămâni, am realizat că nu vreau să mă întorc înapoi. Încercând să aplic asta în tot ce fac, înțelegi cât de mult îți simplifică gândirea. Dar nu este evident, așa că recomand tuturor să încerce TDD timp de două săptămâni. Mie mi-au fost suficiente două săptămâni pentru asta.
(Dmitri) Putem extinde această idee din perspectiva exploatării infrastructurii. Înainte de a lansa ceva nou, facem monitorizare și abia apoi lansăm. În acest caz, monitorizarea devine un test normal. Și există dezvoltare prin monitorizare. Dar aproape toată lumea spune că durează prea mult, că este obositor, că a făcut un draft temporar. Dacă am realizat o monitorizare corectă, înțelegem starea sistemului CI. Iar în sistemul CI există multă monitorizare. Înțelegem starea sistemului și ceea ce se află în interiorul său. Și în timpul dezvoltării, tocmai construim sistemul pentru a ajunge la starea dorită.
Aceste practici sunt cunoscute de mult timp. Le-am discutat acum aproximativ 4 ani. Dar în 4 ani aproape nimic nu s-a schimbat.
Dar pe această notă sugerez să încheiem discuția oficială.
Video (inserat ca element media, dar dintr-un motiv oarecare nu funcționează):
Sursa: habr.com
