

Configurarea stocării datelor aplicațiilor care rulează într-un cluster Kubernetes se poate face în mai multe moduri. Unele dintre acestea sunt deja învechite, în timp ce altele au apărut recent. În acest articol vom explora concepția a trei opțiuni de conectare a stocării, inclusiv cea mai recentă — conectarea prin Container Storage Interface.
Metoda 1. Specificarea PV în manifestul pod-ului
Un manifest tipic care descrie un pod în clusterul Kubernetes:
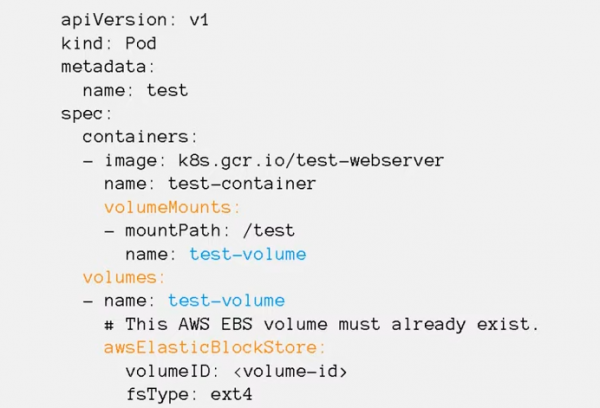
Părțile manifestului care descriu ce volum este conectat și unde sunt evidențiate prin culoare.
În secțiune volumeMounts indică punctele de montare (mountPath) — în ce director din interiorul containerului va fi montat volumul persistent, precum și numele volumului.
În secțiune x enumeră toate volumele care sunt utilizate în pod. Se specifică numele fiecărui volum, precum și tipul (în cazul nostru: awsElasticBlockStore) și parametrii de conectare. Ce anume trebuie specificat în manifest depinde de tipul volumului.
Același volum poate fi montat simultan în mai multe containere ale pod-ului. Astfel, diferite procese ale aplicației pot avea acces la aceleași date.
Această metodă de conectare a fost inventată la începuturile Kubernetes și în prezent metoda este învechită.
Utilizând-o, apar mai multe probleme:
- toate volumele trebuie create manual, Kubernetes nu va putea crea nimic în locul nostru;
- parametrii de acces pentru fiecare volum sunt unici și trebuie specificați în manifestele tuturor pod-urilor care utilizează volumul;
- pentru a schimba sistemul de stocare (de exemplu, a migra de la AWS la Google Cloud), trebuie să schimbi setările și tipul volumelor conectate în toate manifestele.
Toate acestea sunt foarte inconfortabile, de aceea în realitate această metodă este utilizată doar pentru a conecta anumite tipuri speciale de volume: configMap, secret, emptyDir, hostPath:
configMap și secret — volume de sistem, permit crearea unui volum în container cu fișiere din manifestele Kubernetes.
emptyDir — volum temporar, se creează doar pe durata vieții pod-ului. Este convenabil de utilizat pentru teste sau pentru stocarea datelor temporare. Când pod-ul este șters, volumul de tip emptyDir este, de asemenea, șters și toate datele dispar.
hostPath — permite montarea oricărui director local de pe server în interiorul unui container de aplicație, inclusiv /etc/kubernetes. Aceasta este o opțiune nesigură, așa că, de obicei, politicile de securitate interzic utilizarea volumelor de acest tip. Altfel, aplicația unui atacator ar putea monta în interiorul containerului său directorul HTC Kubernetes și ar putea fura toate certificatele cluster-ului. De regulă, volumele hostPath sunt permise doar aplicațiilor de sistem care rulează în namespace kube-system.
sunt descrise în documentație.
Metoda 2. Conectarea la poduri SC/PVC/PV
O altă metodă de conectare — conceptul clasei de stocare, PersistentVolumeClaim, PersistentVolume.
Clasa de stocare stochează parametrii de conectare la sistemul de stocare a datelor.
PersistentVolumeClaim descrie cerințele pentru volumul necesar aplicației.
PersistentVolume stochează parametrii de acces și starea volumului.
Esenta ideii: în manifestul podului, se indică un volum de tip PersistentVolumeClaim și se specifică numele acestei entități în parametrul claimName.
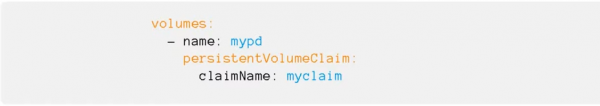
În manifestul PersistentVolumeClaim se descriu cerințele pentru volumul de date necesar aplicației. Acesta include:
- dimensiunea discului;
- metoda de acces: ReadWriteOnce sau ReadWriteMany;
- referința la clasa de stocare — în ce sistem de stocare dorim să creăm volumul.
În manifestul clasei de stocare se păstrează tipul și parametrii de conectare la sistemul de stocare a datelor. Acestea sunt necesare cubletului pentru a monta volumul pe nodul său.
În manifestele PersistentVolume se indică clasa de stocare și parametrii de acces la volumul specific (ID-ul volumului, calea etc.).
Creează PVC, Kubernetes verifică ce volum de ce dimensiune și din ce clasă de stocare este necesar și alege un PersistentVolume liber.
Dacă nu există PV disponibile, Kubernetes poate lansa un program special — Provisioner (numele acestuia este specificat în clasa de stocare). Acest program se conectează la SCSI, creează volumul de dimensiunea necesară, obține un identificator și creează în clusterul Kubernetes un manifest PersistentVolume, care este asociat cu PersistentVolumeClaim.
Această multitudine de abstractizări permite eliminarea informațiilor despre ce SCSI lucrează aplicația, de la nivelul manifestelor aplicațiilor la nivelul administrării.
Toate parametrii de conectare la sistemul de stocare a datelor se află în Storage class, pentru care sunt responsabili administratorii cluster-ului. Tot ce trebuie făcut atunci când se face tranziția de la AWS la Google Cloud este să se schimbe denumirea Storage class în PVC în manifestele aplicației. Volumul de persistență pentru stocarea datelor va fi creat automat în cluster, cu ajutorul programului Provisioner.
Metoda 3. Container Storage Interface
Tot codul care interacționează cu diferitele sisteme de stocare a datelor este parte din nucleul Kubernetes. Lansarea remedierilor de erori sau a unor funcționalități noi este legată de noile versiuni, iar codul trebuie modificat pentru toate versiunile Kubernetes suportate. Toate acestea sunt greu de întreținut și de adăugat funcționalități noi.
Pentru a rezolva problema, dezvoltatorii din Cloud Foundry, Kubernetes, Mesos și Docker au creat Container Storage Interface (CSI) — o interfață simplă și unificată care descrie interacțiunea dintre sistemul de gestionare a containerelor și driverul specific (CSI Driver) care lucrează cu un anumit sistem de stocare a datelor. Tot codul pentru interacțiunea cu sistemele de stocare a fost scos din nucleul Kubernetes într-un sistem separat.
.
În general, CSI Driver este compus din două componente: Node Plugin și Controller plugin.
Node Plugin este rulat pe fiecare nod și este responsabil pentru montarea volumelor și pentru operațiile pe acestea. Controller plugin interacționează cu sistemul de stocare: creează sau șterge volume, alocă drepturi de acces etc.
Deocamdată, în nucleul Kubernetes rămân vechile drivere, dar utilizarea lor nu mai este recomandată, încurajându-se instalarea CSI Driver specific pentru sistemul cu care trebuie să se colaboreze.
Inovația poate speria pe cei care s-au obișnuit să configureze stocarea datelor prin Storage class, dar în realitate nu s-a întâmplat nimic alarmant. Pentru programatori nu se schimbă nimic — ei vor continua să lucreze doar cu denumirea Storage class. Administratorii au acum o instalare a helm chart-ului și s-a schimbat structura setărilor. Dacă înainte setările erau introduse direct în Storage class, acum trebuie definite mai întâi în helm chart și apoi în Storage class. Dacă se analizează, nu s-a întâmplat nimic grav.
Să luăm, prin exemplu, în considerare ce avantaje pot fi obținute trecând la conectarea sistemului de stocare Ceph prin intermediul driverului CSI.
Când se lucrează cu Ceph, pluginul CSI oferă mai multe posibilități de interacțiune cu sistemul de stocare decât driver-ele integrate.
- Crearea dinamică a discurilor. De obicei, discurile RBD sunt folosite doar în modul RWO, iar CSI pentru Ceph permite utilizarea lor în modul RWX. Mai multe pod-uri pe noduri diferite pot monta același disc RDB și pot lucra cu ele în paralel. Așa cum se cuvine, nu totul este atât de strălucitor — acest disc poate fi conectat doar ca un dispozitiv de stocare bloc, ceea ce înseamnă că va trebui să adaptați aplicația pentru a lucra cu el în modul de acces multiplu.
- Crearea snapshot-urilor. În clusterul Kubernetes, se poate crea un manifest cu cerința de a crea un snapshot. Plug-in-ul CSI îl va vedea și va crea un snapshot de pe disc. Pe baza acestuia, se poate face un backup sau o copie a PersistentVolume.
- Creșterea dimensiunii discului pe SxhD și PersistentVolume în clusterul Kubernetes.
- Quotă. Driverii încorporați în Kubernetes pentru CephFS nu suportă cotele, iar noile plugin-uri CSI cu Ceph Nautilus pot activa cotele pe partțiile CephFS.
- Metri. Plug-in-ul CSI poate oferi în Prometheus multe metri despre care volume sunt conectate, ce interacțiuni au loc etc.
- Topologie conștientă. Permite specificarea în manifeste cum este distribuit geografic clusterul și evitarea conectării la pod-uri care rulează în Londra dacă sistemul de stocare este localizat în Amsterdam.
Cum să conectați Ceph la clusterul Kubernetes prin CSI, vedeți . De asemenea, puteți să vă abonați la , care va începe pe 15 octombrie.
Autorul articolului: Sergey Bondarev, arhitect practicant la Southbridge, Administrator Certificat Kubernetes, unul dintre dezvoltatorii kubespray.
Un pic de Post Scriptum nu ca reclamă, ci din utilitate...
P.S. Sergey Bondarev conduce două intensive: actualizat 28-30 septembrie și avansat 14–16 octombrie.
Sursa: habr.com
