

Bună!
Mă numesc Mihail, sunt director adjunct IT la compania „Sportmaster”. Vreau să împărtășesc o poveste despre cum am făcut față dificultăților apărute în timpul pandemiei.
În primele zile ale noilor realități, formatul obișnuit de comerț offline „Sportmaster” s-a oprit, iar volumul de activitate pe canalul nostru online, în special în ceea ce privește livrarea la adresa clientului, a crescut de 10 ori. În câteva săptămâni, am transformat un imens business offline într-unul online, adaptând serviciul la nevoile clienților noștri.
În esență, ceea ce a fost considerat o operațiune secundară a devenit activitatea principală. Importanța fiecărei comenzi online a crescut extrem de mult. Trebuia să păstrăm fiecare leu pe care clientul îl aducea în companie.
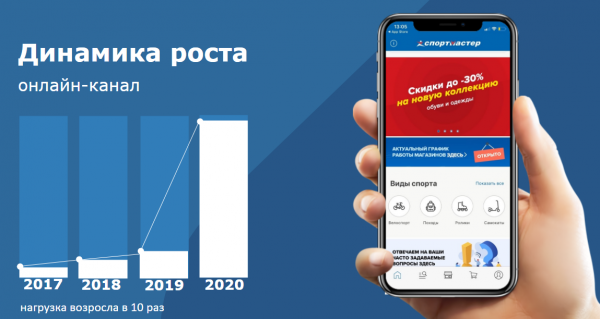
Pentru a răspunde rapid la cererile clienților, am deschis un centru de contact suplimentar în sediul principal al companiei, iar acum putem primi aproximativ 285 de mii de apeluri pe săptămână. În același timp, am transferat 270 de magazine într-un nou format de lucru fără contact și sigur, ceea ce le-a permis clienților să își primească comenzile, iar angajaților să își păstreze locurile de muncă.
În procesul de transformare, am avut două probleme principale. Pe de o parte, volumul de activitate asupra resurselor noastre online a crescut semnificativ (cum am depășit acest lucru ne va povesti Serghei). Pe de altă parte, fluxul de operațiuni rare (până la COVID) a crescut exponențial, ceea ce a necesitat un volum mare de automatizare rapidă. Pentru a rezolva această problemă, a trebuit să realocăm rapid resurse de la direcțiile care erau anterior principale. Cum am făcut față acestei situații — ne va spune Elena.
Exploatarea serviciilor online
Kolesnikov Serghei, responsabil pentru exploatarea magazinului online și a microserviciilor
Din momentul în care magazinele noastre de retail au început să se închidă pentru vizitatori, am început să înregistrăm o creștere a unor metrici, cum ar fi numărul de utilizatori, numărul de comenzi efectuate în aplicația noastră, numărul de solicitări către aplicații.
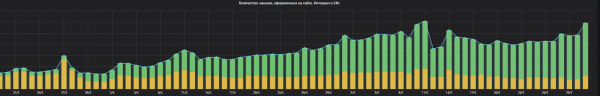 Numărul comenzilor din 18 până pe 31 martie
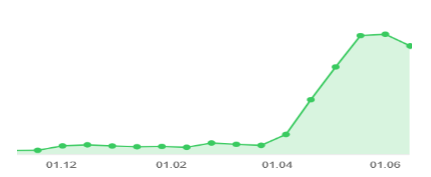 Numărul de solicitări către microserviciile de plată online
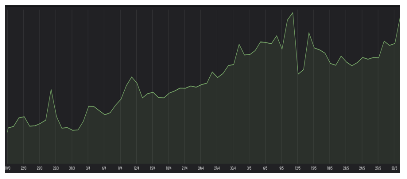 Numărul de comenzi plasate pe site
În prima grafică vedem că creșterea a fost de aproximativ 14 ori, iar în a doua — 4 ori. Considerăm că cea mai reprezentativă metrică în acest caz este timpul de răspuns al aplicațiilor noastre.
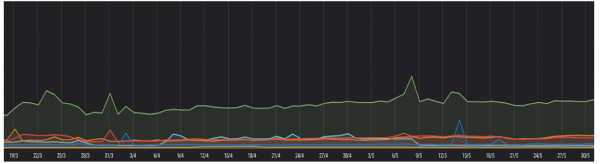
În acest grafic vedem răspunsul fronturilor și aplicațiilor, iar pentru noi s-a stabilit că nu am observat o creștere semnificativă.
În primul rând, acest lucru se datorează faptului că am început lucrările pregătitoare la sfârșitul anului 2019. În prezent, serviciile noastre sunt rezervate, asigurăm redundanța la nivelul serverelor fizice, al sistemelor de virtualizare, Docker-elor și al serviciilor din acestea. În același timp, resursele serverelor noastre sunt capabile să facă față unor sarcini multiple.
Principalul instrument care ne-a ajutat în toată această poveste a fost sistemul nostru de monitorizare. Totuși, cu doar câteva timp în urmă nu aveam un sistem unificat care să permită colectarea metricalor la toate nivelurile, de la echipamentul fizic și hardware la metricalor de business.
Formal, monitorizarea era prezentă în companie, dar de regulă era dispersată și era în responsabilitatea unor subdiviziuni specifice. De fapt, atunci când apărea un incident, aproape niciodată nu aveam o înțelegere unificată a ceea ce s-a întâmplat, nu exista informare, și adesea ducea la o căutare în cerc pentru localizarea problemei și soluționarea acesteia.
La un moment dat am început să ne gândim și am decis că este suficient — avem nevoie de un sistem unificat pentru a vedea întreaga imagine. Tehnologiile principale care intră în stiva noastră sunt Zabbix ca centru de alertare și stocare a metricalor, Prometheus pentru colectarea și stocarea metricalor aplicațiilor, stiva ELK pentru logare și stocarea datelor întregului sistem de monitorizare, precum și Grafana pentru vizualizare, Swagger, Docker și alte lucruri utile și familiarizate vouă.
În plus, folosim nu doar tehnologiile disponibile pe piață, ci și dezvoltăm unele lucruri pe cont propriu. De exemplu, creăm servicii pentru integrarea sistemelor între ele, adică un anumit API pentru colectarea metricalor. De asemenea, lucrăm la propriile noastre sisteme de monitorizare — la nivel de metricale de business folosim teste UI. Plus un bot pe Telegram pentru notificarea echipelor.
În plus, ne străduim să facem sistemul de monitorizare accesibil echipelor, astfel încât acestea să poată stoca și lucra singure cu metricalele lor, inclusiv să configureze alertele pentru anumite metricale înguste, cu utilizare mai puțin răspândită.
În cadrul întregii sisteme, ne străduim să fim proactivi și să localizăm incidentele cât mai rapid. De asemenea, numărul microserviciilor și al sistemelor noastre a crescut semnificativ în ultima vreme, astfel că numărul integrărilor crește. În cadrul optimizării procesului de diagnosticare a incidentelor la nivel de integrare, dezvoltăm un sistem care permite efectuarea de verificări între sisteme și generarea de rezultate, ceea ce ajută la identificarea problemelor fundamentale legate de importuri și interacțiunea dintre sisteme.
Desigur, mai avem mult de crescut și de dezvoltat în ceea ce privește exploatarea sistemelor, și lucrăm activ la acest lucru. Puteți citi mai multe despre sistemul nostru de monitorizare .
Teste tehnice
Serghei Orlov, conduce centrul de competență în dezvoltarea web și mobilă
De la începutul închiderii magazinelor fizice, am fost nevoiți să ne confruntăm cu diverse provocări din punct de vedere al dezvoltării. În primul rând, o creștere a sarcinii de lucru. E clar că, dacă nu sunt luate măsurile corespunzătoare, atunci, în cazul unei sarcini mari aplicate pe sistem, acesta s-ar putea transforma cu un zgomot trist în dovleac, fie că și-ar pierde complet performanța, fie că ar deveni complet inutilizabil.
Al doilea aspect, ceva mai puțin evident, este că sistemul sub o sarcină mare trebuia schimbat foarte repede, adaptându-se schimbărilor în procesele de afaceri. Uneori, de câteva ori pe zi. În multe companii există o regulă că, în timpul unor activități de marketing de amploare, nu ar trebui să se facă modificări în sistem. Niciun fel de modificări, lasă-l să funcționeze, atâta timp cât funcționează.
În cazul nostru, în esență, a fost o vineri neagră nesfârșită, în care, în același timp, trebuia să schimbăm sistemul. Orice greșeală, problemă, eroare în sistem ar fi costat foarte mult business-ul.
Privind înainte, pot spune că am reușit să facem față acestor provocări, toate sistemele au rezistat sarcinii de lucru, s-au scalat ușor și nu am avut probleme tehnice globale.
Există patru piloni pe care se bazează capacitatea sistemului de a face față unor sarcini de încărcare variabilă. Primul dintre aceștia este monitorizarea, despre care ai citit mai sus. Fără un sistem de monitorizare bine structurat, este practic imposibil să găsești punctele slabe ale sistemului. Un sistem bun de monitorizare este ca o ținută de acasă, trebuie să fie comod și adaptat pentru tine.
Al doilea aspect este testarea. Ne tratăm foarte serios acest aspect: scriem atât teste unitare clasice, teste de integrare, teste de performanță și multe altele pentru fiecare sistem. De asemenea, redactăm o strategie de testare și ne străduim să ducem nivelul testării la un punct în care verificările manuale să nu mai fie necesare.
Al treilea pilon este CI/CD Pipeline. Procesele de construire, testare și desfășurare a aplicației trebuie să fie cât mai automatizate, fără intervenții manuale. Subiectul CI/CD Pipeline este destul de profund și îl voi aborda doar în treacăt. Merită menționat că avem o listă de verificare pentru CI/CD Pipeline, care este parcursă de fiecare echipă de produs cu ajutorul centrelor de competență.
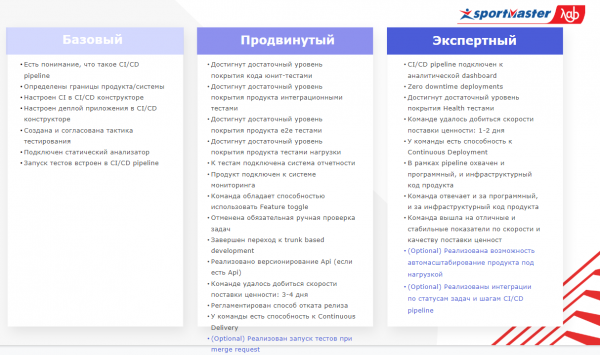 Iată lista de verificare
Astfel se ating foarte multe obiective. Aceasta include versionarea API-ului, feature toggle pentru a evita problemele cu lansările în masă, și asigurarea că diferitele niveluri de teste sunt complet automatizate, desfășurările să fie fără cusur și altele.
Al patrulea pilon sunt principiile arhitecturale și soluțiile tehnice. Despre arhitectură se poate vorbi mult și bine, dar vreau să subliniez câteva principii la care aș dori să atrag atenția.
În primul rând, trebuie să alegem instrumente specializate pentru sarcini specifice. Da, sună evident, și este clar că pentru a bate cuie este necesar un ciocan, iar pentru a demonta ceasuri de mână sunt necesare șurubelnițe speciale. Însă, în epoca noastră, multe instrumente tind spre universalizare, pentru a acoperi un segment maxim de utilizatori: baze de date, cache-uri, framework-uri și altele. De exemplu, dacă luăm baza de date MongoDB, ea funcționează cu tranzacții multi-document, iar baza de date Oracle funcționează cu JSON-uri. Și ar părea că totul poate fi folosit pentru orice. Dar, dacă militam pentru performanță, trebuie să înțelegem clar punctele forte și slabe ale fiecărui instrument și să utilizăm cele necesare pentru clasa noastră de sarcini.
În al doilea rând, atunci când proiectăm sisteme, fiecare creștere a complexității trebuie să fie justificată. Trebuie să păstrăm constant în minte acest lucru, principiul low coupling este bine cunoscut. Cred că acesta trebuie aplicat atât la nivelul serviciului specific, cât și la nivelul întregului sistem și la nivelul peisajului arhitectural. De asemenea, este importantă capacitatea de scalare orizontală a fiecărui component al sistemului sub presiune. Dacă avem această capacitate, scalarea nu va fi o problemă.
Când vine vorba de soluții tehnice, am cerut echipelor de produs să pregătească un set proaspăt de recomandări, idei și soluții pe care le-au implementat în procesul de pregătire pentru următoarea ondă de încărcare.
Cache-uri
Este necesar să abordăm conștient alegerea cache-urilor locale și distribuite. Uneori are sens să folosim atât unele, cât și altele în cadrul aceluiași sistem. De exemplu, avem sisteme în care o parte din date este practic un cache de vitrină, adică sursa actualizărilor se află în afara sistemului, iar sistemele nu modifică aceste date. Pentru un astfel de abordare, folosim cache-ul local Caffeine.
Există date care sunt active modificate de către sistem în timpul funcționării, iar aici aplicăm cache-ul distribuit cu Hazelcast. Această abordare ne permite să folosim avantajele cache-ului distribuit acolo unde sunt cu adevărat necesare și să minimizăm costurile de servicii prin circulația datelor în clusterul Hazelcast acolo unde putem să ne descurcăm fără. Am scris mult despre cache-uri. și .
În plus, trecerea la serializatorul Kryo în Hazelcast ne-a adus un avantaj semnificativ. De asemenea, tranziția de la ReplicatedMap la IMap + Near Cache în Hazelcast ne-a permis să minimizăm mișcarea datelor prin cluster.
Un sfat mic: la invalidarea în masă a cache-ului, uneori este aplicabilă tactica de preîncălzire a unui al doilea cache, urmată de comutarea pe acesta. Ar părea că abordarea aceasta ar trebui să genereze un consum dublu de memorie, dar în practică, în sistemele unde s-a aplicat, consumul de memorie a scăzut.
Stack reactiv
Folosim stack-ul reactiv într-un număr deja destul de mare de sisteme. În cazul nostru, acesta este Webflux sau Kotlin cu corutine. Stack-ul reactiv este deosebit de eficient acolo unde anticipăm operațiuni lente de input-output. De exemplu, apeluri la servicii lente, lucrul cu sistemul de fișiere sau cu sistemele de stocare.
Cel mai important principiu este să evităm apelurile blocante. Sub capotă, cadrele reactive utilizează un număr mic de fire de execuție de serviciu active. Dacă permitem cu neatenție un apel blocant direct, cum ar fi un apel al driver-ului JDBC, sistemul pur și simplu se va opri.
Încercați să transformați erorile în excepții runtime proprii. Fluxul real de execuție al programului se îndreaptă către cadrele reactive, iar execuția codului devine nonlineară. Ca urmare, este foarte greu să diagnosticăm problemele pe baza stack trace-urilor. Soluția aici va fi crearea unor excepții runtime clare și obiective pentru fiecare eroare.
Elasticsearch
Când folosiți Elasticsearch, evitați selectarea datelor nefolosite. Acesta este, de principiu, un sfat simplu, dar cel mai adesea este exact ceea ce se uită. Dacă trebuie să selectați mai mult de 10.000 de înregistrări odată, trebuie să utilizați Scroll. Dacă facem o analogie, aceasta este puțin similară cu un cursor în baza de date relațională.
Nu utilizați postfilter fără necesitate. La date mari în selecția principală, această operațiune încarcă semnificativ baza de date.
Folosiți operațiuni bulk acolo unde este cazul.
API
Când proiectați API-ul, includeți cerințe pentru minimizarea datelor transmise. Acest lucru este deosebit de relevant în legătură cu front-end-ul: exact la acest interfeței noi ne depășim canalele DC-urilor noastre și lucrăm pe canalul care ne leagă de client. Dacă există cele mai mici probleme, un trafic prea mare provoacă o experiență negativă pentru utilizator.
Și, în cele din urmă, nu aruncați toată o grămadă de date, abordați clar contractul dintre consumatori și furnizori.
Transformare organizațională
Erochkina Elena, director adjunct de IT
În momentul în care a avut loc carantina și a apărut necesitatea de a accelera dezvoltarea online și de a implementa servicii omnichannel, noi eram deja în proces de transformare organizațională.
O parte din structura noastră a fost transformată pentru a lucra conform principiilor și practicilor unei abordări bazate pe produse. S-au format echipe care acum sunt responsabile pentru funcționarea și dezvoltarea fiecărui produs. Angajații din aceste echipe sunt implicați 100% și își structurează munca conform metodologiilor Scrum sau Kanban, în funcție de ceea ce este mai preferabil pentru ei, configurează procesul de livrare, implementează practici tehnice, practici de asigurare a calității și multe altele.
Din fericire, majoritatea acestor echipe de produs erau deja în domeniul online și al serviciilor omnichannel. Acest lucru ne-a permis să trecem rapid (serios, în doar două zile) la modul de lucru la distanță fără a pierde eficiența. Procesul configurat ne-a permis să ne adaptăm rapid la noile condiții de lucru și să menținem un ritm suficient de ridicat în livrarea de noi funcționalități.
În plus, a apărut necesitatea de a consolida echipele care se află în prim-planul afacerii online. În acel moment a devenit clar că putem face acest lucru doar prin resurse interne. Aproximativ 50 de persoane au schimbat domeniul în care lucrau până atunci și s-au integrat în lucrul la un nou produs pentru ele, în decurs de două săptămâni.
Pentru aceasta nu a fost nevoie de eforturi manageriale speciale, deoarece, alături de organizarea propriului proces, cu perfecționarea tehnică a produsului și cu practici de asigurare a calității, învățăm echipele noastre despre auto-organizare — să gestioneze propriul proces de producție fără a solicita resurse administrative.
Resursa managerială am reușit să ne concentrăm exact acolo unde a fost necesar în acel moment, adică pe coordonarea împreună cu afacerea: Ce este acum important pentru clientul nostru, ce funcționalitate trebuie să fie implementată în primul rând, ce trebuie să facem pentru a crește capacitatea noastră de livrare și procesare a comenzilor. Toate acestea și un model de rol clar ne-au permis, în această perioadă, să încărcăm fluxurile noastre de producție cu ceea ce este cu adevărat important și necesar.
E clar că, în condițiile muncii de la distanță și a ritmului rapid de schimbare, când depindem de contribuția fiecăruia pentru indicatorii de afaceri, nu ne putem baza doar pe percepțiile interne de genul „Merge totul bine? Da, pare destul de bine”. Sunt necesare metrici obiective ale procesului de producție. Le avem, sunt accesibile oricui este interesat de metricile echipelor de produs. În primul rând, echipei înseși, afacerii, colegilor și conducerii.
O dată la două săptămâni, cu fiecare echipă se desfășoară o întâlnire de status, în cadrul căreia, timp de 10 minute, se analizează metricile, se identifică punctele slabe ale procesului de producție și se dezvoltă o soluție comună: ce se poate face pentru a elimina aceste puncte slabe. De asemenea, se poate solicita imediat ajutorul conducerii în cazul în care o problemă identificată se află în afara zonei de influență a echipelor sau expertiza colegilor care, poate, s-au confruntat deja cu o problemă similară.
Cu toate acestea, înțelegem că pentru a atinge o accelerare exponențială (exact acest obiectiv ne-am propus) trebuie să învățăm și să implementăm multe lucruri în munca zilnică. În prezent, continuăm să extindem abordarea pe bază de produs la alte echipe și la noi produse. Pentru aceasta, a trebuit să ne familiarizăm cu un nou format de școală online pentru metodologi.
Metodologii, persoanele care ajută echipele să își organizeze procesul, să stabilească comunicarea, să îmbunătățească eficiența muncii, sunt, în esență, agenți de schimbare. În acest moment, absolvenții primului nostru lot colaborează cu echipele și le ajută să devină de succes.
Cred că situația actuală ne deschide oportunități și perspective pe care, poate, nici măcar nu le conștientizăm pe deplin. Dar experiența și practica pe care le dobândim chiar acum confirmă că am ales calea corectă de dezvoltare, nu vom pierde aceste noi oportunități în viitor și vom putea răspunde eficient provocărilor care vor apărea în fața „Sportmaster”.
Conclusions
În această perioadă dificilă, am formulat principii principale pe care se bazează dezvoltarea software-ului, care, cred eu, vor fi relevante pentru fiecare companie care se ocupă cu acest domeniu.
Oameni. Acesta este fundamentul. Angajații trebuie să se bucure de muncă, să înțeleagă obiectivele companiei și ale produselor cu care lucrează. Și, desigur, să aibă posibilitatea de a se dezvolta profesional.
Tehnologie. Este necesar ca compania să se apropie matur de gestionarea stivei sale tehnologice și să își dezvolte competențele acolo unde este cu adevărat necesar. Pare foarte simplu și evident. Și este adesea ignorat.
Procese. Este important să organizăm corect munca echipelor de produs și a centrelor de competență, să stabilim interacțiunea cu afacerea, astfel încât să lucrăm cu aceasta ca un partener.
În general, cam așa am supraviețuit. Teza principală a contemporaneității a fost confirmată din nou, lovind puternic în frunte.
Chiar dacă ești un mare business offline cu numeroase magazine și multe orașe de prezență, dezvoltă-ți online-ul. Nu este doar un canal suplimentar de vânzare sau o aplicație frumoasă prin care se poate cumpăra ceva (ci și pentru că și concurenții au aplicații frumoase). Nu este o rezervă pentru vremuri grele, care te va ajuta să rezisti furtunii.
Este o necesitate absolută. La care trebuie să fie pregătite nu doar capacitățile tale tehnice și infrastructura, ci și oamenii și procesele. Căci este posibil să cumperi rapid memorie, spațiu, să desfășori noi instanțe și altele în câteva ore. Însă oamenii și procesele trebuie pregătite în avans pentru a face asta.
Sursa: habr.com
