

Salut tuturor. Acest articol este scris pentru cei care încă se confruntă cu alegerea platformelor de virtualizare și, după ce au citit articole din seria „Am instalat proxmox și totul este excelent, 6 ani de uptime fără întreruperi”. Dar după instalarea unei soluții gata făcute, apare întrebarea cum să ajustez aici și acolo pentru ca monitorizarea să fie mai clară și aici, pentru a controla backup-urile… Apoi vine momentul în care realizezi că îți dorești ceva mai funcțional, sau că vrei ca totul din sistemul tău să fie clar, nu un „cutie neagră”, sau că vrei să folosești ceva mai mult decât un hypervisor și câteva mașini virtuale. În acest articol vor fi unele reflecții și practică bazată pe platforma OpenNebula — am ales-o pentru că nu este foarte exigentă cu resursele și arhitectura ei nu este atât de complexă.
Așadar, cum vedem, mulți furnizori de cloud lucrează pe KVM și implementează soluții externe pentru gestionarea mașinilor. Este clar că marii hosteri își scriu propriile soluții pentru infrastructura cloud, cum ar fi YANDEX de exemplu. Unii folosesc OpenStack și fac soluții pe această bază — SELECTEL, MAIL.RU. Dar dacă ai hardware-ul tău și un mic grup de specialiști, de obicei alegi ceva din soluțiile existente — VMWARE, HYPER-V, există licențe gratuite și plătite, dar acum nu despre asta vorbim. Vom discuta despre entuziaști — aceștia sunt cei care nu se tem să propună și să încerce lucruri noi, în ciuda faptului că compania a dat clar de înțeles „Cine va întreține asta după tine?”, „Asta crezi că o vom implementa în producție? E înfricoșător.” Dar poți începe prin a folosi aceste soluții în condiții de testare și, dacă tuturor le place, poți ridica problema dezvoltării ulterioare și a utilizării în medii mai serioase.
Iată și un link către prezentare de un participant activ în dezvoltarea acestei platforme.
Este posibil ca în acest articol să existe informații care sunt deja evidente pentru un specialist experimentat, iar în alte cazuri nu voi descrie totul, deoarece comenzi similare și descrieri există deja online. Aici este doar experiența mea de lucru cu această platformă. Sper că participanții activi vor completa în comentarii ce poate fi îmbunătățit și ce greșeli am făcut. Toate acțiunile au fost desfășurate în condițiile unui stand de acasă format din 3 PC-uri cu specificații diferite. De asemenea, am decis să nu specific cum funcționează acest program și cum se instalează. Nu, doar experiența de administrare și problemele cu care m-am confruntat. Poate că acesta va fi util cuiva în alegere.
Așadar, să începem. Pentru mine, ca administrator de sistem, sunt importante următoarele puncte, fără de care este puțin probabil să folosesc această soluție.
1. Repetabilitatea instalării
Există o mulțime de instrucțiuni pentru instalarea opennebula, așa că nu ar trebui să apară probleme. De la o versiune la alta, apar noi funcții care nu funcționează întotdeauna când treci de la o versiune la alta.
2. Monitorizarea
Vom monitoriza nodul în sine, kvm și opennebula. Din fericire, există deja soluții gata pregătite. Există o mulțime de opțiuni pentru monitorizarea serverelor linux, cum ar fi Zabbix sau Node Exporter — fiecare cu preferințele sale — în prezent consider că monitorizarea metricilor de sistem (temperatura acolo unde poate fi măsurată, consistența matricei de discuri) se face prin Zabbix, iar aplicațiile sunt monitorizate prin exporter în Prometheus. De exemplu, pentru monitorizarea kvm, putem lua proiectul și să-l configurăm pentru a rula prin systemd, funcționează foarte bine și afișează metrici kvm, de asemenea, există un dashboard gata pregătit. .
De exemplu, acesta este fișierul meu:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
Astfel, avem 1 exporter, avem nevoie de al doilea pentru a monitoriza opennebula, am folosit acesta
Poate fi adăugat la cel standard. Pentru monitorizarea sistemului, următoarele.
În fișierul node_exporter, modificăm start-ul astfel:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorCreăm directorul mkdir -p /var/lib/opennebula_exporter
Verificăm mai întâi funcționarea scriptului bash prezentat mai sus prin consolă; dacă afișează ceea ce trebuie (dacă dă o eroare, instalăm xmlstarlet), îl copiem în /usr/local/bin/opennebula_exporter.sh
Adăugăm o sarcină cron pentru fiecare minut:
*\/1 * * * * (/usr/local/bin/opennebula_exporter.sh > /var/lib/opennebula_exporter/textfile_collector/opennebula.prom)Metricile au început să apară, le putem prelua cu Prometheus și să construim grafice și să facem alerte. În Grafana putem desena, de exemplu, un tablou de bord simplu.
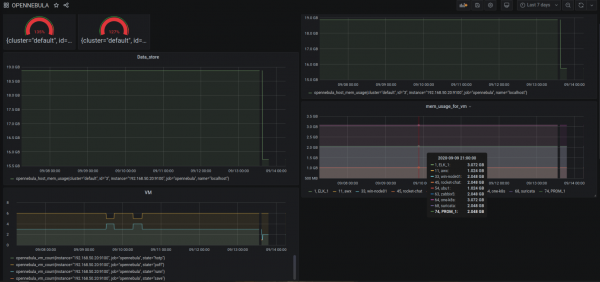
(se vede că aici am făcut overcommit la CPU, RAM)
Pentru cei care iubesc și folosesc Zabbix, există
Despre monitorizare, e totul, cel mai important e că există. Desigur, putem adăuga folosind instrumentele încorporate de monitorizare a mașinilor virtuale și să exportăm datele în facturare; aici fiecare are viziunea sa, deocamdată nu m-am apucat de asta mai serios.
Despre logging, nu am început încă. Cea mai simplă opțiune ar fi să adaug td-agent pentru a parsa directorul /var/lib/one cu expresii regulate. De exemplu, fișierul sunstone.log se potrivește cu regexp nginx și alte fișiere care arată istoricul interacțiunilor cu platforma — care este avantajul în acest sens? De exemplu, putem urmări clar numărul de „Error, error” și putem identifica mai repede unde și la ce nivel există o defectiune.
3. Backup-uri
Există și proiecte plătite, îmbunătățite — de exemplu sep :OpenNebula_Backup. Aici trebuie să înțelegem că pur și simplu a face backup-ul imaginii mașinii, în acest caz, nu este suficient, deoarece mașinile noastre virtuale trebuie să funcționeze cu integrare completă (același context al fișierului în care sunt descrise setările rețelei, numele vm și setările personalizate pentru aplicațiile tale). De aceea, stabilim ce și cum vom face backup. În anumite cazuri, este mai bine să facem copii ale ceea ce se află în mașina virtuală. Și poate că trebuie să facem backup doar pentru un singur disc al acestei mașini.
De exemplu, ne-am decis că toate mașinile pornesc cu imagini persistente, deci citind
înseamnă că mai întâi putem exporta imaginea din mașina noastră:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Să vedem sub ce nume a fost salvat

oneimage show 77
/var/lib/one//datastores/100/f9503161fe180658125a9b32433bf6e8

Și apoi copiem unde avem nevoie. Desigur, este un mod oarecum simplist. Doar am vrut să arăt că, folosind uneltele OpenNebula, putem construi soluții similare.
De asemenea, am găsit în rețea și mai există , dar aici doar pentru stocarea qcow2.
Dar, așa cum știm cu toții, mai devreme sau mai târziu apare momentul când vrei backup-uri incrementale, aici devine mai complicat și este posibil ca conducerea să aloce fonduri pentru o soluție plătită, sau să mergi pe alt drum, înțelegând că aici exploatăm doar resursele, iar rezervarea se face la nivel de aplicații, adăugând noi noduri și pentru mașini virtuale — da, aici spun că trebuie să folosești cloud-ul pur și simplu pentru a rula clustere de aplicații, iar baza de date să fie rulată pe o altă platformă sau să iei una gata pregătită de la furnizor, dacă există această posibilitate.
4. Ușurința utilizării
În acest punct, voi descrie problemele cu care m-am confruntat eu. De exemplu, în ceea ce privește imaginile, așa cum știm există persistent — când montezi această imagine la VM, toate datele sunt scrise în această imagine. Și dacă este non-persistent, atunci imaginea este copiată pe stocare și datele sunt scrise în ceea ce a fost copiat din imaginea originală — așa funcționează modelele de șablon. De multe ori mi-am creat probleme uitând să specific persistent și imaginea de 200 GB a fost copiată, problema este că, cu siguranță, această procedură nu poate fi anulată, trebuie să mergi la nod și să oprești procesul curent de „cp”.
Unul dintre dezavantajele importante — nu poți anula acțiunile pur și simplu utilizând GUI. Mai exact, le vei anula, vei observa că nimic nu se întâmplă și vei relua, anulezi și, la urma urmei, deja vor fi 2 procese cp care copiază imaginea.
Și aici vine înțelegerea de ce OpenNebula numerotează fiecare nouă instanță cu un nou ID, de exemplu, în Proxmox am creat un VM cu ID 101, am șters-o, apoi o creez din nou și ID-ul rămâne 101. În OpenNebula nu va fi așa, fiecare nouă instanță va fi creată cu un nou ID și există o logică în asta — de exemplu, curățarea datelor vechi sau a instalărilor nereușite.
La fel și pentru stocare, această platformă este cel mai mult concepută pentru stocare centralizată. Există add-on-uri pentru utilizarea stocării locale, dar în acest caz nu este vorba despre asta. Cred că în viitor cineva va scrie un articol despre cum a reușit să folosească stocarea locală pe noduri și să o utilizeze cu succes în producție.
5. Simplitate maximă
Desigur, pe măsură ce înaintezi, devine din ce în ce mai puțin că cei care te vor înțelege.
În condițiile mediului meu — 3 noduri cu stocare NFS — totul funcționează corespunzător. Dar, dacă efectuez experimente de deconectare a energiei, de exemplu, la lansarea unei copii de siguranță și la oprirea alimentării nodului, rămânem cu setările în baza de date, că există o copie de siguranță, dar, de fapt, aceasta nu există (bineînțeles, știm cu toții că inițial s-a înregistrat în baza de date SQL despre această acțiune, dar operațiunea în sine nu a fost realizată cu succes). Avantajul este că, la crearea unei copii de siguranță, se generează un fișier separat și există un „părinte”, astfel că, în caz de probleme, chiar dacă nu funcționează prin GUI, putem prelua fișierul qcow2 și să ne restabilim separat.
Din păcate, rețelele nu sunt chiar atât de simple. Cel puțin sunt mai simple decât în OpenStack, am folosit doar VLAN (802.1Q) — funcționează destul de bine, dar dacă faceți modificări în setările pentru rețeaua din template, aceste setări nu se aplică pe mașinile care funcționează deja, adică trebuie să ștergeți și să adăugați placa de rețea, atunci noile setări vor fi aplicate.
Dacă doriți să comparați cu OpenStack, se poate spune astfel: în OpenNebula nu există o definiție clară a tehnologiilor care trebuie utilizate pentru stocarea datelor, managementul rețelei, resurselor — fiecare administrator decide singur ce este mai convenabil pentru el.
6. Pluginuri și instalări suplimentare
Căci, așa cum înțelegem, platforma cloud poate gestiona nu doar KVM, ci și VMware ESXi. Din păcate, nu am avut un pool cu vCenter, dacă cineva a încercat, scrieți-mi.
În suportul altor furnizori de cloud a fost declarat
AWS, AZURE.
De asemenea, am încercat să implementez VMware Cloud de la Selectel, dar nu a funcționat — în general, m-am dat bătut, deoarece sunt multe factores, iar a scrie la suportul tehnic al furnizorului de hosting nu are sens.
De asemenea, acum, în noua versiune, există Firecracker — acesta este un microVM, un tip de interfață KVM deasupra Docker-ului, care oferă și mai multă versatilitate, securitate și creșterea performanței, deoarece nu trebuie să consumi resurse pentru emularea hardware-ului. Văd doar avantaje în raport cu Docker, în sensul că nu ocupă un număr suplimentar de procese și nu sunt utilizate socketuri suplimentare atunci când se folosește această emulație, deci, practic, poate fi utilizat ca un echilibror de sarcină (dar despre aceasta, probabil, ar trebui să scriu un articol separat, până acum nu am realizat toate testele în totalitate).
7. Experiență pozitivă în utilizare și depanarea erorilor
Vreau să-mi împărtășesc observațiile cu privire la funcționarea acestui sistem, am descris o parte mai sus, dar aș vrea să scriu mai mult. Într-adevăr, probabil nu sunt singurul care la început crede că aceasta nu este sistemul potrivit și că totul este improvizat — cum putem să lucrăm cu așa ceva? Dar apoi vine înțelegerea și realizezi că totul are logică. Desigur, nu poți mulțumi pe toată lumea și unele aspecte necesită îmbunătățiri.
De exemplu, o operațiune simplă de copiere a unei imagini de disc de pe un datastore pe altul. În cazul meu, există 2 noduri cu NFS, trimit imaginea — copierea se face prin frontend OpenNebula, deși toți suntem obișnuiți să credem că datele ar trebui să fie copiate direct între gazde — la fel ca în VMware sau Hyper-V, suntem obișnuiți cu aceasta, însă aici este diferit. Aici abordarea și ideologia sunt diferite, și în versiunea 5.12 au eliminat butonul „migrați la datastore” — se mută doar mașina, nu și stocarea, deoarece se presupune un stocaj centralizat.
Apoi, o eroare comună cu diverse cauze „Eroare la desfășurarea mașinii virtuale: Nu s-a putut crea domeniul din /var/lib/one//datastores/103/10/deployment.5” Mai jos va fi un top al lucrurilor de verificat.
- Drepturile asupra imaginii pentru utilizatorul oneadmin;
- Drepturile pentru utilizatorul oneadmin pentru a rula libvirtd;
- Este corect montat datastore-ul? Du-te și verifică calea pe nod, poate s-a deconectat ceva;
- Rețea configurată greșit, mai bine zis, pe frontend este setat în configurația rețelei că br0 este interfața principală pentru VLAN, însă pe nod este scris — bridge0 — trebuie să fie identice.
Datastore-ul sistemului stochează metadatele pentru VM-ul dvs., dacă lansați VM-ul cu o imagine persistentă, atunci VM-ul trebuie să aibă acces la configurația inițial creată pe acel stocaj pe care l-ați utilizat pentru a crea VM-ul — acest lucru este foarte important. Prin urmare, atunci când transferați VM-ul pe un alt datastore, trebuie să verificați totul.
8. Documentația, comunitatea. Dezvoltări ulterioare
Și în plus, o documentație bună, o comunitate și mai ales ca proiectul să continue să existe în viitor.
În general, aici totul este bine documentat și chiar din sursa oficială nu vor fi probleme în a instala și a găsi răspunsuri la întrebări.
Comunitate activă. Publică multe soluții gata, pe care le puteți folosi în instalațiile dvs.
În acest moment, cu versiunea 5.12 s-au schimbat unele politici în companie Va fi interesant de văzut cum va evolua proiectul. La început, am menționat anumiți furnizori care își folosesc propriile soluții și ce oferă industria. Nu există un răspuns clar la ce ar trebui să folosiți. Însă pentru organizațiile mici, sprijinul pentru propria mică cloud privat poate să nu fie atât de costisitor pe cât pare. Principalul lucru este să știți exact ce aveți nevoie.
În concluzie, indiferent de ce ați ales ca sistem cloud, nu ar trebui să vă opriți la un singur produs. Dacă aveți timp, merită să explorați și alte soluții mai deschise.
Există un chat bun ajută activ și nu te îndeamnă să cauți soluții în Google. Alăturați-vă.
Sursa: habr.com
