

Nota traducătorului.: adaptarea Kubernetes în GitLab este considerată unul dintre cele două factori principali care contribuie la creșterea companiei. Cu toate acestea, până de curând, infrastructura serviciului online GitLab.com a fost construită pe mașini virtuale, iar migrarea sa în K8s a început acum aproximativ un an și nu este încă finalizată. Suntem încântați să prezentăm traducerea unui articol recent al inginerului SRE de la GitLab despre cum decurge acest proces și ce concluzii trag inginerii implicați în proiect.
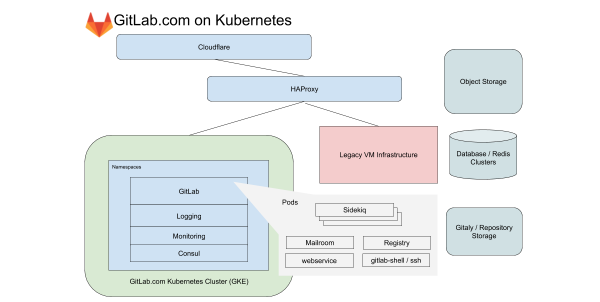
De aproximativ un an, departamentul nostru de infrastructură se ocupă cu migrarea tuturor serviciilor operate pe GitLab.com în Kubernetes. În această perioadă, ne-am confruntat cu probleme legate nu doar de mutarea serviciilor în Kubernetes, ci și de gestionarea unui deployment hibrid în timpul tranziției. Această articol va trata lecțiile valoroase pe care le-am învățat.
Încă de la început, serverele GitLab.com funcționau în cloud pe mașini virtuale. Aceste mașini virtuale sunt gestionate de Chef, iar instalarea lor se efectuează cu ajutorul . în cazul în care este necesară actualizarea aplicației, presupune pur și simplu actualizarea parcului de servere într-un mod coordonat și secvențial prin intermediul CI pipeline-ului. Această metodă — deși lentă și puțin — garantează că GitLab.com aplică aceleași metode de instalare și configurare ca și utilizatorii de (autogestionate) instalații GitLab, care folosesc pentru aceasta pachetele noastre Linux.
Folosim această metodă deoarece este extrem de important să trăim toate bucuriile și tristețile pe care le resimt utilizatorii comunității atunci când instalează și configurează propriile copii GitLab. Această abordare a funcționat bine pentru o vreme, dar când numărul proiectelor pe GitLab a trecut de 10 milioane, ne-am dat seama că nu mai satisface nevoile noastre de scalare și implementare.
Primii pași către Kubernetes și GitLab cloud-native
În 2017, a fost creat proiectul pentru a pregăti GitLab pentru desfășurarea în cloud, precum și pentru a oferi utilizatorilor posibilitatea de a instala GitLab în clustere Kubernetes. Atunci știam că mutarea GitLab în Kubernetes va extinde capacitățile de scalare ale platformei SaaS, va simplifica desfășurările și va îmbunătăți eficiența utilizării resurselor de calcul. În același timp, multe funcții ale aplicației noastre depindeau de părți NFS montate, ceea ce încetinea tranziția de la mașinile virtuale.
Dorința de a deveni cloud native și utilizarea Kubernetes le-a permis inginerilor noștri să planifice o tranziție treptată, în cadrul căreia am renunțat la anumite dependențe ale aplicației de stocarea în rețea, continuând în același timp să dezvoltăm noi funcționalități. De când am început să planificăm migrarea în vara anului 2019, multe dintre aceste restricții au fost eliminate, iar procesul de transfer al GitLab.com pe Kubernetes este acum în plină desfășurare!
Caracteristicile funcționării GitLab.com în Kubernetes
Pentru GitLab.com folosim un singur cluster regional GKE care gestionează tot traficul aplicației. Pentru a minimiza complexitatea (deja destul de complicată) migrației, ne concentrăm pe servicii care nu depind de stocarea locală sau NFS. GitLab.com folosește predominant o bază de cod monolitică pe Rails, iar noi direcționăm traficul în funcție de caracteristicile sarcinii de lucru către diferite endpoint-uri, izolate în propriile grupuri de noduri.
În cazul frontend-ului, aceste tipuri se împart în cereri către web, API, Git SSH/HTTPS și Registry. În cazul backend-ului, împărțim job-urile din cozi în funcție de diferite caracteristici în funcție de , care ne permit să stabilim obiective de nivel de serviciu (Service-Level Objectives, SLOs) pentru diferitele sarcini.
Toate aceste servicii GitLab.com sunt configurate folosind chart-uri Helm nemodificate GitLab. Configurarea se face în sub-chart-uri care pot fi incluse selectiv pe măsură ce ne mutăm gradual serviciile în cluster. Chiar și având în vedere că s-a decis să nu fie incluse în migrație unele dintre serviciile noastre stateful, cum ar fi Redis, Postgres, GitLab Pages și Gitaly, utilizarea Kubernetes permite o reducere radicală a numărului de VM-uri gestionate în prezent de Chef.
Transparență și gestionare a configurației Kubernetes
Toate setările sunt gestionate de GitLab. Trei proiecte de configurare bazate pe Terraform și Helm sunt utilizate pentru acest lucru. Încercăm să folosim GitLab pentru a rula GitLab acolo unde este posibil, dar pentru sarcinile operaționale, avem o instalare separată de GitLab. Aceasta este necesară pentru a nu depinde de disponibilitatea GitLab.com în timpul desfășurării și actualizărilor GitLab.com.
Deși pipeline-urile noastre pentru clusterul Kubernetes funcționează pe o instalare separată de GitLab, există oglinzi pentru repositoarele de cod, disponibile public la următoarele adrese:
- — un binding de configurare GitLab.com pentru chart-ul Helm GitLab;
- — conține configurații pentru servicii care nu sunt direct legate de aplicația GitLab. Acestea includ configurații pentru logare și monitorizarea clusterului, precum și pentru uneltele integrate precum PlantUML;
- — configurația Terraform pentru Kubernetes și infrastructura VM veche (legacy). Aici se configurează toate resursele necesare pentru a rula clusterul, inclusiv clusterul în sine, pool-urile de noduri, conturile de servicii, rezervarea adreselor IP.

Când se fac modificări, se prezintă un cu un link la un diff detaliat, pe care SRE-ul îl analizează înainte de a face modificări în cluster.
Pentru SRE, linkul duce la un diff detaliat în instalarea GitLab utilizată pentru operare și la care accesul este restricționat. Acest lucru permite angajaților și comunității fără acces la proiectul de operare (care este deschis doar pentru SRE) să vizualizeze modificările propuse în configurație. Combinând un exemplu public de GitLab pentru cod cu un exemplu privat pentru pipeline-urile CI, menținem un flux de lucru unificat, asigurând în același timp independența față de GitLab.com în actualizările configurației.
Ce am descoperit în timpul migrației
Pe parcursul mutării, am acumulat experiență pe care o aplicăm în noile migrații și desfășurări în Kubernetes.
1. Creșterea costurilor din cauza traficului între zonele de disponibilitate
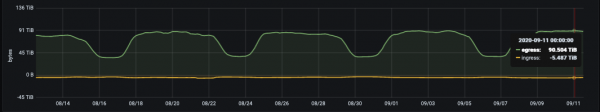
Statistica de egress zilnică (baiți pe zi) pentru parcul de repositoare Git pe GitLab.com
Google își împarte rețeaua în regiuni. Acestea, la rândul lor, se împart în zone de disponibilitate (AZ). Hostingul Git este legat de volume mari de date, așa că este important pentru noi să controlăm egressul rețelei. În cazul traficului intern, egressul este gratuit doar dacă rămâne în cadrul aceleași zone de disponibilitate. La momentul redactării acestui articol, livrăm aproximativ 100 TB de date într-o zi de lucru obișnuită (și aceasta este doar pentru repozitoriile Git). Serviciile care în topologia noastră veche, bazată pe VM, se aflau pe aceleași mașini virtuale, acum funcționează în diferite poduri Kubernetes. Acest lucru înseamnă că o parte din traficul care era anterior local pentru VM poate ieși potențial din limitele zonelor de disponibilitate.
Clusterile regionale GKE permit acoperirea mai multor zone de disponibilitate pentru redundanță. Luăm în considerare pentru serviciile care generează volume mari de trafic. Acest lucru va reduce costurile pentru egress și va menține redundanța la nivel de cluster.
2. Limite, cereri de resurse și scalare
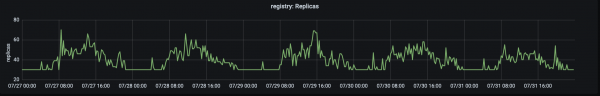
Numărul de replici care gestionează traficul de producție pe registry.gitlab.com. Traficul atinge vârful la aproximativ 15:00 UTC.
Povestea noastră de migrare a început în august 2019, când am mutat primul serviciu — registrul de containere GitLab (GitLab Container Registry) — în Kubernetes. Acest serviciu critic cu trafic ridicat a fost bine ales pentru prima migrare, deoarece reprezintă o aplicație stateless cu puține dependențe externe. Prima problemă cu care ne-am confruntat a fost numărul mare de poduri expulzate din cauza lipsei de memorie pe noduri. Din această cauză, a trebuit să modificăm cererile și limitele.
S-a descoperit că, în cazul unei aplicații al cărei consum de memorie crește în timp, valori scăzute pentru cereri (care rezervă memorie pentru fiecare pod) împreună cu o limită "generoasă" pe utilizare duceau la saturație (saturation) nodurilor și la un nivel ridicat de expulzare. Pentru a face față acestei probleme, s-a . Acest lucru a redus presiunea asupra nodurilor și a asigurat un ciclu de viață al pod-urilor care nu a exercitat o presiune prea mare asupra nodului. Acum începem migrațiile cu valori generoase (și aproape identice) pentru cereri și limite, ajustându-le după necesitate.
3. Metrici și jurnale
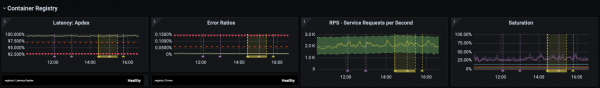
Divizia de infrastructură se concentrează pe întârzieri, procentul de erori și saturația stabilită (SLO), legate de .
În ultimul an, unul dintre evenimentele cheie din cadrul diviziei de infrastructură a fost îmbunătățirea monitorizării și gestionării SLO. SLO-urile ne-au permis să stabilim obiective pentru servicii individuale, pe care le-am monitorizat cu atenție în timpul migrației. Dar chiar și cu o astfel de observabilitate îmbunătățită, nu este întotdeauna posibil să vedem imediat problemele utilizând metrici și alerte. De exemplu, concentrându-ne pe întârzieri și pe procentul de erori, nu acoperim pe deplin toate scenariile de utilizare a serviciului în migrare.
Această problemă a fost identificată aproape imediat după transferul unei părți din sarcinile de lucru în cluster. A devenit deosebit de evidentă atunci când a fost necesară verificarea funcțiilor a căror număr de solicitări este mic, dar care au dependențe de configurare foarte specifice. Una dintre lecțiile cheie învățate în urma migrației a fost necesitatea de a lua în considerare în timpul monitorizării nu doar metricile, ci și jurnalele și „coada lungă” (referindu-se la pe grafic — nota traductoarei) de erori. Acum, pentru fiecare migrație, includem o listă detaliată de solicitări pentru jurnale (log queries) și planificăm proceduri clare de restore, care pot fi transmise de la o echipă la alta în cazul apariției problemelor.
Servirea paralelă a acelorasi solicitări pe vechea infrastructură VM și pe cea nouă, bazată pe Kubernetes, a reprezentat o sarcină unică. Spre deosebire de migrarea de tip lift-and-shift (transfer rapid al aplicațiilor „așa cum sunt” în noua infrastructură; mai multe detalii pot fi citite, de exemplu, — nota trad.), munca paralelă pe VM-urile „vechi” și Kubernetes necesită ca instrumentele de monitorizare să fie compatibile cu ambele medii și să poată combina metricile într-o singură formă. Este important să folosim aceleași dashboard-uri și interogări la loguri pentru a realiza o observabilitate consistentă în timpul perioadei de tranziție.
4. Comutarea traficului pe noul cluster
Pentru GitLab.com, o parte din servere este alocată . Parcul canary deserveste proiectele noastre interne și poate . Dar, în primul rând, este destinat verificării modificărilor aduse infrastructurii și aplicației. Primul serviciu migrat a început prin a accepta un volum limitat de trafic intern, și continuăm să folosim această metodă pentru a ne asigura de respectarea SLO înainte de a direcționa tot traficul către cluster.
În cazul migrării, aceasta înseamnă că mai întâi cererile pentru proiectele interne sunt direcționate către Kubernetes, iar apoi comutăm treptat restul traficului către cluster prin modificarea greutății pentru backend prin HAProxy. În timpul tranziției de la VM la Kubernetes, a devenit clar că este foarte util să avem o modalitate simplă de redirecționare a traficului între infrastructura veche și cea nouă și, în consecință, să ținem infrastructura veche pregătită pentru un rollback în primele zile după migrare.
5. Capacități de rezervă pentru pod-uri și utilizarea acestora
Încă de la început s-a identificat următoarea problemă: pod-urile pentru serviciul Registry porneau rapid, însă pornirea pod-urilor pentru Sidekiq dura până la . Pornirea îndelungată a pod-urilor pentru Sidekiq a devenit o problemă atunci când am început migrarea încărcărilor de lucru în Kubernetes pentru lucrătorii care au nevoie să proceseze rapid job-uri și să se scaleze rapid.
În acest caz, lecția a fost că, deși Horizontal Pod Autoscaler (HPA) în Kubernetes se descurcă bine cu creșterea traficului, este important să se ia în considerare caracteristicile încărcărilor de lucru și să se aloce capacități de rezervă pentru pod-uri (în special în condiții de cerere neregulată). În cazul nostru, s-a observat o explozie bruscă de job-uri, ceea ce a dus la o scalare rapidă, provocând saturarea resurselor CPU înainte de a reuși să scalăm pool-ul de noduri.
Există întotdeauna tentația de a extrage cât mai mult din cluster, totuși, după ce ne-am confruntat inițial cu probleme de performanță, acum începem cu un buget generos pentru pod-uri și îl reducem ulterior, monitorizând cu atenție SLO. Lansarea pod-urilor pentru serviciul Sidekiq s-a accelerat semnificativ și acum durează în medie aproximativ 40 de secunde. au beneficiat atât GitLab.com, cât și utilizatorii noștri de instalări self-managed care folosesc chartul Helm oficial GitLab.
Concluzie
După mutarea fiecărui serviciu, ne-am bucurat de avantajele utilizării Kubernetes în producție: o desfășurare mai rapidă și mai sigură a aplicației, scalabilitate și o distribuție mai eficientă a resurselor. Iar beneficiile migrației depășesc serviciul GitLab.com. Fiecare îmbunătățire a chartului Helm oficial aduce beneficii și utilizatorilor săi.
Sper că v-a plăcut povestea despre aventurile noastre cu migrarea în Kubernetes. Continuăm să mutăm noi servicii în cluster. Informații suplimentare pot fi găsite în publicațiile următoare:
- «»;
- «»;
- .
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
