

Clasificarea datelor bazată pe conținut este o sarcină deschisă. Sistemele tradiționale de prevenire a pierderii datelor (DLP) abordează această problemă prin generarea de amprente pentru datele relevante și monitorizarea punctelor finale pentru extragerea amprentelor. Având în vedere numărul mare de resurse de date în continuă schimbare de pe Facebook, această abordare nu este doar nescalabilă, ci și ineficientă pentru a determina unde se află datele. Această lucrare se concentrează pe un sistem end-to-end construit pentru a detecta tipuri semantice sensibile pe Facebook la scară și pentru a asigura automat stocarea și controlul accesului datelor.
Abordarea descrisă aici reprezintă primul nostru sistem end-to-end de confidențialitate, care încearcă să rezolve această problemă prin integrarea semnalelor de date, învățării automate și metodelor tradiționale de generare de amprente pentru a cartografia și clasifica toate datele de pe Facebook. Sistemul descris este exploatat într-un mediu de producție, atingând un scor mediu F2 de 0,9+ pentru diverse clase de confidențialitate în procesarea unui volum mare de resurse de date în zeci de stocări. Prezentăm traducerea unei publicații Facebook pe ArXiv despre clasificarea datelor scalabile pentru asigurarea securității și confidențialității bazate pe învățare automată.
Introducere
Azi, organizațiile colectează și stochează volume mari de date în diverse formate și locuri [1]. Datele sunt apoi consumate în multe locuri, fiind adesea copiate sau stocate în cache de mai multe ori, ceea ce duce la dispersarea informațiilor de afaceri valoroase și confidențiale în mai multe depozite de date corporative. Atunci când de la organizație se cere să îndeplinească anumite cerințe legale sau normative, de exemplu, să respecte reglementările în timpul proceselor civile, apare necesitatea identificării locației datelor necesare. Când o hotărâre de confidențialitate impune organizației să mascheze toate numerele de siguranță socială (SSN) în timpul transferului de informații personale către terți neautorizați, primul pas natural este să se caute toate SSN-urile din depozitele de date ale organizației. În astfel de circumstanțe, clasificarea datelor devine crucială [1]. Un sistem de clasificare va permite organizațiilor să asigure respectarea automată a confidențialității și a politicii de securitate, cum ar fi implementarea politicii de gestionare a accesului și a păstrării datelor. Facebook prezintă un sistem construit de noi la Facebook, care utilizează multiple semnale de date, o arhitectură de sistem scalabilă și învățare automată pentru a descoperi tipuri de date sensibile semantice.
Detectarea și clasificarea datelor constau în căutarea și etichetarea lor astfel încât, la nevoie, informațiile relevante să poată fi extrase rapid și eficient. Procesul actual este mai degrabă manual și implică studierea legislației sau reglementărilor relevante, determinând ce tipuri de informații ar trebui considerate sensibile și care sunt diferitele niveluri de sensibilitate, apoi stabilind corect clasele și politica de clasificare [1]. După ce sistemele de prevenire a pierderii datelor (DLP) creează amprente ale datelor și urmăresc punctele finale în amvers pentru obținerea amprentelor, în cazul unui depozit cu un număr mare de active și petabyte de date, o astfel de abordare pur și simplu nu se scalează.
Scopul nostru este de a construi un sistem de clasificare a datelor, care să fie scalabil atât pentru datele utilizatorilor persistente, cât și pentru cele nepermanente, fără nicio restricție suplimentară asupra tipului sau formatului datelor. Este un obiectiv îndrăzneț, și, în mod natural, vine cu dificultăți. Orice înregistrare de date poate avea mii de caractere.
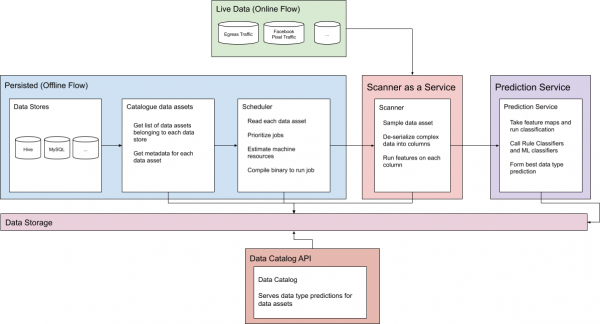
Figura 1. Fluxurile de prognoză online și offline
Prin urmare, trebuie să o reprezentăm eficient, folosind un set comun de caracteristici, care pot fi ulterior combinate și mutate cu ușurință. Aceste caracteristici trebuie să asigure nu doar o clasificare precisă, ci și flexibilitate și scalabilitate pentru a permite adăugarea și descoperirea ușoară a unor noi tipuri de date în viitor. În al doilea rând, trebuie să gestionăm tabelele autonomi mari. Datele persistente pot fi stocate în tabele care ajung la multe petabytes. Acest lucru poate duce la o reducere a vitezei de scanare. În al treilea rând, trebuie să respectăm clasificarea strictă SLA pentru datele nepermanente. Aceasta obligă sistemul să fie foarte eficient, rapid și precis. În final, trebuie să asigurăm o clasificare a datelor cu întârziere mică pentru datele nepermanente, pentru a efectua clasificarea în timp real, precum și pentru cazuri de utilizare online.
Acest articol descrie cum am abordat problemele de mai sus și prezintă un sistem de clasificare rapid și scalabil, care clasifică elementele de date de toate tipurile, formatele și sursele, pe baza unui set comun de caracteristici. Am extins arhitectura sistemului și am creat un model special de învățare automată pentru clasificarea rapidă a datelor offline și online. Articolul este structurat astfel: în secțiunea 2 se prezintă designul general al sistemului. În secțiunea 3 se discută părțile sistemului de învățare automată. Secțiunile 4 și 5 se referă la lucrări conexe și conturează direcțiile viitoare de lucru.
Arhitectură
Pentru a face față provocărilor datelor persistente și celor online la scară Facebook, sistemul de clasificare are două fluxuri separate, pe care le vom discuta în detaliu.
Date persistente
Inițial, sistemul trebuie să identifice o serie de active informaționale Facebook. Pentru fiecare depozit, se adună informații de bază, cum ar fi centrul de date care conține aceste date, sistemul cu aceste date și activele situate într-un anumit depozit de date. Aceasta formează un catalog de metadate, care permite sistemului să extragă eficient datele fără a suprasolicita clienții și resursele utilizate de alți ingineri.
Acest catalog de metadate oferă o sursă de încredere pentru toate activele scanate și permite monitorizarea stării diverselor active. Cu ajutorul acestei informații, se stabilește prioritatea planificării bazate pe datele colectate și informațiile interne din sistem, cum ar fi timpul ultimei scanări reușite a activului și timpul de creare a acestuia, precum și cerințele anterioare de memorie și procesor pentru acest activ, în cazul în care a fost scanat anterior. Apoi, pentru fiecare resursă de date (pe măsură ce resursele devin disponibile) se invocă o sarcină de scanare efectivă a resursei.
Fiecare sarcină este un fișier binar compilat, care execută o selecție Bernoulli pe ultimele date disponibile pentru fiecare activ. Activul este împărțit în coloane separate, unde rezultatul clasificării fiecărei coloane este procesat independent. În plus, sistemul scanează orice date saturate în interiorul coloanelor. JSON, array-uri, structuri codificate, URL-uri, date serializate base 64 și multe altele sunt toate scanate. Acest lucru poate crește semnificativ timpul de executare a scanării, deoarece o tabelă poate conține mii de coloane înglobate într-un obiect binar mare. json.
Pentru fiecare rând selectat în activul de date, sistemul de clasificare extrage obiecte flotați și text din conținut și le corelează înapoi cu coloana din care au fost luate. Rezultatul etapei de extragere a obiectelor este o hartă a tuturor obiectelor pentru fiecare coloană găsită în activul de date.
Pentru ce sunt necesare caracteristicile?
Conceptul de caracteristici este un punct esențial. În loc de caracteristicile float și text, putem transmite mostre brute de șiruri, care sunt extrase direct din fiecare resursă de date. În plus, modelele de învățare automată pot fi instruite direct pe fiecare mostră, și nu pe sute de calcule de caracteristici care doar încearcă să aproximeze mostra. Există câteva motive pentru aceasta:
- Confidențialitatea este pe primul loc: cel mai important, conceptul de caracteristici ne permite să păstrăm în memorie doar acele mostre pe care le extragem. Acest lucru garantează că păstrăm mostrele pentru un singur scop și că nu le logăm prin propriile eforturi. Acest lucru este deosebit de important pentru datele volatile, deoarece serviciul trebuie să mențină o anumită stare de clasificare înainte de a oferi prognoza.
- Memoria: unele mostre pot avea o lungime de mii de caractere. Păstrarea acestor date și transmiterea lor parțial în sistem consumă multe byte suplimentare, fără necesitate. Două factori pot interacționa în timp, având în vedere că există multe resurse de date cu mii de coloane.
- Agregarea caracteristicilor: prin utilizarea caracteristicilor, rezultatele fiecărei scanări sunt prezentate în mod clar, permițând sistemului să combine rezultatele scanărilor anterioare ale aceleași resurse de date într-un mod convenabil. Acest lucru poate fi util pentru agregarea rezultatelor scanării unei resurse de date în mai multe runde.
Apoi, caracteristicile sunt trimise către serviciul de prognoză, unde utilizăm clasificarea bazată pe reguli și învățarea automată pentru a prognoza etichetele de date pentru fiecare coloană. Serviciul se bazează atât pe clasificatorii de reguli, cât și pe învățarea automată și selectează cea mai bună prognoză dată de fiecare obiect de prognoză.
Clasificatorii de reguli sunt o heuristică manuală, folosind calcule și coeficienti pentru a normaliza obiectul într-un interval de la 0 la 100. Odată ce o astfel de scor inițial este generat pentru fiecare tip de date și numele coloanei asociate acestor date, care nu se încadrează în „listele negre”, clasificatorul de reguli selectează cel mai mare scor normalizat dintre toate tipurile de date.
Datorită complexității clasificării, utilizarea exclusivă a heuristicii manuale duce la o precizie scăzută a clasificării, în special pentru datele nestructurate. Din acest motiv, am dezvoltat un sistem de învățare automată pentru a lucra cu clasificarea datelor nestructurate, cum ar fi conținutul utilizatorilor și adresele. Învățarea automată a permis să ne îndepărtăm de heuristica manuală și să aplicăm semnale suplimentare de date (de exemplu, numele coloanelor, originea datelor), crescând semnificativ precizia detectării. Ne vom aprofunda în arhitectura noastră de învățare automată mai târziu.
Serviciul de prognoză stochează rezultatele pentru fiecare coloană împreună cu metadatele legate de timpul și starea scanării. Orice consumatori și procese inferioare care depind de aceste date pot să le citească din setul de date publicat zilnic. Acest set agregă rezultatele tuturor acestor sarcini de scanare sau API-ul în timp real al catalogului de date. Prognozele publicate sunt fundamentul aplicării automate a politicii de confidențialitate și securitate.
În cele din urmă, după ce serviciul de prognoză înregistrează toate datele și toate prognozele sunt salvate, API-ul nostru al catalogului de date poate returna toate prognozele tipurilor de date pentru resursa respectivă în timp real. În fiecare zi, sistemul publică un set de date care conține toate prognozele recente pentru fiecare activ.
Date instabile
Deși procesul descris mai sus este creat pentru activele salvate, traficul nesalvat este, de asemenea, considerat parte din datele organizației și poate fi important. Din acest motiv, sistemul oferă API online pentru generarea în timp real a prognozelor de clasificare pentru orice trafic instabil. Sistemul de prognoză în timp real este utilizat pe scară largă în clasificarea traficului ieșitor, a traficului entrant în modelele de învățare automată și a datelor agenților publicitari.
Aici, API-ul primește două argumente principale: cheia de grupare și datele brute care trebuie prognozate. Serviciul efectuează aceeași extragere a obiectelor, așa cum este descris mai sus, și grupează obiectele împreună pentru aceeași cheie. Aceste caracteristici sunt, de asemenea, păstrate în cache-ul salvat pentru recuperare în caz de defectare. Fiecărui cheie de grupare, serviciul garantează că, înainte de a apela serviciul de prognoză, a văzut suficiente mostre conform procesului descris mai sus.
Optimizare
Pentru a scana unele stocări, folosim biblioteci și metode de optimizare a citirii din stocarea la cald [2] și garantăm că nu există întreruperi din partea altor utilizatori care accesează aceeași stocare.
Pentru tabele extrem de mari (50+ petabytes), în ciuda tuturor optimizărilor și eficienței memoriei, sistemul lucrează la scanarea și calcularea totului înainte de a epuiza memoria. În cele din urmă, scanarea este complet calculată în memorie și nu este salvată pe parcursul scanării. Dacă tabelele mari conțin mii de coloane cu aglomerări de date nestructurate, sarcina poate eșua din cauza lipsei de resurse de memorie în timpul prognozelor pentru întreaga tabelă. Acest lucru va duce la o acoperire redusă. Pentru a combate acest lucru, am optimizat sistemul pentru a folosi viteza de scanare ca mediator în cât de bine se descurcă sistemul cu sarcina actuală. Folosim viteza ca mecanism de prognoză pentru a observa problemele cu memoria și în calculul preventiv al hărții obiectelor. Astfel, folosim mai puțini date decât de obicei.
Semnalele de date
Sistemul de clasificare este bun atât cât de bune sunt semnalele de date. Aici vom analiza toate semnalele folosite de sistemul de clasificare.
- Pe baza conținutului: desigur, primul și cel mai important semnal este conținutul. Se efectuează o selecție Bernoulli pentru fiecare activ de date pe care îl scanăm și extragem caracteristici pe baza conținutului. Multe caracteristici derivate din conținut sunt posibile. Poate exista un număr variabil de obiecte plutitoare care reprezintă calcule despre câte ori a fost observat un anumit tip de model. De exemplu, putem avea indicații referitoare la numărul de e-mailuri văzute în eșantion sau caracteristici referitoare la câte emoji-uri au fost observate în eșantion. Aceste calcule ale caracteristicilor pot fi normalizate și aggregate pe diferite scanări.
- Originea datelor: un semnal important care poate ajuta atunci când conținutul s-a schimbat din tabela părinte. Un exemplu comun sunt datele hash-uite. Când datele din tabela copil sunt hash-uite, ele provin adesea din tabela părinte, unde rămân în formă deschisă. Datele despre origine ajută la clasificarea anumitor tipuri de date atunci când acestea nu sunt citite clar sau sunt transformate din tabela de sus.
- Anotările: un alt semnal de înaltă calitate care ajută la identificarea datelor nestructurate. De fapt, anotările și datele de origine pot lucra împreună pentru a distribui atribute între diferite active de date. Anotările ajută la identificarea sursei datelor nestructurate, în timp ce datele despre origine pot ajuta la urmărirea fluxului acestor date prin întreaga depozitare.
- Injecția de date este o metodă prin care se introduc intenționat caractere speciale, ilizibile, în surse cunoscute cu tipuri de date cunoscute. Apoi, de fiecare dată când scanăm conținutul cu aceeași secvență ilizibilă de caractere, putem deduce că conținutul provine din acest tip cunoscut de date. Acesta este un alt semnal de calitate al datelor, similar cu anotările. Cu excepția faptului că detectarea pe baza conținutului ajută la identificarea datelor introduse.
Măsurarea metricilor
Un component important este metodologia riguroasă de măsurare a metricilor. Principalele metrici ale iterației de îmbunătățire a clasificării sunt precizia și rechemarea fiecărei etichete, evaluarea F2 fiind crucială.
Pentru a calcula acești indicatori, este necesară o metodologie independentă de etichetare a activelor de date, care nu depinde de sistemul propriu-zis, dar poate fi folosită pentru comparații directe cu acesta. Mai jos vom descrie cum colectăm adevărul fundamentat din Facebook și cum îl utilizăm pentru a antrena sistemul nostru de clasificare.
Colectarea de date de încredere
Noi acumulăm date de încredere din fiecare sursă listată mai jos, în propria sa tabelă. Fiecare tabel este responsabil pentru agregarea celor mai recente valori observabile din acea sursă specifică. Fiecare sursă are un control al calității datelor, pentru a garanta că valorile observate pentru fiecare sursă sunt de înaltă calitate și conțin cele mai recente etichete ale tipurilor de date.
- Configurările platformei de logare: anumite câmpuri din tabelele distribuite sunt completate cu date care se referă la un tip specific. Utilizarea și răspândirea acestor date servește ca o sursă fiabilă de date verificate.
- Etichetarea manuală: dezvoltatorii care susțin sistemul, precum și etichetatorii externi, sunt instruiți să eticheteze coloanele. Aceasta funcționează de obicei bine pentru toate tipurile de date din depozit și poate fi sursa principală de încredere pentru unele date nestructurate, cum ar fi datele de mesaje sau conținutul utilizatorilor.
- Coloanele din tabelele parentale pot fi etichetate sau annotate ca având date specifice, iar noi putem urmări aceste date în tabelele subordonate.
- Selectarea fluxurilor de execuție: fluxurile de execuție din Facebook transportă date de un anumit tip. Folosind scanerul nostru ca arhitectură de serviciu, putem selecta fluxuri având tipuri de date cunoscute și să le trimitem prin sistem. Sistemul promite să nu stocheze aceste date.
- Tabele de selecție: tabele mari distribuite, care sunt cunoscute că conțin întreaga cantitate de date, pot fi folosite și ca date de antrenare și transmise prin scaner ca serviciu. Acest lucru este excelent pentru tabele cu un interval complet de tipuri de date, așa că selecția unei coloane aleatorii este echivalentă cu selecția întregului set de acest tip de date.
- Date sintetice: putem chiar să folosim biblioteci care generează date pe loc. Acest lucru funcționează bine pentru tipuri simple de date publice, cum ar fi adresa sau GPS.
- Stewardii datelor: programele de confidențialitate folosesc, de obicei, stewardi ai datelor pentru a lega manual politicile de părți ale datelor. Acest lucru servește ca o sursă foarte precisă de credibilitate.
Combinăm fiecare sursă principală de date credibile într-un corp cu toate aceste date. Cea mai mare problemă cu credibilitatea este asigurarea că aceasta este reprezentativă pentru depozitul de date. Altfel, motoarele de clasificare se pot supraantrena. În combaterea acestui lucru, toate sursele menționate anterior sunt utilizate pentru a asigura un echilibru în timpul antrenării modelului sau calculării metricilor. În plus, etichetații umani selectează uniform diferitele coloane din depozit și etichetează datele în mod corespunzător, astfel încât colectarea valorilor credibile să rămână imparțială.
Integrare continuă
Pentru a asigura o iterație rapidă și îmbunătățire, este important să măsurăm întotdeauna performanța sistemului în timp real. Putem măsura fiecare îmbunătățire a clasificării în comparație cu sistemul de astăzi, astfel încât să ne putem orienta tactic pe date în îmbunătățirile viitoare. Aici vom analiza modul în care sistemul finalizează ciclul de feedback, care este asigurat de datele credibile.
Când sistemul de planificare se confruntă cu un activ care are o etichetă dintr-o sursă credibilă, planificăm două sarcini. Prima folosește scannerul nostru de producție și, astfel, capacitățile noastre de producție. A doua sarcină folosește scannerul ultimei versiuni cu cele mai recente caracteristici. Fiecare sarcină scrie ieșirea sa într-un tabel propriu, marcând versiunile împreună cu rezultatele clasificării.
Astfel comparăm rezultatele clasificării pentru versiunea candidat de lansare și modelul de producție în timp real.
În timp ce seturile de date compară caracteristicile RC și PROD, se înregistrează numeroase variații ale motorului de clasificare ML al serviciului de prognoză. Cel mai recent model de învățare automată construit, modelul curent în producție și orice modele experimentale. Aceeași abordare ne permite să "tăiem" diferitele versiuni ale modelului (agnostic la clasificatorii noștri de reguli) și să comparăm metricile în timp real. Astfel este ușor de determinat când un experiment cu ML este pregătit pentru implementare în producție.
În fiecare noapte, caracteristicile RC calculate pentru ziua respectivă sunt trimise în pipeline-ul de învățare ML, unde modelul este antrenat pe ultimele caracteristici RC și își evaluează performanța în comparație cu un set de date de referință.
În fiecare dimineață, modelul finalizează antrenamentul și este publicat automat ca experimental. Acesta este inclus automat în lista celor experimentale.
Câteva rezultate
Sunt etichetate peste 100 de tipuri diferite de date cu o mare precizie. Tipurile bine structurare, cum ar fi adresele de email și numerele de telefon, sunt clasificate cu o notă F2 de peste 0,95. Tipurile libere de date, cum ar fi conținutul utilizatorului și numele, funcționează de asemenea foarte bine, cu punctaje F2 de peste 0,85.
Zilnic, se clasifică un număr mare de coloane individuale de date stabile și instabile în toate depozitele. Peste 500 de terabytes sunt scanate zilnic în mai mult de 10 depozite de date. Acoperirea majorității acestor depozite este de peste 98%.
De-a lungul timpului, clasificarea a devenit foarte eficientă, deoarece sarcinile de clasificare în fluxul autonom salvat durează în medie 35 de secunde de la scanarea activului până la calcularea prognozelor pentru fiecare coloană.
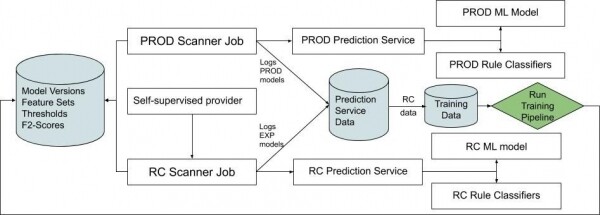
Fig. 2. Diagramă care descrie fluxul continuu de integrare, pentru a înțelege cum sunt generate și trimise obiectele RC la model.
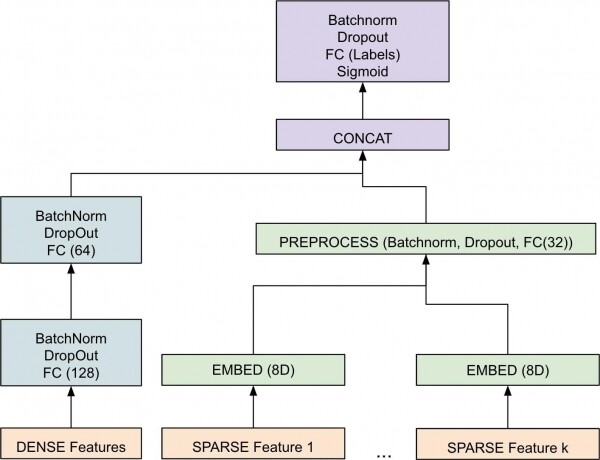
Fig. 3. Diagramă de nivel înalt a componentului de învățare automată.
Componenta sistemului de învățare automată
În secțiunea anterioară, am analizat în profunzime arhitectura întregului sistem, evidențiind scalabilitatea, optimizarea și fluxurile de date în mod autonom și online. În această secțiune, ne vom concentra asupra serviciului de prognoză și vom descrie sistemul de învățare automată care asigură funcționarea serviciului de prognoză.
Cu peste 100 de tipuri de date și unele conținuturi nestructurate, cum ar fi datele mesajelor și conținutul utilizatorilor, utilizarea exclusivă a euristicii manuale duce la o precizie subparametrică în clasificare, în special pentru datele nestructurate. Din acest motiv, am dezvoltat un sistem de învățare automată pentru a aborda complexitățile datelor nestructurate. Utilizarea învățării automate ne permite să ne îndepărtăm de euristica manuală și să lucrăm cu caracteristici și semnale suplimentare ale datelor (de exemplu, numele coloanelor, proveniența datelor) pentru a îmbunătăți acuratețea.
Modelul implementat studiază reprezentările vectoriale [3] ale obiectelor dense și rare separat. Apoi acestea sunt combinate pentru a forma un vector care trece printr-o serie de etape de normalizare a lotului [4] și nonlinearitate pentru a obține rezultatul final. Rezultatul final este un număr cu punct zecimal între [0-1] pentru fiecare etichetă, indicând probabilitatea ca un exemplu să aparțină unui anumit tip de sensibilitate. Utilizarea PyTorch pentru model ne-a permis să avansăm mai repede, oferind dezvoltatorilor din afara echipei posibilitatea de a face și testa rapid modificări.
În proiectarea arhitecturii, a fost important să modelăm obiectele rare (de exemplu, textuale) și dense (de exemplu, numerice) separat din cauza diferențelor interne. De asemenea, pentru arhitectura finală, a fost important să efectuăm o desfășurare a parametrilor pentru a găsi valoarea optimă a ratei de învățare, dimensiunii lotului și altor hiperparametri. Alegerea optimizerului a fost, de asemenea, un hiperparametru important. Am descoperit că optimizerul popular Adamduce adesea la suprasolicitare, în timp ce modelul cu SGD mai stabil. Au existat aspecte suplimentare pe care trebuia să le includem direct în model. De exemplu, reguli statice care garantau că modelul face o previziune deterministă atunci când caracteristica are o valoare specifică. Aceste reguli statice sunt definite de clienții noștri. Am descoperit că includerea lor direct în model a dus la crearea unei arhitecturi mai autonome și fiabile, spre deosebire de implementarea unei etape de post-procesare pentru a gestiona aceste cazuri speciale. De asemenea, rețineți că în timpul antrenamentului aceste reguli sunt dezactivate pentru a nu interfera cu procesul de antrenare a descensului gradient.
Probleme
Una dintre probleme a fost colectarea de date fiabile de înaltă calitate. Modelul are nevoie de validitate pentru fiecare clasă pentru a putea învăța asociațiile dintre obiecte și etichete. În secțiunea anterioară, am discutat despre metodele de colectare a datelor atât pentru măsurarea sistemului, cât și pentru antrenarea modelelor. Analiza a arătat că clase de date cum ar fi numerele de carduri de credit și conturi bancare nu sunt foarte frecvente în depozitul nostru. Acest lucru face dificilă colectarea unor volume mari de date fiabile pentru antrenarea modelelor. Pentru a rezolva această problemă, am dezvoltat procese pentru generarea de date sintetice fiabile pentru aceste clase. Generăm astfel de date pentru tipuri sensibile, inclusiv SSN, numere de carduri de credit și IBAN-numere pentru care modelul nu a putut prezice anterior. Această abordare permite gestionarea tipurilor de date confidențiale fără riscul de confidențialitate asociat cu ascunderea datelor reale confidențiale.
Pe lângă problemele legate de datele fiabile, există probleme arhitecturale deschise la care lucrăm, cum ar fi izolarea modificărilor și oprirea timpurie. Izolarea modificărilor este importantă pentru ca, atunci când se fac diverse modificări în diferite părți ale rețelei, efectul să fie izolat de clasele specifice și să nu aibă un impact amplu asupra performanței generale de predicție. Îmbunătățirea criteriilor de oprire timpurie este, de asemenea, crucială pentru a putea opri procesul de antrenare într-un punct stabil pentru toate clasele, și nu într-un punct în care unii clasa să fie suprantrenați, iar altele nu.
Importanța caracteristicii
Atunci când se introduce o nouă caracteristică în model, dorim să știm impactul său global asupra modelului. De asemenea, vrem să ne asigurăm că prognozele sunt interpretabile de către oameni, astfel încât să putem înțelege exact ce caracteristici sunt utilizate pentru fiecare tip de date. Pentru aceasta, am dezvoltat și introdus pe clase importanța caracteristicilor pentru modelul PyTorch. Rețineți că acest lucru diferă de importanța generală a caracteristicii, care de obicei este susținută, deoarece nu ne spune ce caracteristici sunt importante pentru o clasă anume. Măsurăm importanța unui obiect, calculând creșterea erorii prognozei după permutarea obiectului. O caracteristică este „importantă” atunci când permutarea valorilor crește eroarea modelului, deoarece în acest caz modelul se baza pe caracteristică în prognozare. O caracteristică este „neimportantă” atunci când permutarea valorilor sale lasă eroarea modelului neschimbată, deoarece în acest caz modelul a ignorat-o [5].
Importanța caracteristicii pentru fiecare clasă face ca modelul să fie interpretabile, astfel încât să putem vedea pe ce se concentrează modelul în prognozarea etichetei. De exemplu, când analizăm ADDR, ne asigurăm că caracteristica asociată cu adresa, cum ar fi AddressLinesCount, ocupă un loc de frunte în tabelul importanței caracteristicilor pentru fiecare clasă, astfel încât intuiția noastră umană să se alinieze bine cu ceea ce a învățat modelul.
Evaluare
Este important să definim o metrică unică de succes. Am ales F2 — un echilibru între recall și precizie (cu un bias mic spre recall). Recall-ul este mai important pentru cazul de utilizare al confidențialității decât precizia, deoarece pentru echipă este extrem de important să nu rateze datele confidențiale (asigurând totodată o precizie rezonabilă). Datele reale de evaluare a performanței F2 ale modelului nostru ies în afara subiectului acestui articol. Cu toate acestea, cu o ajustare atentă, putem atinge un scor ridicat (0,9+) F2 pentru cele mai importante clase sensibile.
Lucrarea asociată
Există multe algoritme de clasificare automată a documentelor nestructurate, folosind diverse metode, cum ar fi potrivirea modelelor, căutarea similitudinii documentelor și diverse metode de învățare automată (bayesiene, arbori de decizie, k-vecini cei mai apropiați și multe altele) [6]. Oricare dintre acestea poate fi utilizat ca parte a clasificării. Totuși, problema constă în scalabilitate. Abordarea de clasificare din această lucrare se îndreaptă spre flexibilitate și performanță. Acest lucru ne permite să susținem noi clase în viitor și să menținem o latență scăzută.
Există, de asemenea, o mulțime de lucrări privind extragerea de amprente din date. De exemplu, autorii din [7] au descris o soluție care se concentrează pe problema captării scurgerilor de date confidentiale. Presupunerea de bază este că amprenta de la date poate fi asociată cu un set de date confidențiale cunoscute. Autorii din [8] descriu o problemă similară de scurgere a confidențialității, dar soluția lor se bazează pe o arhitectură specifică Android și este clasificată doar în cazul în care acțiunile utilizatorului au dus la transmiterea informațiilor personale sau dacă în aplicația de bază există o scurgere a datelor utilizatorilor. Situația aici este ceva diferită, deoarece datele utilizatorilor pot fi de asemenea foarte nestructurate. Prin urmare, avem nevoie de o tehnică mai complexă decât extragerea amprentelor.
În cele din urmă, pentru a face față insuficienței datelor pentru anumite tipuri de date confidențiale, am introdus date sintetice. Există o cantitate mare de literatură despre augmentarea datelor; de exemplu, autorii din [9] au cercetat rolul injectării zgomotului în timpul instruirii și au observat rezultate pozitive în învățarea controlată. Abordarea noastră față de confidențialitate este diferită deoarece introducerea de date zgomotoase poate fi contraproductivă, iar în schimb ne concentrăm pe date sintetice de înaltă calitate.
Concluzie
În acest articol, am prezentat un sistem care poate clasifica fragmente de date. Acest lucru ne permite să creăm sisteme de asigurare a conformității cu politicile de confidențialitate și securitate. Am arătat că o infrastructură scalabilă, integrarea continuă, învățarea automată și datele de calitate privind veridicitatea informațiilor joacă un rol crucial în succesul multor inițiative ale noastre în domeniul confidențialității.
Există multe direcții pentru munca viitoare. Aceasta poate include asigurarea suportului pentru date nestructurate (fișiere), clasificarea nu doar a tipului de date, ci și a nivelului de sensibilitate, precum și utilizarea învățării auto-supervizate direct în timpul instruirii prin generarea de exemple sintetice precise. Acestea, la rândul lor, vor ajuta modelul să reducă pierderile la maxim. Munca viitoare poate, de asemenea, să se concentreze pe fluxul de lucru al investigației, unde depășim pur și simplu detectarea și oferim o analiză a cauzelor fundamentale ale diferitelor încălcări ale confidențialității. Acest lucru va ajuta în cazuri precum analiza sensibilității (adică, dacă sensibilitatea confidențialității tipului de date este ridicată (de exemplu, IP-ul utilizatorului) sau scăzută (de exemplu, IP-ul intern al Facebook)).
Bibliografie
- David Ben-David, Tamar Domany și Abigail Tarem. Clasificarea datelor în întreprindere folosind tehnologii de web semantic. În Peter F. Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks, și Birte Glimm, editori, Webul Semantic – ISWC 2010, paginile 66–81, Berlin, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang, și Sanjeev Kumar. f4: Sistemul de stocare BLOB cald al Facebook. În 11-a Simpozion USENIX privind proiectarea și implementarea sistemelor de operare (OSDI 14), paginile 383–398, Broomfield, CO, octombrie 2014. USENIX Association.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S. Corrado și Jeff Dean. Reprezentări distribuite ale cuvintelor și frazelor și compoziția lor. În C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani, și K. Q. Weinberger, editori, Avansuri în procesele de informații neuronale 26, paginile 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe și Christian Szegedy. Normalizarea lotului: Accelerarea instruirii rețelelor profunde prin reducerea schimbării interne a covariatelor. În Francis Bach și David Blei, editori, Actele celei de-a 32-a Conferințe Internaționale asupra Învățării Automate, volumul 37 din Actele cercetării asupra învățării automate, paginile 448–456, Lille, Franța, 07–09 Iul 2015. PMLR.
- Leo Breiman. Păduri aleatoare. Mach. Înv., 45(1):5–32, octombrie 2001.
- Thair Nu Phyu. Sondaj al tehnicilor de clasificare în mineritul de date.
- X. Shu, D. Yao și E. Bertino. Detectarea păstrării confidențialității expunerii datelor sensibile. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning și Xiaoyang Wang. Appintent: Analiza transmiterii datelor sensibile în Android pentru detectarea scurgerilor de confidențialitate. paginile 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong și Quoc V. Le. Augmentare de date nesupravegheată.
Află detalii despre cum poți obține o profesie căutată de la zero sau să avansezi în carieră pe baza abilităților și salariului, urmând cursurile online SkillFactory:
- (12 luni)
- (12 săptămâni)
- (20 de săptămâni)
- (20 de săptămâni)
Alte cursuri
- (9 luni)
- (8 luni)
- (9 luni)
- (12 luni)
- (18 luni)
- (12 luni)
- (9 luni)
- (7 luni)
Sursa: habr.com
