

Mulți cred că este suficient să transferi aplicația pe Kubernetes (fie prin Helm, fie manual) — și vei fi fericit. Dar nu este atât de simplu.
Comanda Am tradus articolul inginerului DevOps Julian Gindi. El povestește despre capcanele cu care s-a confruntat compania sa în procesul de migrare, astfel încât să nu pățești aceleași greșeli.
Pasul unu: configurarea cerințelor podului și a limitelor
Să începem cu configurarea unui mediu curat în care să funcționeze podurile noastre. Kubernetes gestionează excelent planificarea podurilor și tratarea stărilor de eșec. Dar s-a dovedit că planificatorul uneori nu poate plasa un pod dacă îi este dificil să evalueze câte resurse sunt necesare pentru o funcționare de succes. Aici intervin cerințele de resurse și limitele. Există multe dezbateri despre cea mai bună abordare în configurarea cerințelor și limitelor. Uneori pare că este mai degrabă o artă decât o știință. Iată abordarea noastră.
Cerințele podului (pod requests) — sunt valoarea principală utilizată de planificator pentru plasarea optimă a podului.
Din : în etapa de filtrare, se determină setul de noduri unde poate fi programat podul. De exemplu, filtrul PodFitsResources verifică dacă există suficiente resurse pe nod pentru a satisface cerințele specifice ale podului.
Folosim cerințele aplicațiilor astfel încât să putem evalua câte resurse de fapt sunt necesare aplicației pentru a funcționa normal. Astfel, planificatorul va putea plasa realist nodurile. Inițial, am dorit să stabilim cerințele cu un anumit surplus pentru a garanta suficiente resurse pentru fiecare pod, dar am observat că timpul de planificare s-a crescut semnificativ, iar unele poduri nu au fost complet programate, de parcă nu au primit niciodată cerințe de resurse.
În această situație, planificatorul adesea "împinge" podurile și nu le poate programa din nou deoarece planul de control nu avea idee câte resurse va necesita aplicația, iar acesta este un component esențial al algoritmului de planificare.
Limitele podului (pod limits) — sunt o limitare mai clară pentru pod. Aceasta reprezintă volumul maxim de resurse pe care clusterul îl va aloca containerului.
Din nou, din : dacă pentru un container este stabilit un limită de memorie de 4 GiB, atunci kubelet (și mediul de execuție al containerului) îl va aplica forțat. Mediul de execuție nu permite containerului să utilizeze mai mult decât limita de resurse specificată. De exemplu, atunci când un proces din container încearcă să utilizeze mai multă memorie permisă, nucleul sistemului finalizează acest proces cu o eroare «out of memory» (OOM).
Containerul poate folosi întotdeauna mai multe resurse decât cele specificate în cererea de resurse, dar nu poate folosi niciodată mai mult decât ceea ce este definit în limită. Este dificil să setați corect această valoare, dar este foarte important.
Ideal, vrem ca cerințele de resurse ale podului să se schimbe pe parcursul ciclului de viață al procesului, fără a interveni asupra altor procese din sistem — aceasta este scopul stabilirii limitelor.
Din păcate, nu pot oferi indicații specifice despre valorile care trebuie stabilite, dar noi ne respectăm următoarele reguli:
- Folosind un instrument de testare a încărcării, modelăm un nivel de trafic de bază și observăm utilizarea resurselor podului (memorie și procesor).
- Stabilim cererile podului la o valoare aleatorie redusă (cu o limită de resurse de aproximativ 5 ori mai mare decât valoarea cererilor) și observăm. Atunci când cererile sunt prea scăzute, procesul nu se poate porni, ceea ce generează adesea erori misterioase de runtime Go.
Vreau să menționez că limitele de resurse mai mari complică planificarea, deoarece podul are nevoie de un nod țintă cu suficiente resurse disponibile.
Imaginați-vă o situație în care aveți un server web ușor cu o limită de resurse foarte înaltă, de exemplu 4 GB de memorie. Probabil că acest proces va trebui să fie scalat pe orizontală, iar fiecare nou modul va trebui planificat pe un nod cu un volum disponibil de memorie de cel puțin 4 GB. Dacă un astfel de nod nu există, clusterul trebuie să introducă un nou nod pentru a gestiona acest pod, ceea ce poate dura ceva timp. Este important să obțineți o diferență minimă între cererile de resurse și limite, pentru a asigura o scalare rapidă și lină.
Pasul doi: configurarea testelor Liveness și Readiness
Aceasta este încă o temă delicată, care este adesea discutată în comunitatea Kubernetes. Este important să înțelegem bine testele de sănătate (Liveness) și cele de disponibilitate (Readiness), deoarece acestea oferă un mecanism pentru funcționarea stabilă a software-ului și minimizează timpii de nefuncționare. Cu toate acestea, ele pot avea un impact semnificativ asupra performanței aplicației dumneavoastră dacă nu sunt configurate corect. Mai jos este un rezumat al celor două probe.
Liveness arată dacă un container funcționează. Dacă acesta eșuează, kubelet omoară containerul și se activează politica de repornire. Dacă containerul nu are o probă de Liveness, starea implicită va fi de succes — așa este menționat în .
Probele Liveness trebuie să fie ieftine, adică să nu consume multe resurse, deoarece acestea sunt rulată frecvent și trebuie să informeze Kubernetes că aplicația este pornită.
Dacă setați parametrul pentru a rula la fiecare secundă, acesta va adăuga 1 cerere pe secundă, așa că luați în considerare că vor fi necesare resurse suplimentare pentru a gestiona acest trafic.
În compania noastră, testele de Liveness verifică componentele esențiale ale aplicației, chiar și în cazul în care datele (de exemplu, dintr-o bază de date externă sau din cache) nu sunt complet disponibile.
Am configurat în aplicații un endpoint de „sănătate”, care returnează pur și simplu un cod de răspuns 200. Acesta este un indiciu că procesul este activ și capabil să gestioneze cereri (dar nu încă trafic).
Proba Readiness indică dacă un container este pregătit să gestioneze cereri. Dacă proba de disponibilitate eșuează, controllerul endpointurilor elimină adresa IP a podului din toate endpointurile serviciilor corespunzătoare podului. Acest lucru este de asemenea menționat în documentația Kubernetes.
Probele Readiness consumă mai multe resurse, deoarece acestea trebuie să ajungă la backend într-un mod care să demonstreze disponibilitatea aplicației de a accepta cereri.
În comunitate există multe discuții despre dacă ar trebui să ne adresăm direct bazei de date. Având în vedere costurile indirecte (verificările sunt frecvente, dar pot fi reglate), am decis că pentru anumite aplicații disponibilitatea de a gestiona traficul este considerată validă doar după ce am verificat că din baza de date sunt returnate înregistrări. Probe bine concepute de disponibilitate au asigurat un nivel mai mare de accesibilitate și au eliminat timpii de nefuncționare în timpul desfășurării.
Dacă decideți să faceți o interogare la baza de date pentru a verifica disponibilitatea aplicației, asigurați-vă că aceasta costă cât mai puțin posibil. Să luăm următoarea interogare:
SELECT small_item FROM table LIMIT 1Iată un exemplu de cum configurăm aceste două valori în Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Puteți adăuga unele parametri suplimentari de configurare:
initialDelaySeconds— câte secunde vor trece între pornirea containerului și începutul verificărilor probe.periodSeconds— intervalul de așteptare între verificările probe.timeoutSeconds— numărul de secunde după care un pod este considerat în stare de eșec. Un timeout obișnuit.failureThreshold— numărul de eșecuri ale verificărilor înainte ca podul să primească un semnal de repornire.successThreshold— numărul de verificări de succes înainte ca podul să treacă în starea de disponibilitate (după o eșec, când podul este repornit sau recuperat).
Pasul trei: configurarea politicilor de rețea implicite ale podului
În Kubernetes, topologia rețelei este „plană”, în mod implicit toate podurile interacționează direct între ele. În unele cazuri, acest lucru nu este dorit.
O problemă potențială de securitate este că un atacator ar putea utiliza o aplicație vulnerabilă pentru a trimite trafic către toate podurile din rețea. Așa cum se aplică în multe domenii ale securității, principiul minimului privilegiu este relevant aici. Ideal este ca politicile de rețea să specifice clar ce conexiuni între poduri sunt permise și care nu.
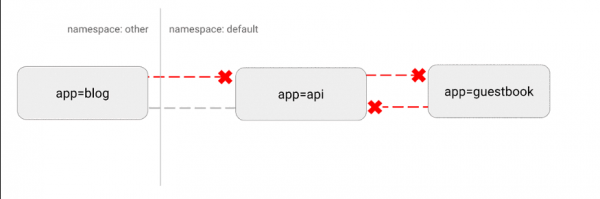
De exemplu, mai jos este o politică simplă care interzice tot traficul de intrare pentru un anumit spațiu de nume:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Vizualizarea acestei configurații:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Mai în detaliu .
Pasul patru: comportament personalizat cu ajutorul hook-urilor și init-containerelor
Una dintre principalele noastre sarcini a fost asigurarea desfășurării aplicațiilor în Kubernetes fără întreruperi pentru dezvoltatori. Acest lucru este dificil din cauza faptului că există numeroase modalități de a termina funcționarea aplicațiilor și de a elibera resursele utilizate de acestea.
Dificultăți speciale au apărut cu . Am observat că, în timpul desfășurării secvențiale a acestor poduri, conexiunile active erau întrerupte înainte de finalizare cu succes.
După cercetări extinse pe internet, am aflat că Kubernetes nu așteaptă ca conexiunile Nginx să se epuizeze înainte de a încheia funcționarea podului. Folosind hook-ul pre-stop, am implementat această funcționalitate și am eliminat complet timpii de nefuncționare:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Dar nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
O altă paradigmă extrem de utilă este utilizarea containerelor init pentru gestionarea lansării aplicațiilor specifice. Acest lucru este deosebit de util în cazul în care aveți un proces consumator de resurse pentru migrarea bazei de date, care trebuie să fie rulat înainte de lansarea aplicației. Pentru acest proces, puteți specifica, de asemenea, un limită de resurse mai mare, fără a stabili o astfel de limită pentru aplicația principală.
O altă schemă frecventă este accesul la secrete în containerul init, care furnizează aceste acreditive modulului principal, prevenind accesul neautorizat la secrete din modulul principal al aplicației.
Ca de obicei, un citat din documentație: containerele init rulează în siguranță codul sau utilitarele utilizatorului, care altfel ar reduce securitatea imaginii containerului aplicației. Păstrând separat instrumentele care nu sunt necesare, limitati suprafața de atac a imaginii containerului aplicației.
Pasul cinci: configurarea nucleului
În cele din urmă, să discutăm despre o tehnică mai avansată.
Kubernetes este o platformă extrem de flexibilă care permite desfășurarea sarcinilor de lucru așa cum considerați potrivit. Avem o serie de aplicații cu o eficiență ridicată care necesită resurse extrem de mari. După teste extensive de încărcare, am descoperit că una dintre aplicații se descurcă cu dificultate cu traficul așteptat, dacă sunt utilizate setările Kubernetes implicite.
Cu toate acestea, Kubernetes permite lansarea unui container privilegiat, care modifică parametrii kernel-ului doar pentru podul specific. Iată ce am folosit pentru a schimba numărul maxim de conexiuni deschise:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Aceasta este o tehnică mai avansată, care este adesea inutilă. Dar dacă aplicația dumneavoastră abia face față unei sarcini mari, puteți încerca să ajustați câțiva dintre acești parametri. Informații mai detaliate despre acest proces și despre configurarea diferitelor valori – ca întotdeauna .
În concluzie
Deși Kubernetes poate părea o soluție gata de utilizare „din cutie”, pentru o funcționare fără întreruperi a aplicațiilor este necesar să faceți câțiva pași cheie.
Pe parcursul întreagii migrații către Kubernetes, este important să urmați „ciclul de testare a încărcării”: lansați aplicația, testați-o sub sarcină, observați metricile și comportamentul în timpul scalării, ajustați configurația pe baza acestor date și apoi repetați din nou acest ciclu.
Evaluați realist traficul așteptat și încercați să depășiți această limită pentru a vedea ce componente se vor defecta prima dată. Cu o astfel de abordare iterativă, poate fi suficient doar să urmați câteva din recomandările enumerate. Sau ar putea fi necesară o configurare mai aprofundată.
Întotdeauna puneți-vă aceste întrebări:
- Câte resurse consumă aplicațiile și cum se va schimba această cantitate?
- Care sunt cerințele reale de scalare? Cât trafic va gestiona aplicația în medie? Dar în cazul traficului de vârf?
- Cât de frecvent va avea nevoie serviciul de scalare orizontală? Cât de repede trebuie să fie introduse noi poduri pentru a primi trafic?
- Cât de corect se finalizează lucrul podurilor? Este necesar acest lucru? Se poate realiza o desfășurare fără timp de nefuncționare?
- Cum se pot minimiza riscurile pentru securitate și se poate limita daunele cauzate de orice poduri compromise? Există servicii care au permisiuni sau accesuri de care nu au nevoie?
Kubernetes oferă o platformă incredibilă care permite aplicarea celor mai bune practici pentru implementarea a mii de servicii într-un cluster. Cu toate acestea, toate aplicațiile sunt diferite. Uneori, implementarea necesită ceva mai mult efort.
Din fericire, Kubernetes oferă setările necesare pentru a atinge toate obiectivele tehnice. Folosind o combinație de cereri de resurse și limite, probe Liveness și Readiness, containere init, politici de rețea și configurație personalizată a nucleului, puteți obține performanță înaltă alături de reziliență și scalabilitate rapidă.
Ce altceva să citești:
- .
- .
- .
Sursa: habr.com
