

Acum trei ani, Victor Tarnavsky și Alexey Milovidov de la Yandex au discutat pe scenă HighLoad++ , cât de bun este ClickHouse și cum nu se blochează. Iar pe scena alăturată a fost Alexander Zaitsev de despre migrarea la ClickHouse de la o altă bază de date analitică, rezultând în concluzia că ClickHouse, bineînțeles, este o soluție bună, dar nu foarte convenabilă. Când, în 2016, compania LifeStreet, unde lucra atunci Alexander, a migrat un sistem analitic multi-petabyte la ClickHouse, a fost o „călătorie pe drumul de cărămidă galbenă”, plină de pericole necunoscute — ClickHouse atunci părea un câmp minat.
Trei ani mai târziu ClickHouse s-a îmbunătățit semnificativ — în această perioadă, Alexander a înființat compania Altinity, care nu doar ajută la migrarea la ClickHouse zeci de proiecte, ci și îmbunătățește produsul împreună cu colegii de la Yandex. Acum ClickHouse nu mai este o plimbare lipsită de griji, dar nici un câmp minat.
Alexander se ocupă de sisteme distribuite din 2003, a dezvoltat proiecte mari pe MySQL, Oracle și Vertica. La recentul HighLoad++ 2019 Alexander, unul dintre pionierii utilizării ClickHouse, a vorbit despre cum arată acum această bază de date. Vom afla despre principalele caracteristici ClickHouse: în ce se deosebește de alte sisteme și în ce cazuri este mai eficient să o folosim. Vom analiza prin exemple practici recente și testate în proiecte despre construirea sistemelor pe ClickHouse.
Retrospectivă: ce s-a întâmplat acum 3 ani
Acum trei ani, migram compania LifeStreet pe ClickHouse de la o altă bază de date analitică, iar migrarea analizei rețelei de publicitate a arătat astfel:
- Iunie 2016. În OpenSource a apărut ClickHouse și a început proiectul nostru;
- August. Proof Of Concept: o rețea publicitară mare, infrastructură și 200-300 terabytes de date;
- Octombrie. Primele date în producție;
- Decembrie. Sarcină completă a produsului — 10-50 miliarde evenimente pe zi.
- Iunie 2017. Migrarea reușită a utilizatorilor la ClickHouse, 2,5 petabyte de date pe un cluster de 60 de servere.
În procesul de migrare, s-a crescut înțelegerea că ClickHouse — este un sistem bun, cu care este plăcut să lucrezi, dar este un proiect intern al companiei Yandex. Prin urmare, există nuanțe: Yandex se va concentra mai întâi pe clienții interni și doar apoi pe comunitate și nevoile utilizatorilor externi, iar ClickHouse nu reușea atunci să atingă nivelul enterprise în multe domenii funcționale. Așadar, în martie 2017, am fondat compania Altinity pentru a face ClickHouse mai rapid și mai convenabil nu doar pentru Yandex, ci și pentru alți utilizatori. Și acum noi:
- Învățăm și ajutăm la construirea de soluții pe ClickHouse astfel încât clienții să nu întâmpine dificultăți, iar soluția să funcționeze în cele din urmă;
- Asigurăm suport 24/7 ClickHouse-instalări;
- Dezvoltăm propriile proiecte ecologice;
- Actively we commit to the ClickHouse, răspunzând la cererile utilizatorilor care doresc să vadă anumite funcții.
Și, desigur, ajutăm cu migrarea către ClickHouse de MySQL, Vertica, Oracle, Greenplum, Redshift și alte sisteme. Am participat la diverse migrații, iar toate au fost de succes.
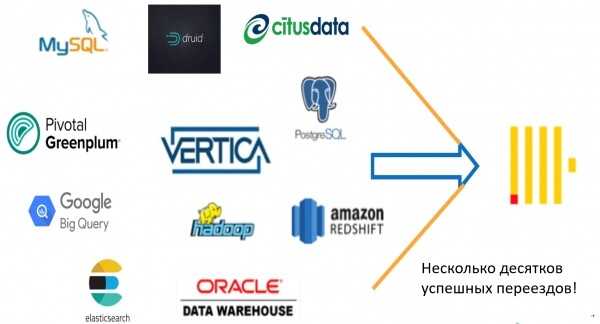
De ce ar trebui să migrăm la ClickHouse
Nu încetinește! Aceasta este principala raison. ClickHouse — o bază de date extrem de rapidă pentru diferite scenarii:
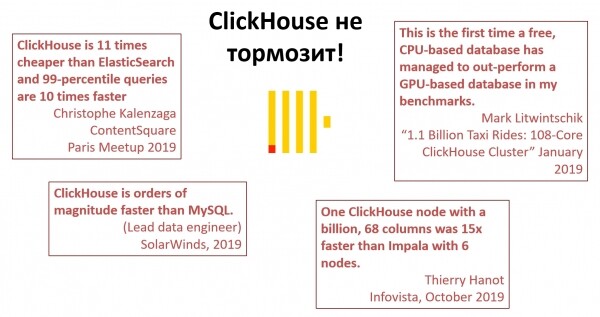
Citate random de persoane care lucrează de mult timp cu ClickHouse.
Scalabilitate. Pe o altă bază de date poți obține performanțe decente pe un singur server, dar ClickHouse poți scala nu doar vertical, ci și orizontal, adăugând pur și simplu servere. Toate funcționează nu la fel de perfect cum ne-am dori, dar funcționează. Poți extinde sistemul pe măsură ce afacerea crește. Este important că nu suntem limitați de soluția actuală și întotdeauna există potențial pentru dezvoltare.
Portabilitate. Nu există o legătură cu ceva anume. De exemplu, cu Amazon Redshift este greu să migrezi undeva. Dar ClickHouse poate fi instalat pe laptop, server, poate fi desfășurat în cloud, poți merge în Kubernetes — nu există restricții privind utilizarea infrastructurii. Este convenabil pentru toată lumea și acesta este un avantaj mare de care multe alte baze de date similare nu se pot lăuda.
Flexibilitate. ClickHouse nu se oprește pe ceva anume, cum ar fi Yandex.Metrica, ci se dezvoltă și se folosește într-un număr tot mai mare de proiecte și industrii. Poate fi extins prin adăugarea de noi funcționalități pentru soluționarea de noi sarcini. De exemplu, se crede că stocarea jurnalelor în baza de date este un moft, așa că pentru aceasta s-a inventat Elasticsearch. Dar, datorită flexibilității ClickHouse, poți stoca jurnaluri în el, și adesea este chiar mai bine decât în Elasticsearch — în ClickHouse pentru aceasta, este nevoie de 10 ori mai puțin hardware.
Gratuit Open Source. Nu trebuie să plătești pentru nimic. Nu trebuie să negociezi permisiunea de a instala sistemul pe laptopul sau serverul tău. Nu există plăți ascunse. Totuși, nicio altă tehnologie Open Source de baze de date nu poate concura cu viteza ClickHouse. MySQL, MariaDB, Greenplum — toate sunt mult mai lente.
Comunitatea, energia și distracția. În ClickHouse o comunitate excelentă: întâlniri, chat-uri și Alexey Milovidov, care ne energizează pe toți cu energia și optimismul său.
Migrarea la ClickHouse
Pentru a trece la ClickHouse altceva, sunt necesare doar trei lucruri:
- A înțelege limitările ClickHouse și pentru ce nu se potrivește.
- A folosi avantajele tehnologiei și cele mai puternice părți ale acesteia.
- A experimenta. Chiar și înțelegând cum funcționează ClickHouse, nu este întotdeauna posibil să anticipatezi când va fi mai rapid, când mai lent, când mai bine și când mai rău. Așadar, încearcă.
Problema migrației
Există un singur „dar”: dacă te muți la ClickHouse de la altceva, de obicei ceva nu merge bine. Ne-am obișnuit cu anumite practici și lucruri care funcționează în baza de date preferată. De exemplu, orice persoană care lucrează cu baze de date SQLconsideră că un set de funcții este indispensabil:
- tranzacții;
- constrângeri;
- consistență;
- indici;
- UPDATE/DELETE;;
- NULL-uri;;
- milisecunde;
- convertiri automate de tip;
- join-uri multiple;
- partiții arbitrare;
- instrumente de gestionare a clusterului.
Setul este obligatoriu, dar acum trei ani în ClickHouse nu existau niciuna dintre aceste funcții! Acum a rămas mai puțin de jumătate din ceea ce nu era implementat: tranzacții, constrângeri, consistență, milisecunde și conversii de tip.
Și cel mai important — ceea ce în ClickHouse anumite practici și abordări standard nu funcționează sau funcționează diferit față de ceea ce suntem obișnuiți. Tot ce apare în ClickHouse, corespunde „ClickHouse way”, adică funcțiile diferă de cele din alte baze de date. De exemplu:
- Indicii nu sunt selectați, ci sunt săriți.
- UPDATE/DELETE; nu sunt sincrone, ci asincrone.
- Join-uri multiple există, dar nu există un planificator de interogări. Cum se execută atunci acestea, nu este foarte clar pentru oamenii din lumea bazelor de date.
Scenariile ClickHouse
În 1960, matematicianul american de origine ungară Wigner E. P. a scris un articol „The unreasonable effectiveness of mathematics in the natural sciences” despre cum lumea înconjurătoare este, dintr-un motiv oarecare, bine descrisă prin legi matematice. Matematica este o știință abstractă, iar legile fizicii, exprimate sub formă matematică, nu sunt triviale și Wigner E. P. a subliniat că acest lucru este foarte ciudat.
Din punctul meu de vedere, ClickHouse aceasta este la fel de stranie. Reformulându-l pe Wigner, se poate spune că: eficiența incomprehensibilă a ClickHouse în cele mai variate aplicații analitice este uluitoare!
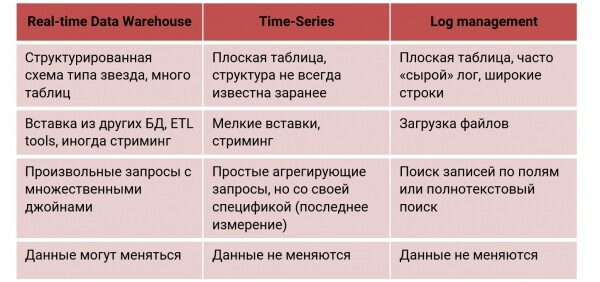
De exemplu, să luăm Real-Time Data Warehouse, în care datele sunt încărcate aproape continuu. Vrem să primim cereri de la el cu întârziere de o secundă. Vă rugăm — folosiți ClickHouse, deoarece acest scenariu a fost dezvoltat pentru acest lucru. ClickHouse exact așa este utilizat nu doar în web, ci și în analiza de marketing și financiară, AdTech, precum și în detectarea fraudelor. În Depozitul de Date în Timp Real se folosește o schemă complexă structurantă de tip «stea» sau «fulg de zăpadă», cu multe tabele JOIN (uneori multiple), iar datele sunt de obicei stocate și modificate în anumite sisteme.
Să luăm un alt scenariu — Seria Temporală: monitorizarea dispozitivelor, rețelelor, statisticile de utilizare, Internetul lucrurilor. Aici ne confruntăm cu evenimente destul de simple ordonate temporal. ClickHouse pentru care nu a fost inițial dezvoltat, dar s-a demonstrat eficient, astfel că companiile mari folosesc ClickHouse ca depozit pentru informațiile de monitorizare. Pentru a examina dacă ClickHouse este potrivit pentru seria temporală, am realizat un benchmark bazat pe abordare și rezultate InfluxDB și TimescaleDB — baze de date specializate serie temporală . , ceea ce ClickHouse, chiar și fără optimizare pentru astfel de sarcini, câștigă și pe un teren străin:
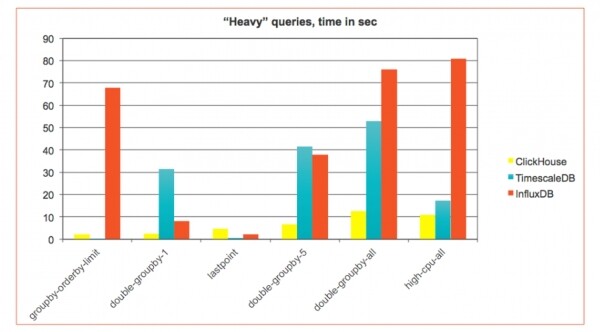
În serie temporală de obicei se folosește o tabelă îngustă — câteva coloane mici. Monitorizarea poate genera foarte multe date — milioane de înregistrări pe secundă — și de obicei sosesc în inserții mici (real-time streaming). De aceea, este necesar un alt scenariu de inserție, iar cererile au propria specificitate.
Gestionarea Jurnalelor. Colectarea jurnalelor în Baza de Date — de obicei este nerecomandată, dar în ClickHouse se poate face cu anumite comentarii, așa cum este descris mai sus. Multe companii folosesc ClickHouse tocmai pentru aceasta. În acest caz, se folosește o tabelă plată și largă, în care stocăm jurnalele în întregime (de exemplu, sub formă de JSON), sau le tăiem în părți. Datele sunt încărcate de obicei în batch-uri mari (fișiere), iar căutăm pe baza unor câmpuri.
Pentru fiecare dintre aceste funcții se folosesc de obicei baze de date specializate. ClickHouse unul poate face toate acestea și atât de bine încât le depășește în performanță. Să examinăm acum în detaliu serie temporală scenariul și cum să «preparăm» ClickHouse pentru acest scenariu.
Seria Temporală
În prezent, acesta este scenariul principal pentru care ClickHouse este considerat o soluție standard. Serie temporală — este un set de evenimente ordonate în timp, reprezentând modificările unui anumit proces în timp. De exemplu, aceasta poate fi frecvența bătăilor inimii pe parcursul unei zile sau numărul de procese dintr-un sistem. Tot ce oferă ticuri temporale cu anumite măsurători este serie temporală:
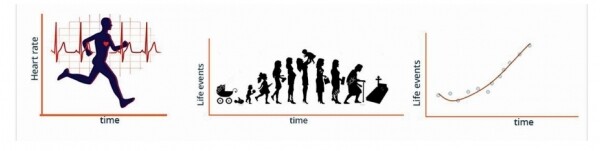
Cea mai mare parte a acestui tip de evenimente provine din monitorizare. Nu este vorba doar despre monitorizarea web, ci și despre dispozitive reale: automobile, sisteme industriale, IoT, producție sau taxiuri fără șofer, în portbagajul cărora Yandex deja pune ClickHouse-server.
De exemplu, există companii care colectează date de pe nave. La fiecare câteva secunde, senzorii de pe un cargobot transmit sute de măsurători diferite. Inginerii le studiază, construiesc modele și încearcă să înțeleagă cât de eficient este utilizată nava, deoarece cargobotul nu ar trebui să rămână nici o secundă inactiv. Orice perioadă de inactivitate este o pierdere de bani, de aceea este important să se prognozeze ruta astfel încât opririle să fie minime.
În prezent, există o creștere a bazelor de date specializate care măsoară serie temporală. Pe site-ul DB-Engines sunt într-un fel clasificate diferite baze de date, iar acestea pot fi vizualizate pe tipuri:
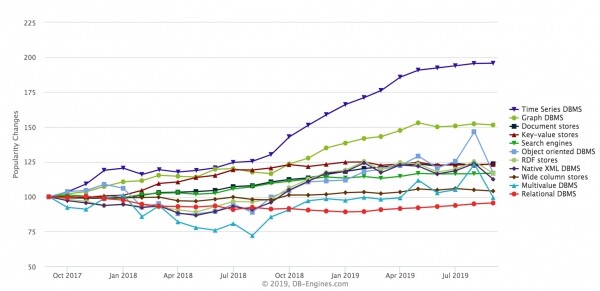
Cel mai rapid tip în expansiune este time-series. De asemenea, baze de date grafice cresc, dar time-series cresc mai repede în ultimii câțiva ani. Reprezentanții tipici ai acestui tip de baze de date sunt InfluxDB, Prometheus, KDB, TimescaleDB (construit pe PostgreSQL), soluții de la Amazon. ClickHouse poate fi folosit și aici, și este utilizat. Voi cita câteva exemple publice.
Unul dintre pionieri este compania CloudFlare (CDN-provider). Ei monitorizează CDN prin ClickHouse (DNS-cererile, HTTP-cererile) cu o încărcare uriașă — 6 milioane de evenimente pe secundă. Totul trece prin Kafka, este trimis în ClickHouse, care oferă posibilitatea de a vedea în timp real tablourile de bord ale evenimentelor din sistem.
Comcast — unul dintre liderii telecomunicațiilor din SUA: internet, televiziune digitală, telefonie. Ei au creat un sistem similar de gestionare CDN în cadrul Open Source proiectului Apache Traffic Control pentru a lucra cu datele lor enorme. ClickHouse este utilizat ca backend pentru analiză.
Percona a integrat ClickHouse în interiorul propriului PMM, pentru a stoca monitorizarea diferitelor MySQL.
Cerințe specifice
Bazele de date time-series au propriile cerințe specifice.
- Inserție rapidă din multe surse. Trebuie să inserăm foarte repede date din multe fluxuri. ClickHouse făcând acest lucru bine, deoarece toate inserțiile sunt non-blocante. Orice inserați — este un nou fișier pe disc, iar inserțiile mici pot fi tamponate într-un fel sau altul. În ClickHouse cel mai bine este să inserăm datele în pachete mari, nu pe o singură linie.
- Schemă flexibilă. În serie temporală în general nu cunoaștem structura datelor complet. Putem construi un sistem de monitorizare pentru o aplicație specifică, dar apoi este greu de utilizat pentru o altă aplicație. Pentru aceasta este nevoie de o schemă mai flexibilă. ClickHouse, permite acest lucru, chiar dacă este o bază strict tipizată.
- Stocarea eficientă și «uitarea» datelor. De obicei, în serie temporală o cantitate uriașă de date, așa că trebuie stocată cât mai eficient posibil. De exemplu, la InfluxDB o bună compresie — aceasta este caracteristica sa principală. Dar pe lângă stocare, trebuie să știm și să «uităm» datele vechi și să facem un fel de downsampling — calculul automat al agregatelor.
- Interogări rapide pentru date agregate. Uneori este interesant să vedem ultimele 5 minute cu precizie până la milisecunde, dar pentru date lunare granularitatea pe minut sau secundă poate să nu fie necesară — statistica generală este suficientă. Suportul pentru acest tip de cerințe este necesar, altfel o interogare pe 3 luni va dura foarte mult, chiar și în ClickHouse.
- Interogări de tip «last point, as of». Acestea sunt tipice pentru serie temporală interogări: ne uităm la ultima măsurare sau stare a sistemului într-un moment specific. t. Pentru DB, acestea nu sunt interogări foarte plăcute, dar trebuie să știm cum să le executăm.
- «Lipirea» seriilor temporale. Serie temporală — este o serie temporală. Dacă avem două serii temporale, adesea trebuie să le unim și să le corelăm. Nu toate DB-urile facilitează acest lucru, mai ales cu serii temporale nealinierate: aici sunt - un fel de timpi, acolo - altele. Putem calcula mediile, dar totuși ar putea fi o lipsă, așa că nu este clar.
Haideți să vedem cum sunt îndeplinite aceste cerințe în ClickHouse.
Schema
În ClickHouse schema pentru serie temporală poate fi realizată în diverse moduri, în funcție de gradul de regularitate al datelor. Putem construi un sistem pe date regulate, când știm toate metricile dinainte. De exemplu, așa a făcut CloudFlare cu monitorizarea CDN — este un sistem bine optimizat. Putem construi un sistem mai general, care monitorizează întreaga infrastructură, diferite servicii. În cazul datelor neregulate, nu știm dinainte ce monitorizăm — și, probabil, acesta este cazul cel mai general.
Datele regulate. Coloane. Schema este simplă – coloane cu tipurile necesare:
CREAȚI TABELA cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* join to dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Aceasta este o tabelă obișnuită care monitorizează o anumită activitate de încărcare a sistemului (utilizator, sistem, inactiv, nice). Este simplu și convenabil, dar nu foarte flexibil. Dacă dorim o schemă mai flexibilă, putem folosi array-uri.
Date neregulate. Array-uri:
CREAȚI TABELA cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Structura Nested — acestea sunt două array-uri: metrics.name și metrics.value. Aici pot fi stocate date de monitorizare aleatorii, cum ar fi un array de nume și un array de valori la fiecare eveniment. Pentru o optimizare ulterioară, în loc de o astfel de structură, pot fi făcute mai multe. De exemplu, una — pentru float-valoare, alta — pentru int-valoare, deoarece int se dorește stocarea mai eficientă.
Dar această structură este mai greu de accesat. Va trebui să folosim o construcție specială pentru a extrage valorile mai întâi de la index și apoi de la array:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Dar aceasta funcționează totuși destul de repede. O altă metodă de stocare a datelor neregulate – pe rânduri.
Date neregulate. Rânduri. În această abordare tradițională, fără array-uri, sunt stocate direct numele și valorile. Dacă de pe un dispozitiv vin simultan 5 000 de măsurători – sunt generate 5 000 de rânduri în baza de date:
CREAȚI TABELA cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FROM cpu_r
WHERE metric_name IN ('usage_user', ...)
ClickHouse cu acesta se descurcă — are extensii speciale ClickHouse SQL. De exemplu, maxIf — este o funcție specială care calculează maximul unei metrici atunci când se îndeplinește o anumită condiție. Poți scrie în aceeași interogare mai multe astfel de expresii și să calculezi imediat valorile pentru mai multe metrici.
Să comparăm cele trei abordări:
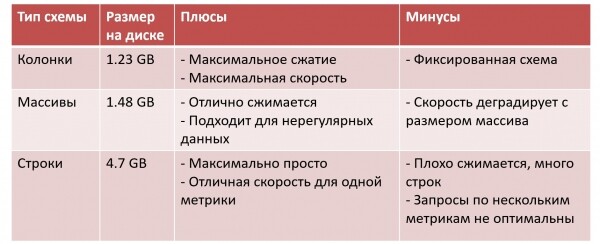
Aici am adăugat „Dimensiunea datelor pe disc” pentru un anumit set de date. În cazul coloanelor, avem cea mai mică dimensiune a datelor: compresia maximă, viteza maximă a interogărilor, dar plătim prin faptul că trebuie să le blocăm pe toate imediat.
În cazul aranjamentelor, lucrurile sunt puțin mai complicate. Datele sunt totuși bine comprimate, iar o schemă neregulată poate fi stocată. Dar ClickHouse — o bază de date pe coloane, iar când începem să stocăm totul într-un aranjament, aceasta se transformă într-o bază de date pe șiruri, și plătim pentru flexibilitate cu eficiența. Pentru orice operațiune va trebui să citim întregul aranjament în memorie, apoi să găsim elementul dorit — iar dacă aranjamentul crește, viteza degradează.
Într-una dintre companiile care folosesc o astfel de abordare (de exemplu, ), aranjamentele sunt tăiate în bucăți de 128 de elemente. Datele a câteva mii de metrici, totalizând 200 TB de date/pe zi, nu sunt stocate într-un singur aranjament, ci în 10 sau 30 de aranjamente cu o logică specială pentru stocare.
Cea mai simplă abordare este cu șiruri. Dar datele nu se comprimă bine, dimensiunea tabelului devine mare, iar atunci când interogările merg pe mai multe metrici, ClickHouse funcționează suboptim.
Schema hibridă
Să presupunem că am ales schema cu aranjament. Dar dacă știm că majoritatea tablourilor noastre de bord afișează doar metricile user și system, putem materializa aceste metrici suplimentar din aranjament la nivel de tabel astfel:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
La inserare ClickHouse le va număra automat. Astfel putem combina plăcutul cu utilul: schema este flexibilă și generală, dar cele mai frecvent utilizate coloane le-am extras. Menționez că acest lucru nu a necesitat modificarea inserției și ETL, care continuă să insereze în tabel aranjamente. Pur și simplu am făcut ALTER TABLE, am adăugat câteva coloane și a rezultat o schemă hibridă și mai rapidă, pe care o putem folosi imediat.
Codecuri și compresie
Pentru serie temporală este important cât de bine îți ambalezi datele, pentru că aranjamentul informațiilor poate fi foarte mare. În ClickHouse există un set de instrumente pentru a obține un efect de compresie de 1:10, 1:20, iar uneori chiar mai mult. Aceasta înseamnă că datele necomprimate cu un volum de 1 TB pe disk ocupă 50-100 GB. O dimensiune mai mică este benefică, deoarece datele pot fi citite și procesate mai repede.
Pentru a atinge un nivel înalt de compresie, ClickHouse suportă următoarele codecuri:
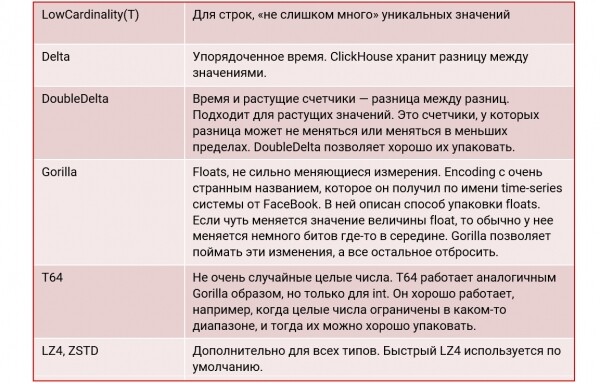
Exemplu de tabel:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Aici definim codec-ul DoubleDelta într-un caz, iar în celălalt — Gorilla, și adăugăm neapărat și LZ4 compresia. Drept rezultat, dimensiunea datelor pe disk este semnificativ redusă:
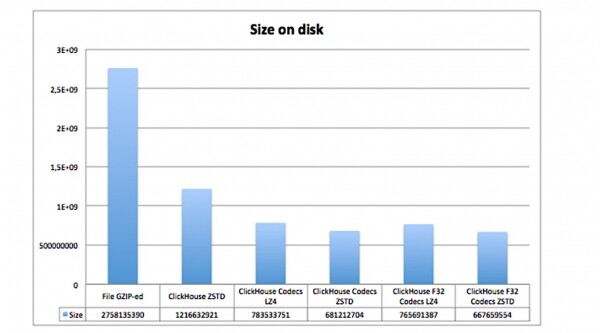
Aici este arătat cât de mult spațiu ocupă aceleași date, dar folosind diferite codecuri și compresii:
- într-un fișier GZIP pe disk;
- în ClickHouse fără codecuri, dar cu compresie ZSTD;
- în ClickHouse cu codecuri și compresie LZ4 și ZSTD.
Se observă că tabelele cu codecuri ocupă mult mai puțin spațiu.
Dimensiunea contează
Este la fel de important tipul de date potrivit:
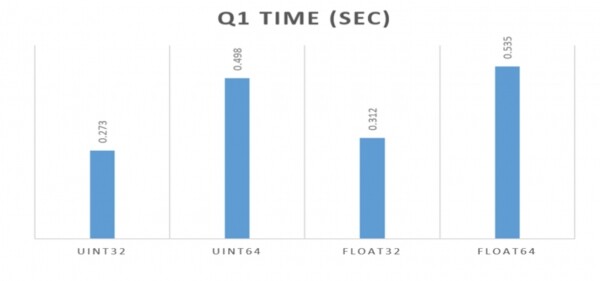
În toate exemplele de mai sus, am folosit Float64. Dar dacă am fi ales Float32, atunci ar fi fost chiar mai bine. Acest lucru a fost demonstrat foarte bine de echipa de la Percona în articolul din linkul de mai sus. Este important să folosești cel mai compact tip care se potrivește cu sarcina: chiar și mai puțin pentru dimensiunea pe disk, decât pentru viteza interogărilor. ClickHouse este foarte sensibil la asta.
Dacă poți folosi int32 în loc de int64, așteaptă-te la aproape o dublare a performanței. Datele ocupă mai puțină memorie, iar toată "aritmetica" funcționează mult mai repede. ClickHouse în interiorul său — un sistem foarte strict tipizat, folosește la maximum toate posibilitățile oferite de sistemele moderne.
Agregarea și Materialized Views
Agregarea și materializatele permit realizarea agregatelor pentru diverse situații:
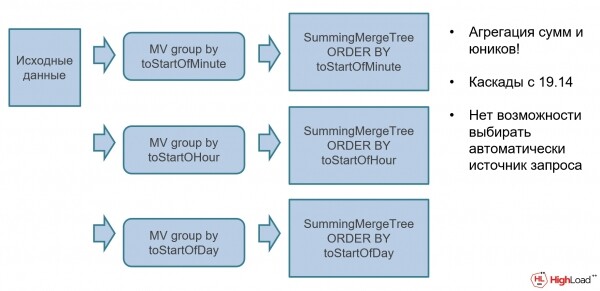
De exemplu, puteți avea date sursă neagregate, iar pe acestea se pot aplica diverse vizualizări materializate cu sumarizare automată printr-un motor specializat. SummingMergeTree (SMT). SMT este o structură de date specială de agregare care calculează automat agregatele. Datele brute sunt inserate în baza de date, acestea sunt agregate automat și pot fi folosite imediat pentru tablouri de bord.
TTL — „uită” datele vechi
Cum putem „uita” datele care nu mai sunt necesare? ClickHouse acest lucru este posibil. Când creați tabele, puteți specifica TTL expresii: de exemplu, păstrăm datele minute timp de o zi, datele zilnice - 30 de zile, iar cele săptămânale sau lunare nu sunt atinse niciodată:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…

tot fără TTL
Multi-tier — împărțim datele pe discuri
Continuând această idee, datele pot fi stocate în ClickHouse locuri diferite. Să presupunem că dorim să păstrăm datele fierbinți din ultima săptămână pe un SSDdiscuri locale foarte rapide, iar datele mai istorice le stocăm în altă parte. În ClickHouse este acum posibil:
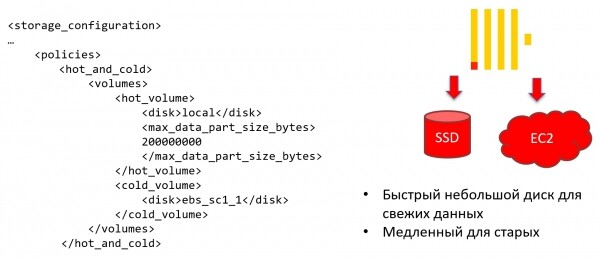
Puteți configura o politică de stocare (storage policy) astfel încât ClickHouse să mute automat datele în alt stocaj la atingerea anumitor condiții.
Dar aceasta nu este tot. La nivelul unei tabele specifice, puteți defini reguli pentru momentul în care datele trec la stocare la rece. De exemplu, datele stau timp de 7 zile pe un disc foarte rapid, iar tot ce este mai vechi este mutat pe un disc lent. Acest lucru este benefic deoarece permite sistemului să funcționeze la o performanță maximă, controlând în același timp cheltuielile și evitând să cheltuie resurse pe datele la rece:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Posibilități unice ClickHouse
Practic, în ClickHouse există astfel de „figurine”, dar acestea sunt atenuate de exclusivitate — de ceea ce nu găsești în alte baze de date. De exemplu, iată câteva dintre funcțiile unice ClickHouse:
- Matrice. În ClickHouse o suport foarte bun pentru matrici, precum și capacitatea de a efectua calcule complexe pe acestea.
- Structuri de date de agregare. Aceasta este una dintre „caracteristicile cheie” ClickHouse. În ciuda faptului că echipa de la Yandex spune că nu dorim să agregăm date, toți agregăm în ClickHouse, deoarece este rapid și convenabil.
- Vizualizări materializate. Împreună cu structurile de date de agregare, vizualizările materializate permit realizarea unei real-time agregări.
- ClickHouse SQL. Acesta este un extensie a limbajului SQL cu unele caracteristici suplimentare și exclusive, care există doar în ClickHouse. A fost odată, pe de o parte, o extensie, iar pe de altă parte – un dezavantaj. Acum am eliminat aproape toate dezavantajele în comparație cu SQL 92 . Acum este doar o extensie.
- Lambda– expresii. Există și în alte baze de date?
- ML- suport. Acesta există în diverse Baze de Date, în unele mai bine, în altele mai rău.
- Cod deschis. Putem extinde ClickHouse împreună. Acum în ClickHouse aproape 500 de contribuitori, iar acest număr continuă să crească.
Întrebări complexe
În ClickHouse există multe moduri diferite de a obține același rezultat. De exemplu, se poate returna ultimul lucru din tabel de trei moduri diferite pentru CPU (există și o a patra, dar este și mai exotică).
Primul arată cât de convenabil este să faci în ClickHouse întrebări, când dorești să verifici că tuple este inclus în subîntrebare. Asta mi-a lipsit foarte mult în alte Baze de Date. Dacă vreau să compar ceva cu subîntrebarea, atunci în alte Baze de Date pot compara doar scalar, iar pentru mai multe coloane trebuie să scriu JOIN. În ClickHouse poate fi folosit tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Al doilea mod face același lucru, dar folosește funcția de agregare argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
În ClickHouse există câteva zeci de funcții de agregare, iar dacă folosești combinatori, conform legilor combinatoricii vor exista în jur de o mie. ArgMax — una dintre funcții care calculează valoarea maximă: interogarea returnează valoarea usage_user, la care se atinge valoarea maximă created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
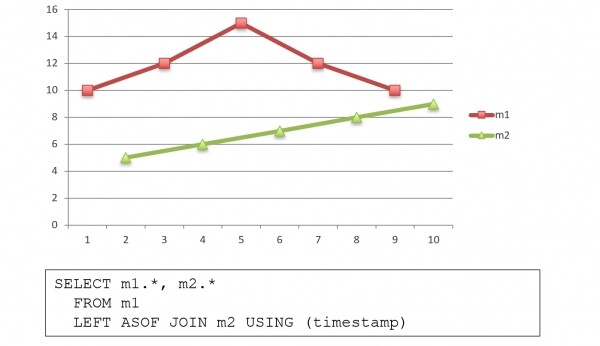
ASOF JOIN — „lipirea” rândurilor cu momente diferite. Aceasta este o funcție unică pentru bazele de date, care există doar în kdb+. Dacă există două serii temporale cu momente diferite, ASOF JOIN permite să le aliniezi și să le lipești într-o singură interogare. Pentru fiecare valoare dintr-o serie temporală, se găsește cea mai apropiată valoare din cealaltă, și acestea sunt returnate pe un singur rând:
Funcții analitice
În standardul SQL-2003 se poate scrie astfel:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
În ClickHouse Asta nu se poate - nu suportă standardul SQL-2003 și, probabil, niciodată nu o va face. În schimb, în ClickHouse se obișnuiește să se scrie așa:
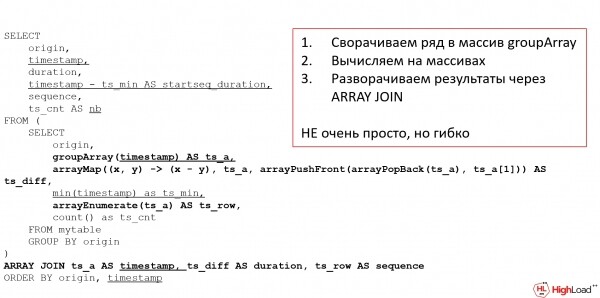
Am promis lambda – iată-le!
Aceasta este analogul unei interogări analitice în standardul SQL-2003: el calculează diferența dintre două timestamp, duration, numărul de ordine - tot ceea ce, de obicei, considerăm funcții analitice. În ClickHouse noi le calculăm prin intermediul array-urilor: mai întâi, agregăm datele într-un array, după care facem asupra array-ului tot ce dorim, iar apoi le desfășurăm înapoi. Este destul de inconvenient, necesită o afecțiune pentru programarea funcțională, cel puțin, dar este foarte flexibil.
Funcții speciale
În plus, în ClickHouse există multe funcții specializate. De exemplu, cum să determinăm câte sesiuni se desfășoară simultan? O problemă tipică pentru monitorizare - a determina încărcarea maximă într-o interogare. În ClickHouse există o funcție specială pentru acest scop:
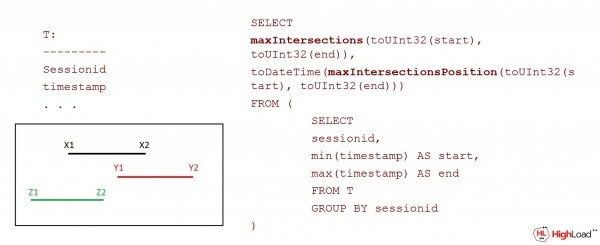
În general, pentru multe scopuri în ClickHouse există funcții speciale:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Aceasta nu este o listă completă de funcții, în total există 500-600. Indiciu: toate funcțiile din ClickHouse se află în tabelul sistemic (nu toate sunt documentate, dar toate sunt interesante):
select * from system.functions order by nameClickHouse se auto-conține multe informații despre sine, inclusiv log tables, query_log, log de urmărire, log de operațiuni cu blocuri de date (part_log), log de metrici și log sistemic, pe care, de obicei, îl scrie pe disc. Logul de metrici este serie temporală în ClickHouse în esență: ClickHouseBD-ul poate juca rolul serie temporală bazelor de date, astfel încât să "înghită" de fapt, sine.
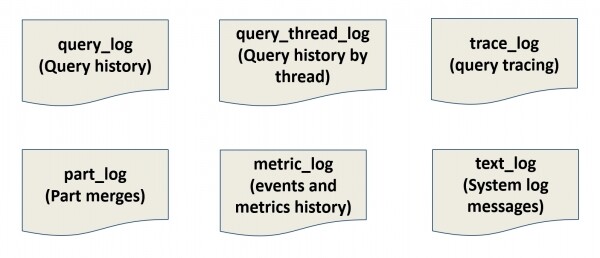
Este o chestiune unică - dacă facem bine treaba pentru serie temporală, de ce nu putem stoca tot ceea ce este necesar în interior? Nu avem nevoie de Prometheus, stocăm totul în interior. Ne-am conectat la Grafana și ne monitorizăm pe noi înșine. Totuși, dacă ClickHouse cade, atunci nu vom vedea de ce - de aceea, de obicei, nu se face așa.
Un cluster mare sau multe mici ClickHouse
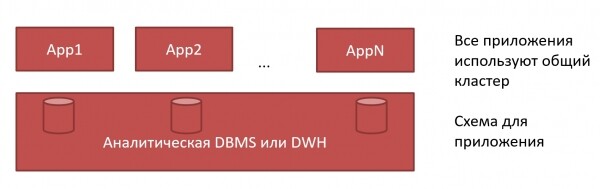
Ce este mai bine - un cluster mare sau multe ClickHouse mici? Abordarea tradițională la DWH — este un cluster mare, în care sunt rezervate scheme pentru fiecare aplicație. Am ajuns la administratorul de baze de date — dă-ne schema, și ne-a fost oferită:
În ClickHouse se poate face diferit. Fiecare aplicație poate avea propria ClickHouse:
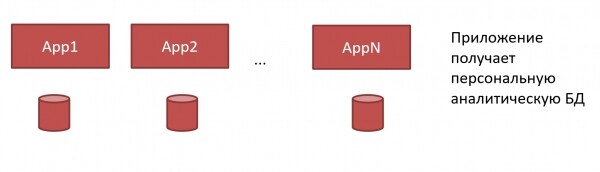
Nu mai avem nevoie de un mare monstruoasă DWH și administratori inflexibili. Fiecare aplicație poate avea propriul ClickHouse, și dezvoltatorul o poate face singur, deoarece ClickHouse se instalează foarte ușor și nu necesită o administrare complexă:
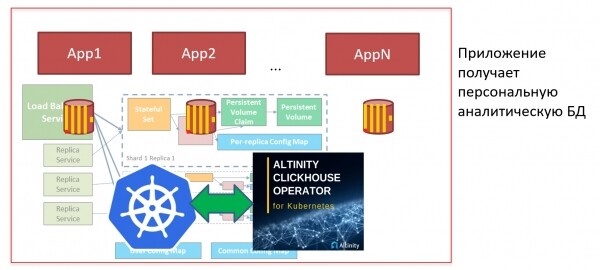
Dar dacă avem multe ClickHouse, și trebuie să le instalăm frecvent, dorim să automatizăm acest proces. Pentru aceasta, putem, de exemplu, utiliza Kubernetes și clickhouse-operator. În Kubernetes ClickHouse poate fi instalat «cu un clic»: pot apăsa un buton, lansa manifestul și baza este gata. Pot crea imediat schema, începe să încarce metrici, și în 5 minute deja am un dashboard gata Grafana. Atât de simplu!
Ce înseamnă în final?
Deci, ClickHouse — aceasta este:
- Rapid. Asta știe toată lumea.
- Simplu. Puțin discutabil, dar cred că greu în învățare, ușor în luptă. Dacă înțelegi cum ClickHouse funcționează, mai departe totul este foarte simplu.
- Universal. Este potrivit pentru diferite scenarii: DWH, Time Series, Log Storage. Dar aceasta nu este OLTP baza de date, așa că nu încercați să faceți inserții scurte și citiri.
- Interesant. Probabil, cei care lucrează cu ClickHouse, au trăit multe momente interesante în sens bun și rău. De exemplu, a apărut o nouă versiune, totul a încetat să funcționeze. Sau când te-ai luptat cu o problemă două zile, dar după o întrebare în chat-ul de pe Telegram problema a fost rezolvată în două minute. Sau cum la conferință, în prezentarea lui Alexey Milovidov, un screenshot din ClickHouse a rupt transmisia HighLoad++. Astfel de lucruri se întâmplă tot timpul și fac viața noastră cu ClickHouse strălucitoare și interesantă!
Prezentarea poate fi vizionată .
Așteptata întâlnire a dezvoltatorilor de sisteme cu sarcină mare pe va avea loc pe 9 și 10 noiembrie la Skolkovo. În sfârșit va fi o conferință offline (chiar dacă cu respectarea tuturor măsurilor de precauție), deoarece energia HighLoad++ nu poate fi ambalată online.
Pentru conferință găsim și vă arătăm cazuri despre capacitățile maxime ale tehnologiilor: HighLoad++ a fost, este și va fi singurul loc unde poți afla în două zile cum sunt structurate Facebook, Yandex, VKontakte, Google și Amazon.
Organizând întâlnirile noastre fără întrerupere din 2007, anul acesta ne vom întâlni pentru a 14-a oară. În această perioadă, conferința a crescut de 10 ori; anul trecut, evenimentul cheie al industriei a reunit 3339 de participanți, 165 de vorbitori și 16 sesiuni simultane.
Anul trecut, am avut 20 de autobuze, 5280 de litri de ceai și cafea, 1650 de litri de băuturi răcoritoare și 10200 de sticle de apă. De asemenea, 2640 de kilograme de mâncare, 16.000 de farfurii și 25.000 de pahare. Apropo, cu banii obținuți din hârtia reciclată, am plantat 100 de puieți de stejar 🙂Biletele pot fi cumpărate , pentru a primi noutăți despre conferință — , iar pentru discuții — pe toate rețelele sociale: , , și .
Sursa: habr.com
