

Astăzi vom vorbi despre cum să stocăm mai bine datele într-o lume în care rețelele de generație a cincea, scanerele genomurilor și mașinile autonome generează într-o zi mai multe date decât întreaga umanitate a creat în perioada anterioară revoluției industriale.
Lumea noastră generează din ce în ce mai multe informații. O parte din acestea sunt efemere și se pierd la fel de repede cum sunt colectate. Alte informații trebuie să fie stocate pe termen mai lung, iar unele sunt destinate să dureze „în veci” — cel puțin așa ni se pare din perspectiva actuală. Fluxurile de informații se acumulează în centrele de date cu o viteză atât de mare încât orice nouă abordare, orice tehnologie destinată să satisfacă această cerere nesfârșită, se învechește rapid.
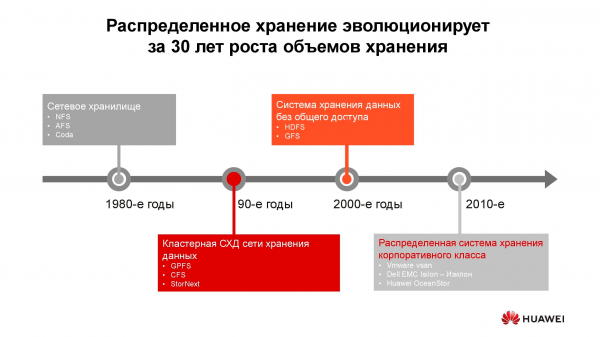
40 de ani de dezvoltare a sistemelor de stocare distribuite
Primele stocări de rețea în forma în care le cunoaștem au apărut în anii 1980. Mulți dintre voi ați avut de-a face cu NFS (Network File System), AFS (Andrew File System) sau Coda. După un deceniu, moda și tehnologiile s-au schimbat, iar sistemele de fișiere distribuite au cedat locul sistemelor de stocare pe clustere bazate pe GPFS (General Parallel File System), CFS (Clustered File Systems) și StorNext. Ca bază au fost utilizate stocările bloc din arhitectura clasică, peste care, cu ajutorul unui strat software, a fost creat un sistem unitar de fișiere. Aceste soluții și similare sunt încă utilizate, ocupându-și nișa și fiind foarte căutate.
La începutul mileniului, paradigma sistemelor de stocare distribuite s-a schimbat ușor, iar sistemele cu arhitectură SN (Shared-Nothing) au ajuns în poziții de frunte. S-a realizat o tranziție de la stocarea pe clustere la stocarea pe noduri separate, care, de regulă, erau servere clasice cu software care asigură stocarea de încredere; pe astfel de principii sunt construite, de exemplu, HDFS (Hadoop Distributed File System) și GFS (Global File System).
Aproape de anii 2010, conceptele fundamentale ale sistemelor distribuite de stocare au început din ce în ce mai des să fie reflectate în produse comerciale complete, precum VMware vSAN, Dell EMC Isilon și al nostru . În spatele acestor platforme nu mai stă o comunitate de entuziaști, ci furnizori specifici, care sunt responsabili pentru funcționalitate, suport, întreținerea produsului și garantează dezvoltarea sa ulterioară. Aceste soluții sunt cele mai solicitate în mai multe domenii.
Operatori de telecomunicații
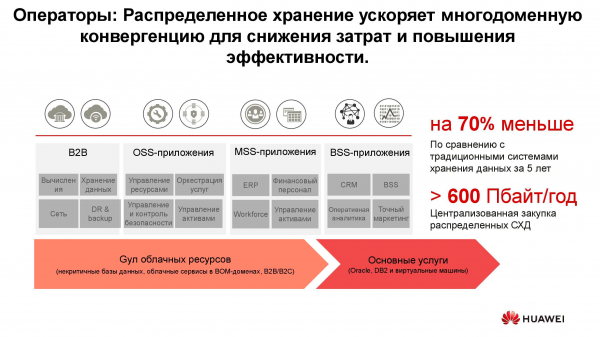
Probabil că printre cei mai vechi utilizatori ai sistemelor de stocare distribuite se numără operatorii de telecomunicații. În schema de mai sus, se poate observa ce grupuri de aplicații generează principalul volum de date. OSS (Sisteme de Suport Operațional), MSS (Servicii de Suport al Managementului) și BSS (Sisteme de Suport pentru Afaceri) reprezintă cele trei straturi software care se completează reciproc, necesare pentru furnizarea serviciilor abonaților, raportarea financiară către furnizor și suportul operațional pentru inginerii operatorului.
Adesea, datele din aceste straturi sunt foarte amestecate între ele, iar pentru a evita acumularea de copii inutile, se folosesc sisteme de stocare distribuite, care acumulează întregul volum de informații provenite de la rețeaua activă. Stocările sunt unite într-un pool comun, la care au acces toate serviciile.
Calculul nostru arată că trecerea de la sistemele de stocare clasice la cele pe blocuri permite economii de până la 70% din buget doar prin eliminarea sistemelor de stocare dedicate de tip hi-end și utilizarea serverelor obișnuite cu arhitectură clasică (de obicei x86), care funcționează împreună cu software specializat. Operatorii de telefonie mobilă au început să achiziționeze astfel de soluții în volume considerabile de mai bine de șase ani. În special, operatorii ruși folosesc aceste produse de la Huawei de mai bine de șase ani.
Da, anumite sarcini nu pot fi realizate prin intermediul sistemelor distribuite. De exemplu, în condiții de cerințe ridicate pentru performanță sau compatibilitate cu protocoalele mai vechi. Dar nu mai puțin de 70% din datele pe care le prelucrează operatorul pot fi stocate în pool-ul distribuit.
Sectorul bancar
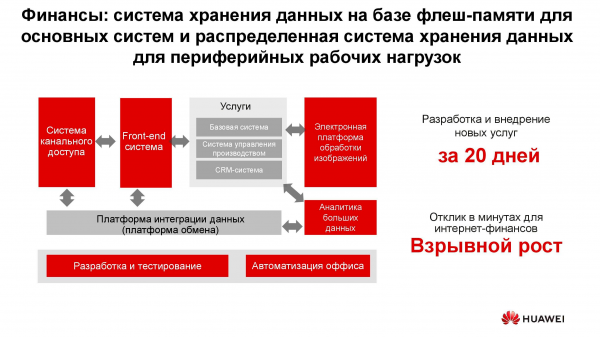
În orice bancă coexistă numeroase sisteme IT diverse, de la procesare până la sistemul bancar automatizat. Această infrastructură lucrează și cu un volum enorm de informații, iar o mare parte din sarcini nu necesită performanțe ridicate și fiabilitate a sistemelor de stocare, cum ar fi dezvoltarea, testarea, automatizarea proceselor de birou etc. Aici utilizarea sistemelor de stocare clasice este posibilă, dar devine cu fiecare an din ce în ce mai puțin rentabilă. Mai mult, în acest caz lipsește flexibilitatea utilizării resurselor, a căror performanță este calculată pe baza încărcăturii de vârf.
În utilizarea sistemelor distribuite de stocare, nodurile lor, care sunt de fapt servere obișnuite, pot fi convertite în orice moment, de exemplu, într-o fermă de servere și utilizate ca o platformă de calcul.
Lacuri de date
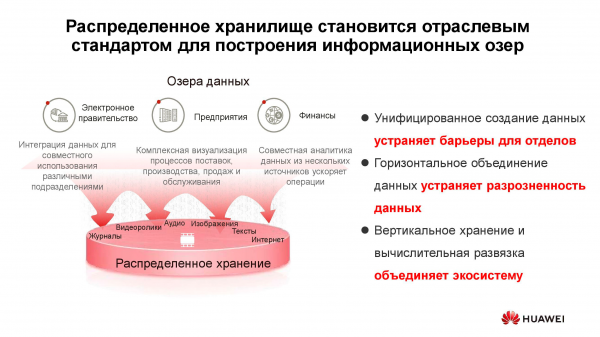
În diagrama de mai sus este listat un set tipic de consumatori ai serviciilor . Acestea pot fi servicii de guvernare electronică (de exemplu, „Service public”) care au trecut prin digitalizarea întreprinderilor, structuri financiare și altele. Toate acestea trebuie să lucreze cu volume mari de informații diverse.
Exploatarea sistemelor de stocare tradiționale pentru astfel de sarcini nu este eficientă, deoarece este necesar atât accesul de înaltă performanță la bazele de date bloc, cât și accesul obișnuit la bibliotecile documentelor scanate, păstrate sub formă de obiecte. Aici ar putea fi legată, de exemplu, o sistemă de comenzi prin portal web. Pentru a realiza toate acestea pe o platformă de stocare tradițională, ar fi nevoie de un mare complex de echipamente pentru diferite sarcini. O singură sistemă de stocare universală orizontală poate acoperi toate sarcinile enumerate anterior: va fi necesar doar să se creeze în ea mai multe pool-uri cu diferite caracteristici de stocare.
Generatoarele de informații noi
Cantitatea de informație stocată în lume crește cu aproximativ 30% pe an. Acestea sunt vești bune pentru furnizorii de sisteme de stocare, dar care este și va fi sursa principală a acestor date?
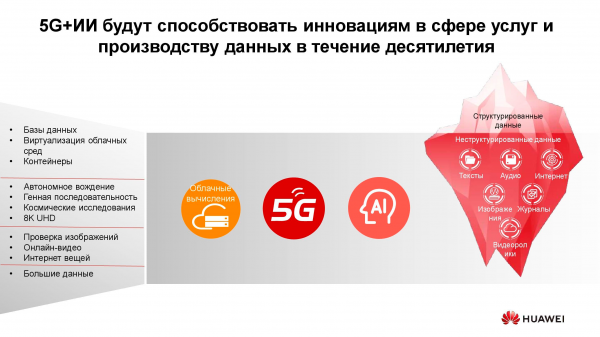
Acum zece ani, astfel de generatoare au devenit rețelele sociale, ceea ce a necesitat crearea unui număr mare de algoritmi noi, soluții hardware etc. Acum se evidențiază trei principalii factori de creștere a volumului de stocare. Primul — cloud computing. În prezent, aproximativ 70% din companii folosesc într-un fel sau altul servicii cloud. Acestea pot fi sisteme de poștă electronică, copiile de rezervă și alte entități virtualizate.
Al doilea motor devine rețelele de generație a cincea. Acestea reprezintă viteze noi și volume noi de transfer de date. Conform prognozelor noastre, răspândirea pe scară largă a 5G va duce la o scădere a cererii pentru cardurile de memorie flash. Indiferent de câtă memorie este pe telefon, aceasta se va termina oricum, iar având un canal de 100 megabiți în dispozitiv, nu există nicio necesitate de a stoca fotografiile local.
Printre cele trei grupuri de motive pentru care cererea de sisteme de stocare crește se numără dezvoltarea rapidă a inteligenței artificiale, tranziția către analiza big data și tendința de automatizare a tot ce se poate.
O caracteristică a „traficului nou” este . Trebuie să stocăm aceste date fără a defini formatul lor. Acesta este necesar doar la citirea ulterioară. De exemplu, un sistem bancar de scoring pentru a determina suma de credit disponibilă va analiza fotografiile pe care le-ați postat pe rețele sociale, stabilind cât de des mergeți la mare și în restaurante, în timp ce studiază, de asemenea, extrasele disponibile din documentele dumneavoastră medicale. Aceste date sunt, pe de o parte, cuprinzătoare, iar pe de altă parte, lipsite de omogenitate.
Oceanul de date nestructurate
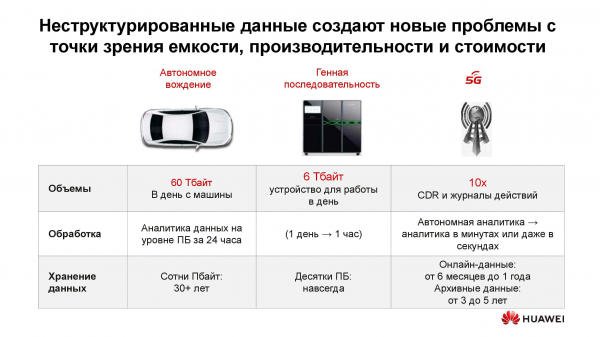
Ce probleme aduce apariția „datelor noi”? Prima și cea mai importantă este volumul de informații și termenii estimați pentru stocarea acestora. Un singur automobil autonom modern fără șofer generează zilnic până la 60 TB de date, provenind din toate senzorii și mecanismele sale. Pentru a dezvolta noi algoritmi de deplasare, aceste informații trebuie procesate în aceeași zi, altfel vor începe să se acumuleze. În plus, trebuie stocate foarte mult timp — zeci de ani. Numai atunci se vor putea trasa concluzii pe baza unor eșantioane analitice mari în viitor.
Un dispozitiv destinat decriptării secvențelor genetice produce aproximativ 6 TB pe zi. Iar datele colectate cu ajutorul său nu presupun deloc ștergerea, adică ar trebui teoretic să fie stocate pentru totdeauna.
În sfârșit, toate aceste rețele de generație a cincea. Pe lângă informațiile transmise, o astfel de rețea este în sine un imens generator de date: jurnale de acțiuni, înregistrări ale apelurilor, rezultate intermediare ale interacțiunilor între mașini etc.
Toate acestea necesită dezvoltarea unor noi abordări și algoritmi pentru stocarea și procesarea informațiilor. Și astfel de abordări apar.
Tehnologiile unei epoci noi
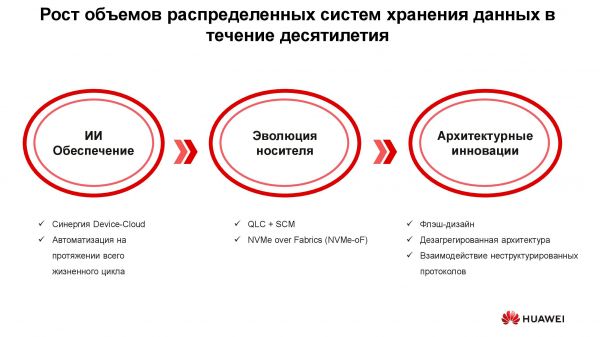
Se pot evidenția trei grupuri de soluții destinate să facă față noilor cerințe pentru sistemele de stocare a informației: implementarea inteligenței artificiale, evoluția tehnică a suporturilor de date și inovațiile în arhitectura sistemelor. Să începem cu IA.
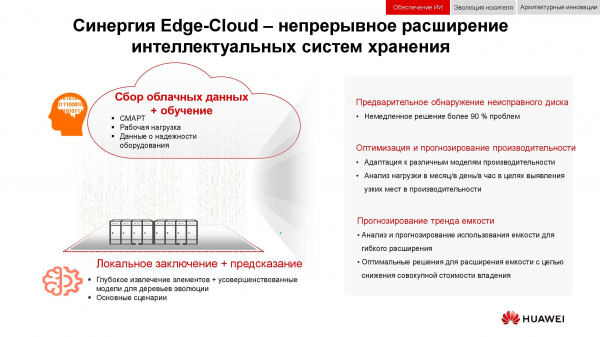
În noile soluții Huawei, inteligența artificială este folosită deja la nivelul stocării, echipată cu un procesor AI care permite sistemului să își analizeze starea și să prezică defecțiuni. Dacă unitatea de stocare este conectată la un serviciu de cloud care dispune de capacități de calcul semnificative, inteligența artificială va putea procesa mai multe informații și va spori precizia ipotezelor sale.
Pe lângă defecțiuni, această inteligență artificială poate prognoza viitoarea sarcină de vârf și timpul rămas până la epuizarea capacității. Aceasta permite optimizarea performanței și scalarea sistemului înainte de apariția unor evenimente nedorite.
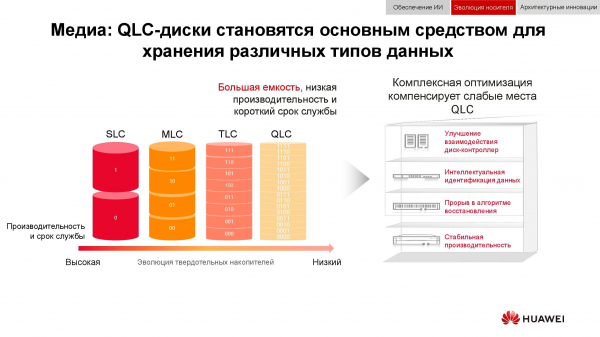
Acum, să discutăm despre evoluția suporturilor de date. Primele unități flash au fost realizate pe baza tehnologiei SLC (Single-Level Cell). Dispozitivele bazate pe această tehnologie erau rapide, fiabile, stabile, dar aveau o capacitate mică și costau foarte mult. Creșterea volumului și scăderea prețului au fost obținute prin anumite compromisuri tehnice, care au redus viteza, fiabilitatea și durata de viață a unităților. Totuși, tendința nu a afectat unitățile de stocare, care, datorită unor ingeniozități arhitecturale, au devenit în general mai performante și mai fiabile.
Dar de ce au fost necesare unitățile de stocare de tip All-Flash? Nu era suficient să înlocuim vechile HDD-uri din sistemul deja operativ cu noi SSD-uri de același factor de formă? A fost necesar pentru a utiliza eficient toate resursele noilor memorii flash, ceea ce în sistemele vechi era pur și simplu imposibil.
Compania Huawei, de exemplu, pentru a rezolva această problemă, a dezvoltat o serie de tehnologii, dintre care una este , care a permis optimizarea maximă a interacțiunii "disk - controller".
Identificarea inteligentă a permis disocierea datelor pe mai multe fluxuri și rezolvarea unor fenomene nedorite, cum ar fi (write amplification). În plus, noile algoritme de recuperare, în special , au crescut viteza de rebuild, reducând timpul său la valori total neglijabile.
Defecțiunea, supraaglomerarea, „colectarea de deșeuri” - acești factori nu mai influențează performanța sistemului de stocare datorită unei perfecționări speciale a controlerelor.
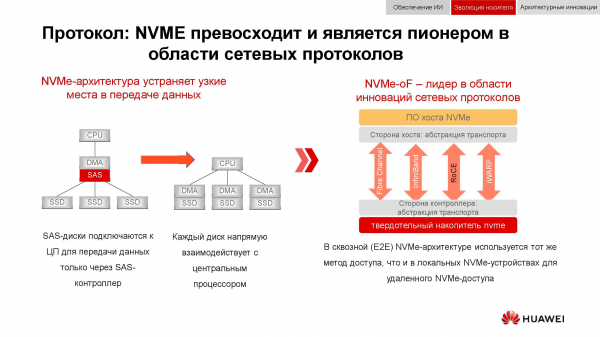
De asemenea, stocările de date bloc sunt pregătite să întâmpine . Să reamintim că schema clasică de organizare a accesului la date a funcționat astfel: procesorul se adresa controlerului RAID prin magistrala PCI Express. Acesta, la rândul său, interacționa cu discurile mecanice prin SCSI sau SAS. Folosirea NVMe pe backend a accelerat semnificativ întregul proces, însă a avut un dezavantaj: stocatoarele trebuiau să aibă o conexiune directă la procesor pentru a-i asigura acces direct la memorie.
Următoarea fază de dezvoltare a tehnologiei, pe care o observăm acum, a fost aplicarea NVMe-oF (NVMe over Fabrics). În ceea ce privește tehnologiile de bloc Huawei, acestea deja suportă FC-NVMe (NVMe over Fibre Channel), iar NVMe over RoCE (RDMA over Converged Ethernet) este pe cale să apară. Modelele de testare sunt complet funcționale, iar până la prezentarea lor oficială mai sunt câteva luni. Observăm că tot acest lucru va apărea și în sistemele distribuite, unde „Ethernet fără pierderi” va fi foarte solicitat.
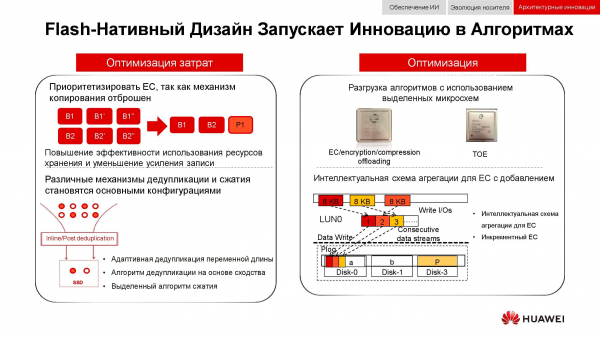
O altă modalitate de optimizare a funcționării stocărilor distribuite a fost abandonarea completă a mirror-ingului datelor. Soluțiile Huawei nu mai folosesc n copii, așa cum se întâmpla în RAID 1, și trec complet la mecanismul (Erasure coding). Un pachet matematic special calculează periodic blocuri de control, care permit restaurarea datelor intermediare în caz de pierdere.
Mecanismele de deduplicare și compresie devin obligatorii. Dacă în stocările tradiționale suntem limitați de numărul procesorului instalate în controlere, în sistemele de stocare distribuite, scalabile orizontal, fiecare nod conține tot ce este necesar: discuri, memorie, procesoare și interconectare. Aceste resurse sunt suficiente pentru a asigura că deduplicarea și compresia au un impact minim asupra performanței.
Și despre metodele hardware de optimizare. Aici, sarcina centralelor de procesare a fost redusă prin adăugarea de cipuri dedicate (sau blocuri dedicate în cadrul procesorului), care joacă rolul de (TCP/IP Offload Engine) sau preiau sarcinile matematice de EC, deduplicare și compresie.
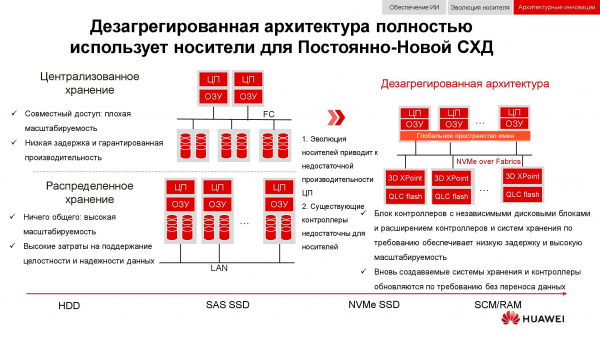
Noile abordări în stocarea datelor s-au concretizat în arhitectura dezagregată (distribuită). În sistemele de stocare centralizată există o fabrică de servere, conectată prin Fibre Channel la un număr mare de array-uri. Dezavantajele acestei abordări sunt dificultățile de scalare și asigurarea unui nivel garantat de serviciu (în ceea ce privește performanța sau latențele). Sistemele hiperconvergente folosesc aceleași gazde atât pentru stocare, cât și pentru procesarea informațiilor. Acest lucru oferă practic un spațiu nelimitat pentru scalare, dar implică costuri ridicate pentru menținerea integrității datelor.
Spre deosebire de ambele arhitecturi menționate anterior, arhitectura dezagregată implică separarea sistemului într-o fabrică de calcul și un sistem de stocare orizontal. Aceasta oferă avantajele ambelor arhitecturi și permite scalarea practic nelimitată doar a acelui element al cărui nivel de performanță este insuficient.
De la integrare la convergență
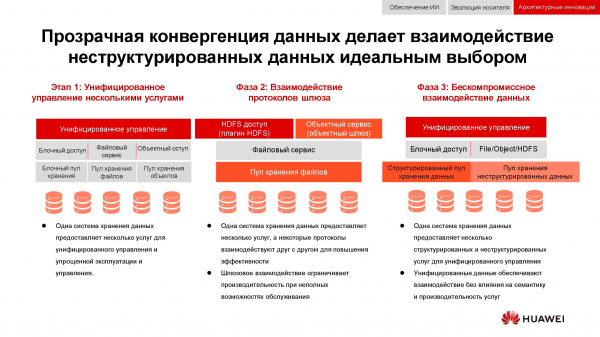
O problemă clasică, a cărei relevanță a crescut în ultimii 15 ani, este necesitatea de a asigura simultan stocare bloc, acces la fișiere, acces la obiecte, lucru pentru fermele de mari date etc. Un alt aspect poate fi, de exemplu, un sistem de backup pe bandă magnetică.
În prima etapă, a fost posibilă unificarea doar a gestionării acestor servicii. Sistemele heterogene de stocare a datelor erau legate la un software specializat prin care administratorul distribua resurse din pool-urile disponibile. Dar, deoarece aceste pool-uri erau diferite din punct de vedere hardware, migrarea sarcinii între ele era imposibilă. La un nivel mai înalt de integrare, unificarea se realiza la nivel de gateway. În prezența unui acces comun la fișiere, acesta putea fi furnizat prin diferite protocoale.
Cea mai avansată metodă de convergență disponibilă acum ne implică crearea unui sistem hibrid universal. Exact astfel cum ar trebui să devină sistemul nostru . Accesul universal folosește aceleași resurse hardware, împărțite logic în piscine diferite, dar permite migrarea încărcăturii. Toate acestea pot fi realizate printr-o consolă de management unificată. Astfel, am reușit să implementăm conceptul „un singur datacenter — un singur sistem de stocare”.
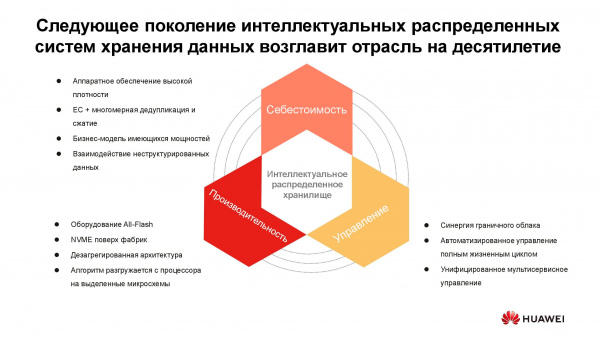
Costul stocării informațiilor determină acum multe decizii arhitecturale. Și, deși aceasta poate fi considerată fundamentală, astăzi discutăm despre stocarea „live” cu acces activ, așa că performanța trebuie de asemenea să fie luată în considerare. O altă caracteristică importantă a sistemelor distribuite de nouă generație este unificarea. Nimeni nu dorește să aibă mai multe sisteme disparate, gestionate din console diferite. Toate aceste calități s-au concretizat în noua serie de produse Huawei. .
Sistem de stocare de date masiv de nouă generație
OceanStor Pacific îndeplinește cerințele de fiabilitate la nivelul „șase nouri” (99,9999%) și poate fi utilizat pentru construirea de datacentere de clasă HyperMetro. La o distanță de până la 100 km între cele două datacentere, sistemele demonstrează o întârziere suplimentară de 2 ms, ceea ce permite construirea de soluții rezistente la catastrofe, inclusiv cu servere de quorum.
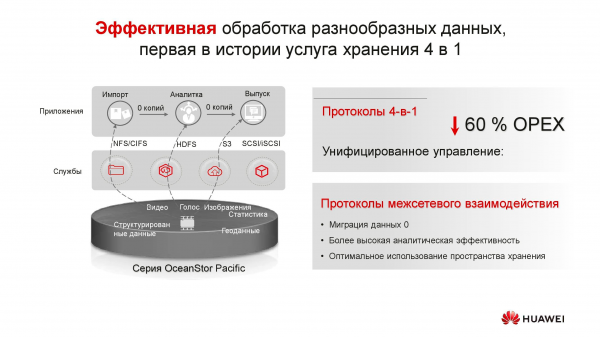
Produsele din noua serie demonstrează versatilitate în materie de protocoale. OceanStor 100D suportă deja accesul de tip bloc, accesul obiect și accesul Hadoop. În curând va fi implementat și accesul de tip fișier. Nu este necesar să păstrați mai multe copii ale datelor dacă acestea pot fi livrate prin protocoale diferite.
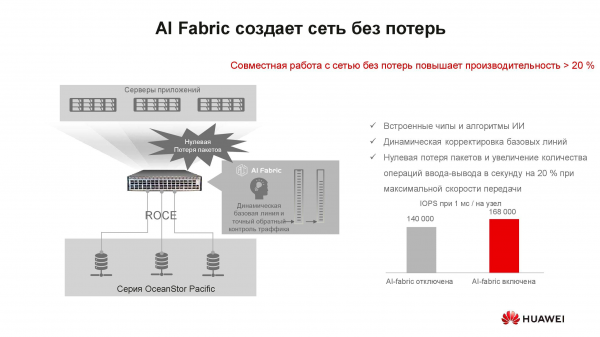
Care este legătura între conceptul de „rețea fără pierderi” și sistemele de stocare? Problema este că sistemele de stocare distribuite sunt construite pe o rețea rapidă, care suportă algoritmi corespunzători și mecanismul RoCE. În plus, sistemele de inteligență artificială susținute de comutatoarele noastre cresc viteza rețelei și reduc întârzierile. . Câștigul de performanță al sistemului de stocare activând AI Fabric poate atinge 20%.
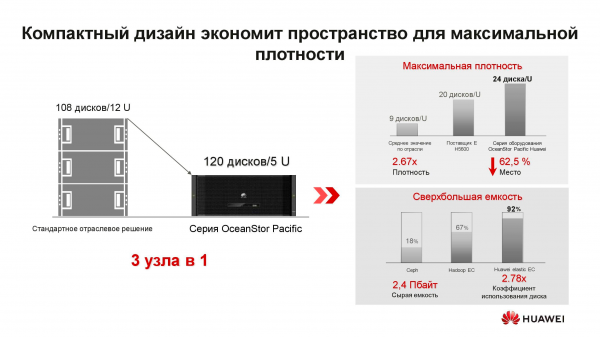
Ce reprezintă noul nod de sistem de stocare distribuit OceanStor Pacific? Această soluție de formă 5U include 120 de unități de stocare și poate înlocui trei noduri clasice, ceea ce oferă o economisire de spațiu în rack de peste două ori. Prin eliminarea păstrării copiilor, eficiența unităților de stocare crește semnificativ (până la +92%).
Ne-am obișnuit ca stocarea definită prin software să fie un software special, instalat pe un server clasic. Dar acum, pentru a obține parametrii optimi, această soluție arhitecturală necesită și noduri speciale. Ea include două servere bazate pe procesoare ARM care gestionează un array de unități de stocare de 3 inchi.
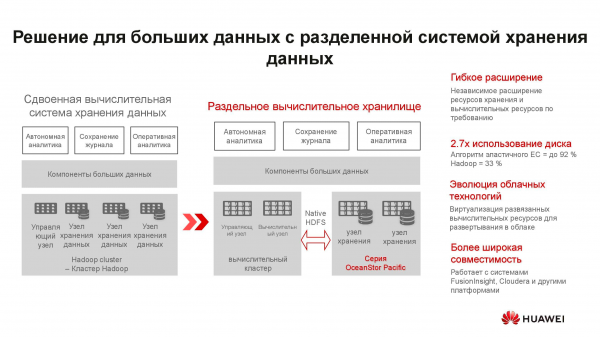
Aceste servere sunt puțin potrivite pentru soluții hiperconvergente. În primul rând, aplicațiile pentru ARM sunt destul de puține, iar în al doilea rând, este greu să se mențină un echilibru al încărcării. Noi vă propunem să treceți la stocarea separată: un cluster de calcul, reprezentat de servere clasice sau servere rack, funcționează separat, dar se conectează la nodurile de stocare OceanStor Pacific, care își îndeplinesc, de asemenea, sarcinile directe. Și aceasta se justifică.
De exemplu, să luăm o soluție clasică pentru stocarea datelor mari cu un sistem hiperconvergente, care ocupă 15 rack-uri de servere. Dacă distribuim încărcătura între serverele de calcul separate și nodurile OceanStor Pacific, separându-le una de cealaltă, numărul rack-urilor necesare se va reduce la jumătate! Acest lucru reduce costurile de operare a centrului de date și scade costul total de proprietate. Într-o lume în care volumul de informații stocate crește cu 30% în fiecare an, astfel de avantaje nu sunt de neglijat.
***
Mai multe informații despre soluțiile Huawei și scenariile lor de aplicare puteți obține pe site-ul nostru sau contactând direct reprezentanții companiei.
Sursa: habr.com
