

Prezentarea este dedicată întrebărilor practice legate de dezvoltarea operatorului în Kubernetes, proiectarea arhitecturii acestuia și principiile de funcționare.
În prima parte a prezentării vom analiza:
- ce este un operator în Kubernetes și de ce este necesar;
- cum simplifică operatorul gestionarea sistemelor complexe;
- ce poate face un operator și ce nu poate face.
Apoi, vom trece la discutarea structurii interne a operatorului. Vom examina arhitectura și funcționarea operatorului pas cu pas. Vom analiza în detaliu:
- interacțiunea dintre operator și Kubernetes;
- ce funcții își asumă operatorul și ce delegă în Kubernetes.
Vom examina gestionarea shard-urilor și replicilor Bază de Date în Kubernetes.
Apoi, vom discuta despre întrebările legate de stocarea datelor:
- cum să lucrăm cu Persistent Storage din perspectiva operatorului;
- capcanele utilizării Local Storage.
În partea finală a prezentării, vom analiza exemple practice de utilizare cu Amazon sau Google Cloud Service. Prezentarea se bazează pe exemple de dezvoltare și experiențe de exploatare a operatorului pentru ClickHouse.
Video:
Numele meu este Vladislav Klimenko. Astăzi aș dori să vă vorbesc despre experiența noastră în dezvoltarea și exploatarea operatorului, care este un operator specializat pentru gestionarea cluster-urilor de baze de date. Pe exemplul pentru gestionarea cluster-ului ClickHouse.
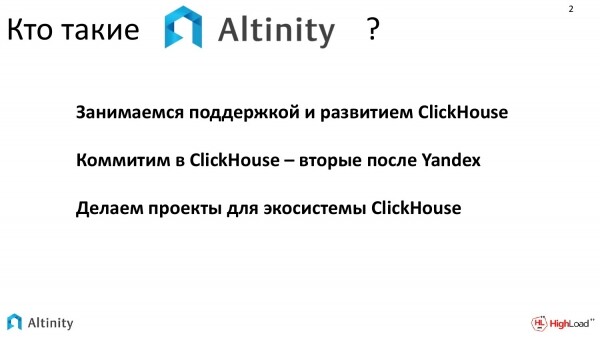
De ce avem posibilitatea să vorbim despre operator și ClickHouse?
- Ne ocupăm cu suportul și dezvoltarea ClickHouse.
- În prezent, ne străduim să contribuim treptat la dezvoltarea ClickHouse. Suntem pe locul doi după Yandex în ceea ce privește volumul de modificări efectuate în ClickHouse.
- Încercăm să realizăm proiecte suplimentare pentru ecosistemul ClickHouse.
Despre unul dintre aceste proiecte aș dori să vă vorbesc. Este vorba despre ClickHouse-operator pentru Kubernetes.
În prezentarea mea, aș dori să abordez două subiecte:
- Primul subiect – cum funcționează operatorul nostru de gestionare a bazelor de date ClickHouse în Kubernetes.
- Al doilea subiect – cum funcționează orice operator, adică cum interacționează cu Kubernetes.
Aceste două întrebări se vor intersecta pe parcursul întregii mele prezentări.
Cui i-ar putea fi interesant să asculte ceea ce încerc să explic?
- Va fi cel mai interesant pentru cei care exploatează operatori.
- Sau pentru cei care doresc să creeze propriul lor, pentru a înțelege cum funcționează din interior, cum interacționează operatorul cu Kubernetes și ce capcane pot apărea.
Pentru a înțelege mai bine ceea ce vom discuta astăzi, ar fi bine să știm cum funcționează Kubernetes și să avem o pregătire de bază în tehnologiile cloud.
Ce este ClickHouse? Este o bază de date columnară specializată în procesarea analitică online a interogărilor. Și este complet open source.
Și trebuie să știm doar două lucruri. Trebuie să știm că este o bază de date, prin urmare, ceea ce voi explica va fi aplicabil practic oricărei baze de date. Și că SGBD-ul ClickHouse se scalabilizează foarte bine, oferind practic scalabilitate liniară. Din acest motiv, starea clusterului este o stare naturală pentru ClickHouse. Și cel mai interesant este să discutăm despre cum se administrează clusterul ClickHouse în Kubernetes.
De ce este necesar acolo? De ce nu putem continua să-l exploatăm singuri? Răspunsurile sunt parțial tehnice, parțial organizaționale.
- În practică, ne întâlnim tot mai des cu situația în care, în companii mari, practic toate componentele sunt deja în Kubernetes. Singurele rămase sunt bazele de date.
- Și se pune tot mai des întrebarea: „Se poate integra acest lucru?” De aceea, companiile mari încearcă să realizeze o maximă uniformizare a managementului, pentru a putea gestiona rapid stocurile de date.
- Și acest lucru ajută în special atunci când este necesară maximă repetabilitate într-un alt loc, adică o portabilitate maximă.
Cât de simplu sau complicat este acest lucru? Desigur că se poate face manual. Dar nu este atât de simplu, deoarece se adaugă complexitatea gestionării Kubernetes, dar și specificitatea ClickHouse. Și rezultatul este o agregare.
Și toate acestea împreună creează un set destul de mare de tehnologii, al căror management devine destul de complicat, deoarece Kubernetes aduce propriile întrebări zilnice de exploatare iar ClickHouse aduce întrebările proprii pentru exploatarea zilnică. În special, dacă avem mai multe instanțe ClickHouse și trebuie să facem constant ceva cu ele.
ClickHouse, în cazul unei configurații dinamice, are un număr destul de mare de întrebări care generează o sarcină constantă pe DevOps:
- Când dorim să schimbăm ceva în ClickHouse, de exemplu, să adăugăm o replică sau un shard, trebuie să gestionăm configurația.
- Apoi, trebuie să schimbăm schema de date, deoarece ClickHouse are un mod specific de shardare. Trebuie să desfășurăm schema de date și să desfășurăm configurațiile.
- Trebuie să configurăm monitorizarea.
- Colectarea jurnalelor pentru noile sharde, pentru noile replici.
- Trebuie să ne ocupăm de recuperare.
- Și de repornire.
Acestea sunt lucrări de rutină pe care ne-ar plăcea să le simplificăm în exploatare.
Kubernetes se descurcă bine în exploatare, dar la lucruri sistemice de bază.
Kubernetes simplifică bine și automatizează astfel de lucruri, cum ar fi:
- Recuperarea.
- Repornirea.
- Gestionarea sistemului de stocare.
Este un lucru bun, este o direcție corectă, dar nu are o imagine completă despre cum să exploateze un cluster de baze de date.
Ne dorim mai mult, dorim ca întreaga noastră bază de date să funcționeze în Kubernetes.
Ne dorim să avem ceva de genul unei mari butoane magice roșii, pe care să o apesi și să se desfășoare și să se mențină pe parcursul întregului ciclu de viață un cluster cu sarcini zilnice care trebuie rezolvate. Clusterul ClickHouse în Kubernetes.
Și am încercat să realizăm o soluție care să ajute la simplificarea muncii. Acesta este ClickHouse-operator pentru Kubernetes de la Altinity.
Un operator este un program, a cărui sarcină principală este de a gestiona alte programe, adică este un manager.
Și conține șabloane de comportament. Poate fi numit cunoștințe codificate despre domeniul de expertiză.
Sarcina sa principală este să faciliteze viața DevOps și să reducă micro-managementul, astfel încât el (DevOps) să gândească în termeni de nivel înalt, adică să nu se ocupe de micro-management, să nu configureze toate detaliile manual.
Și exact operatorul este un robot asistent care se ocupă de micro-sarcini și ajută DevOps.
De ce este necesar un operator? Se dovedește a fi foarte eficient în două aspecte:
- Când specialistul care se ocupă de ClickHouse nu are suficientă experiență, dar trebuie să exploateze ClickHouse, operatorul facilitează exploatarea și permite gestionarea unui cluster ClickHouse cu o configurație destul de complexă, fără a intra prea mult în detalii despre cum funcționează toate acestea în interior. Pur și simplu îi dai sarcini de nivel înalt și funcționează.
- Și a doua sarcină în care se manifestă cel mai bine este atunci când trebuie automatizate un număr mare de sarcini standard. Îndepărtează micro-sarcinile de la administratorii de sistem.
Acest lucru este necesar cel mai mult fie pentru cei care abia își încep drumul, fie pentru cei care trebuie să se ocupe mult de automatizare.
Care este diferența dintre abordarea bazată pe operatori și alte sisteme? Există Helm. De asemenea, ajută la instalarea ClickHouse, se pot crea grafice helm care vor instala chiar și un întreg cluster ClickHouse. Care este, așadar, diferența între operator și, de exemplu, Helm?
Diferența fundamentală principală este că Helm este un manager de pachete, în timp ce operatorul merge mai departe. Acesta însoțește întregul ciclu de viață. Nu este vorba doar de instalare, ci de sarcini zilnice care includ scalarea, fragmentarea, adică tot ce trebuie efectuat în timpul ciclului de viață (dacă este necesar, chiar și eliminarea) – toate acestea sunt gestionate de operator. Acesta încearcă să automatizeze și să întrețină întregul ciclu de viață al software-ului. În aceasta constă diferența sa fundamentală față de alte soluții disponibile.
Aceasta a fost partea introductivă, să mergem mai departe.
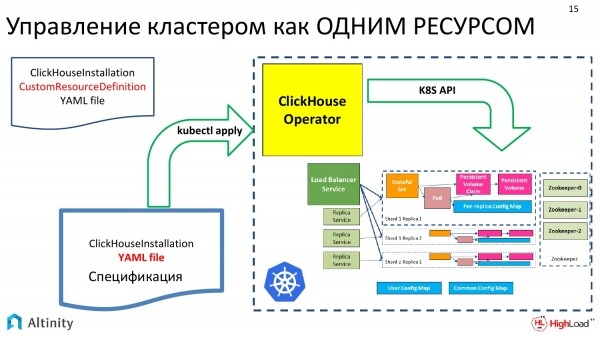
Cum construim operatorul nostru? Încercăm să abordăm problema pentru a gestiona clusterul ClickHouse ca pe o resursă unică.
Iată, în partea stângă a imaginii, avem datele de intrare. Acesta este YAML cu specificația clusterului, care este transmis în mod clasic prin kubectl în Kubernetes. Aici, operatorul nostru preia, face magia sa. Și la ieșire obținem un astfel de diagramă. Aceasta este implementarea ClickHouse în Kubernetes.
Și apoi vom examina treptat cum funcționează operatorul, ce sarcini standard pot fi rezolvate. Vom analiza doar sarcini standard, deoarece avem timp limitat. Și nu va fi discutat despre toate problemele pe care le poate rezolva operatorul.
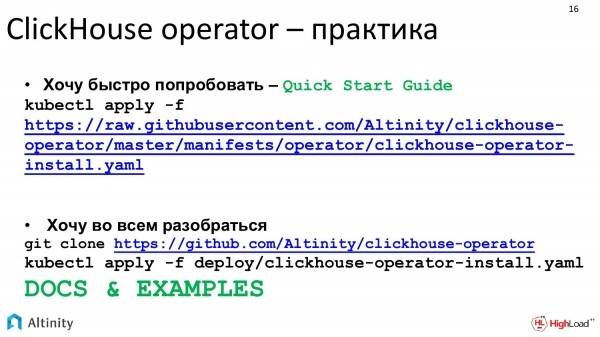
Să ne bazăm pe experiență. Proiectul nostru este complet open source, așa că puteți vedea pe GitHub cum funcționează. Și putem pleca de la premisa că, dacă doriți doar să începeți, cu Ghidul Rapid de Început se poate începe.
Dacă doriți să înțelegeți detaliat, ne străduim să menținem documentația într-o formă cât mai acceptabilă.
Să începem cu o sarcină practică. Prima sarcină, cu ce toți vrem să începem, este să lansăm primul exemplu în orice mod. Cum putem să pornim ClickHouse utilizând operatorul, chiar fără a cunoaște prea bine cum funcționează? Redactăm un manifest, deoarece toată interacțiunea cu k8s se face prin manifeste.
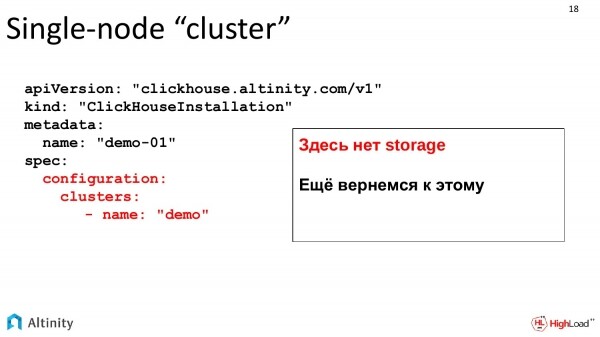
Iată un manifest destul de complex. Ceea ce este evidențiat cu roșu este ceea ce trebuie să accentuăm. Cerem operatorului să creeze un cluster numit demo.
Până acum, acestea sunt exemple de bază. Storage-ul nu este încă descris, dar ne vom întoarce la storage puțin mai târziu. Deocamdată, vom observa în dinamică dezvoltarea cluster-ului.
Am creat acest manifest. Îl oferim operatorului nostru. El a lucrat, a făcut magie.
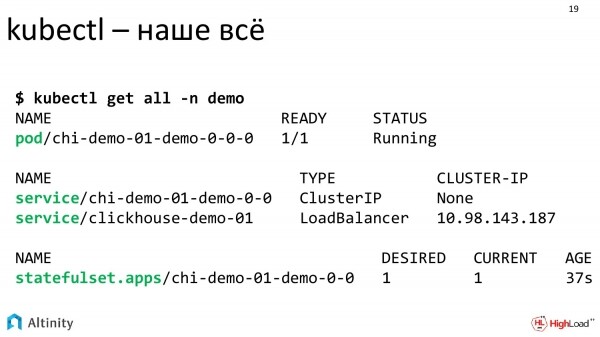
Ne uităm în consolă. Trei componente ne atrag atenția – este vorba de Pod, două servicii și StatefulSet.
Operatorul a procesat cererea, iar noi putem vedea ce anume a creat.
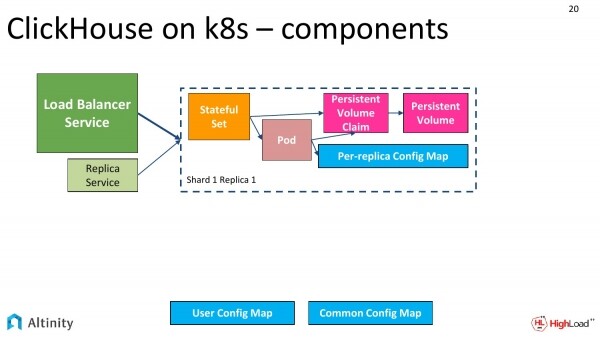
El creează aproximativ o schemă ca aceasta. Avem StatefulSet, Pod, ConfigMap pentru fiecare replică și ConfigMap pentru întregul cluster. Serviciile sunt esențiale ca puncte de acces în cluster.
Serviciile sunt un Load Balancer Service central și, de asemenea, putem avea câte unul pentru fiecare replică, pentru fiecare shard.
Așa arată un cluster de bază. Este format dintr-o singură nod.
Să mergem mai departe, vom complica lucrurile. Trebuie să shard-ăm cluster-ul.
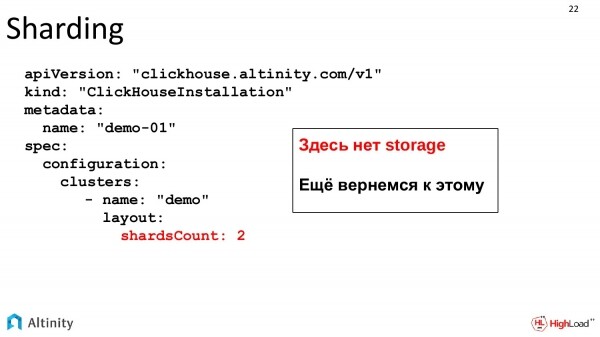
Sarcinile noastre cresc, începe dinamica. Vrem să adăugăm un shard. Urmărim dezvoltarea. Modificăm specificația noastră. Menționăm că vrem două shards.
Este același fișier, care se dezvoltă dinamic pe măsură ce sistemul crește. Storage-ul nu este inclus, va fi discutat mai departe, este un subiect separat.
Oferim operatorului YAML și vedem ce rezultat obținem.
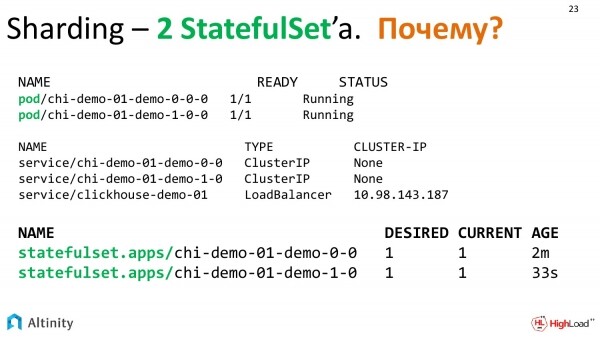
Operatorul a analizat și a creat următoarele entități. Avem deja două Pod-uri, trei servicii și, dintr-o dată, două StatefulSets. De ce două StatefulSets?
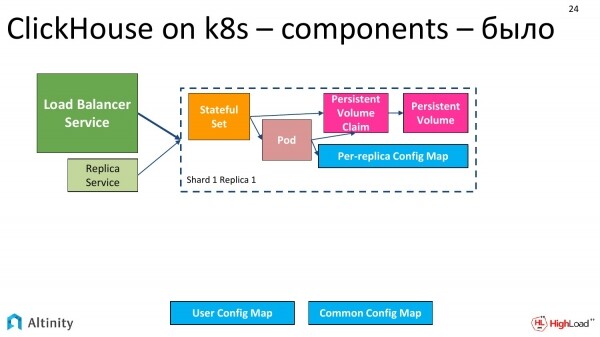
În schemă era în felul următor – acesta este starea inițială, când aveam un singur pod.
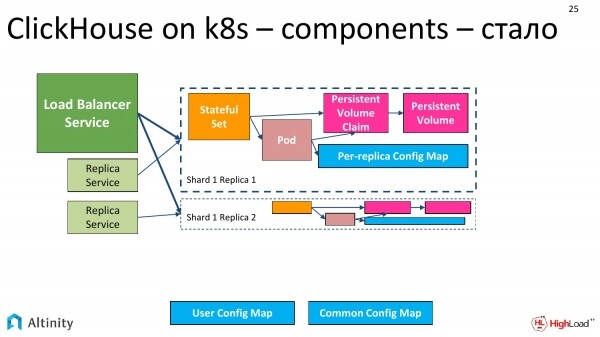
A devenit așa. Deocamdată, totul este simplu, s-a duplicat.
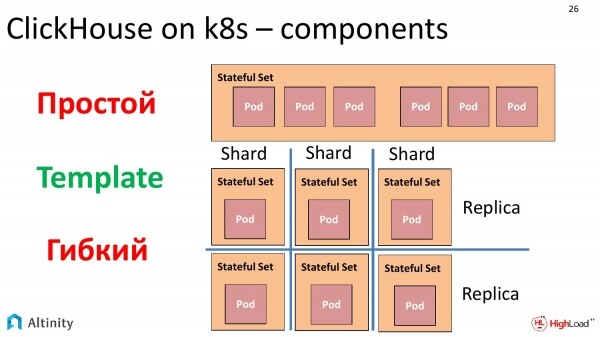
Și de ce a devenit StatefulSet-ul două? Aici trebuie să ne detașăm și să discutăm despre cum se gestionează Pod-urile în Kubernetes.
Există un obiect numit StatefulSet, care permite crearea unui grup de Pod-uri dintr-un șablon. Factorul cheie aici este Template. Și este posibil să rulăm mai multe Pod-uri dintr-un singur șablon într-un StatefulSet. Cuvântul cheie aici este „dintr-un singur șablon, multe Pod-uri.”
A existat o tentație mare de a crea întregul cluster, împachetându-l într-un singur StatefulSet. Aceasta va funcționa, nu există nicio problemă în acest sens. Dar este o nuanță. Dacă dorim să formăm un cluster heterogen, adică din mai multe versiuni ClickHouse, aici apar întrebările. Da, StatefulSet poate efectua un rolling update, da, se poate aplica o nouă versiune, explicând că trebuie încercate nu mai mult de atât noduri simultan.
Dar dacă extrapolăm sarcina și spunem că vrem să facem un cluster complet heterogen și nu dorim să schimbăm de la o versiune veche la una nouă prin rolling update, ci doar dorim să creăm un cluster heterogen atât în ceea ce privește diferitele versiuni ClickHouse, cât și în ceea ce privește diferite tipuri de stocare. Vrem, de exemplu, să facem anumite replici pe discuri separate, pe discuri lente, în general, să construim complet un cluster heterogen. Și din cauza că StatefulSet creează o soluție standardizată dintr-un singur șablon, nu există posibilitatea de a face acest lucru.
După o oarecare reflecție, s-a decis că procedăm în acest fel. Fiecare replică va fi în propriul său StatefulSet. Există unele dezavantaje ale acestei soluții, dar în praxis aceasta se încadrează complet în operator. Și există o mulțime de avantaje. Putem construi complet un cluster așa cum dorim, de exemplu, absolut heterogen. De aceea, în clusterul în care avem două sharde cu o replică, vor fi 2 StatefulSet-uri și 2 Pod-uri exact pentru că am ales această abordare din motivele menționate mai sus pentru a putea construi un cluster heterogen.
Să revenim la sarcinile practice. În clusterul nostru trebuie să configurăm utilizatorii, adică trebuie să facem o anumită configurare ClickHouse în Kubernetes. Operatorul oferă toate posibilitățile pentru acest lucru.
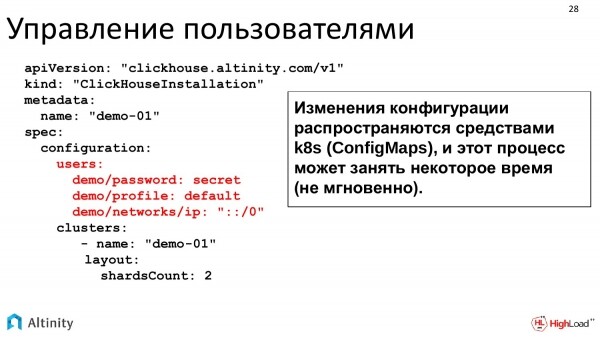
Putem scrie direct în YAML ce dorim. Toate opțiunile de configurare sunt mapate direct din acest YAML în configurațiile ClickHouse, care apoi sunt distribuite în întregul cluster.
Se poate scrie și așa. Acesta este doar un exemplu. Parola poate fi criptată. Toate opțiunile de configurare ClickHouse sunt complet acceptate. Aici este doar un exemplu.
Configurarea la nivel de cluster se răspândește ca un ConfigMap. În practică, actualizarea ConfigMap-ului nu se întâmplă instantaneu, așadar, dacă avem un cluster mare, procesul de propagare a configurației durează ceva timp. Dar totul este foarte convenabil în exploatare.
Îngreunăm sarcina. Clusterul se dezvoltă. Vrem să replicăm datele. Adică, avem deja două șarde, fiecare cu câte o replică, utilizatorii sunt configurați. Creștem și dorim să ne ocupăm de replicare.
Ce ne trebuie pentru replicare?
Avem nevoie de ZooKeeper. În ClickHouse, replicarea este construită folosind ZooKeeper. ZooKeeper este necesar pentru ca diferitele replici ClickHouse să aibă consens cu privire la ce blocuri de date există pe care ClickHouse.
Orice ZooKeeper poate fi folosit. Dacă există un ZooKeeper extern al întreprinderii, acesta poate fi utilizat. Dacă nu, putem instala din depozitul nostru. Există un instalator care facilitează tot acest proces.
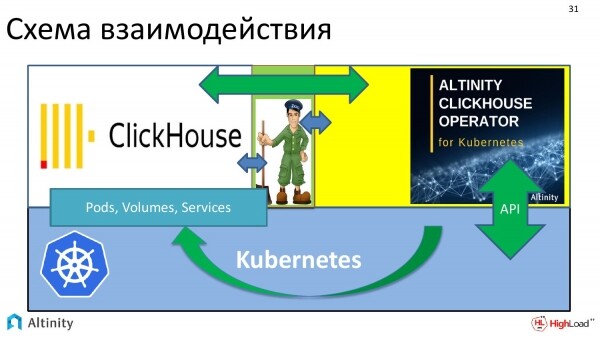
Și schema de interacțiune a întregului sistem arată astfel. Avem Kubernetes ca platformă. Pe el rulează operatorul ClickHouse. ZooKeeper l-am reprezentat aici. Și operatorul interacționează atât cu ClickHouse, cât și cu ZooKeeper. Adică se va realiza interacțiunea.
Și tot acest lucru este necesar pentru ca ClickHouse să poată replica cu succes datele în k8s.
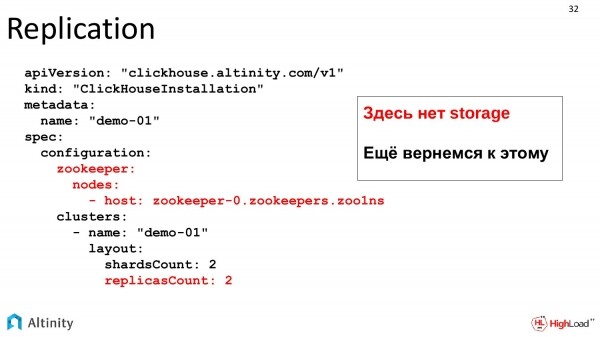
Haideți acum să ne uităm la sarcina însăși, la cum va arăta manifestul pentru replicare.
Adăugăm două secțiuni la manifestul nostru. Prima – este de unde să luăm ZooKeeper, care poate fi fie în interiorul Kubernetes, fie extern. Aceasta este pur și simplu o descriere. Și cerem replicile. Adică, vrem două replici. În total, ar trebui să avem 4 pod-uri. Își amintim de storage, el va reveni puțin mai târziu. Storage – este o melodie separată.
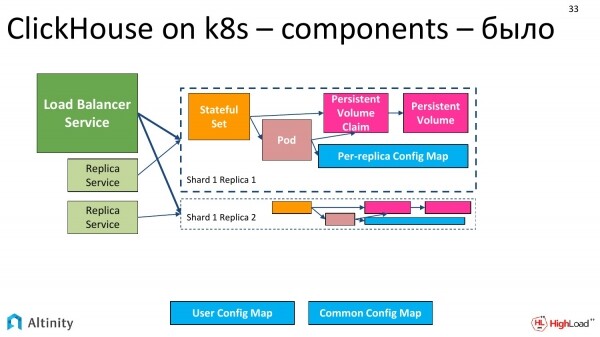
A fost așa.
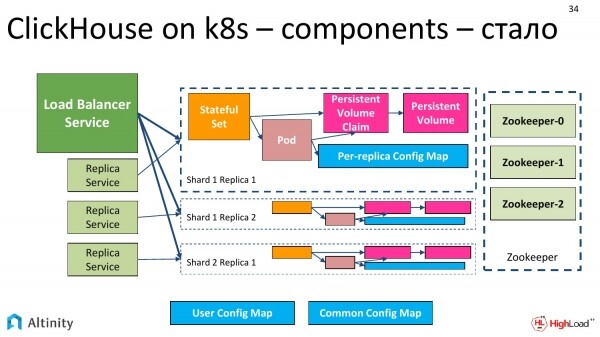
Devine așa. Se adaugă replicile. A patra nu încăpea, dar credem că pot fi multe. Și pe lateral se adaugă ZooKeeper. Schemele devin mai complexe.
Și a venit timpul să adăugăm următoarea sarcină. Vom adăuga stocare persistentă.
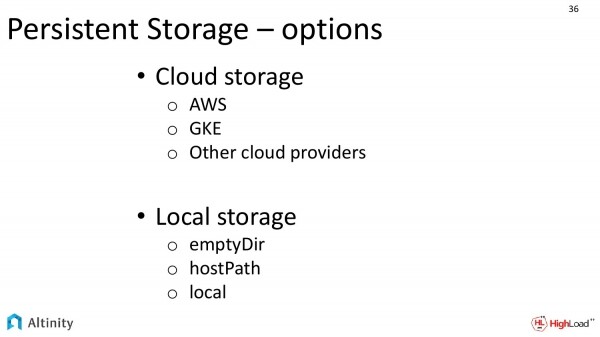 În cazul stocării persistente, avem diferite opțiuni de implementare.
În cazul în care ne implementăm la un furnizor de cloud, de exemplu, folosind Amazon, Google, există o mare tentație de a folosi stocarea cloud. Este foarte convenabil, este bine.
Și există a doua opțiune. Aceasta este pentru stocarea locală, când avem discuri locale pe fiecare nod. Această opțiune este mult mai complexă în implementare, dar în același timp este mai performantă.
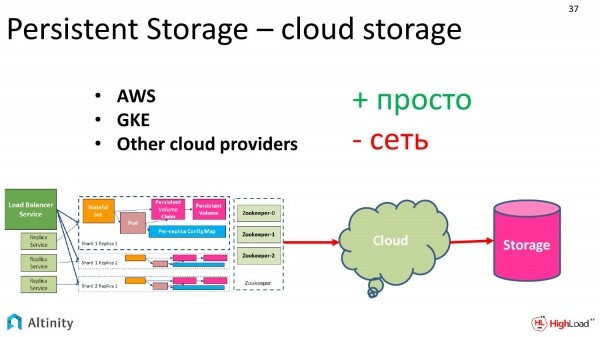
Să vedem ce avem în ceea ce privește stocarea cloud.
Există avantaje. Este foarte simplu de configurat. Pur și simplu cerem furnizorului de cloud să ne ofere stocare de o anumită capacitate, de un anumit tip. Tipurile sunt detaliate de furnizori.
Există un dezavantaj. Pentru unii, acesta nu este un dezavantaj critic. Desigur, vor exista unele suprapuneri legate de performanță. Este foarte convenabil în utilizare, sigur, dar există anumite scăderi potențiale de performanță.
Și ținând cont că ClickHouse se concentrează în mod special pe performanță, se poate spune că extrage tot ce este posibil, de aceea foarte mulți clienți încearcă să obțină maximum de performanță.
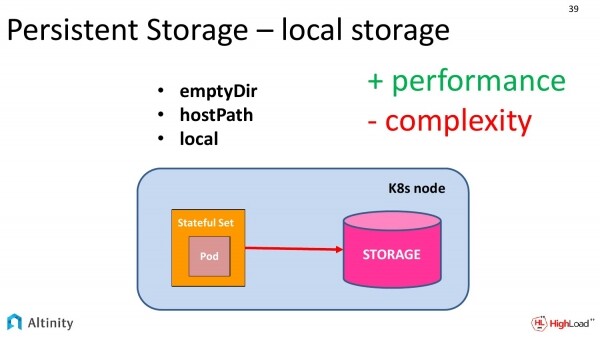
Pentru a obține maximum, avem nevoie de stocare locală.
Kubernetes oferă trei abstracții pentru utilizarea stocării locale în Kubernetes. Acestea sunt:
- EmptyDir
- HostPath.
- Local
Să vedem în ce se diferențiază și în ce se aseamănă.
În primul rând, în toate cele trei abordări avem stocare – acestea sunt discurile locale care se află pe aceeași nodă fizică k8s. Dar există unele diferențe.
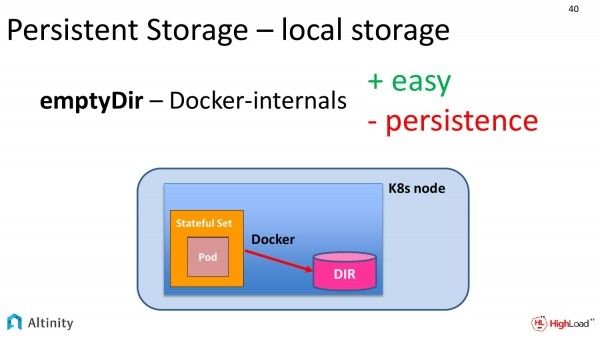
Să începem cu cel mai simplu, adică cu emptyDir. Ce înseamnă acest lucru în practică? Cerem sistemului de containerizare (cel mai adesea – Docker) să ne ofere acces la un folder de pe discul local.
În practică, Docker creează undeva, pe căile sale proprii, un folder temporar, numit cu un hash lung. Și oferă un interfață de acces la acesta.
Cum va funcționa aceasta în ceea ce privește performanța? Va funcționa cu viteza discului local, adică este acces complet la propriul sistem de stocare.
Dar acest lucru are un dezavantaj. Persistent în această situație este destul de suspect. La prima mișcare a Docker-ului cu containerele, Persistent se pierde. Dacă Kubernetes dorește dintr-un anumit motiv să mute acest Pod pe un alt disc, datele se vor pierde.
Această abordare este bună pentru teste, deoarece viteza este deja decentă, dar pentru ceva serios, această variantă nu se potrivește.
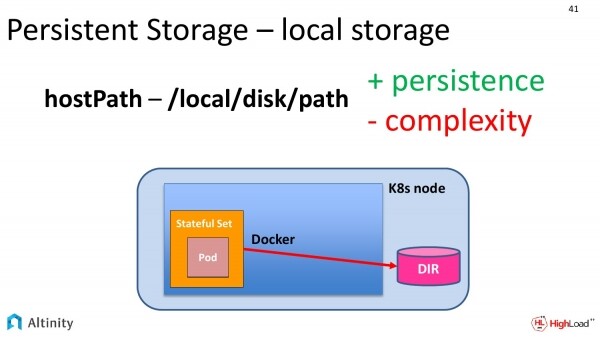
Prin urmare, există a doua abordare. Aceasta este hostPath. Dacă ne uităm la diapozitivul anterior și la acesta, putem observa o singură diferență. Folderul a ieșit din Docker direct pe nodul Kubernetes. Aici e puțin mai simplu. Specificăm direct calea pe sistemul de fișiere local, unde am dori să ne stocăm datele.
Avantajele acestei metode există. Acesta este un adevărat Persistent, în plus, clasic. Datele noastre vor fi scrise pe disc la o anumită adresă.
Există și dezavantaje. Acesta este complexitatea gestionării. Kubernetes-ul nostru poate dori să mute un Pod pe un alt nod fizic. Aici intervine DevOps. El trebuie să explice corect întregului sistem că aceste pod-uri pot fi mutate doar pe acele noduri pe care ai ceva montat pe acele căi, și nu mai mult de un nod pe dată. Acest lucru este destul de complicat.
Special pentru aceste scopuri, la noi, în operator, am creat șabloane pentru a ascunde toată această complexitate. Și s-ar putea pur și simplu să spunem: „Vreau să am un instance ClickHouse pe fiecare nod fizic și pe un anumit drum.”
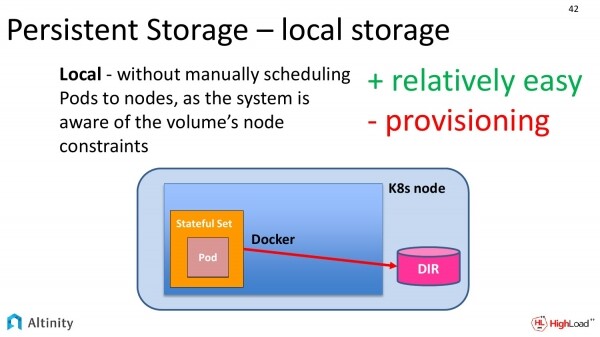
Dar această necesitate nu este doar a noastră, de aceea domnii din Kubernetes înțeleg și ele că oamenii doresc acces la discurile fizice, așa că oferă un al treilea nivel.
Se numește local. Practic, nu există nicio diferență față de diapozitivul anterior. Doar că înainte trebuia să facem manual ceea ce nu permitea mutarea acestor pod-uri de la un nod la altul, deoarece acestea trebuiau să fie atașate pe o anumită cale la un disc fizic local, iar acum toate aceste cunoștințe sunt încapsulate în Kubernetes. Și devine mult mai simplu de configurat.
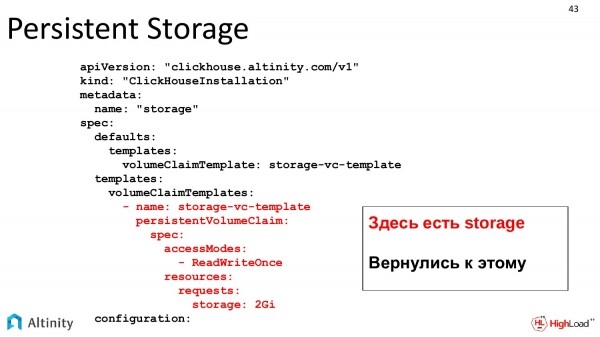
Să ne întoarcem la sarcina noastră practică. Să ne întoarcem la șablonul YAML. Aici ne-a apărut un adevărat storage. Ne-am întors la acest lucru. Definim un șablon clasic de VolumeClaim ca în k8s. Și descriem ce storage dorim.
După aceasta, k8s va solicita storage. Ne va aloca în StatefulSet. Iar în cele din urmă, acesta va fi la dispoziția ClickHouse.
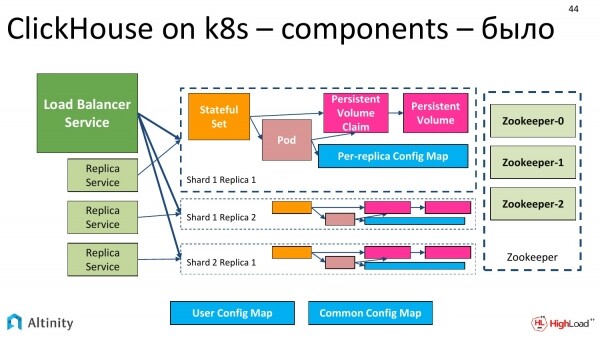
A avut o schemă de acest fel. Storage-ul nostru Persistent a fost roșu, ceea ce sugera că ar trebui să-l creăm.
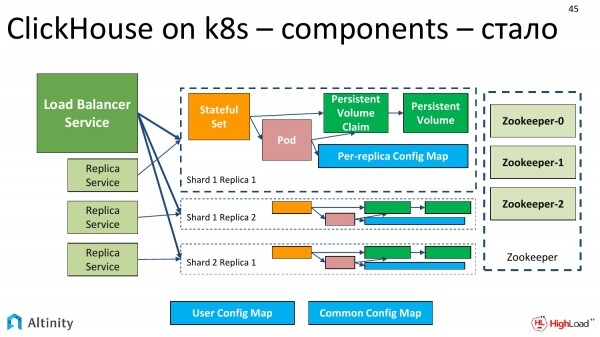
Și devine verde. Acum schema cluster-ului ClickHouse pe k8s este complet finalizată. Avem sharde, replici, ZooKeeper, există un Persistent adevărat, care este realizat într-un mod sau altul. Schema este deja complet funcțională.
Continuăm să trăim mai departe. Cluster-ul nostru se dezvoltă. Și Alexey se străduiește și lansează o nouă versiune a ClickHouse.
Se ridică o sarcină practică – să testăm noua versiune a ClickHouse pe cluster-ul nostru. Și, desigur, nu vrem să o aplicăm în întregime, vrem să punem o nouă versiune undeva într-un colț îndepărtat, poate chiar două versiuni noi, pentru că acestea apar destul de des.
Ce putem spune despre asta?
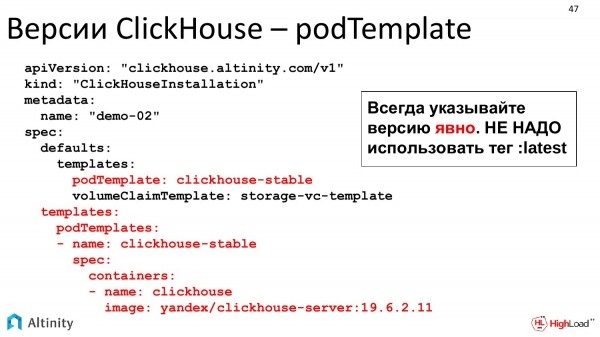
Aici avem exact această oportunitate. Sunt șabloanele de pod-uri. Putem detalia, operatorul nostru permite complet construirea unui cluster heterogen. Adică, configurând, începând de la toate replicile ca un întreg, până la fiecare replică personalizată pentru a alege ce versiune de ClickHouse dorim, ce versiune de stocare dorim. Putem configura complet un cluster cu această configurație, așa cum avem nevoie.
Vom pătrunde puțin mai profund. Până acum am vorbit despre cum funcționează ClickHouse-operator în raport cu specificitatea ClickHouse.
Acum aș dori să spun câteva cuvinte despre cum funcționează de fapt orice operator, precum și despre cum interacționează cu K8s.
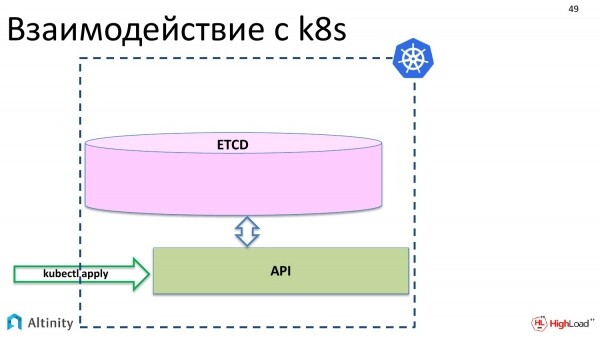
Să analizăm interacțiunea cu K8s la început. Ce se întâmplă când facem kubectl apply? Obiectele noastre apar în etcd prin API.
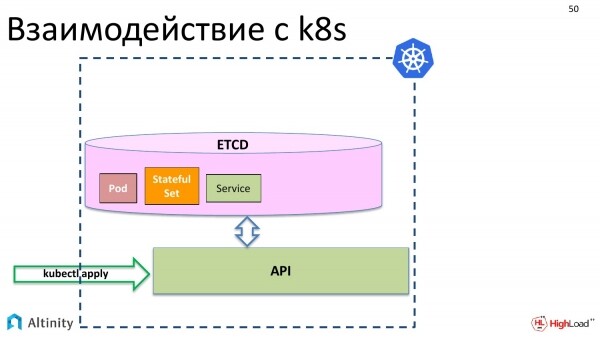
De exemplu, obiectele de bază Kubernetes: pod, StatefulSet, service și așa mai departe.
În acest moment, nimic fizic nu se întâmplă încă. Aceste obiecte trebuie materializate în cluster.
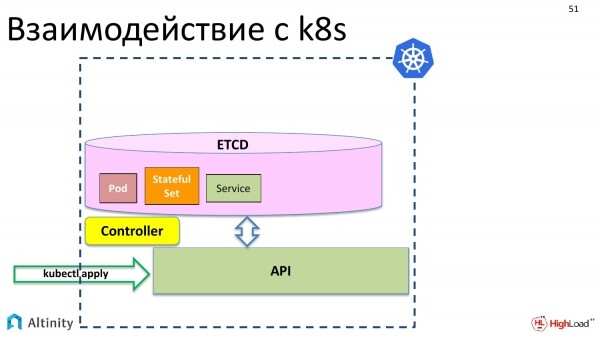
Pentru aceasta, apare un controller. Controller-ul este un component special K8s, care știe să materializeze aceste descrieri. Știe cum și ce trebuie făcut fizic. Știe cum să lanseze containere, ce trebuie configurat pentru ca serverul să funcționeze.
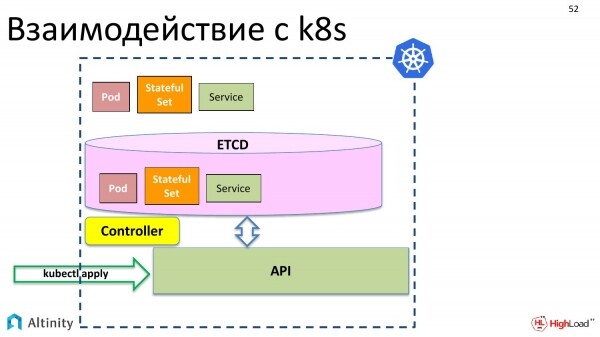
Și el materializează obiectele noastre în K8s.
Dar vrem să operăm nu doar cu pod-uri, StatefulSet-uri, vrem să creăm ClickHouseInstallation, adică un obiect de tip ClickHouse, pentru a opera cu acesta ca un întreg. Deocamdată, nu există această posibilitate.
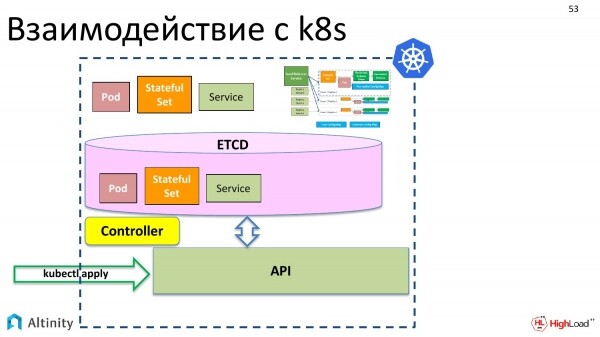
Dar K8s are următoarea caracteristică plăcută. Vrem să avem un fel de entitate complexă acolo, care să fie alcătuită din pod-uri și StatefulSet, formând clusterul nostru.
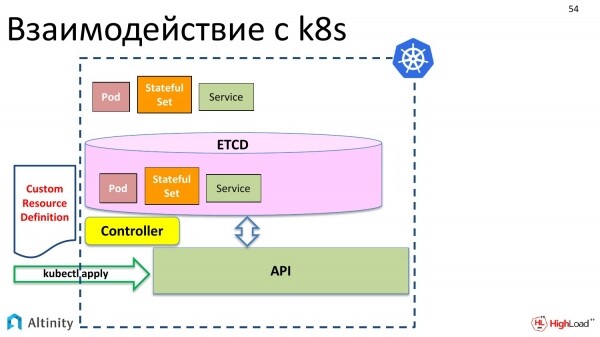
Și ce trebuie făcut pentru aceasta? În primul rând, intră în scenă Custom Resource Definition. Ce este aceasta? Este o descriere pentru K8s, că vei avea un alt tip de date, că vrem să adăugăm un resursă personalizată la pod, StatefulSet, care va fi complexă în interior. Este o descriere a structurii datelor.
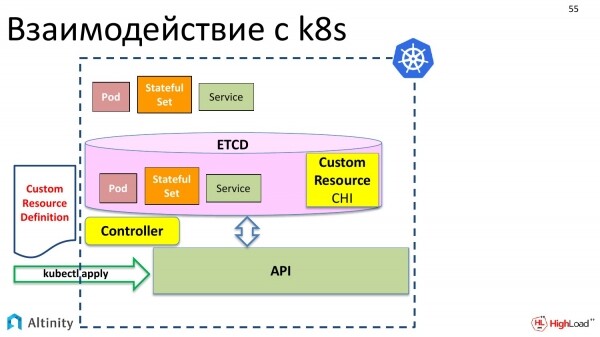
De asemenea, o trimitem acolo prin kubectl apply. Kubernetes a preluat-o cu bucurie.
Și acum avem în stocare, la obiectul din etcd, posibilitatea de a înregistra o resursă personalizată numită ClickHouseInstallation.
Însă, până acum, nu se va întâmpla nimic. Adică, dacă acum creăm un fișier YAML, pe care l-am discutat, cu descrierea shard-urilor, replicatelor și spunem „kubectl apply”, Kubernetes îl va accepta, îl va pune în etcd și va spune: „Excelent, dar nu știu ce să fac cu el. Nu știu cum să întrețin ClickHouseInstallation.”
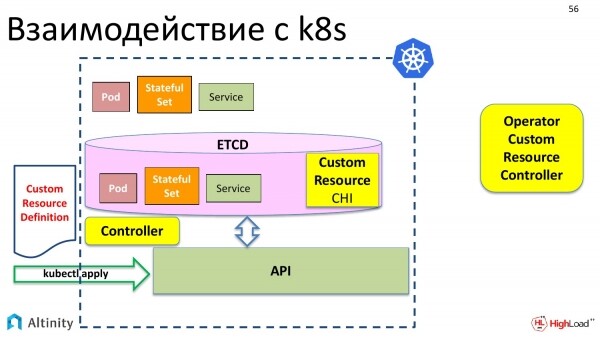
Prin urmare, avem nevoie de cineva care să ajute Kubernetes să întrețină un nou tip de date. În stânga avem un controler Kubernetes standard care lucrează cu tipuri de date standard. Iar în dreapta ar trebui să apară un controler personalizat, care știe să lucreze cu tipuri de date personalizate.
Și, pe scurt, acesta se numește operator. L-am scos aici din Kubernetes, deoarece poate fi executat și în afara K8s. Cel mai adesea, bineînțeles, toți operatorii rulează în Kubernetes, dar nimic nu îi împiedică să funcționeze din exterior, așa că l-am scos special afară.
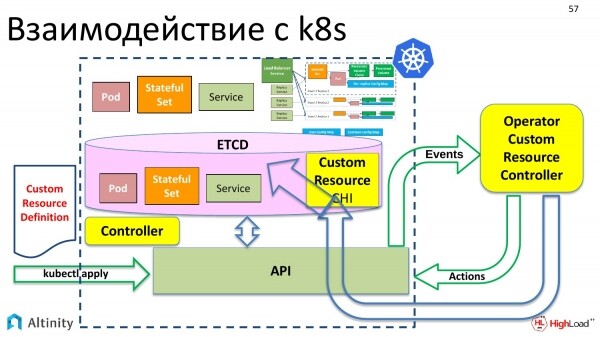
Și, la rândul său, controlerul personalizat, adică operatorul, interacționează cu Kubernetes prin API. Acesta deja știe cum să interacționeze cu API-ul și știe cum să materializeze o schemă complexă din resursa personalizată pe care dorim să o realizăm. Aceasta este exact ceea ce face operatorul.
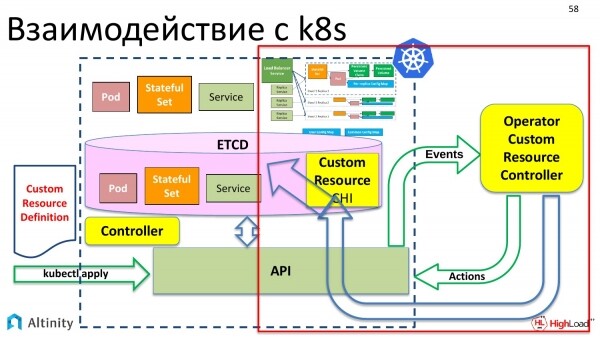
Cum funcționează operatorul? Haideți să ne uităm în partea dreaptă pentru a descoperi cum face acest lucru. Vom învăța cum operatorul materializează totul și cum continuă interacțiunea cu K8s.
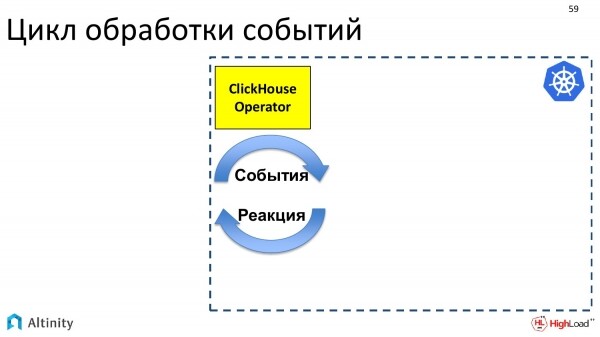
Operatorul este un program. Este orientat pe evenimente. Operatorul, cu ajutorul API-ului Kubernetes, se abonează la evenimente. În API-ul Kubernetes există puncte de intrare la care se poate abona pentru evenimente. Și dacă ceva se schimbă în K8s, Kubernetes trimite evenimente tuturor celor care doresc, adică cine s-a abonat la acest punct API va primi notificări.
Operatorul se abonează la evenimente și trebuie să facă o reacție. Sarcina sa este să reacționeze la evenimentele care apar.
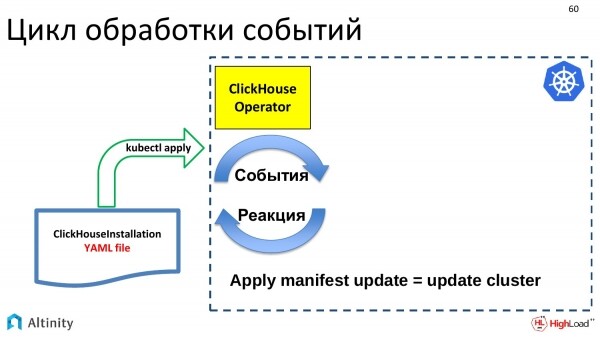
Evenimentele sunt generate de anumite actualizări. Vine fișierul nostru YAML cu descrierea ClickHouseInstallation. Acesta, prin kubectl apply, a fost trimis în etcd. Acolo s-a activat un eveniment, iar acest eveniment a ajuns la ClickHouse-operator. Operatorul a primit această descriere și trebuie să facă ceva. Dacă s-a primit o actualizare pentru obiectul ClickHouseInstallation, trebuie să actualizăm clusterul. Sarcina operatorului este să actualizeze clusterul.
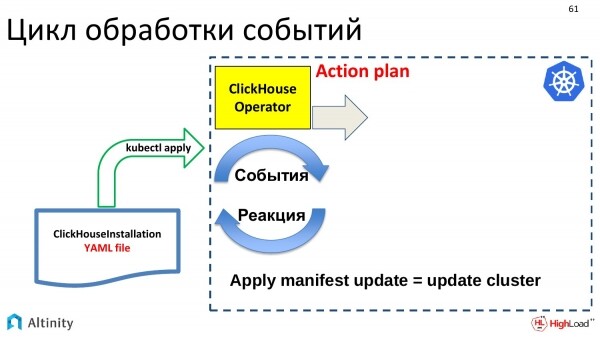
Ce face el? În primul rând, trebuie să elaborăm un plan de acțiune pentru ceea ce vom face cu această actualizare. Actualizările pot fi foarte mici, adică mici în execuția YAML, dar pot aduce modificări foarte mari în cluster. De aceea, operatorul creează un plan și apoi se ține de el.
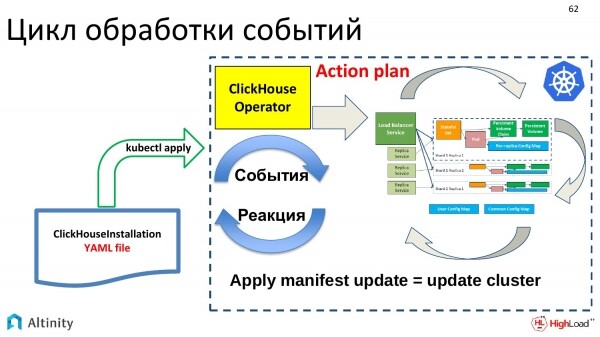
El începe, conform acestui plan, să construiască această structură în interior pentru a materializa podurile, serviciile, adică pentru a face ceea ce este sarcina sa principală. Este ca și cum ai construi un cluster ClickHouse în Kubernetes.
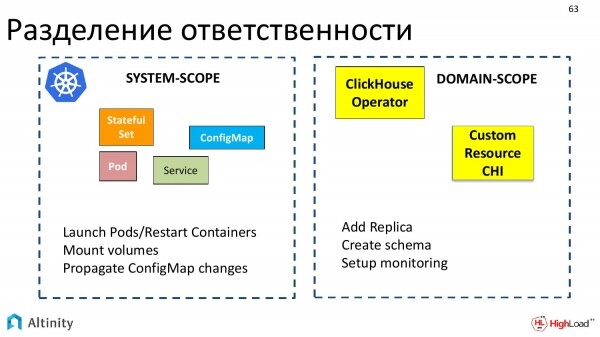
Acum să discutăm despre un aspect interesant. Aceasta este împărțirea responsabilităților între Kubernetes și operator, adică ce face Kubernetes, ce face operatorul și cum interacționează între ei.
Kubernetes se ocupă de lucruri de sistem, adică de un set de obiecte de bază care pot fi interpretate ca având un domeniu de sistem. Kubernetes știe cum să ruleze poduri, cum să repornească containere, cum să monteze volume, cum să lucreze cu ConfigMap, adică tot ce poate fi numit sistem.
Operatorii operează în domenii specifice. Fiecare operator este creat pentru domeniul său specific. Noi am realizat unul pentru ClickHouse.
Și operatorul interacționează exact în termenii domeniului, cum ar fi adăugarea unei replici, crearea unui schemă, configurarea monitorizării. Astfel se realizează această împărțire.
Haideți să analizăm un exemplu practic, cum are loc această împărțire a responsabilităților atunci când executăm acțiunea de a adăuga o replică.
La operator vine o solicitare – adăugarea unei replici. Ce face operatorul? Operatorul va calcula că trebuie să creeze un nou StatefulSet, în care trebuie să descrie anumite șabloane și cerințe de volum.
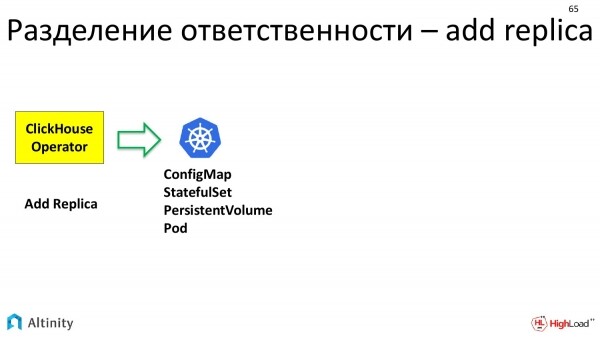
El pregătește totul și transmite mai departe în K8s. Spune că are nevoie de ConfigMap, StatefulSet, Volume. Kubernetes își îndeplinește sarcinile. El materializează unitățile de bază cu care operează.
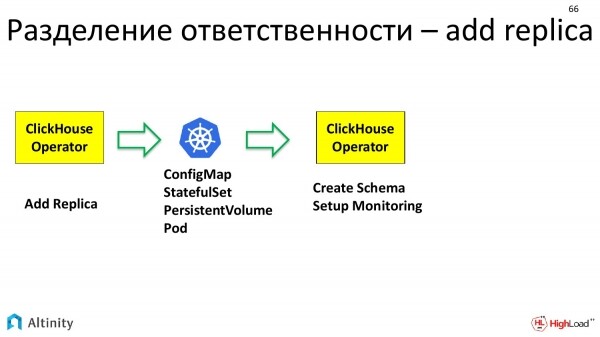
Și apoi intervine din nou ClickHouse-operator. Acesta are deja un pod fizic, pe care se poate lucra. Iar ClickHouse-operator lucrează din nou în termenii domeniului. Adică, în cazul specific al ClickHouse, pentru a activa o replică în cluster, trebuie, în primul rând, să configureze schema de date care există în acest cluster. Iar, în al doilea rând, această replică trebuie să fie inclusă în monitorizare, pentru a fi bine urmărită. Aceste setări le face operatorul.
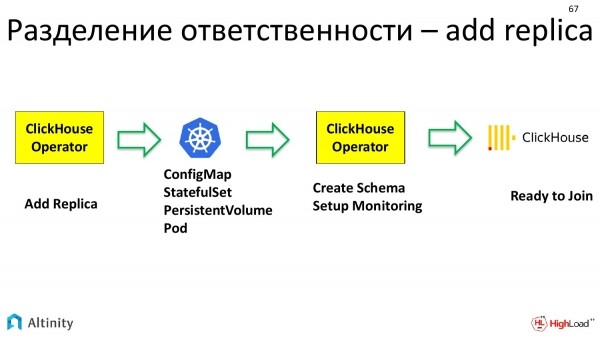
Și doar după aceea intervine ClickHouse, adică o entitate de nivel superior. Aceasta este deja o bază de date. Are propria instanță, o replică configurată, care este pregătită să intre în cluster.
Așadar, lanțul de execuție și separarea responsabilităților la adăugarea unei replici este destul de lung.
Continuăm cu sarcinile noastre practice. Dacă clusterul există deja, se poate efectua migrarea configurației.
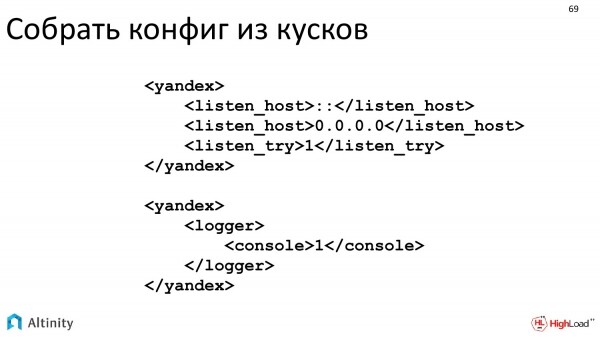
Am realizat astfel încât în XML-ul existent, pe care ClickHouse îl înțelege, să putem introduce date direct.
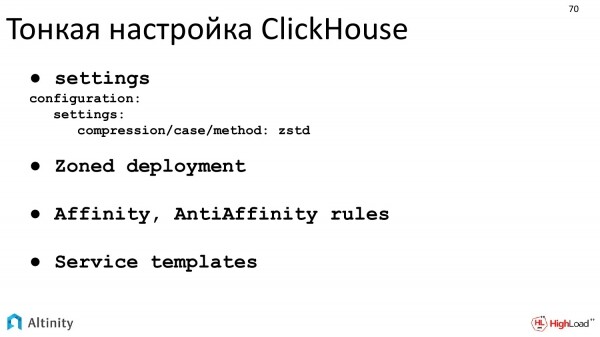
Se poate face o ajustare fină a ClickHouse. Implementarea zonată este exact ceea ce am explicat când am vorbit despre hostPath, stocare locală. Este modul corect de a face o implementare zonată.
Următoarea sarcină practică este monitorizarea.
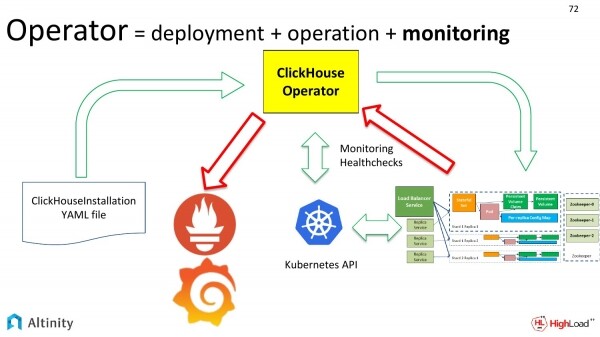
Dacă clusterul nostru se schimbă, trebuie să configurăm periodic monitorizarea.
Să examinăm schema. Să zicem că săgețile verzi le-am discutat deja. Acum să analizăm săgețile roșii. Acestea arată cum dorim să monitorizăm clusterul nostru. Cum metricile din clusterul ClickHouse ajung în Prometheus, iar apoi în Grafana.
Care este dificultatea asociată cu monitorizarea? De ce este considerată o realizare? Dificultatea constă în dinamică. Când avem un cluster static, putem configura o dată monitorizarea și apoi să nu mai avem griji.
Dar dacă avem multe clustere sau se schimbă constant ceva, procesul devine dinamic. Așadar, a reconfigura constant monitorizarea consumă resurse și timp, adică devine pur și simplu o povară. Trebuie să automatizăm acest lucru. Dificultatea rezidă în dinamica procesului. Iar operatorul automatizează foarte bine acest lucru.
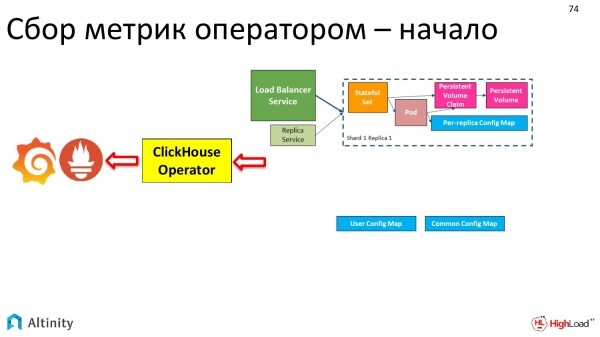
Cum s-a dezvoltat clusterul nostru? La început a fost așa.
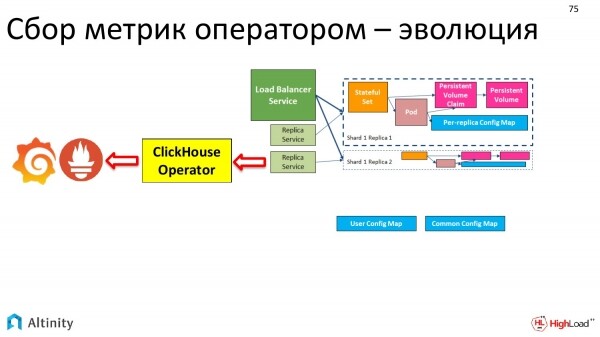
Apoi a fost așa.
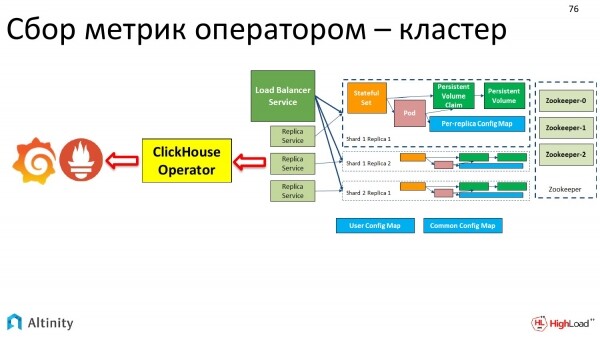
În final, a ajuns să fie astfel.
Iar monitorizarea se face automat de către operator. Există un punct unic de acces.
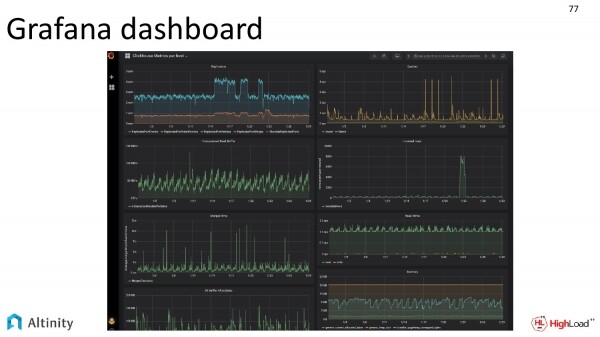
Și noi doar ne uităm la tabloul de bord Grafana, observând cum viața din interiorul clusterului nostru se desfășoară.
Apropo, tabloul de bord Grafana este de asemenea distribuit cu operatorul nostru direct în sursă. Poate fi conectat și utilizat. Această captură de ecran mi-a fost oferită de echipa noastră DevOps.
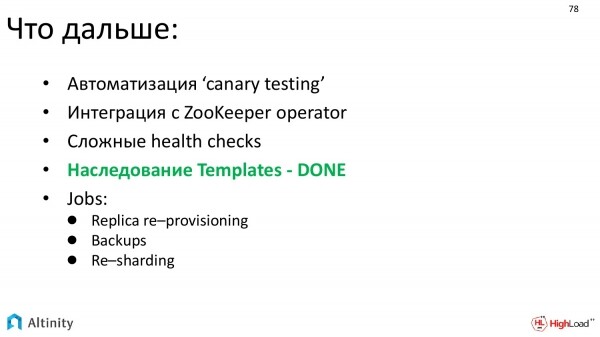
Încotro ne dorim să mergem mai departe? Este:
- Să dezvoltăm automatizarea testării. Obiectivul principal este testarea automată a noilor versiuni.
- De asemenea, dorim foarte mult să automatizăm integrarea cu ZooKeeper. În plan este integrarea cu ZooKeeper-operator. Adică, pentru ZooKeeper a fost scris un operator și este logic ca cele două operații să înceapă să se integreze pentru a construi o soluție mai convenabilă.
- Dorim să facem verificări de sănătate mai complexe.
- Am evidențiat în verde ceea ce ne apropie de moștenirea Templates – GATA, adică, cu următoarea versiune a operatorului vom avea deja moștenirea șabloanelor. Acesta este un instrument puternic care permite construirea de configurații complexe din fragmente.
- Și dorim automatizarea sarcinilor complexe. Principală dintre acestea este Re-sharding.
Să facem un bilanț intermediar.
Ce obținem la sfârșit? Și merită să ne ocupăm de asta sau nu? Trebuie să încercăm să aducem baza de date în Kubernetes și să aplicăm operatorul în general și operatorul Alitnity în special.
La sfârșit obținem:
- O substanțială simplificare și automatizare a configurării, desfășurării, precum și întreținerii.
- Monitorizare încorporată imediat.
- Și șabloane codificate gata de utilizare pentru situații complexe. Acum, acțiune de tipul adăugării unei replici nu trebuie efectuată manual. Asta face operatorul.
A rămas doar o ultimă întrebare. Avem deja baza de date în Kubernetes, virtualizare. Ce este cu performanța unei astfel de soluții, mai ales având în vedere că ClickHouse este optimizat pentru performanță?
Răspunsul – totul este în regulă! Nu voi detalia asta, este un subiect pentru o altă prezentare.
Dar există un proiect numit TSBS. Care este principalul său obiectiv? Este un test de performanță al bazelor de date. O încercare de a compara căldura cu căldura, moale cu moale.
Cum funcționează? Este generat un singur set de date. Apoi, acest set de date este rulat pe același set de teste pe diferite baze de date. Și fiecare bază de date rezolvă o problemă așa cum știe. Apoi, rezultatele pot fi comparate.
Deja suportă o mulțime mare de baze de date. Am evidențiat trei principale. Acestea sunt:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
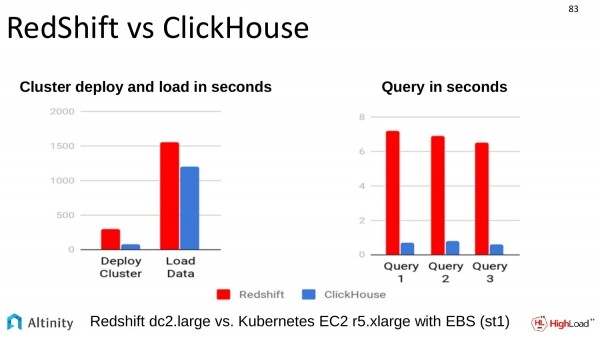
De asemenea, a fost efectuată o comparație cu o altă soluție similară. Comparația cu RedShift. Comparatia a fost realizată pe Amazon. ClickHouse, de asemenea, depășește pe toți în această privință.
Ce concluzii se pot trasa din ceea ce am spus?
- Baza de date în Kubernetes este posibilă. Probabil, orice bază de date ar putea fi utilizată, dar în general, se pare că este posibil. ClickHouse în Kubernetes este cu siguranță posibil cu ajutorul operatorului nostru.
- Operatorul ajută la automatizarea proceselor și realmente simplifică viața.
- Performanța este normală.
- Și, ni se pare că aceasta poate și trebuie folosită.
Open source – alăturați-vă!
Așa cum am spus, operatorul este un produs complet open source, așa că ar fi foarte bine dacă un număr maxim de oameni l-ar folosi. Alăturați-vă! Vă așteptăm pe toți!
Mulțumesc tuturor!
Întrebări
Mulțumesc pentru prezentare! Mă numesc Anton. Sunt din compania SEMrush. Mă interesează ce se întâmplă cu logarea. Se aude despre monitorizare, dar nimic despre logare, dacă vorbim despre întregul cluster. De exemplu, noi avem un cluster pe hardware. Și folosim logare centralizată, adunând datele în mod standard în totalitate. Și apoi extragem datele care ne interesează.
Întrebare bună, adică logarea este pe lista de sarcini. Operatorul nostru în prezent nu automatizează acest proces. Încă se dezvoltă, proiectul este încă destul de tânăr. Înțelegem necesitatea logării. Este, de asemenea, o temă foarte importantă. Și probabil că nu este mai puțin importantă decât monitorizarea. Dar primul pe lista de implementare a fost monitorizarea. Logarea va fi. Evident, ne străduim să automatizăm toate aspectele legate de funcționarea cluster-ului. Prin urmare, răspunsul este – în prezent, operatorul, din păcate, nu știe să facă asta, dar este în planuri, vom face asta. Dacă aveți dorința de a vă alătura, vă rog, trimiteți un pull request.
Bună! Mulțumesc pentru prezentare! Am o întrebare standard, legată de Volume Persistente. Când creăm o configurație cu ajutorul acestui operator, cum determină operatorul pe ce nod este montat un anumit disc sau folder? Trebuie să-i explicăm dinainte că, vă rog, așează ClickHouse-ul nostru exact pe acele noduri pe care există un disc?
Din câte înțeleg, această întrebare este o continuare a stocării locale, în special partea sa referitoare la hostPath. Este ca și cum ai explica întregului sistem ceea ce trebuie să faci pentru ca pod-ul să fie lansat exact pe un anumit nod, pe care avem un disc fizic conectat, care este montat pe un anumit parcurs. Este o întreagă secțiune, pe care am acoperit-o foarte superficial, deoarece răspunsul este destul de mare.
În esență, asta arată așa. Este evident că trebuie să realizăm provisioning pentru aceste volume. Momentan, în stocarea locală nu există provisioning dinamic, așa că DevOps trebuie să taie manual discurile, aceste volume. De asemenea, trebuie să explicăm Kubernetes provisioning-ului că vor exista volume persistente de un anumit tip, situate pe anumite noduri. Apoi, va trebui să explicăm Kubernetes că podurile care necesită un anumit tip de stocare locală trebuie programate doar pe acele noduri specifice, conform etichetelor. În acest scop, operatorul are posibilitatea de a atribui anumite etichete și o instanță per gazdă. Astfel, podurile vor fi rutate de Kubernetes pentru a fi lansate doar pe nodurile care îndeplinesc cerințele etichetelor, vorbind pe înțelesul tuturor. Administratorii atribuie etichete, fac provisioning pentru discuri manual. Și atunci se poate scala.
Iar cea de-a treia variantă locală ajută să ușurăm puțin această problemă. Așa cum am subliniat anterior, este o muncă minuțioasă de configurare, care la final ajută să obținem performanța optimă.
Am o a doua întrebare legată de acest subiect. Kubernetes a fost gândit astfel încât să nu ne pese dacă pierdem un nod sau nu. Ce ar trebui să facem în cazul în care pierdem nodul care găzduiește un shard?
Da, Kubernetes a fost inițial poziționat astfel încât relația noastră cu podurile să fie asemănătoare cu cea dintre crescătorii de animale, dar aici fiecare disc devine ceva similar cu un animal de companie. Există această problemă că nu îi putem aruncate pur și simplu. Dezvoltarea Kubernetes merge în direcția în care nu se poate aborda complet această filozofie, considerându-le resurse complet eliminabile.
Acum o întrebare practică. Ce să facem dacă ați pierdut un nod pe care era un disc? Aici problema se rezolvă la un nivel mai înalt. În cazul ClickHouse, avem replici care funcționează la un nivel superior, adică la nivelul ClickHouse.
Care este dispoziția, până la urmă? DevOps este responsabil pentru a se asigura că datele nu se pierd. Trebuie să configureze corect replicarea și să se asigure că replicarea se desfășoară. În replică, la nivelul ClickHouse, datele trebuie să fie duplicate. Aceasta nu este o sarcină atribuită operatorului. Și nu este o sarcină pe care o rezolvă Kubernetes. Aceasta se rezolvă la nivelul ClickHouse.
Ce să faci dacă ai o nodă hardware care a căzut? Așadar, va trebui să instalezi una secundară, corect, să configurezi discul pe aceasta, să aplici etichete. După aceea, aceasta va îndeplini cerințele, astfel încât Kubernetes să poată lansa un instantaneu al pod-ului. Kubernetes îl va lansa. Totuși, nu ai suficient număr de pod-uri conform cerințelor stabilite. Aceasta va trece prin ciclul pe care l-am arătat. Și la cel mai înalt nivel, ClickHouse va înțelege că a intrat o replică, este încă goală și trebuie să începem să transferăm date către aceasta. Adică, acest proces este încă prost automatizat.
Mulțumesc pentru prezentare! Când se întâmplă tot felul de neplăceri, operatorul pică și se repornește, iar în acel moment sosesc evenimente, cum le gestionezi?
Ce se va întâmpla dacă operatorul a picat și s-a repornit, nu-i așa?
Da. Și în acel moment au sosit evenimente.
Sarcina, ce să faci în acest caz, se împarte parțial între operator și Kubernetes. Kubernetes are capacitatea de a reintegra evenimentele care s-au întâmplat. El le reintegrează. Sarcina operatorului este de a se asigura că, atunci când s-a realizat reintregratea jurnalului de evenimente, aceste evenimente sunt idempotente. Și ca reapariția aceluiași eveniment să nu ne distrugă sistemul. Și operatorul nostru se descurcă cu această sarcină.
Bună ziua! Mulțumesc pentru prezentare! Dmitri Zavyalov, compania Smedova. Se preconizează adăugarea în operator a posibilității de configurare cu haproxy? Ne-ar interesa un alt echilibrator pe lângă cel standard, care să fie inteligent și să înțeleagă că există de fapt ClickHouse.
Vorbești despre Ingress?
Da, înlocuiește Ingress cu haproxy. În haproxy poți să specifici topologia cluster-ului, unde sunt replicile.
Deocamdată nu ne-am gândit la asta. Dacă îți este necesar și poți explica de ce este nevoie, atunci poate fi implementat, mai ales dacă vrei să participi. Cu plăcere vom analiza opțiunea. Răspunsul scurt – nu, în acest moment nu avem această funcționalitate. Mulțumesc pentru sugestie, ne vom uita la asta. Și dacă ne explici use case-ul și de ce este necesar în practică, de exemplu, să creezi issues pe GitHub, va fi minunat.
Deja există.
Bine. Suntem deschiși la orice sugestii. Și haproxy se adaugă pe lista de to-do. Lista de to-do crește, nu scade deocamdată. Dar este bine, asta înseamnă că produsul este căutat.
Sursa: habr.com
