

În activitatea mea, mă confrunt adesea cu soluții tehnice noi/produse software, despre care există foarte puține informații în internetul vorbitor de limbă română. Prin acest articol, voi încerca să completez una dintre aceste lacune, oferind un exemplu din practica mea recentă, când a fost necesară configurarea trimiterii evenimentelor CDC din două SGBD populare (PostgreSQL și MongoDB) către un cluster Kafka cu ajutorul Debezium. Sper ca acest articol de sinteză, apărut în urma muncii depuse, să fie util și altora.
Ce este Debezium și, în general, CDC?
— un reprezentant al categoriei de software CDC (), iar mai precis — este un set de conectori pentru diferite SGBD, compatibili cu cadrul Apache Kafka Connect.
Aceasta folosind licența Apache License v2.0 și sponsorizat de compania Red Hat. Dezvoltarea a început în 2016, iar în prezent oferă suport oficial pentru următoarele SGBD: MySQL, PostgreSQL, MongoDB, SQL Server. Există, de asemenea, conectori pentru Cassandra și Oracle, dar în prezent acestea se află în stadiul de „acces timpuriu”, iar noile versiuni nu garantează compatibilitatea inversă.
Comparând CDC cu abordarea tradițională (când aplicația citește datele direct din SGBD), principalele sale avantaje includ implementarea stream-ului de schimbări de date la nivel de rând, cu latență redusă, fiabilitate ridicată și disponibilitate. Ultimele două puncte sunt realizate prin utilizarea unui cluster Kafka ca spațiu de stocare pentru evenimentele CDC.
De asemenea, printre avantajele se numără faptul că pentru stocarea evenimentelor este folosit un model unic, astfel încât aplicația finală nu va trebui să se preocupe de aspectele legate de exploatarea diferitelor SGBD.
În cele din urmă, datorită utilizării brokerului de mesaje, se deschide oportunitatea pentru scalarea orizontală a aplicațiilor care monitorizează schimbările în date. În acest fel, influența asupra sursei de date este redusă la minimum, deoarece obținerea datelor nu se realizează direct din SGBD, ci din clusterul Kafka.
Despre arhitectura Debezium
Utilizarea Debezium se rezumă la o schemă simplă:
SGBD (ca sursă de date) → conector în Kafka Connect → Apache Kafka → consumator
Ca ilustrare, voi prezenta schema de pe website-ul proiectului:
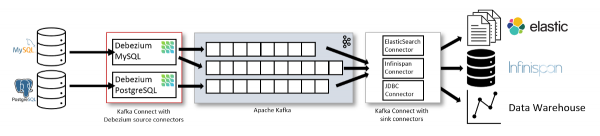
Totuși, acest schema nu îmi place foarte mult, deoarece dă impresia că este posibilă doar utilizarea unui conector sink.
În realitate, situația este diferită: umplerea Data Lake-ului vostru (ultimul element din schema de mai sus) — nu este singura modalitate de a utiliza Debezium. Evenimentele trimise către Apache Kafka pot fi folosite de aplicațiile voastre pentru a rezolva diverse situații. De exemplu:
- îndepărtarea datelor irelevante din cache;
- trimiterea notificărilor;
- actualizarea indexurilor de căutare;
- un fel de loguri de audit;
- …
În cazul în care aveți o aplicație Java și nu aveți nevoie/posibilitatea de a utiliza un cluster Kafka, există și opțiunea de a lucra prin . Avantajul evident este că, cu acesta, puteți renunța la infrastructură suplimentară (în formă de conector și Kafka). Totuși, această soluție a fost declarată învechită (deprecated) în versiunea 1.1 și nu mai este recomandată pentru utilizare (în viitoarele versiuni, suportul pentru aceasta ar putea fi eliminat).
În acest articol se va discuta arhitectura recomandată de dezvoltatori, care oferă reziliență la erori și capacitate de scalare.
Configurarea conectorului
Pentru a începe să urmărim modificările celei mai valoroase resurse — datele — ne vor trebui:
- o sursă de date, care poate fi MySQL începând cu versiunea 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- clusterul Apache Kafka;
- instanța Kafka Connect (versiunile 1.x, 2.x);
- un conector Debezium configurat.
Lucrările pentru primele două puncte, adică procesul de instalare a SGBD-ului și Apache Kafka, depășesc cadrul acestui articol. Cu toate acestea, pentru cei care doresc să desfășoare totul într-un sandbox, în depozitul oficial cu exemple există un .
Ne vom concentra mai în detaliu asupra ultimelor două puncte.
0. Kafka Connect
Aici și mai departe în articol, toate exemplele de configurare sunt discutate în contextul imaginii Docker distribuite de dezvoltatorii Debezium. Aceasta conține toate fișierele plugin-urilor necesare (conectori) și preconizează configurarea Kafka Connect prin intermediul variabilelor de mediu.
În cazul în care se preconizează utilizarea Kafka Connect de la Confluent, va trebui să adăugați singuri plugin-urile conectorilor necesari în directorul specificat în plugin.path sau setat prin variabila de mediu CLASSPATH. Setările worker-ului Kafka Connect și ale conectorilor sunt definite prin fișierele de configurare, care sunt transmise ca argumente în comanda de pornire a worker-ului. Mai multe detalii găsiți în .
Întreaga procedură de configurare Debezium cu conector se desfășoară în două etape. Să analizăm fiecare dintre ele:
1. Configurarea framework-ului Kafka Connect
Pentru streaming-ul datelor în clusterul Apache Kafka, framework-ul Kafka Connect definește parametrii specifici, cum ar fi:
- parametrii de conectare la cluster,
- numele topicurilor în care va fi stocată efectiv configurația conectorului,
- numele grupului în care este pornit conectorul (în cazul utilizării modului distribuit).
Imaginea oficială Docker a proiectului suportă configurarea prin variabile de mediu - și asta vom folosi. Așadar, descărcăm imaginea:
docker pull debezium/connectSetul minim de variabile de mediu necesare pentru a porni conectorul arată în felul următor:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— lista inițială de servere ale clusterului Kafka pentru a obține lista completă a membrilor clusterului; -
OFFSET_STORAGE_TOPIC=connector-offsets— topic pentru stocarea pozițiilor actuale la care se află conectorul; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— topic pentru stocarea stării conectorului și a sarcinilor sale; -
CONFIG_STORAGE_TOPIC=connector-config— topic pentru stocarea datelor de configurare ale conectorului și ale sarcinilor sale; -
GROUP_ID=1— identificatorul grupului de workeri pe care poate fi efectuată sarcina conectorului; necesar la utilizarea modului distribuit (distributed) mod.
Pornim containerul cu aceste variabile:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Nota despre Avro
În mod implicit, Debezium scrie datele în format JSON, ceea ce este acceptabil pentru medii de testare și volume mici de date, dar poate deveni o problemă în baze de date cu încărcare mare. O alternativă la converterul JSON este serializarea mesajelor folosind în format binar, ceea ce reduce încărcătura pe subsistemul I/O din Apache Kafka.
Pentru a utiliza Avro, este necesar să implementați un (pentru stocarea schemelor). Variabilele pentru converter vor arăta în felul următor:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Detalii privind utilizarea Avro și configurarea registrului depășesc subiectul acestui articol — în continuare, pentru claritate, vom folosi JSON.
2. Configurarea connectorului
Acum putem trece la configurarea connectorului care va citi date din sursă.
Vom lua ca exemplu conectorii pentru două baze de date: PostgreSQL și MongoDB, pentru care am experiență și care au diferențe (chiar dacă sunt mici, în unele cazuri sunt substanțiale!).
Configurarea este descrisă în notația JSON și se încarcă în Kafka Connect printr-o cerere POST.
2.1. PostgreSQL
Exemplu de configurare a conectorului pentru PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Principiul de funcționare al connectorului după această configurare este destul de simplu:
- La prima rulare, se conectează la baza de date specificată în configurație și pornește în modul instantanee inițială, trimițând în Kafka un set inițial de date, obținut prin
SELECT * FROM table_name. - După finalizarea inițializării, connectorul trece în modul de citire a modificărilor din fișierele WAL PostgreSQL.
Despre opțiunile utilizate:
-
name— numele connectorului pentru care se utilizează configurația descrisă mai jos; ulterior, acest nume este folosit pentru a lucra cu connectorul (de exemplu, pentru a verifica statusul/reporni/actualiza configurația) prin API-ul REST Kafka Connect; -
connector.class— clasa connectorului bază de date care va fi utilizată de connectorul configurabil; -
plugin.name— numele pluginului pentru decodarea logică a datelor din fișierele WAL. Opțiunile disponibile suntwal2json,decoderbuffsșipgoutput. Primele două necesită instalarea extensiilor corespunzătoare în baza de date, iarpgoutputpentru PostgreSQL versiunea 10 și mai recentă nu necesită manipulări suplimentare; -
database.*— opțiuni pentru conectarea la baza de date, undedatabase.server.name— numele instanței PostgreSQL, folosit pentru formarea numelui subiectului în clusterul Kafka; -
table.include.list— lista de tabele în care dorim să urmărim modificările; se stabilește în formatulschema.table_name; nu poate fi utilizat împreună cutable.exclude.list; -
heartbeat.interval.ms— intervalul (în milisecunde) cu care conectorul trimite mesaje heartbeat într-un subiect special; -
heartbeat.action.query— interogarea care va fi executată la trimiterea fiecărui mesaj heartbeat (opțiune disponibilă din versiunea 1.1); -
slot.name— numele slotului de replicare care va fi utilizat de conector; publication.name— numele din PostgreSQL, pe care o folosește conectorul. În cazul în care aceasta nu există, Debezium va încerca să o creeze. Dacă utilizatorul sub care se face conexiunea nu are suficiente privilegii pentru această acțiune — conectorul va ieși cu o eroare;-
transformsdefinește cum să modificăm numele subiectului țintă:-
transforms.AddPrefix.typeindică faptul că vom folosi expresii regulate; -
transforms.AddPrefix.regex— masca pe care se redefinește numele subiectului țintă; -
transforms.AddPrefix.replacement— direct ceea ce redefinim.
-
Aflați mai multe despre heartbeat și transforms
În mod implicit, conectorul trimite date în Kafka pentru fiecare tranzacție confirmată, iar LSN-ul său (Log Sequence Number) este înregistrat într-un subiect de serviciu offset. Dar ce se întâmplă dacă conectorul este configurat să citească nu întreaga bază de date, ci doar o parte a tabelelor sale (în care actualizarea datelor nu se întâmplă frecvent)?
- Conectorul va citi fișierele WAL și nu va descoperi nicio confirmare a tranzacțiilor în tabelele pe care le urmărește.
- De aceea, el nu va actualiza poziția sa curentă nici în subiect, nici în slotul de replicare.
- Aceasta, la rândul său, va conduce la „retenția” fișierelor WAL pe disc și la posibilitatea epuizării întregului spațiu de stocare.
Și aici intervin opțiunile heartbeat.interval.ms și heartbeat.action.query. Utilizarea acestor opțiuni împreună permite efectuarea unei interogări de modificare a datelor într-o tabelă separată de fiecare dată când se trimite un mesaj heartbeat. Astfel, LSN-ul la care se află acum conectorul (în slotul de replicare) este mereu actualizat. Aceasta permite SGBD-ului să elimine fișierele WAL, care nu mai sunt necesare. Pentru a afla mai multe despre funcționarea opțiunilor, puteți consulta .
O altă opțiune, care merită o atenție mai atentă, este transforms. Deși este mai mult despre comoditate și estetică…
Implicit, Debezium crée des sujets en se basant sur la politique de nommage suivante : serverName.schemaName.tableName. Cela n'est pas toujours pratique. Les options transforms permettent de définir à l'aide d'expressions régulières la liste des tables dont les événements doivent être routés vers un sujet avec un nom spécifique.
Dans notre configuration, grâce à En conclusion de la description de la configuration du connecteur pour PostgreSQL, il convient de parler des caractéristiques/limitations suivantes de son fonctionnement : Alors, téléchargeons notre configuration dans le connecteur : Vérifions que le téléchargement a réussi et que le connecteur a démarré : Super : il est configuré et prêt à fonctionner. Maintenant, faisons semblant d'être un consommateur et connectons-nous à Kafka, puis ajoutons et modifions une entrée dans la table : Dans notre sujet, cela apparaîtra comme suit : Un JSON très long avec nos modifications În ambele cazuri, înregistrările constau din cheia înregistrării (PK) care a fost modificată și esența modificărilor: cum era înregistrarea înainte și cum a devenit după. Acest conector utilizează mecanismul standard de replicare MongoDB, citind informațiile din oplog-ul nodului primar al SGBD-ului. Similar cu conectorul descris anterior pentru PgSQL, aici, de asemenea, la prima pornire se face un snapshot primar al datelor, după care conectorul trece în modul de citire a oplog-ului. Exemplu de configurare: După cum se poate observa, nu există opțiuni noi în comparație cu exemplul anterior, însă s-au redus doar numărul de opțiuni care se ocupă de conectarea la baza de date și prefixele acestora. Setări Întrebarea disponibilității și a accesibilității ridicate este mai actuală ca niciodată — mai ales când vorbim despre date și tranzacții, iar urmărirea modificărilor de date nu stă deoparte în această privință. Să analizăm ce ar putea merge prost și ce se va întâmpla cu Debezium în fiecare dintre aceste cazuri. Există trei variante de eșec: Cu toate acestea, există excepții. Dacă conectorul a fost într-o stare deconectată pentru o perioadă lungă (sau nu a putut să se conecteze la instanța MongoDB), iar oplog-ul a fost rotit în această perioadă, la restabilirea conexiunii, conectorul va continua să citească datele de la prima poziție disponibilă, ceea ce va duce la pierderi de date în Kafka. nu Au apărut. Debezium este prima mea experiență cu sistemele CDC și, în general, una foarte pozitivă. Proiectul m-a impresionat prin suportul pentru principalele SGBD-uri, simplitatea configurației, suportul pentru clusterizare și comunitatea activa. Recomand celor interesați să studieze ghidurile pentru și . Comparativ cu conectorul JDBC pentru Kafka Connect, principalul avantaj al Debezium este că modificările sunt citite din jurnalele SGBD-ului, ceea ce permite obținerea datelor cu o întârziere minimă. Conectorul JDBC (din livrarea Kafka Connect) face interogări asupra tabelului monitorizat la intervale fixe și (din același motiv) nu generează mesaje atunci când datele sunt șterse (cum poți interoga date care nu există?). Pentru a rezolva probleme asemănătoare, se pot lua în considerare următoarele soluții (în afară de Debezium): Citiți și în blogul nostru: Sursa: habr.comtransforms ceci se produit : tous les événements CDC de la base de données surveillée seront envoyés dans un sujet nommé data.cdc.dbname. Sinon (sans ces paramètres), Debezium créerait par défaut un sujet pour chaque table du type : pg-dev.public..
Restrictions du connecteur
Application de la configuration
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date : Thu, 17 Sep 2020 20:19:40 GMT
Content-Type : application/json
Content-Length : 175
Server : Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: valoarea înainte de (before) este egală null, iar după — este un șir care a fost inserat. UPDATE: în payload.before se afișează starea anterioară a înregistrării, iar în payload.after — noul cu esența modificărilor.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms în acest caz se face următoarele: se transformă numele subiectului țintă din schema .. în data.cdc.mongo_.Redundanță
Concluzie
P.S.
