

Cum își dă seama un dezvoltator backend că o interogare SQL va funcționa bine în producție? În companiile mari sau în cele în creștere rapidă, accesul la producție nu este disponibil pentru toată lumea. Și chiar și cu acces, nu toate interogările pot fi verificate fără probleme, iar crearea unei copii a bazei de date durează uneori ore. Pentru a rezolva aceste probleme, am creat un DBA artificial - Joe. El a fost deja implementat cu succes în mai multe companii și ajută nu doar câțiva zeci de dezvoltatori.
Video:
Salutare tuturor! Mă numesc Anatoliy Stansler. Lucrez pentru compania . Ne ocupăm de accelerarea procesului de dezvoltare, eliminând întârzierile asociate cu utilizarea Postgres de către dezvoltatori, DBA și QA.
Avem clienți extraordinari și astăzi o parte din prezentare va fi dedicată cazurilor pe care le-am întâlnit lucrând cu ei. Voi povesti despre cum i-am ajutat să rezolve probleme destul de serioase.
Când facem dezvoltare și realizăm migrații complexe și solicitante, ne punem întrebarea: „Va funcționa această migrație?”. Folosim review-uri, ne bazăm pe cunoștințele colegilor mai experimentați și pe experții DBA. Iar ei ne pot spune - va funcționa sau nu.
Dar, poate ar fi fost mai bine dacă am fi putut testa singuri asta pe copii complete. Astăzi vom discuta despre ce abordări există acum pentru testare și cum putem face acest lucru mai bine, precum și ce instrumente putem folosi. De asemenea, vom discuta despre avantajele și dezavantajele acestor abordări și ce putem îmbunătăți aici.
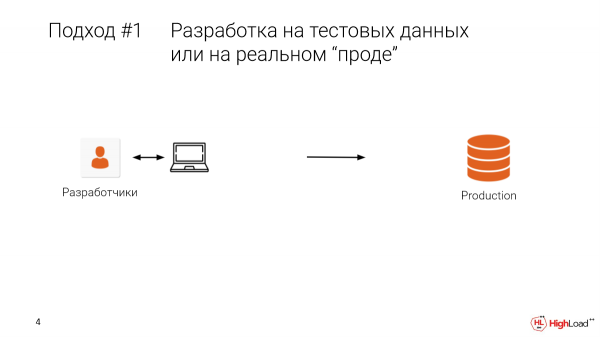
Cine a făcut vreodată indecși sau a adus modificări direct în producție? Destul de multă lume. Și câți au întâmpinat probleme de pierdere a datelor sau timp de inactivitate? Atunci sunteți familiarizați cu această durere. Slavă Domnului, avem backup-uri.
Prima abordare - este testarea în producție. Sau, când dezvoltatorul lucrează de pe un calculator local, are date de testare, există un eșantion limitat. Și noi lansăm în producție, iar situația se prezintă astfel.
Este dureros, este costisitor. Probabil că așa nu ar trebui să facem.
Dar cum să facem mai bine?
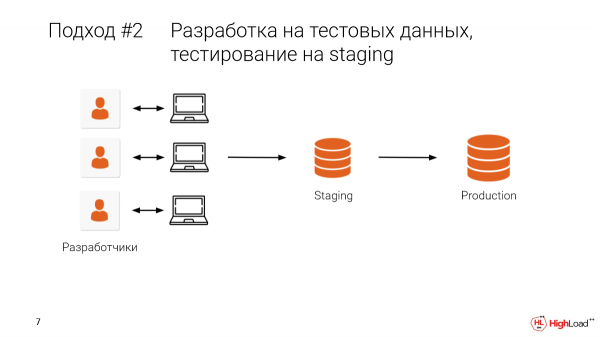
Să luăm un staging și să alocăm o parte din producție acolo. Sau, în cel mai bun caz, să folosim producția reală, toate datele. Iar după ce am dezvoltat local, vom verifica și pe staging.
Aceasta ne va permite să eliminăm o parte din erori, adică să nu le permitem în producție.
Ce probleme există?
- Problema este că acest staging îl împărțim cu colegii. Și foarte des se întâmplă că faci o modificare, bum – și nu mai ai date, munca este în zadar. Staging-ul a fost de câteva terabaiți. Și trebuie să aștepți mult timp până când se ridică din nou. Și decidem să lucrăm la asta mâine. Asta e, dezvoltarea s-a oprit.
- Și, desigur, avem mulți colegi acolo, multe echipe. Și trebuie să ne coordonăm manual. Asta este incomod.
Și trebuie să spunem că avem doar o singură încercare, un singur șut, dacă vrem să facem vreo modificare în baza de date, să ne atingem datele, să schimbăm structura. Și dacă ceva nu merge bine, dacă a fost o eroare în migrare, atunci nu ne mai putem întoarce rapid.
Este mai bine decât abordarea anterioară, dar totuși există o mare probabilitate ca o eroare să ajungă în production.
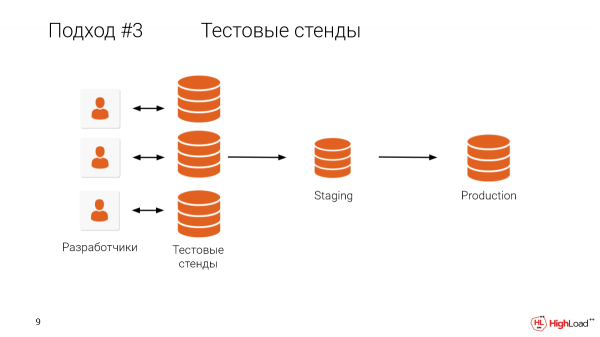
Ce ne împiedică să dăm fiecărui dezvoltator un mediu de testare, o copie de dimensiuni complete? Cred că este clar ce ne oprește.
Cine are o bază de date mai mare de un terabyte? Mai mult decât jumătate din sală.
Și este clar că a avea mașini pentru fiecare dezvoltator, când production-ul este atât de mare, este foarte scump și, în plus, durează mult.
Avem clienți care au realizat că este foarte important să testeze toate modificările pe copii de dimensiuni complete, dar baza lor este mai mică de un terabyte, iar resursele pentru a avea un mediu de testare pentru fiecare dezvoltator nu există. Așadar, trebuie să descarce dumpuri local pe mașina lor și să testeze în acest mod. Asta durează mult timp.
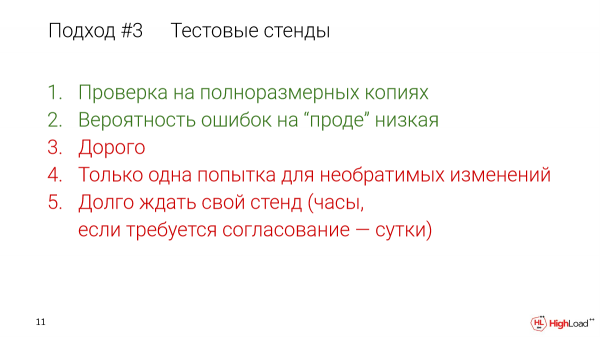
Chiar și dacă faci asta în cadrul infrastructurii, să descarci un terabyte de date într-o oră – este deja foarte bine. Dar ei folosesc dumpuri logice, descarcă local din cloud. Pentru ei, viteza este de aproximativ 200 de gigabytes pe oră. Și mai este nevoie de timp pentru a restaura din dumpul logic, a aplica indecșii etc.
Dar ei folosesc această abordare pentru că permite menținerea prod-ului de încredere.
Ce putem face aici? Haideți să facem astfel încât mediile de testare să fie ieftine și să oferim fiecărui dezvoltator propriul său mediu de testare.
Și asta este posibil.
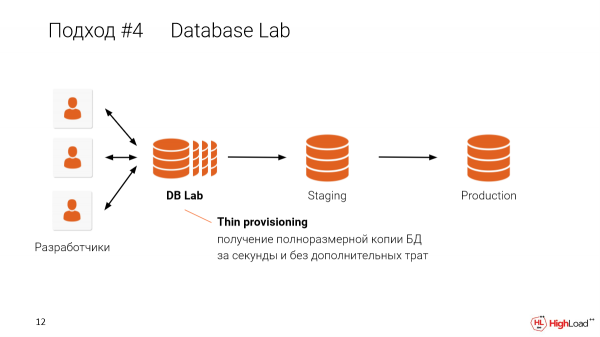
Și în această abordare, când facem clone subțiri pentru fiecare dezvoltator, putem partaja asta pe o singură mașină. De exemplu, dacă aveți o bază de date de patru terabytes și doriți să o oferiți 10 dezvoltatori, nu trebuie să aveți 10 x patru terabytes de baze de date. Este suficient să aveți o singură mașină pentru a crea copii subțiri izolate pentru fiecare dezvoltator, folosind o singură mașină. Cum funcționează, voi explica puțin mai târziu.
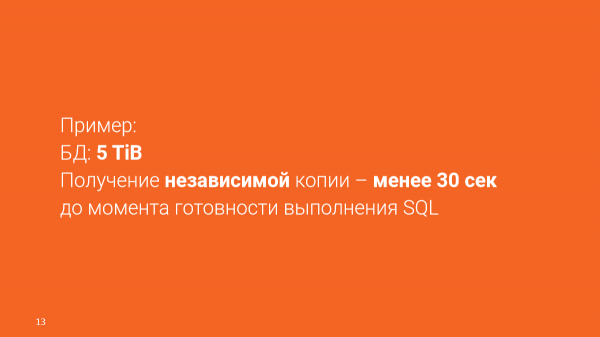
Un exemplu real:
Baza de date – 4,5 terabytes.
Putem obține copii independente în 30 de secunde.
Nu trebuie să așteptați un mediu de testare și să depindeți de dimensiunea acestuia. Puteți să-l obțineți în câteva secunde. Acesta va fi un mediu complet izolat, dar care împarte datele între ele.
Este grozav. Aici vorbim despre magie și o univers paralel.
În cazul nostru, acest lucru funcționează cu ajutorul sistemului OpenZFS.
OpenZFS este un sistem de fișiere copy-on-write care suportă din cutie instantanee și clone. Este fiabil și scalabil. Este foarte ușor de gestionat. Poate fi desfășurat în doar două comenzi.
Există și alte opțiuni:
LVM,
Sisteme de stocare (de exemplu, Pure Storage).
Database Lab, despre care vorbesc, este modular. Poate fi implementat folosind astfel de opțiuni. Dar momentan ne-am concentrat pe OpenZFS, deoarece am avut probleme specifice cu LVM.
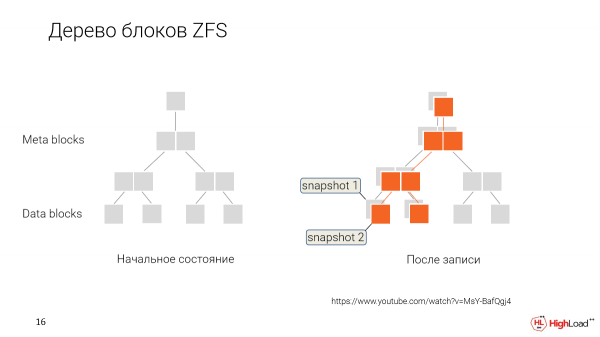
Cum funcționează? În loc să rescriem datele de fiecare dată când le modificăm, le stocăm, pur și simplu marcând că aceste date noi se referă la un nou moment în timp, la o nouă instantanee.
Și mai departe, când dorim să revenim sau să facem o nouă clonă dintr-o versiune mai veche, spunem doar: 'Ok, dați-ne aceste blocuri de date, care sunt marcate astfel'.
Și acest utilizator va lucra cu un astfel de set de date. Le va schimba treptat, făcând propriile sale instantanee.
Și vom avea ramificare. Fiecare dezvoltator va avea în cazul nostru posibilitatea de a avea propria clonă pe care o editează, iar datele care sunt comune vor fi partajate între toți.
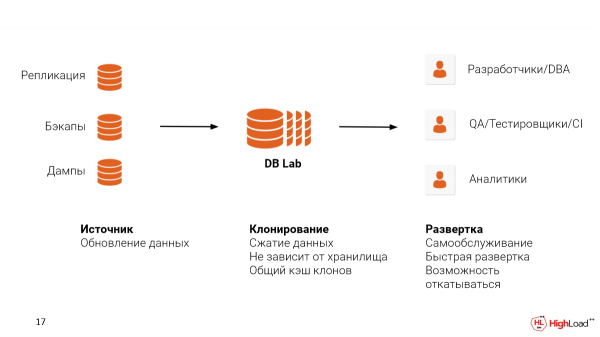
Pentru a desfășura un astfel de sistem, trebuie să rezolvați două probleme:
Primul este sursa de date de unde le vei prelua. Poți configura replicarea cu producția. Poți folosi deja backup-urile pe care le ai configurate, sper. WAL-E, WAL-G sau Barman. Și chiar dacă folosești o soluție Cloud, de exemplu, RDS sau Cloud SQL, poți folosi dump-uri logice. Totuși, îți recomandăm să folosești backup-uri, deoarece prin această abordare vei păstra și structura fizică a fișierelor, ceea ce va permite să fii mai aproape de metricile pe care le-ai vedea în producție, pentru a identifica problemele existente.
Al doilea este locul unde dorești să găzduiești Database Lab. Poate fi Cloud, poate fi On-premise. Aici este important să menționăm că ZFS suportă comprimarea datelor. Și o face destul de bine.
Imaginează-ți că fiecare astfel de clonă, în funcție de operațiile pe care le facem cu baza, va crește un anumit dev. Pentru acest dev va fi nevoie de spațiu. Dar datorită faptului că am preluat o bază de 4,5 terabyte, ZFS o va comprima la 3,5 terabyte. În funcție de setări, aceasta poate varia. Și ne va rămâne și spațiu pentru dev.
Un astfel de sistem poate fi utilizat pentru diferite cazuri de utilizare.
Acesta este pentru dezvoltatori, DBA pentru verificarea interogarilor, pentru optimizare.
Acest lucru poate fi folosit în testarea QA pentru a verifica o migrație specifică înainte de a o implementa în producție. De asemenea, putem crea medii speciale pentru QA cu date reale, unde pot testa noi funcționalități. Și acest lucru va dura câteva secunde în loc să aștepți ore, sau poate zile în alte cazuri, unde nu sunt utilizate copii subțiri.
Și un alt caz distinct. Dacă compania nu are un sistem de analiză configurat, putem crea un clon subțire al bazei de date a produsului și să o alocăm pentru interogări lungi sau pentru indecși speciali care pot fi utilizați în analiză.
Cu această abordare:
Probabilitate scăzută de erori în producție, deoarece toate modificările au fost testate pe date complete.
Apare o cultură a testării, deoarece acum nu mai trebuie să aștepți ore întregi pentru propriul tău mediu.
Și nu există obstacole, nu există așteptări între teste. Poți efectiv să te duci și să verifici. Și va fi mai bine, deoarece vom accelera dezvoltarea.
Vor fi mai puține refactorizări. Vor exista mai puține erori care ajung în prod. Le vom refactoriza mai puțin apoi.
Putem inversa modificările ireversibile. Acest lucru nu există în abordările standard.
- Este avantajoso, deoarece împărțim resursele mediilor de testare.
E bine deja, dar ce altceva am putea accelera?
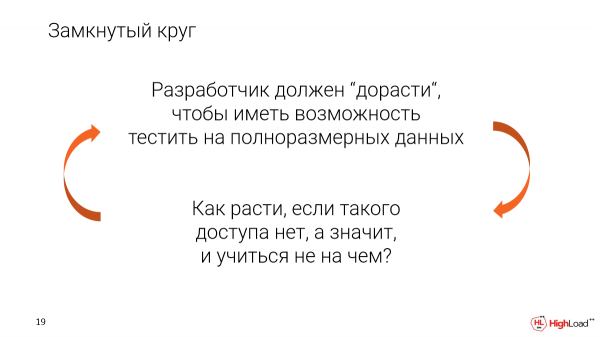
Datorită acestui sistem, putem reduce semnificativ pragul de admitere în acest tip de testare.
Acum există un cerc vicios, unde dezvoltatorul trebuie să devină expert pentru a avea acces la date reale de dimensiuni complete. Trebuie să i se acorde încrederea pentru acest acces.
Dar cum poți crește dacă nu există. Și ce se întâmplă dacă ai acces doar la un set foarte mic de date de testare? Atunci nu vei putea obține experiență reală.
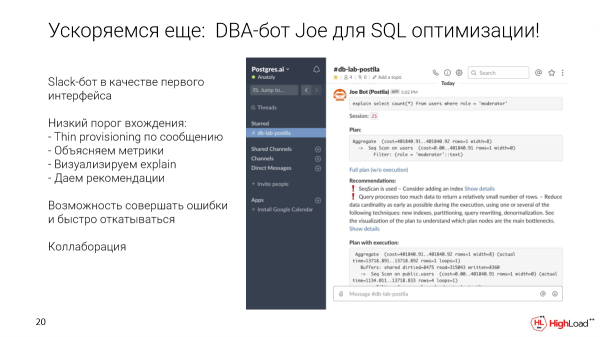
Cum putem ieși din acest cerc? Ca prim interfață, convenabilă pentru dezvoltatori de orice nivel, am ales un bot Slack. Dar aceasta poate fi orice altă interfață.
Ce permite să facă? Poți lua o interogare specifică și să o trimiți într-un canal special pentru baza de date. Vom desfășura automat în câteva secunde un clone subțire. Vom rula această interogare. Vom colecta metrici și recomandări. Vom arăta vizualizări. Iar acest clone va rămâne pentru ca interogarea să poată fi optimizată, adăugat indecși etc.
De asemenea, Slack ne oferă posibilități de colaborare din cutie. Deoarece este pur și simplu un canal, poți începe discuția despre această interogare direct în thread, să-ți ping-uiești colegii, DBA-ii care sunt în companie.
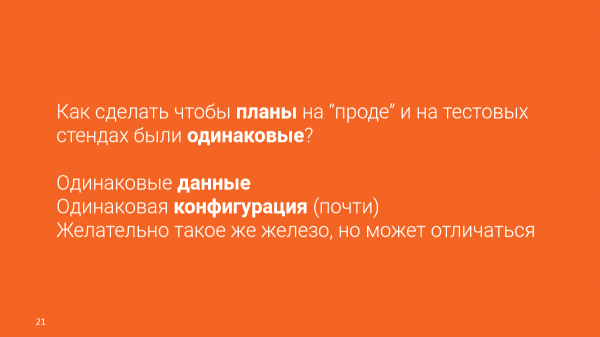
Dar, desigur, există și probleme. Deoarece acesta este lumea reală și folosim un server pe care găzduim multe clone, trebuie să comprimăm cantitatea de memorie și puterea de procesare disponibile clonelor.
Dar pentru ca aceste teste să fie credibile, trebuie cumva să rezolvăm această problemă.
Este clar că un aspect important sunt datele identice. Dar asta avem deja. Și vrem să obținem o configurație identică. Și putem oferi o configurație aproape identică.
Ar fi grozav să avem același hardware ca în producție, dar poate diferi.
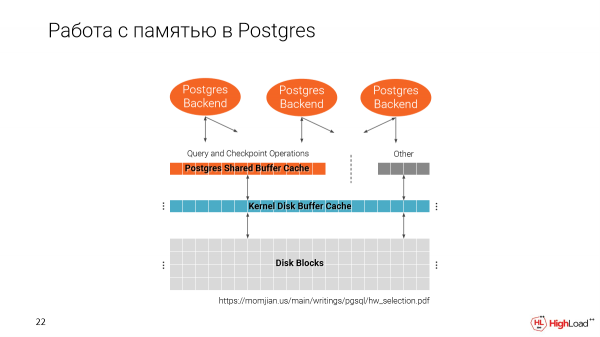
Să ne aducem aminte cum funcționează Postgres cu memoria. Avem două cache-uri. Unul de la sistemul de fișiere și unul propriu Postgres, adică Shared Buffer Cache.
Este important de menționat că Shared Buffer Cache este alocat la pornirea Postgres în funcție de dimensiunea pe care o setați în configurație.
Și al doilea cache folosește tot spațiul disponibil.
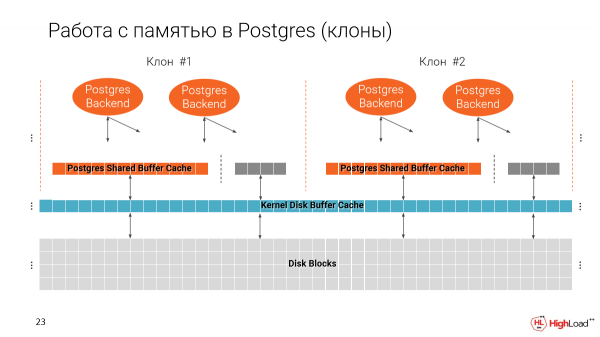
Și când facem mai multe clone pe aceeași mașină, ajungem să umplem treptat memoria. Din punct de vedere ideal, Shared Buffer Cache ar trebui să fie 25% din întreaga memorie disponibilă pe mașină.
Astfel, dacă nu vom schimba acest parametru, vom putea rula doar 4 instanțe pe aceeași mașină, adică 4 astfel de clona subțire. Și aceasta, desigur, este o problemă, deoarece ne dorim să avem mult mai multe.
Dar, pe de altă parte, Buffer Cache este folosit pentru executarea interogărilor, pentru indici, adică planul depinde de dimensiunea cache-urilor noastre. Și dacă vom reduce acest parametru fără o justificare, planurile noastre se pot schimba semnificativ.
De exemplu, dacă avem un cache mare în productie, Postgres va prefera să folosească indicele. Dar dacă nu, atunci va utiliza SeqScan. Și care ar fi sensul, dacă planurile noastre nu s-ar potrivi?
Dar ajungem la concluzia că planul în Postgres nu depinde de dimensiunea specifică setată în Shared Buffer, ci de effective_cache_size.
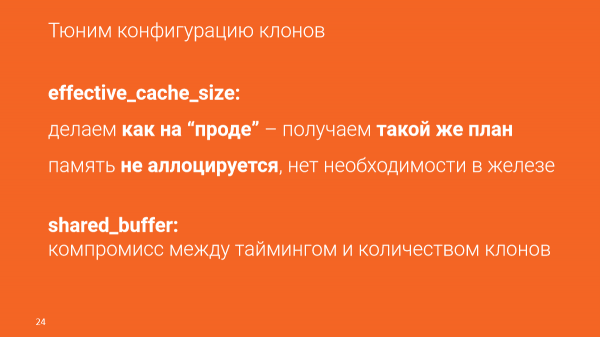
Effective_cache_size reprezintă volumul estimat al cache-ului disponibil, adică suma dintre Buffer Cache și cache-ul sistemului de fișiere. Acesta este setat prin configurație. Și această memorie nu este alocată.
Și prin acest parametru putem, într-un fel, înșela Postgres, spunându-i că avem de fapt acces la multe date, chiar dacă nu avem acele date. Astfel, planurile vor coincide complet cu cele din producție.
Însă, acest lucru poate afecta timpii. Și optimizăm interogările pe baza timpurilor, dar este important de menționat că timpii depind de mulți factori:
Depinde de sarcina care există în prezent pe mediu de producție.
Depinde de caracteristicile mașinii în sine.
Și acest parametru este indirect, dar în realitate putem optimiza în funcție de cantitatea de date pe care această interogare le va citi pentru a obține rezultatul.
Și dacă vrem ca temporizarea să fie apropiată de ceea ce vom vedea în prod, atunci trebuie să luăm hardware cât mai asemănător și, poate, chiar mai mult, pentru a putea găzdui toate clonele. Dar aceasta este un compromis, adică veți obține aceleași planuri, veți vedea cât de multe date citeste un anumit query și veți putea concluziona - acest query este bun (sau migrarea) sau este rău, trebuie optimizat mai departe.
Să discutăm despre cum anume se desfășoară optimizarea cu Joe.
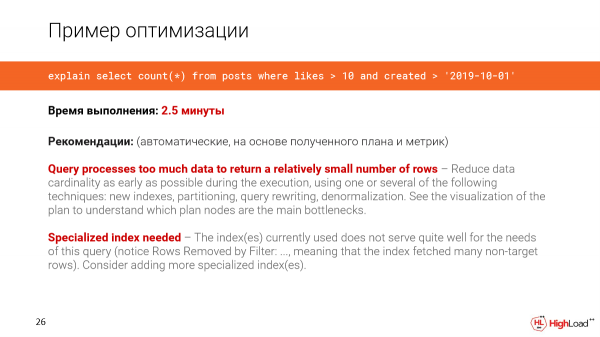
Să luăm o interogare dintr-un sistem real. În acest caz, baza de date este de 1 terabyte. Și vrem să calculăm numărul de postări noi care au avut mai mult de 10 like-uri.
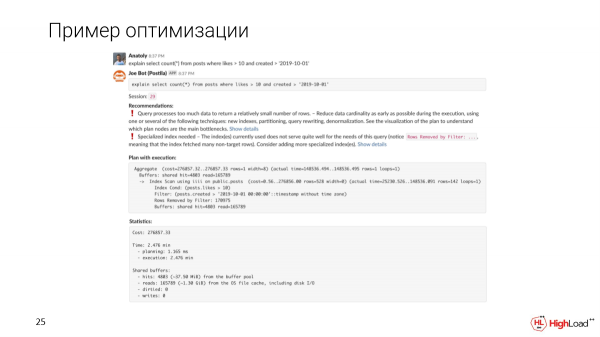
Trimițăm un mesaj în canal, s-a deschis pentru noi o clonă. Și vom vedea că o astfel de interogare va rula în 2,5 minute. Acesta este primul lucru pe care îl vom observa.
Joe va arăta recomandări automate, bazate pe plan și metrici.
Vom observa că interogarea procesează prea multe date pentru a obține un număr relativ mic de rânduri. Și este nevoie de un index specializat, deoarece am observat că interogarea are prea multe rânduri filtrate.
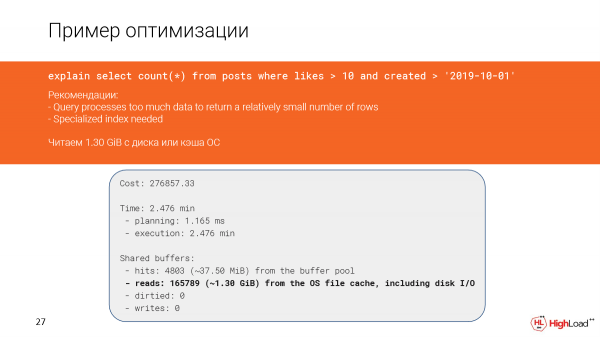
Să ne uităm mai în detaliu la ce s-a întâmplat. De fapt, vedem că am citit aproape un terabyte și jumătate de date din cache-ul de fișiere sau chiar de pe disc. Și aceasta nu este bine, deoarece am obținut doar 142 de rânduri.
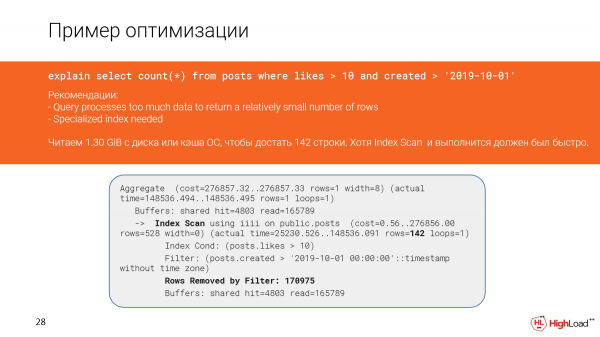
Și, se părea că avem un index scan și ar fi trebuit să funcționeze rapid, dar, deoarece am filtrat prea multe rânduri (a trebuit să le numărăm), interogarea a fost lentă.
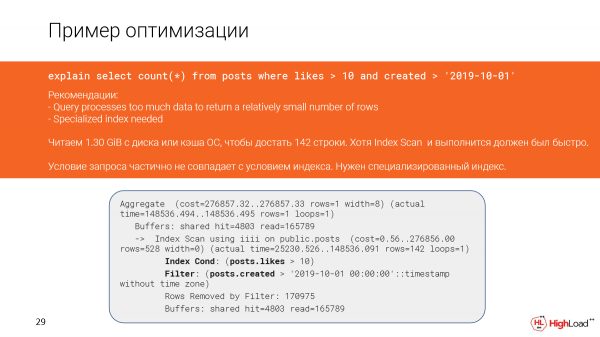
Și aceasta s-a întâmplat în plan din cauza faptului că condițiile din interogare și cele din index nu coincid parțial.
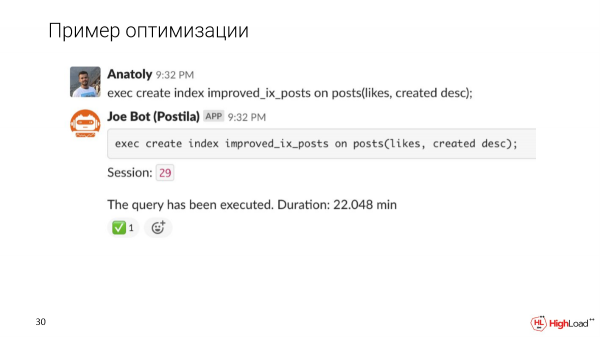
Să încercăm să facem indexul mai precis și să vedem cum se va schimba execuția interogării după aceasta.
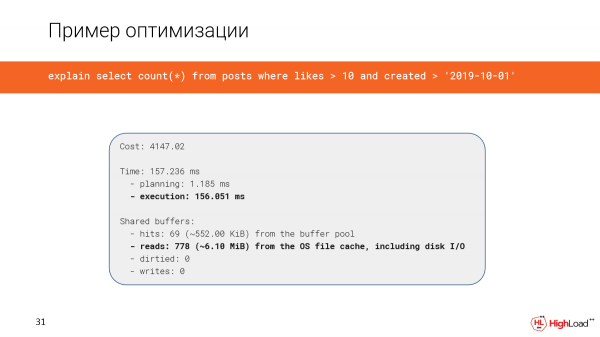
Crearea indexului a durat destul de mult, dar acum verificăm interogarea și vedem că timpul, în loc de 2,5 minute, a devenit doar 156 de milisecunde, ceea ce este foarte bine. Și citim doar 6 megabyte de date.
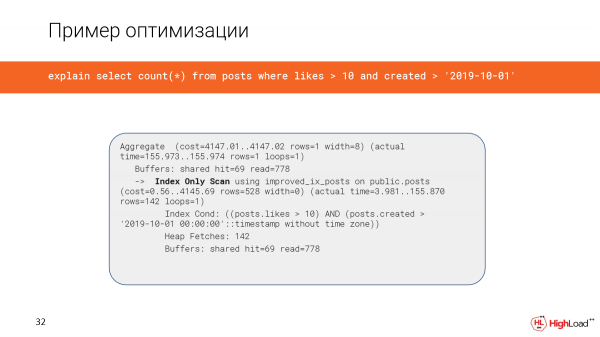
Și acum folosim index only scan.
O altă poveste importantă este că vrem să prezentăm planul într-un mod mai ușor de înțeles. Am implementat o vizualizare folosind Flame Graphs.
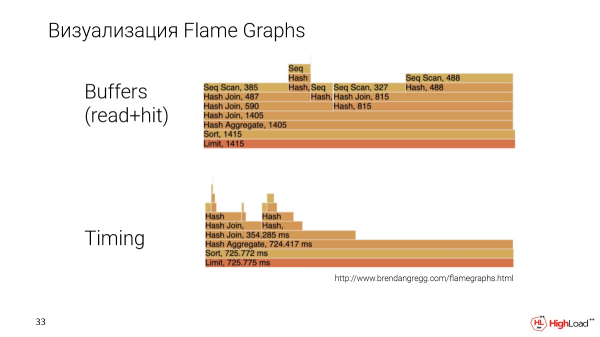
Aceasta este o altă interogare, mai complexă. Și construim Flame Graphs pe baza a două parametrii: cantitatea de date pe care un anumit nod din plan a citit-o și temporizarea, adică timpul de execuție al nodului.
Aici putem compara nodurile între ele. Va fi clar care dintre ele ocupă mai mult sau mai puțin, ceea ce este de obicei greu de făcut în alte metode de vizualizare.
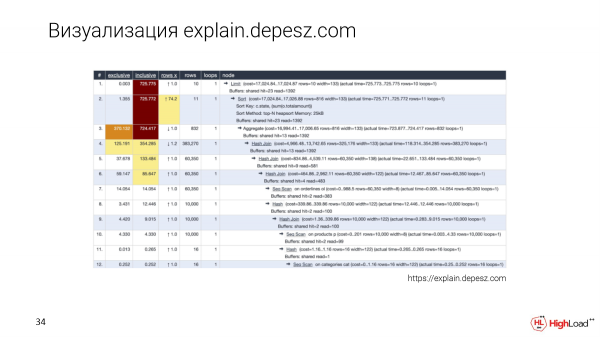
Desigur, toată lumea știe de explain.depesz.com. O caracteristică bună a acestei vizualizări este că păstrăm planul text și de asemenea scoatem câteva parametrii principali în tabel, pentru a putea sorta.
Și dezvoltatorii care nu s-au adâncit încă în acest subiect folosesc explain.depesz.com, pentru că le este mai ușor să înțeleagă ce metrici sunt importante și care nu.
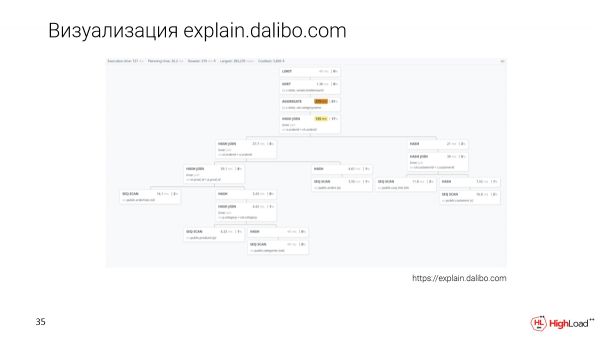
Există o nouă abordare pentru vizualizare – aceasta este explain.dalibo.com. Ei fac o vizualizare în formă de arbore, dar aici este foarte greu de comparat nodurile între ele. Aici poți să înțelegi bine structura, dar dacă va fi o cerere mare, va trebui să derulezi în sus și în jos, dar este, de asemenea, o variantă.
Colaborare
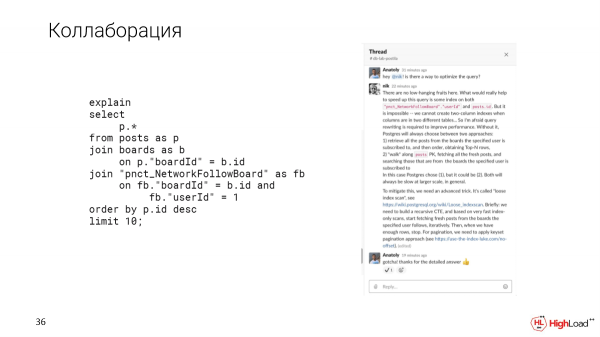
Și, așa cum am spus, Slack ne oferă posibilitatea de colaborare. De exemplu, dacă întâlnim o cerere complexă, pe care nu știm cum să o optimizăm, putem clarifica această întrebare în thread-ul din Slack cu colegii noștri.
Ni se pare că este important să testăm pe date de dimensiuni reale. Pentru asta am creat instrumentul Update Database Lab, care este disponibil în open source. Puteți folosi și botul Joe. Îl puteți lua chiar acum și implementa la voi. Toate ghidurile sunt disponibile acolo.
De asemenea, este important de menționat că soluția în sine nu este revoluționară, pentru că există Delphix, dar aceasta este o soluție enterprise. Este complet închisă, costă foarte mult. Noi ne specializăm pe Postgres. Toate acestea sunt produse open source. Alăturați-vă nouă!
Aici închei. Vă mulțumesc!
Întrebări
Bună ziua! Vă mulțumesc pentru prezentare! Foarte interesant, mai ales pentru mine, deoarece am rezolvat o problemă similară acum ceva timp. Așadar, am o serie întreagă de întrebări. Sper că voi reuși să pun măcar o parte dintre ele.
Este interesant cum calculați spațiul pentru acest mediu? Tehnologia presupune că, în anumite circumstanțe, clonele dvs. pot crește până la dimensiunea maximă. Cu alte cuvinte, dacă aveți o bază de date de zece terabytes și 10 clone, este ușor să simulați o astfel de situație, în care fiecare clonă va cântări 10 date unice. Cum calculați acest spațiu, adică acel delta despre care ați vorbit, în care vor trăi aceste clone?
O întrebare bună. Aici este important să monitorizăm clonele specifice. Dacă o clonă suferă o modificare prea mare și începe să crească, putem să-i dăm inițial un avertisment utilizatorului despre aceasta sau să o oprim imediat, pentru a evita o situație de eșec.
Da, am o întrebare suplimentară. Adică, cum asigurați ciclul de viață al acestor module? Este o problemă pentru noi și o întreagă poveste separată. Cum se desfășoară acest proces?
Fiecare clonă are un ttl. În principiu, avem un ttl fixat.
Care este, dacă nu este un secret?
1 oră, adică idle – 1 oră. Dacă nu este folosit, îl eliminăm. Dar nu este nimic surprinzător aici, deoarece putem ridica o clonă în câteva secunde. Și dacă va fi din nou necesară, ei bine, să fie.
Sunt interesat și de alegerea tehnologiilor, deoarece, de exemplu, utilizăm în paralel mai multe metode din diverse motive. De ce anume ZFS? De ce nu ați folosit LVM? Ați menționat că au fost probleme cu LVM. Ce probleme au fost? Din punctul meu de vedere, opțiunea cu SCD este cea mai optimă din perspectiva performanței.
Care este problema principală cu ZFS? Întrucât trebuie să rulezi pe un singur host, adică toate instanțele vor trăi în cadrul unui singur sistem de operare. În cazul SCD, poți conecta diverse echipamente. Iar punctul slab sunt doar acele blocuri care sunt pe SCD. Și este interesantă întrebarea privind alegerea tehnologiilor. De ce nu LVM?
Despre LVM putem discuta la meetup. Despre SCD – este pur și simplu costisitor. Sistemul ZFS poate fi implementat oriunde. Poți să-l desfășori pe mașina ta. Poți pur și simplu să descarci repository-ul și să-l desfășori. ZFS se instalează practic peste tot, dacă vorbim despre Linux. Adică, obținem o soluție foarte flexibilă. Și ZFS în sine oferă foarte multe din cutie. Poți să încarci cât mai multe date, să conectezi un număr mare de disk-uri, există snapshot-uri. Și, așa cum am spus anterior, este foarte simplu de administrat. Adică, pare foarte plăcut de utilizat. Este testat, are mulți ani. Are o comunitate foarte mare, care crește. ZFS este o soluție foarte fiabilă.
Nikolay Samokhvalov: Pot să adaug și eu un comentariu? Mă numesc Nikolay, lucrăm împreună cu Anatoly. Sunt de acord că SCD este grozav. Și unii dintre clienții noștri au Pure Storage etc.
Anatolie a remarcat corect că ne concentrăm pe modularitate. Și în viitor putem implementa o singură interfață – fă un snapshot, fă un clon, distruge clonul. Toate acestea sunt ușor de realizat. Iar stocarea este excelentă, dacă există.
Dar ZFS este accesibil tuturor. Deja este suficient cu Delphix, au 300 de clienți. Dintre aceștia, în Fortune 100 - 50 de clienți, adică sunt concentrați pe NASA etc. Este timpul ca toată lumea să aibă acces la această tehnologie. Și de aceea avem Core open source. Avem o parte de interfață, care nu este open source. Aceasta este platforma pe care o vom prezenta. Dar vrem să fie accesibilă tuturor. Vrem să facem o revoluție, astfel încât toți testorii să nu mai ghicească pe laptop-uri. Trebuie să scriem SELECT și să vedem imediat că este lent. Să nu mai așteptăm ca DBA-ul să ne spună despre asta. Asta este principalul obiectiv. Și cred că vom ajunge acolo. Și acest lucru îl facem să fie disponibil pentru toți. De aceea ZFS, pentru că va fi disponibil peste tot. Mulțumesc comunității pentru soluționarea problemelor și pentru că avem licență open source etc.
Salut! Mulțumesc pentru prezentare! Mă numesc Maxim. Noi am rezolvat aceleași probleme. La noi le-am rezolvat. Cum împărțiți resursele între aceste clone? Fiecare clonă poate în fiecare moment să se ocupe de propriile sarcini: unul testează ceva, altul altceva, cineva își construiește indexul, altcineva are un job greu de procesat. Și dacă pentru CPU mai putem împărți, cum faceți cu IO? Aceasta este prima întrebare.
Și a doua întrebare este despre diferențele dintre medii. Să presupunem că aici am ZFS și totul este grozav, iar clientul meu în producție nu are ZFS, ci ext4, de exemplu. Ce se întâmplă în acest caz?
Întrebările sunt foarte bune. Am menționat puțin această problemă cu împărțirea resurselor. Iar soluția constă în următoarele. Imaginează-ți că testezi pe staging. Poate la tine să fie aceeași situație, că cineva generează o sarcină, altcineva o altă sarcină. Și în cele din urmă vezi metrici confuze. Chiar o astfel de problemă poate apărea și în producție. Când vrei să verifici o anumită interogare și vezi că are o problemă – că rulează lent, de fapt problema nu era în interogare, ci în faptul că există o sarcină paralelă.
Așadar, este important să ne concentrăm asupra planului, pașii pe care îi vom urma și cât de multe date vom aduna pentru asta. Faptul că discurile noastre, de exemplu, vor fi încărcate cu ceva, va afecta în mod specific timpul. Dar putem evalua încărcătura acestei cereri în funcție de cantitatea de date. Nu este atât de important că, în același timp, va avea loc o altă execuție.
Am două întrebări. Este o chestie foarte tare. Au existat cazuri în care datele în producție au fost critice, de exemplu, numerele cardurilor de credit? Există deja ceva pregătit sau este o sarcină separată? Și a doua întrebare – există ceva similar pentru MySQL?
Referitor la date. Vom face obfuscare, deocamdată nu facem asta. Dar dacă desfășurați tocmai Joe, dacă nu oferiți acces dezvoltatorilor, atunci nu există acces la date. De ce? Pentru că Joe nu afişează datele. El arată doar metricile, planurile și atât. A fost făcut așa special, deoarece este una dintre cerințele clientului nostru. Au vrut să aibă posibilitatea de a optimiza, dar fără a oferi acces tuturor.
Despre MySQL. Acest sistem poate fi folosit pentru orice, ce stochează starea pe disc. Și cum ne ocupăm de Postgres, în acest moment facem prioritar întreaga automatizare pentru Postgres. Vrem să automatizăm obținerea datelor din backup. Configurăm corect Postgres. Știm cum să ne asigurăm că planurile coincid etc.
Dar, deoarece sistemul este extensibil, va putea fi folosit și pentru MySQL. Și există exemple de acest tip. O soluție similară există la Yandex, dar nu o publică nicăieri. O folosesc în interiorul Yandex.Metrica. Și acolo este vorba despre povestea MySQL. Dar tehnologia este aceeași, ZFS.
Mulțumesc pentru prezentare! Am și eu câteva întrebări. Ați menționat că clonarea poate fi folosită pentru analiză, de exemplu, pentru a construi indecși suplimentari. Puteți să ne spuneți mai multe despre cum funcționează asta?
Și voi pune imediat a doua întrebare despre uniformitatea standurilor, uniformitatea planurilor. Planul depinde, de asemenea, de statistica adunată de Postgres. Cum rezolvați această problemă?
Nu avem analize pentru cazuri specifice, deoarece nu le-am folosit încă în acest fel, dar există această posibilitate. Dacă discutăm despre indecși, imaginați-vă că o interogare este executată pe un tabel cu sute de milioane de înregistrări și pe o coloană care, în mod obișnuit, nu este indexată în producție. Și vrem să calculăm anumite date. Dacă acestă interogare este executată în producție, există riscul ca în producție să existe latență, deoarece interogarea va dura un minut pentru a se procesa.
Ok, haideți să facem un clon subțire, care nu este periculos să fie oprit câteva minute. Și pentru a ne facilita analiza, vom adăuga indecși pe coloanele care ne interesează.
Indexul va fi creat de fiecare dată?
Se poate face astfel încât să manipulăm datele, să facem snapshot-uri, iar apoi să ne restabilim din acel snapshot și să executăm noi interogări. Adică, se poate face astfel încât să putem ridica noi clone cu indecșii deja setați.
Referitor la întrebarea despre statistici, dacă ne restabilim dintr-un backup, dacă facem replicare, atunci statistica va fi exact aceeași. Deoarece vom aduce toată structura fizică a datelor, adică datele așa cum sunt cu toate metricele statistice.
Aici este o altă problemă. Dacă utilizați o soluție cloud, atunci numai dump-urile logice sunt disponibile, deoarece Google, Amazon nu permit obținerea unei copii fizice. Aceasta va fi o problemă.
Mulțumesc pentru prezentare. Aici au fost ridicate două întrebări bune despre MySQL și despre separarea resurselor. Dar, în esență, totul se reduce la faptul că este o temă legată nu de SGBD-uri specifice, ci, în general, de sistemele de fișiere. Și, prin urmare, problemele de separare a resurselor trebuie să fie rezolvate din acel punct de vedere, nu la final, că este Postgres, ci în sistemul de fișiere, în server, în instanță.
Întrebarea mea este despre altceva. Este mai apropiată de multilayer-ul bazei de date, unde există mai multe straturi. De exemplu, am configurat actualizarea unei imagini de zece terabaiți, avem replicare în curs. Și folosim specific această soluție pentru baze de date. Replicarea se desfășoară, se actualizează datele. Între timp, 100 de angajați lucrează paralel, care rulează constant aceste diferite snapshot-uri. Ce facem? Cum facem să nu existe conflicte, ca ei să fi început una, iar apoi sistemul de fișiere să se schimbe și aceste snapshot-uri să devină incoerente?
Ei nu vor merge, pentru că așa funcționează ZFS. Putem păstra separat într-un singur flux modificările sistemului de fișiere, care vin prin replicare. Și putem păstra clonele pe versiunile anterioare ale datelor, pe care le folosesc dezvoltatorii. Și asta funcționează pentru noi, totul este în regulă.
Deci, actualizarea va avea loc ca un strat suplimentar, iar toate noi instantanee vor fi bazate pe acest strat, nu-i așa?
Din straturile anterioare, care au fost din replicările anterioare.
Straturile anterioare se vor pierde, dar ele vor face referire la stratul vechi, iar noile imagini vor lua de la ultimul strat obținut în actualizare?
În general, da.
Atunci, ca urmare, vom avea foarte multe straturi. Și în timp, va trebui să le comprimăm?
Da, exact. Există o anumită fereastră. Salvăm instantanee săptămânale. Acest lucru depinde de resursa pe care o aveți. Dacă aveți capacitate de stocare mare, puteți păstra instantanee pe o perioadă lungă de timp. Ele nu se vor șterge singure. Nu va exista corupție a datelor. Dacă instantanele sunt depășite, așa cum considerăm noi, adică depinde de politica companiei, atunci le putem șterge pur și simplu și elibera spațiu.
Bună ziua, mulțumesc pentru prezentare! În legătură cu întrebarea lui Joe. Ați spus că clientul nu dorea să ofere acces la date tuturor. Strict vorbind, dacă cineva are rezultatul Explain Analyze, poate să observe datele.
Exact așa. De exemplu, putem scrie: „SELECT FROM WHERE email = cuiva”. Adică, nu vom vedea datele propriu-zise, dar putem observa anumite indicii indirecte. Trebuie să înțelegem asta. Dar, pe de altă parte, totul este vizibil. Avem audit de jurnale, avem controlul altor colegi care vizionează de asemenea ce fac dezvoltatorii. Și dacă cineva încearcă să facă asta, atunci serviciul de securitate va veni să se ocupe de această problemă.
Bună ziua! Mulțumesc pentru prezentare! Am o întrebare scurtă. Dacă în companie nu se folosește Slack, există vreo legătură acum sau se poate desfășura instanțe pentru dezvoltatori pentru a conecta aplicația de testare la baze de date?
În prezent, există o integrare cu Slack, ceea ce înseamnă că nu este disponibil niciun alt messenger, dar ne dorim foarte mult să facem suport pentru alte mesaje. Ce puteți face? Puteți să desfășurați DB Lab fără Joe, să folosiți REST API sau platforma noastră pentru a crea clone și a vă conecta cu PSQL. Dar acest lucru se poate face doar dacă sunteți pregătiți să oferiți dezvoltatorilor acces la date, deoarece aici nu va mai fi un ecran.
Nu am nevoie de acest strat, ci de o astfel de capacitate.
Atunci – da, se poate face.
Sursa: habr.com
