

Salut tuturor! Numele meu este Oleg Sidorenkov, iar eu lucrez ca șef al echipei de infrastructură la compania DomClick. Folosim „Cubul” în producție de mai bine de trei ani și, în această perioadă, am trecut prin multe momente interesante. Astăzi vă voi împărtăși cum, cu o abordare corectă, puteți extrage și mai multă performanță din Kubernetes „vanilla” pentru clusterul vostru. Ready steady go!
Toți știți foarte bine că Kubernetes este un sistem scalabil cu cod sursă deschis pentru orchestrarea containerelor; sau, altfel spus, 5 binare care fac magie gestionând ciclul de viață al microserviciilor voastre în mediul server. În plus, este un instrument destul de flexibil, pe care-l puteți construi ca pe un set de Lego, pentru a maximiza personalizarea în funcție de diverse sarcini.
Și părea că totul este bine: adăugați servere în cluster ca pe niște bușteni în foc și nu mai aveți griji. Dar dacă vă pasă de ecologie, veți reflecta: „Cum pot menține focul în sobe și, în același timp, să protejez pădurea?”. Cu alte cuvinte, cum să găsiți modalități de a îmbunătăți infrastructura și de a reduce costurile.
1. Monitorizați resursele echipelor și aplicațiilor
Una dintre cele mai banale, dar eficiente metode este introducerea requests/limits. Împărțiți aplicațiile pe namespaces și namespaces pe echipele de dezvoltare. Setați aplicației valori pentru consumul de CPU, memorie și stocare efemeră înainte de deployment.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Prin experiență, am ajuns la concluzia că nu este bine să exagerați cererile față de limite cu mai mult de două ori. Volumul clusterului este calculat pe baza cererilor, iar dacă veți defini aplicațiilor o diferență în resurse, de exemplu, de 5-10 ori, imaginați-vă ce se va întâmpla cu nodul vostru când acesta se va umple de poduri și va primi brusc o încărcătură. Nimic bun. Cel puțin, throttling, iar la maxim, veți spune adio lucrătorului și veți avea o încărcare ciclică pe celelalte noduri după ce podurile vor începe să migreze.
În plus, cu ajutorul limitranges puteți să stabiliți la început pentru container valori pentru resurse — minime, maxime și implicite:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Nu uitați să limitați resursele namespace-ului pentru a împiedica o echipă să consume toate resursele cluster-ului:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
După cum se vede din descriere resourcequotas, dacă echipa ops dorește să desfășoare pod-uri care vor consuma încă 10 cpu, atunci planificatorul nu va permite acest lucru și va genera o eroare:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Pentru a rezolva o problemă similară, se poate scrie un instrument, de exemplu, ca , capabil să stocheze și să comite starea resurselor echipelor.
2. Alegeți un stocare optimă a fișierelor
Aici aș dori să discut despre volumele persistente și subsistemul de stocare al nodurilor worker Kubernetes. Sper că nimeni nu folosește „Cube” pe HDD în producție, dar uneori chiar și un SSD obișnuit devine insuficient. Ne-am confruntat cu problema că jurnalele supraincarcă discul din cauza operațiunilor de intrare-ieșire, iar soluțiile nu sunt foarte multe:
Utilizați SSD-uri de înaltă performanță sau treceți la NVMe (dacă gestionați propriul hardware).
Reduceți nivelul de jurnalizare.
Faceți o „îmbinare inteligentă” a pod-urilor care supraîncarcă discul (
podAntiAffinity).
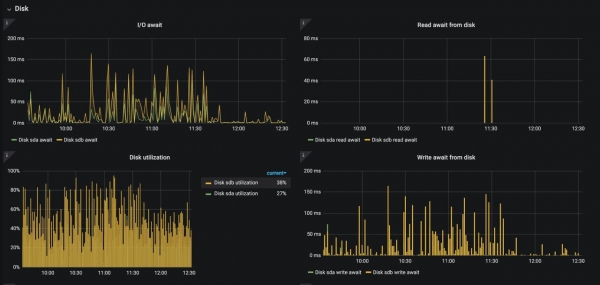
Screenshot-ul de mai sus arată ce se întâmplă cu nginx-ingress-controller pe disk când jurnalizarea access_logs este activată (~12 mii jurnale/sec.). Această stare poate duce, desigur, la degradarea tuturor aplicațiilor de pe acest nod.
În ceea ce privește PV, din păcate, nu am testat toate Volume Persistente. Utilizați cea mai bună opțiune care vi se potrivește. Istoric vorbind, o mică parte din servicii necesită volume RWX, iar pentru această sarcină am început să folosim stocarea NFS. E ieftin și... suficient. Desigur, ne-am săturat de probleme - dar am învățat să-l ajustăm, iar acum nu mai avem dureri de cap. Dacă este posibil, treceți la stocarea obiect S3.
3. Colectați imagini optimizate
Cel mai bine este să utilizați imagini optimizate pentru containere, astfel încât Kubernetes să le poată accesa mai rapid și să le execute mai eficient.
Optimizarea înseamnă că imaginile:
conțin o singură aplicație sau îndeplinesc o singură funcție;
sunt de dimensiuni mici, deoarece imaginile mari sunt mai greu de transferat prin rețea;
au puncte finale pentru verificarea stării de funcționare și a disponibilității, prin care Kubernetes poate lua măsuri în caz de nefuncționare;
utilizează sisteme de operare prietenoase cu containere (cum ar fi Alpine sau CoreOS), care sunt mai rezistente la erori de configurare;
folosesc compilări multi-etapă, astfel încât să puteți desfășura doar aplicațiile compilate, nu și sursele însoțitoare.
Există multe instrumente și servicii care permit verificarea și optimizarea imaginilor în timp real. Este important să le mențineți întotdeauna actualizate și verificate pentru securitate. În final, obțineți:
Reducerea încărcării de rețea pe întregul cluster.
Reducerea timpului de lansare a containerului.
Un volum mai mic al întregului dvs. registry Docker.
4. Utilizați memoria cache DNS
În ceea ce privește sarcinile mari, fără ajustarea sistemului DNS al clusterului, viața poate fi destul de neplăcută. În trecut, dezvoltatorii Kubernetes susțineau soluția lor kube-dns. A fost implementată și la noi, dar această aplicație nu a fost ajustată special și nu oferea performanța necesară, deși, aparent, sarcina era simplă. Apoi a apărut coredns, la care am trecut și nu am mai avut probleme, devenind ulterior serviciul DNS implicit în K8s. La un moment dat, am ajuns la 40.000 de solicitări pe secundă la sistemul DNS, iar această soluție a devenit insuficientă. Totuși, din fericire, a apărut Nodelocaldns, denumit și cache local de noduri, .
De ce o folosim? În nucleul Linux există un bug care, în urma unor apeluri multiple prin conntrack NAT pe UDP, conduce la o stare de competiție pentru scrierea în tabelele conntrack, ceea ce duce la pierderea unor pachete prin NAT (fiecare accesare prin Service este NAT). Nodelocaldns rezolvă această problemă prin eliminarea NAT-ului și modernizarea conexiunii la TCP cu DNS-urile upstream, precum și prin cache localizat pentru solicitările DNS către upstream (inclusiv un cache negativ scurt de 5 secunde).
5. Scalati podurile automat atât orizontal, cât și vertical
Puteți spune cu încredere că toate microserviciile dvs. sunt pregătite pentru o creștere a sarcinii de lucru de două sau trei ori? Cum să alocați corect resursele aplicațiilor dvs.? Menținerea unui număr excesiv de poduri în funcție de sarcina de lucru poate fi redundantă, iar menținerea la limită riscă să provoace opriri din cauza unei creșteri bruște a traficului pe serviciu. Echilibrul este realizat cu ajutorul serviciilor de scalare, cum ar fi și .
VPA care permite creșterea automată a requests/limits containerelor din pod în funcție de utilizarea reală. Cum poate fi util? Dacă aveți poduri care nu pot fi scalate orizontal dintr-un anumit motiv (ceea ce nu este tocmai sigur), puteți încerca să lăsați VPA să gestioneze modificarea resurselor sale. Caracteristica sa constă în sistemul de recomandări bazat pe date istorice și actuale din metric-server, așadar, dacă nu doriți să schimbați automat requests/limits, puteți pur și simplu să monitorizați resursele recomandate pentru containerele dvs. și să optimizați setările pentru economisirea CPU și memorie în cluster.
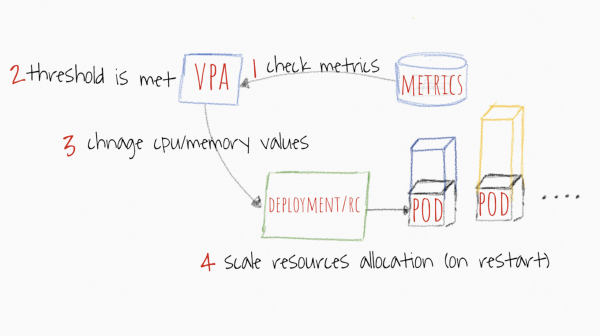 Imaginea este preluată de la https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Planificatorul din Kubernetes se bazează întotdeauna pe requests. Indiferent de valoarea pe care o puneți acolo, planificatorul va căuta un nod potrivit, bazându-se pe aceasta. Valorile limits sunt necesare kubelet-ului pentru a înțelege când să throttleze sau să omoare podul. Și deoarece singurul parametru important este valoarea requests, VPA va lucra cu acesta. De fiecare dată când stabiliți scalarea verticală a aplicației, definiți cum ar trebui să fie requests. Dar ce se va întâmpla cu limits? Acest parametru va fi, de asemenea, scalat proporțional.
De exemplu, iată setările obișnuite ale podului:
resurse:
   cereri:
     memorie: 250Mi
     cpu: 200m
   limite:
     memorie: 500Mi
     cpu: 350m
Mecanismul de recomandare stabilește că aplicația dumneavoastră necesită 300m CPU și 500Mi pentru a funcționa corespunzător. Veți primi următoarele setări:
resurse:
   cereri:
     memorie: 500Mi
     cpu: 300m
   limite:
     memorie: 1000Mi
     cpu: 525m
Așa cum s-a menționat mai sus, aceasta este o scalare proporțională bazată pe raportul cereri/limite din manifest:
CPU: 200m → 300m: raport 1:1.75;
Memorie: 250Mi → 500Mi: raport 1:2.
În ceea ce privește HPA, aici mecanismul de funcționare este mai transparent. Se stabilesc valori prag pentru statistici, cum ar fi CPU și memorie, iar dacă media tuturor replicilor depășește pragul, aplicația se scalează cu +1 pod până când valoarea scade sub prag sau până când se atinge numărul maxim de replici.
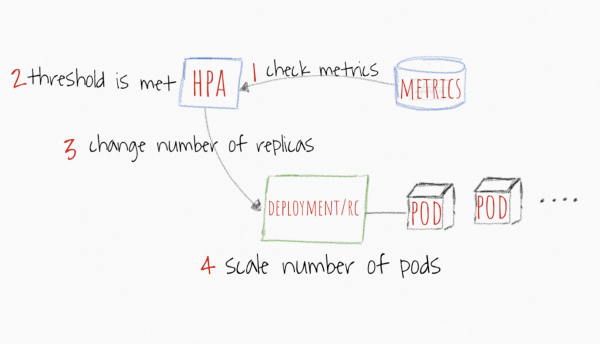 Imaginea este preluată de la https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Pe lângă statisticile obișnuite, cum ar fi CPU și memorie, puteți configura praguri pe metrici personalizate din Prometheus și să lucrați cu acestea, dacă considerați că este cea mai precisă definiție despre când să scalați aplicația dumneavoastră. Odată ce aplicația se stabilizează sub limita stabilită, HPA va începe să scaleze podurile în jos până la numărul minim de replici sau până când sarcina va îndeplini pragul stabilit.
6. Nu uitați de Node Affinity și Pod Affinity
Nu toate nodurile funcționează pe hardware identical, nu toate podurile trebuie să ruleze aplicații ce necesită capacitate de procesare intensă. Kubernetes permite specializarea nodurilor și podurilor prin: Node Affinity și Pod Affinity.
Dacă aveți noduri potrivite pentru operațiuni cu intensitate de procesare, pentru eficiență maximă este mai bine să legați aplicațiile la noduri corespunzătoare. Pentru aceasta utilizați: nodeSelector cu eticheta nodului.
Să presupunem că aveți două noduri: unul cu CPUType=HIGHFREQ și multe nuclee rapide, altul cu MemoryType=HIGHMEMORY multe memorie și o performanță mai mare. Cel mai simplu este să alocați desfășurarea podului nodului HIGHFREQ, adăugând în secțiunea spec un selector ca acesta:
…
nodeSelector:
	CPUType: HIGHFREQ
O modalitate mai costisitoare și specifică de a face acest lucru este prin utilizarea secțiunii nodeAffinity în câmpul affinity Există două opțiuni: spec: configurare strictă (planificatorul va desfășura podurile doar pe noduri specifice (și nicăieri altundeva));
requiredDuringSchedulingIgnoredDuringExecutionpreferredDuringSchedulingIgnoredDuringExecutionpreferredDuringSchedulingIgnoredDuringExecution: configurare flexibilă (schedulerul va încerca să desfășoare pe noduri specifice, iar dacă nu reușește, va încerca să desfășoare pe următorul nod disponibil).
Puteți specifica o sintaxă de control al etichetelor nodurilor, de exemplu, In, NotIn, Exists, DoesNotExist, Gt sau Lt. Totuși, rețineți că metodele complexe în liste lungi de etichete vor încetini luarea deciziilor în situații critice. Cu alte cuvinte, nu complicați.
Așa cum s-a menționat mai sus, Kubernetes permite specificarea asocierii podurilor curente. Adică puteți face astfel încât anumite poduri să lucreze împreună cu alte poduri în aceeași zonă de disponibilitate (relevant pentru cloud-uri) sau noduri.
În podAffinity câmpuri affinity Există două opțiuni: spec sunt disponibile aceleași câmpuri ca și în cazul nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution și preferredDuringSchedulingIgnoredDuringExecution. Singura diferență este că matchExpressions va asocia podurile cu nodul pe care deja rulează un pod cu această etichetă.
De asemenea, Kubernetes oferă câmpul podAntiAffinity, care, spre deosebire, nu asociază podul cu nodul care are anumite poduri.
Referitor la expresii, nodeAffinity se poate da același sfat: încercați să mențineți simplitatea și logica regulilor, nu trebuie să încercați să suprasolicitați specificația podurilor cu un set complex de reguli. Este foarte ușor să creați o regulă care să nu corespundă condițiilor cluster-ului, creând o sarcină suplimentară pentru scheduler și scăzând performanța generală.
7. Taints & Tolerations
Există și o altă modalitate de a gestiona schedulerul. Dacă aveți un cluster mare cu sute de noduri și mii de microservicii, atunci este foarte greu să nu permiteți anumitor poduri să fie plasate pe anumite noduri.
Acesta este sprijinit de mecanismul taints — reguli interzicătoare. De exemplu, în anumite scenarii, puteți interzice anumitor noduri să ruleze poduri. Pentru a aplica taint unui nod specific, trebuie să folosiți opțiunea taint în kubectl. Specificați cheia și valoarea, apoi taint cum ar fi NoSchedule sau NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleDe asemenea, este important de menționat că mecanismul taint suportă trei efecte principale: NoSchedule, NoExecute și PreferNoSchedule.
NoScheduleînseamnă că atâta timp cât în specificația podului nu va exista o înregistrare corespunzătoaretolerations, acesta nu va putea fi desfășurat pe nod (în acest exemplunode10).PreferNoSchedule— o versiune simplificatăNoSchedule. În acest caz, schedulerul va încerca să nu distribuie podurile care nu au o înregistrare corespunzătoaretolerationspe nod, dar aceasta nu este o restricție strictă. Dacă în cluster nu vor exista resurse, atunci podurile vor începe să se desfășoare pe acest nod.NoExecute— acest efect declanșează evacuarea imediată a podurilor care nu au o înregistrare corespunzătoaretolerations.
Este interesant că acest comportament poate fi anulat prin intermediul mecanismului de toleranțe. Este convenabil atunci când există un nod "interzis" și trebuie să plasați pe el doar servicii infrastructurale. Cum se face asta? Permiteți doar acele poduri pentru care există toleranța potrivită.
Iată cum va arăta specificația podului:
spec:
   toleranțe:
     - cheie: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        valoare: "true"
        efect: "NoSchedule"
Asta nu înseamnă că la următorul redeploy podul va ajunge exact pe acest nod, nu este un mecanism de Node Affinity și nodeSelector. Dar combinând mai multe funcții, puteți obține o configurare foarte flexibilă a scheduler-ului.
8. Configurați prioritatea desfășurării podurilor
Ceea ce ați configurat ca și legare a podurilor de noduri nu înseamnă că toate podurile trebuie să fie procesate cu aceeași prioritate. De exemplu, s-ar putea să doriți să desfășurați unele poduri mai devreme decât altele.
Kubernetes oferă diferite moduri de a configura prioritatea podurilor (Pod Priority and Preemption). Configurarea constă din mai multe părți: obiectul PriorityClass și descrierea câmpului priorityClassName în specificația podului. Să vedem un exemplu:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Această clasă de prioritate ar trebui să fie utilizată doar pentru podurile foarte importante"
Creăm PriorityClass, îi dăm un nume, o descriere și o valoare. Cu cât valoare, cu atât prioritatea este mai mare. Valoarea poate fi orice număr întreg de 32 de biți, mai mic sau egal cu 1 000 000 000. Valori mai mari sunt rezervate pentru podurile critice de sistem, care, în general, nu pot fi înlăturate. Înlocuirea va avea loc doar dacă podul de înaltă prioritate nu are loc unde să se desfășoare, atunci unele poduri de pe un anumit nod vor fi evacuate. Dacă acest mecanism este prea rigid pentru dvs., puteți adăuga opțiunea preemptionPolicy: Never, și atunci nu va exista înlocuire, podul va fi pus primul în așteptare și va aștepta până când scheduler-ul găsește resurse libere pentru el.
Apoi creăm un pod în care specificăm numele priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Puteți crea câte clase de prioritate doriți, deși se recomandă să nu exagerați (să vă limitați la prioritate mică, medie și mare).
Astfel, în caz de necesitate, veți putea îmbunătăți eficiența desfășurării serviciilor critice, cum ar fi nginx-ingress-controller, coredns etc.
9. Optimizarea clusterului ETCD
ETCD poate fi numit creierul întregului cluster. Este foarte important să mențineți funcționarea acestei baze de date la un nivel ridicat, deoarece de aceasta depinde viteza operațiunilor în „Kube”. O soluție standard, dar totuși bună, ar fi să mențineți clusterul ETCD pe nodurile master, pentru a avea o întârziere minimă față de kube-apiserver. Dacă nu reușiți să faceți acest lucru, atunci plasați ETCD cât mai aproape posibil, având o lățime de bandă bună între participanți. De asemenea, aveți grijă la câte noduri din ETCD pot ieși din funcțiune fără a afecta clusterul.
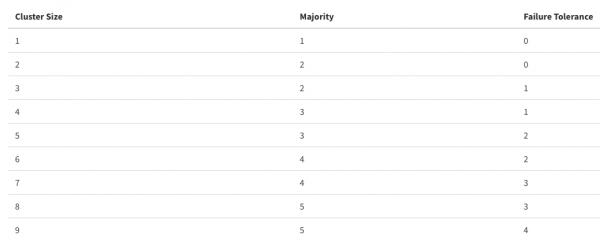
Fiți conștienți că o creștere excesivă a numărului de participanți în cluster poate spori disponibilitatea, dar poate afecta performanța; totul trebuie să fie într-o măsură rezonabilă.
Când vine vorba de configurarea serviciului, recomandările sunt puține:
Să aveți hardware bun, în funcție de dimensiunea clusterului (puteti citi ).
Să ajustați câteva parametrii, dacă ați dispersat clusterul între câteva centre de date sau rețeaua și discurile dumneavoastră lasă de dorit (puteți citi ).
Concluzie
În acest articol sunt descrise punctele pe care echipa noastră încearcă să le respecte. Acesta nu este un ghid pas cu pas, ci variante care pot fi utile pentru optimizarea costurilor indirecte ale clusterului. Este clar că fiecare cluster este unic, iar soluțiile de configurare pot varia foarte mult, așa că ar fi interesant să primim feedback de la voi: cum vă monitorizați clusterul Kubernetes, cu ce instrumente îmbunătățiți funcționarea lui. Împărtășiți-vă experiența în comentarii, va fi interesant de aflat.
Sursa: habr.com
