

De parcă dezvoltatorii Terraform oferă suficiente practici de top pentru a lucra cu infrastructura AWS. Doar că există un meci. În timp, numărul de medii crește, iar fiecare are particularitățile sale. Apare aproape o copie a stack-ului de aplicații în regiunea vecină. Și codul Terraform trebuie copiat și modificat cu atenție în conformitate cu noile cerințe sau trebuie să facem o „zăpadă”.
Prezentarea mea se referă la modele în Terraform pentru a combate haosul și rutina manuală în proiecte mari și de lungă durată.
Video:
Am 40 de ani și am 20 de ani de experiență în IT. Lucrez de 12 ani la compania Ixtens. Ne ocupăm cu dezvoltarea bazată pe ecommerce. Iar de 5 ani practic metodele DevOps.
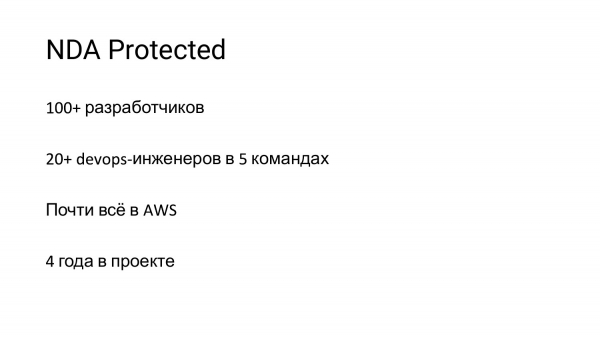
Povestea mea va fi despre experiența într-un proiect la o companie al cărei nume nu-l voi menționa, protejându-mă cu un acord de confidențialitate.
Numerele de pe slide sunt menționate pentru a înțelege amploarea proiectului. Și tot ceea ce voi spune mai departe este legat de Amazon.
M-am alăturat acestui proiect acum 4 ani. Și în plină desfășurare era un refactoring al infrastructurii, pentru că proiectul a crescut. Iar modelele utilizate nu mai erau potrivite. Având în vedere toată creșterea planificată a proiectului, era nevoie de ceva nou.
Mulțumesc lui Matvey, care ieri a povestit ce s-a întâmplat la Dodo Pizza. Acesta este ceea ce ne-a avut loc acum 4 ani.
Dezvoltatorii au venit și au început să creeze codul infrastructurii.
Cele mai evidente motive pentru care a fost necesar erau timpul de lansare pe piață. Trebuia să facem astfel încât echipa DevOps să nu fie un punct restricționat în timpul implementării. Și pe lângă toate acestea, la nivelul cel mai de bază s-au folosit Terraform și Puppet.
Terraform este un proiect open source al companiei HashiCorp. Și pentru cei care nu știu ce este, următoarele câteva slide-uri.
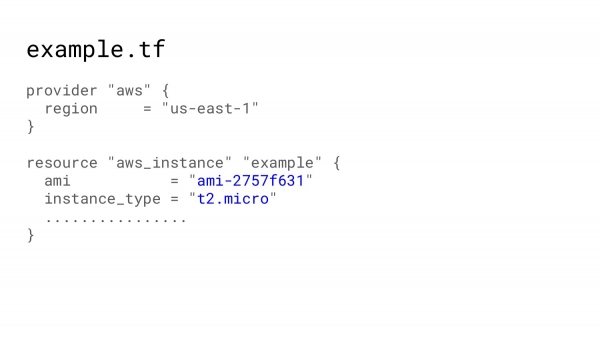
Infrastructura ca și cod înseamnă că putem descrie infrastructura noastră și putem cere unor roboți să facă în așa fel încât să obținem resursele pe care le-am descris.
De exemplu, avem nevoie de mașină virtuală. O vom descrie, adăugând câteva parametrii obligatorii.
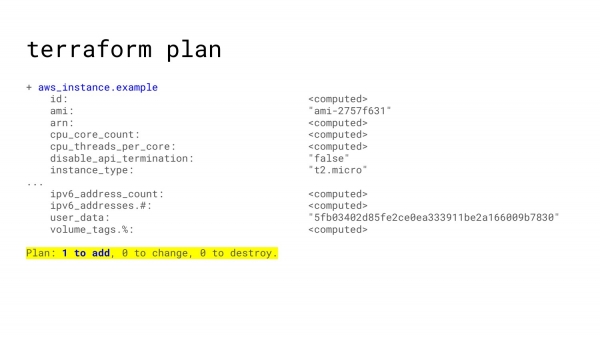
După aceea, în consolă vom configura accesul la Amazon. Și vom cere Terraform plan. Terraform plan ne va spune: „Ok, pentru resursa ta putem face următoarele lucruri”. Și, cel puțin, o resursă va fi adăugată. Și nu sunt prevăzute modificări.
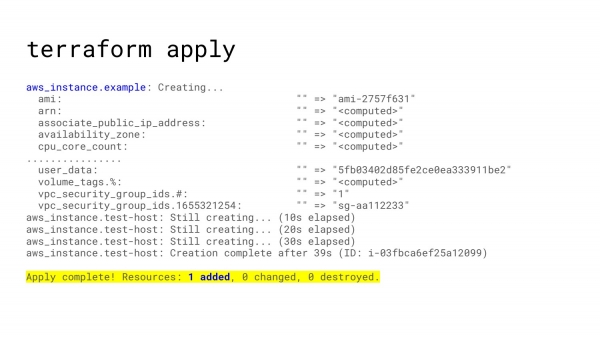
După ce totul este în regulă, poți cere Terraform apply și Terraform îți va crea un instance, iar tu vei obține o mașină virtuală în norul tău.
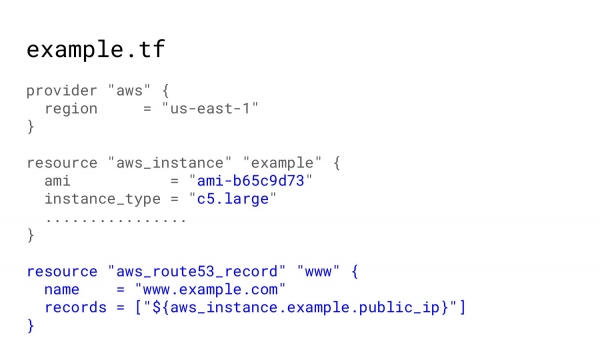
Apoi, proiectul nostru se dezvoltă. Adăugăm anumite modificări. Cerem mai multe instanțe, adăugăm 53 de înregistrări.
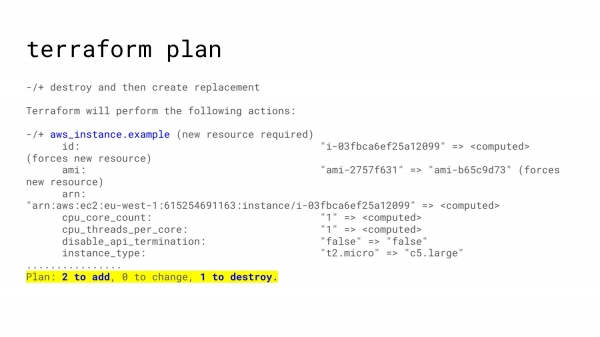
Și repetăm. Cerem un plan. Vedem ce modificări sunt planificate. Aplicăm. Astfel, infrastructura noastră crește.
Terraform folosește așa-numitele fișiere state. Adică, toate modificările care merg pe Amazon sunt păstrate într-un fișier, unde pentru fiecare resursă pe care ați descris-o, există resurse corespunzătoare create în Amazon. Astfel, atunci când se schimbă descrierea unei resurse, Terraform știe exact ce trebuie să schimbe în Amazon.
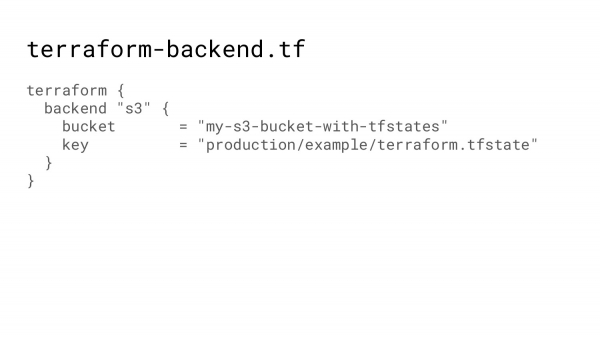
Aceste fișiere state erau inițial doar fișiere. Le păstram în Git, ceea ce era extrem de incomod. Tot timpul cineva uita să comită modificările și apăreau multe conflicte.
Acum există posibilitatea de a utiliza un back-end, adică Terraform specifică în ce bucket și cu ce cheie trebuie să fie salvat fișierul state. Iar Terraform se ocupă de obținerea acestui fișier state, de a face toată magia și de a returna rezultatul final.
Infrastructura noastră crește. Iată codul nostru. Și acum nu vrem doar să creăm o mașină virtuală, vrem să avem un mediu de testare.
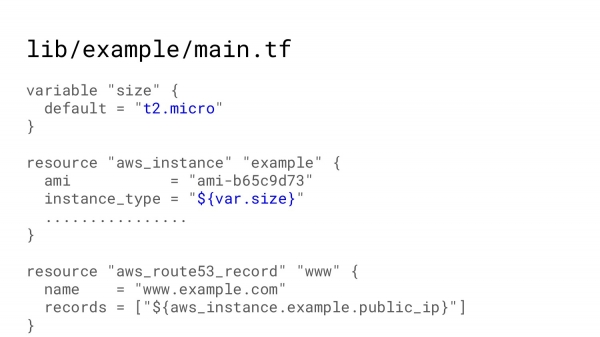
Terraform permite crearea unui modul, adică să descriem același lucru într-un folder.
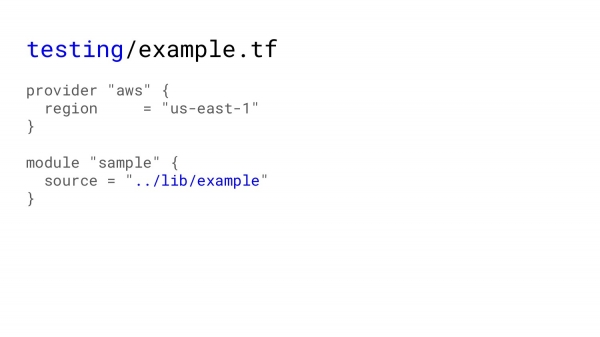
De exemplu, în testare putem apela acest modul și obține același rezultat ca și cum am rula Terraform apply în modulul însuși. Pentru testare va fi un cod de acest tip.
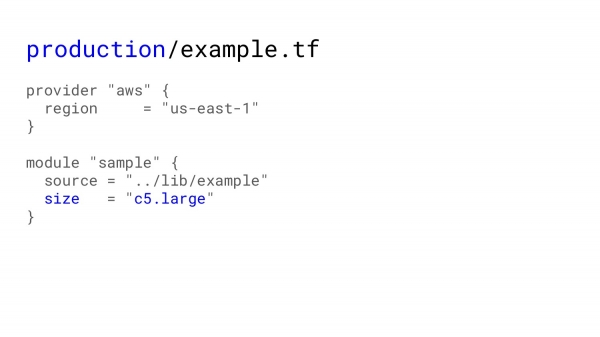
Pentru producție putem trimite acolo anumite modificări, deoarece în testare nu avem nevoie de instanțe mari, dar în producție instanțele mari sunt foarte utile.
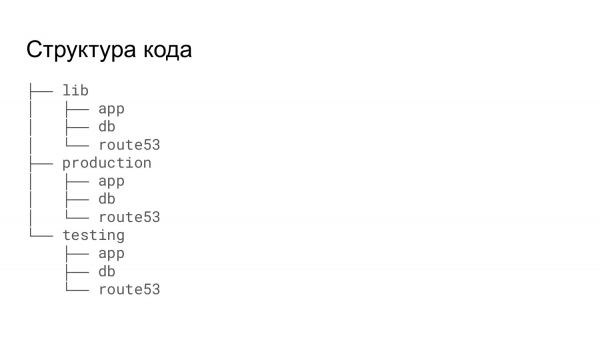
Și apoi mă voi întoarce în proiect. A fost o sarcină complexă, infrastructura era planificată să fie foarte mare. Și trebuia să găsim o modalitate de a organiza tot codul astfel încât să fie convenabil pentru toți: atât pentru cei care întrețin acest cod, cât și pentru cei care fac modificări. Era planificat ca orice dezvoltator să poată merge și să ajusteze infrastructura așa cum este necesar pentru partea sa de platformă.
Aceasta este o structură de directoare recomandată de HashiCorp, dacă aveți un proiect mare și are sens să împărțiți întreaga infrastructură în bucăți mai mici și să descrieți fiecare bucată în folderul său.
Având o bibliotecă extinsă de resurse, puteți apela cam aceeași ceva atât în testare cât și în producție.
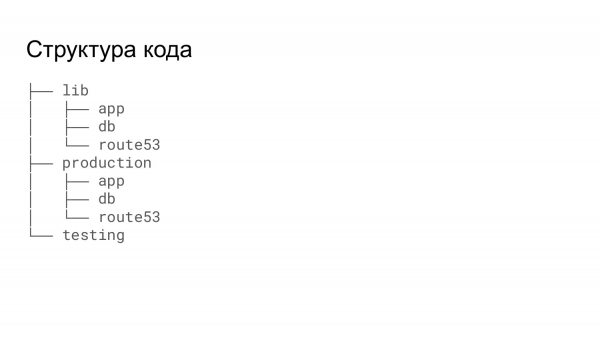
În cazul nostru, aceasta nu se potrivea foarte bine, deoarece era nevoie de un stack de testare pentru dezvoltatori sau pentru testare, care să fie obținut într-un mod mai simplu. Nu voiam să navigăm prin foldere și să aplicăm în ordinea necesară, îngrijorându-ne că baza de date se va ridica, iar apoi va apărea un instance care utilizează această bază. Așadar, tot testul era lansat dintr-un singur folder. Acolo erau invocate aceleași module, dar totul se desfășura într-o singură execuție.
Terraform se ocupă de toate dependențele. Și întotdeauna creează resurse în ordinea în care se poate obține un IP, de exemplu, de la un instance nou creat și obține acest IP în înregistrarea route53.
Pe lângă asta, platforma este foarte mare. Și lansarea unui stack de testare, chiar și pentru o oră, chiar și pentru 8 ore – este o afacere destul de costisitoare.
Și am automatizat acest proces. Jobul Jenkins permitea lansarea stack-ului. Era necesar să se lanseze un pull request cu modificările pe care dezvoltatorul dorea să le testeze, specificând toate opțiunile necesare, componentele, precum și dimensiunile. Dacă dorea testare de performanță, putea lua mai multe instances. Dacă voia doar să verifice că un formular se deschide, putea porni pe minim. De asemenea, putea specifica dacă era necesar un cluster sau nu și așa mai departe.
Apoi, Jenkins lansa un script shell, care modifica puțin codul din folderul Terraform. Eliminând fișierele inutile, adăuga fișierele necesare. Și apoi, printr-o singură execuție, Terraform apply ridica stack-ul.
Apoi urmează alte etape, în care nu vreau să mă adâncesc.
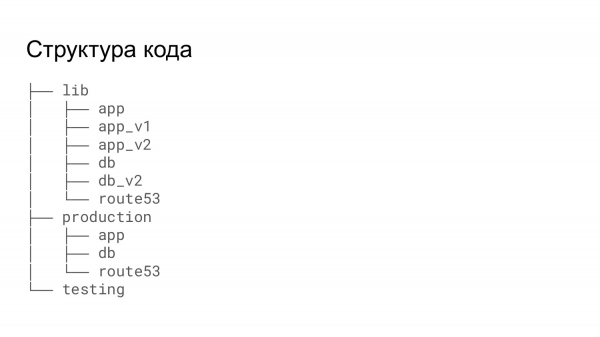
Din cauza că pentru testare aveam nevoie de puțin mai multe opțiuni decât în producție, a fost necesar să facem copii ale modulelor, pentru a putea adăuga acele funcționalități care sunt necesare doar în testare.
Și astfel s-a întâmplat că, în testare, părea că vrem să testăm modificările care, în cele din urmă, vor ajunge în producție. Dar, de fapt, se testa un lucru, iar în producție se aplica puțin altceva. Și a existat o mică discrepanță, că în producție toate modificările erau aplicate de echipa de operațiuni. Și, uneori, se întâmpla că modificările care trebuiau să treacă din testare în producție rămâneau într-o altă versiune.
În plus, a existat o problemă în care se adăuga un nou serviciu, care era puțin diferit de unul deja existent. Și în loc să modificăm modulul existent, era necesar să facem o copie a acestuia și să adăugăm modificările necesare.
În esență, Terraform nu este un adevărat limbaj. Este o declarație. Dacă trebuie să declarăm ceva, atunci o facem. Și totul funcționează.
Într-un anumit moment, când se discuta despre una dintre cererile mele de pull, unul dintre colegi a spus că nu trebuie să creăm zăpadă. M-a interesat ceea ce avea în minte. Există un fapt științific conform căruia nu există două fulgi de zăpadă identici în lume; toți sunt puțin diferiți. Și imediat ce am auzit asta, am simțit toată greutatea codului Terraform. Pentru că, atunci când era necesar să trecem de la o versiune la alta, Terraform necesita modificări care îmbină. Adică, codul nu mai era compatibil cu următoarea versiune. Și era necesar să facem o cerere de pull care acoperea aproape jumătate din fișierele din infrastructură, pentru a aduce infrastructura la următoarea versiune de Terraform.
Și după ce a apărut această zăpadă, tot codul Terraform pe care îl aveam se transforma într-un mare munte de zăpadă.
Pentru un dezvoltator extern, care nu face parte din operațiuni, acest lucru nu are o mare importanță, deoarece el a făcut o cerere de pull, resursa sa a fost lansată. Și atât, nu mai este grija lui. Dar echipei DevOps, care monitorizează totul pentru a fi în regulă, îi sunt cerute toate aceste modificări. Iar costul acestor modificări creștea foarte mult cu fiecare zăpadă suplimentară.
Există o poveste despre un student care desenează la seminar două cercuri perfecte cu creta pe tablă. Iar profesorul se miră cum a reușit să le deseneze atât de uniform fără compas. Studentul răspunde: „Foarte simplu, am petrecut doi ani în armată răsucind o mașină de tocat carne.”
Și din cei patru ani în care particip la acest proiect, aproximativ doi ani mă ocup de Terraform. Și, desigur, am câteva trucuri, câteva sfaturi despre cum să simplific codul Terraform, să lucrez cu el ca pe un limbaj de programare și să reduc povara asupra dezvoltatorilor care trebuie să mențină acest cod actualizat.
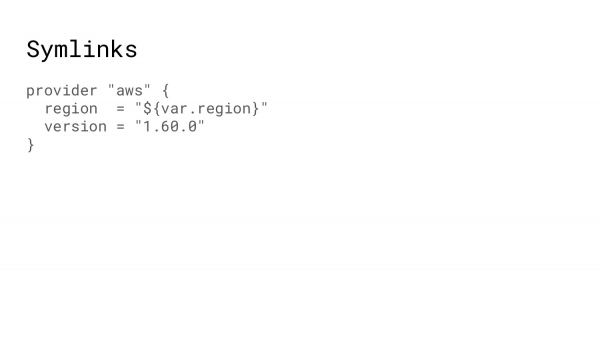
Primul lucru cu care aș vrea să încep este Symlinks. Terraform are mult cod repetitiv. De exemplu, apelul provider-ului este practic în fiecare punct în care creăm un element de infrastructură, același. Și e logic să-l mutăm într-un folder separat. Și în toate locurile unde este necesar, provider-ul să facă Symlinks la acest fișier.
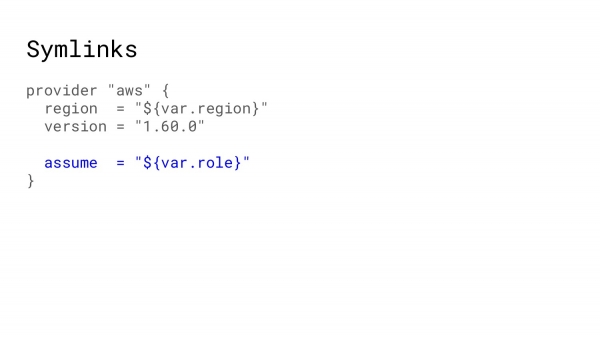
De exemplu, aveți în producție un assume role, care vă permite să obțineți drepturi de acces la un cont Amazon extern. Și prin schimbarea unui fișier, toate celelalte din arborele de resurse vor avea drepturile necesare pentru ca Terraform să știe la ce segment Amazon să se adreseze.
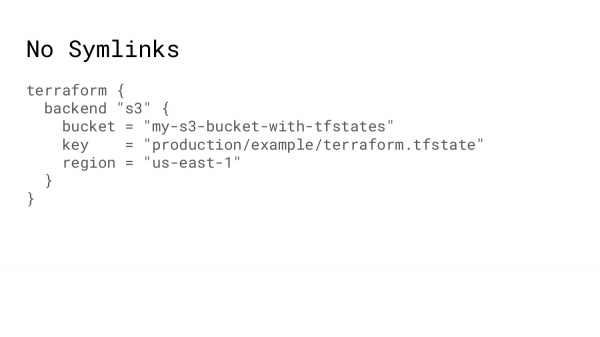
Unde nu funcționează Symlinks? Așa cum am spus, în Terraform există fișiere de stare. Și acestea sunt foarte, foarte utile. Dar problema este că Terraform inițializează backend-ul în primul rând. Și nu poate folosi în aceste parametri variabile, acestea trebuie scrise întotdeauna în text.
Și ca rezultat, când cineva creează un nou resource, el copiază o parte din cod din alte foldere. Și poate greși cu cheia sau cu bucket-ul. De exemplu, el face din sandbox un lucru de sandbox, iar apoi îl face în producție. Și astfel poate să se întâmple ca bucket-ul din producție să fie utilizat din sandbox. Desigur, asta va fi rapid descoperită. Se poate corecta cumva, dar totuși este o pierdere de timp și, într-o oarecare măsură, de resurse.
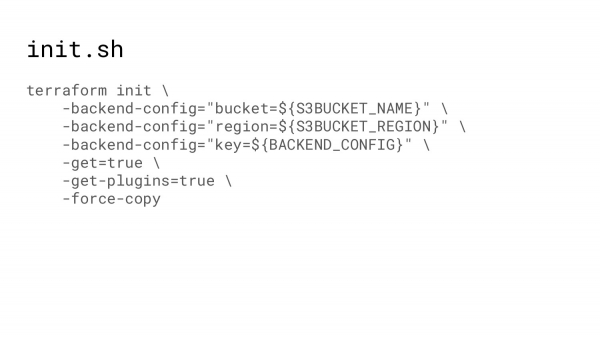
Ce putem face mai departe? Înainte de a lucra cu Terraform, trebuie să-l inițializăm. În momentul inițializării, Terraform descarcă toate pluginurile. Acestea, la un moment dat, au fost despărțite dintr-o arhitectură monolitică într-o arhitectură microserviciu. Și trebuie să facem întotdeauna Terraform init, pentru ca acesta să tragă toate modulele, toate pluginurile.
Și putem folosi un script shell, care, pe de-o parte, va putea extrage toate variabilele. Scriptul shell nu are limite. Și, pe de altă parte, căile. Dacă folosim întotdeauna acea cale care se află în repository ca cheie pentru fișierul de stare, atunci, prin urmare, eroarea va fi exclusă.
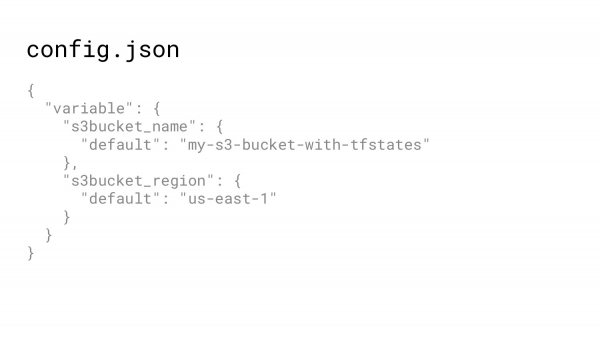
De unde să extragem datele? Fișier JSON. Terraform permite scrierea infrastructurii nu doar în hcl (HashiCorp Configuration Language), ci și în JSON.
JSON poate fi citit ușor din scriptul shell. Prin urmare, putem plasa un fișier de configurare cu bucket într-un loc și să folosim acest bucket atât în codul Terraform, cât și în scriptul shell pentru inițializare.
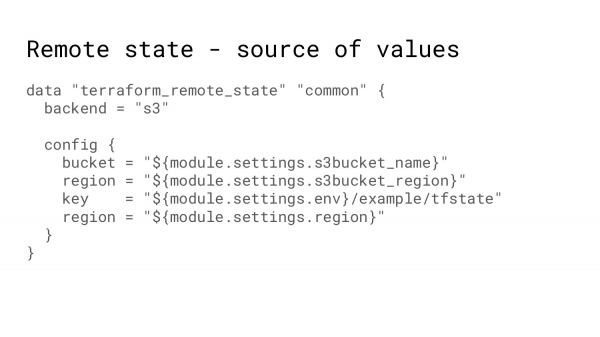
De ce este important să ai un bucket pentru Terraform? Pentru că există un lucru numit fișiere de stare remote. Adică, atunci când ridic un anumit resource, pentru a spune Amazon: „Te rog, ridică un instance”, trebuie să indic multe parametrii obligatorii.
Și aceste identificatoare sunt stocate într-un alt folder. Pot să spun: „Terraform, te rog, mergi în fișierul de stare al acelui resource și adu-mi aceste identificatoare”. Astfel apare o anumită unificare între diferite regiuni sau medii.
Nu este întotdeauna posibil să folosești un fișier de stare remote. De exemplu, ai creat manual un VPC. Și codul Terraform care creează VPC-ul creează un VPC atât de diferit, încât îți va lua mult timp să adaptezi unul la altul, de aceea poți folosi următoarea soluție.
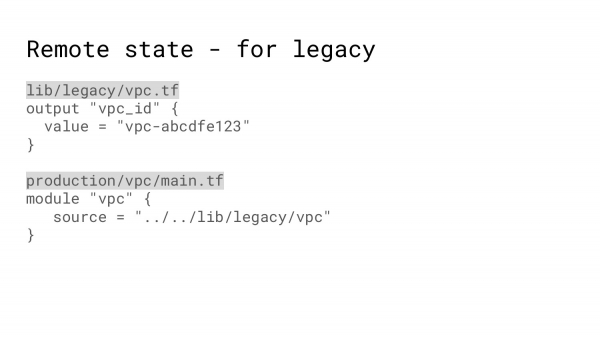
Adică, să faci un modul care să creeze VPC-ul și să-ți ofere identificatoarele, dar de fapt există doar un fișier cu valori hardcodate, care poate fi folosit pentru a crea același instance.
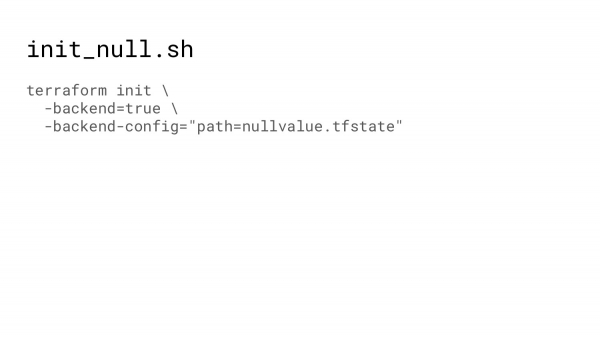
Nu este întotdeauna necesar să păstrezi fișierul de stare în cloud. De exemplu, când testezi modulele, poți folosi inițializarea backend-ului, când fișierul va fi salvat pur și simplu pe disc pe durata testării.
Acum puțin despre testare. Ce se poate testa în Terraform? Probabil, multe lucruri se pot testa, dar voi vorbi despre aceste 4 aspecte.
HashiCorp are o viziune asupra modului în care trebuie formatat codul Terraform. Terraform fmt îți permite să formatezi codul pe care îl editezi conform acestei viziuni. Prin urmare, testele trebuie să verifice dacă formatul este conform cu ceea ce a lăsat HashiCorp, astfel încât să nu fie necesar să schimbi poziția parantezelor etc.
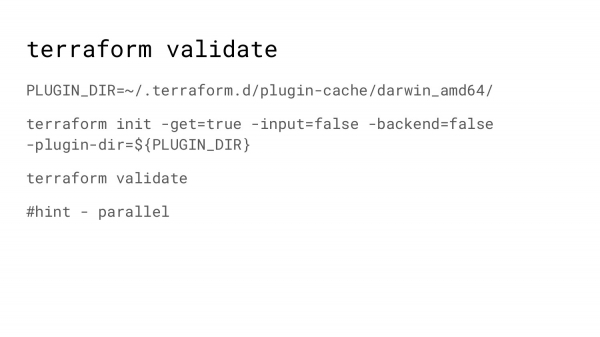
Următorul este Terraform validate. El face puțin mai mult decât o verificare sintactică - adică, dacă toate parantezele sunt pereche. Ce este important aici? Infrastructura noastră este foarte extinsă. Are foarte multe foldere diferite. Și în fiecare trebuie să rulezi Terraform validate.
Astfel, pentru a accelera testarea, rulăm mai multe procese în paralel, folosind paralelismul.
Paralelismul este o chestie foarte grozavă, folosiți-l.
Dar de fiecare dată când se inițiază Terraform, acesta se conectează la HashiCorp și întreabă: „Care sunt cele mai recente versiuni ale pluginurilor? Și acel plugin pe care îl am în cache – este acela sau nu?”. Iar acest lucru încetinește procesul la fiecare pas.
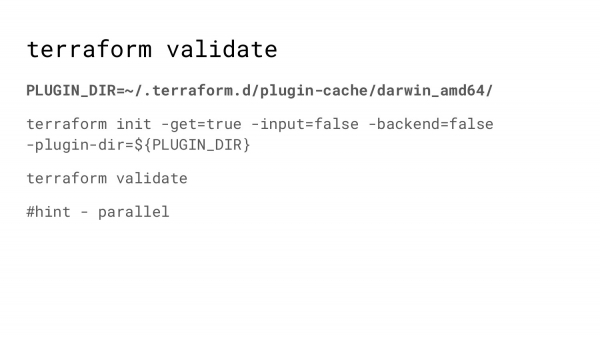
Dacă îi spui lui Terraform unde se află pluginurile, va răspunde: „Ok, probabil că aceasta este cea mai recentă versiune. Nu voi căuta altundeva, voi începe imediat să validează codul tău Terraform”.
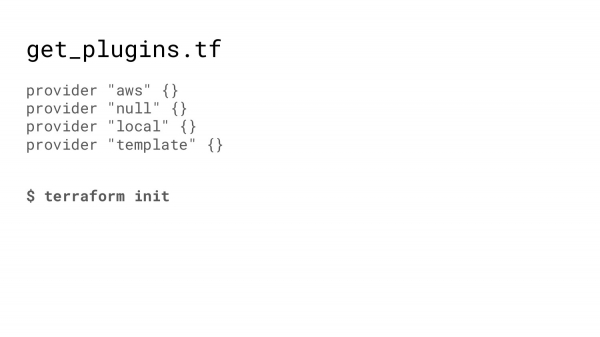
Pentru a completa folderul cu pluginurile necesare, avem un cod Terraform foarte simplu care trebuie doar inițializat. Aici, desigur, trebuie să specifici toți providerii care participă în codul tău, altfel Terraform va spune: „Nu cunosc niciun provider, pentru că nu este în cache”.
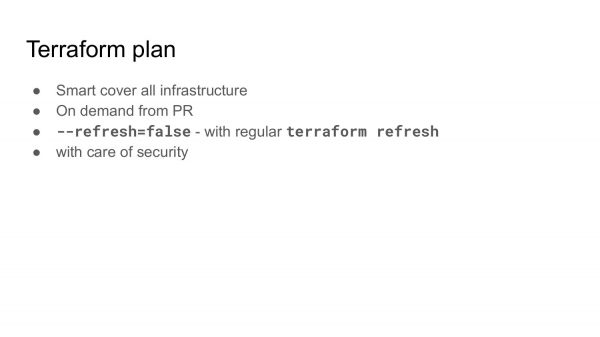
Următorul pas este Terraform plan. Așa cum am spus, dezvoltarea este ciclică. Facem cod cu modificări. Și apoi trebuie să știm ce modificări sunt planificate pentru infrastructură.
Și când infrastructura este foarte, foarte mare, poți schimba un modul, repara o mediu de testare sau un anumit regiune și poți strica un vecin. De aceea, Terraform plan trebuie realizat pentru întreaga infrastructură și să arate ce modificări sunt planificate.
Acest lucru poate fi realizat inteligent. De exemplu, am scris un script în Python, care rezolvă dependențele. În funcție de ce a fost modificat: modul Terraform sau un anumit component, acesta creează planuri pentru toate folderele dependente.
Terraform plan ar trebui să fie realizat la cerere. Cel puțin, aceasta este ceea ce facem noi.
Testele, desigur, sunt bine de realizat pentru fiecare modificare, pentru fiecare commit, dar planurile sunt oarecum costisitoare. Și în pull request spunem: „Te rog, dă-mi planurile”. Se activează un robot. Și trimite în comentarii sau în atașamente toate planurile care sunt anticipate din modificările tale.
Planul este o resursă destul de costisitoare. Acesta necesită timp, pentru că Terraform merge în Amazon și întreabă: „Există încă acest instance? Are acest autoscale exact aceste parametrii?”. Iar pentru a accelera acest proces, poți folosi un parametru precum refresh=false. Asta înseamnă că Terraform va descărca din S3 statele. Și va crede că starea corespunde exact cu ceea ce se află în Amazon.
Acest plan Terraform se execută mult mai repede, dar state-ul trebuie să corespundă infrastructurii tale, adică, undeva, cândva, trebuie să ruleze Terraform refresh. Terraform refresh face exact ceea ce este necesar pentru ca state-ul să corespundă ceea ce se află în infrastructura reală.
Și trebuie să vorbim despre securitate. De aici trebuia să începem. Acolo unde rulezi Terraform și Terraform lucrează cu infrastructura ta, există o vulnerabilitate. Asta înseamnă că, în esență, rulezi cod. Și dacă pull request-ul conține cod malițios, acesta poate fi executat pe infrastructura care are prea mult acces. Așadar, fii atent unde rulezi Terraform plan.
Următorul lucru despre care aș dori să vorbesc este testarea user-data.
Ce este user-data? În Amazon, când creăm o instanță, putem trimite un anumit mesaj din cadrul instanței – metadate. Când instanța pornește, de obicei cloud init este întotdeauna prezent pe aceste instanțe. Cloud init citește acest mesaj și spune: „Ok, astăzi eu sunt load balancer”. Și conform acestor porunci, efectuează anumite acțiuni.
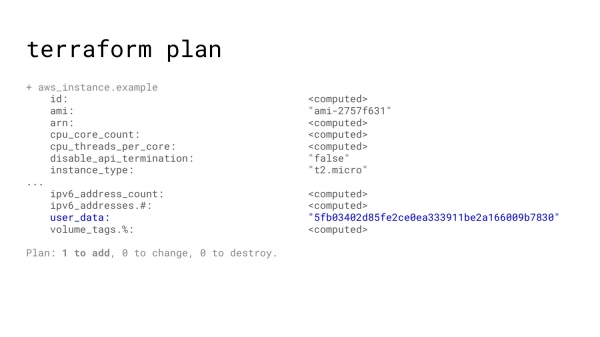
Din păcate, atunci când facem Terraform plan și Terraform apply, user-data arată ca un amestec de cifre. Adică, îți trimite pur și simplu un hash. Și tot ce poți verifica în plan este dacă sunt schimbări sau hash-ul rămâne același.
Și dacă nu acorzi atenție acestui aspect, atunci pe Amazon, un fișier text corupt ar putea ajunge în infrastructura reală.
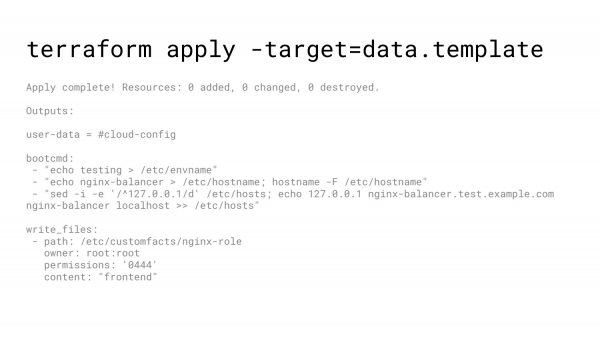
O variantă ar fi să specifici, la execuție, nu toată infrastructura, ci doar template-ul. Și în cod să spui: „Te rog, afișează-mi acest template”. Astfel, poți obține o imagine despre cum vor arăta datele tale pe Amazon.
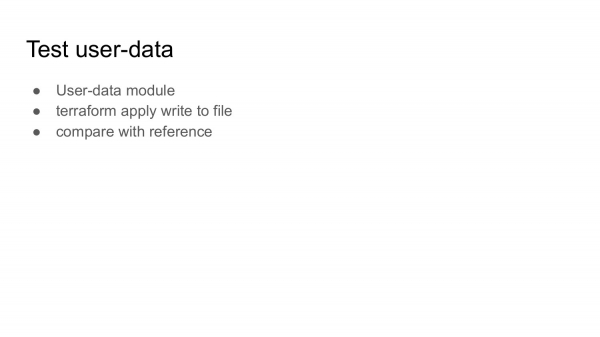
O altă variantă este să folosești un modul pentru generarea user-data. Aplici acest modul. Obții un fișier pe disc. Îl compari cu referința. Și astfel, dacă un junior decide să modifice puțin user-data, testele tale îi vor spune: „Ok, aici și aici sunt unele modificări – este în regulă”.
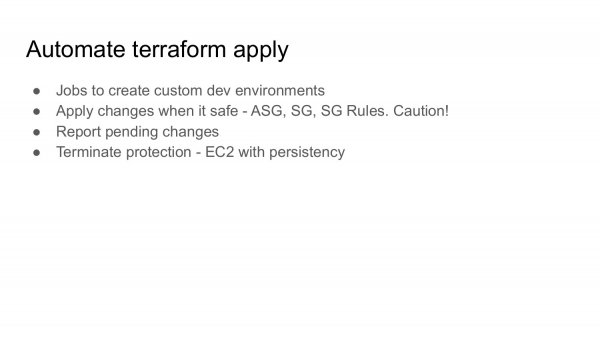
Următorul lucru despre care aș dori să vorbesc este Automatizarea Terraform apply.
Desigur, este destul de înfricoșător să faci Terraform apply în mod automat, deoarece cine știe ce modificări au venit și cât de devastatoare pot fi pentru infrastructura live.
Pentru un mediu de testare - totul este în regulă. Adică, jobul care creează un mediu de testare este ceea ce au nevoie toți dezvoltatorii. Și expresia „totul a mers bine” nu este un meme amuzant, ci o dovadă că o persoană s-a preocupat, a creat stiva, a rulat pe această stivă câteva teste. Și s-a asigurat că totul este în regulă și a spus: „Ok, codul pe care îl public, a fost testat.”
În producție, sandbox și alte medii care sunt mai importante pentru afacere, se pot aplica parțial unele resurse în mod destul de sigur, deoarece nu duce la moartea cuiva. Acestea sunt: grupuri autoscale, grupuri de securitate, roluri, route53 și lista poate fi destul de mare. Dar urmăriți ceea ce se întâmplă, citiți rapoartele despre aplicațiile automate.
Acolo unde aplicarea este periculoasă sau temătoare, de exemplu, dacă sunt anumite resurse persistente, cum ar fi bazele de date, obțineți rapoarte despre faptul că în vreo zonă a infrastructurii există modificări neaplicate. Și inginerul, sub supraveghere, lansează joburi pentru a aplica sau face asta din consola sa.
Amazon are un mecanism numit Terminate protection. Acesta poate proteja în anumite cazuri împotriva modificărilor nedorite pentru dumneavoastră. Adică Terraform a mers pe Amazon și spune: „Trebuie să distrug acest instance pentru a crea altul.” Iar Amazon spune: „Îmi pare rău, nu azi. Avem activată protecția împotriva terminării.”
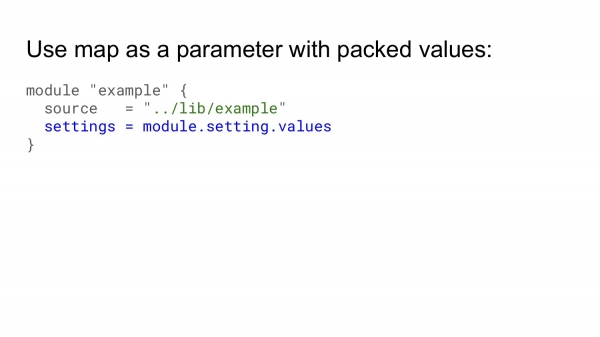
Iar cireșa de pe tort - este optimizarea codului. Când lucrăm cu codul Terraform, trebuie să trecem în modul un număr foarte mare de parametri. Aceștia sunt parametrii care sunt necesari pentru a crea o resursă. Și codul devine o listă mare de parametri, care trebuie transmiși din modul în modul, din modul în modul, mai ales dacă modulele sunt înnestate.
Și este foarte greu de citit. Este foarte greu de făcut revizuirea. Și adesea se întâmplă ca anumite parametrii să treacă revizuirea și să nu fie chiar cei necesari. Iar acest lucru costă timp și bani, pentru a corecta ulterior.
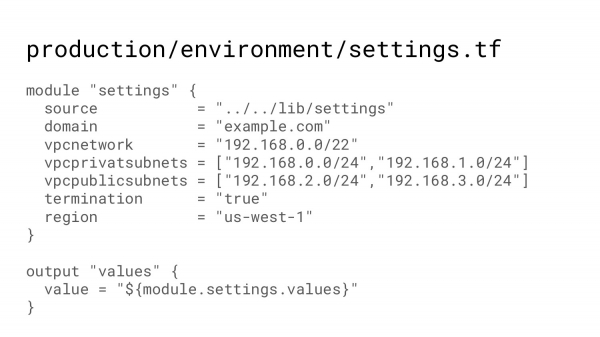
De aceea, vă propun să folosiți un parametru complex, care include o anumită structură a valorilor. Adică, aveți nevoie de un dosar în care sunt indicate toate valorile pe care ați dori să le aveți pe un anumit mediu.
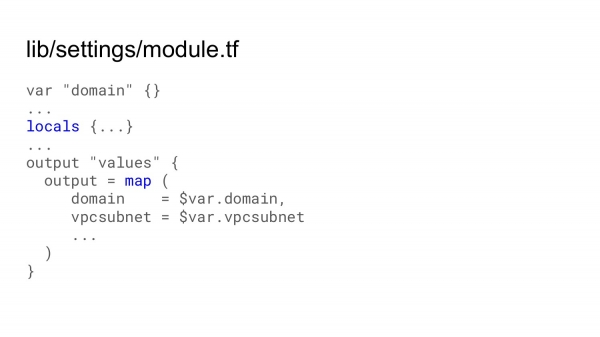
Și apelând la acest modul, se poate obține un arbore care este generat într-un singur modul comun, adică un modul comun care funcționează uniform pentru întreaga infrastructură.
În acest modul, se pot face anumite calcule, folosind o caracteristică nouă în Terraform, cum ar fi locals. Și apoi, cu un output, se poate oferi un parametru complex, care poate include hash-uri, array-uri etc.
Aici s-au încheiat toate cele mai bune descoperiri pe care le am. Aș dori să povestesc o legendă despre Columb. Când căuta bani pentru expediția sa, pentru a descoperi India (așa cum credea el atunci), nimeni nu l-a crezut și toată lumea considera că este imposibil. Atunci a spus: „Faceți ca oul să nu cadă”. Toți bancherii, oameni foarte bogați și, probabil, deștepți, au încercat în diverse moduri să sprijine oul, iar acesta cădea mereu. Atunci Columb a luat oul, a apăsat puțin pe el. Coaja s-a strivit și oul a rămas nemișcat. Ei au spus: „Oh, asta e prea simplu!”. Iar Columb a răspuns: „Da, este prea simplu. Și când voi descoperi India, toată lumea va folosi această rută comercială.”
Iar ceea ce v-am povestit acum sunt, probabil, lucruri destul de simple și triviale. Și când le descoperi și începi să le folosești, devine un lucru firesc. Așa că folosiți-le. Și dacă pentru voi aceste lucruri sunt absolut normale, atunci, măcar, știți cum să sprijiniți oul astfel încât să nu cadă.
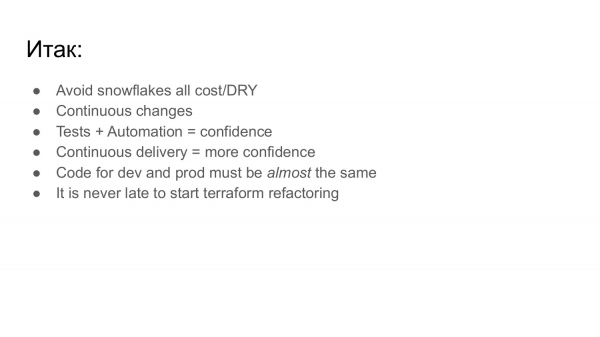
Să facem o sinteză:
- Încercați să evitați fulgii de nea. Cu cât sunt mai puțini fulgi de nea, cu atât mai puține resurse vă vor fi necesare pentru a face modificări în toată infrastructura voastră mare.
- Modificări constante. Adică, atunci când în cod au avut loc modificări, trebuie să aduceți infrastructura în conformitate cu aceste modificări cât mai repede posibil. Nu ar trebui să existe situații în care cineva vine după două-trei luni să verifice Elasticsearch, face un Terraform plan și acolo sunt o mulțime de modificări pe care nu le-aștepta. Și se pierde foarte mult timp pentru a aduce totul înapoi în ordine.
- Teste și automatizare. Cu cât codul vostru este mai mult acoperit de teste și funcționalități, cu atât aveți mai multă încredere că faceți totul corect. Iar livrarea automată va crește încrederea voastră de mai multe ori.
- Codul pentru medii de testare și de producție ar trebui să fie practic identic. Practic, pentru că totuși producția este puțin diferită și vor exista totuși nuanțe care depășesc aria de testare. Dar totuși, plus-minus se poate asigura acest lucru.
- Și dacă aveți foarte mult cod Terraform și întreținerea acestuia necesită foarte mult timp, niciodată nu e prea târziu să faceți refactoring și să-l aduceți într-o formă bună.
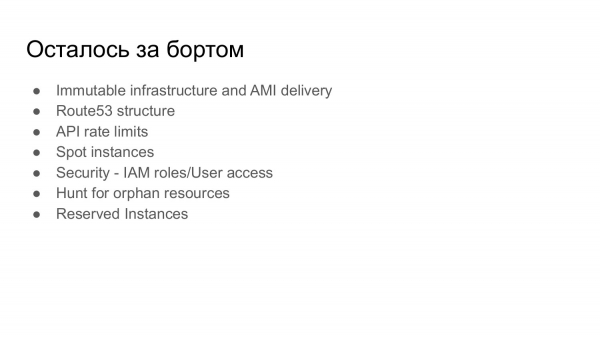
- Infrastructură imutabilă. Livrarea AMI conform unui program.
- Structura pentru route53, atunci când aveți foarte multe înregistrări și doriți să fie într-o ordine coezivă.
- Lupta cu limitele de rată ale API-ului. Aceasta este atunci când Amazon spune: „Totul, totul, nu mai pot accepta cereri, vă rog să așteptați”. Și jumătate din companie așteaptă până când poate lansa infrastructura.
- Instanțe Spot. Amazon – o activitate costisitoare, iar spot-urile permit economii semnificative. Se poate face o întreagă prezentare despre asta.
- Securitate și roluri IAM.
- Căutarea resurselor pierdute, atunci când aveți în Amazone instanțe de origine necunoscută, care consumă bani. Chiar dacă o instanță costă 100-150 de dolari pe lună – aceasta înseamnă mai mult de 1.000 pe an. Găsirea acestor resurse este o activitate profitabilă.
- Și instanțe rezervate.
Asta a fost tot din partea mea. Terraform este foarte cool, folosiți-l. Mulțumesc!
Întrebări
Mulțumesc pentru prezentare! Fișierul vostru de state este stocat în S3, cum rezolvați problema că mai multe persoane ar putea accesa acest fișier de stare și ar încerca să-l desfășoare?
În primul rând, nu ne grăbim. În al doilea rând, există flag-uri prin care anunțăm că lucrăm la un anumit cod. Adică, deși infrastructura este foarte mare, nu înseamnă că cineva aplică constant ceva. Și când a fost faza activă – aceasta era o problemă, fișierele noastre de stare erau stocate în Git. Acest lucru era important, altfel cineva ar fi creat un fișier de stare și trebuia să le adunăm manual pentru a continua. Acum nu mai avem această problemă. În general, Terraform a rezolvat această problemă. Și dacă se schimbă constant ceva, atunci se pot folosi blocări, care previn ce ați spus.
Folosiți versiunea deschisă sau cea enterprise?
Nicio versiune enterprise, adică tot ce se poate descărca gratuit.
Mă numesc Stanislav. Aș dori să fac o mică completare. Ați discutat despre funcția Amazon care permite crearea unui instance indestructibil. Acest lucru este disponibil și în Terraform, în blocul Life Second puteți specifica o interdicție de modificare sau o interdicție de distrugere.
A avut un timp limitat. O observație bună.
De asemenea, aș dori să întreb două lucruri. În primul rând, ați vorbit despre testare. Ați folosit vreun instrument pentru testare? Am auzit despre pluginul Test Kitchen. Poate că există ceva în plus. Și aș vrea să întreb despre Local Values. Cu ce se deosebesc în principal de Input Variables? Și de ce nu pot parametriza ceva doar prin Local Values? Am încercat să înțeleg acest subiect, dar cumva nu am reușit.
Putem discuta mai în detaliu despre acest lucru în afara sălii. Instrumentele pentru testare - sunt complet improvisate de noi. Nu există nimic acolo pentru a testa. Dar, în general, există opțiuni în care teste automate ridică infrastructura undeva, verifică dacă este în regulă și apoi o distrug cu un raport că infrastructura dvs. este încă în formă bună. Nu avem asta, deoarece stivele de testare sunt lansate în fiecare zi. Și este suficient. Dacă ceva începe să se strice, va începe să se strice fără să verificăm asta în altă parte.
În legătură cu Local Values, haideți să continuăm discuția în afara sălii.
Salut! Mulțumesc pentru prezentare! Foarte informativ. Ai menționat că aveți foarte mult cod similar pentru descrierea infrastructurii. Ați luat în considerare generația acestui cod?
Întrebare excelentă, mulțumesc! Adevărul este că, atunci când folosim infrastructura ca Cod, presupunem că ne uităm la cod și înțelegem ce infrastructură stă la baza acelui cod. Dacă codul este generat, trebuie să ne imaginăm ce cod va fi generat pentru a înțelege ce infrastructură va fi acolo. Fie generăm codul, fie îl angajăm și, în esență, obținem același lucru. De aceea, am urmat calea pe care am scris-o, am obținut asta. În plus, generatoarele au apărut ceva mai târziu, când am început să lucrăm, și era deja prea târziu să schimbăm.
Ai auzit ceva despre jsonnet?
Nu.
Uită-te, este un instrument foarte bun. Văd un caz concret în care poate fi aplicat pentru a genera o structură de date.
Generatoarele sunt utile, așa cum spune gluma cu aparatul de ras. Adică, prima dată fața este diferită, dar apoi toată lumea are aceeași față. Generatoarele sunt foarte atractive. Dar din păcate, fețele noastre sunt puțin diferite. Aceasta este problema.
Uită-te! Mulțumesc!
Mă numesc Maxim, sunt de la Sberbank. Ați menționat puțin că ați încercat să adaptați Terraform ca un limbaj de programare. Nu ar fi mai simplu să folosiți Ansible?
Sunt lucruri foarte diferite. Poți crea resurse și cu Ansible, și cu Puppet, în Amazon. Dar Terraform este specializat pentru asta.
Aveți doar Amazon?
Nu este vorba că avem doar Amazon. Avem aproape doar Amazon. Dar trăsătura principală este că Terraform își amintește. În Ansible, dacă spui: „Creează-mi 5 instanțe”, el le va crea, iar apoi spui: „Acum am nevoie de 3”. Și Terraform va spune: „Bine, voi șterge 2”, iar Ansible va spune: „Bine, iată-ți 3”. Așadar, avem 8.
Bună ziua! Mulțumesc pentru prezentarea dumneavoastră! A fost foarte interesant să ascult despre Terraform. Vreau să fac un mic comentariu în legătură cu faptul că Terraform nu are, totuși, o versiune stabilă, așa că trebuie să aveți mare grijă cu Terraform.
Când e vorba de o situație urgentă, uneori amâni ceea ce nu este stabil etc., dar funcționează și ne-a ajutat.
Am o întrebare. Folosiți Remote backend, folosiți S3. De ce nu folosiți backend-ul oficial?
Oficial?
Terraform Cloud.
Când a apărut?
Cu aproximativ 4 luni în urmă.
Dacă ar fi apărut acum 4 ani, probabil aș fi răspuns la întrebarea dumneavoastră.
Acolo există deja o funcție încorporată și lock-uri, și se poate stoca fișierul de stare. Încercați-l. Dar nici eu nu l-am testat.
Ne aflăm într-un tren mare care se mișcă cu viteză. Și nu poți pur și simplu să arunci câteva vagoane.
Ați vorbit despre fulgi de zapadă; de ce nu ați folosit branch? De ce nu a funcționat așa?
Avem o astfel de abordare încât toată infrastructura este într-un singur repository. Terraform, Puppet, toate scripturile legate de acest lucru sunt toate într-un singur repository. Astfel, putem garanta că modificările incrementale sunt testate pe rând. Dacă ar fi fost o mulțime de branch-uri, un astfel de proiect ar fi aproape imposibil de întreținut. Trec 6 luni și devin atât de diferite încât este pur și simplu o pedeapsă. Aceasta este ceea ce am vrut să evit înainte de refactorizare.
Adică, nu funcționează?
Asta deloc nu funcționează.
În branch am tăiat slide-ul folderului. Adică, dacă facem câte un stack de test pentru fiecare echipă, de exemplu, echipa A - are folderul ei, echipa B - are folderul ei, atunci nici asta nu funcționează. Am creat un cod unificat pentru mediu de testare, care a fost destul de flexibil pentru a se potrivi tuturor. Adică, am întreținut un singur cod.
Salut! Mă numesc Iura! Mulțumesc pentru prezentare! Am o întrebare despre module. Vorbiți despre utilizarea modulelor. Cum rezolvați problema dacă un modul suferă modificări care nu sunt compatibile cu modificările altcuiva? Faceți vreo versiune pentru module sau încercați să adaptați totul pentru a corespunde ambelor cerințe?
Aceasta este problema unei mari avalanșe. Este ceea ce suferim atunci când o modificare inofensivă poate distruge o parte din infrastructură. Și acest lucru va fi observat abia după un timp îndelungat.
Adică, în prezent nu este rezolvată deloc?
Faci module universale. Evită fulgii de zăpadă. Și totul va funcționa. A doua jumătate a prezentării este despre cum să eviți acest lucru.
Bună ziua! Mulțumesc pentru prezentare! Aș dori să clarific. A rămas o mare problemă de fond pentru care am venit. În ce mod sunt integrate Puppet și distribuirea rolurilor?
User-data.
Adică, pur și simplu aruncați un fișier și cumva acționați pe baza lui?
User-data este o notă, adică, atunci când facem un clon al imaginii, un Daemon se ridică și, încercând să se identifice, citește nota că este un load balancer.
Adică, este un proces separat care este delegat?
Nu noi l-am inventat. Noi doar îl folosim.
Bună ziua! Am o întrebare despre User-data. Ați menționat că există probleme, că cineva ar putea să transmită informații greșite. Există vreo modalitate de stocare a user-data în același Git, astfel încât să fie întotdeauna clar la ce se referă User-data?
Generăm User-data din template. Adică, acolo intră un anumit număr de variabile. Și Terraform generează rezultatul final. Așadar, nu poți pur și simplu să te uiți la template și să spui ce va ieși, deoarece toate problemele sunt legate de faptul că dezvoltatorul crede că transmite un șir în această variabilă, dar intră un array. Și el se trezește cu – hop – că este altceva, următoarea linie, și totul s-a rupt. Dacă este o resursă nouă și persoana o ridică, vede că ceva nu funcționează, atunci se rezolvă rapid. Dar dacă este un grup autoscale care s-a actualizat, atunci, la un moment dat, instanțele din grupul autoscale începe să fie înlocuite. Și, bum, ceva nu funcționează. Este frustrant.
Așadar, singura soluție este să testăm?
Da, vezi problema, adaugi pași de testare. Adică output-ul poate fi testat. Poate nu este atât de convenabil, dar poți pune și unele etichete – verifică că User-data este prinsă aici cu cuie.
Mă numesc Timur. E foarte grozav că există prezentări despre cum să organizezi corect Terraform.
Nu am început încă.
Cred că la următoarea conferință, poate, va exista. Am o întrebare simplă. De ce codifici valorile într-un modul separat, și nu folosești tfvars? Adică, ce este mai bun în modulul cu valori decât tfvars?
Adică, aici (slide: Production/environment/settings.tf) trebuie să scriu: domain = variabilă, domain vpcnetwork, variabilă vpcnetwork și stvars – a obține același lucru?
Exact așa facem. Ne referim la modulul setting source, de exemplu.
Practic, este un tfvars. Tfvars este foarte convenabil în mediu de testare. Am tfvars pentru instanțe mari și pentru cele mici. Și am aruncat un fișier în folder. Și am obținut ceea ce am dorit. Când dezvoltăm infrastructura, vrem să putem verifica și să înțelegem imediat totul. Dar așa trebuie să ne uităm aici, apoi să ne uităm în tfvars.
Deci, vrei să ai totul într-un singur loc?
Da, tfvars este atunci când ai un singur cod. Și este folosit în mai multe locuri diferite cu nuanțe diferite. Atunci ai aruncat tfvars și ai obținut nuanțele tale. Iar noi – aceasta este infrastructura ca și cod în forma sa pură. Te-ai uitat și ai înțeles.
Bună ziua! Ați întâlnit astfel de situații în care furnizorul de cloud intervine în ceea ce ați realizat cu Terraform? Să presupunem că modificăm meta-datele. Acolo sunt chei ssh. Iar Google tot timpul introduce meta-datele și cheile sale. Și Terraform tot timpul raportează că are modificări. După fiecare execuție, chiar dacă nimic nu se schimbă, el spune mereu că va actualiza acest câmp.
Cu cheile, dar – da, o parte din infrastructură este afectată de această problemă, adică Terraform nu poate schimba nimic. Nici noi nu putem schimba nimic manual. Deocamdată trăim cu asta.
Așadar, ați întâmpinat asta, dar nu ați găsit soluții? Continuă să facă ceea ce face singur?
Din păcate, da.
Bună ziua! Mă numesc Starkov Stanislav. Mail.ru Group. Cum rezolvați problema generării tagului pe ..., cum îl transmiteți în interior? Înțeleg că prin User — data, pentru a specifica numele gazdei, să folosiți Puppet? Și a doua parte a întrebării. Cum rezolvați această problemă la SG, adică atunci când generați SG, o sută de instanțe de același tip, cum le numiți corect?
Instanțele care sunt foarte importante pentru noi le numim frumos. Cele care nu sunt necesare au o anexă care indică că sunt într-o grupă autoscale. Și, teoretic, acestea pot fi șterse și obținem noi.
Referitor la problema cu tagul, nu este o problemă, ci o sarcină. Și tagurile sunt folosite foarte, foarte mult, deoarece infrastructura este mare și costisitoare. Trebuie să monitorizăm unde se duc banii, prin urmare tagurile ne permit să înțelegem ce și unde s-au cheltuit. Și, prin urmare, să căutăm locurile unde se cheltuie prea mulți bani.
Despre ce altceva a fost întrebarea?
Când SG creează o sută de instanțe, trebuie să le diferentiem cumva?
Nu, nu este necesar. Fiecare instanță are un agent care raportează că are o problemă. Dacă agentul raportează, atunci agentul cunoaște despre el și, cel puțin, există un IP al său. Se poate verifica. În al doilea rând, folosim Consul pentru Discovery, acolo unde nu avem Kubernetes. Și Consul arată și el IP-ul instanței.
Așadar, vă orientați pe IP, nu pe numele gazdei?
Este imposibil să te orientezi după numele gazdei, adică sunt foarte multe. Există identificatori de instanță – AE etc. Acesta poate fi găsit undeva, poate fi căutat.
Salut! Am înțeles că Terraform este o chestie bună, adaptată pentru cloud.
Nu doar.
Aceasta este întrebarea care mă interesează. Dacă decideți să migrați, să zicem, pe Bare Metal în masă cu toate instanțele dvs.? Nu vor fi probleme? Sau va fi necesar să folosiți alte produse, de exemplu, același Ansible menționat aici?
Ansible se referă la altceva. Adică, Ansible funcționează atunci când instanța a fost pornită. Pe când Terraform funcționează înainte ca instanța să fie pornită. Trecerea la Bare Metal – nu.
Acum nu este, dar va veni un business și va spune: «Hai».
Trecerea la un alt cloud – da, dar aici este o poveste puțin diferită. Trebuie să scriem cod Terraform astfel încât să putem trece pe un alt cloud cu mai puțin efort.
Inițial, s-a pus această sarcină, că întreaga infrastructură trebuie să fie agnostic, adică orice cloud ar trebui să funcționeze, dar într-un anumit moment businessul a cedat și a spus: «Ok, în următorii N ani nu ne vom muta nicăieri, putem folosi serviciile de la Amazon».
Terraform permite crearea de joburi Front-End, configurarea PagerDuty, documente de date etc. Are foarte multe extensii. Practic, poate controla întreaga lume.
Mulțumesc pentru prezentare! De asemenea, eu folosesc Terraform de 4 ani. În etapa tranziției la Terraform, la infrastructură, la descrierea declarativă, ne-am confruntat cu situația în care cineva făcea ceva manual, iar tu încercai să faci un plan. Și primeai o eroare. Cum abordați astfel de probleme? Cum găsiți resursele pierdute care au fost specificate?
În principal manual și prin observare, dacă vedem în raport ceva ciudat, analizăm ce se întâmplă acolo sau pur și simplu ștergem. În general, pull requests sunt o practică obișnuită.
Dacă există o eroare, faceți rollback? Ați încercat să faceți asta?
Nu, aceasta este decizia unei persoane în momentul în care vede problema.
Sursa: habr.com
